Self-hosted runner GitHub Actions dla całej organizacji
Dla CTO i programistówDecyzje CTO

Filip PapranecZałożyciel Digitaliko
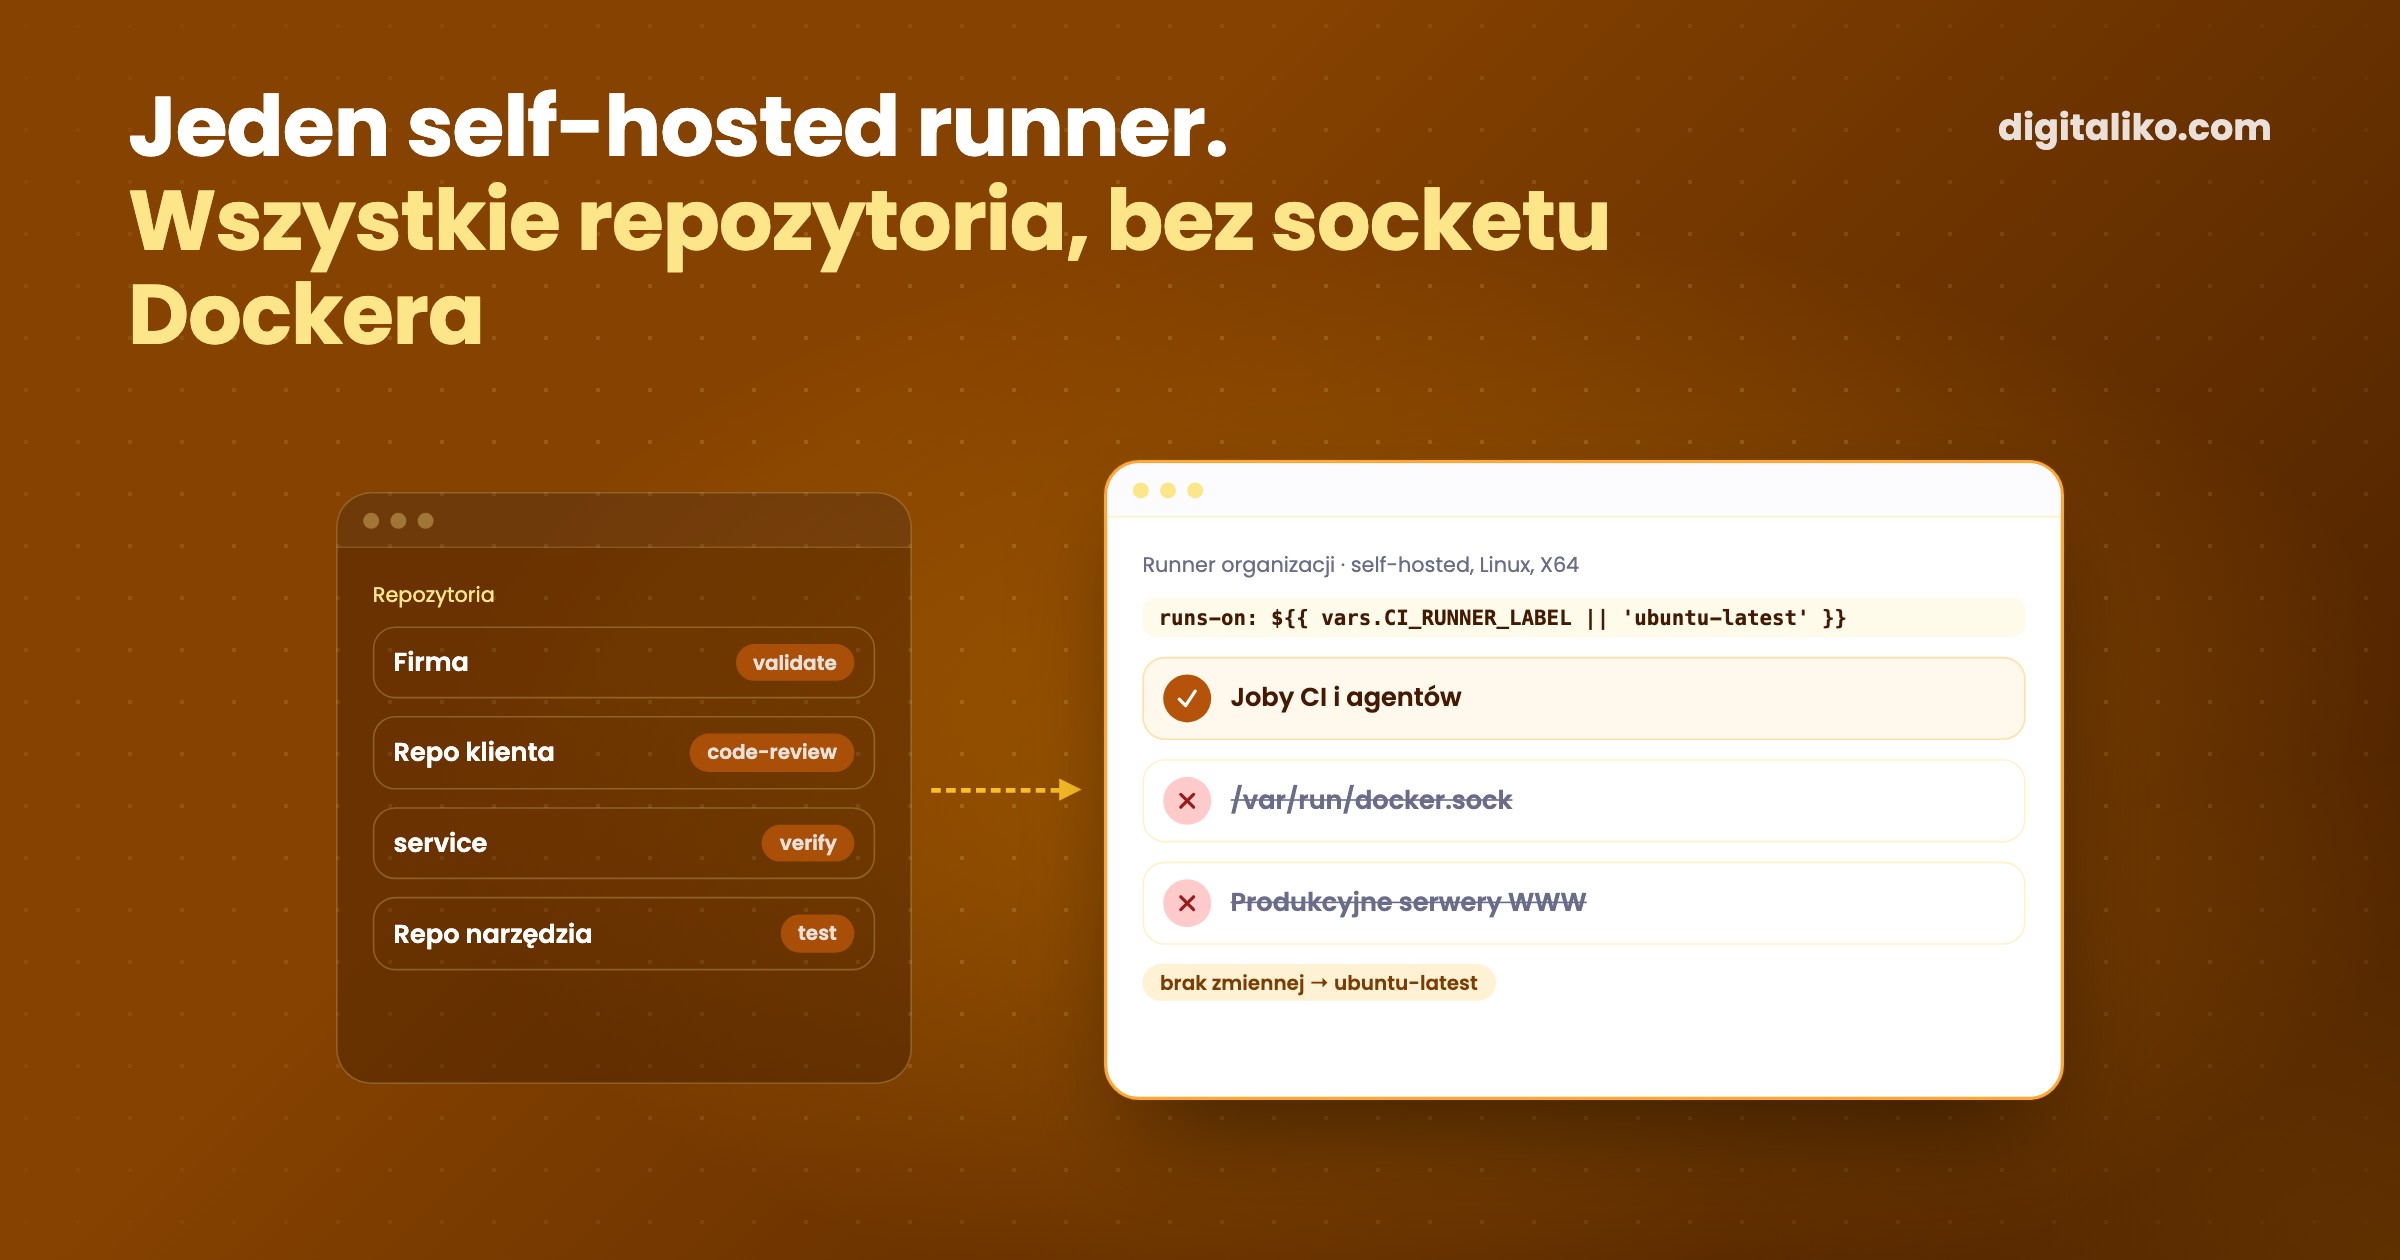
Self-hosted runner GitHub Actions to maszyna, którą Państwo zarządzają i która przejmuje joby z Państwa workflowów. Repozytorium może wybrać go jedną zmienną organizacji, a bez niej wraca do runnerów hostowanych przez GitHub.
Polecamy trzy decyzje. Proszę zarejestrować runner na poziomie organizacji, a nie w jednym repozytorium. Proszę nie dawać mu dostępu do socketu Dockera. I proszę nie wpuszczać na niego repozytoriów innej organizacji, na przykład tych należących do klienta.
Czym jest self-hosted runner i kiedy się opłaca?
Runnery hostowane przez GitHub to świeże maszyny wirtualne, które GitHub uruchamia dla każdego joba. Self-hosted runner to Państwa własna maszyna z aplikacją runnera od GitHub. Państwo go instalują, aktualizują i decydują, do czego ma dostęp.
| Runner hostowany przez GitHub | Self-hosted runner | |
|---|---|---|
| Maszyna | Świeża VM dla każdego joba, zarządzana przez GitHub | Państwa serwer, VM lub komputer |
| Czysty stan | Każdy job startuje od zera | Bez gwarancji, pliki i procesy mogą zostać |
| Oprogramowanie | Obraz GitHub | To, co Państwo zainstalują |
| Sieć | Publiczny internet | Może sięgać do Państwa sieci prywatnej |
| Kto go utrzymuje | GitHub | Państwo: aktualizacje, dysk, bezpieczeństwo |
| Rozliczenie | Minuty Actions w Państwa planie | Państwa własna maszyna |
Self-hosted runner opłaca się, gdy joby uruchamiają się często, gdy potrzebują czegoś, czego nie ma hostowany obraz, albo gdy długie joby agentów zjadałyby hostowane minuty. Typowy przypadek to CI, które przy większości pull requestów uruchamia walidator, code review z AI i krok weryfikacji z AI.
Jak wybrać runner dla każdego repozytorium?
Proszę nie wpisywać nazwy runnera do żadnego workflow. Każdy szablon workflow ma tę samą linię:
jobs:
  validate:
    runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }}
    steps:
      - uses: actions/checkout@v4
      - run: npm ci && npm test
CI_RUNNER_LABEL to zmienna organizacji o wartości self-hosted, widoczna dla repozytoriów, które mogą korzystać z runnera. Gdy jest ustawiona, job trafia do Państwa runnera. Gdy jej brakuje, wyrażenie wraca do ubuntu-latest.
Właśnie o ten powrót chodzi. Gdy maszyna padnie, jedna zmiana zmiennej odsyła wszystkie repozytoria z powrotem do runnerów hostowanych. Nikt nie edytuje ani jednego pliku workflow.
Konfiguracja ma cztery kroki:
01
Rejestracja na poziomie organizacji
Proszę dodać runner w ustawieniach organizacji, a nie w jednym repozytorium, aby każde repozytorium w organizacji mogło wysyłać mu joby.
02
Ustawienie zmiennej organizacji
CI_RUNNER_LABEL = self-hosted, widoczna dla wszystkich repozytoriów.
03
Jedna linia runs-on wszędzie
Każdy szablon workflow używa wyrażenia z powrotem do ubuntu-latest. Szablony to jedyne miejsce, gdzie jest zapisane.
04
Goły runner
Współdzielone actions same instalują Node i Bun przez setup-node i setup-bun, więc na maszynie prawie nic nie musi być zainstalowane z góry.
GitHub opisuje opcję na poziomie organizacji wprost: runnery dodane "at the organization level, where they can be used to process jobs for multiple repositories in an organization" (dokumentacja GitHub, stan na 24.10.2026).
Dlaczego nie dawać runnerowi socketu Dockera?
Bo runner CI uruchamia kod z pull requestów. GitHub mówi wprost, co to oznacza:
Self-hosted runners for GitHub do not have guarantees around running in ephemeral clean virtual machines, and can be persistently compromised by untrusted code in a workflow.
Z socketem Dockera jest jeszcze gorzej. Strona bezpieczeństwa Dockera pisze "only trusted users should be allowed to control your Docker daemon", bo kontener może zamontować katalog główny hosta (dokumentacja Docker, stan na 24.10.2026). Krok workflow, który dosięgnie socketu, może uruchomić taki kontener i zostać rootem na maszynie.
Dlatego proszę nie montować socketu hosta w runnerze. Joby, które potrzebują kontenerów usług, zatrzymają się wtedy na Initialize containers. To w porządku: błąd jest widoczny, a własny daemon go rozwiązuje.
Co powinno działać na runnerze, a co nie?
Tylko praca CI i agentów, na przykład walidator, code review z AI i krok weryfikacji z AI. Żadnej produkcji. Jak krok weryfikacji ocenia pull request, opisujemy w LLM as a judge.
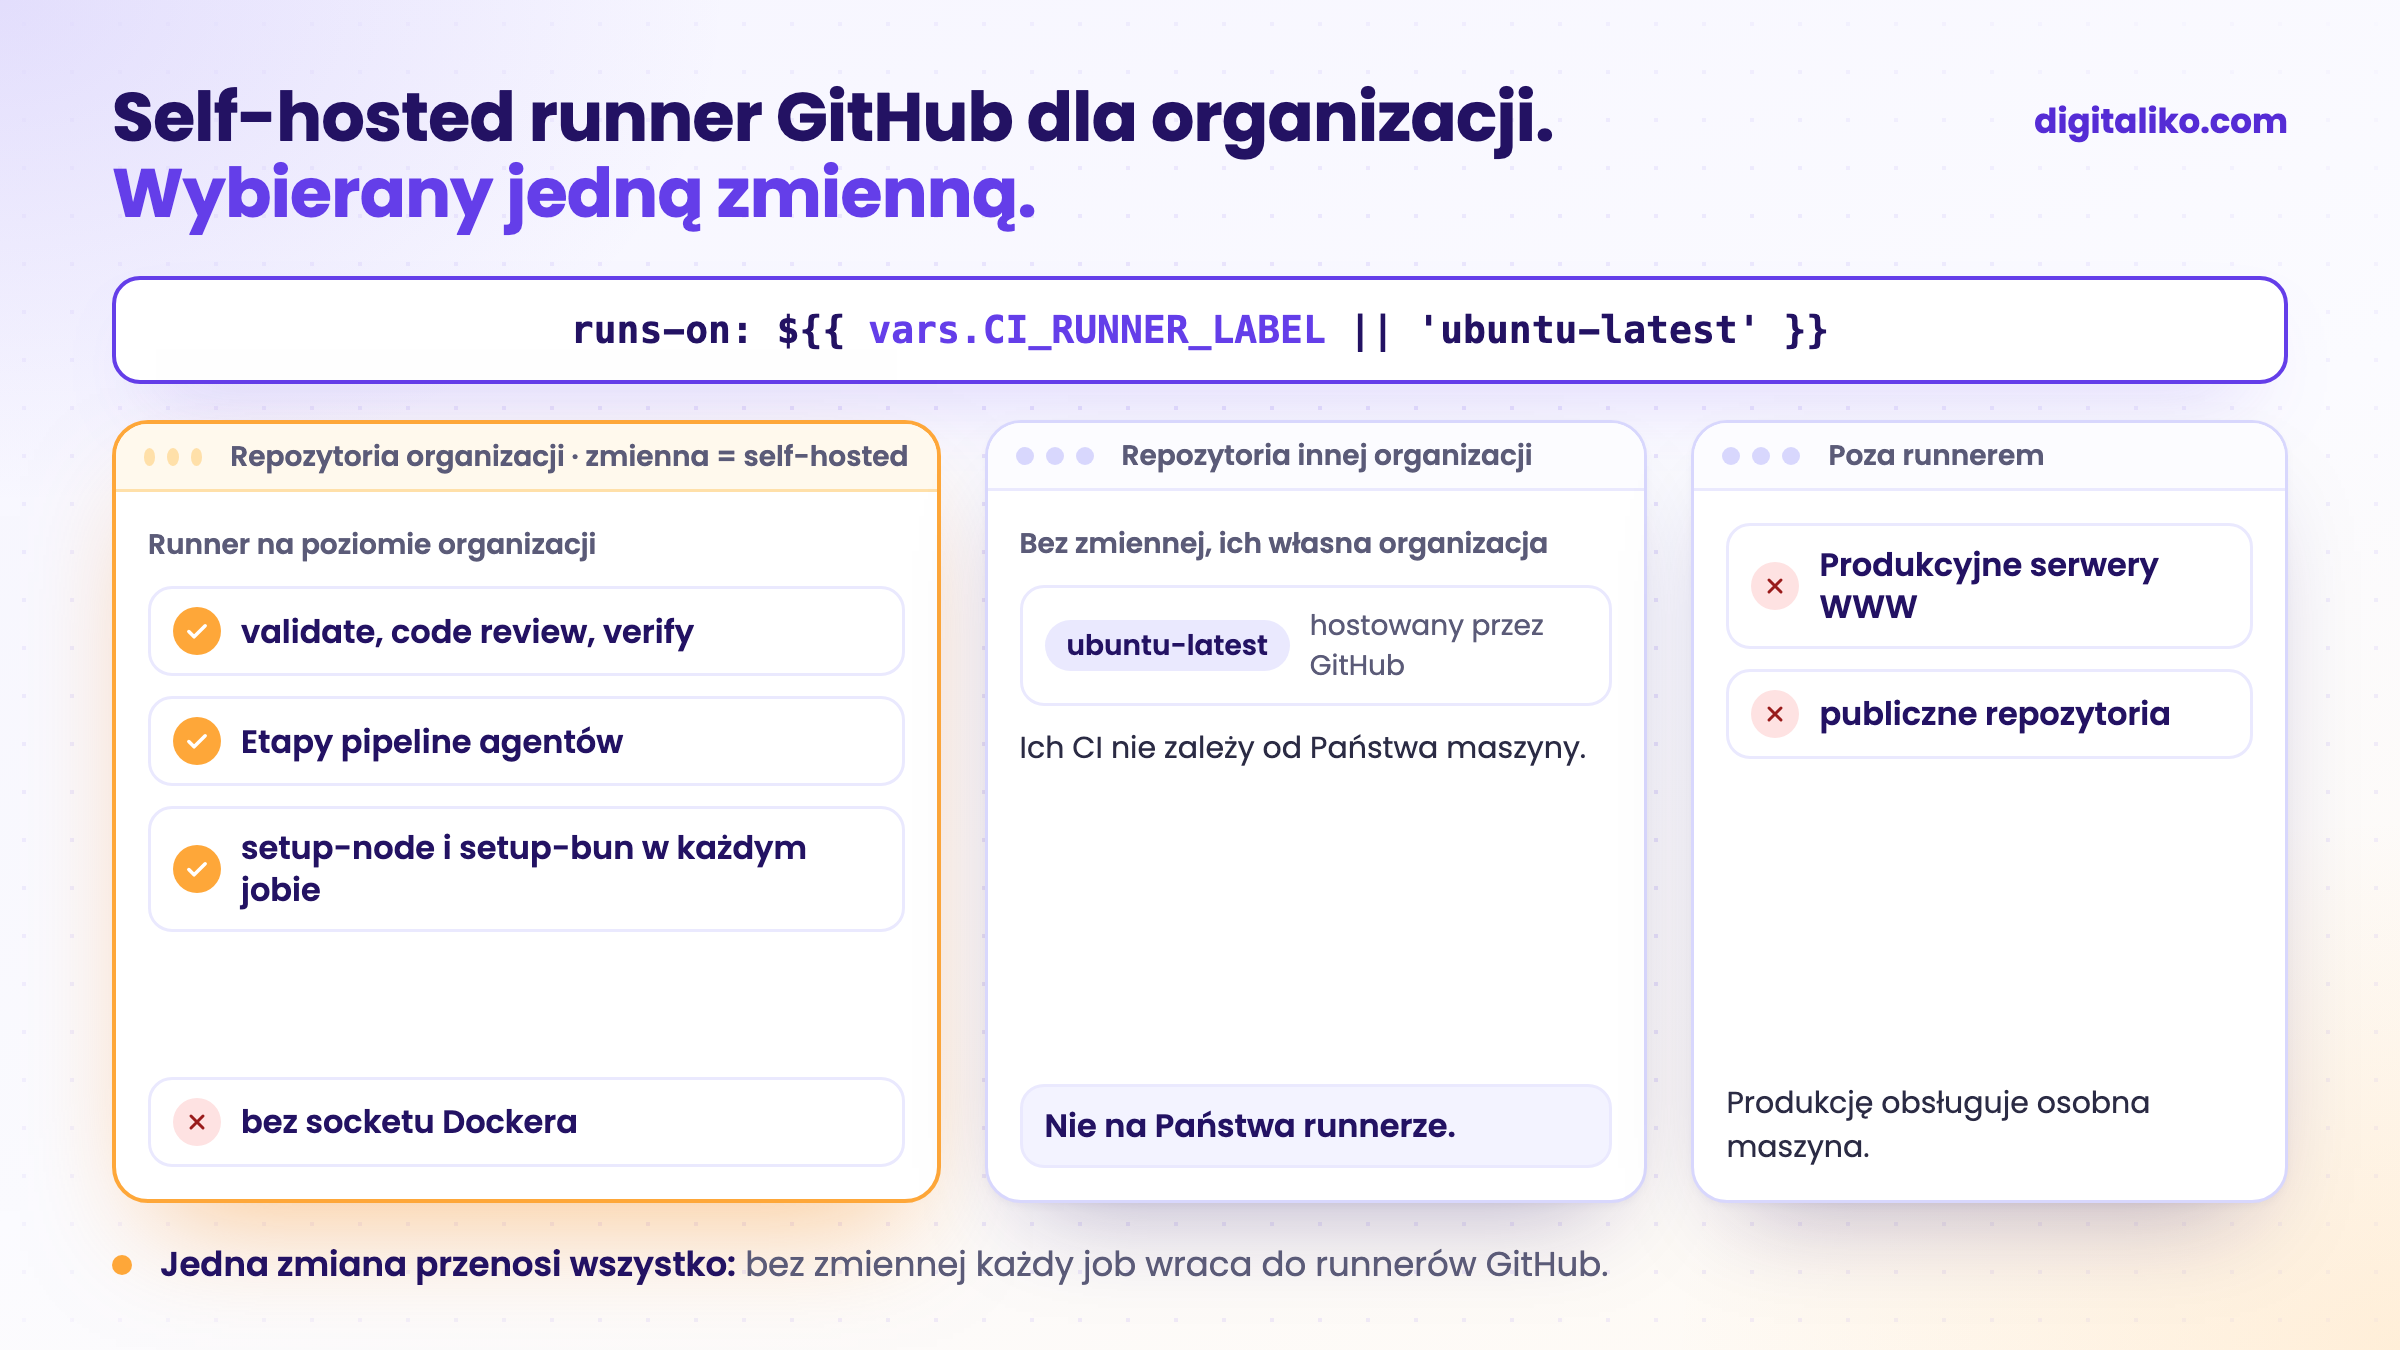
Produkcyjne serwery WWW proszę trzymać na osobnej maszynie. Buildy obok produkcji konkurowałyby z nią o zasoby.
Sam runner proszę zostawić gołym. Action verify może zaczynać się tak, bo reviewer potrzebuje Node, a skrypty repozytorium swojego menedżera pakietów:
steps:
  # the self-hosted runner is bare: the reviewer needs node, the repo scripts need their package manager
  - uses: actions/setup-node@v4
    with:
      node-version: 22
  - uses: oven-sh/setup-bun@v2
  - shell: bash
    run: corepack enable
Każdy job deklaruje, czego potrzebuje. Job, który działa na Państwa runnerze, działa też na ubuntu-latest, i to właśnie czyni powrót bezpiecznym.
Dlaczego repozytoria innej organizacji zostają na runnerach hostowanych?
Jeśli pracują Państwo także nad repozytoriami, które należą do klienta, w jego własnej organizacji na GitHub, proszę zostawić ich workflowy na runs-on: ubuntu-latest. Trzy powody:
- To ich kod i ich CI. Klient, do którego należy repozytorium, nie powinien zależeć od maszyny prowadzonej przez dostawcę. Gdy współpraca się skończy, jego CI działa dalej bez jednej zmiany.
- Runner organizacji należy do swojej organizacji. Obsługuje repozytoria tej organizacji. Sięganie między organizacjami oznacza drugą rejestrację i drugą granicę zaufania.
- Mniej do tłumaczenia. Nikt nie musi pytać, co uruchamia jego kod ani gdzie.
Proszę wpisać tę zasadę do dokumentacji CI. Repozytoria Państwa organizacji idą za zmienną organizacji, repozytoria klientów zostają na ubuntu-latest.
Czy self-hosted runner pasuje do Państwa organizacji?
Proszę przejść przez to, co mają Państwo dziś:
Ostatni punkt to limit, który boli najwcześniej. Jeden proces runnera bierze jeden job naraz, a reszta czeka. Krótkie joby to ukrywają. Długie joby agentów już nie. Więcej procesów runnera na tej samej maszynie to tańsze rozwiązanie, zanim sięgną Państwo po większą maszynę.
AI review każdego pull requestu opisujemy w Claude Code review: AI code review w CI. Jak daleko pozwolić agentowi działać samodzielnie na własnej maszynie, opisujemy w Claude Code dangerously skip permissions.
Potrzebują Państwo CI, na którym może polegać cały zespół i jego agenci?
Runnery, współdzielone actions CI i review wokół nich konfigurujemy dla zespołów deweloperskich w ramach usługi senior developer dla Państwa zespołu. Stronę agentów obejmuje AI-native SDLC dla zespołów deweloperskich. Większość naszego kodu pisze AI. Senior przegląda każdą zmianę i odpowiada za produkcję. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co robimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę umówić 15-minutową rozmowę wstępną.
Gdyby Państwa runner padł dziś w nocy, ile plików workflow musieliby Państwo jutro edytować?
W skrócie
- Runner zarejestrowany na poziomie organizacji może obsługiwać wiele repozytoriów, a grupy runnerów decydują, które.
- runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }} go wybiera, a jedna zmienna odsyła wszystko do runnerów hostowanych.
- Bez socketu Dockera: kto kontroluje daemon, jest rootem na maszynie.
- Repozytoria klientów i produkcja zostają poza runnerem.
Najczęściej zadawane pytania
Czym jest self-hosted runner GitHub Actions?
To maszyna, którą Państwo zarządzają, na której działa aplikacja runnera GitHub Actions i która przejmuje joby z Państwa workflowów. Może to być serwer w chmurze, VM albo komputer w biurze. W workflow wybierają go Państwo przez runs-on i jego etykiety.
Czy jeden self-hosted runner może obsługiwać wszystkie repozytoria organizacji?
Tak. Runner zarejestrowany na poziomie organizacji może przetwarzać joby wielu repozytoriów tej organizacji. Grupy runnerów (runner groups) pozwalają ograniczyć, które repozytoria mogą z niego korzystać.
Czy self-hosted runner jest bezpieczny dla repozytoriów publicznych?
GitHub pisze, że self-hosted runnerów prawie nigdy nie należy używać w repozytoriach publicznych, bo każdy może otworzyć pull request i uruchomić kod na maszynie. Nawet w repozytoriach prywatnych kod może tam uruchomić każdy, kto może otworzyć pull request.
Jak przełączać się między self-hosted runnerem a runnerem hostowanym przez GitHub?
Wyrażeniem w runs-on: runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }}. Gdy zmienna jest ustawiona, joby trafiają do Państwa runnera. Bez niej wracają do Ubuntu hostowanego przez GitHub. Jedna zmiana zmiennej organizacji przenosi wszystkie repozytoria.
Dlaczego nie montować socketu Dockera w runnerze?
Kto może rozmawiać z daemonem Dockera, może uruchomić kontener z zamontowanym systemem plików hosta i zostać rootem na maszynie. Na runnerze CI to każdy, kto może otworzyć pull request. Jeśli job potrzebuje kontenerów, proszę dać mu własny daemon.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

