GitHub Actions Self-hosted Runner für die Organisation
Für CTOs und EntwicklerCTO-Entscheidungen · Aktualisiert

Filip PapranecGründer von Digitaliko
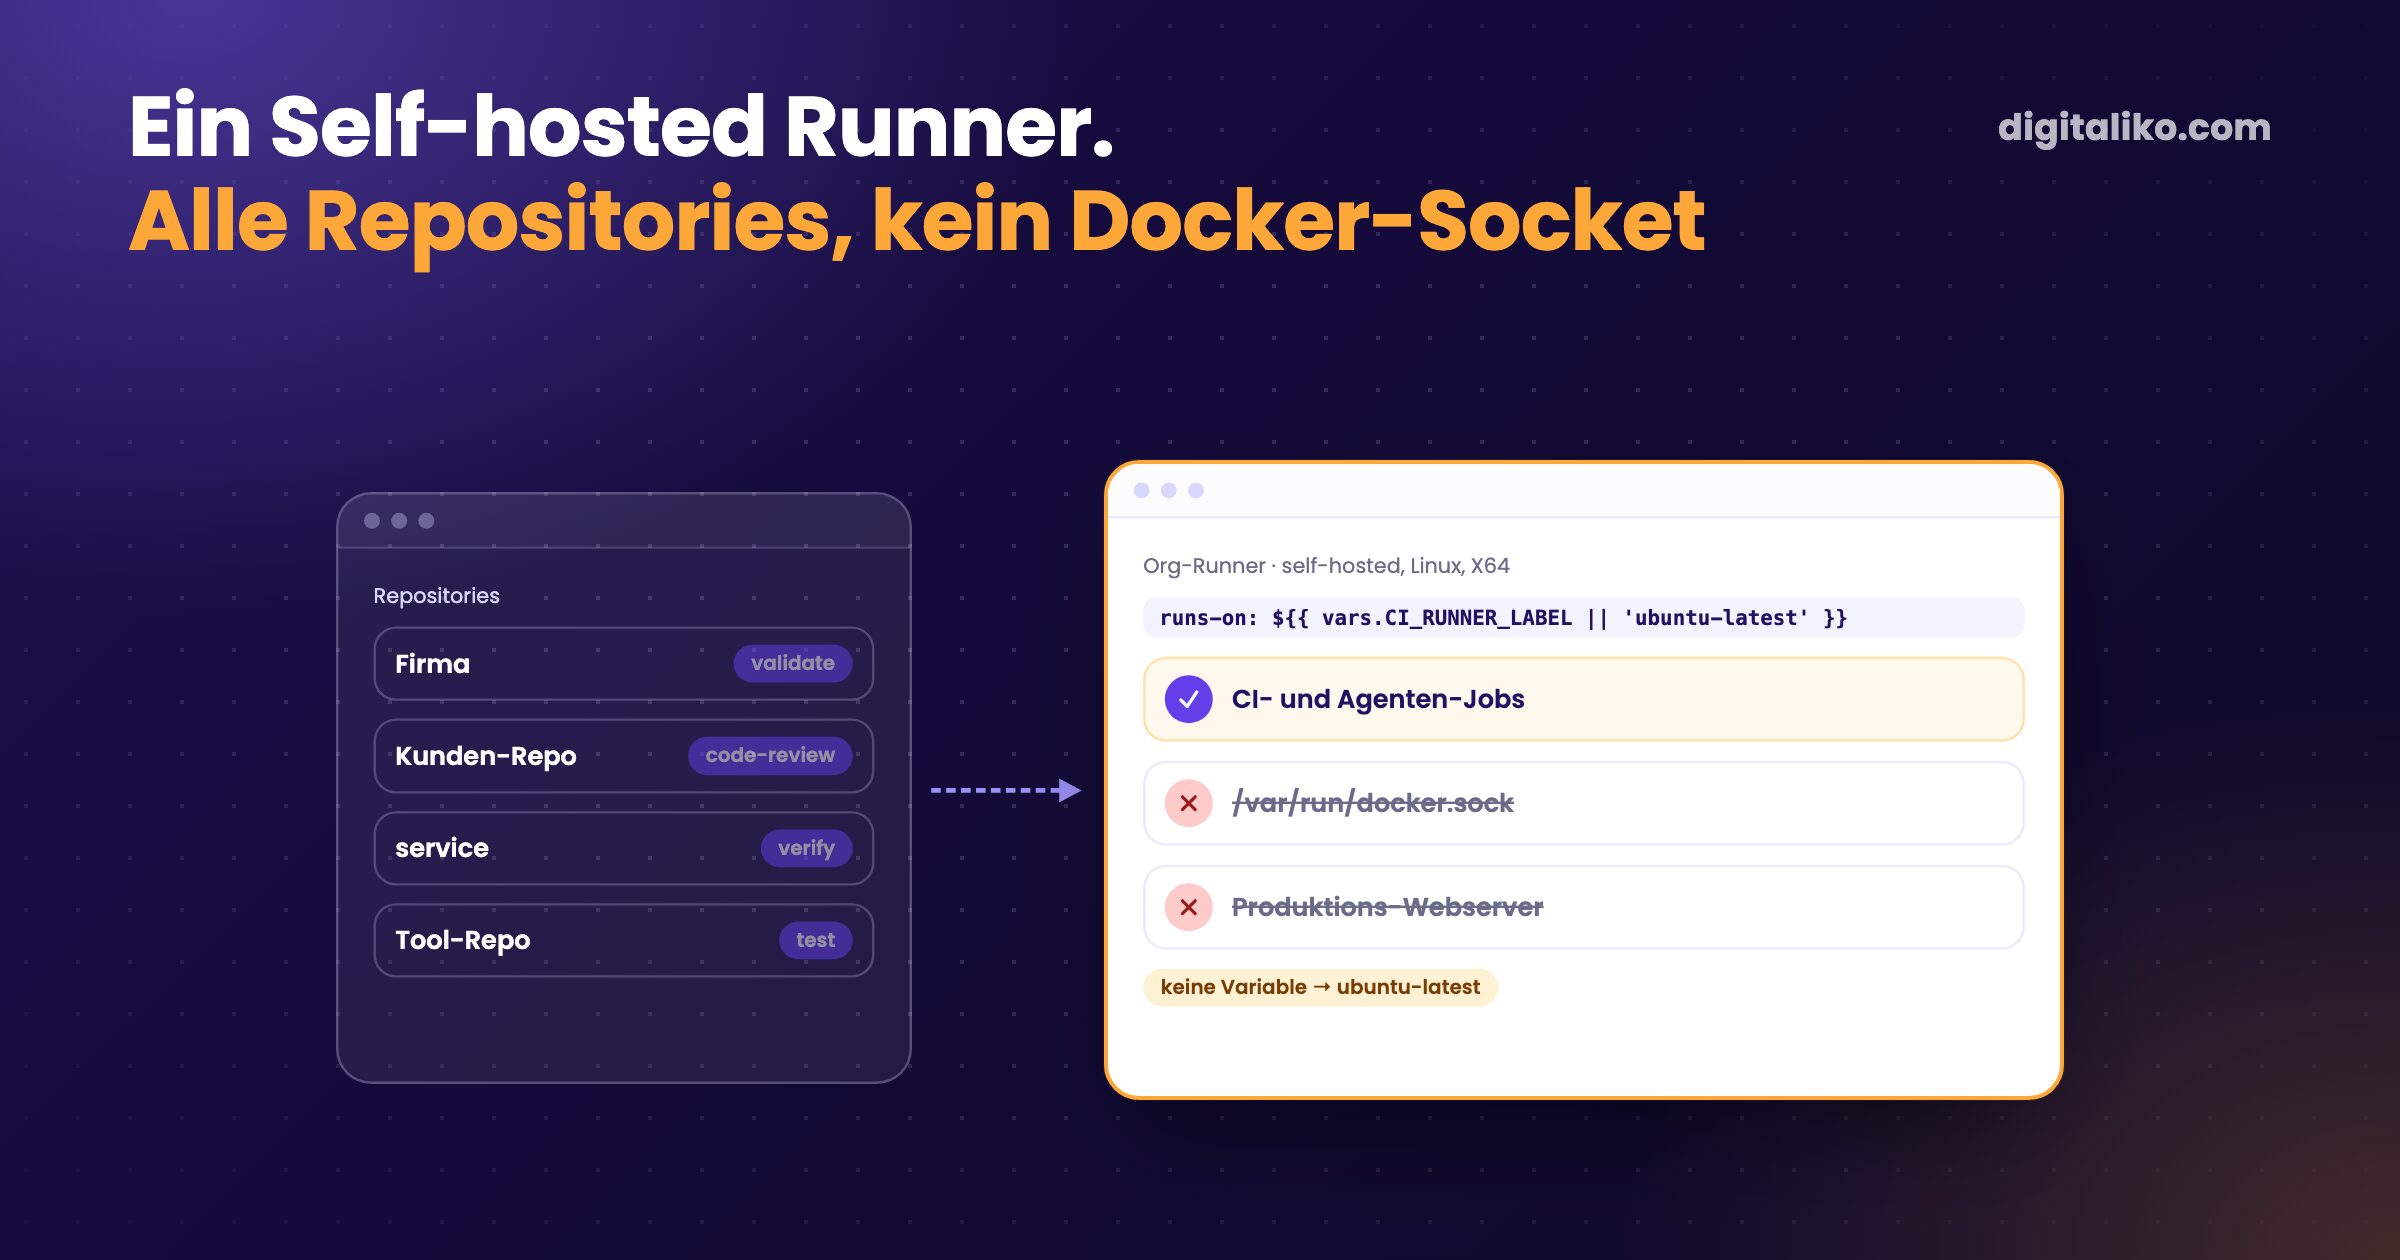
Ein GitHub Actions Self-hosted Runner ist eine Maschine, die Sie selbst verwalten und die Jobs aus Ihren Workflows übernimmt. Wir betreiben einen für die ganze Organisation. Jedes Repository wählt ihn über eine Org-Variable und fällt ohne sie auf die gehosteten Runner von GitHub zurück.
Drei Entscheidungen lassen das für uns funktionieren. Der Runner ist auf Organisationsebene registriert, nicht pro Repository. Er hat bewusst keinen Zugriff auf den Docker-Socket. Und Repositories, die unseren Kunden gehören, laufen nie darauf.
Was ist ein Self-hosted Runner und wann lohnt er sich?
Die gehosteten Runner von GitHub sind frische virtuelle Maschinen, die GitHub für jeden Job startet. Ein Self-hosted Runner ist Ihre eigene Maschine mit der Runner-Anwendung von GitHub. Sie installieren ihn, halten ihn aktuell und entscheiden, was er erreichen darf.
| Von GitHub gehosteter Runner | Self-hosted Runner | |
|---|---|---|
| Maschine | Eine frische VM pro Job, verwaltet von GitHub | Ihr Server, Ihre VM oder Ihr Rechner |
| Sauberer Zustand | Jeder Job startet sauber | Nicht garantiert, Dateien und Prozesse können bleiben |
| Software | Das Image von GitHub | Was Sie installieren |
| Netzwerk | Öffentliches Internet | Erreicht auch Ihr internes Netz |
| Wer ihn pflegt | GitHub | Sie: Updates, Festplatte, Sicherheit |
| Abrechnung | Actions-Minuten in Ihrem Plan | Ihre eigene Maschine |
Ein Self-hosted Runner lohnt sich, wenn Jobs oft laufen, wenn sie etwas brauchen, das das gehostete Image nicht hat, oder wenn lange Agenten-Jobs gehostete Minuten auffressen würden. Bei uns waren es die letzten beiden. Unsere CI führt bei den meisten Pull Requests einen Validator, ein KI-Code-Review und eine KI-Verifikation aus, über viele Repositories hinweg.
Wie wählen wir den Runner pro Repository?
Wir nennen den Runner in keinem Workflow. Jede Workflow-Vorlage hat dieselbe Zeile. Ihr validate-Schritt kommt aus wizrd, unserem internen Claude-Code-Plugin und CLI (nicht öffentlich), und dasselbe Muster funktioniert mit Ihrer eigenen Action:
jobs:
  validate:
    runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }}
    steps:
      - uses: actions/checkout@v4
      - uses: Digitaliko/wizrd/.github/actions/validate@v1
CI_RUNNER_LABEL ist eine Org-Variable mit dem Wert self-hosted, sichtbar für alle Repositories. Ist sie gesetzt, geht der Job an unseren Runner. Fehlt sie, fällt der Ausdruck auf ubuntu-latest zurück.
Genau dieser Fallback ist der Punkt. Fällt die Maschine aus, schickt eine Änderung der Variable alle Repositories zurück auf gehostete Runner. Niemand ändert auch nur eine Workflow-Datei.
Die Einrichtung hatte vier Schritte:
01
Auf Organisationsebene registrieren
Fügen Sie den Runner in den Einstellungen der Organisation hinzu, nicht bei einem Repository, damit jedes Repository der Organisation ihm Jobs schicken kann.
02
Die Org-Variable setzen
CI_RUNNER_LABEL = self-hosted, sichtbar für alle Repositories.
03
Eine runs-on-Zeile überall
Jede Workflow-Vorlage nutzt den Ausdruck mit dem Fallback auf ubuntu-latest. Die Vorlagen sind der einzige Ort, an dem er steht.
04
Den Runner nackt lassen
Geteilte Actions installieren Node und Bun selbst mit setup-node und setup-bun, sodass auf der Maschine fast nichts vorinstalliert sein muss.
GitHub beschreibt die Option auf Organisationsebene direkt: Runner, die „at the organization level, where they can be used to process jobs for multiple repositories in an organization“ hinzugefügt werden (GitHub Docs, Stand 24.10.2026).
Warum haben wir dem Runner Docker genommen?
Weil ein CI-Runner Code aus Pull Requests ausführt. GitHub sagt deutlich, was das bedeutet:
Self-hosted runners for GitHub do not have guarantees around running in ephemeral clean virtual machines, and can be persistently compromised by untrusted code in a workflow.
Mit dem Docker-Socket wird es schlimmer. Die Sicherheitsseite von Docker schreibt „only trusted users should be allowed to control your Docker daemon“, weil ein Container das Wurzelverzeichnis des Hosts mounten kann (Docker Docs, Stand 24.10.2026). Ein Workflow-Schritt, der den Socket erreicht, kann so einen Container starten und root auf der Maschine werden.
Deshalb haben wir am 28.09.2026 den Host-Socket von den Runnern getrennt. Jobs, die Service-Container brauchten, scheiterten danach bei Initialize containers. Der ehrliche Teil: Ihre CI war schon Wochen vorher rot, und niemand hatte es bemerkt. Nur die Fehlermeldung hat sich geändert.
Was läuft auf dem Runner und was nicht?
Nur CI und Agentenarbeit: der Validator, das KI-Code-Review, die KI-Verifikation und die Stufen unserer Agenten-Pipeline. Keine Produktion. Wie die Verifikation einen Pull Request beurteilt, steht in LLM as a Judge.
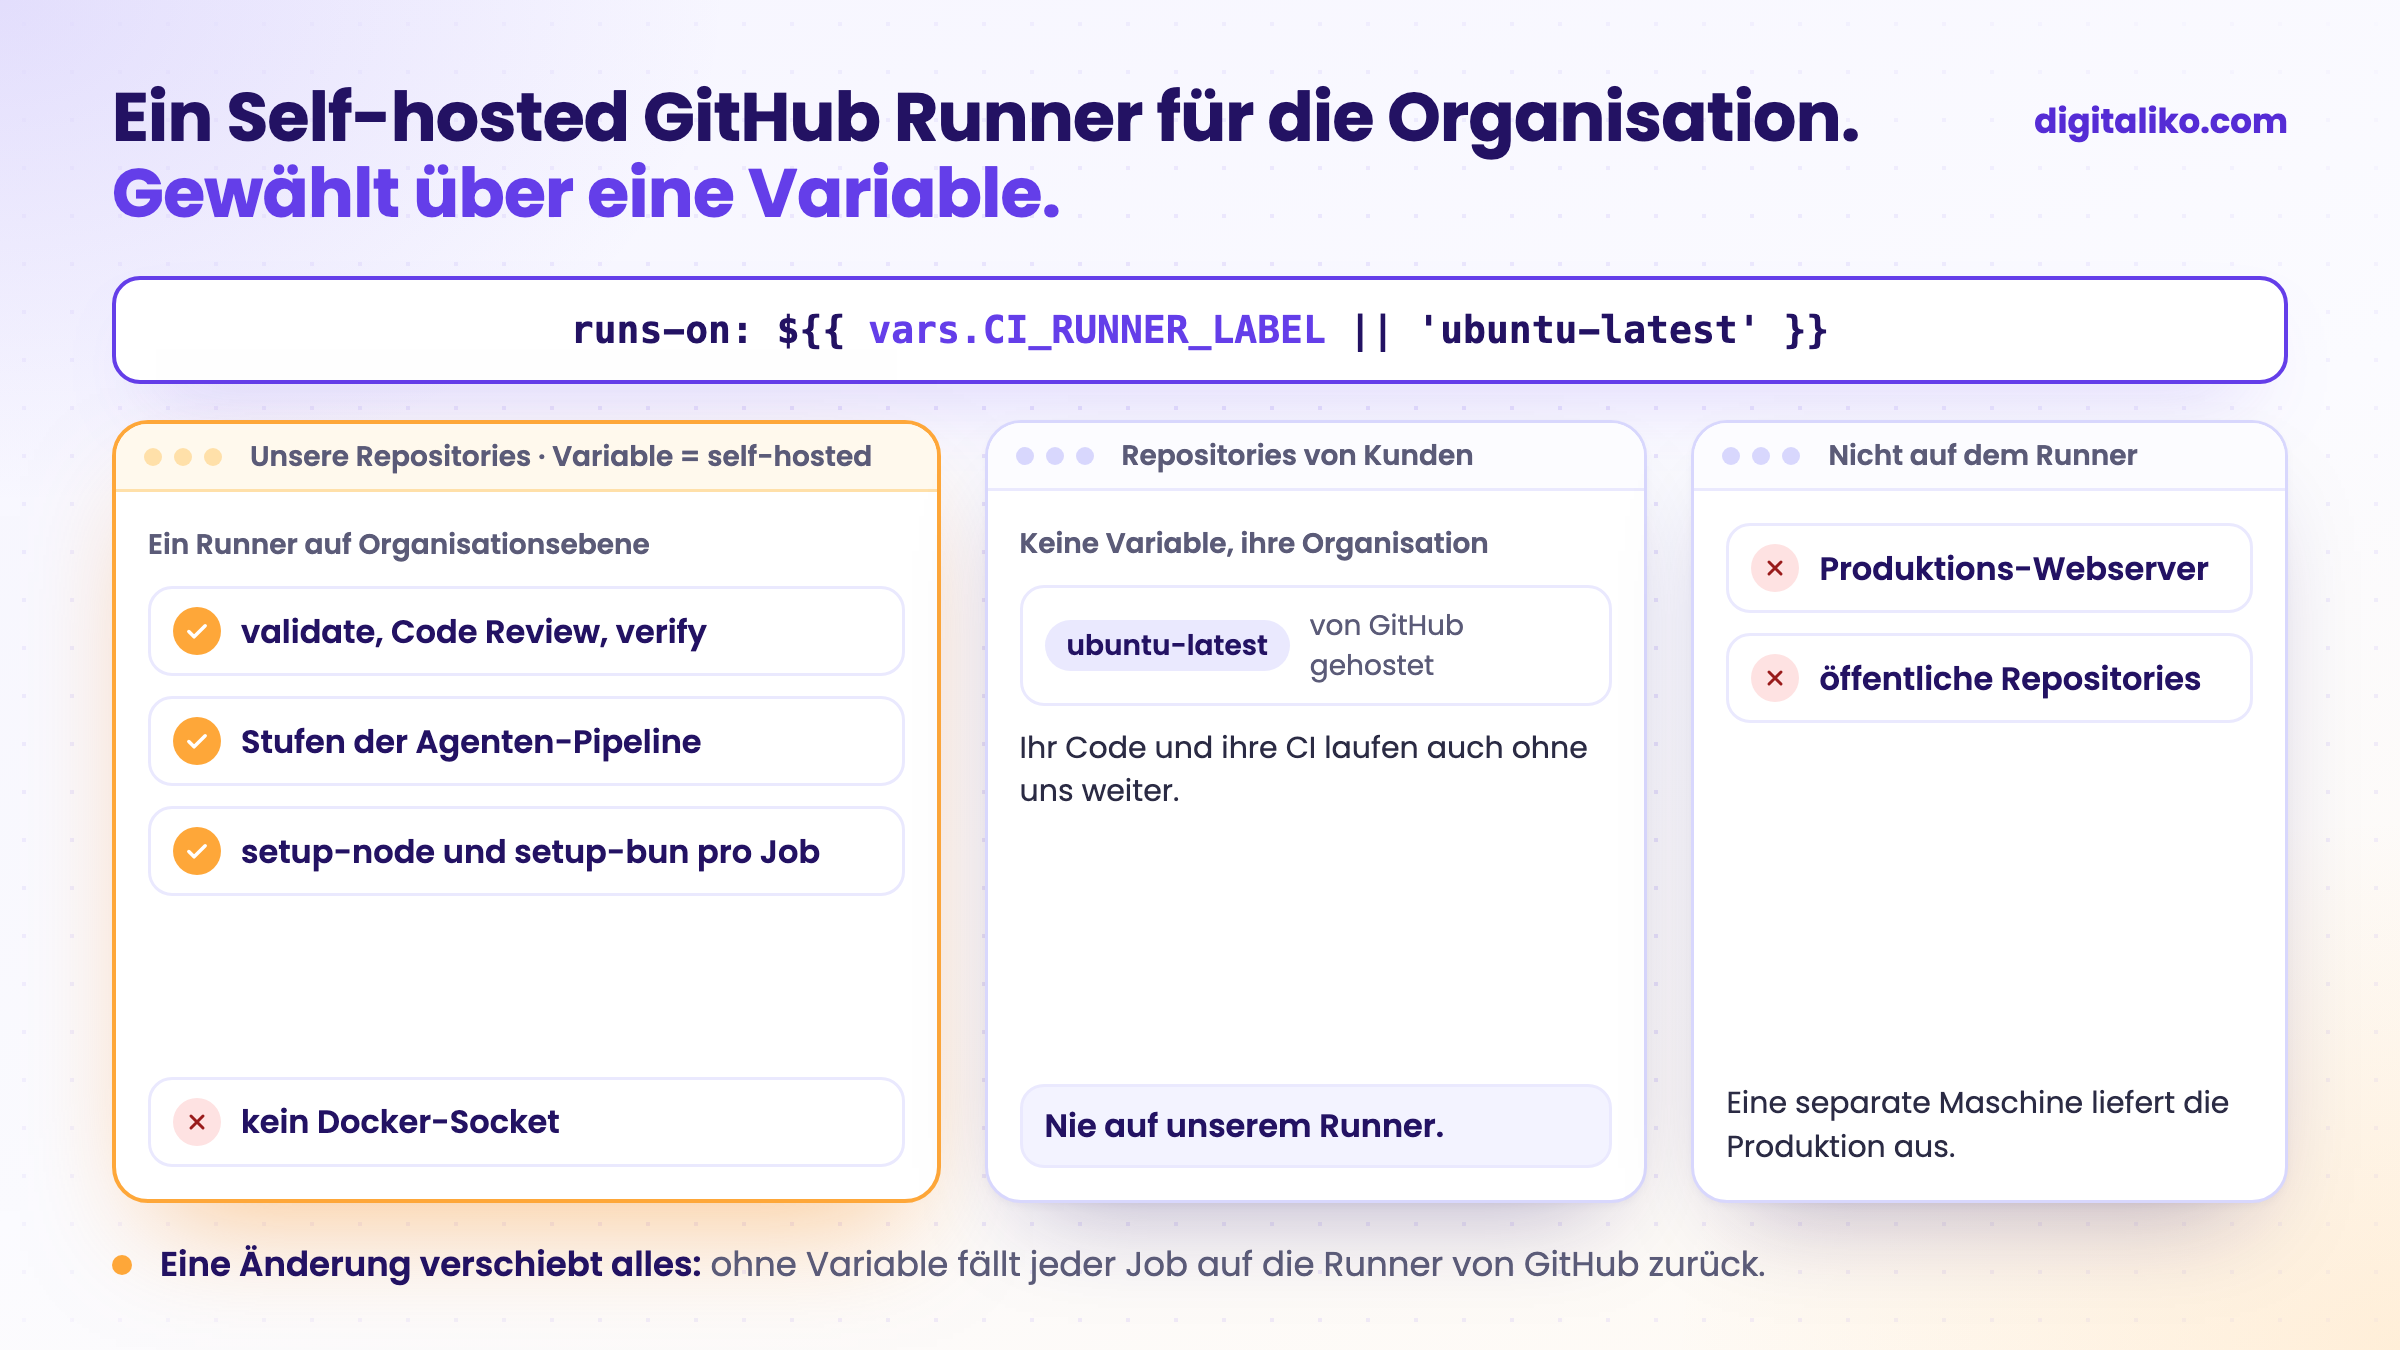
Die Produktions-Webserver sind eine separate Maschine. Bei einem Kundenprojekt liefen Builds früher neben der Produktion, und nachdem sie umgezogen waren, konnte die Produktion verkleinert werden. CI wieder daneben zu stellen, würde den Kampf um Ressourcen zurückbringen, den dieser Umzug gelöst hat.
Der Runner selbst bleibt nackt. Unsere verify-Action beginnt so, weil der Reviewer Node braucht und die Skripte des Repositories ihren Paketmanager:
steps:
  # the self-hosted runner is bare: the reviewer needs node, the repo scripts need their package manager
  - uses: actions/setup-node@v4
    with:
      node-version: 22
  - uses: oven-sh/setup-bun@v2
  - shell: bash
    run: corepack enable
Jeder Job erklärt, was er braucht. Ein Job, der auf unserem Runner läuft, läuft auch auf ubuntu-latest. Genau das macht den Fallback sicher.
Warum bleiben Repositories von Kunden auf gehosteten Runnern?
Manche Repositories gehören unseren Kunden und liegen in deren eigener GitHub-Organisation. Ihre Workflows behalten runs-on: ubuntu-latest. Drei Gründe:
- Es ist ihr Code und ihre CI. Ein Kunde, dem das Repository gehört, soll nicht von einer Maschine abhängen, die wir betreiben. Endet die Zusammenarbeit, läuft seine CI ohne eine einzige Änderung weiter.
- Unser Runner lebt in unserer Organisation. Ein Organisations-Runner bedient die Repositories dieser Organisation. Über Organisationen hinweg zu greifen, hieße eine zweite Registrierung und eine zweite Vertrauensgrenze.
- Weniger zu erklären. Niemand muss fragen, worauf und wo sein Code läuft.
Die Regel steht in unserer Validierungsdokumentation. Repositories in unserer Organisation folgen der Org-Variable. Service-Repositories von Kunden bleiben auf ubuntu-latest.
Passt ein Self-hosted Runner zu Ihrer Organisation?
Gehen Sie durch, was Sie heute haben:
Der letzte Punkt ist die Grenze, die zuerst schmerzt. Ein Runner-Prozess übernimmt einen Job nach dem anderen, alles andere wartet. Kurze Jobs verbergen das. Lange Agenten-Jobs nicht. Mehr Runner-Prozesse auf derselben Maschine sind die günstigere Lösung, vor einer größeren Maschine.
Was auf unserem Runner läuft, das KI-Review jedes Pull Requests, steht in KI-Code-Review mit Claude Code in CI. Wie weit wir einen Agenten auf seiner eigenen Maschine gehen lassen, steht in Claude Code Permissions: wann ist Skip Permissions sicher?
Brauchen Sie CI, auf die sich ein ganzes Team und seine Agenten verlassen?
Runner, geteilte CI-Actions und das Review darum richten wir für Entwicklerteams im Rahmen von ein Senior-Entwickler für Ihr Team ein. Die Agentenseite deckt AI-native SDLC für Entwicklerteams ab. KI schreibt heute unseren gesamten Code, und ein Senior steht für das Ergebnis ein. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Wenn Ihr Runner heute Nacht ausfällt, wie viele Workflow-Dateien müssten Sie morgen ändern?
Kurz gesagt
- Ein Runner auf Organisationsebene bedient alle Repositories der Organisation.
- runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }} wählt ihn, und eine Variable schickt alles zurück auf gehostete Runner.
- Kein Docker-Socket: Wer den Daemon steuert, ist root auf der Maschine.
- Repositories von Kunden und die Produktion bleiben vom Runner fern.
Häufige Fragen
Was ist ein GitHub Actions Self-hosted Runner?
Eine Maschine, die Sie selbst verwalten, auf der die Runner-Anwendung von GitHub Actions läuft und Jobs aus Ihren Workflows übernimmt. Das kann ein Cloud-Server, eine VM oder ein Rechner im Büro sein. Im Workflow wählen Sie ihn mit runs-on und seinen Labels.
Kann ein Self-hosted Runner alle Repositories einer Organisation bedienen?
Ja. Ein auf Organisationsebene registrierter Runner verarbeitet Jobs für mehrere Repositories dieser Organisation. Mit Runner Groups legen Sie fest, welche Repositories ihn nutzen dürfen.
Ist ein Self-hosted Runner für öffentliche Repositories sicher?
GitHub schreibt, dass Self-hosted Runner fast nie für öffentliche Repositories genutzt werden sollten, weil jeder einen Pull Request öffnen und Code auf der Maschine ausführen kann. Auch bei privaten Repositories kann dort jeder Code ausführen, der einen Pull Request öffnen darf.
Wie wechsle ich zwischen Self-hosted und gehostetem GitHub-Runner?
Mit einem Ausdruck in runs-on: runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }}. Ist die Variable gesetzt, gehen die Jobs an Ihren Runner. Fehlt sie, fallen sie auf das gehostete Ubuntu von GitHub zurück. Eine Änderung der Org-Variable verschiebt alle Repositories.
Warum den Docker-Socket nicht in den Runner mounten?
Wer mit dem Docker-Daemon sprechen kann, startet einen Container mit dem gemounteten Dateisystem des Hosts und wird root auf der Maschine. Auf einem CI-Runner ist das jeder, der einen Pull Request öffnet. Braucht ein Job Container, geben Sie ihm einen eigenen Daemon.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity