Self-hosted runner de GitHub Actions para toda la organización
Para CTO y desarrolladoresDecisiones de CTO

Filip PapranecFundador de Digitaliko
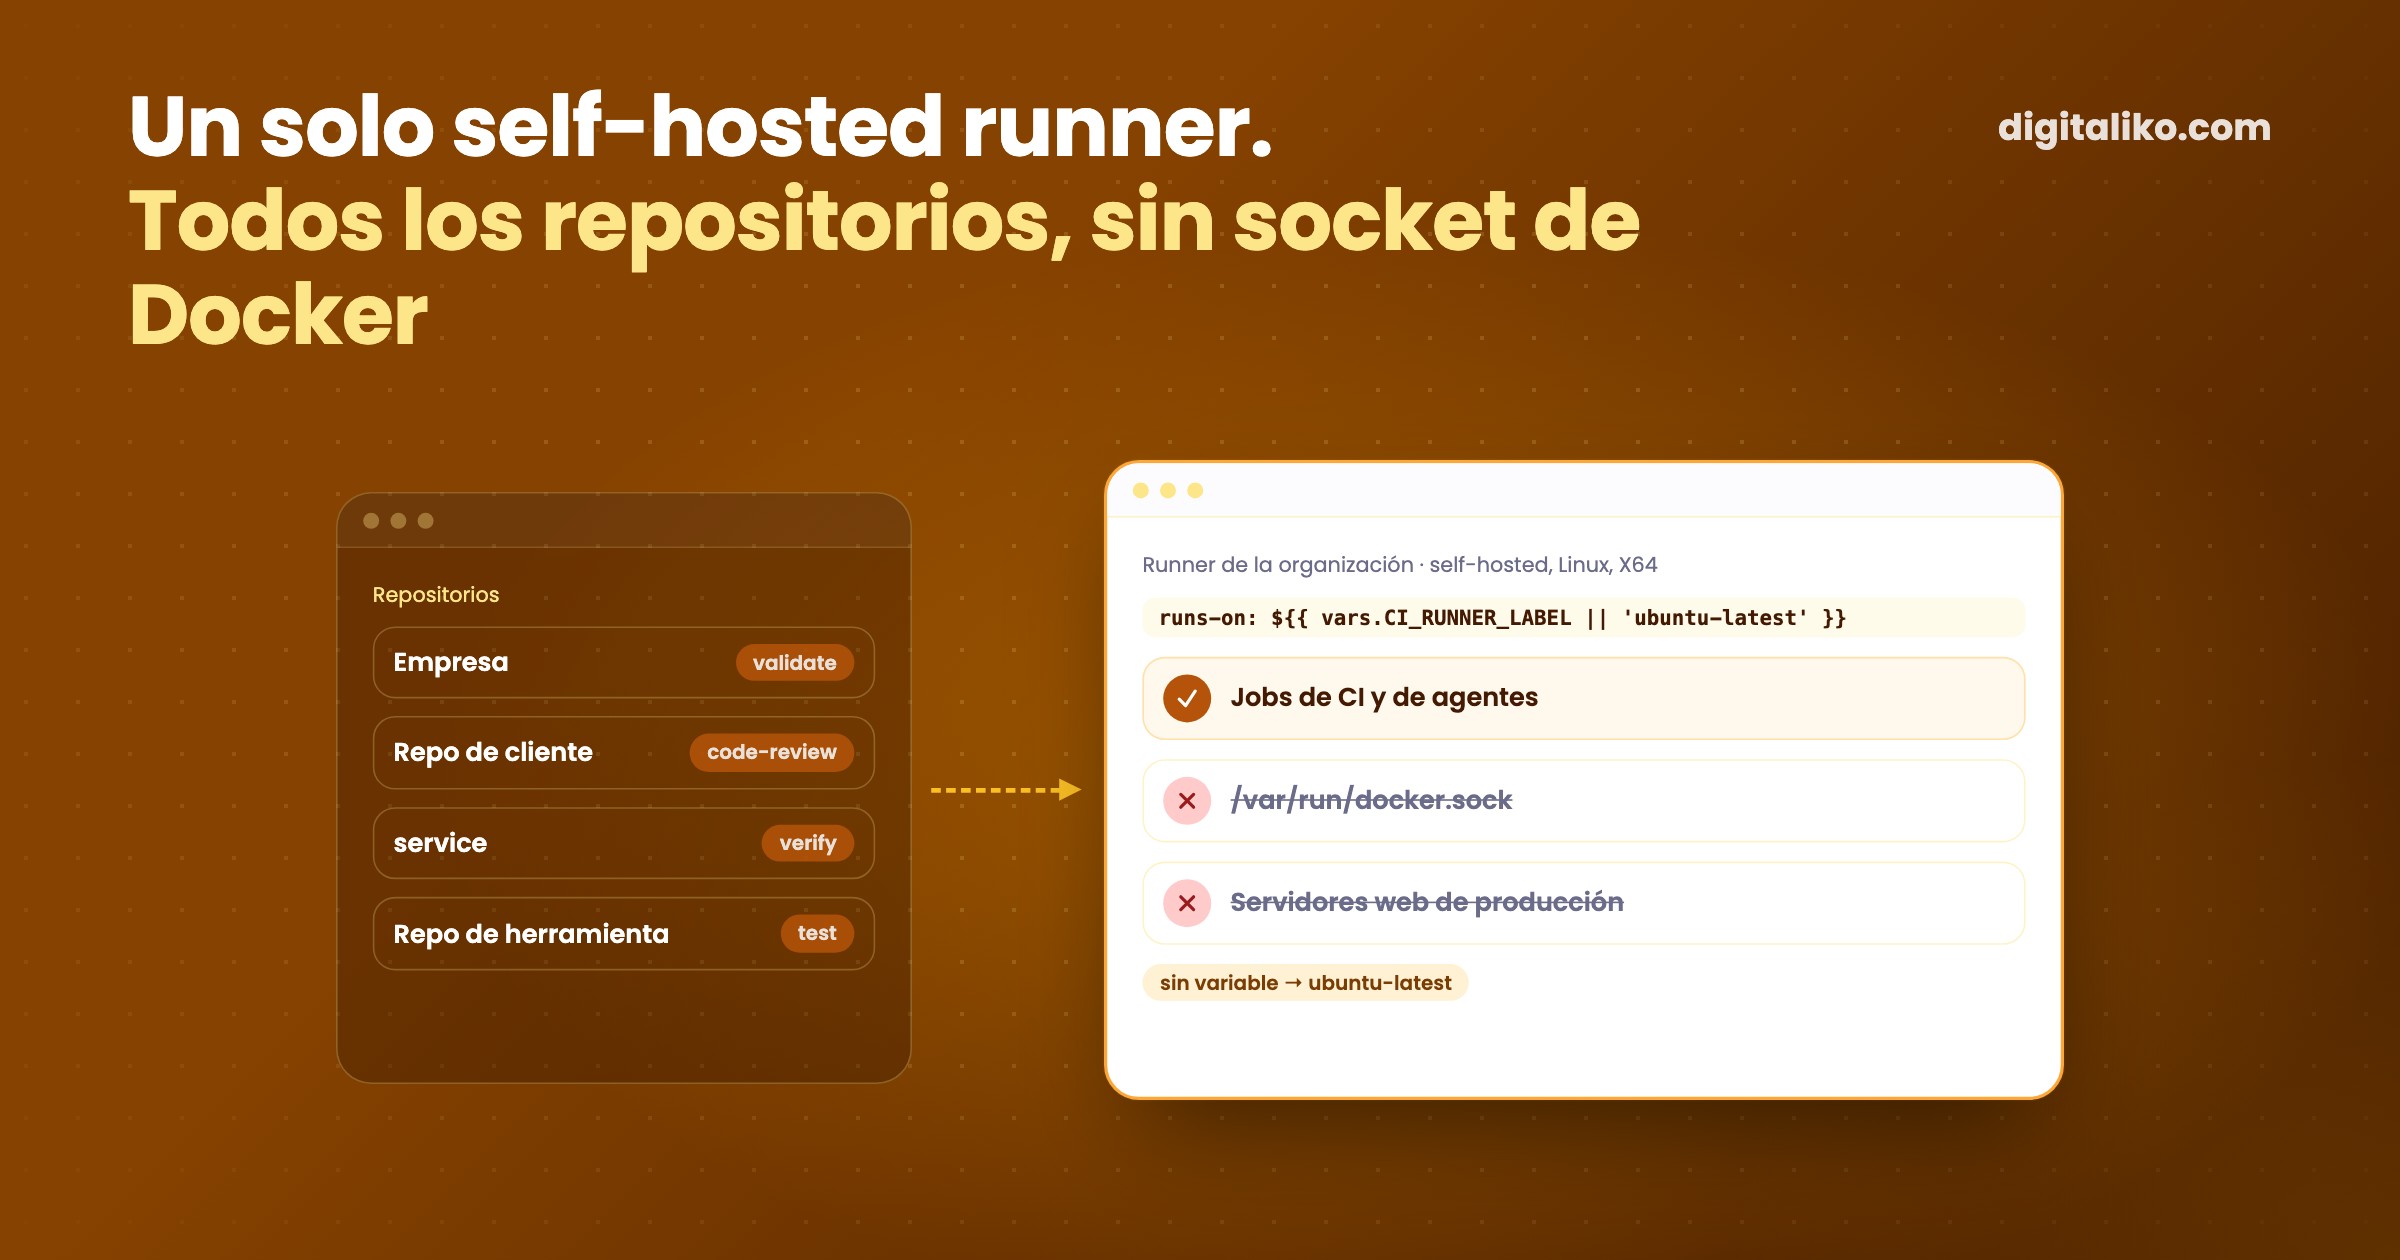
Un self-hosted runner de GitHub Actions es una máquina que usted gestiona y que recoge los jobs de sus workflows. Un repositorio puede elegirlo con una variable de organización y, sin ella, vuelve a los runners alojados por GitHub.
Recomendamos tres decisiones. Registre el runner a nivel de organización, no en un solo repositorio. No le dé acceso al socket de Docker. Y deje fuera los repositorios de otra organización, por ejemplo los que pertenecen a un cliente.
¿Qué es un self-hosted runner y cuándo merece la pena?
Los runners alojados por GitHub son máquinas virtuales nuevas que GitHub arranca para cada job. Un self-hosted runner es su propia máquina con la aplicación runner de GitHub. Usted la instala, la mantiene actualizada y decide a qué puede acceder.
| Runner alojado por GitHub | Self-hosted runner | |
|---|---|---|
| Máquina | Una VM nueva por job, gestionada por GitHub | Su servidor, VM u ordenador |
| Estado limpio | Cada job empieza limpio | No garantizado, archivos y procesos pueden quedarse |
| Software | La imagen de GitHub | Lo que usted instale |
| Red | Internet público | Puede llegar a su red privada |
| Quién lo mantiene | GitHub | Usted: actualizaciones, disco, seguridad |
| Facturación | Minutos de Actions de su plan | Su propia máquina |
Un self-hosted runner compensa cuando los jobs se ejecutan a menudo, cuando necesitan algo que la imagen alojada no tiene o cuando los jobs largos de agentes consumirían los minutos alojados. Un caso típico es una CI que ejecuta un validador, una code review con IA y un paso de verificación con IA en la mayoría de los pull requests.
¿Cómo se elige el runner para cada repositorio?
No nombre el runner en ningún workflow. Cada plantilla de workflow tiene la misma línea:
jobs:
  validate:
    runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }}
    steps:
      - uses: actions/checkout@v4
      - run: npm ci && npm test
CI_RUNNER_LABEL es una variable de organización con el valor self-hosted, visible para los repositorios que pueden usar el runner. Si está definida, el job va a su runner. Si falta, la expresión vuelve a ubuntu-latest.
Esa vuelta atrás es la clave. Si la máquina cae, un solo cambio en la variable devuelve todos los repositorios a los runners alojados. Nadie toca ni un archivo de workflow.
La configuración tiene cuatro pasos:
01
Registrar a nivel de organización
Añada el runner en la configuración de la organización, no en un repositorio, para que cualquier repositorio de la organización pueda enviarle jobs.
02
Definir la variable de organización
CI_RUNNER_LABEL = self-hosted, visible para todos los repositorios.
03
Una sola línea runs-on en todas partes
Cada plantilla de workflow usa la expresión con la vuelta a ubuntu-latest. Las plantillas son el único lugar donde está escrita.
04
Mantener el runner desnudo
Las actions compartidas instalan Node y Bun por sí mismas con setup-node y setup-bun, así que la máquina apenas necesita nada preinstalado.
GitHub documenta directamente la opción de organización: runners añadidos "at the organization level, where they can be used to process jobs for multiple repositories in an organization" (documentación de GitHub, a 24/10/2026).
¿Por qué no darle al runner el socket de Docker?
Porque un runner de CI ejecuta código de pull requests. GitHub es claro sobre lo que eso significa:
Self-hosted runners for GitHub do not have guarantees around running in ephemeral clean virtual machines, and can be persistently compromised by untrusted code in a workflow.
Con el socket de Docker, la cosa empeora. La propia página de seguridad de Docker dice "only trusted users should be allowed to control your Docker daemon", porque un contenedor puede montar el directorio raíz del host (documentación de Docker, a 24/10/2026). Un paso del workflow que llegue al socket puede arrancar ese contenedor y convertirse en root de la máquina.
Así que no monte el socket del host en el runner. Los jobs que necesitan contenedores de servicio fallarán entonces en Initialize containers. No pasa nada: el fallo es visible y un daemon propio lo resuelve.
¿Qué va en el runner y qué no?
Solo trabajo de CI y de agentes, como un validador, una code review con IA y un paso de verificación con IA. Nada de producción. Cómo juzga el paso de verificación un pull request se explica en LLM as a judge.
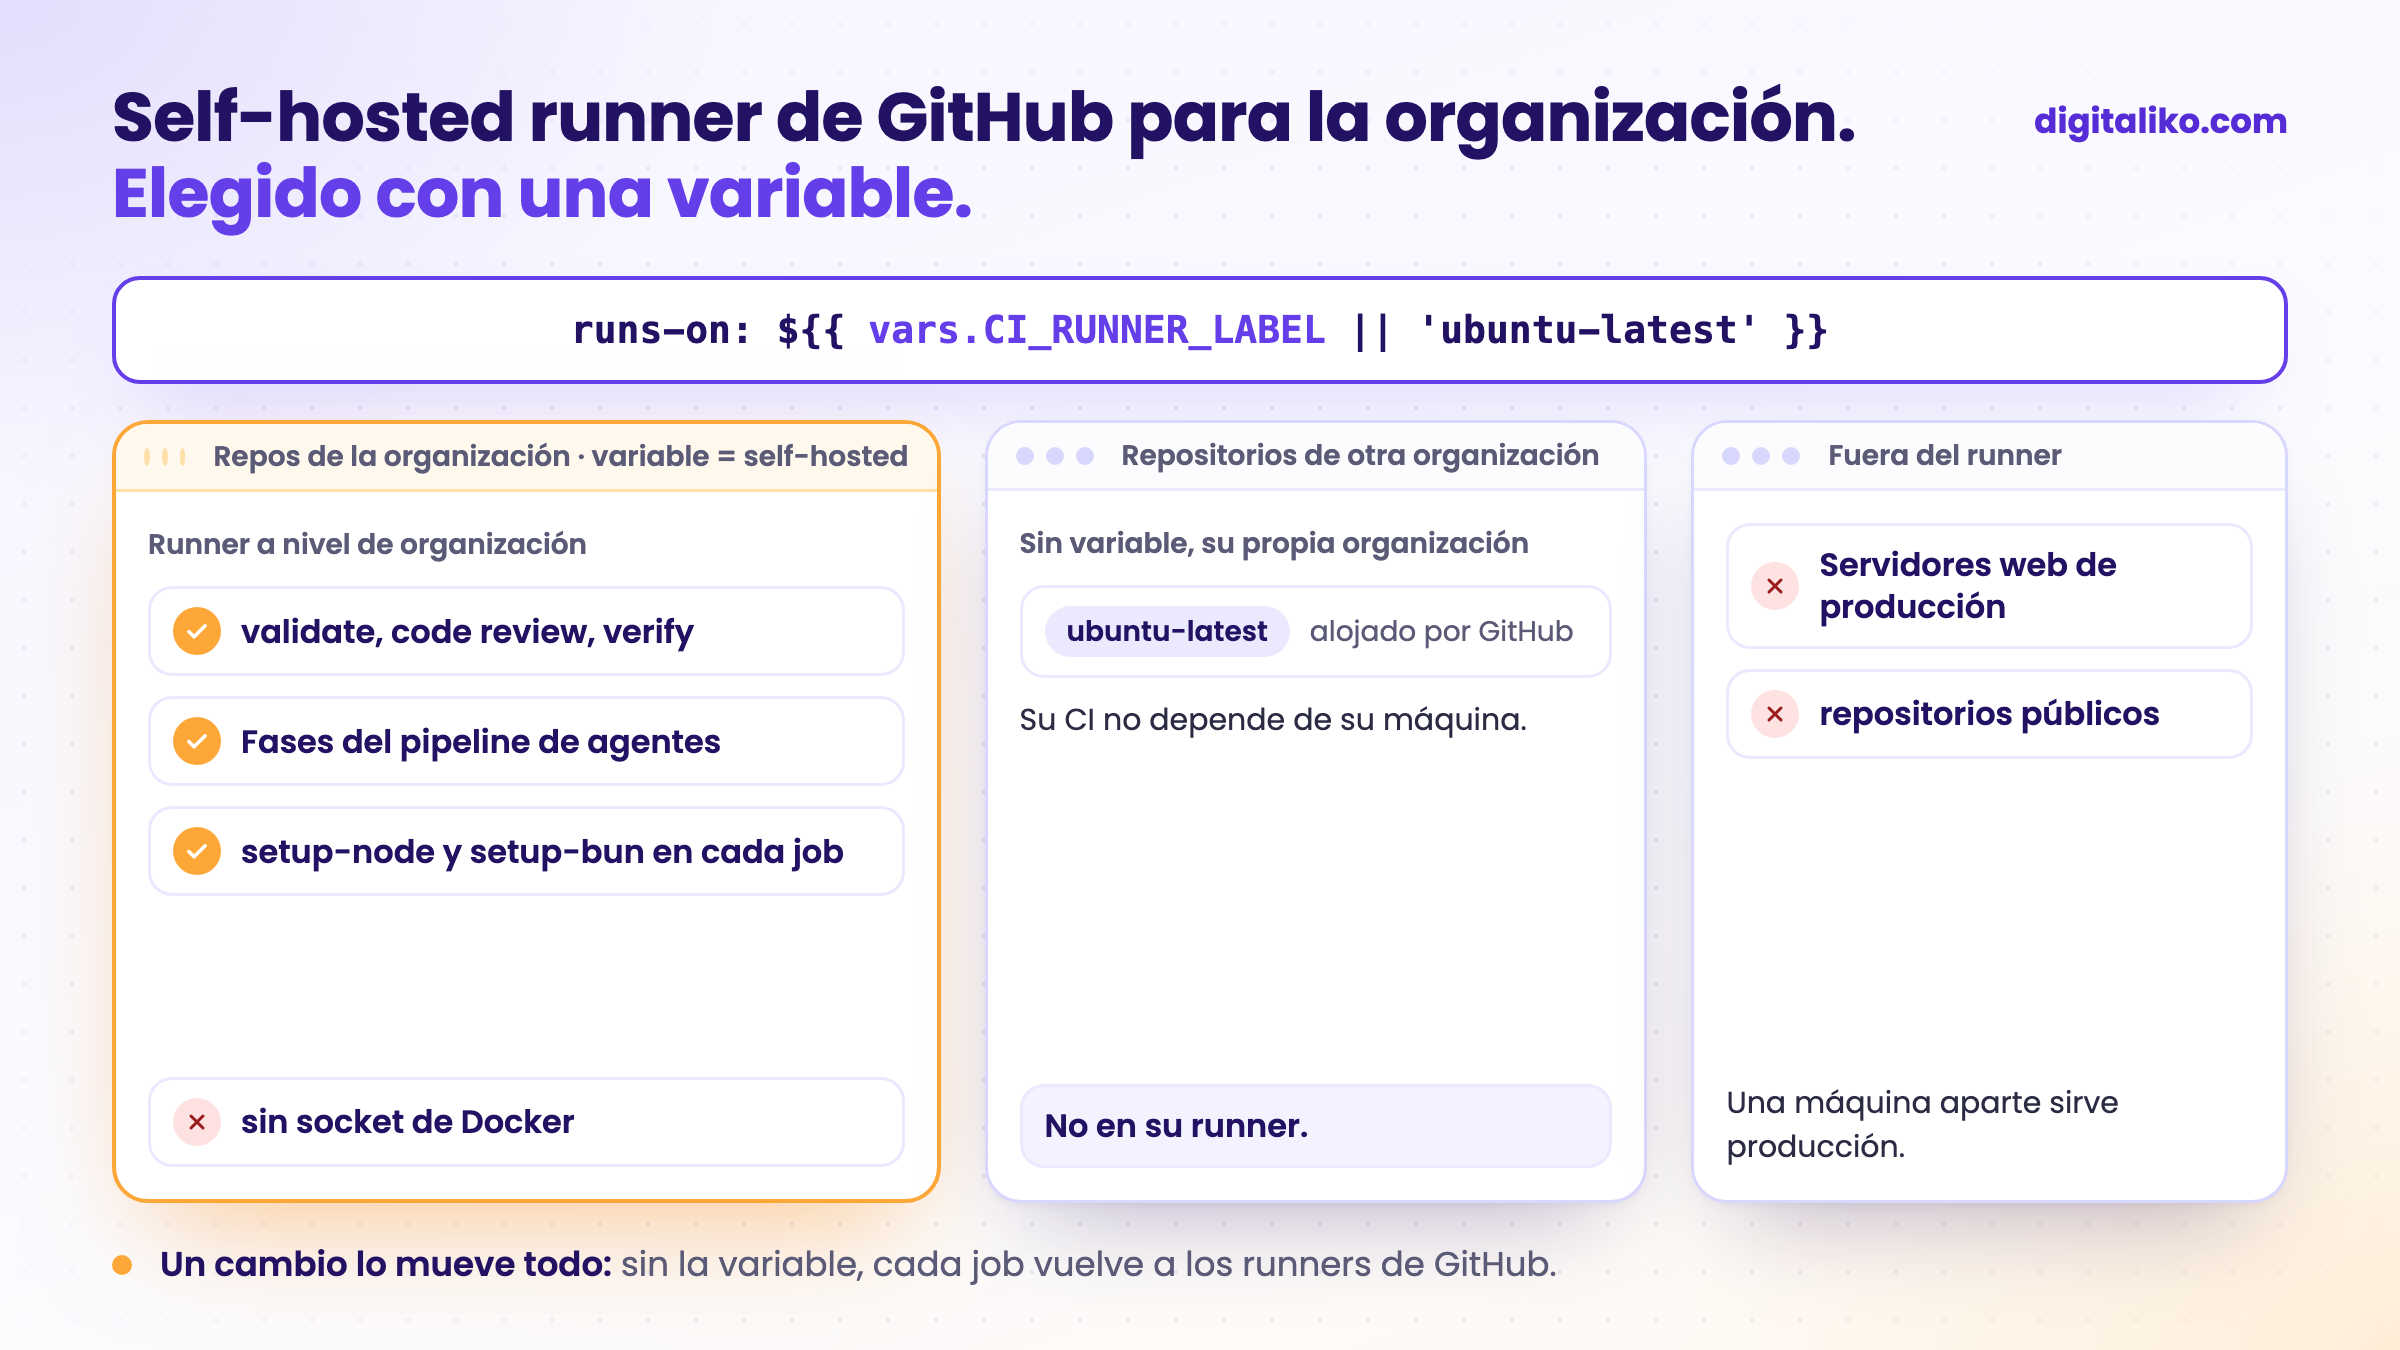
Mantenga los servidores web de producción en una máquina aparte. Las builds junto a producción competirían con ella por los recursos.
Mantenga el propio runner desnudo. Una action de verify puede empezar así, porque el revisor necesita Node y los scripts del repositorio necesitan su gestor de paquetes:
steps:
  # the self-hosted runner is bare: the reviewer needs node, the repo scripts need their package manager
  - uses: actions/setup-node@v4
    with:
      node-version: 22
  - uses: oven-sh/setup-bun@v2
  - shell: bash
    run: corepack enable
Cada job declara lo que necesita. Un job que funciona en su propio runner también funciona en ubuntu-latest, y eso es lo que hace segura la vuelta atrás.
¿Por qué dejar los repositorios de otra organización en runners alojados?
Si también trabaja en repositorios que pertenecen a un cliente, en la organización de GitHub del propio cliente, deje sus workflows en runs-on: ubuntu-latest. Tres motivos:
- Es su código y su CI. Un cliente propietario del repositorio no debería depender de una máquina que gestiona un proveedor. Si la colaboración termina, su CI sigue funcionando sin un solo cambio.
- Un runner de organización pertenece a su organización. Atiende a los repositorios de esa organización. Cruzar organizaciones implica un segundo registro y una segunda frontera de confianza.
- Menos que explicar. Nadie tiene que preguntar qué ejecuta su código, ni dónde.
Escriba la regla en su documentación de CI. Los repositorios de su organización siguen la variable de organización, los repositorios de clientes se quedan en ubuntu-latest.
¿Le conviene un self-hosted runner a su organización?
Revise lo que tiene hoy:
El último punto es el límite que duele primero. Un proceso runner toma un job cada vez y todo lo demás espera. Los jobs cortos lo ocultan. Los jobs largos de agentes no. Más procesos runner en la misma máquina son la solución más barata, antes que una máquina más grande.
La review con IA de cada pull request está en Claude Code review: code review con IA en CI. Hasta dónde dejar que un agente actúe solo en su propia máquina está en Claude Code dangerously skip permissions.
¿Necesita una CI en la que puedan confiar todo un equipo y sus agentes?
Configuramos runners, actions de CI compartidas y la review que las rodea para equipos de desarrollo, como parte de un desarrollador senior para su equipo. La parte de agentes la cubre AI-native SDLC para equipos de desarrollo. La IA escribe la mayor parte de nuestro código. Un senior revisa cada cambio y responde de la producción. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en dos días hábiles con unas pocas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar antes, reserve una llamada introductoria de 15 minutos.
Si su runner cayera esta noche, ¿cuántos archivos de workflow tendría que editar mañana?
En resumen
- Un runner registrado a nivel de organización puede atender muchos repositorios, los runner groups deciden cuáles.
- runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }} lo elige, y una variable devuelve todo a los runners alojados.
- Sin socket de Docker: quien controla el daemon es root en la máquina.
- Los repositorios de clientes y la producción se quedan fuera del runner.
Preguntas frecuentes
¿Qué es un self-hosted runner de GitHub Actions?
Una máquina que usted gestiona, en la que se ejecuta la aplicación runner de GitHub Actions y que recoge los jobs de sus workflows. Puede ser un servidor en la nube, una VM o un ordenador de su oficina. En el workflow lo elige con runs-on y sus etiquetas.
¿Puede un self-hosted runner atender todos los repositorios de una organización?
Sí. Un runner registrado a nivel de organización puede procesar jobs de varios repositorios de esa organización. Con los runner groups usted limita qué repositorios pueden usarlo.
¿Es seguro un self-hosted runner para repositorios públicos?
GitHub indica que los self-hosted runners casi nunca deberían usarse en repositorios públicos, porque cualquiera puede abrir un pull request y ejecutar código en la máquina. Incluso en repositorios privados, cualquiera que pueda abrir un pull request puede ejecutar código allí.
¿Cómo se cambia entre un self-hosted runner y un runner alojado por GitHub?
Con una expresión en runs-on: runs-on: ${{ vars.CI_RUNNER_LABEL || 'ubuntu-latest' }}. Con la variable definida, los jobs van a su runner. Sin ella, vuelven al Ubuntu alojado por GitHub. Un solo cambio en la variable de la organización mueve todos los repositorios.
¿Por qué no montar el socket de Docker en el runner?
Quien puede hablar con el daemon de Docker puede arrancar un contenedor con el sistema de archivos del host montado y convertirse en root de la máquina. En un runner de CI, eso es cualquiera que pueda abrir un pull request. Si un job necesita contenedores, dele su propio daemon.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

