Subagenci i worktree w Claude Code: kiedy którego używać
Dla CTO i programistówAI w zespole deweloperskim

Filip PapranecZałożyciel Digitaliko
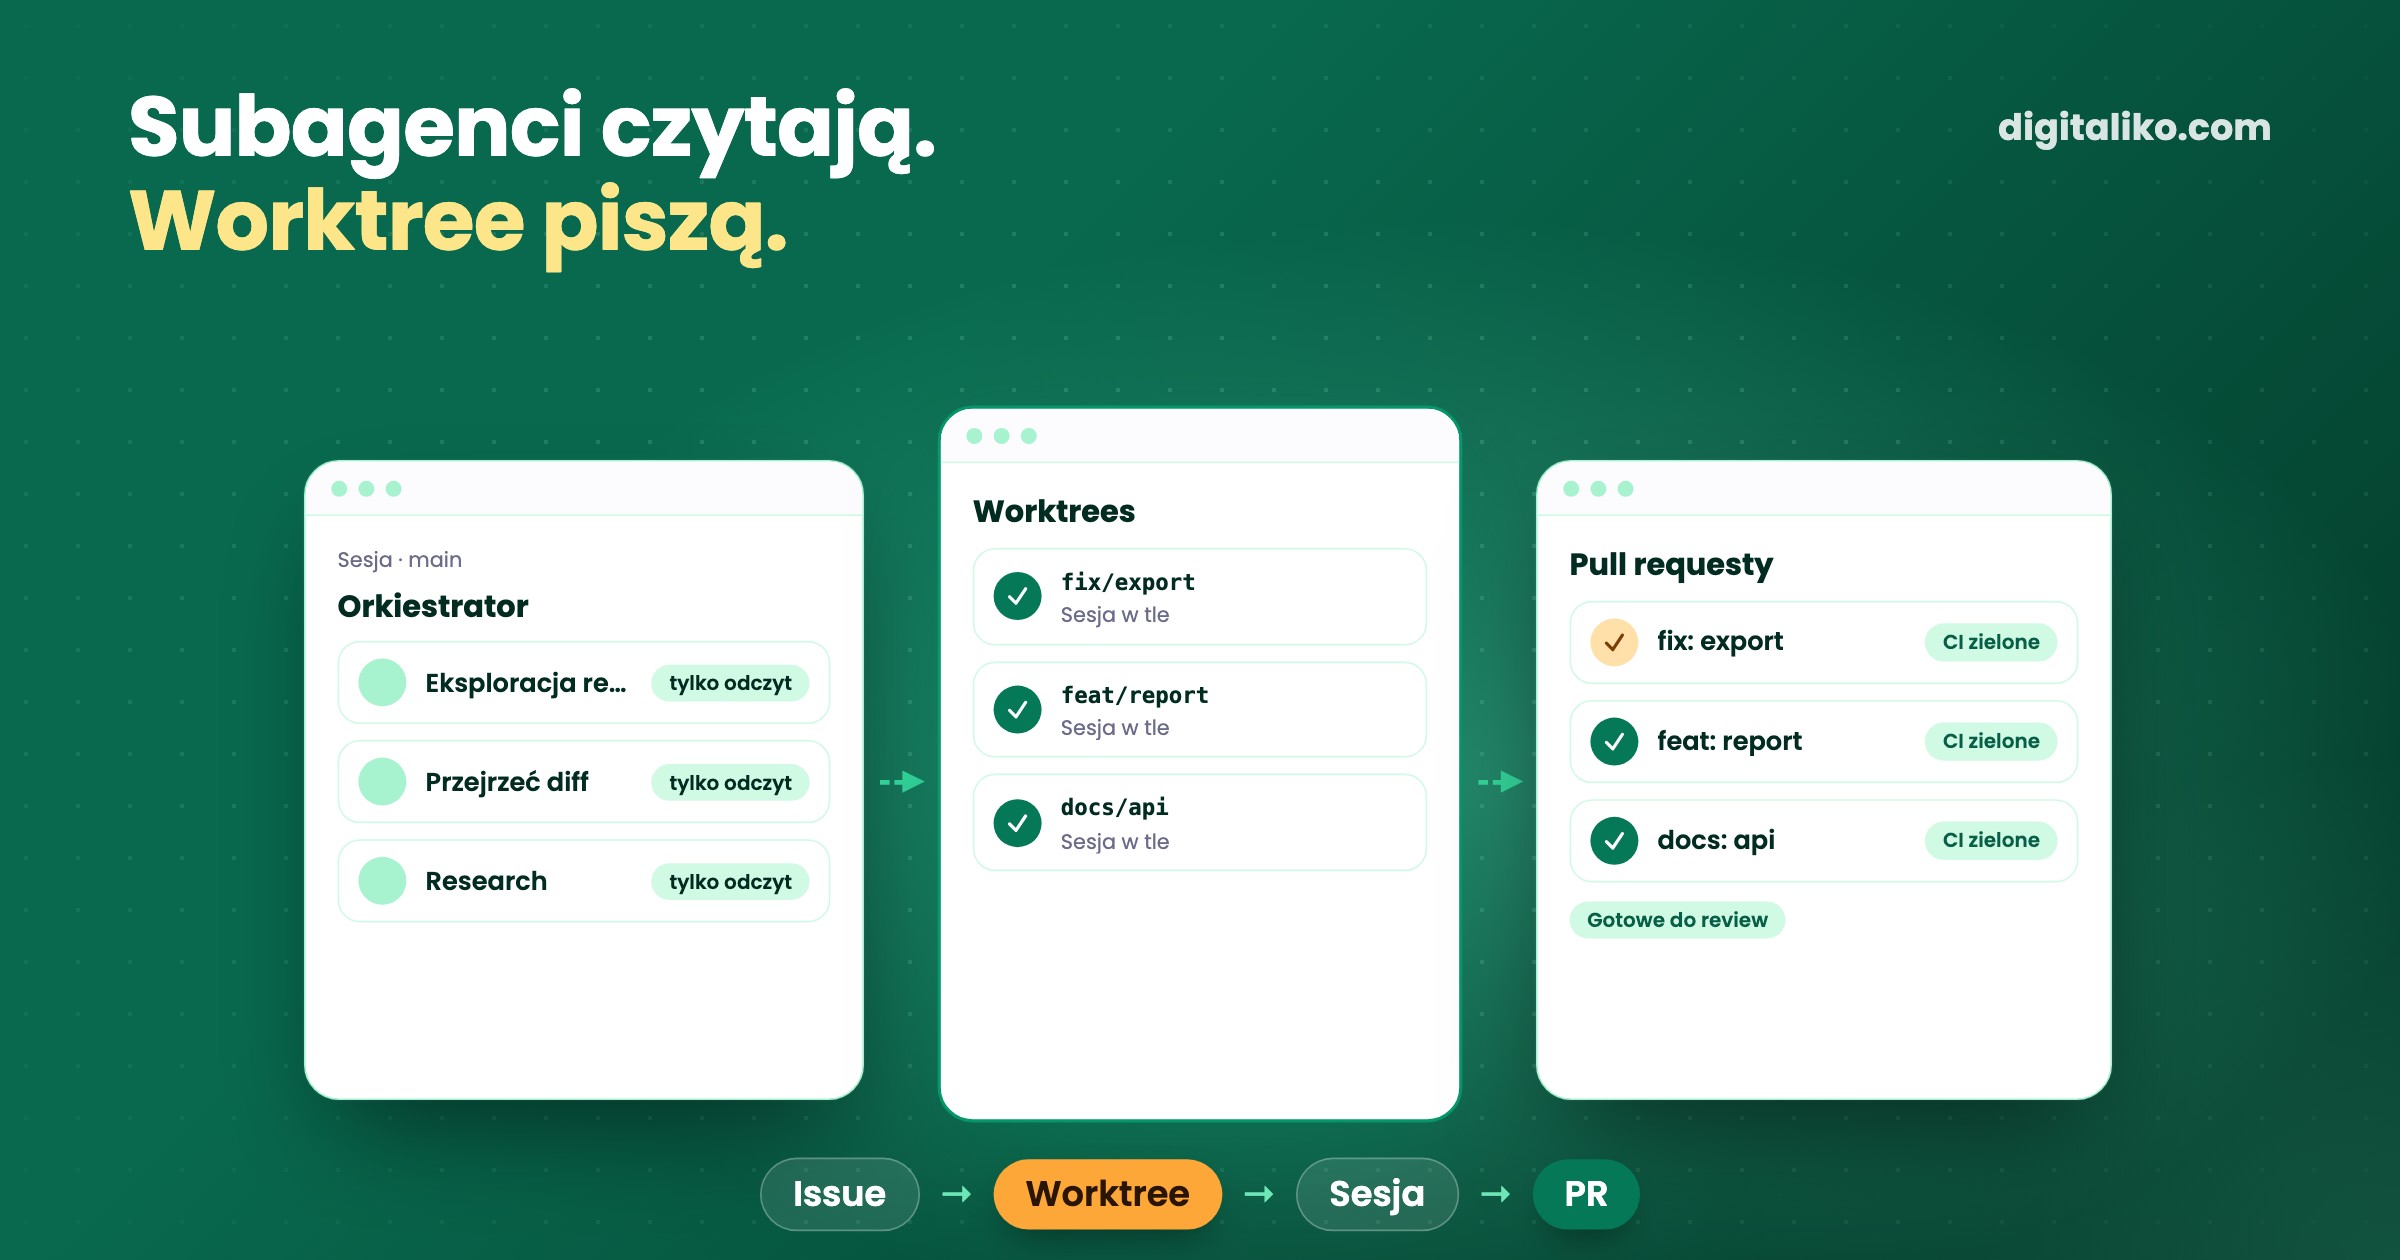
Subagenci Claude Code dzielą pracę w ramach jednej sesji. Każdy działa we własnym oknie kontekstu, wykonuje jedno zadanie i zwraca podsumowanie. Worktree izolują zmiany w plikach: każda sesja dostaje własną kopię repozytorium i własną gałąź. Nasza zasada z codziennej pracy z równoległymi agentami: subagenci tylko czytają, a każda zmiana dostaje własny worktree, własną sesję i własny pull request.
U nas większość kodu pisze AI. Każdą zmianę sprawdza senior i odpowiada za to, co trafia na produkcję. Równoległe agenty to sposób, żeby kilka zadań szło naraz i nie wchodziło sobie w drogę. Poniżej: kiedy używamy czego, polecenie, które to obsługuje, i co się po drodze psuło.
Czym są subagenci Claude Code?
Subagent to pomocnik, którego Claude uruchamia w Państwa sesji. Dokumentacja Claude Code ujmuje to jednym zdaniem: „Each subagent runs in its own context window with a custom system prompt, specific tool access, and independent permissions.” Każdy subagent ma więc własne okno kontekstu, własny prompt systemowy, własne narzędzia i uprawnienia.
Na tym polega cała idea. Subagent czyta stos plików, a główna rozmowa dostaje z powrotem jeden akapit. Własnych subagentów można zdefiniować w .claude/agents/ z nazwą, opisem, narzędziami i modelem. Claude wybiera jednego po opisie albo prosi go Państwo po nazwie.
Ceną jest ten sam akapit. Widzą Państwo to, co subagent raportuje, a nie to, co przeczytał. Jeśli coś przeoczył, podsumowanie tego nie powie.
Subagenci czy worktree: co do czego?
Rozwiązują różne problemy. Subagenci chronią kontekst. Worktree chronią pliki. Dokumentacja worktree opisuje worktree jako „a separate working directory with its own files and branch, sharing the same repository history and remote as your main checkout”, czyli osobny katalog roboczy z własnymi plikami i gałęzią, który dzieli historię i remote z główną kopią.
| Subagent | Sesja w worktree | |
|---|---|---|
| Izoluje | kontekst | pliki i gałąź |
| Żyje | w jednej sesji, dopóki nie zaraportuje | tyle, ile trwa zadanie, także w tle |
| Do czego | eksploracja, review, research, długie testy | zmiana, która kończy się PR |
| Zwraca | podsumowanie | gałąź, diff, pull request |
| Typowe ryzyko | pewne siebie podsumowanie po częściowej lekturze | przygotowanie: pliki env, zależności, stare gałęzie |
Dlaczego nasi subagenci tylko czytają?
Zapisaliśmy to w briefie, który dostaje każda sesja programistyczna:
Only you write code. Subagents only read (explore the repo, run a long test suite and return just the failures).Kod pisze tylko sesja główna. Subagenci tylko czytają: eksplorują repozytorium albo uruchamiają długi zestaw testów i zwracają tylko błędy. Przy pisaniu dokumentów i QA w przeglądarce granica jest jeszcze ostrzejsza: „Do it yourself, no subagents.” Research to odwrotność. Tam brief dopasowuje liczbę subagentów do zadania: jeden na pojedynczy fakt, kilku na porównanie, po jednym na pozycję przy szerokim przeglądzie. Każdy zapisuje wyniki do pliku i zwraca tylko ścieżkę.
Claude Code pozwala subagentom pisać. Wystarczy dodać subagentowi isolation: worktree, a dostanie własny tymczasowy worktree. Mimo to trzymamy jednego piszącego na zadanie. Recenzent śledzi jeden diff i jeden tok rozumowania. Kilku piszących przy jednym zadaniu daje kilka diffów, które ktoś musi połączyć w głowie.
Jak prowadzimy jedno issue w jednym worktree?
Jedno zadanie to jeden worktree, jedna gałąź, jedna sesja Claude Code i jeden pull request. Sesja orkiestrująca zostaje na main w głównej kopii i nigdy nie przełącza tam gałęzi. Każda zmiana zaczyna się jednym poleceniem wizrd, naszego wewnętrznego pluginu i CLI do Claude Code (niepublicznego):
wizrd task start <repo> "<brief>"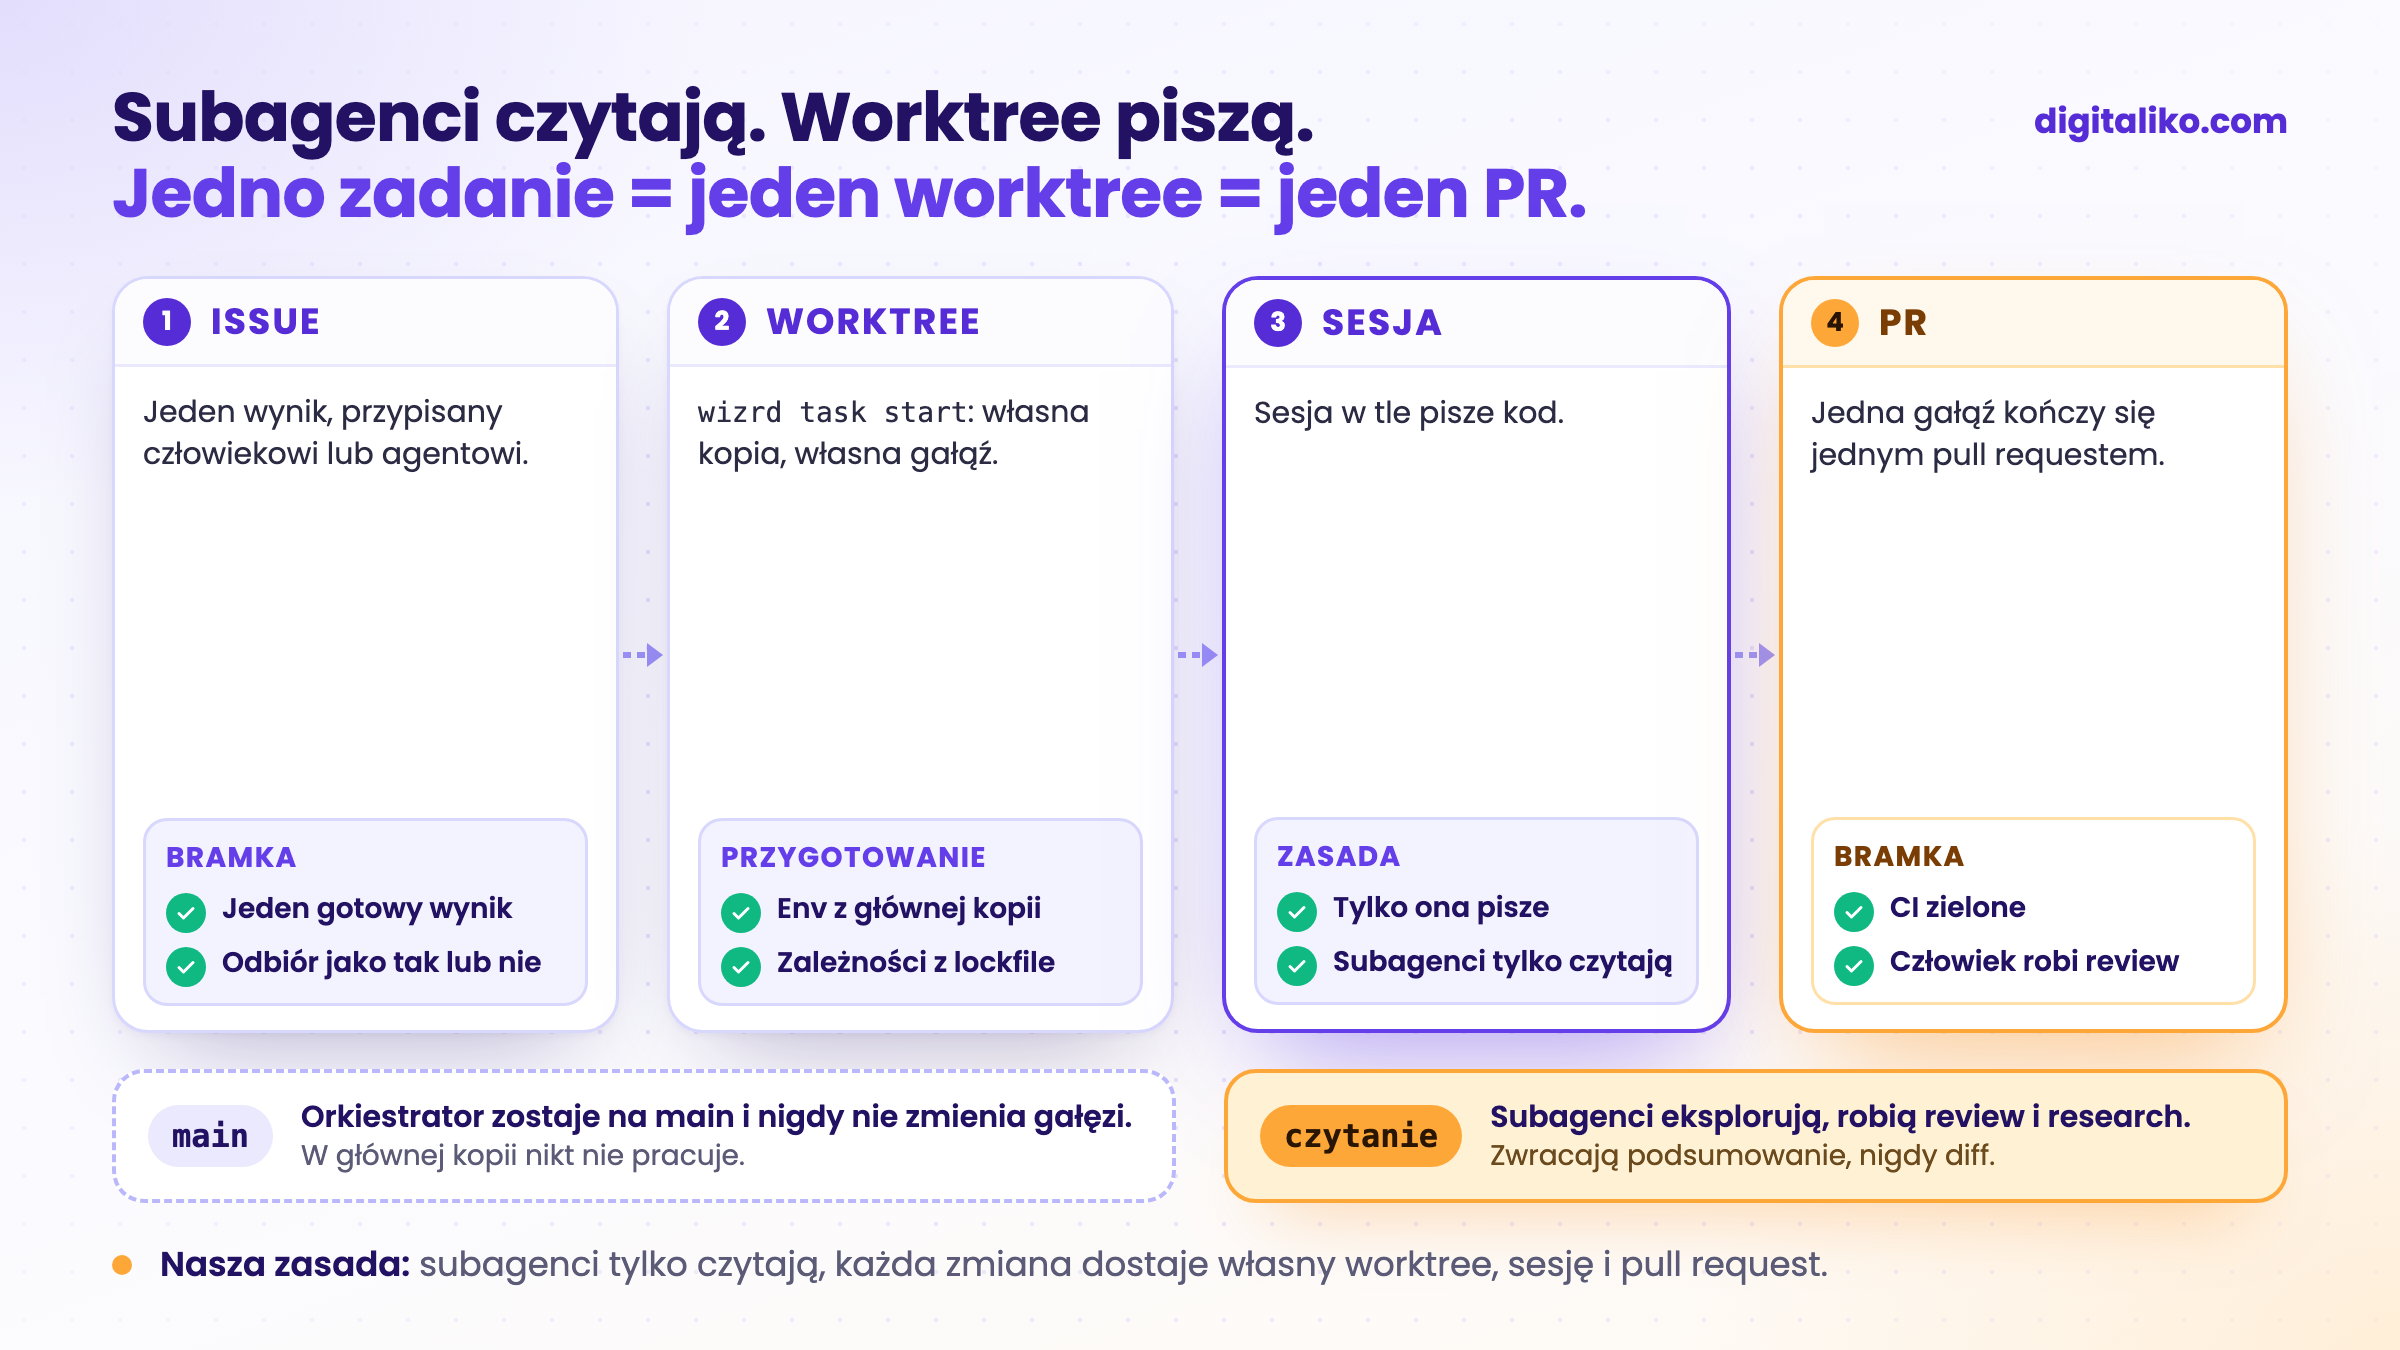
Co robi to polecenie:
- Worktree.
wizrd worktree newtworzy go w jednym katalogu trees na maszynę. Pliki env są linkowane z głównej kopii, a zależności instalują się z lockfile. - Kontekst. Usługa, która żyje w repozytorium klienta, dostaje worktree tego repozytorium z usługą zagnieżdżoną w ścieżce jej submodułu, żeby wczytały się wszystkie
CLAUDE.mdw górę łańcucha. Skille i agenci z repozytoriów nadrzędnych dochodzą przez--add-dir. - Sesja. W worktree startuje
claude --bgw tle. Śledzimy ją wclaude agentsi piszemy do niej między sesjami, gdy czegoś potrzebuje. - PR. Sesja robi commit, push i otwiera pull request ze swojej gałęzi. Po merge'u
wizrd worktree pruneusuwa worktree.
Issue, które oddajemy naszemu agentowi AI, przebiega tak samo, w pętli opisanej w Harness engineering w praktyce: od issue do PR. Ten sam kod worktree działa na laptopie człowieka i na maszynie agenta. Jak agent pisze plan przed rozpoczęciem pracy, opisujemy w Plan mode w Claude Code.
Kiedy subagenci marnują tokeny?
Każdy subagent zaczyna ze świeżym kontekstem. Nie widzi, co sesja główna już przeczytała, więc czyta to jeszcze raz. Kilku subagentów zapytanych o ten sam moduł czyta go każdy od zera.
Sygnały, na które uważamy:
- Zadanie jest małe. Jedno wyszukiwanie nie potrzebuje pomocnika. Podsumowanie kosztuje więcej niż odpowiedź.
- Zadania się pokrywają. „Jak działa logowanie” i „gdzie sprawdzana jest sesja” wysyłają dwóch subagentów do tych samych plików.
- Potrzebne są szczegóły. Review, które musi cytować dokładne linie, lepiej zrobić tam, gdzie te linie zostają w kontekście.
Rozwiązaniem jest zwykle mniej subagentów, a nie mądrzejsi subagenci.
Może powinniśmy coś raczej uprościć. Nie musimy ciągle dokładać.

Szczerze: nie mierzymy zużycia tokenów na subagenta. Śledzimy rundy i aktywny czas na zadanie, i tam marnotrawstwo wychodzi na jaw. Rozdzielenie pracy wyraźnie się nam opłaca przy szerokim researchu z niezależnymi pytaniami i przy pracy, która zalałaby wywołującego. Nasz skill do podsumowań spotkań działa w rozwidleniu (context: fork), więc długi transkrypt nigdy nie trafia do kontekstu wywołującego.
Co się psuło z worktree?
Izolacja to łatwa część. Psuje się przygotowanie. Te przypadki warto znać:
- Wznowione zadanie nie mogło dostać swojego worktree. Jego gałąź była wciąż wybrana w starszym katalogu trees, więc
git worktree addkończył się błędem. Teraz CLI ponownie używa worktree, który już ma tę gałąź, a jeden katalog trees na maszynę jest ustalony zarówno dla ludzi, jak i dla agenta. - Przygotowanie środowiska było zbyt usłużne. Linkowało pliki env do pustych folderów submodułów i tworzyło zastępcze pliki
.envz przykładów. Teraz linkuje tylko to, co główna kopia naprawdę ma. - Gałąź zadania przesunęła wskaźnik submodułu. W repozytorium złożonym z repozytoriów po cichu zmienia to, co pobierają wszyscy inni. Teraz nasza bramka odrzuca każdą gałąź zadania, która go przesuwa. Wskaźniki przesuwa tylko osobna synchronizacja.
- Równoległe sesje w jednej kopii. Dwie sesje przełączające gałęzie w tym samym folderze niszczą sobie nawzajem niezacommitowaną pracę. Dlatego główna kopia zostaje na
maini nikt w niej nie pracuje.
Ostatni przypadek to powód, dla którego worktree w ogóle istnieją. Pierwsze trzy to powód, dla którego opakowaliśmy je w jedno polecenie, zamiast wpisywać git worktree add ręcznie.
Jak zacząć we własnym repozytorium?
Nasze CLI nie jest potrzebne. Claude Code pokrywa podstawy:
01
Jeden worktree na zadanie
claude --worktree <nazwa> tworzy go w .claude/worktrees/ na nowej gałęzi.
02
Ignorować i dołączać
Proszę dodać .claude/worktrees/ do .gitignore. W .worktreeinclude wymienić pliki env potrzebne świeżej kopii.
03
Subagenci tylko do odczytu
Własnym subagentom proszę dać tylko narzędzia do odczytu. Pisanie zostaje w sesji zadania.
04
Jeden PR na zadanie
Sesja pushuje swoją gałąź i otwiera jeden PR. Po merge'u proszę usunąć worktree.
Potem proszę dodać sprawdzenia, dzięki którym pracę równoległą da się bezpiecznie przeglądać: testy, typy i bramkę CI, która musi przejść na każdej gałęzi. Hooki zatrzymujące niebezpieczne polecenia są w naszym publicznym Claude Code production starter. Co należy do zasad czytanych przez każdą sesję, opisujemy w CLAUDE.md i AGENTS.md: zasady dla kodu AI w zespole.
Czy Państwa repozytorium jest gotowe na równoległe agenty?
Prawdziwym limitem jest review. Nasz dyspozytor nie uruchamia nowego zadania agenta, dopóki PR-y agentów czekają na ludzi. Więcej równoległych agentów niż recenzentów tylko wydłuża kolejkę.
Chcą Państwo równoległych agentów w repozytorium zespołu?
Konfigurujemy to bezpośrednio w repozytorium zespołu w ramach AI-native SDLC dla zespołów deweloperskich: worktree, zasady, hooki i sprawdzenia, dzięki którym PR-y agentów da się przeglądać. Brakuje raczej rąk niż konfiguracji? Proszę zobaczyć senior developera dla Państwa zespołu. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Ilu agentów Państwa zespół uruchamia dziś naraz i kto przegląda ich pracę?
W skrócie
- Subagenci chronią kontekst: własne okno kontekstu, jedno zadanie, podsumowanie z powrotem.
- Worktree chronią pliki: własna kopia, własna gałąź, własny pull request.
- Nasza zasada: subagenci tylko czytają, każda zmiana dostaje własny worktree i sesję.
- Częściej psuje się przygotowanie niż izolacja: pliki env, stare gałęzie, wskaźniki submodułów.
- Limitem jest review. Równoległych agentów proszę dodawać tylko tak szybko, jak ludzie nadążą z review.
Najczęstsze pytania
Czym jest subagent w Claude Code?
Pomocnikiem, którego Claude uruchamia w Państwa sesji. Działa we własnym oknie kontekstu, z własnym promptem, narzędziami i uprawnieniami, wykonuje jedno zadanie i zwraca podsumowanie. Główna rozmowa pozostaje mała.
Czym różnią się subagenci od worktree?
Subagenci dzielą pracę w ramach jednej sesji i chronią jej kontekst. Worktree izolują zmiany w plikach: każda sesja ma własną kopię plików i własną gałąź. Subagentów używamy do czytania, a worktree do każdej zmiany.
Czy subagenci mogą pisać kod równolegle?
Mogą. Z isolation: worktree Claude Code daje każdemu z nich własny tymczasowy worktree. Mimo to trzymamy jednego piszącego na zadanie, bo recenzent dużo lepiej śledzi jeden diff i jeden tok rozumowania niż kilka.
Jak uruchomić Claude Code w worktree?
Proszę uruchomić claude --worktree <nazwa>. Claude Code tworzy worktree w .claude/worktrees/ na nowej gałęzi. Proszę dodać .claude/worktrees/ do .gitignore, a w .worktreeinclude wymienić pliki env potrzebne świeżej kopii.
Kiedy subagenci marnują tokeny?
Gdy ich zadanie jest małe albo pokrywa się z innym. Każdy subagent zaczyna ze świeżym kontekstem, więc czyta ponownie to, co sesja główna już przeczytała. Rozdzielenie pracy opłaca się przy szerokim researchu z niezależnymi pytaniami.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

