Harness engineering agentów w praktyce: od issue do PR
Dla CTO i programistówHarness i kontrole · Zaktualizowano

Filip PapranecZałożyciel Digitaliko
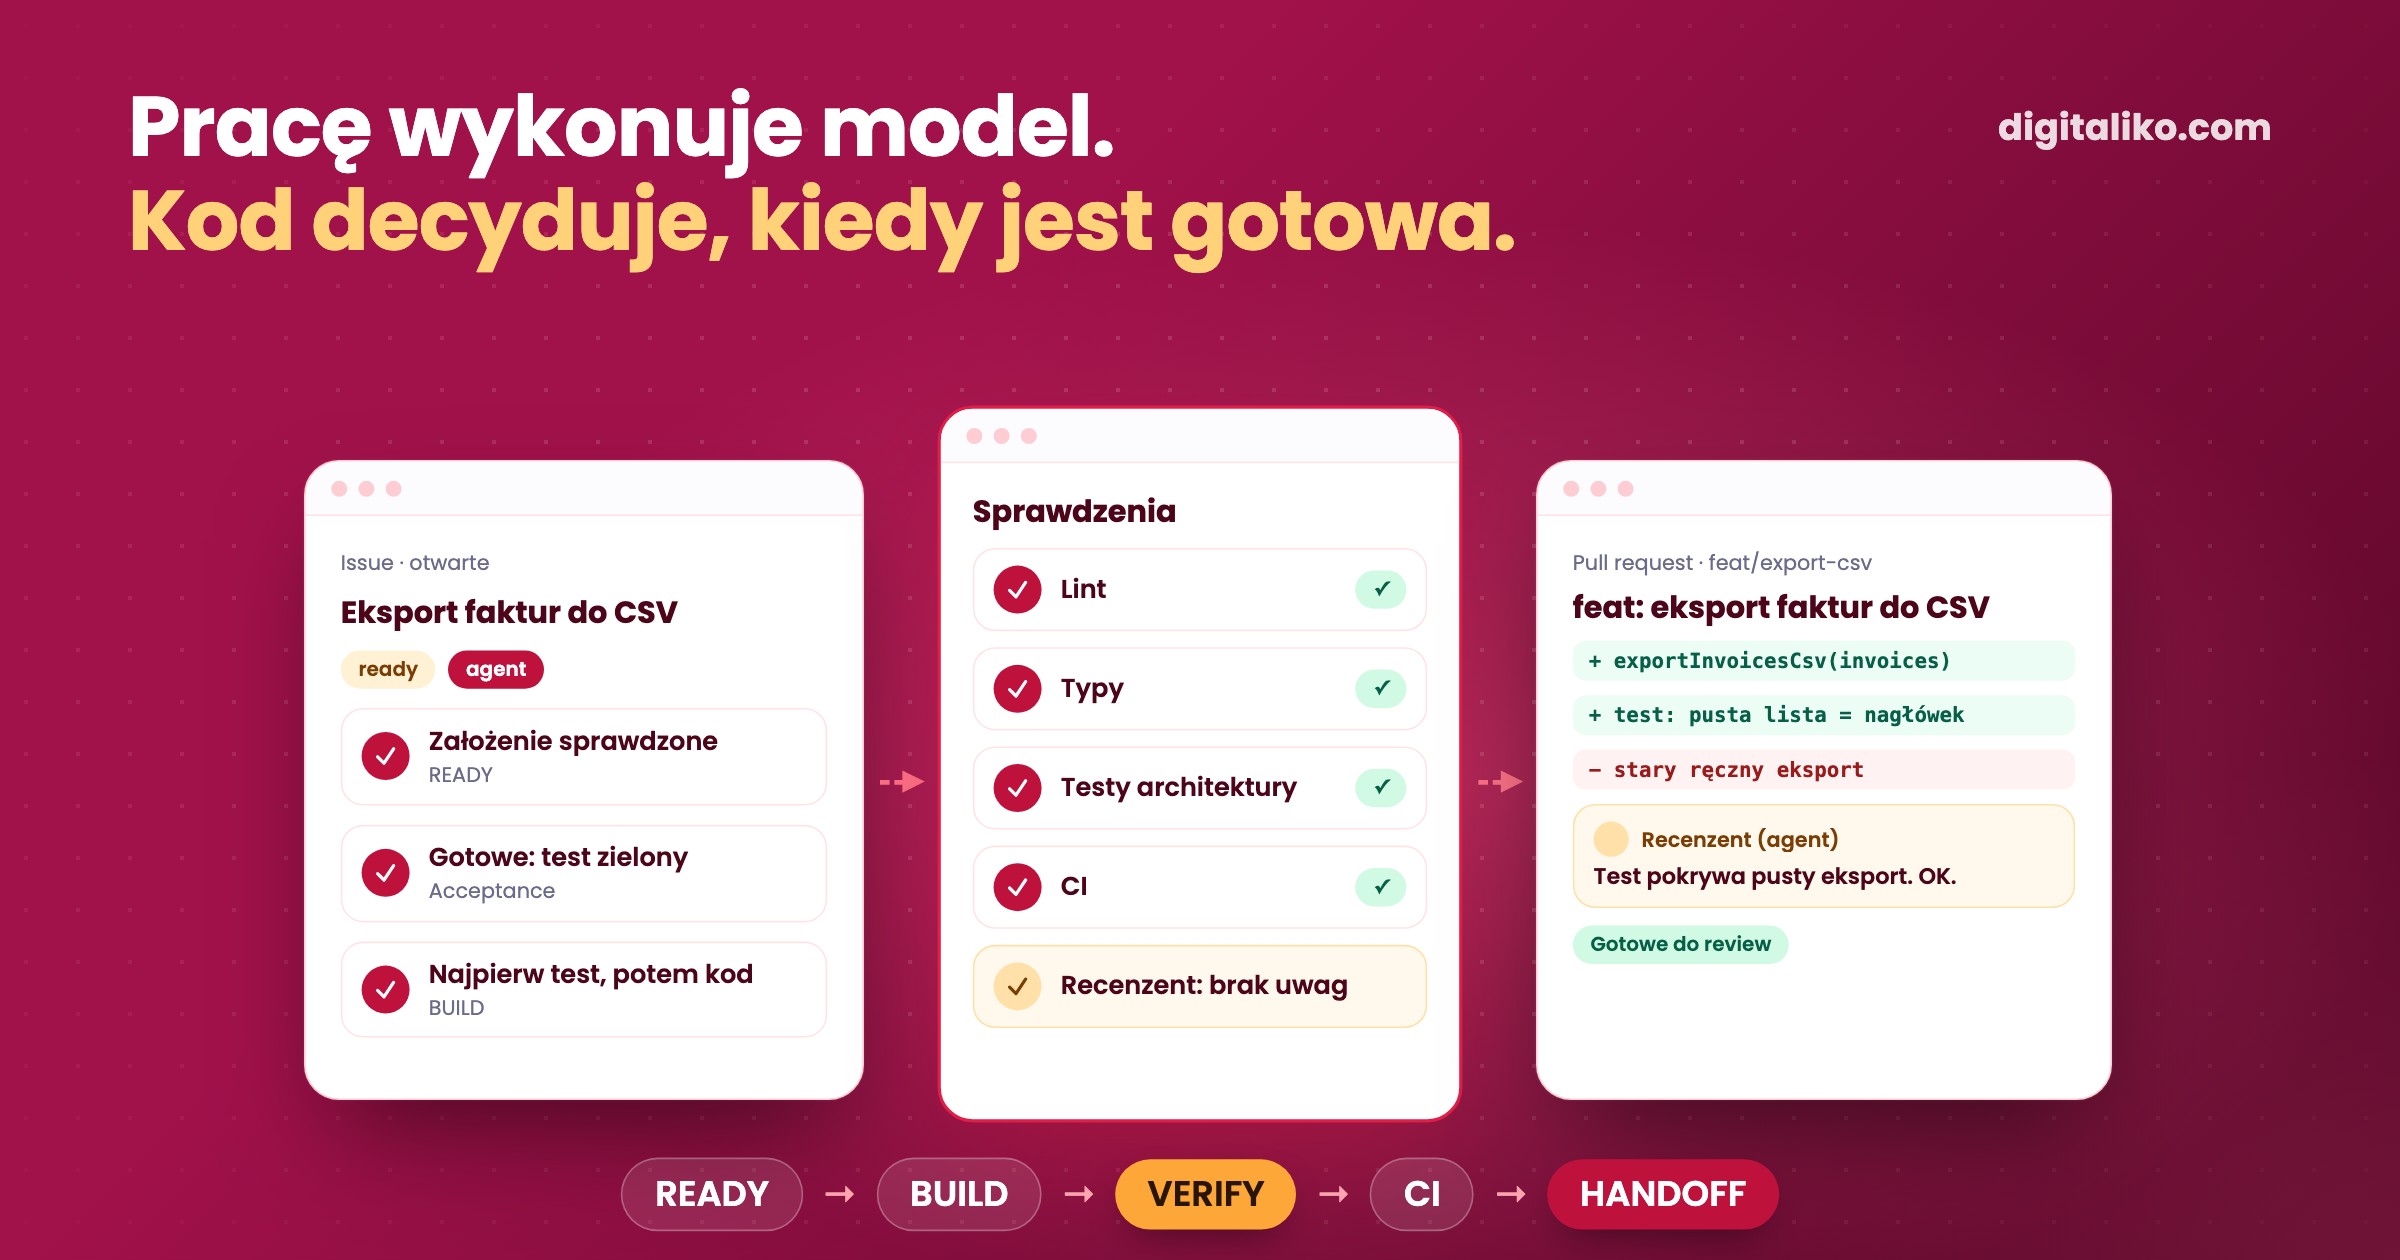
Agent harness to kod wokół agenta AI, który decyduje, jakie zadanie agent bierze, kiedy praca liczy się jako gotowa i kto ją sprawdza. Harness engineering to budowanie go. Model tylko wykonuje pracę. Agent AI, który pisze kod, jest tani. Drogi jest agent, którego pull requesty seniorzy mogą zmergować bez przerabiania, i tę lukę zamyka harness.
Taką pętlę uruchamiamy codziennie na własnych repozytoriach. Większość naszego kodu pisze AI. Każdą zmianę przegląda senior i odpowiada za to, co trafia na produkcję. Poniżej: jak działa pętla, linie kodu, które ją niosą, i co po drodze się zepsuło.
Stawiam agentom AI tyle przeszkód, że zostaje im tylko jedna droga. Ta właściwa.

Czym jest agent harness?
Agent harness to wszystko wokół modelu, w czym pracuje agent: reguły i kontekst, które ładuje, narzędzia, które może wywołać, pętla, która go uruchamia, sprawdzenia jego wyniku i moment, w którym się zatrzymuje i pyta człowieka. Claude Code to na przykład model opakowany w harness, który daje mu pliki, polecenia i pętlę. Państwa własny harness jest na wierzchu: co agent widzi, czego może dotykać i co liczy się jako gotowe.
Trzy pojęcia często się mylą:
- Framework. Biblioteka, z której buduje się agenta, na przykład SDK do agentów. Daje elementy, nie decyzje.
- Scaffold. Okablowanie promptu i narzędzi wokół jednego wywołania modelu albo jednego przebiegu benchmarku.
- Harness. Całe środowisko pracy na produkcji, łącznie ze sprawdzeniami i przekazaniem człowiekowi. Tu żyją reguły Państwa zespołu.
Dwa zespoły na tym samym modelu osiągają różne wyniki, bo mają różne harnessy. Model się wynajmuje. Harness jest Państwa.
Co oznacza harness engineering w praktyce?
Agent to model plus jego harness. Model się wynajmuje. Harness jest Państwa: reguły, kontekst, sprawdzenia, limity i przekazanie człowiekowi.
Nasza jedyna zasada projektowa stoi na początku skryptu dispatchera:
# Deterministic on purpose: code decides WHAT to take and WHEN it is done, models only do the work.Wynikają z niej trzy rzeczy:
- Kod wybiera pracę. Dispatcher w bashu wybiera zadania według priorytetu. Żaden model nie decyduje, co zacząć.
- Najpierw sprawdzenie maszynowe. Typecheck, lint, testy i nasza własna bramka działają, zanim jakikolwiek model wyrazi opinię.
- Kto wykonał pracę, nigdy jej nie ocenia. Wynik przegląda świeże wywołanie modelu z narzędziami tylko do odczytu.
Co robi programista, gdy kod pisze agent?
U nas zaczęło się od mniejszego zadania, które agent doprowadził aż do merge. To skłoniło nas do zastanowienia, co dziś właściwie robi programista.
Większość naszego kodu pisze AI. My pilnujemy, żeby wynik naprawdę działał. I bierzemy na siebie większe problemy, z dystansu, a nie linijka po linijce.
Większość naszego kodu pisze AI. Dlatego nie skupiamy się na tym, jak pisze, tylko na tym, co chcemy osiągnąć i jak udowodni, że to działa.
W praktyce to cztery kroki:
01
Plan
Cel, kiedy jest gotowe, przypadki i testy. Dopiero potem kod.
02
Twarde reguły
Testy, typy, architektura, co agent może, a czego nie. Dopóki nie przejdą, zmiana nie idzie dalej.
03
Review przez innego agenta
Kto napisał kod, ten go nie ocenia.
04
Człowiek na końcu
Nie czyta każdej linii. Sprawdza, czy rozwiązanie pasuje koncepcyjnie.
Jak nasza pętla prowadzi issue do PR?
Jedno issue na przebieg: jeden git worktree, jedna gałąź, jedna sesja Claude Code, jeden pull request.
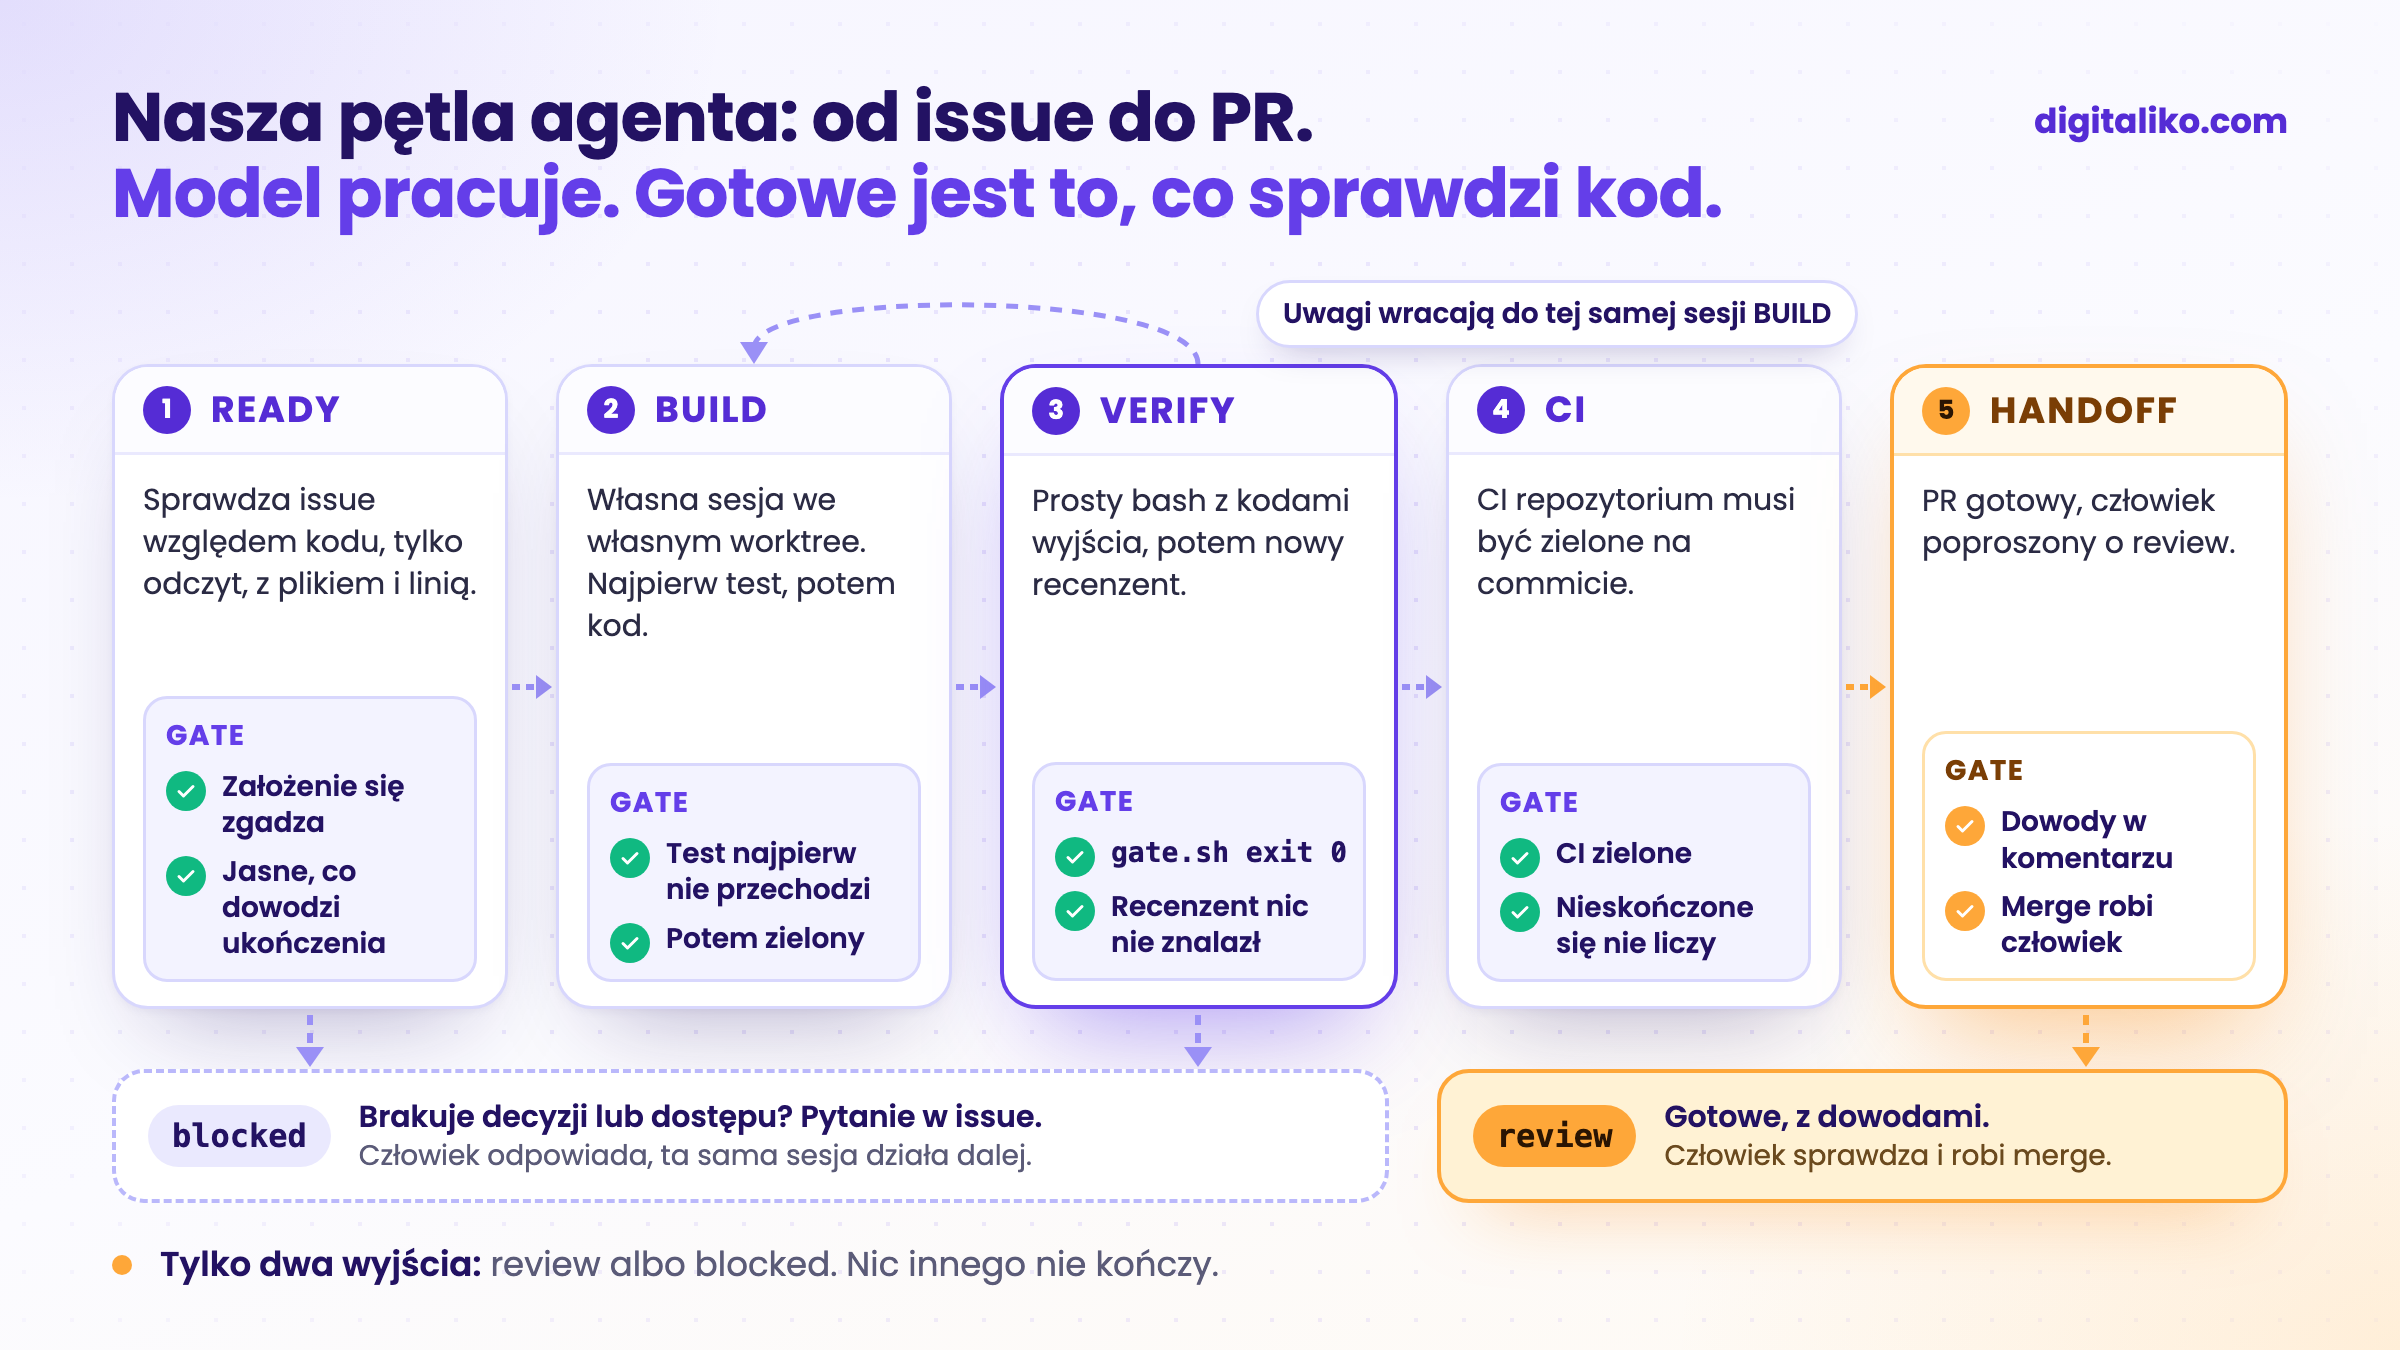
- READY. Wywołanie modelu tylko do odczytu sprawdza issue względem kodu, zanim cokolwiek się zacznie. Czy założenie się trzyma, z plikiem i linią? Jaki to typ zadania? Co udowadnia, że jest gotowe: test czy tylko człowiek, który na to spojrzy? Jeśli brakuje decyzji, agent pyta w issue i się zatrzymuje.
- BUILD. Sesja Claude Code w tle wykonuje pracę we własnym worktree. Przy kodzie najpierw pisze test, który nie przechodzi na niezmienionym kodzie, a potem implementuje.
- VERIFY. Dwie warstwy. Najpierw
gate.sh, zwykły bash z kodami wyjścia. Potem świeży recenzent, którego jedynym zadaniem jest próba obalenia pracy. Jego uwagi wracają do tej samej sesji BUILD. - CI. Własne CI repozytorium musi przejść na wypchniętym commicie. Sprawdzenie, które nie przechodzi także na głównej gałęzi, jest raportowane jako wcześniejsze, a nie przypisywane gałęzi.
- HANDOFF. PR zostaje oznaczony jako gotowy, człowiek jest poproszony o review, a komentarz zawiera dowody.
Są tylko dwa wyjścia: review (gotowe, z dowodami) albo blocked (pytanie na GitHubie). Gdy człowiek odpowie i usunie blocked, ta sama sesja kontynuuje z pełnym kontekstem.
Które linie kodu niosą pętlę?
Większość pracy wykonują trzy krótkie fragmenty.
Każde wywołanie modelu zwraca typowaną odpowiedź JSON. Brak odpowiedzi to porażka, nigdy wartość domyślna. W skrócie:
# one read-only model call with a typed answer; no object back = failure, never a default
ask() {
    ( cd "$tree" && claude -p "$prompt" --tools "Read,Grep,Glob" \
        --json-schema "$(cat "$schema")" --output-format json ) > "$out.raw"
    jq -e 'select(.subtype == "success") | .structured_output // empty' "$out.raw" > "$out" && [ -s "$out" ]
}
Czerwonego sprawdzenia maszynowego nie da się przegadać na zielone:
verdict=$(jq -r .verdict "$R/verify-$round.json")
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix   # a red executable check is never overruled to pass
A pętla, która nie zbiega się do wyniku, się zatrzymuje. Jeśli recenzent zgłosi tę samą uwagę dwa razy z rzędu, zadanie trafia do człowieka z tą uwagą w załączniku. Kolejna runda by tego nie naprawiła.
Jeszcze jeden szczegół: niezaufany tekst dostaje ogrodzenie. Treści issue i komentarze w PR trafiają do modelu oznaczone jako dane, a nie instrukcje.
Dlaczego reguły w pliku tekstowym nie wystarczą agentowi?
Jeszcze niedawno agent miał reguły tylko w plikach reguł. Czasem ich nie przestrzegał. Zamieniliśmy je więc w sprawdzenia, których nie może obejść: ESLint, testy architektury, typecheck przed pushem i to wszystko jeszcze raz w CI.
Tekst agent może przeczytać po swojemu. Sprawdzenia nie.
Każda kolejna bramka zwęża drogę: testy architektury, sprawdzenie, czy kod jest kompletny, wymagane pliki. Im więcej bramek, tym mniej miejsca, by agent zboczył. Zostaje tylko dozwolona droga.
Jest też efekt uboczny:
Projekty, przy których dziś pracuję, mają więcej testów, niż kiedykolwiek widziałem.
Gdzie wchodzi człowiek?
W trzech momentach i nigdzie więcej:
| Moment | Co robi człowiek |
|---|---|
| Start | Przypisuje issue. To jest zatwierdzenie. |
| Pytanie | Odpowiada w issue i usuwa blocked. |
| Przekazanie | Przegląda i robi merge. Merge robi tylko człowiek. |
Wąskim gardłem jest review, nie agent. Dlatego dispatcher nie zaczyna nowego zadania, dopóki PR agenta czekają na ludzi. Zadanie, które już trwa, może być kontynuowane. Merge, push do main, wysyłanie i wdrożenia są zablokowane pod agentem, w hookach, których nie może edytować.
Co się po drodze zepsuło?
Więcej, niż się spodziewaliśmy. Te przypadki warto znać:
- Dispatcher po cichu przestał zaczynać zadania. Zmiana limitu review wstawiła liczenie między
jq |awhile read. Pętla czytała wtedy puste wejście i żadne zadanie nie startowało. Nic nie padło, nic nie zaalarmowało. Znalazł to audyt. Poprawka przyszła z testem dispatchera na zaślepionymgh, czerwonym na starym kodzie i zielonym na nowym. - Infrastruktura lądowała u człowieka jako
blocked. Sesji, która padała w pierwszych minutach, brakowało dostępu, a nie była to zła praca. Teraz zamiast tego ponawia próbę w następnym cyklu. - CI, które nigdy się nie skończyło, liczyło się jako zielone. Teraz to zwrot do człowieka. Nieskończone to nie zaliczone.
- Sprawdzenie gotowości przyszło późno. Sprawdzenie założenia względem kodu dodaliśmy później. Dziś to pierwszy etap i od niego byśmy zaczęli.
Najtrudniejszy bywa ostatni krok: sprawdzenie, że to naprawdę działa od początku do końca. Bramki i prawdziwe testy. Najwięcej pracy wymaga utrzymanie spójnych środowisk, tak by sprawdzenia zawsze się uruchamiały. Dobrze sprawdził nam się jeden trik: wysyłamy agenta do funkcji jako określony typ klienta, personę, żeby sam ją zbadał.
Przed tą pętlą próbowaliśmy dwóch innych form. Jedną był pipeline workflowów GitHub Actions sterowany etykietami. Drugą jednorazowe wzmianki @claude w issue. Obie usunęliśmy. Bezstanowe joby CI źle pasują, gdy wykonawca musi wznowić sesję i w trakcie zadania zapytać człowieka.
W czym nie zgadzamy się z tym, co pisze się o harness engineering?
Większość tekstów jest o narzędziach. Naszym zdaniem decyduje to, gdzie w procesie stoi człowiek.
Czy da się to uruchomić we własnym zespole?
Proszę zacząć od bramek jakości. Jeśli zespół nie ma żadnych, od tego trzeba zacząć. Nasza pętla READY → BUILD → VERIFY → CI → HANDOFF jest prosta i działa. Każdy system potrzebuje jednak trochę innej.
Sama pętla jest związana z naszą konfiguracją. Najważniejsze elementy nie są. Opublikowaliśmy je jako małe publiczne repozytorium: Claude Code production starter. Ma reguły agenta, hooki zatrzymujące niebezpieczne polecenia, Stop hook, który blokuje „gotowe”, dopóki sprawdzenia są na czerwono, i bramkę CI z testami red-proof. Licencja MIT. Wystarczy sklonować, zostawić narzędzia i podmienić aplikację.
Które z tych elementów Państwa zespół już ma?
Co należy do reguł, które zasilają taki harness, opisujemy w Reguły dla kodu AI w zespole. Kiedy zespołowi wystarcza tryb planowania agenta, wyjaśniamy w Plan mode w Claude Code.
Chcą Państwo taki harness w swoim repozytorium?
Taką pętlę budujemy bezpośrednio w repozytorium zespołu w ramach AI-native SDLC dla zespołów deweloperskich. Państwa zespołowi brakuje raczej rąk niż reguł? Proszę zobaczyć seniora dla Państwa zespołu. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych. Senior dołącza do Państwa repozytorium i pull requestów od pierwszego dnia.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Co dziś robi Państwa agent, gdy nie jest pewien: pyta czy zgaduje?
W skrócie
- Pracę wykonuje model. Kod decyduje, co agent bierze i kiedy jest gotowe.
- Najpierw sprawdzenia maszynowe, potem świeży recenzent, który nie pisał kodu.
- Człowiek wchodzi trzy razy: przypisuje issue, odpowiada na pytanie, przegląda i robi merge.
- Proszę zacząć od bramek jakości. Pętlę dodać, gdy jedna sesja na zadanie przestanie wystarczać.
Najczęstsze pytania
Co oznacza harness engineering w praktyce?
Budowanie kodu wokół agenta AI: jakie zadanie bierze, jakie narzędzia i reguły dostaje, co sprawdza jego pracę i kiedy przejmuje człowiek. Pracę wykonuje model. Harness decyduje, kiedy praca liczy się jako gotowa.
Czym jest agent harness?
Wszystkim wokół modelu, w czym pracuje agent AI: reguły i kontekst, narzędzia, pętla, która go uruchamia, sprawdzenia wyniku i moment, w którym pyta człowieka. Nasz to dispatcher i runner w bashu, które biorą jedno issue z GitHuba na jedną sesję Claude Code, uruchamiają sprawdzenia i świeżego recenzenta, a potem przekazują PR człowiekowi.
Czym różni się agent harness od frameworka agentowego?
Framework, na przykład SDK do agentów, to biblioteka, z której buduje się agenta. Harness to środowisko pracy, w którym agent działa: jakie reguły ładuje, czego może dotykać, które sprawdzenia decydują o ukończeniu i kiedy przejmuje człowiek. Harness można zbudować z frameworkiem albo wokół gotowego agenta, takiego jak Claude Code.
Czy agent sam robi merge swoich pull requestów?
Nie. Merge robi tylko człowiek. Merge, push do głównej gałęzi, wysyłanie i wdrożenia blokują hooki pod agentem, których agent nie może zmienić.
Co agent harness powinien zawierać najpierw?
Cztery elementy, jeszcze przed pętlą: reguły agenta w repozytorium, hooki zatrzymujące niebezpieczne polecenia, Stop hook, który blokuje „gotowe”, dopóki sprawdzenia są na czerwono, i bramkę CI z testami red-proof. Nasz publiczny Claude Code production starter ma wszystkie cztery. Pętlę warto dodać, gdy jedna sesja na zadanie przestaje wystarczać.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

