Subagentes y worktrees en Claude Code: cuándo usar cada uno
Para CTO y desarrolladoresIA en el equipo de desarrollo

Filip PapranecFundador de Digitaliko
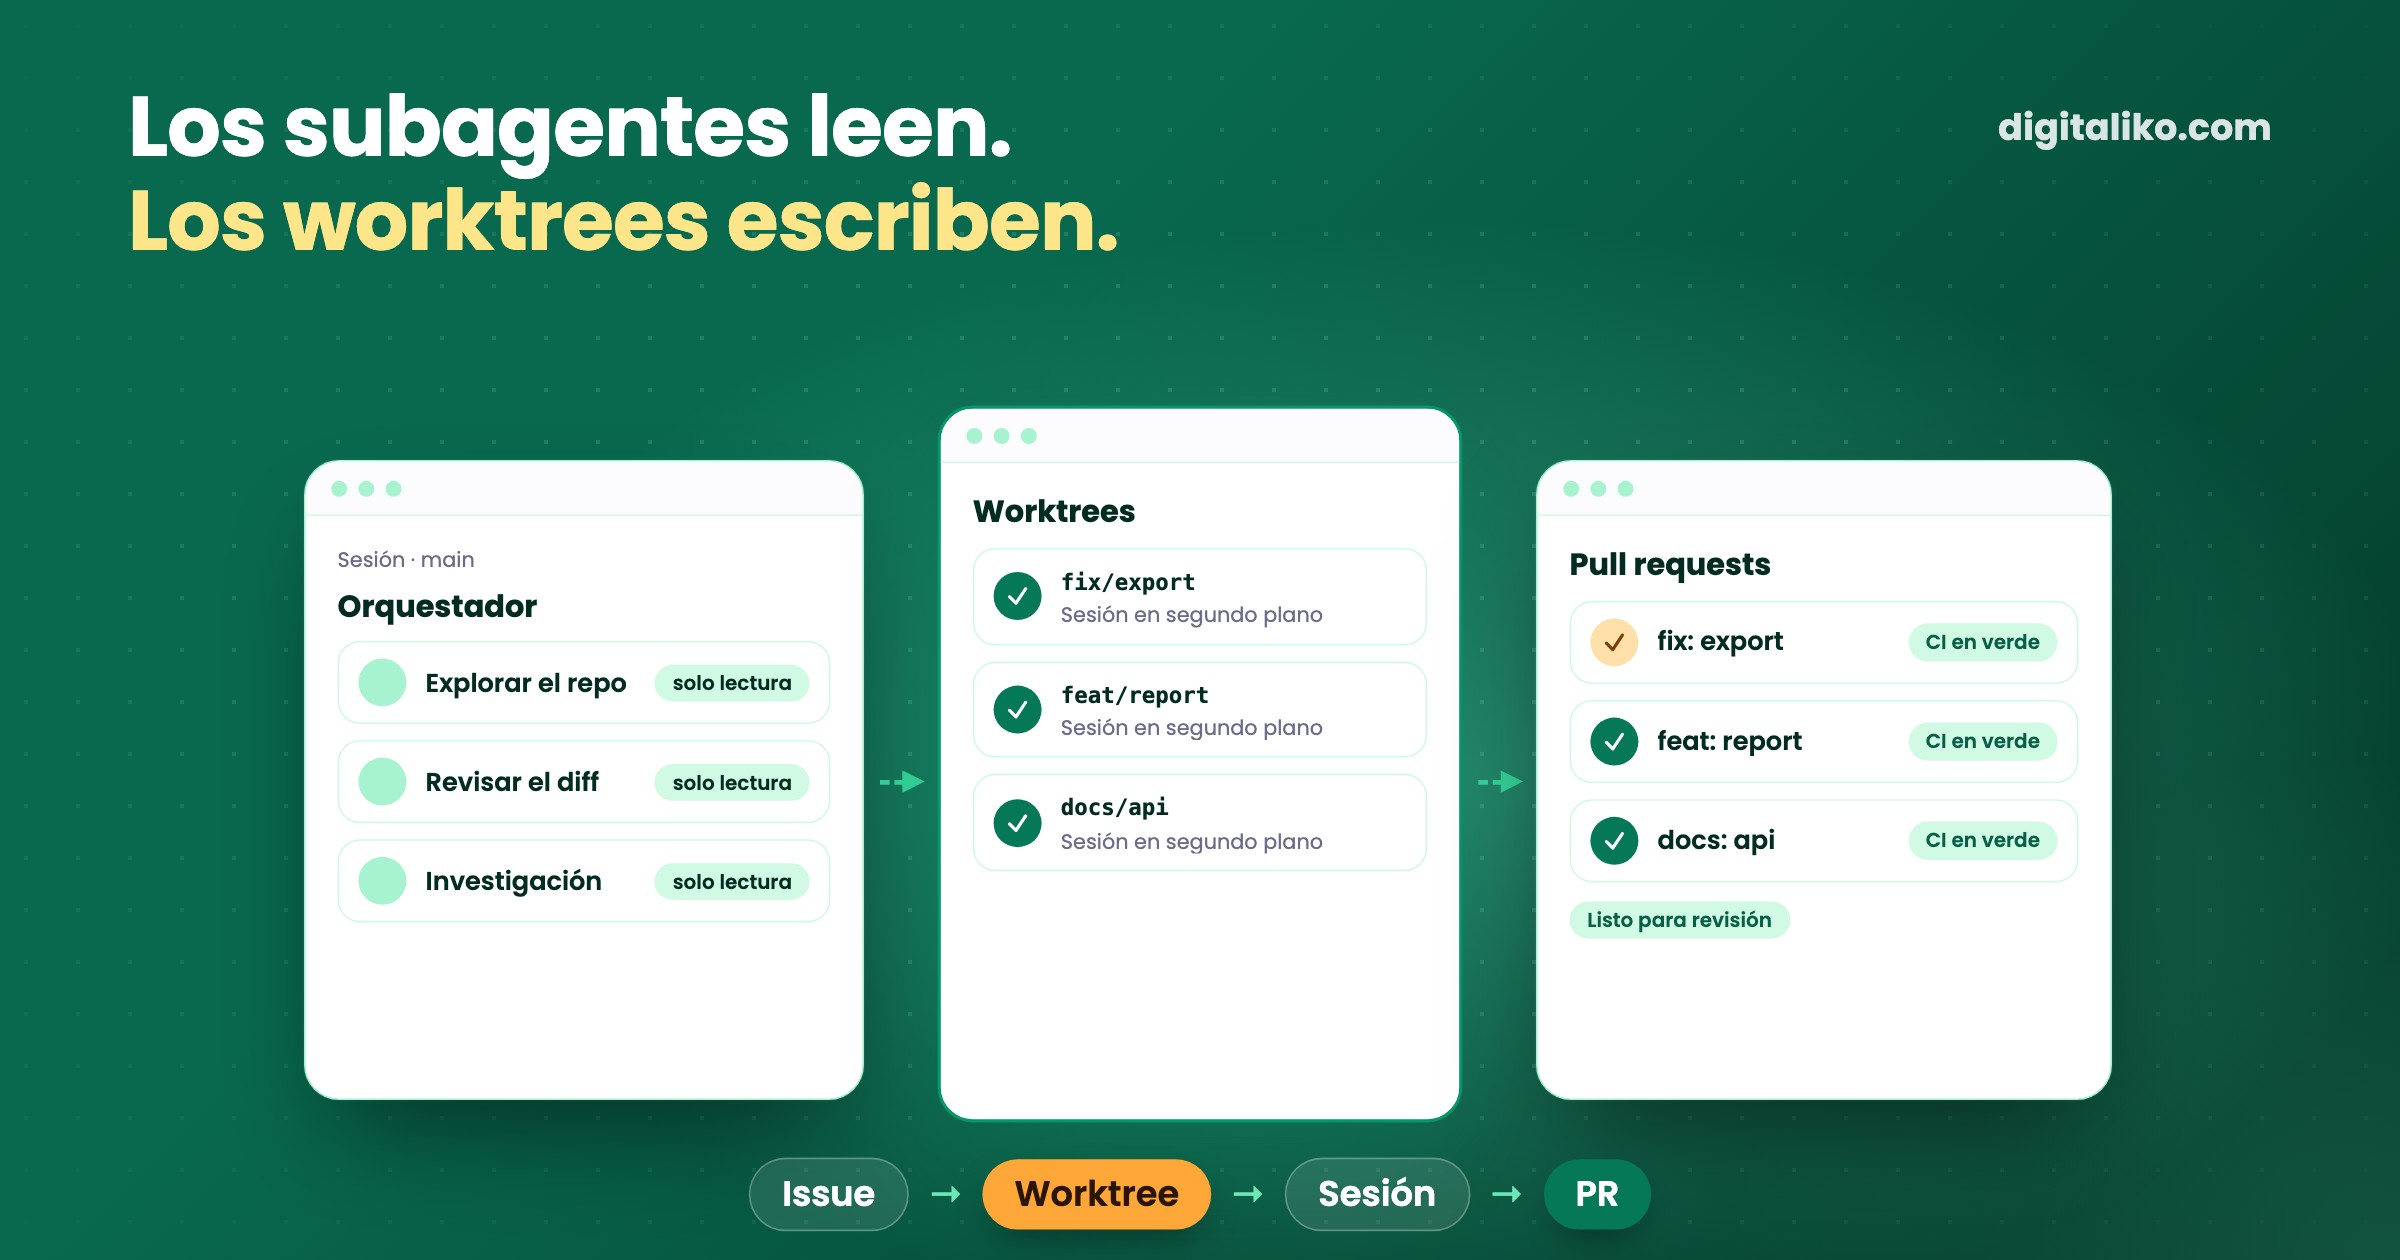
Los subagentes de Claude Code reparten el trabajo dentro de una sesión. Cada uno funciona en su propia ventana de contexto, hace una tarea y devuelve un resumen. Los worktrees aíslan los cambios en los archivos: cada sesión tiene su propia copia del repositorio y su propia rama. Nuestra regla tras usar agentes en paralelo a diario: los subagentes solo leen, y cada cambio tiene su propio worktree, su propia sesión y su propio pull request.
En nuestro caso, la IA escribe la mayor parte del código. Un senior revisa cada cambio y responde de lo que llega a producción. Los agentes en paralelo son la forma de avanzar varias tareas a la vez sin que se pisen. A continuación: cuándo usamos cada cosa, el comando que lo sostiene y qué se rompió por el camino.
¿Qué son los subagentes de Claude Code?
Un subagente es un ayudante que Claude arranca dentro de su sesión. La documentación de Claude Code lo resume en una frase: «Each subagent runs in its own context window with a custom system prompt, specific tool access, and independent permissions.» Es decir, cada subagente tiene su propia ventana de contexto, su propio prompt de sistema, sus herramientas y sus permisos.
Esa es toda la gracia. El subagente lee un montón de archivos y su conversación principal recibe un párrafo. Puede definir los suyos en .claude/agents/ con un nombre, una descripción, sus herramientas y un modelo. Claude elige uno por su descripción, o usted lo pide por su nombre.
El precio es ese mismo párrafo. Usted ve lo que el subagente informa, no lo que leyó. Si se le escapó algo, el resumen no lo dice.
¿Subagentes o worktrees: cuál para qué?
Resuelven problemas distintos. Los subagentes protegen su contexto. Los worktrees protegen sus archivos. La documentación de worktrees describe un worktree como «a separate working directory with its own files and branch, sharing the same repository history and remote as your main checkout», es decir, un directorio de trabajo separado con sus propios archivos y rama, que comparte historial y remoto con la copia principal.
| Subagente | Sesión en un worktree | |
|---|---|---|
| Aísla | el contexto | archivos y rama |
| Vive | dentro de una sesión, hasta que informa | lo que dura la tarea, también en segundo plano |
| Sirve para | explorar, revisar, investigar, una batería larga de tests | un cambio que termina como PR |
| Le devuelve | un resumen | una rama, un diff, un pull request |
| Riesgo típico | un resumen seguro de sí mismo tras una lectura parcial | la preparación: archivos env, dependencias, ramas antiguas |
¿Por qué nuestros subagentes solo leen?
Lo escribimos en el brief que recibe cada sesión de programación:
Only you write code. Subagents only read (explore the repo, run a long test suite and return just the failures).Solo la sesión principal escribe código. Los subagentes solo leen: exploran el repositorio o ejecutan una batería larga de tests y devuelven solo los fallos. Al escribir documentos y en la QA en el navegador, la línea es aún más estricta: «Do it yourself, no subagents.» La investigación es lo contrario. Ahí el brief ajusta los subagentes a la tarea: uno para un solo dato, unos pocos para una comparación, uno por elemento para un estudio amplio. Cada uno escribe sus resultados en un archivo y devuelve solo la ruta.
Claude Code puede dejar que los subagentes escriban. Añada isolation: worktree a un subagente y tendrá su propio worktree temporal. Aun así mantenemos un solo escritor por tarea. Un revisor sigue un diff y una línea de razonamiento. Varios escritores en una tarea producen varios diffs que alguien tiene que fusionar en su cabeza.
¿Cómo ejecutamos una issue en un worktree?
Una tarea es un worktree, una rama, una sesión de Claude Code y un pull request. La sesión orquestadora se queda en main en la copia principal y nunca cambia de rama allí. Cada cambio empieza con un solo comando de wizrd, nuestro plugin y CLI interno para Claude Code (no es público):
wizrd task start <repo> "<brief>"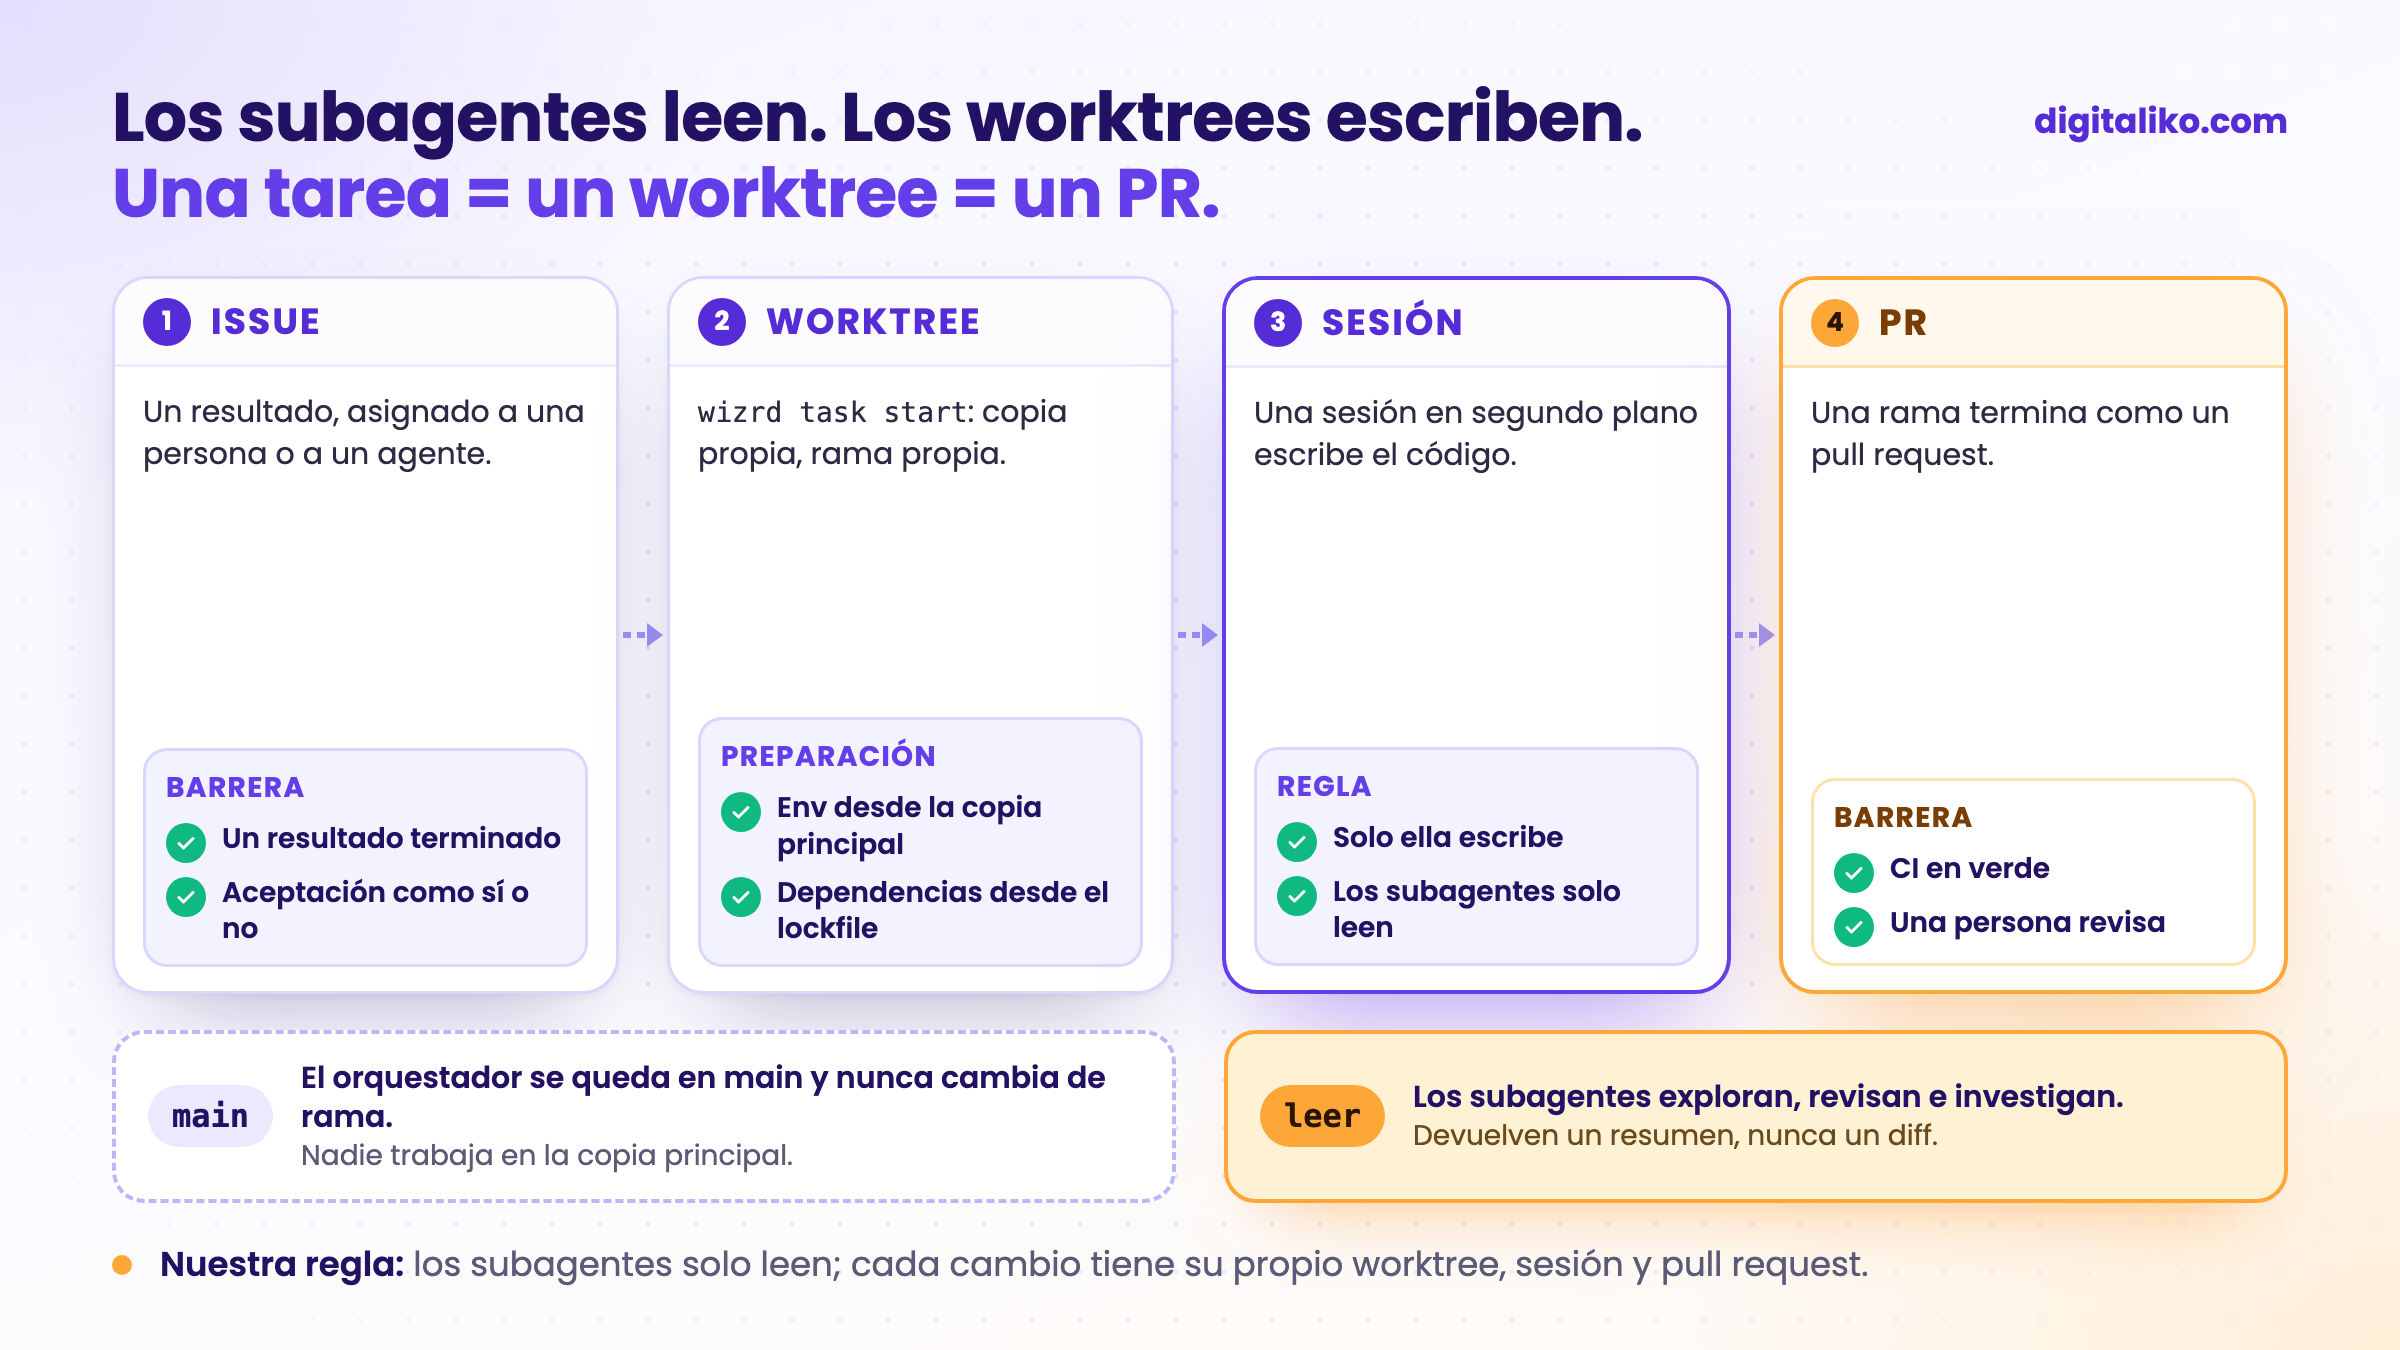
Qué hace el comando:
- Worktree.
wizrd worktree newlo crea en un único directorio de trees por máquina. Los archivos env se enlazan desde la copia principal y las dependencias se instalan desde el lockfile. - Contexto. Un servicio que vive dentro del repositorio de un cliente recibe un worktree de ese repositorio con el servicio anidado en la ruta de su submódulo, para que se carguen todos los
CLAUDE.mdde la cadena. Las skills y los agentes de los repositorios superiores entran con--add-dir. - Sesión. En el worktree arranca un
claude --bgen segundo plano. Lo seguimos enclaude agentsy le escribimos entre sesiones cuando necesita algo. - PR. La sesión hace commit, push y abre un pull request desde su rama. Tras el merge,
wizrd worktree pruneelimina el worktree.
Una issue que damos a nuestro agente de IA funciona igual, dentro del ciclo descrito en Harness engineering en la práctica: de la issue al PR. El mismo código de worktrees se ejecuta en el portátil de una persona y en la máquina del agente. Cómo escribe el agente un plan antes de empezar lo explicamos en El plan mode de Claude Code.
¿Cuándo malgastan tokens los subagentes?
Cada subagente empieza con un contexto nuevo. No ve lo que su sesión principal ya leyó, así que lo lee otra vez. Varios subagentes a los que se pregunta por el mismo módulo leen cada uno ese módulo desde cero.
Las señales que vigilamos:
- La tarea es pequeña. Una búsqueda no necesita un ayudante. El resumen cuesta más que la respuesta.
- Las tareas se solapan. «¿Cómo funciona el login?» y «¿dónde se comprueba la sesión?» mandan a dos subagentes a los mismos archivos.
- Necesita los detalles. Una revisión que tiene que citar líneas exactas se hace mejor donde esas líneas siguen en el contexto.
La solución suele ser menos subagentes, no subagentes más listos.
Quizá deberíamos simplificar algo. No tenemos por qué seguir añadiendo.

Con franqueza: no medimos el consumo de tokens por subagente. Seguimos las rondas y el tiempo activo por tarea, y ahí es donde se nota el derroche. Donde repartir el trabajo nos compensa claramente es en investigaciones amplias con preguntas independientes y en trabajos que inundarían a quien los llama. Nuestra skill para resumir reuniones se ejecuta bifurcada (context: fork), así que una transcripción larga nunca entra en el contexto de quien la llama.
¿Qué se rompió con los worktrees?
El aislamiento es la parte fácil. Donde se rompe es en la preparación. Estos son los casos que vale la pena conocer:
- Una tarea reanudada no podía obtener su worktree. Su rama seguía activa en un directorio de trees antiguo, así que
git worktree addfallaba. Ahora la CLI reutiliza el worktree que ya tiene la rama, y hay un único directorio de trees fijo por máquina, igual para personas que para el agente. - La preparación del entorno era demasiado servicial. Enlazaba archivos env en carpetas de submódulos vacías y creaba archivos
.envde relleno a partir de los ejemplos. Ahora enlaza solo lo que la copia principal tiene de verdad. - Una rama de tarea movió el puntero de un submódulo. En un repositorio hecho de repositorios, eso cambia en silencio lo que todos los demás descargan. Ahora nuestra barrera hace fallar cualquier rama de tarea que mueva uno. Los punteros solo se mueven con una sincronización aparte.
- Sesiones en paralelo en una misma copia. Dos sesiones que cambian de rama en la misma carpeta destruyen el trabajo sin commit de la otra. Por eso la copia principal se queda en
mainy nadie trabaja ahí.
El último caso es la razón de que existan los worktrees. Los tres primeros son la razón de que los envolviéramos en un solo comando en vez de escribir git worktree add a mano.
¿Cómo empezar en su propio repositorio?
No necesita nuestra CLI. Claude Code cubre lo básico:
01
Un worktree por tarea
claude --worktree <nombre> lo crea en .claude/worktrees/ sobre una rama nueva.
02
Ignorar e incluir
Añada .claude/worktrees/ a .gitignore. Liste en .worktreeinclude los archivos env que necesita una copia nueva.
03
Subagentes de solo lectura
Dé a sus propios subagentes solo herramientas de lectura. La escritura se queda en la sesión de la tarea.
04
Un PR por tarea
La sesión hace push de su rama y abre un PR. Elimine el worktree tras el merge.
Después añada las comprobaciones que hacen que el trabajo en paralelo se pueda revisar con seguridad: tests, tipos y una barrera de CI que debe pasar en cada rama. Los hooks que detienen comandos peligrosos están en nuestro Claude Code production starter público. Qué va en las reglas que lee cada sesión lo explicamos en CLAUDE.md y AGENTS.md: reglas para el código de IA en equipo.
¿Está su repositorio listo para agentes en paralelo?
La revisión es el verdadero límite. Nuestro despachador no arranca ninguna tarea nueva de agente mientras haya PRs de agentes esperando a personas. Más agentes en paralelo que revisores solo alarga la cola.
¿Quiere agentes en paralelo en el repositorio de su equipo?
Lo configuramos en el propio repositorio del equipo como parte de AI-native SDLC para equipos de desarrollo: worktrees, reglas, hooks y las comprobaciones que hacen revisables los PRs de agentes. ¿Le faltan más manos que configuración? Vea un desarrollador senior para su equipo. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en dos días laborables con unas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Cuántos agentes ejecuta hoy su equipo a la vez, y quién revisa su trabajo?
En resumen
- Los subagentes protegen su contexto: ventana de contexto propia, una tarea, un resumen de vuelta.
- Los worktrees protegen sus archivos: copia propia, rama propia, pull request propio.
- Nuestra regla: los subagentes solo leen, cada cambio tiene su propio worktree y su sesión.
- Falla más la preparación que el aislamiento: archivos env, ramas antiguas, punteros de submódulos.
- El límite es la revisión. Añada agentes en paralelo solo al ritmo al que las personas puedan revisar.
Preguntas frecuentes
¿Qué es un subagente en Claude Code?
Un ayudante que Claude arranca dentro de su sesión. Funciona en su propia ventana de contexto, con su propio prompt, herramientas y permisos, hace una tarea y devuelve un resumen. Su conversación principal se mantiene pequeña.
¿Qué diferencia hay entre subagentes y worktrees?
Los subagentes reparten el trabajo dentro de una sesión y protegen su contexto. Los worktrees aíslan los cambios en los archivos: cada sesión tiene su propia copia de los archivos y su propia rama. Usamos subagentes para leer y un worktree para cada cambio.
¿Pueden los subagentes escribir código en paralelo?
Pueden. Con isolation: worktree, Claude Code da a cada uno su propio worktree temporal. Aun así mantenemos un solo escritor por tarea, porque un revisor sigue mucho mejor un diff y una línea de razonamiento que varios.
¿Cómo arranco Claude Code en un worktree?
Ejecute claude --worktree <nombre>. Claude Code crea el worktree en .claude/worktrees/ sobre una rama nueva. Añada .claude/worktrees/ a .gitignore y liste en .worktreeinclude los archivos env que necesita una copia nueva.
¿Cuándo malgastan tokens los subagentes?
Cuando su tarea es pequeña o se solapa con otra. Cada subagente empieza con un contexto nuevo, así que vuelve a leer lo que la sesión principal ya leyó. Repartir el trabajo compensa en investigaciones amplias con preguntas independientes.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

