LLM as a Judge: KI-Reviewer, der die Arbeit widerlegen soll
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer von Digitaliko
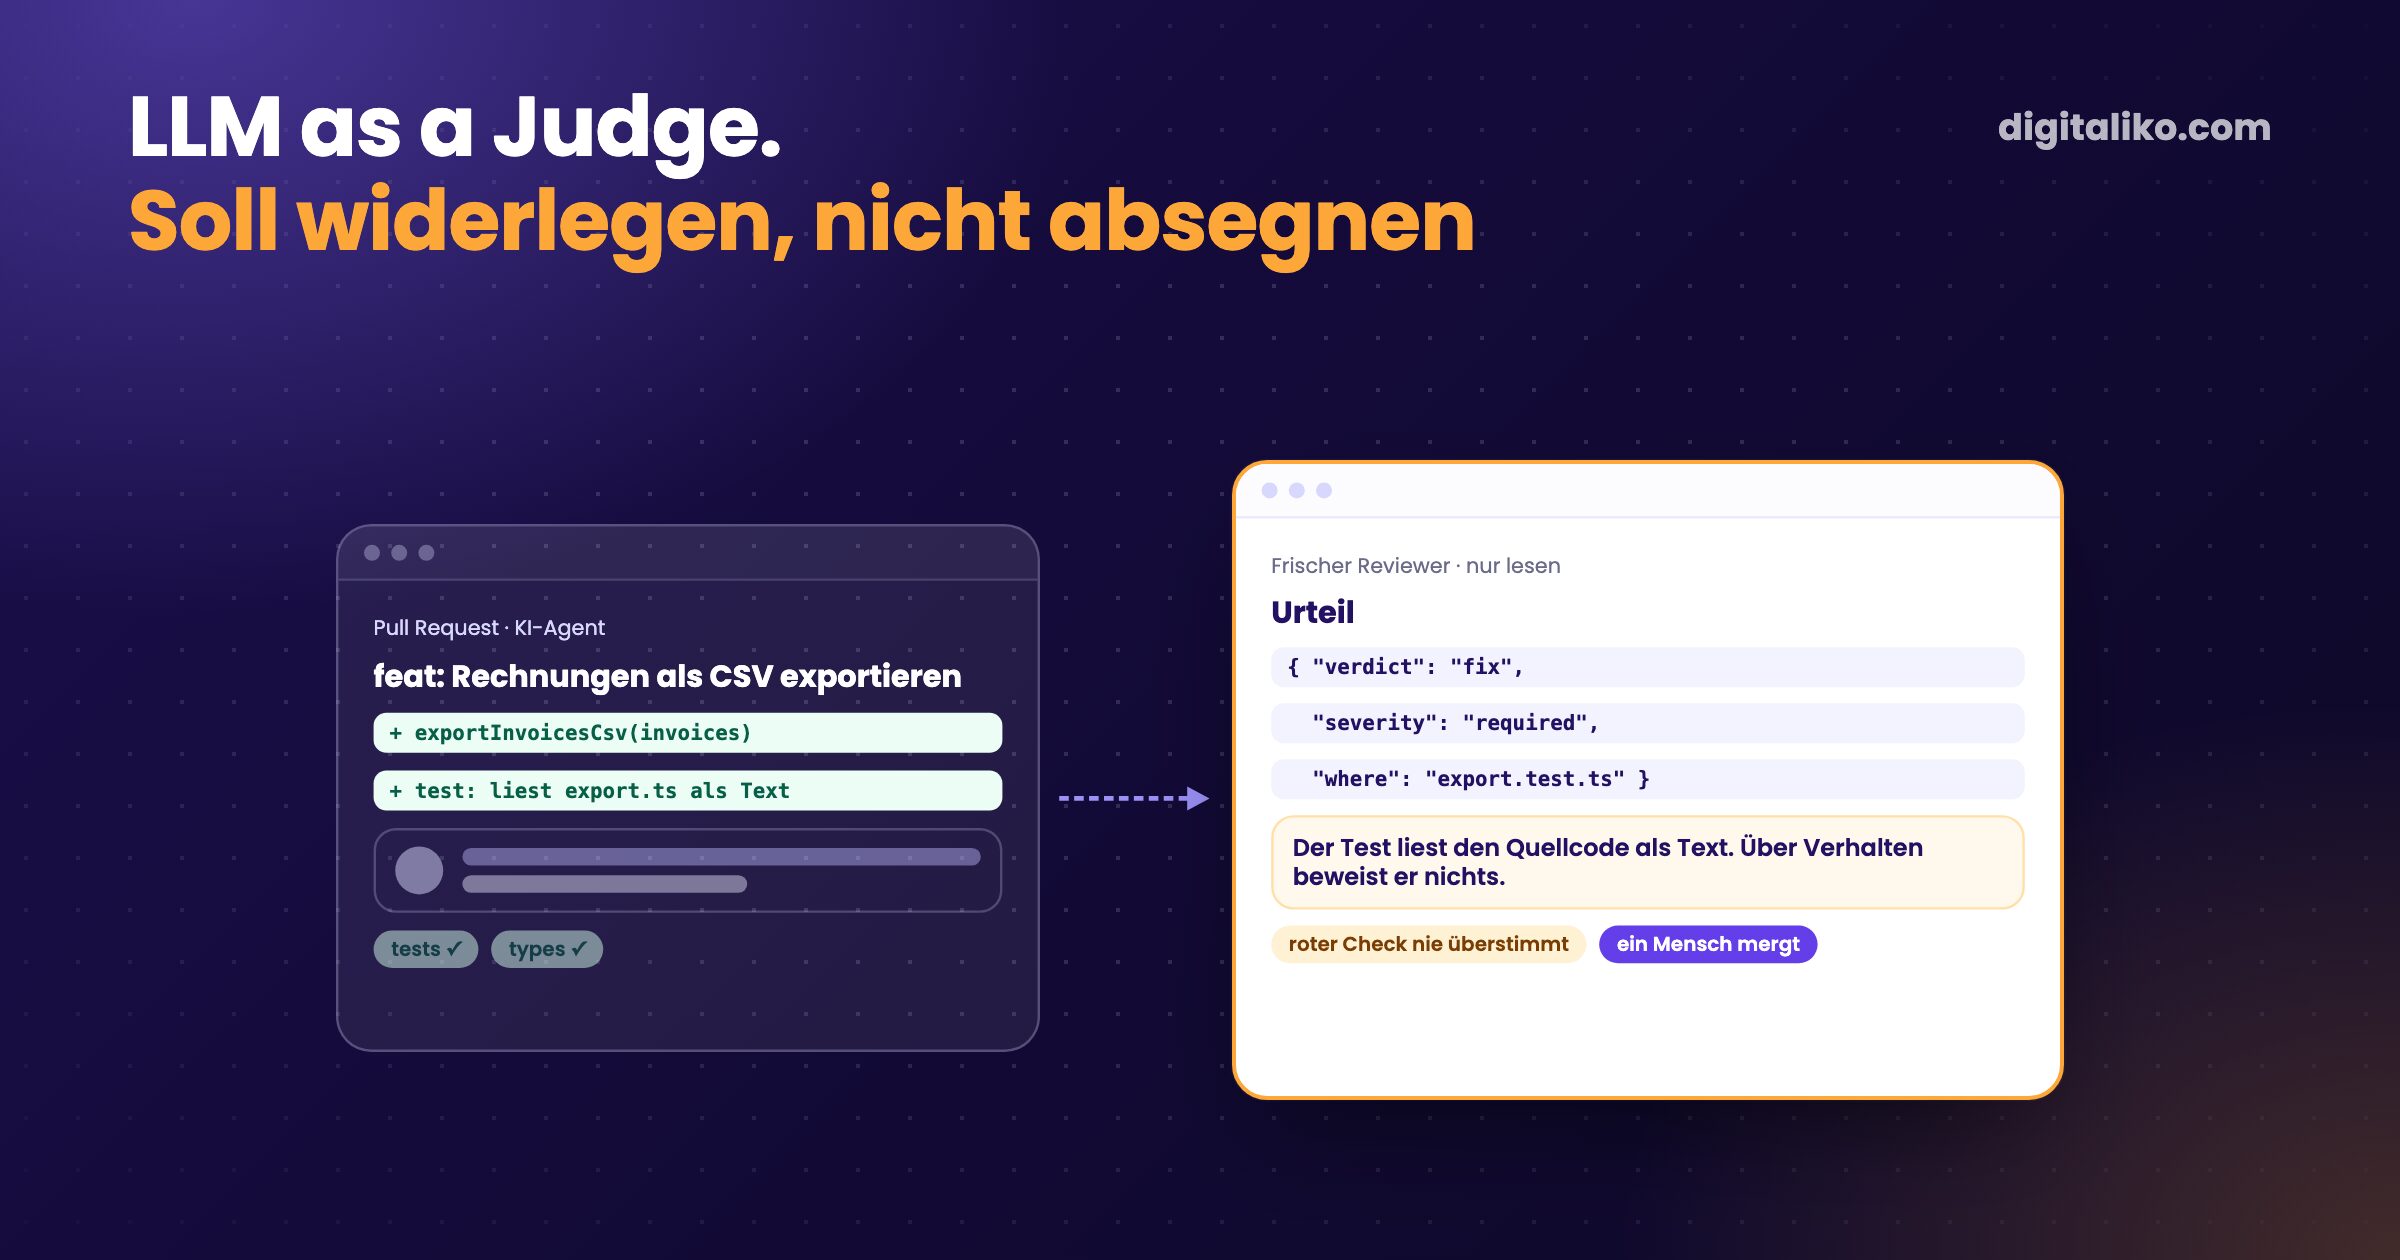
LLM as a Judge heißt: Ein Sprachmodell bewertet Arbeit anhand schriftlicher Kriterien, statt eines Menschen oder eines exakten Tests. Das funktioniert, wenn der Judge die Kriterien schriftlich hat, die Belege sieht, in einem festen Format antwortet und die Checks, die eine Maschine kann, nicht überstimmen darf.
Wir setzen einen bei jedem Pull Request ein, den unser KI-Agent öffnet. Er wird nicht gefragt, ob die Arbeit gut ist. Er soll versuchen, sie zu widerlegen. So ist er gebaut, und das sind die Regeln, die jedes Mal dazukamen, wenn er danebenlag.
Was ist LLM as a Judge?
Der Begriff kommt aus der Bewertung von Chat-Modellen. Statt Menschen dafür zu bezahlen, Antworten zu vergleichen, lässt man das ein starkes Modell tun. Die Studie, die den Begriff prägte, Zheng et al., hat gemessen, wie gut das funktioniert:
Our results reveal that strong LLM judges like GPT-4 can match both controlled and crowdsourced human preferences well, achieving over 80% agreement, the same level of agreement between humans.
Derselbe Abstract nennt auch die Grenzen: „position, verbosity, and self-enhancement biases, as well as limited reasoning ability“. Ein Judge bevorzugt die Antwort, die er zuerst gesehen hat, die längere und die, die wie er selbst klingt. Behalten Sie diese drei im Kopf. Jede Regel unten bekämpft eine davon.
Heute wird die Idee weit über Chat-Benchmarks hinaus genutzt: um Antworten aus der Suche zu bewerten, Agenten-Läufe zu benoten und Code zu reviewen. Unserer macht das Letzte.
Wann sollte man keinen LLM-Judge einsetzen?
Wenn ein günstigerer Check die richtige Antwort liefert. Ein Judge ist langsam, kostet Tokens und kann sich irren. Code, der einen Fakt prüft, tut nichts davon.
| Was Sie wissen wollen | Der richtige Check | Judge? |
|---|---|---|
| Laufen die Tests, stimmen die Typen? | Ausführen | Nein |
| Ist ein neuer Test vor dem Fix gescheitert? | Auf dem Basiscode ausführen | Nein |
| Funktionieren die Links, steht das Zitat wirklich auf der Quellseite? | Ein Skript | Nein |
| Wählt ein Klassifikator die richtige Kategorie? | Von Menschen gelabelte Beispiele, von Code ausgewertet | Nein |
| Tut die Änderung, was das Issue verlangt? | Issue, Diff und Belege lesen | Ja |
| Prüft ein Test Verhalten, oder liest er nur den Quellcode als Text? | Den Test lesen | Ja |
Die Zeile mit dem Klassifikator ist echt. Für den Online-Marktplatz eines Kunden haben wir ein LLM abgestimmt, das Inserate in Kategorien sortiert. Wir haben kein anderes Modell gefragt, ob die Kategorien gut aussehen. Wir haben echte Inserate von Hand gelabelt und die Treffer von Code zählen lassen. Wenn es eine richtige Antwort gibt, bringt ein Judge nur Rauschen.
Wie prüft unser LLM-Judge einen Pull Request?
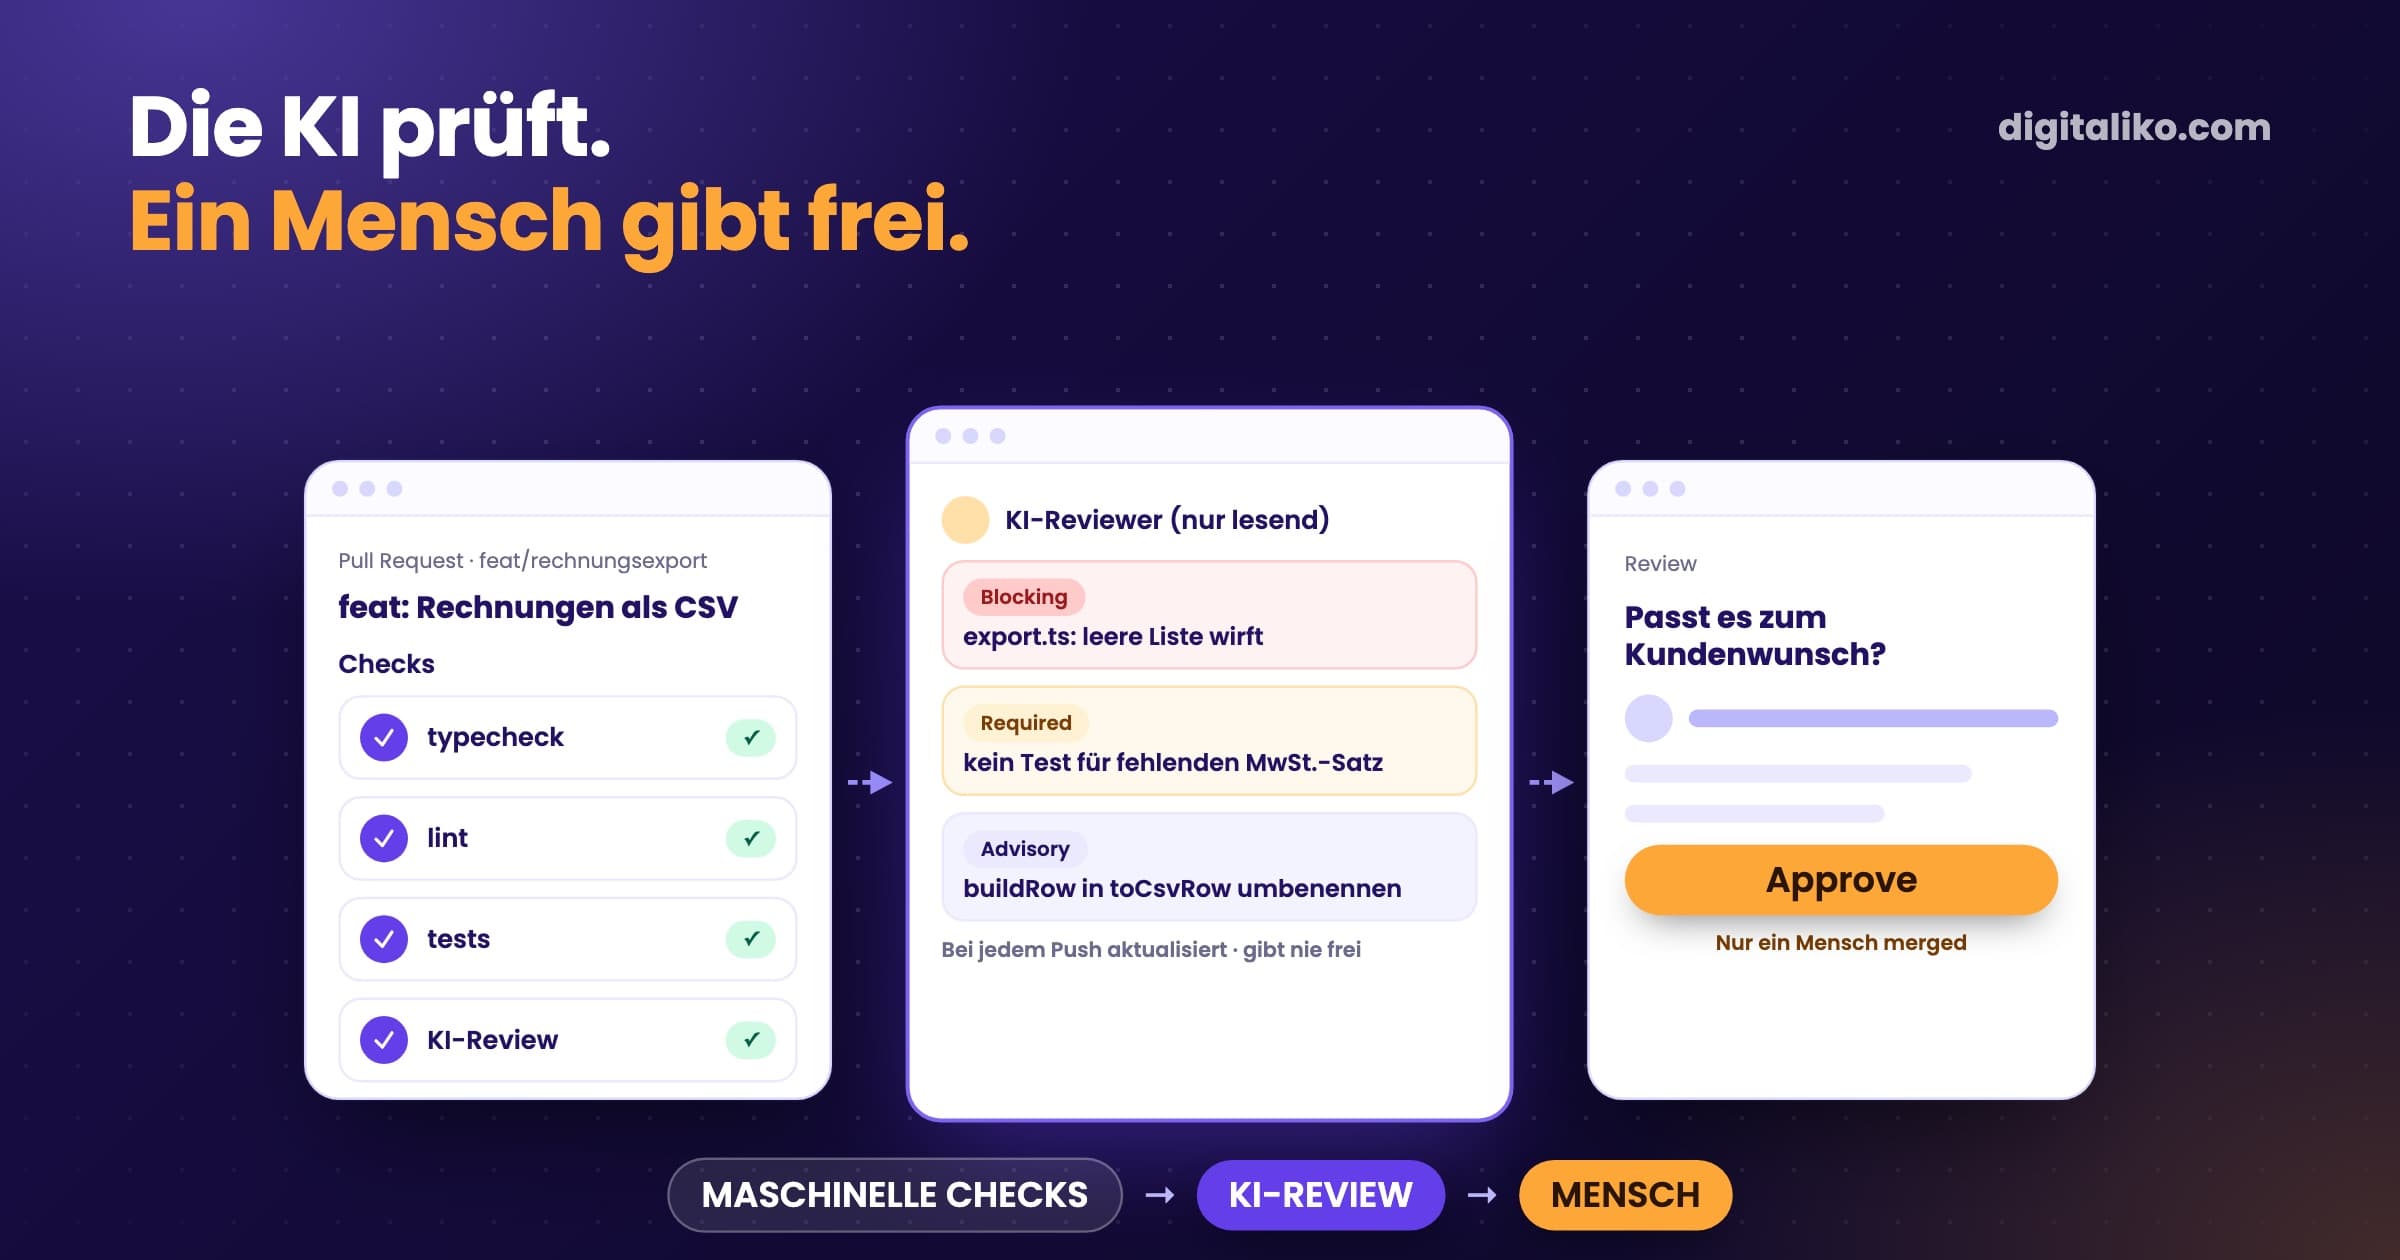
Der Judge ist der Schritt VERIFY in unserer Agenten-Schleife und ein beratender Check auf Pull Requests, die Menschen öffnen. In beiden Fällen dieselben Teile:
01
Zuerst maschinelle Checks
Ein einfaches Bash-Gate führt Tests, Typechecks und Lint des Repositorys aus und beweist, dass neue Tests auf dem Basiscode rot waren. Das bewertet nie ein Modell.
02
Was verlangt war
Der Judge bekommt das Issue, seine Done-when-Kriterien und die Diff-Statistik. Bei einem Pull Request ohne Issue das, was der Pull Request zu tun behauptet.
03
Eine frische Session nur mit Lesezugriff
Eine neue Session, die die Arbeit nicht gemacht hat, mit reinen Lese-Tools wie Read, Grep und Glob. Den Code, den sie beurteilt, kann sie nicht ändern.
04
Soll widerlegen
Der Prompt beginnt: Du hast diese Arbeit nicht gemacht, deine Aufgabe ist, sie zu widerlegen. Nur Befunde, für die auch ein Mensch die Arbeit zurückschicken würde.
05
Ein typisiertes Urteil
pass, fix oder blocked plus Befunde mit id, Schweregrad, Ort und Beleg, gegen ein JSON-Schema validiert.
Der Aufruf selbst sind ein paar Zeilen. Das ist der Schritt in unserer gemeinsamen CI-Action, leicht gekürzt:
prompt="$(cat "$L/verify.md"; data "$W/asked.md"; data "$W/checks.txt")"
npx -y @anthropic-ai/claude-code -p "$prompt" --tools "Read,Grep,Glob" \
  --json-schema "$(cat "$L/verify.schema.json")" --output-format json --max-turns 40 > "$W/raw.json"
verdict=$(jq -r .verdict "$W/verify.json")
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix   # a red machine check is never overruled
--json-schema sorgt dafür, dass Claude Code eine Ausgabe passend zum Schema zurückgibt (CLI reference, Stand 24.10.2026). data packt das Issue und das Check-Log in Markierungen, und der Prompt sagt, dass alles dazwischen Daten von anderen sind, keine Anweisungen. Ein Issue-Text kann den Judge nicht zu einem pass überreden.
Die letzte Zeile ist die wichtigste. Sind die Tests rot, macht kein Urteil daraus ein pass. Dasselbe Gate lässt auch einen Task-Branch scheitern, der einen Submodul-Pointer verschiebt, eine Regel, die wir in Monorepo vs. Polyrepo erklären.
Wo lag der Judge falsch, und was haben wir geändert?
Jede Regel im Prompt des Judges kam aus einem echten Fehlgriff. Vier davon:
- Tests, die nichts beweisen. Der Agent schrieb Tests, die Quelldateien als Text lasen und prüften, ob ein Import da war. Grün und nutzlos. Der Judge muss jetzt jeden neuen oder geänderten Test öffnen, und ein Test, der kein Verhalten prüft, ist ein Pflichtbefund.
- Wandernde Torpfosten. In der zweiten Runde fand der Judge neue, kleinere Probleme in Code, der sich nicht geändert hatte, und die Schleife endete nie. Jetzt bekommt eine spätere Runde die vorherigen Befunde und prüft nur diese.
- Buchstabe statt Absicht. Er bemängelte exakte Zahlen, Formulierungen und Tabellenlayout, die vom Issue abwichen, obwohl die Absicht erfüllt war. Jetzt ist ein Befund nur Pflicht, wenn ein Mensch die Arbeit dafür zurückschicken würde.
- Derselbe Befund ohne Ende. Befunde haben eine stabile id. Kommt dieselbe id zwei Runden hintereinander zurück, behebt eine weitere Runde sie nicht, also hält die Schleife an und fragt einen Menschen.
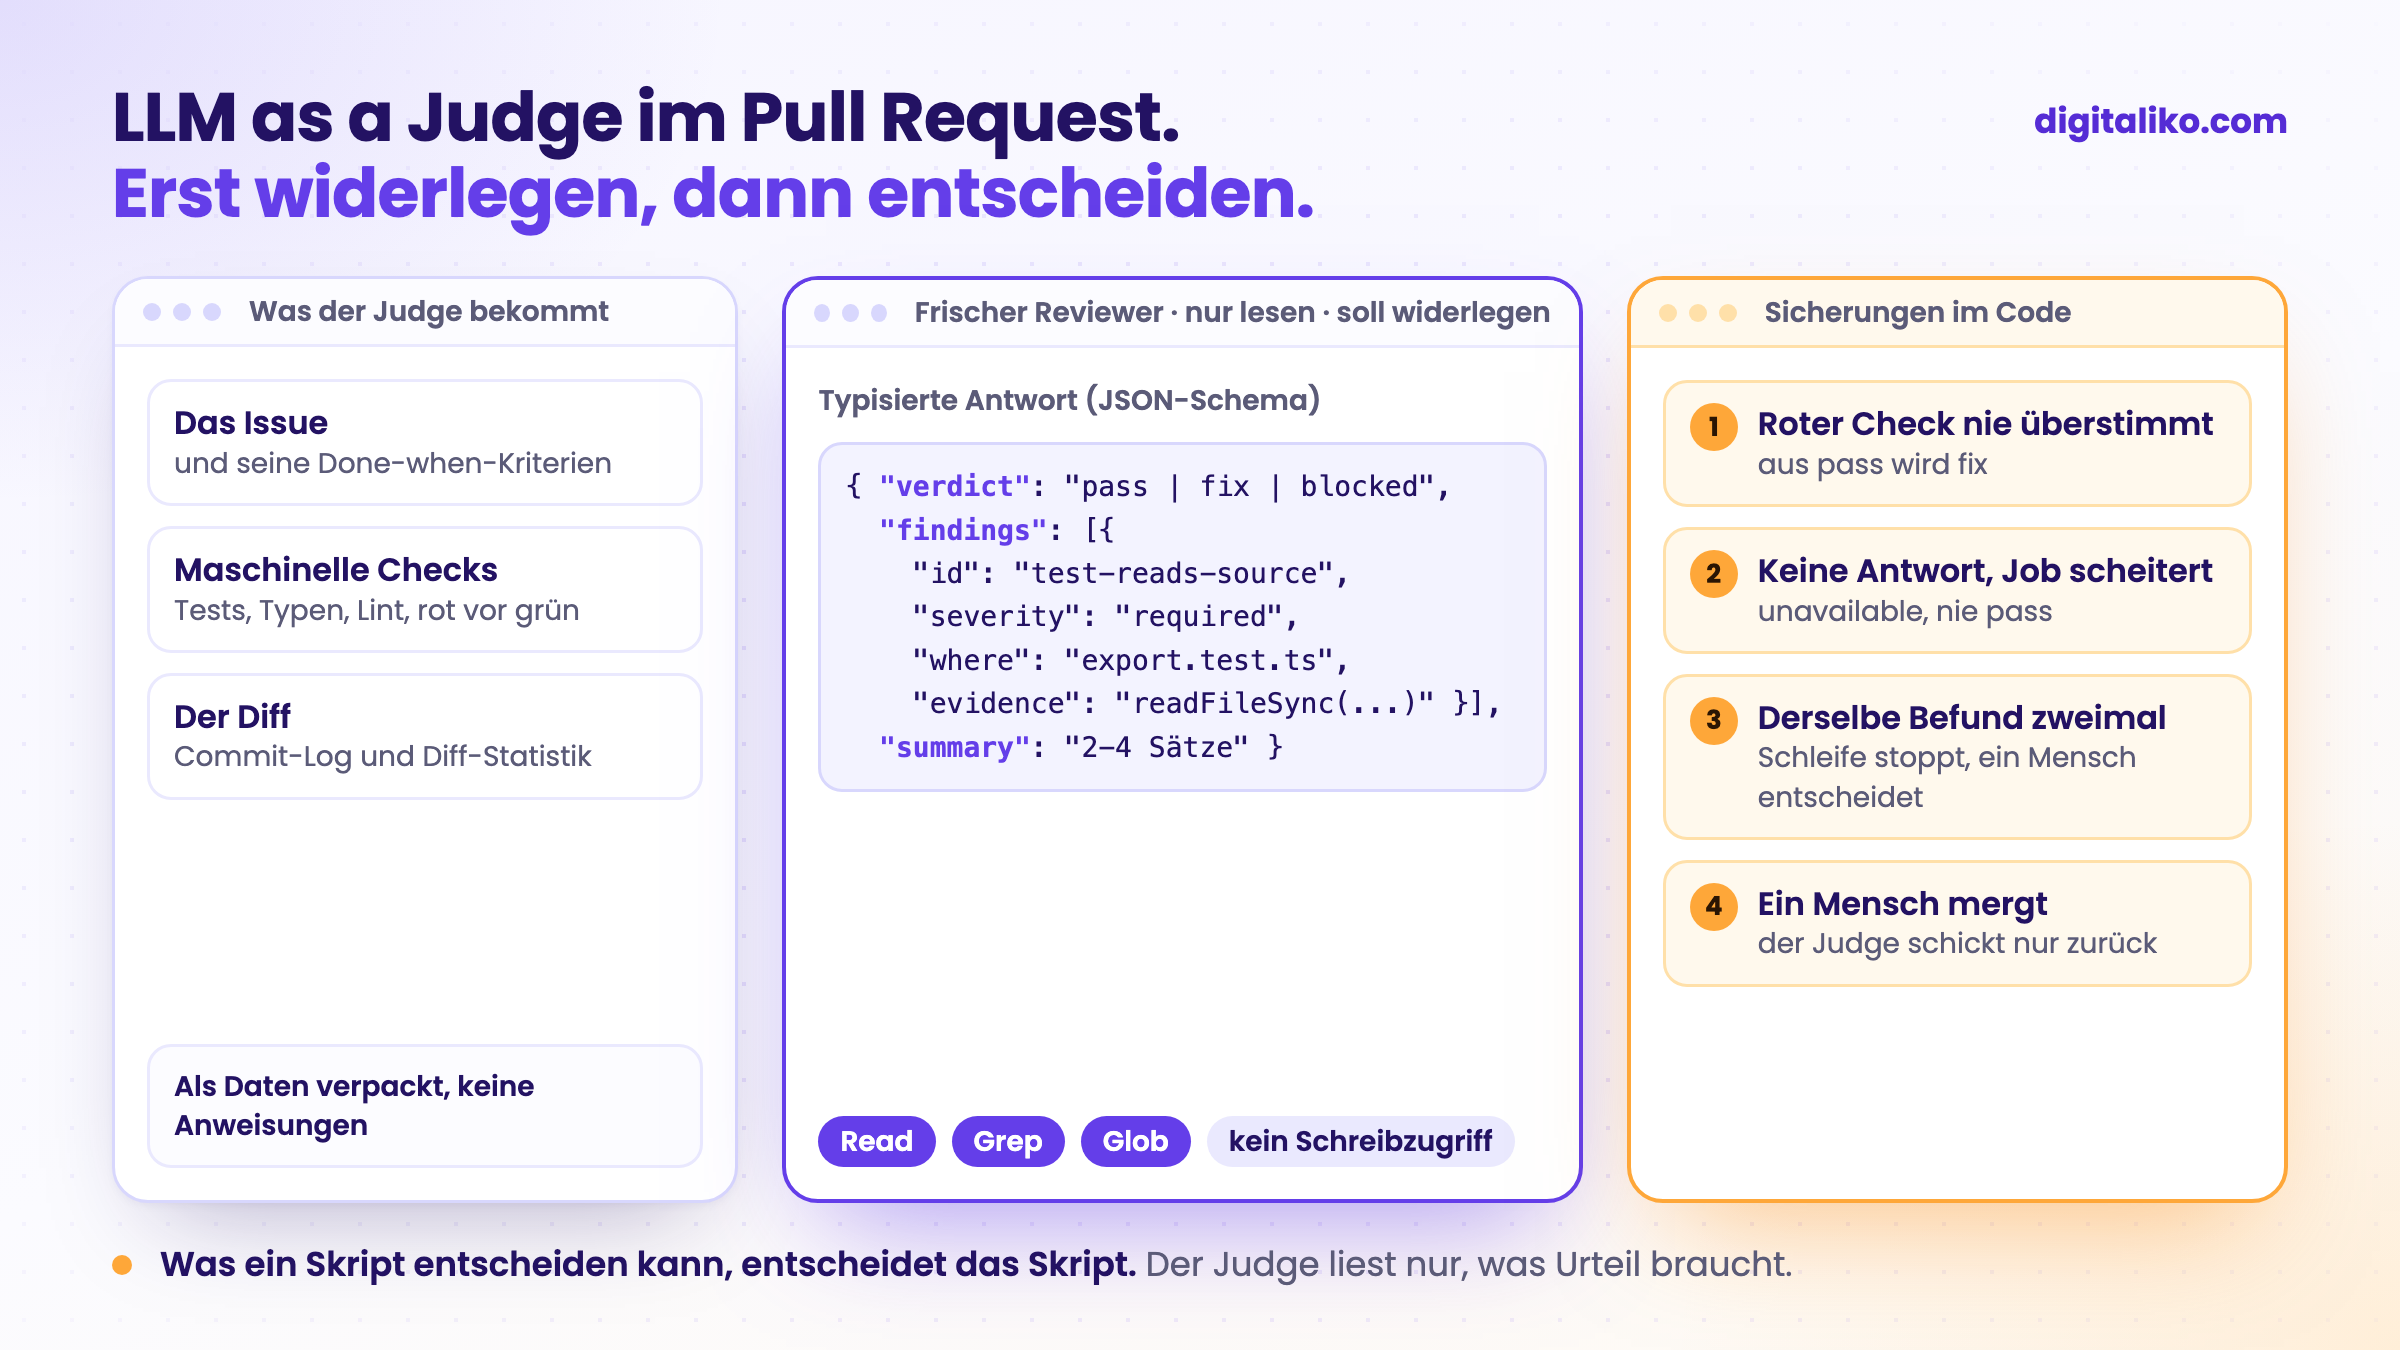
Der schlimmste Fehlgriff war gar nicht der des Judges. Anfang des Jahres lief unser KI-Code-Review in der CI auf jedem Pull Request grün durch und schrieb kein einziges Review. Ein Upgrade der zugrunde liegenden Action hatte zwei Inputs gestrichen, und der Job endete grün ohne Prompt. Ein Judge, der nie lief, sah genauso aus wie ein Judge, der zugestimmt hat. Heute ist eine fehlende oder ungültige Antwort ein eigenes Urteil, unavailable, und lässt den Job scheitern.
Welche Judge-Biases gelten noch?
Alle drei aus der Studie, in kleinerer Form:
- Positions-Bias wiegt am schwersten, wenn ein Judge zwei Antworten vergleicht. Unserer bewertet eine Arbeit anhand von Kriterien, es gibt also keine erste oder zweite Antwort zu bevorzugen.
- Längen-Bias zieht einen Judge zu langen Antworten. Das Schema begrenzt, was zählt: ein Urteil, Befunde mit Beleg, eine Zusammenfassung in wenigen Sätzen.
- Selbstbevorzugung haben wir nicht beseitigt. Unser Judge stammt aus derselben Modellfamilie wie der Agent, der den Code geschrieben hat. Eine frische Session, der Widerlegen-Prompt und die maschinellen Checks verringern sie. Sie lassen sie nicht verschwinden.
Ein anderes Modell als Judge ist der naheliegende nächste Schritt. Bei Texten machen wir das von Hand, in die Schleife haben wir es noch nicht eingebaut.
Ist Ihr LLM-Judge bereit für echte Arbeit?
Gehen Sie Ihr Setup durch:
Wie der Reviewer, der jeden Pull Request kommentiert, in GitHub Actions eingerichtet ist, steht in KI-Code-Review: Claude Code in der CI. Warum ein roter Test vor dem Fix zählt, steht in Red-Green-TDD mit KI-Agenten.
Möchten Sie einen Reviewer, der schlechte Pull Requests zurückschickt?
Die maschinellen Checks, den Judge und die CI drumherum richten wir direkt im Repository eines Teams ein, im Rahmen von AI-native SDLC für Entwicklerteams. Fehlen Ihrem Team eher Hände als Reviews? Sehen Sie sich einen Senior-Entwickler für Ihr Team an. KI schreibt heute unseren gesamten Code, und ein Senior steht für das Ergebnis ein. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Was tut Ihr KI-Reviewer, wenn er nichts zu sagen hat: schweigen oder scheitern?
Kurz gesagt
- Ein LLM-Judge bewertet Arbeit anhand schriftlicher Kriterien. Setzen Sie ihn nur dort ein, wo kein Skript entscheiden kann.
- Unserer läuft nach den maschinellen Checks, in einer frischen Session nur mit Lesezugriff, und soll widerlegen.
- Er gibt typisiertes JSON zurück. Ein roter Check wird nie überstimmt, und keine Antwort lässt den Job scheitern.
- Die Selbstbevorzugung bleibt, deshalb mergt ein Mensch jeden Pull Request.
Häufige Fragen
Was ist LLM as a Judge?
Ein Sprachmodell bewertet die Ausgabe eines anderen Modells oder eines Agenten anhand schriftlicher Kriterien, statt eines Menschen oder eines Tests auf exakte Übereinstimmung. Der Judge bekommt die Aufgabe, die Kriterien und die Belege und gibt ein Urteil zurück, idealerweise als strukturierte Daten.
Wie genau ist LLM as a Judge?
In der Studie zu MT-Bench und Chatbot Arena erreichten starke Judges wie GPT-4 über 80 % Übereinstimmung mit menschlichen Präferenzen, etwa so viel, wie Menschen untereinander übereinstimmen. Dieselbe Studie nennt Positions-, Längen- und Selbstbevorzugungs-Bias. Die Genauigkeit hängt von der Aufgabe ab, also messen Sie sie an Ihrer.
Wann sollte man keinen LLM-Judge einsetzen?
Wenn es eine richtige Antwort gibt, die Code prüfen kann: ein Test, ein Typecheck, ein Linkcheck oder ein von Menschen gelabeltes Set. Ein Judge ist für Kriterien, die man lesen und beurteilen muss, etwa ob eine Änderung tut, was das Issue verlangt.
Kann dasselbe Modell seine eigene Arbeit bewerten?
Es kann, neigt aber dazu, den eigenen Stil zu bevorzugen, was die Literatur Self-Enhancement-Bias nennt. Wir verringern das mit einer frischen Session, die die Arbeit nicht gemacht hat, einem Prompt, der zum Widerlegen auffordert, maschinellen Checks, die es nicht überstimmen kann, und einem Menschen, der mergt.
Was sollte ein LLM-Judge zurückgeben?
Eine typisierte Antwort, keinen Fließtext: ein Urteil aus einer festen Menge und Befunde mit stabiler id, Schweregrad, Ort des Problems und Beleg. Code kann dann damit arbeiten, und eine fehlende oder ungültige Antwort zählt als Fehler, nie als pass.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity