Monorepo vs. Polyrepo: Warum wir beides nutzen
Für CTOs und EntwicklerCTO-Entscheidungen · Aktualisiert

Filip PapranecGründer von Digitaliko
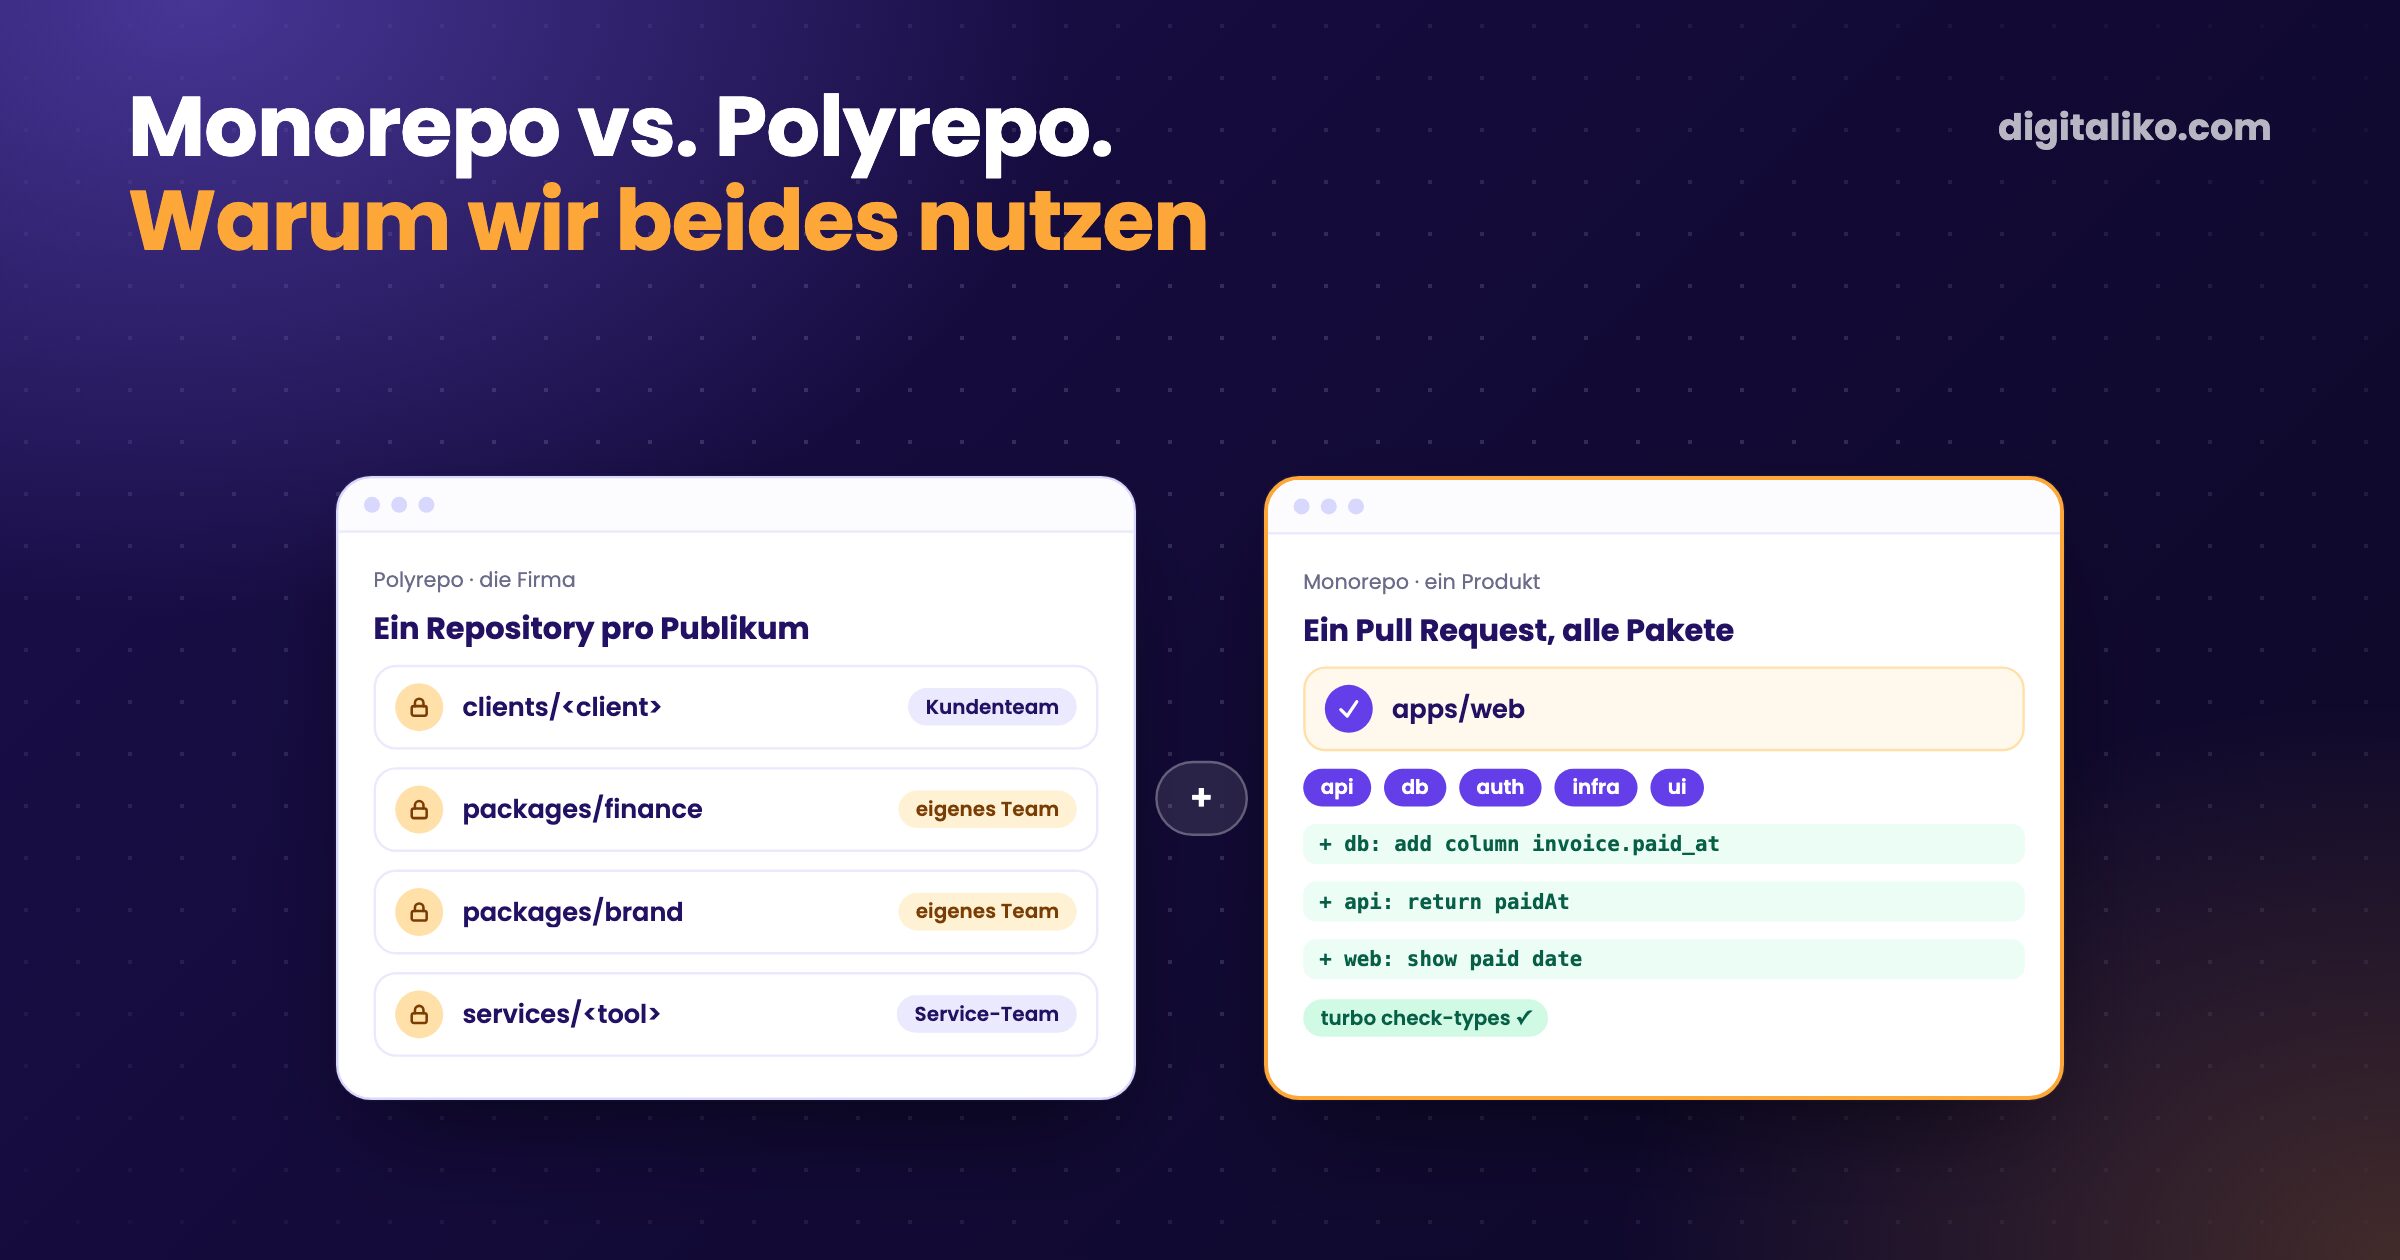
Monorepo vs. Polyrepo ist die Frage, welche Grenze Sie brauchen. Ein Monorepo legt viele Pakete in ein Repository, sodass eine Änderung alle durchqueren kann. Ein Polyrepo gibt jedem Projekt ein eigenes Repository, sodass jedes eigenen Zugriff, eigene CI und eigene Releases haben kann.
Wir nutzen beides, mit Absicht. Jedes Produkt, das wir bauen, ist ein Turborepo-Monorepo. Die Firma selbst ist ein Polyrepo: jeder Kunde, jeder Service und jeder vertrauliche Bereich ist ein eigenes Repository, verbunden über Git-Submodule. Ein KI-Agent arbeitet jeden Tag in beiden.
Was ist der Unterschied zwischen Monorepo und Polyrepo?
Kurz gesagt: Ein Monorepo zieht eine Code-Grenze um Pakete, ein Polyrepo eine Zugriffsgrenze um Repositories.
| Monorepo | Polyrepo | |
|---|---|---|
| Eine Änderung über viele Teile | Ein Commit, ein Pull Request | Ein Pull Request pro Repository |
| Geteilter Code | Ein Workspace-Paket, direkt importiert | Ein veröffentlichtes Paket oder eine Kopie |
| Wer was lesen darf | Wer Zugriff hat, sieht alles | Zugriff pro Repository |
| CI | Eine Pipeline, ein Build-Tool überspringt Unverändertes | Eine Pipeline pro Repository |
| Abhängigkeitsversionen | Ein Lockfile, eine Version pro Paket | Jedes Repository driftet für sich |
| Kontext für einen KI-Agenten | Das ganze System in einem Checkout | Nur was die Aufgabe braucht, der Rest per Navigation |
Die meisten Artikel zum Thema plädieren für eine Spalte. Wir halten beide für richtig, für unterschiedliche Einheiten. Die Frage ist, worum Sie die Linie ziehen.
Warum ist jedes Produkt ein Monorepo?
Ein Produkt ist Code, der zusammen ausgeliefert wird. Unser Template und wizrd, unser internes Claude-Code-Plugin und CLI (nicht öffentlich), sehen gleich aus: eine App und die Pakete, aus denen sie besteht.
{
  "packageManager": "bun@1.3.13",
  "workspaces": {
    "packages": ["apps/*", "packages/*"],
    "catalog": { "zod": "^4.1.13", "typescript": "^6", "better-auth": "1.5.5" }
  },
  "scripts": { "build": "turbo build", "check-types": "turbo check-types", "deploy": "turbo -F @wizrd/infra deploy" }
}
apps/web ist die App. packages/ enthält api, db, auth, infra, ui, env und ein paar mehr. Die App importiert sie als workspace:*, es gibt also nichts zu veröffentlichen. Der catalog legt gemeinsame Versionen einmal fest, sodass API und App nie zwei Versionen derselben Bibliothek nutzen.
Darüber sitzt Turborepo mit einer kurzen turbo.json:
{
  "tasks": {
    "build": { "dependsOn": ["^build"], "outputs": ["dist/**"] },
    "check-types": { "dependsOn": ["^check-types"] },
    "dev": { "cache": false, "persistent": true },
    "deploy": { "cache": false }
  }
}
^build heißt: Baue zuerst, wovon ich abhänge. Builds, Typprüfungen und Lint kommen aus dem Cache. Deploys und Datenbank-Pushes nie. Der Cache ist genau der Grund, den die Turborepo-Doku für das Werkzeug nennt:
Turborepo uses caching to speed up builds, ensuring you never do the same work twice.
Der eigentliche Gewinn ist aber nicht die Geschwindigkeit. Es ist der eine Pull Request. Ändert sich das Datenbankschema, ändern sich API, Typen und Bildschirm im selben Commit, und check-types schlägt fehl, wenn eines davon fehlt. Für einen KI-Agenten ist das Gold wert: Die Typprüfung sagt ihm, was er kaputt gemacht hat, bevor ein Mensch es tun muss.
Der Online-Marktplatz eines Kunden läuft in derselben Form, sein Crawler ist einfach eine weitere App im Monorepo.
Warum ist die Firma ein Polyrepo?
Weil Zugriff für uns die wichtigste Grenze ist und GitHub Zugriff pro Repository vergibt. Ein Leserecht für einen einzelnen Ordner gibt es nicht. Alles, was ein anderes Publikum braucht, bekommt deshalb ein eigenes Repository:
- Kunden-Repositories für jeden Kunden, lesbar für das Team, das für diesen Kunden arbeitet. Ein Speditionsunternehmen, für das wir ein System gebaut haben und betreiben, hat ein eigenes Kunden-Repository und darin seine Service-Repositories als Submodule.
- Räume für vertrauliche Bereiche wie Finanzen und Marke, jeweils nur für das eigene GitHub-Team lesbar.
- Service-Repositories für unsere eigenen Werkzeuge, etwa das Plugin und den Harness, den unsere Agenten nutzen.
Das Firmen-Repository an der Wurzel verbindet sie über Git-Submodule. Niemand bekommt standardmäßig den ganzen Baum. Eine Session ohne Zugriff auf Finanzen kann Finanzen nicht lesen, egal was in ihrem Prompt steht.
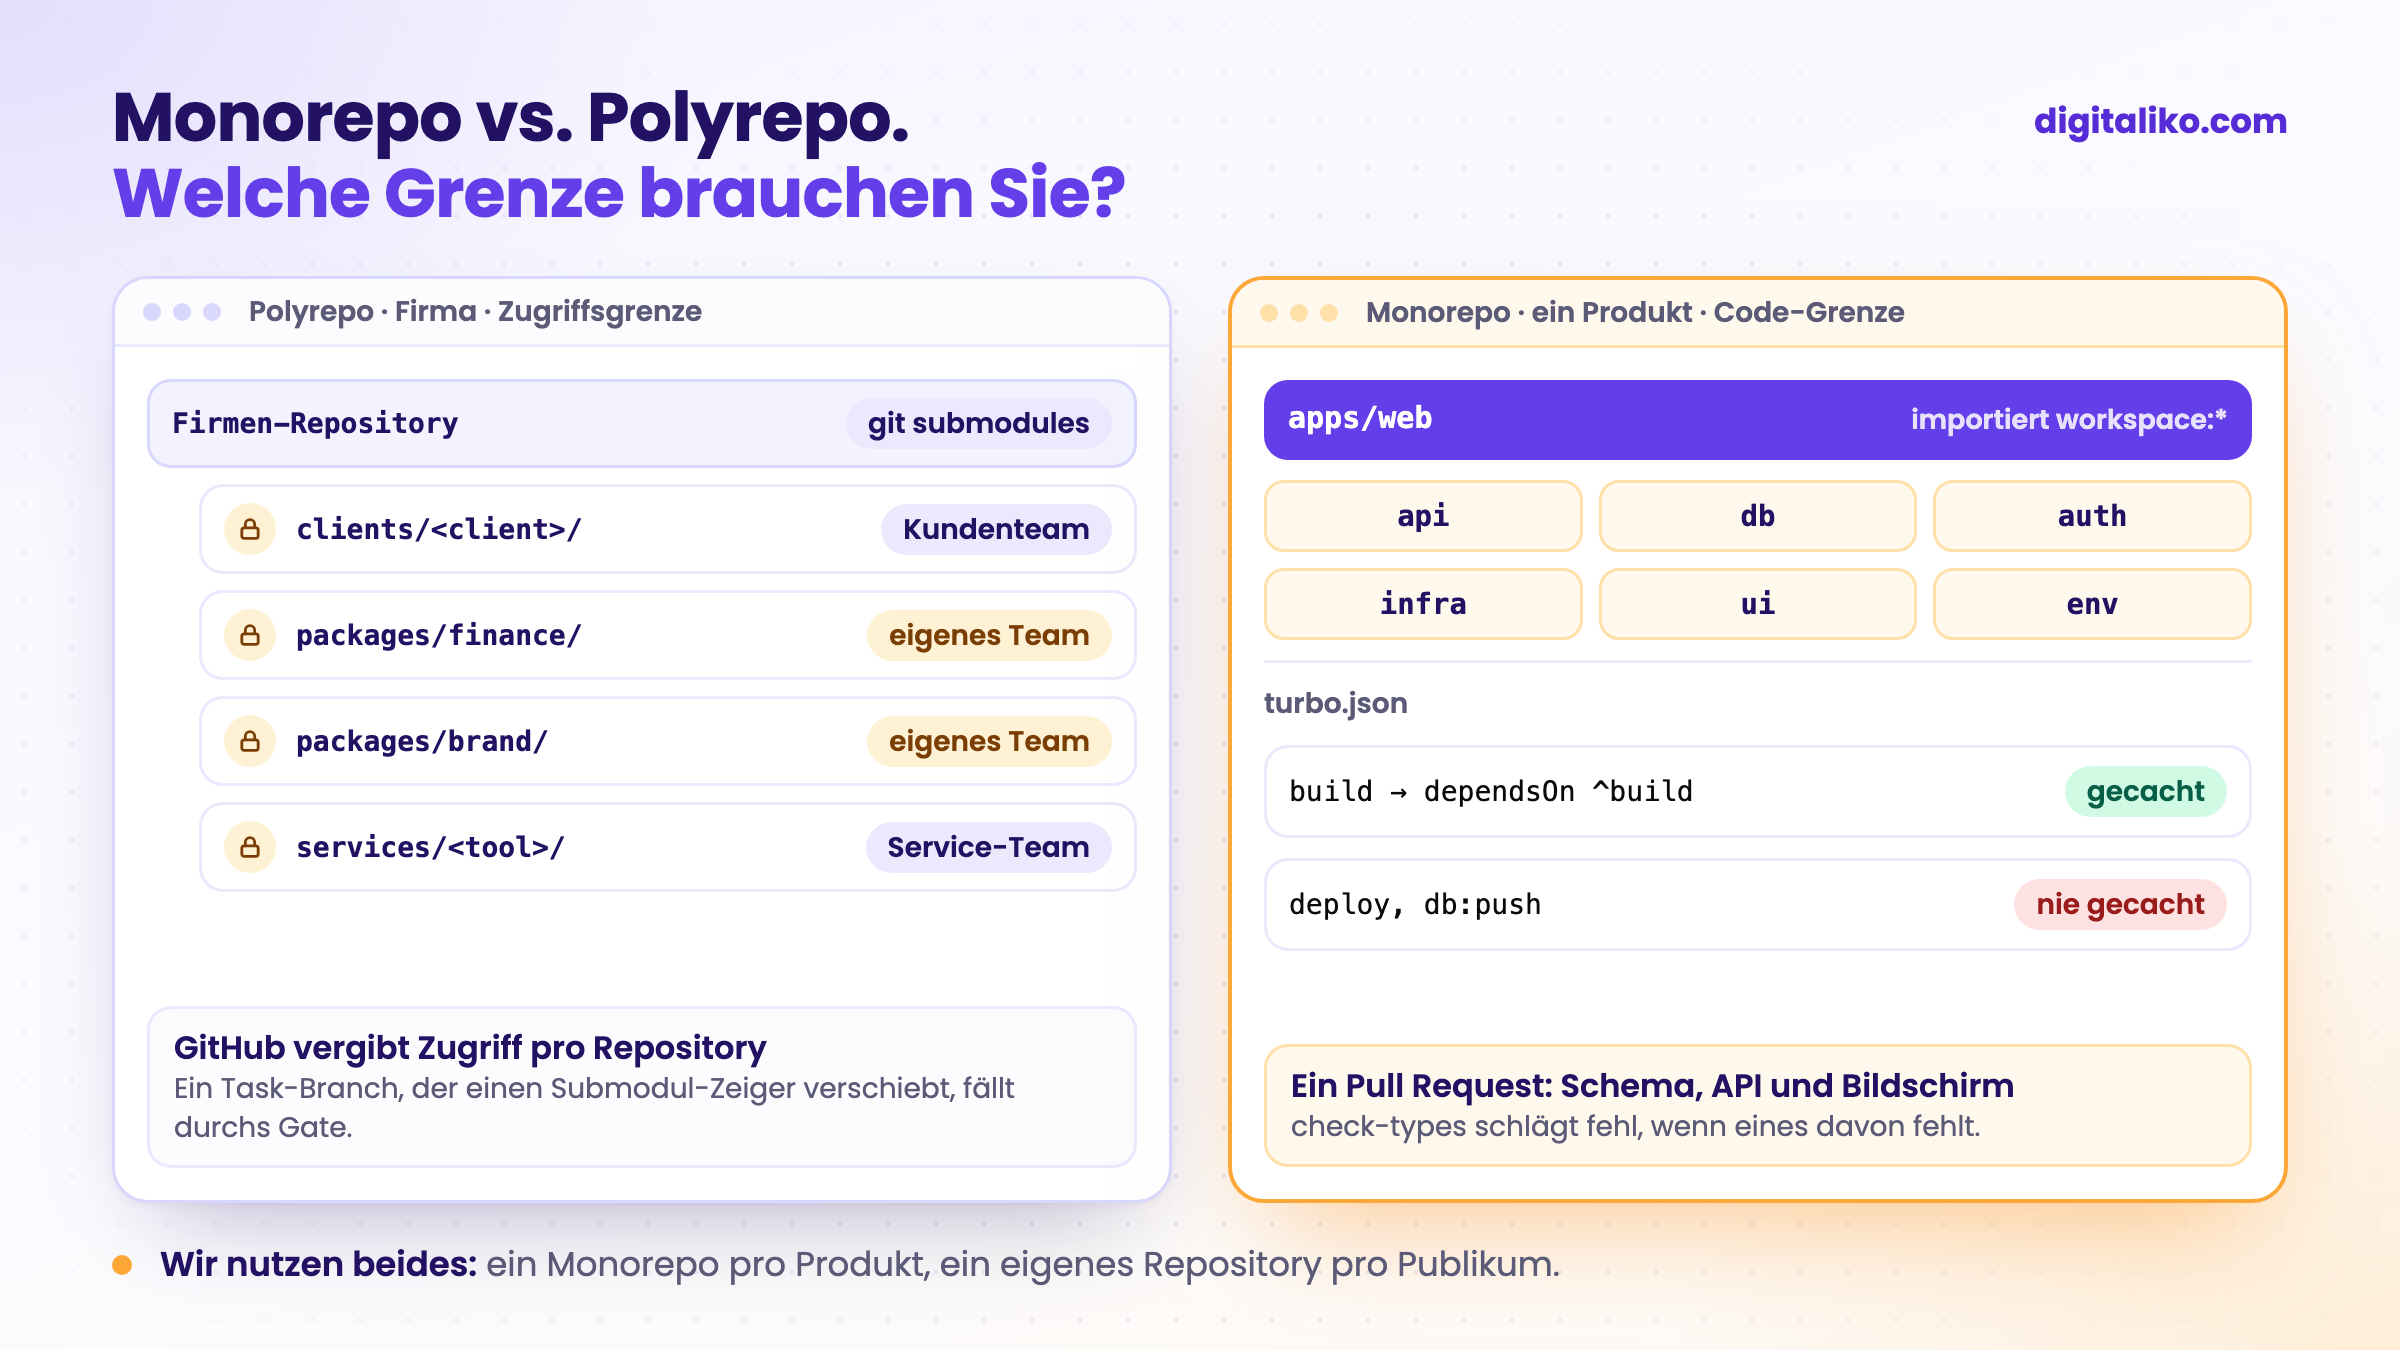
Das kann ein Monorepo nicht leisten. Ein Monorepo mit der Regel „bitte den Finanzordner nicht öffnen“ ist eine Bitte. Ein eigenes Repository mit eigenem Team ist ein Schloss.
Wie arbeitet ein KI-Agent in beiden?
Der Agent folgt denselben wenigen Regeln auf dem Laptop eines Menschen und auf seiner eigenen Maschine:
01
Navigieren, nie klonen
Jedes Repository ist ein Submodul im Baum. Der Agent wechselt nach clients/<x>/ oder services/<y>/, statt anderswo eine zweite Kopie zu klonen.
02
Ein Worktree pro Aufgabe
Jede Aufgabe bekommt einen eigenen Git-Worktree. Ein Kunden-Service liegt verschachtelt in einem Worktree seines Kunden-Repositories, sodass die Session jede CLAUDE.md entlang der Kette lädt.
03
Arbeit in einem Repository
Commits und Pull Requests gehen in das Repository, zu dem die Änderung gehört: Kundenarbeit zum Kunden, Service-Arbeit zum Service.
04
Zeiger separat verschieben
Ein Task-Branch verschiebt nie einen Submodul-Zeiger. Das macht ein eigener Sync-Schritt, nachdem die Arbeit gemergt ist.
Die letzte Regel sichert ein Skript, nicht Vertrauen. Unser Gate lässt einen Task-Branch scheitern, der einen Gitlink ändert, also das Git-Objekt hinter einem Submodul-Zeiger:
moved=$(git diff --raw "$base"...HEAD | awk '$1 ~ /160000/ || $2 == "160000" {print $NF}')
[ -z "$moved" ] || { echo "FAIL submodule pointer changed: pointers move only via sync"; exit 1; }
Ohne das würde ein Agent, der in einer Aufgabe zwei Repositories angefasst hat, den Zeiger im Eltern-Repository still auf einen nicht gemergten Commit setzen. Alle anderen würden dann Code auschecken, den es nur auf einem Branch gibt.
Der verschachtelte Worktree ist das andere Detail, das uns eine Weile gekostet hat. Ein einfacher Worktree eines Service würde die CLAUDE.md des Kunden einen Ordner höher verpassen, und der Agent würde ohne die Regeln des Kunden arbeiten. Liegt der Service in einem Worktree seines Kunden, bleibt die ganze Kontextkette erhalten.
Was kostet ein Polyrepo?
Kostenlos ist es nicht, und wir tun auch nicht so:
- Änderungen über Repositories hinweg brauchen mehrere Pull Requests. Eine Regel, die sich für jeden Kunden ändert, bedeutet einen Pull Request pro Kunden-Repository.
- Submodule haben Ecken und Kanten. Ein frischer Checkout braucht
git submodule update --init, und ein veralteter Zeiger zeigt alten Code ohne jede Warnung. - CI wird oft konfiguriert. Jedes Repository braucht eigene Workflows.
Das Letzte haben wir gelöst, indem wir CI nicht kopieren. Jedes Repository ruft dünne geteilte Actions aus einem Werkzeug-Repository auf, gepinnt auf einen wandernden Major-Tag. Ein neuer Validierungs-Check landet an einer Stelle und erreicht jedes Repository beim nächsten Lauf. Alle laufen auf einem GitHub Actions Self-hosted Runner für die Organisation.
Monorepo oder Polyrepo: Wie entscheidet Ihr Team?
Gehen Sie durch, was heute für Ihren Code gilt:
Als Nächstes kommt meist Turborepo vs. Nx. Ehrliche Antwort: Wir nutzen Turborepo, weil unsere Monorepos TypeScript-Apps auf Bun Workspaces sind und eine kurze turbo.json alles ist, was sie brauchen. Nx haben wir nicht in Produktion betrieben, deshalb ranken wir die beiden nicht.
Wie wir mehrere Agenten parallel mit Worktrees laufen lassen, steht in Claude Code Subagents und Worktrees. Die ganze Schleife vom Issue bis zum Pull Request zeigt Harness Engineering in der Praxis.
Brauchen Sie Repositories, in denen ein Agent sicher arbeiten kann?
Wir richten Repository-Struktur, geteilte CI und Agentenregeln direkt in der Codebasis eines Teams ein im Rahmen von AI-native SDLC für Entwicklerteams. Fehlen Ihrem Team eher Hände als Struktur? Sehen Sie sich einen Senior-Entwickler für Ihr Team an. KI schreibt heute unseren gesamten Code, und ein Senior steht für das Ergebnis gerade. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Wo braucht Ihr Code eine Code-Grenze, und wo eine Zugriffsgrenze?
Kurz gesagt
- Ein Monorepo zieht eine Code-Grenze, ein Polyrepo eine Zugriffsgrenze.
- Jedes unserer Produkte ist ein Turborepo-Monorepo: Ein Pull Request ändert Schema, API und Bildschirm zusammen.
- Die Firma ist ein Polyrepo aus Submodulen, weil GitHub Zugriff pro Repository vergibt.
- Der Agent navigiert statt zu klonen, arbeitet in einem verschachtelten Worktree, und ein Gate blockiert verschobene Submodul-Zeiger.
Häufige Fragen
Was ist der Unterschied zwischen Monorepo und Polyrepo?
Ein Monorepo hält viele Projekte oder Pakete in einem Git-Repository mit einer Historie. Ein Polyrepo gibt jedem Projekt ein eigenes Repository. Im Monorepo ändert ein Commit mehrere Pakete auf einmal. Im Polyrepo hat jedes Repository eigenen Zugriff, eigene CI und eigene Releases.
Wann ist ein Monorepo die bessere Wahl?
Wenn die Teile zusammen ausgeliefert werden und Code teilen: eine Web-App, ihre API, ihr Datenbankschema und ihre UI-Komponenten. Ein Pull Request ändert alle, und die Typen zeigen, was nicht mehr passt, bevor etwas deployt wird.
Wann ist ein Polyrepo die bessere Wahl?
Wenn verschiedene Menschen verschiedene Teile sehen dürfen. GitHub vergibt Zugriff pro Repository, nicht pro Ordner. Kundencode, Finanzen und interne Werkzeuge mit unterschiedlichem Publikum gehören deshalb in verschiedene Repositories.
Turborepo oder Nx?
Wir nutzen Turborepo mit Bun Workspaces, weil unsere Monorepos TypeScript-Apps sind und Turborepo über den Workspaces nur eine kurze turbo.json braucht. Nx haben wir nicht in Produktion betrieben, deshalb können wir beide nicht aus Erfahrung vergleichen.
Kann ein KI-Agent in einem Polyrepo mit Git-Submodulen arbeiten?
Ja, wenn er Regeln hat. Unserer navigiert in das Submodul, statt eine Kopie zu klonen, arbeitet pro Aufgabe in einem eigenen Worktree, und ein Gate blockiert jeden Task-Branch, der einen Submodul-Zeiger verschiebt.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity