Harness Engineering in der Praxis: vom Issue zum PR
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer von Digitaliko
Harness Engineering ist der Code um einen KI-Agenten, der entscheidet, welche Aufgabe er übernimmt, wann die Arbeit als fertig gilt und wer sie prüft. Das Modell macht nur die Arbeit. Ein KI-Agent, der Code schreibt, ist billig. Teuer ist ein Agent, dessen Pull Requests Ihre Seniors mergen können, ohne sie neu zu machen, und genau diese Lücke schließt der Harness.
Wir betreiben so einen Loop jeden Tag auf unseren eigenen Repositories. KI schreibt heute unseren gesamten Code, und ein Senior steht für das gerade, was in Produktion geht. Hier steht, wie der Loop funktioniert, welche Codezeilen ihn tragen und was unterwegs kaputtging.
Ich baue so viele Hindernisse um KI-Agenten, dass ihnen nur ein Weg bleibt. Der richtige.

Was bedeutet Harness Engineering in der Praxis?
Ein Agent ist ein Modell plus sein Harness, der Rahmen, in dem er arbeitet. Das Modell mieten Sie. Der Harness gehört Ihnen: Regeln, Kontext, Checks, Limits und die Übergabe an einen Menschen. Woraus ein Harness besteht, steht in Was ist ein Agent-Harness? Agent = Modell + Rahmen. Dieser Artikel ist die Praxis: ein Loop, der jeden Tag läuft.
Unsere einzige Designregel steht ganz oben im Dispatcher-Skript:
# Deterministic on purpose: code decides WHAT to take and WHEN it is done, models only do the work.
Daraus folgen drei Dinge:
- Code wählt die Arbeit. Ein Bash-Dispatcher liest die dem Agenten zugewiesenen GitHub-Issues, sortiert nach Prioritätslabel. Kein Modell entscheidet, was startet.
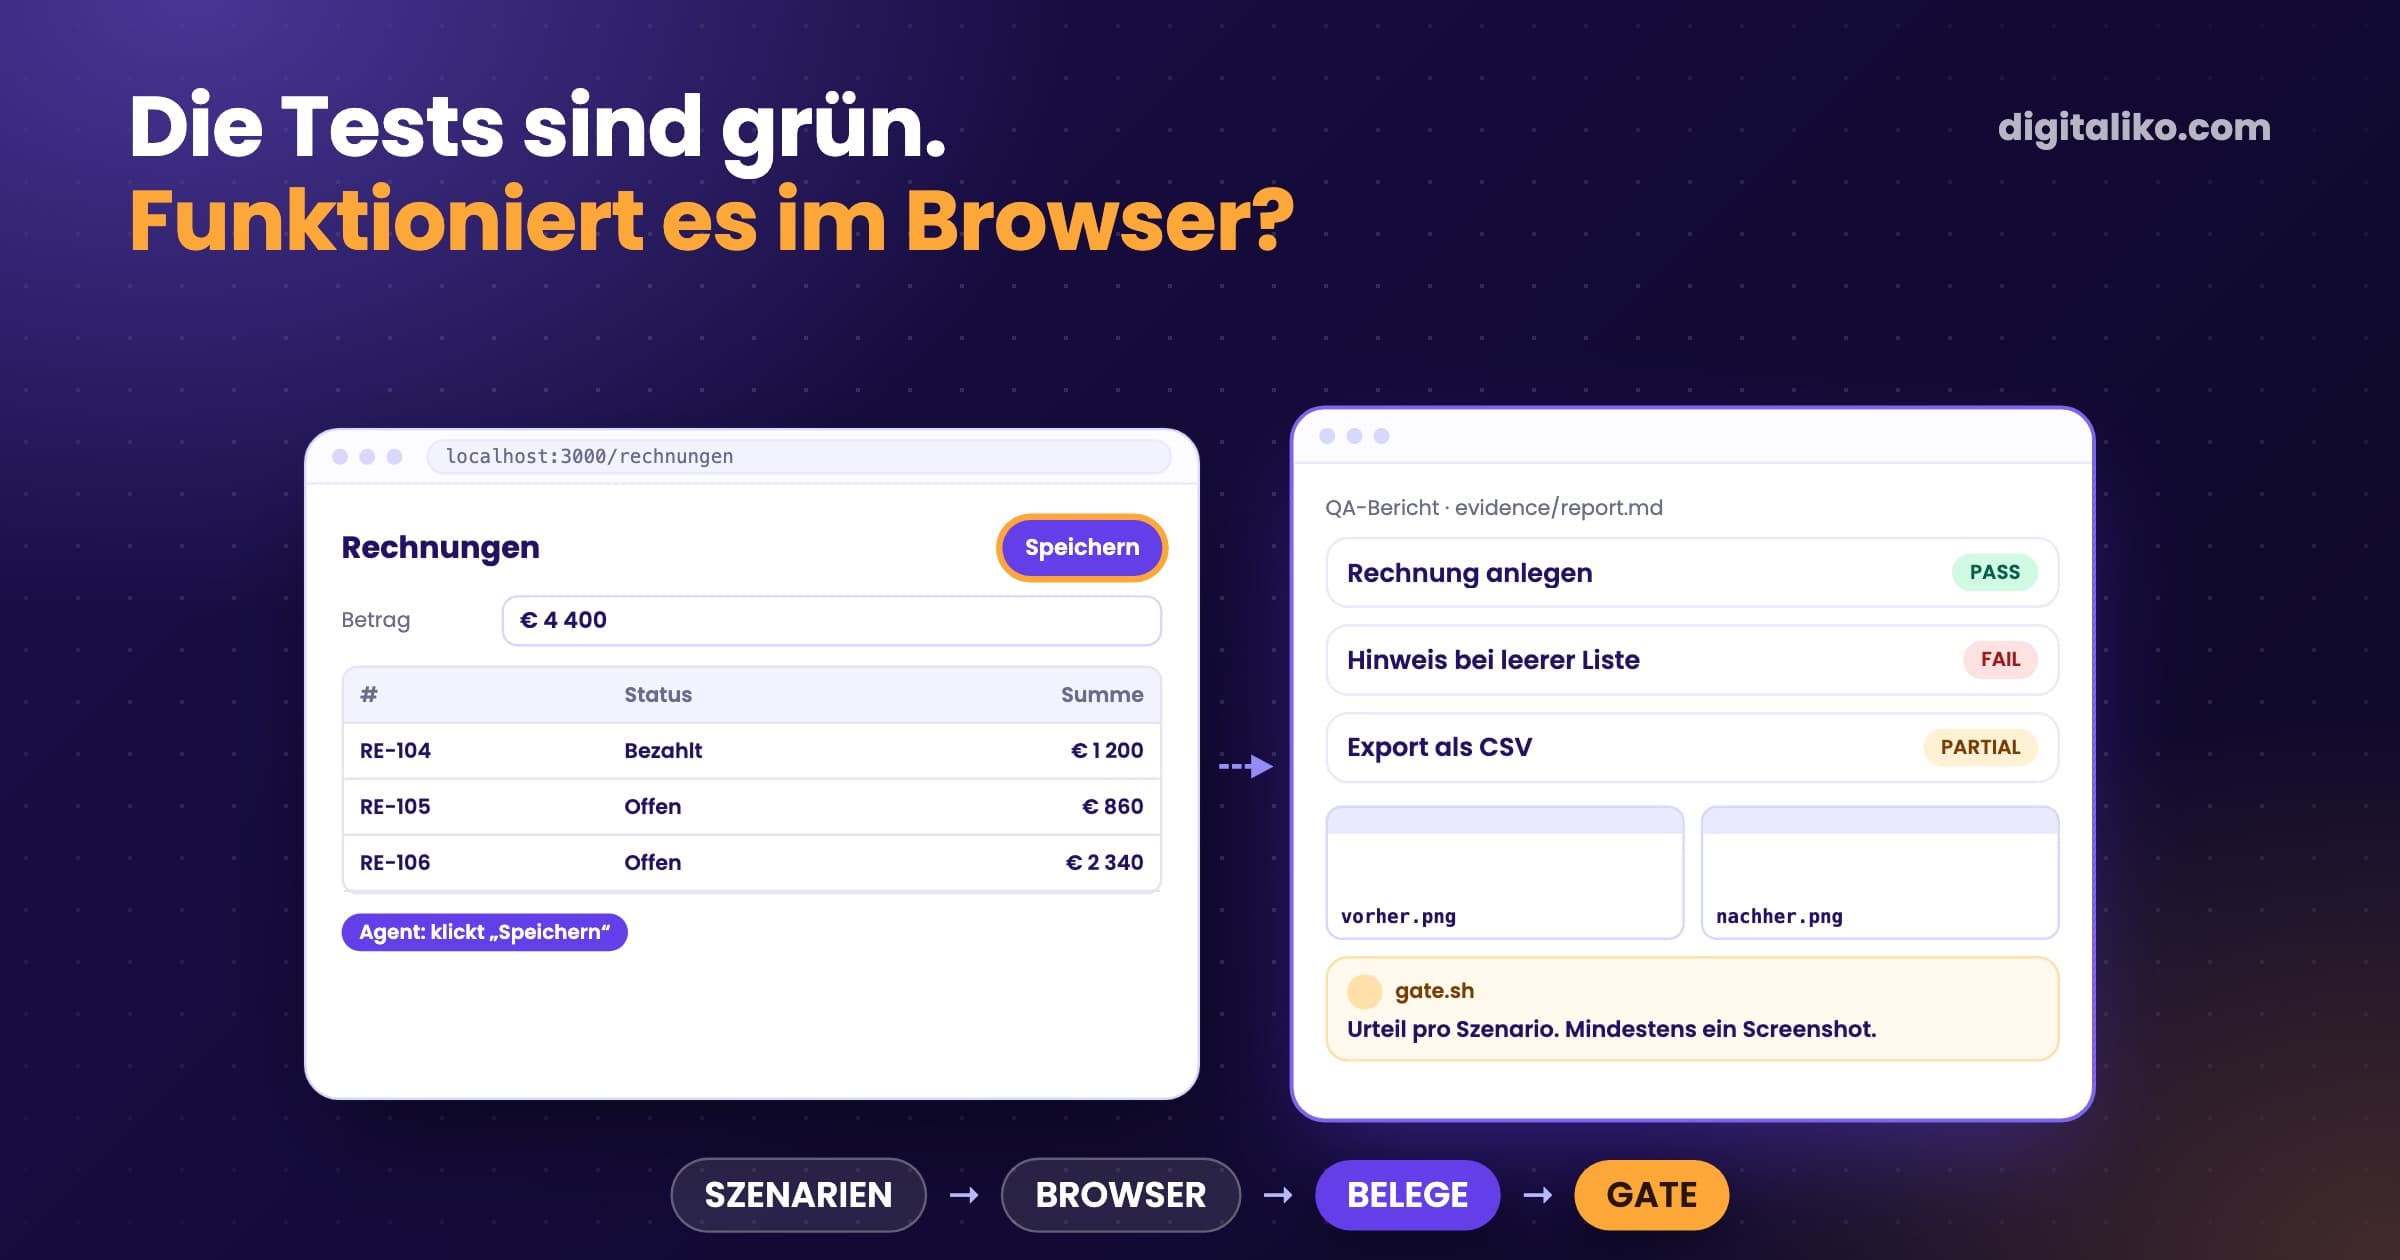
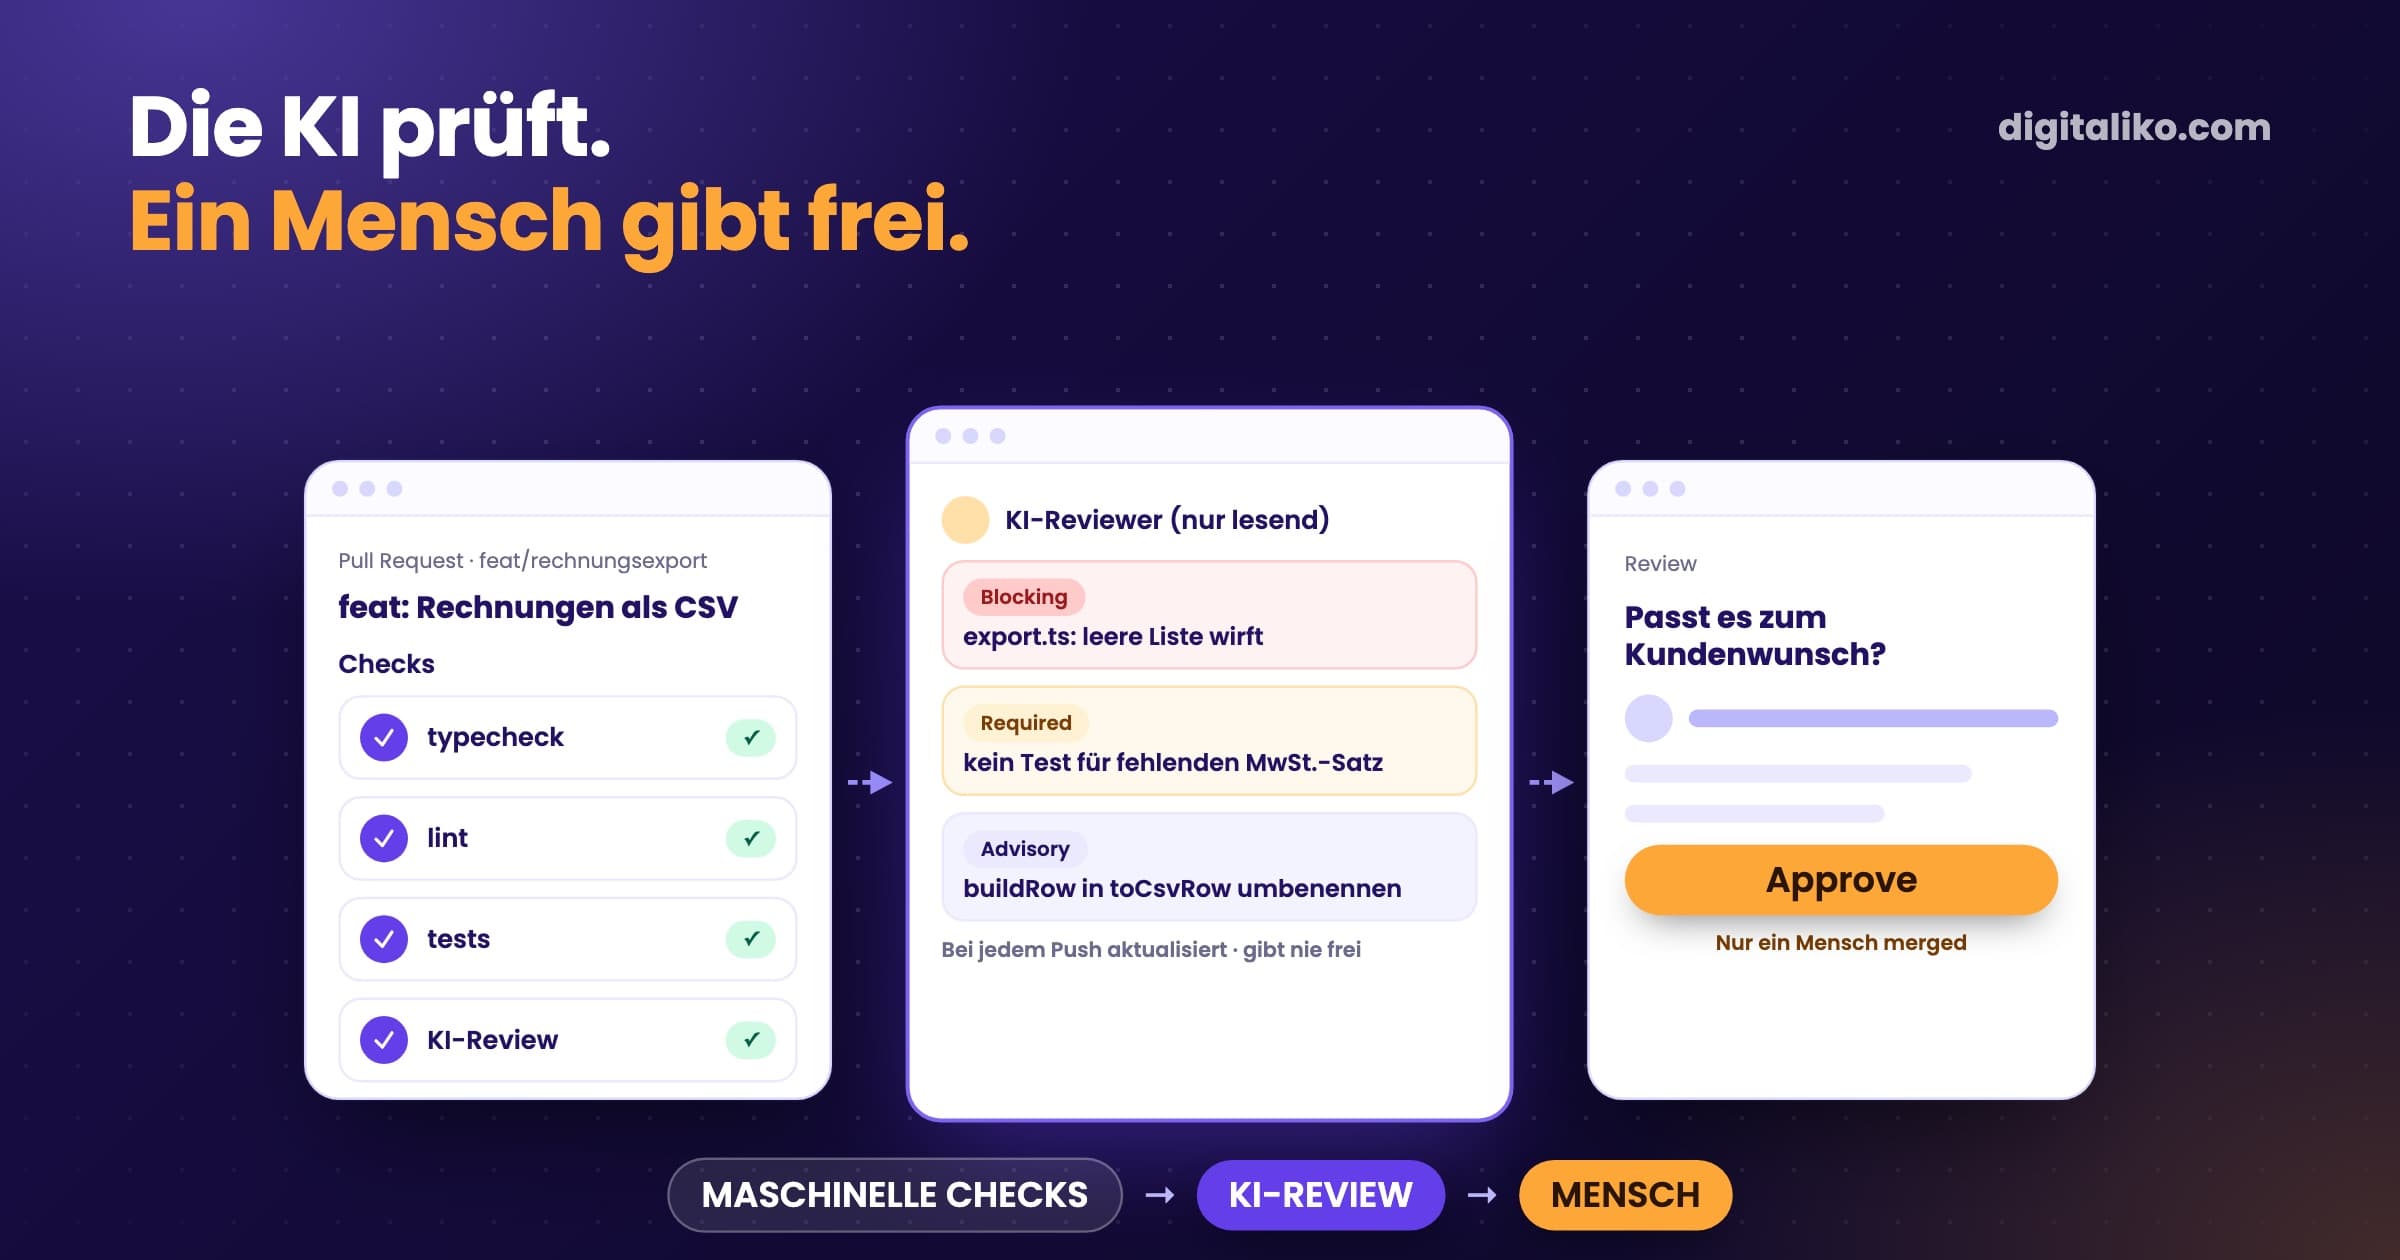
- Zuerst ein maschineller Check. Typecheck, Lint, Tests und unser eigenes Gate laufen, bevor ein Modell eine Meinung hat.
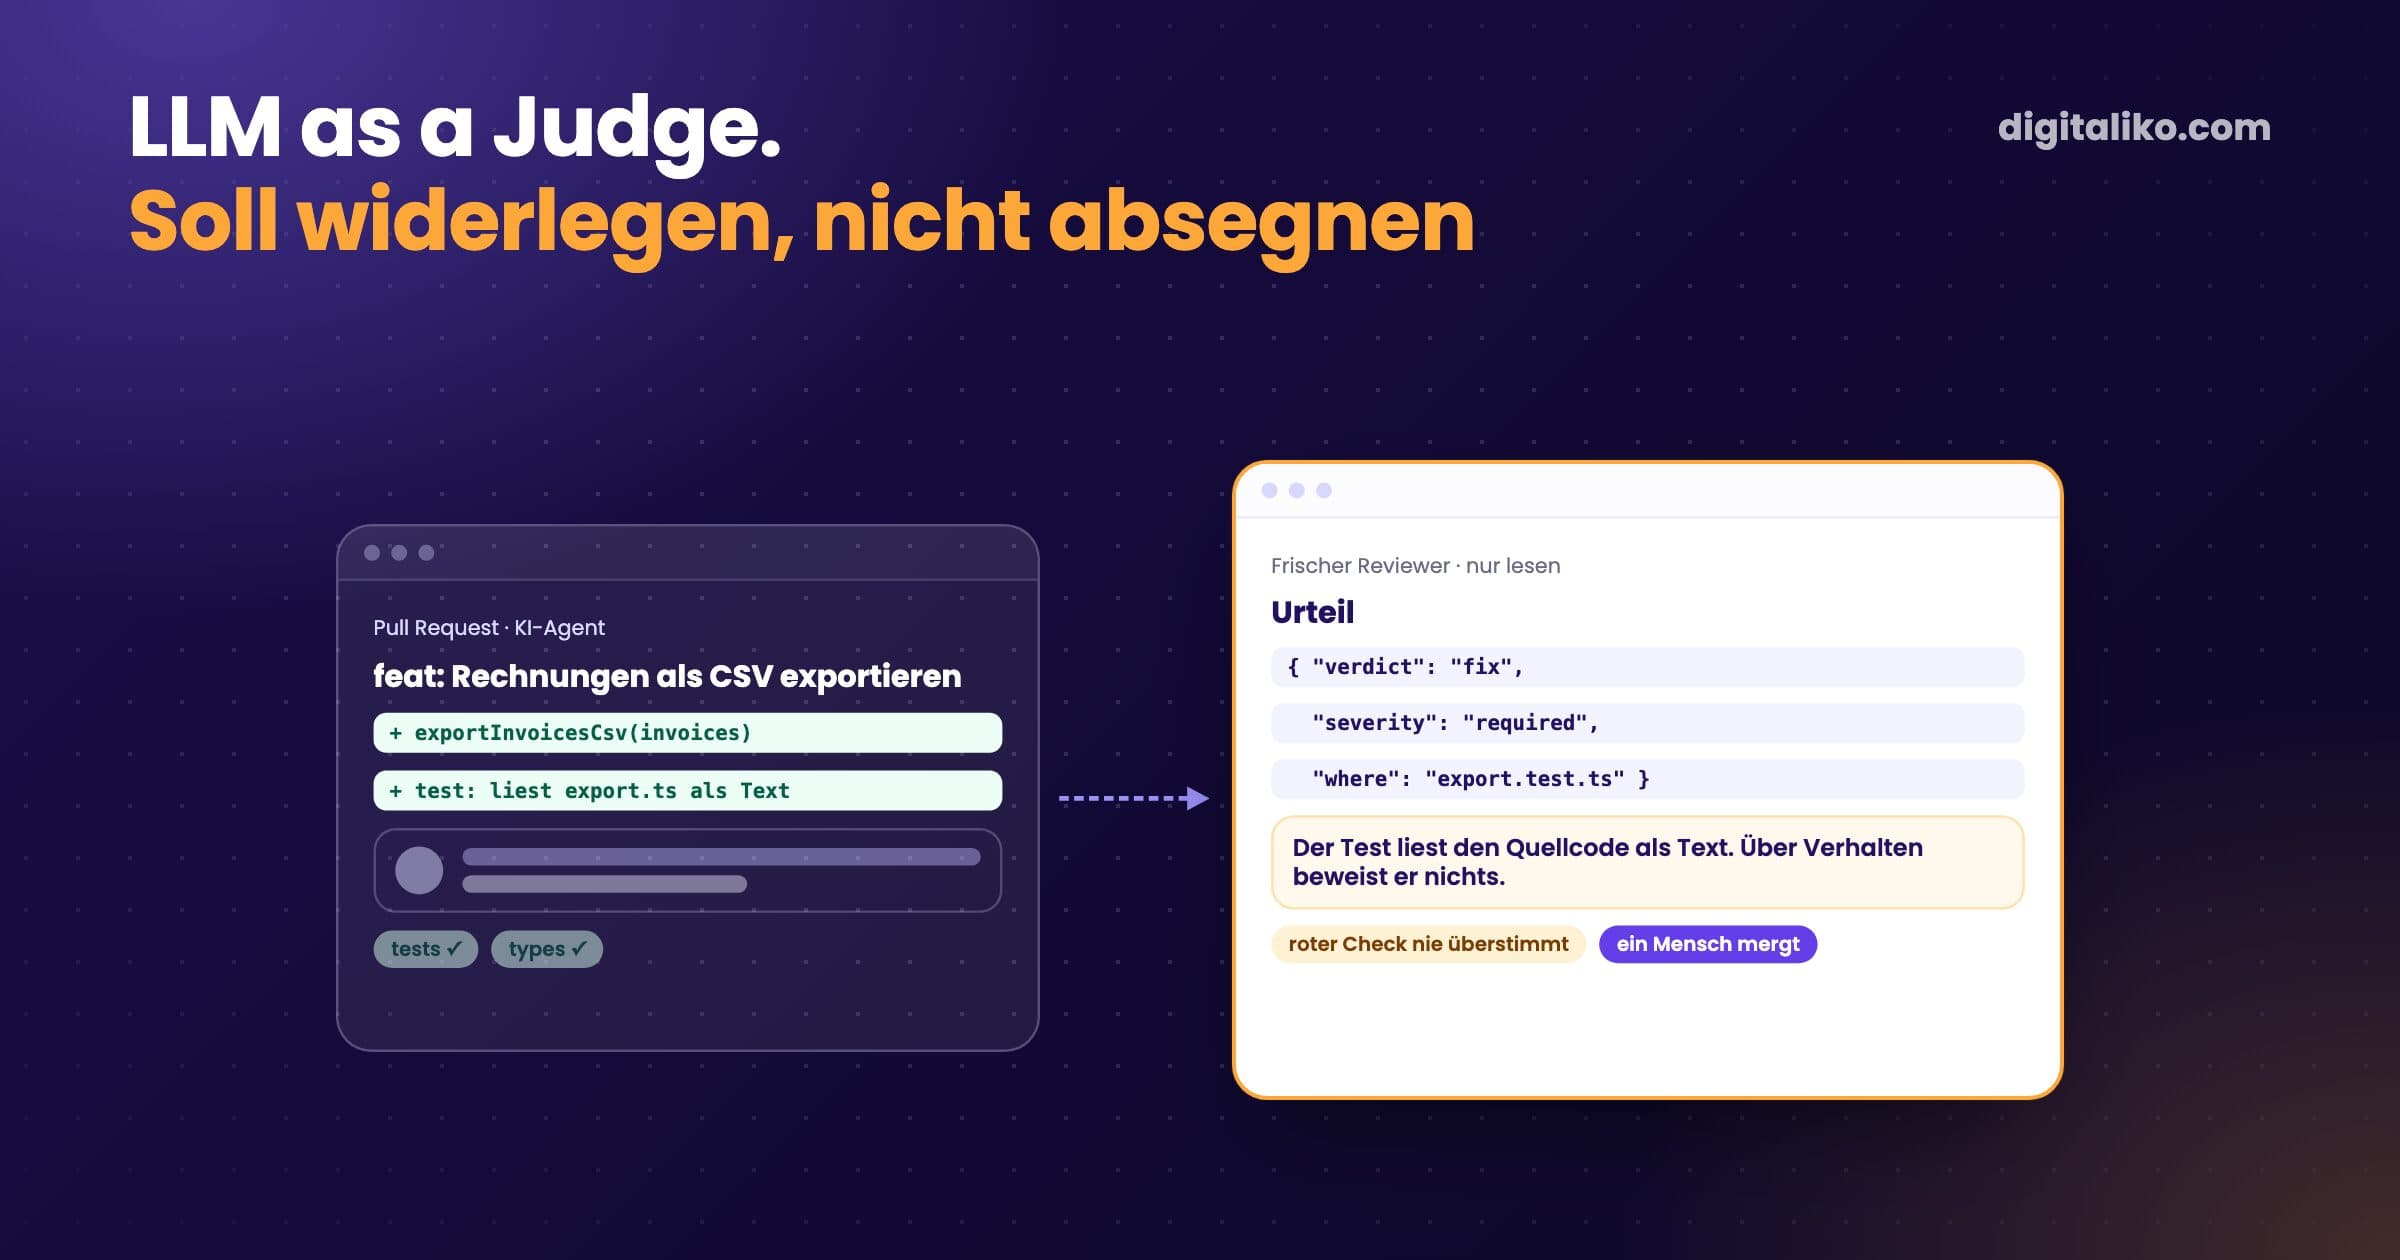
- Wer die Arbeit gemacht hat, bewertet sie nie. Ein frischer Modellaufruf, der nur lesen darf, prüft das Ergebnis.
Was macht ein Entwickler, wenn der Agent den Code schreibt?
Bei uns begann es mit einer kleineren Aufgabe, die der Agent bis zum Merge gebracht hat. Da haben wir uns gefragt, was ein Entwickler heute eigentlich tut.
Code schreiben wir nicht mehr. Wir sorgen dafür, dass das Ergebnis wirklich funktioniert. Und wir lösen die größeren Probleme, mit Abstand, nicht Zeile für Zeile.
Heute schreibt KI unseren gesamten Code. Deshalb konzentrieren wir uns nicht darauf, wie sie schreibt, sondern darauf, was wir erreichen wollen und wie sie beweist, dass es funktioniert.
In der Praxis sind das vier Schritte:
01
Plan
Ziel, wann es fertig ist, Fälle und Tests. Erst dann Code.
02
Feste Regeln
Tests, Typen, Architektur, was der Agent darf und was nicht. Solange sie nicht bestehen, geht die Änderung nicht weiter.
03
Review durch einen anderen Agenten
Wer den Code geschrieben hat, bewertet ihn nicht.
04
Am Ende ein Mensch
Er liest nicht jede Zeile. Er prüft, ob die Lösung konzeptionell passt.
Wie bringt unser Loop ein Issue zum PR?
Ein Issue pro Lauf: ein Git-Worktree, ein Branch, eine Claude-Code-Session, ein Pull Request.
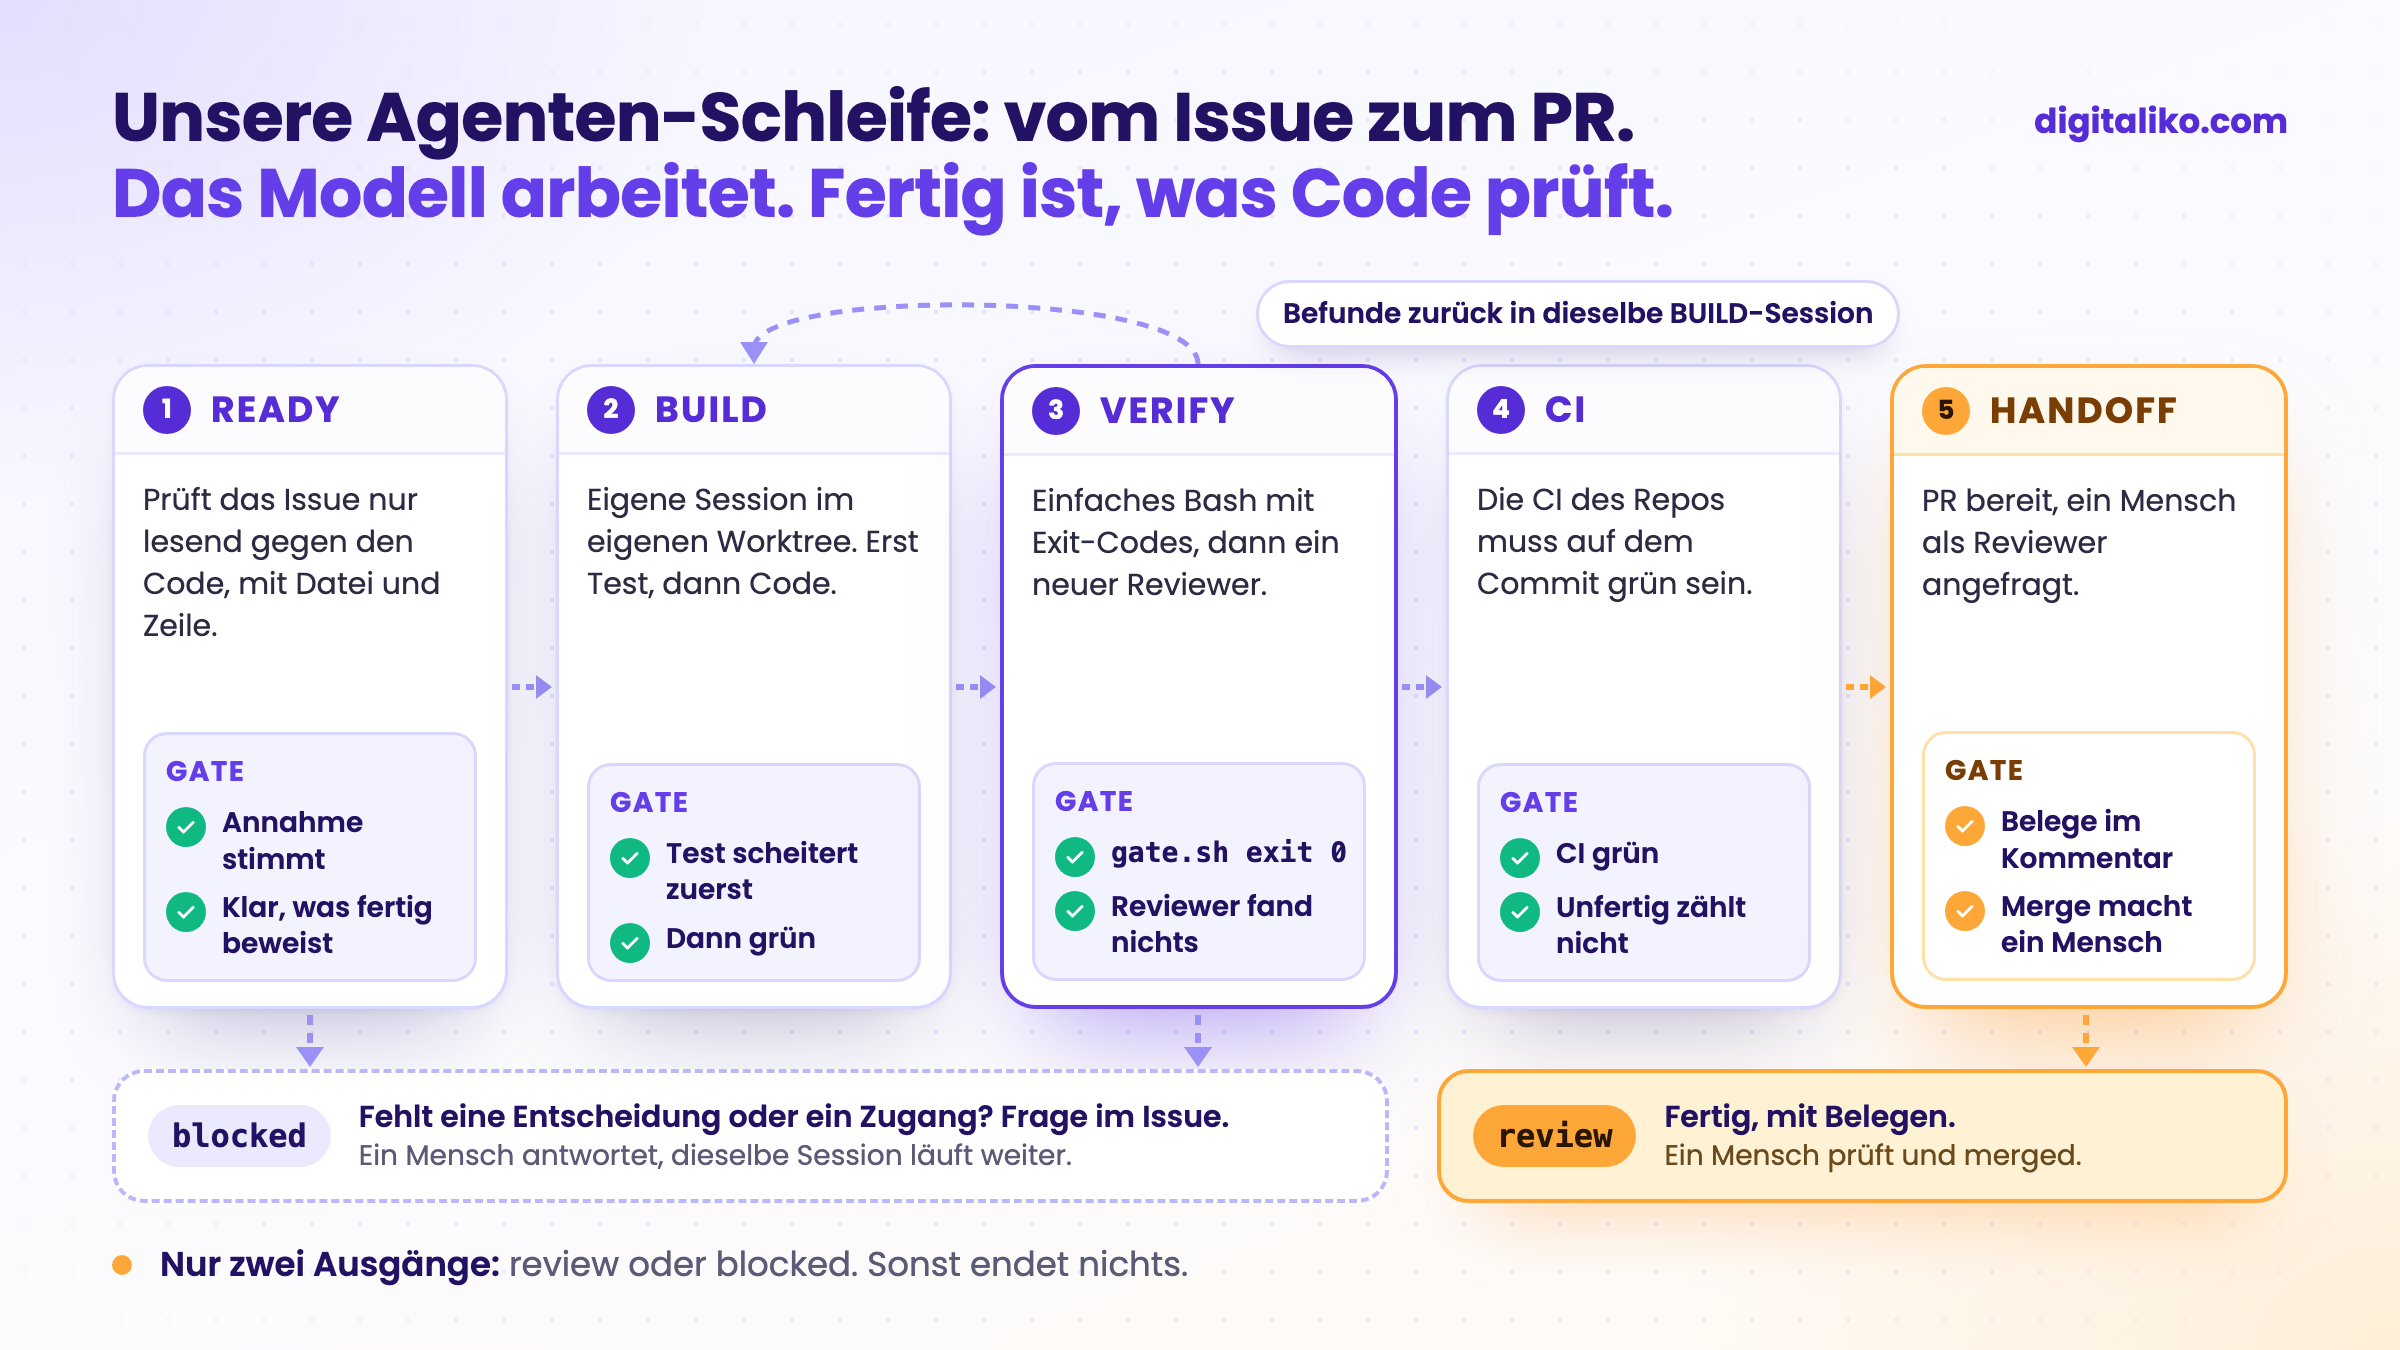
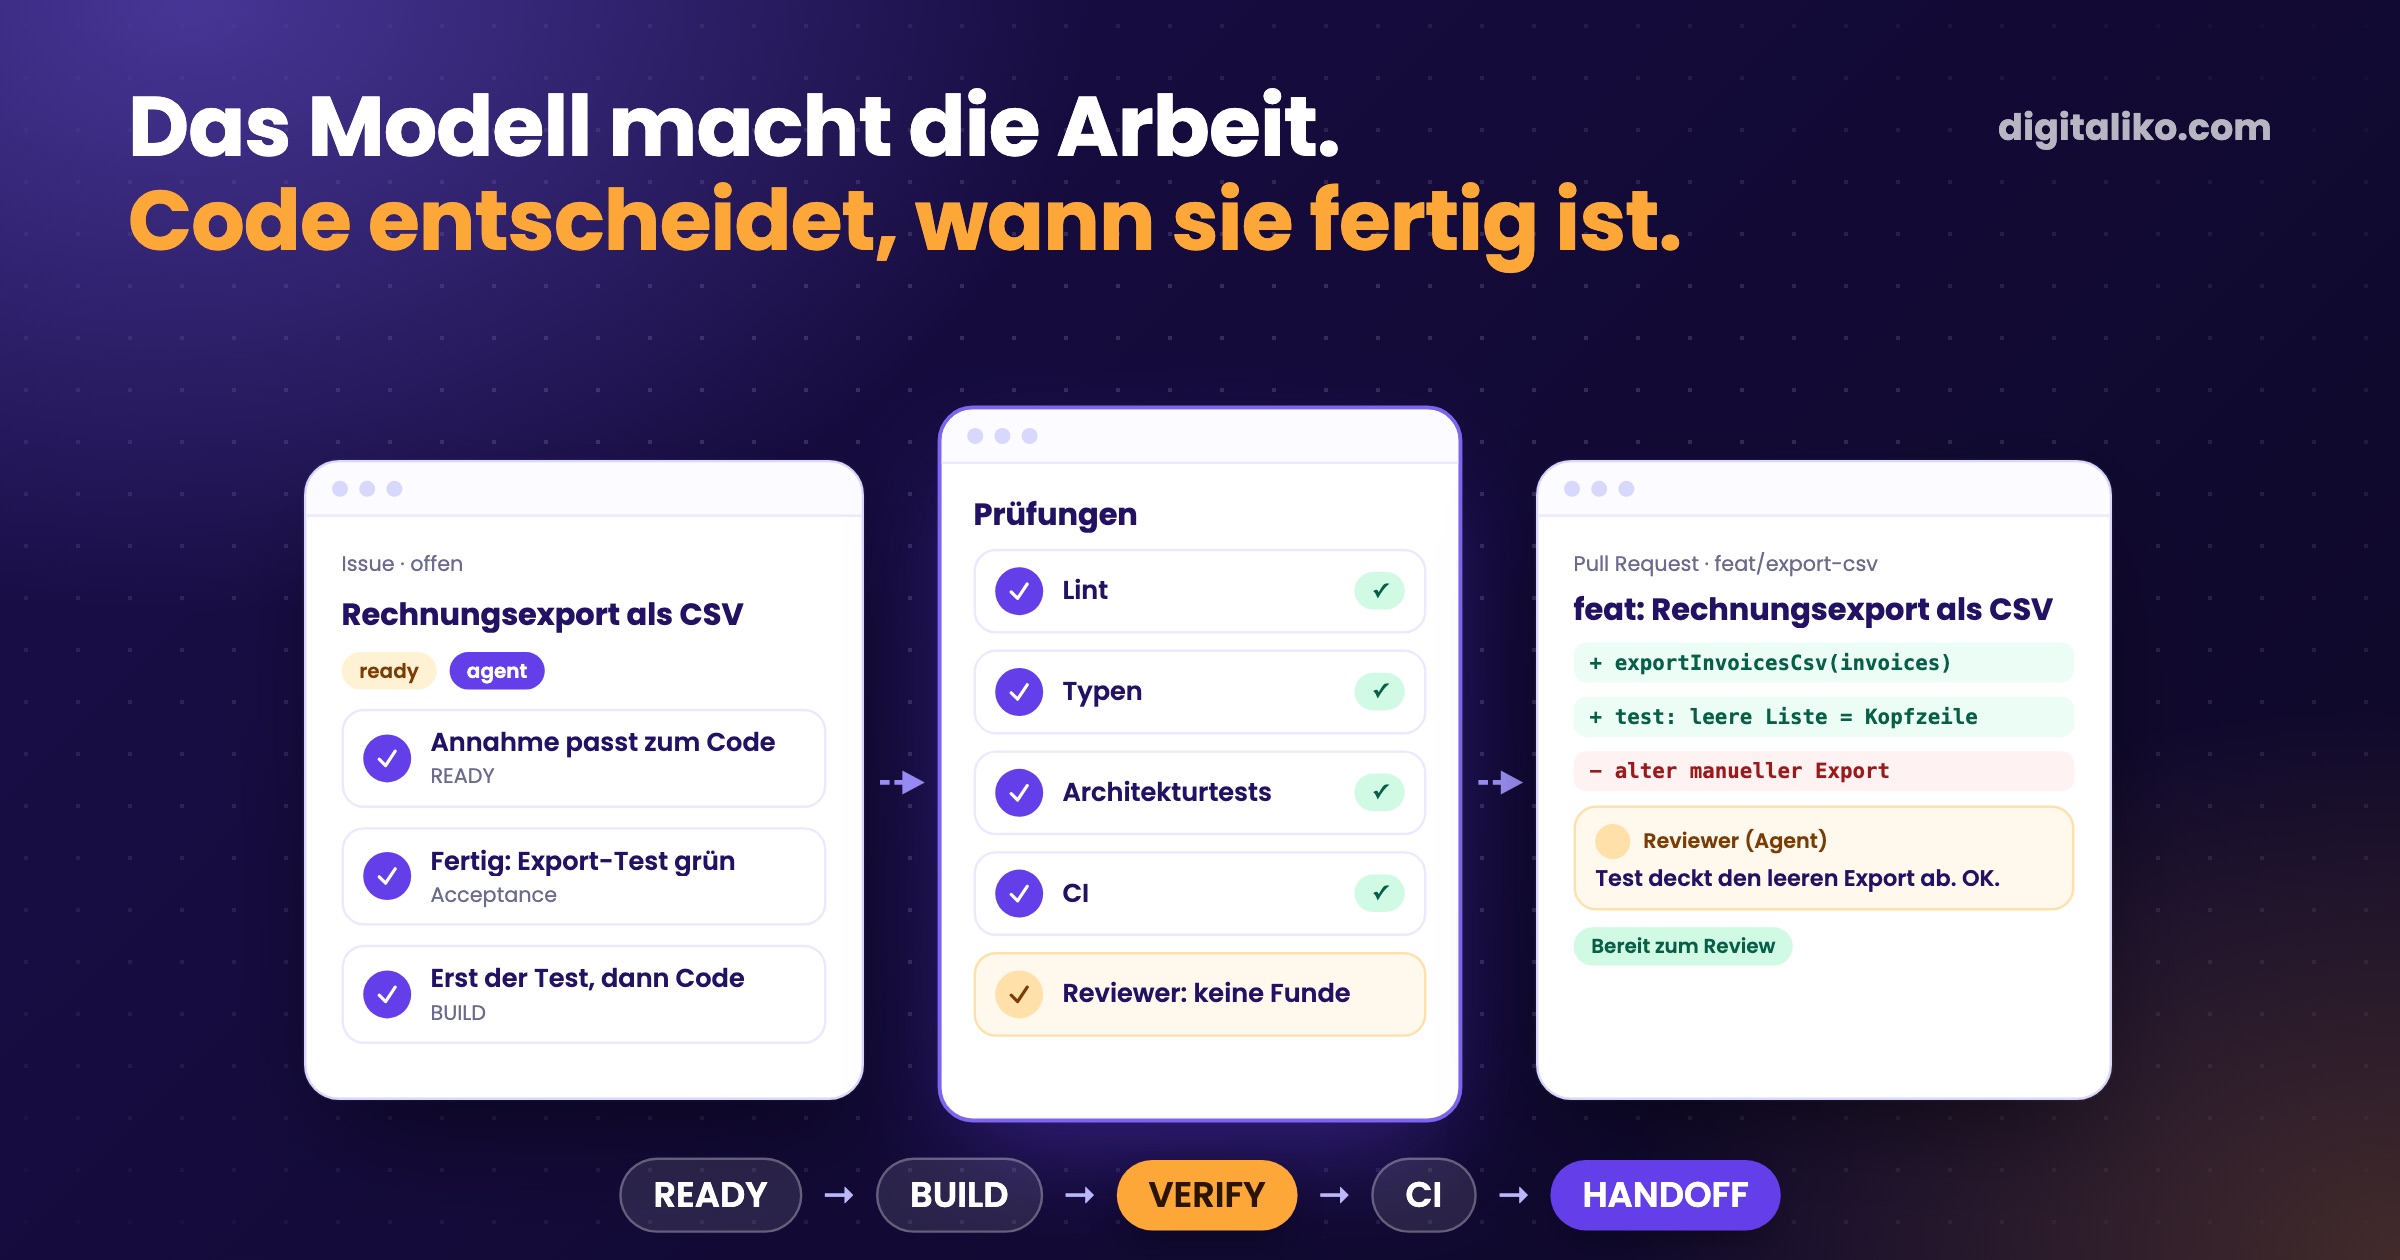
- READY. Ein Modellaufruf nur mit Lesezugriff prüft das Issue gegen den Code, bevor etwas startet. Stimmt die Annahme, mit Datei und Zeile? Welcher Aufgabentyp ist es? Was beweist, dass es fertig ist: ein Test oder nur ein Mensch, der hinschaut? Fehlt eine Entscheidung, fragt der Agent im Issue und stoppt.
- BUILD. Eine Claude-Code-Session im Hintergrund erledigt die Arbeit in ihrem eigenen Worktree. Bei Code schreibt sie zuerst einen Test, der auf dem unveränderten Code fehlschlägt, und implementiert erst dann.
- VERIFY. Zwei Schichten. Zuerst
gate.sh, schlichtes Bash mit Exit-Codes. Dann ein frischer Reviewer, dessen einzige Aufgabe es ist, die Arbeit zu widerlegen. Seine Befunde gehen zurück in dieselbe BUILD-Session. - CI. Die eigene CI des Repositorys muss auf dem gepushten Commit grün sein. Ein Check, der auch auf dem Hauptzweig fehlschlägt, wird als bestehender Fehler gemeldet, nicht dem Branch angelastet.
- HANDOFF. Der PR wird als bereit markiert, ein Mensch wird als Reviewer angefragt, und ein Kommentar enthält die Belege.
Es gibt nur zwei Ausgänge: review (fertig, mit Belegen) oder blocked (eine Frage auf GitHub). Wenn ein Mensch antwortet und blocked entfernt, läuft dieselbe Session mit vollem Kontext weiter.
Welche Codezeilen tragen den Loop?
Drei kurze Stücke erledigen den Großteil.
Jeder Modellaufruf liefert eine typisierte JSON-Antwort. Keine Antwort heißt Fehler, nie ein Standardwert. Gekürzt:
# one read-only model call with a typed answer; no object back = failure, never a default
ask() {
    ( cd "$tree" && claude -p "$prompt" --tools "Read,Grep,Glob,WebFetch" \
        --json-schema "$(cat "$schema")" --output-format json ) > "$out.raw"
    jq -e 'select(.subtype == "success") | .structured_output // empty' "$out.raw" > "$out" && [ -s "$out" ]
}
Einen roten maschinellen Check kann niemand grün reden:
verdict=$(jq -r .verdict "$R/verify-$round.json")
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix   # a red executable check is never overruled to pass
Und ein Loop, der nicht vorankommt, stoppt. Meldet der Reviewer denselben Befund zweimal hintereinander, geht die Aufgabe mit diesem Befund an einen Menschen. Eine weitere Runde würde ihn nicht beheben.
Noch ein Detail: Nicht vertrauenswürdiger Text bekommt einen Zaun. Issue-Texte und PR-Kommentare erreichen das Modell als Daten markiert, nicht als Anweisungen, und HTML-Kommentare werden vorher entfernt. Genau dort verstecken sich eingeschleuste Anweisungen gern.
Warum reichen einem Agenten Regeln im Text nicht?
Bis vor Kurzem hatte der Agent seine Regeln nur in Rules-Dateien. Manchmal hat er sie nicht eingehalten. Also haben wir daraus Prüfungen gemacht, die sich nicht umgehen lassen: ESLint, Architekturtests, Typprüfung vor dem Push und alles noch einmal in der CI.
Einen Text kann der Agent auslegen, wie er will. Eine Prüfung nicht.
Jedes weitere Gate macht den Weg enger: Architekturtests, eine Prüfung, ob der Code vollständig ist, Pflichtdateien. Je mehr Gates, desto weniger kann der Agent ausweichen. Es bleibt nur der erlaubte Weg.
Das hat auch einen Nebeneffekt:
Die Projekte, an denen ich heute arbeite, haben mehr Tests, als ich je gesehen habe.
Wo kommt ein Mensch ins Spiel?
An drei Stellen und sonst nirgends:
| Moment | Was der Mensch tut |
|---|---|
| Start | Weist das Issue zu. Das ist die Freigabe. |
| Frage | Antwortet im Issue und entfernt blocked. |
| Übergabe | Reviewt und merged. Nur ein Mensch merged. |
Der Engpass ist das Review, nicht der Agent. Deshalb startet der Dispatcher keine neue Aufgabe, solange Agenten-PRs auf Menschen warten. Eine laufende Aufgabe darf weitermachen. Merge, Push auf main, Versand und Deployment sind unterhalb des Agenten blockiert, in Hooks, die er nicht bearbeiten kann.
Was ist unterwegs kaputtgegangen?
Mehr als erwartet. Diese Fälle sollte man kennen:
- Der Dispatcher hat still aufgehört, Aufgaben zu starten. Eine Änderung am Review-Limit setzte eine Zählung zwischen
jq |undwhile read. Die Schleife las danach leere Eingaben, und keine Aufgabe startete. Nichts schlug fehl, nichts alarmierte. Ein Audit fand es. Der Fix kam mit einem Dispatcher-Test gegen ein gestubbtesgh, rot auf dem alten Code und grün auf dem neuen. - Infrastrukturfehler landeten als
blockedbei einem Menschen. Eine Session, die in den ersten Minuten starb, war ein fehlender Login oder Token, keine schlechte Arbeit. Jetzt wird sie beim nächsten Lauf erneut versucht. - CI, die nie fertig wurde, galt als grün. Jetzt ist das eine Rückgabe an einen Menschen. Nicht fertig ist nicht bestanden.
- Der Readiness-Check kam spät. Die Prüfung der Annahme gegen den Code haben wir erst später ergänzt. Heute ist sie die erste Stufe, und dort würden wir anfangen.
Am schwersten ist meist der letzte Schritt: prüfen, dass es wirklich von Anfang bis Ende funktioniert. Gates und echte Tests. Die meiste Arbeit macht es, die Umgebungen abgestimmt zu halten, damit die Prüfungen immer laufen. Ein Trick hat sich bewährt: Wir schicken einen Agenten als Kundentyp, als Persona, in die Funktion, damit er sie selbst erkundet.
Vor diesem Loop haben wir zwei andere Formen probiert. Eine war eine labelgesteuerte Pipeline aus GitHub-Actions-Workflows. Die andere waren einmalige @claude-Erwähnungen in Issues. Beides haben wir gelöscht. Zustandslose CI-Jobs passen schlecht, wenn der Arbeiter eine Session fortsetzen und mitten in der Aufgabe einen Menschen fragen muss.
Wo widersprechen wir dem, was über Harness Engineering geschrieben wird?
Die meisten Texte drehen sich um Tools. Aus unserer Sicht entscheidet, wo im Prozess ein Mensch steht.
Lässt sich das im eigenen Team betreiben?
Beginnen Sie mit den Qualitäts-Gates. Hat Ihr Team keine, fangen Sie dort an. Unser Loop READY → BUILD → VERIFY → CI → HANDOFF ist einfach und funktioniert. Jedes System braucht aber einen etwas anderen.
Der Loop selbst hängt an unserem Setup. Die wichtigsten Teile nicht. Wir haben sie als kleines öffentliches Repository veröffentlicht: den Claude Code Production Starter. Er enthält Agentenregeln, Hooks, die gefährliche Befehle stoppen, einen Stop-Hook, der „fertig“ blockiert, solange Checks rot sind, und ein CI-Gate mit Red-Proof-Tests. MIT-Lizenz. Klonen, Werkzeuge behalten, App ersetzen.
Was davon hat Ihr Team schon?
Was in die Regeln gehört, die so einen Harness füttern, steht in Regeln für KI-Code im Team. Wann dem Team der Planungsmodus des Agenten reicht, steht in Claude Code Plan Mode.
Möchten Sie so einen Harness in Ihrem Repository?
Wir bauen diese Art Loop direkt im Repository eines Teams im Rahmen von AI-native SDLC für Entwicklerteams. Fehlen Ihrem Team eher Hände als Regeln? Sehen Sie sich einen Senior-Entwickler für Ihr Team an. Seit 2023 haben wir 15+ Produktionsprojekte geliefert. Ein Senior arbeitet ab dem ersten Tag in Ihrem Repository und Ihren Pull Requests.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Was macht Ihr Agent heute, wenn er unsicher ist: fragen oder raten?
Kurz gesagt
- Die Arbeit macht das Modell. Was der Agent nimmt und wann es fertig ist, entscheidet Code.
- Zuerst maschinelle Checks, dann ein frischer Reviewer, der den Code nicht geschrieben hat.
- Ein Mensch kommt dreimal ins Spiel: Er weist das Issue zu, beantwortet eine Frage, reviewt und merged.
- Beginnen Sie mit den Qualitäts-Gates. Ergänzen Sie den Loop, wenn eine Session pro Aufgabe nicht mehr reicht.
Häufige Fragen
Was bedeutet Harness Engineering in der Praxis?
Der Bau des Codes um einen KI-Agenten: welche Aufgabe er übernimmt, welche Werkzeuge und Regeln er bekommt, was seine Arbeit prüft und wann ein Mensch übernimmt. Das Modell macht die Arbeit. Der Harness entscheidet, wann sie als fertig gilt.
Was ist ein Agent Harness?
Die feste Schleife, in der ein KI-Agent läuft. Unsere ist ein Bash-Dispatcher mit Runner. Er liest GitHub-Issues, startet pro Issue eine Claude-Code-Session, führt ausführbare Checks und einen frischen Reviewer aus und übergibt dann einen PR an einen Menschen.
Warum nicht eine lange Agenten-Session selbst entscheiden lassen, wann sie fertig ist?
Weil der Agent, der die Arbeit gemacht hat, sie zu milde bewertet. In unserem Loop entscheidet Code, wann die Arbeit fertig ist: zuerst Exit-Codes, dann ein Reviewer, der den Code nicht geschrieben hat und ihn nicht ändern kann.
Merged der Agent seine Pull Requests selbst?
Nein. Nur ein Mensch merged. Merge, Push auf den Hauptzweig, Versand und Deployment sind durch Hooks unterhalb des Agenten blockiert, die er nicht ändern kann.
Brauche ich für den Anfang Ihr ganzes Setup?
Nein. Starten Sie mit dem öffentlichen Claude Code Production Starter: Agentenregeln, Hooks, ein Stop-Hook und ein CI-Gate mit Red-Proof-Tests. Ergänzen Sie einen Loop, wenn eine Agenten-Session pro Aufgabe nicht mehr reicht.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity