Spec-driven Development mit KI-Agenten: unser Issue-Vertrag
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer von Digitaliko
Spec-driven Development heißt: Sie schreiben auf, was gebaut wird und woran Sie erkennen, dass es fertig ist, bevor ein KI-Agent die erste Zeile Code schreibt. GitHubs Spec Kit fasst es so zusammen: „Define what to build and why, then turn the specification into a plan, tasks, and working code.“ Also: Definieren Sie, was und warum, und machen Sie aus der Spezifikation Plan, Aufgaben und funktionierenden Code. Wir nutzen eine leichtere Version: Die Spezifikation ist ein GitHub Issue mit Aufgabentyp und Abnahmekriterien, und ein maschinelles Gate prüft, ob das versprochene Ergebnis existiert.
KI schreibt heute unseren gesamten Code. Unsere Arbeit ist deshalb in die Spezifikation und die Checks drumherum gewandert. Unten stehen unser Issue-Vertrag, der Code, der ihn liest, und was wir gelernt haben, als die Spezifikation falsch war.
Wenn du schon einen Agenten baust, gib ihm ordentliche Leitplanken und einen klaren Auftrag. Setz ihn auf eine Aufgabe und spezifiziere die gut.

Was ist Spec-driven Development mit KI-Agenten?
Die Idee ist alt: Vor dem Bauen klären, was fertig bedeutet. Bei KI-Agenten zählt das mehr, denn ein Agent baut so oder so etwas. Ohne Spezifikation füllt er Lücken mit Annahmen, und die Annahmen sehen fertig aus.
Spec Kit führt das als Befehle im Chat mit dem Agenten aus: Projektgrundsätze, Spezifikation, Plan, Aufgaben, Umsetzung. Andere Tools machen es auf ihre Art. Eines haben alle gemeinsam. Die Spezifikation kommt vor dem Code und bleibt der Maßstab im Review.
Wo Context Engineering hingehört: Kontext ist alles, was der Agent sieht, von Regeldateien bis zur Tool-Ausgabe. Die Spezifikation ist der Teil dieses Kontexts, der sagt, was fertig bedeutet. Mehr Kontext ohne sie bringt nur ein selbstsichereres falsches Ergebnis.
Warum ein GitHub Issue statt eines langen Dokuments?
Unsere Issues sind eine Warteschlange, die Menschen jeden Morgen lesen. Die Regel dafür beginnt mit drei Wörtern: „Queue items, not specs.“ Einträge in der Warteschlange, keine Spezifikationen. Eine lange Spezifikation kommt in ein verlinktes Dokument. Das Issue ist das, was ein Mensch oder ein Agent aufnimmt und fertigstellt.
Langes Spezifikationsdokument
- Vorab für ein ganzes Feature geschrieben.
- Läuft nach der ersten Änderung vom Code weg.
- Schwer Zeile für Zeile zu prüfen.
- Gut für eine große Designentscheidung.
Das nutzen wir
Issue-Vertrag
- Ein Ergebnis, ein Verantwortlicher, ein PR.
- Aufgabentyp, Abnahme, wohin das Ergebnis kommt.
- Vor und nach der Arbeit von Code geprüft.
- Verlinkt ein Designdokument, wenn nötig.
Weniger, dafür größere Issues passen auch für Agenten besser. Unsere Regel: ein fertiges Ergebnis pro Issue und pro Pull Request. Auch ein großes Ergebnis ist ein PR, mit einem Commit pro Schicht, damit ein Mensch ihn in Bau-Reihenfolge lesen kann.
Was steht in unserem Issue-Vertrag?
Drei Dinge sind Pflicht: ein Titel mit Verb und konkretem Objekt, ein Prioritäts-Label und was zu tun ist. Für einfache Arbeit reicht der Titel. Abschnitte wie ## What, ## Acceptance und ## Output erscheinen nur, wenn sie Inhalt tragen. Ein leeres ## Acceptance: TBD ist verboten.
Der Aufgabentyp bestimmt, was am Ende existieren muss:
| Typ | Das Issue liefert | Ergebnis, das existieren muss |
|---|---|---|
| Code | was falsch ist oder gewünscht wird, Abnahme | ein PR, der das Issue schließt, ein Test, der vorher scheitert und danach besteht, grüne Checks des Repositorys |
| Recherche | Frage, Umfang, Ergebnis | Ergebnisse plus Aussagendatei: jede Aussage mit Quell-URL und wörtlichem Zitat von dieser Seite |
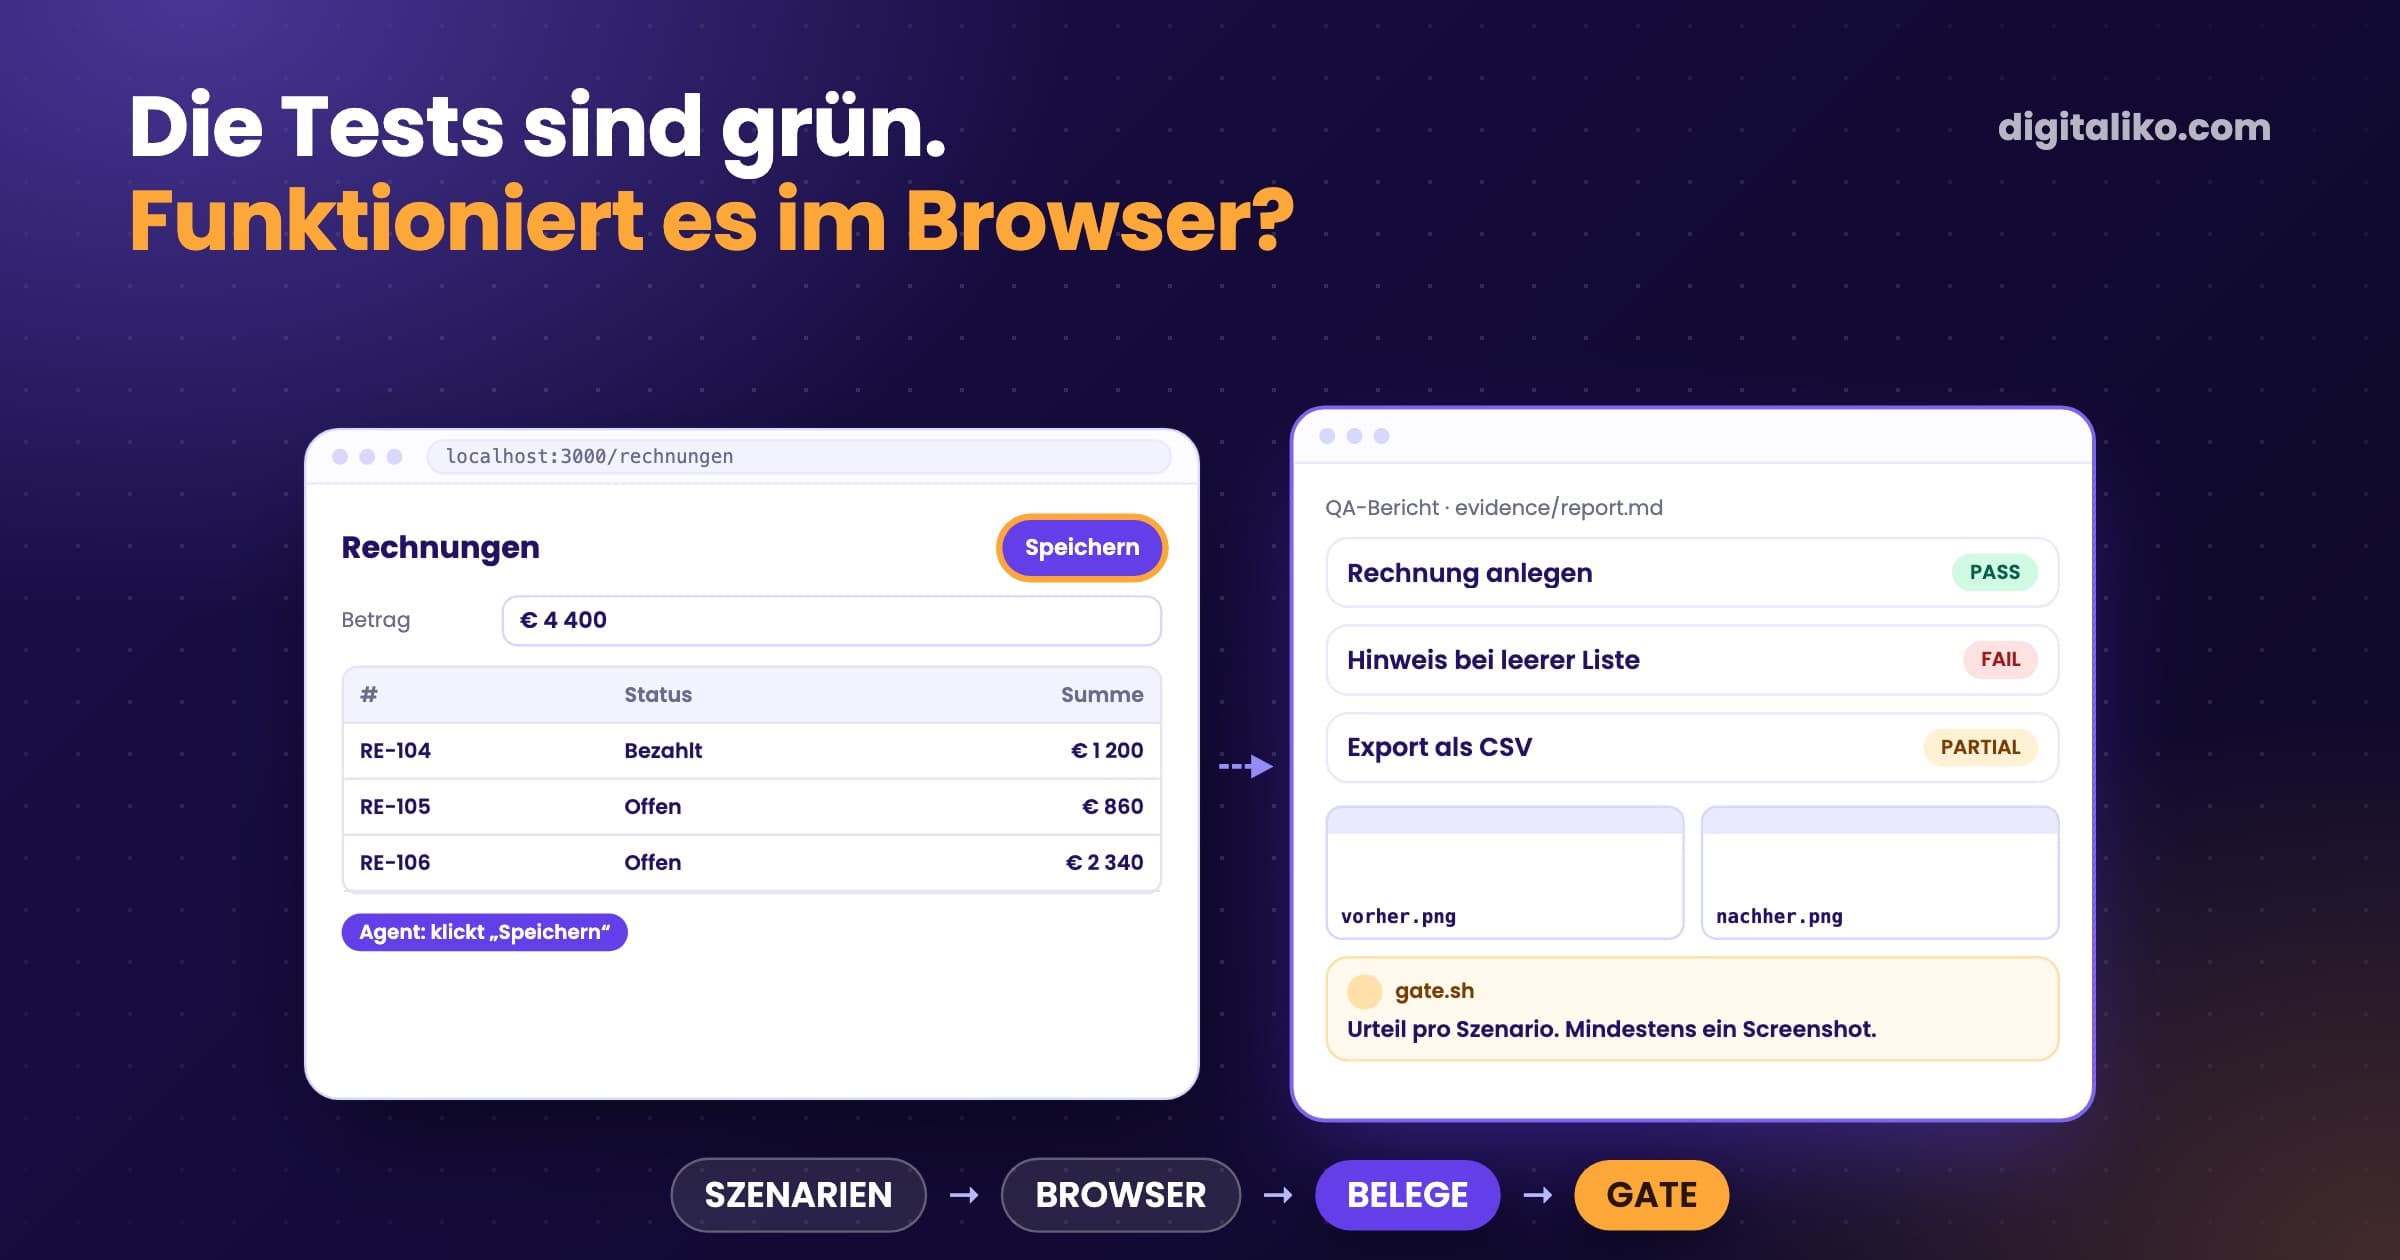
| QA | URL oder Ablauf, Szenarien | ein Bericht mit PASS oder FAIL pro Szenario, plus Screenshots |
| Dokument | was, für wen, Ergebnis | das Dokument mit funktionierenden Links |
| Antwort | die Nachricht und ihr Kontext | ein Entwurf in der Sprache des Absenders, nie gesendet |
Für den Typ setzt niemand ein Label. Wer das Issue aufnimmt, leitet ihn ab. Fehlt ## Output oder ## Acceptance, wird es als ausgesprochene Annahme ergänzt, nie stillschweigend.
Wie prüft eine Maschine die Spezifikation?
Zweimal: vor der Arbeit und danach.
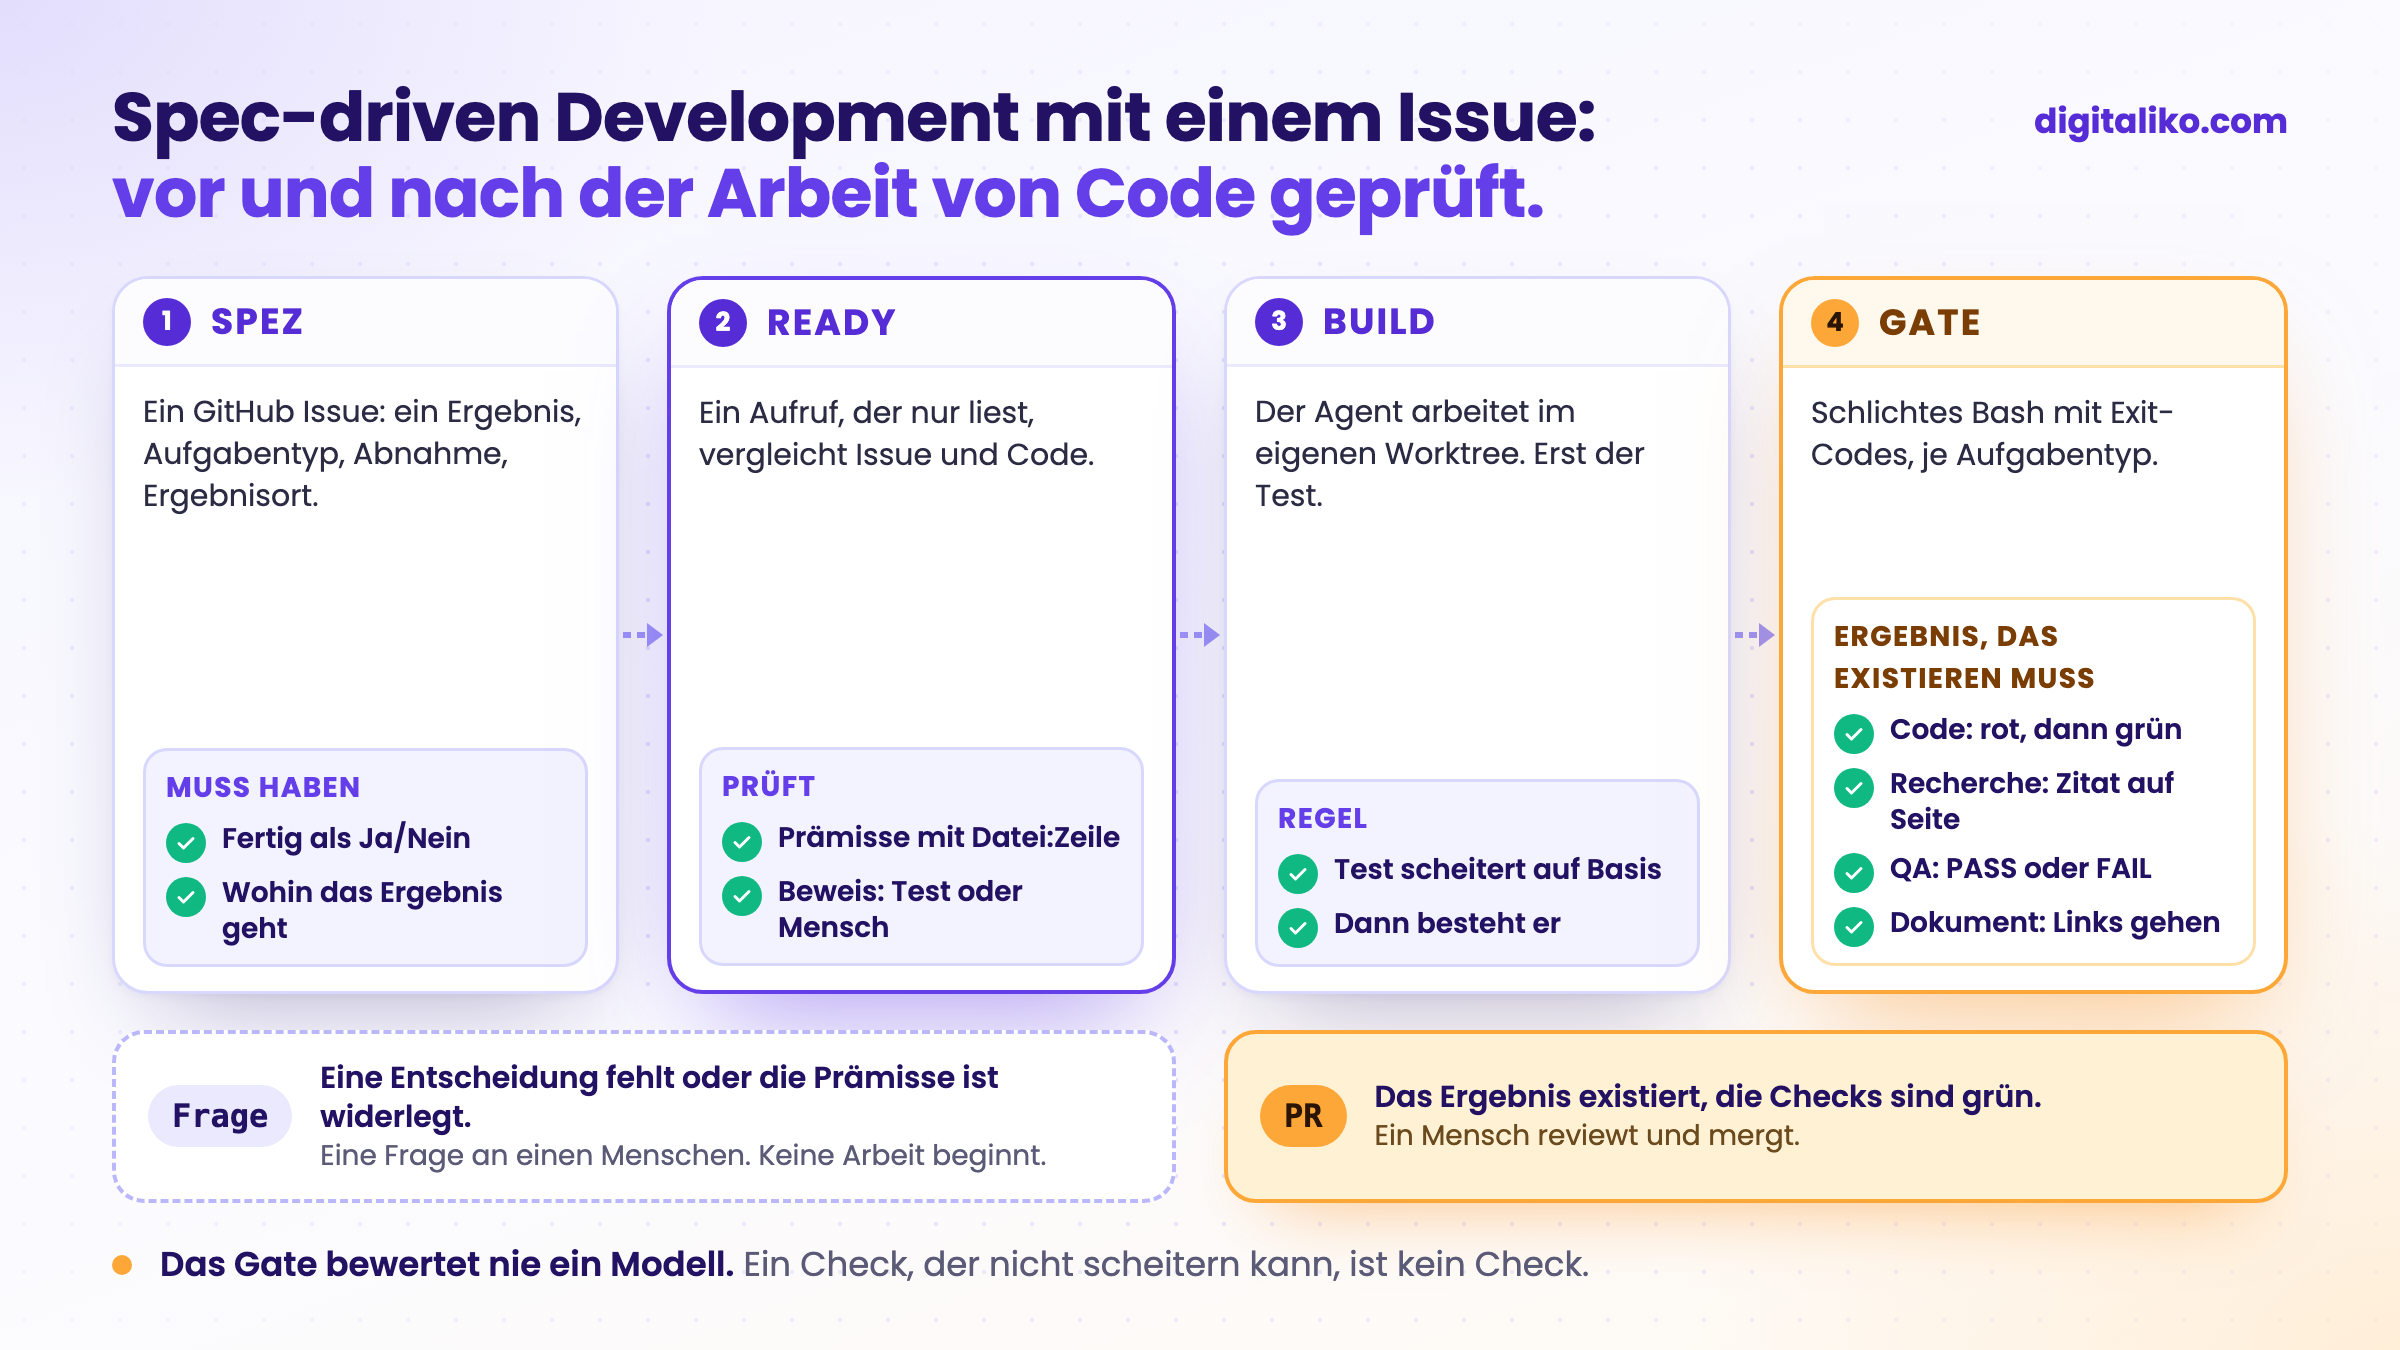
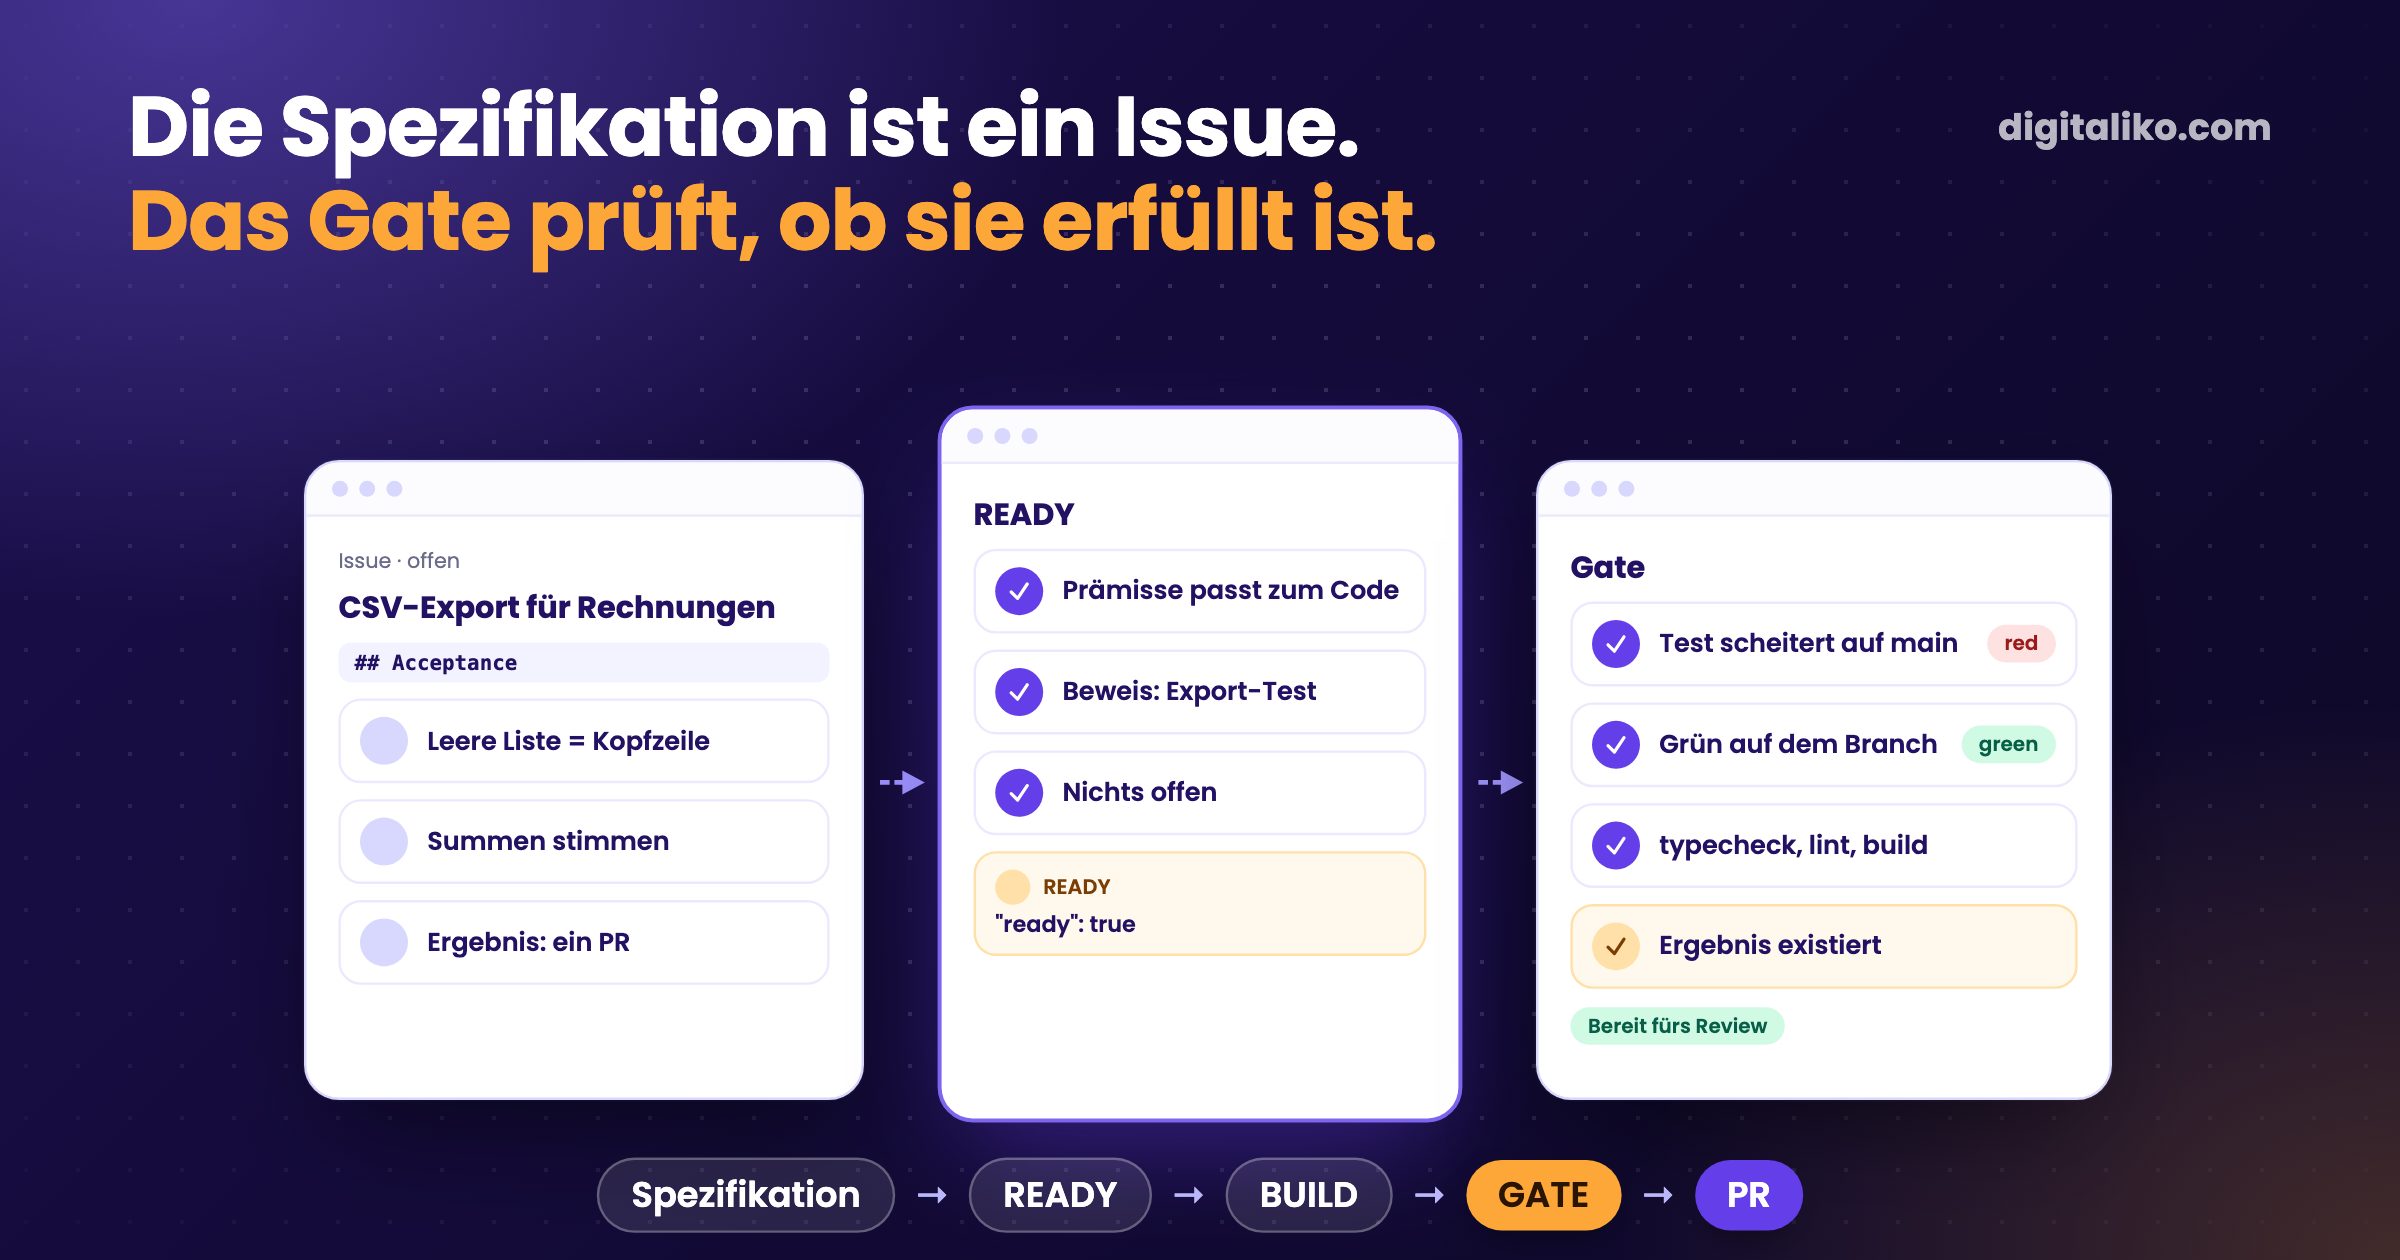
Vor der Arbeit: READY. Ein Modellaufruf, der nur liest, geht Issue und Code durch und liefert eine Antwort mit fester Struktur. Gekürzt aus unserem Schema:
{
  "ready": true,
  "type": "code",
  "done_when": ["criteria a reviewer can answer yes or no"],
  "verifiable": "test",
  "confirmation": ["the test that carries the proof"],
  "premise": "verified against <file:line>",
  "question": ""
}
Am meisten Zeit spart uns premise. Der Check vergleicht jede Aussage des Issues über das heutige Verhalten mit dem Code, mit Datei und Zeile. Gilt vom Issue nichts mehr, schlägt er vor, es zu schließen. verifiable sagt, ob ein Test das riskanteste Kriterium beweisen kann oder nur ein Mensch, der hinschaut. Fehlt eine Produktentscheidung, stellt question eine Frage mit zwei Optionen und einer Empfehlung, und die Arbeit beginnt nicht.
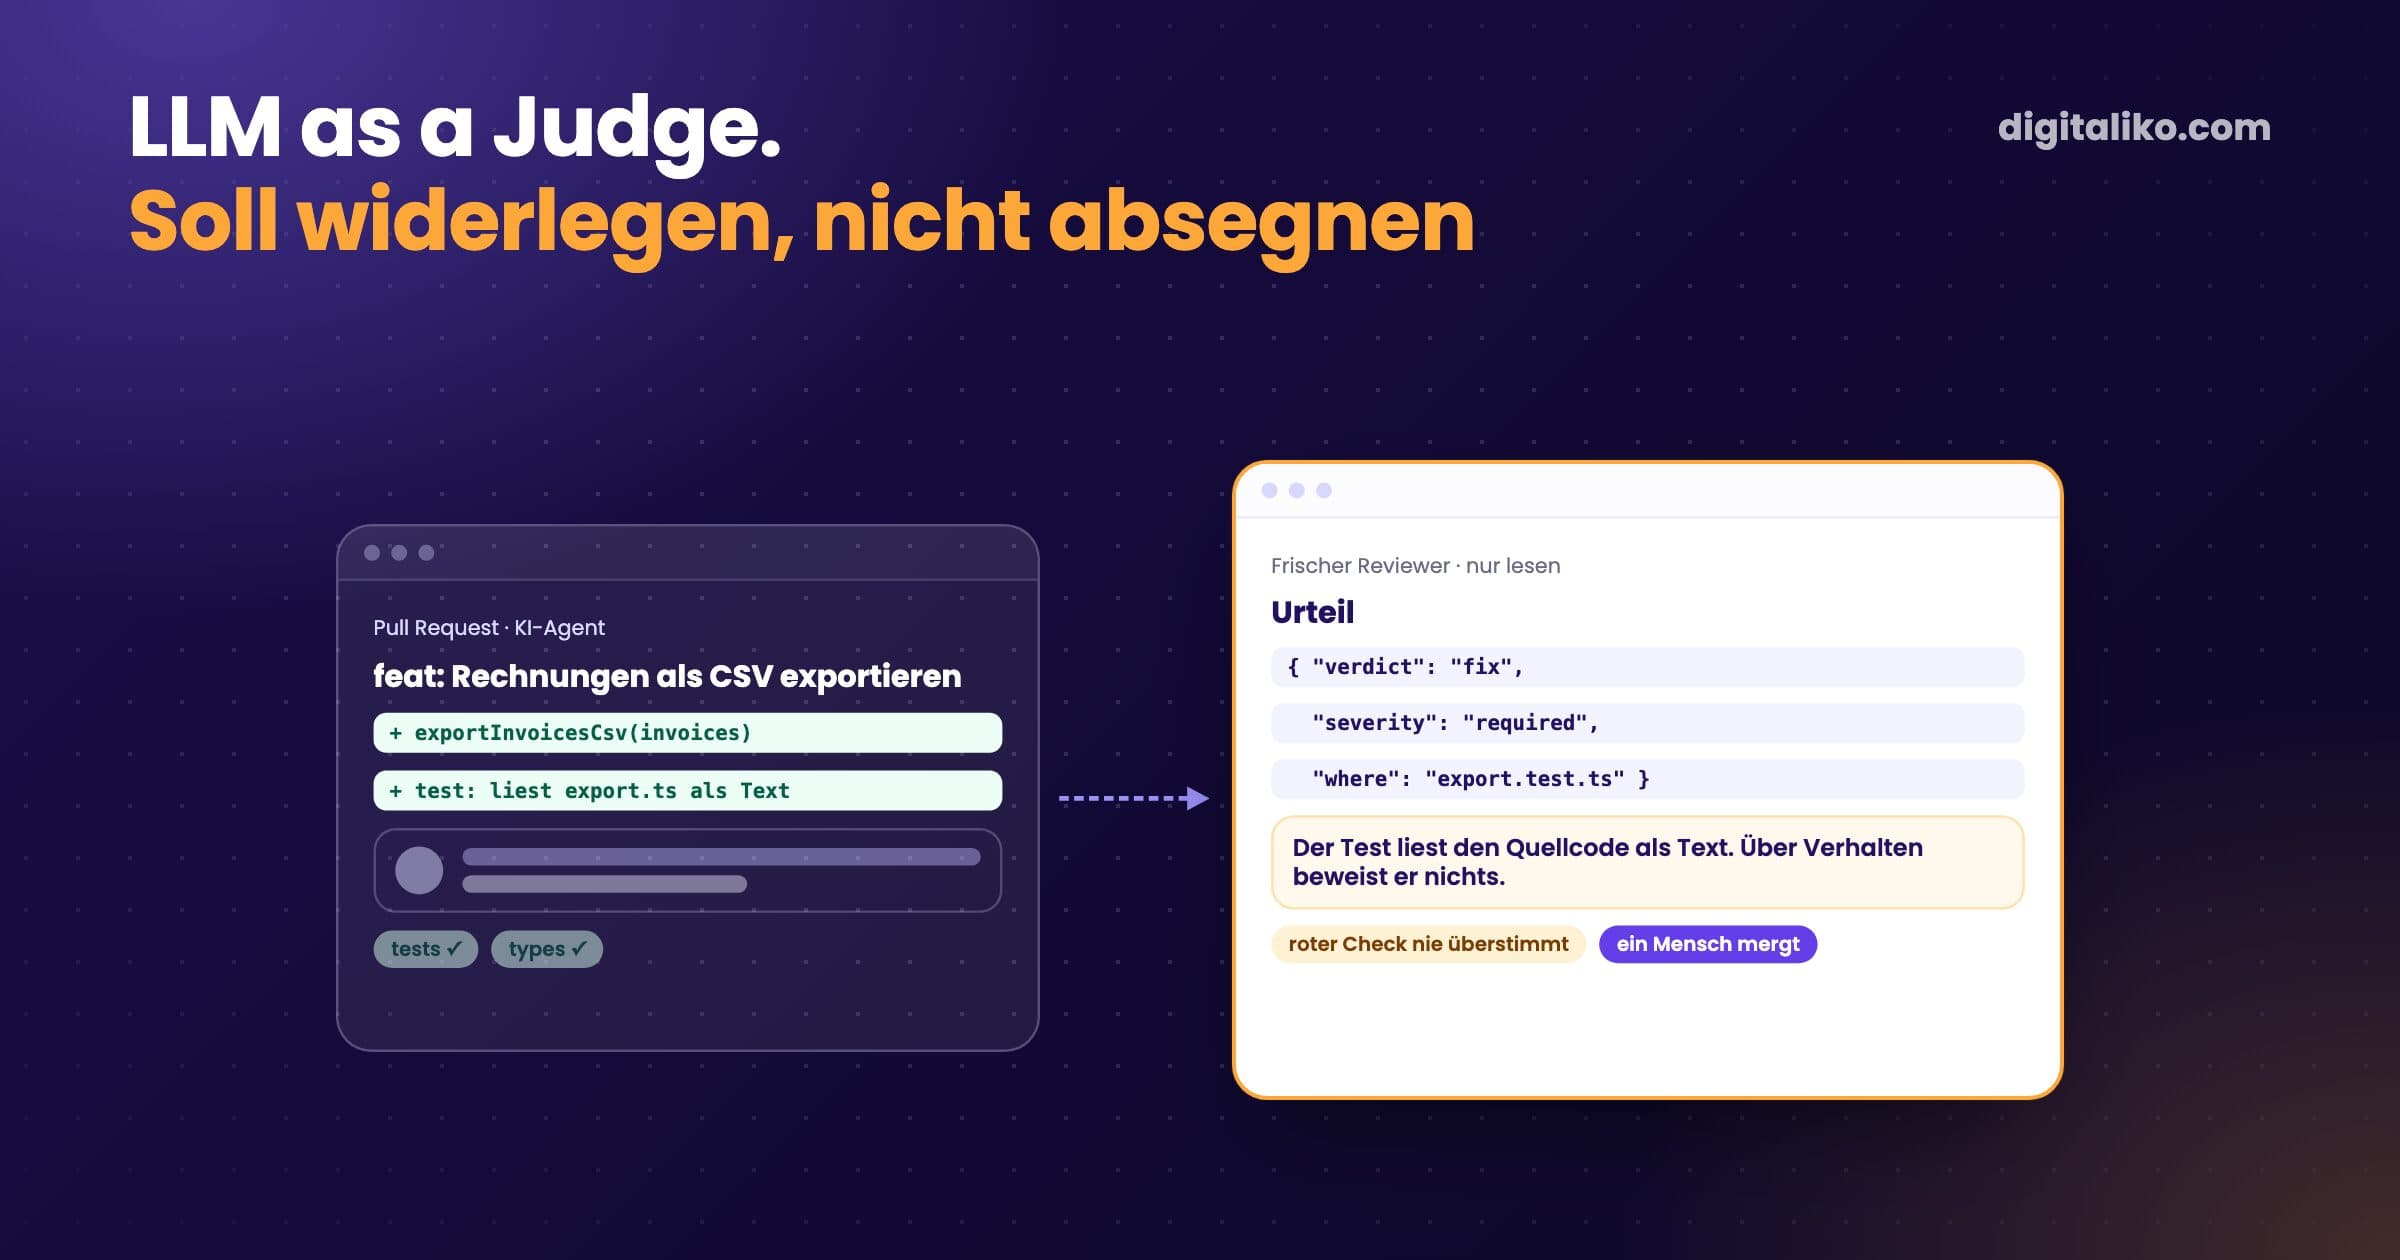
Nach der Arbeit: das Gate. Schlichtes Bash mit Exit-Codes, ein Zweig pro Aufgabentyp. Bei Code laufen Typecheck, Lint, Tests und Build des Repositorys, dazu ein Red-Proof: Geänderter Quellcode braucht einen geänderten Test, und dieser Test muss auf dem Basis-Branch scheitern. Bei Recherche öffnet es jede Quell-URL und sucht das Zitat auf der Seite. Eine Paraphrase fällt durch. Diesen Teil bewertet nie ein Modell.
Was änderte sich, als wir aufhörten, Aufgaben nach Größe zu schätzen?
Früher haben wir Aufgaben nach Größe bewertet und danach verteilt. Ersetzt haben wir das durch Bereitschaft: Ist die Prämisse gegen den Code geprüft, ist der Beweis benannt, ist noch etwas zu entscheiden?
Die Gates sind die zweite Hälfte der Spezifikation. Das Issue sagt, was fertig bedeutet. Die Checks sorgen dafür, dass niemand, ob Mensch oder Agent, es anders erklären kann.
Wir wollen die Tore bauen, durch die wir den Agenten lassen, und festlegen, was wir ihm erlauben.
Was ging bei unseren Spezifikationen schief?
- Der Bereitschafts-Check kam spät. Anfangs nahm der Agent das Issue, wie es geschrieben war. Den Abgleich der Prämisse mit dem Code haben wir erst später ergänzt. Heute ist er die erste Stufe, und dort würden wir anfangen.
- Ein falscher Kommentar ist kein falsches Issue. Ein alter Plan in einem Kommentar ließ den Check gute Issues widerlegen. Heute zählt nur eine Aussage im Issue-Text. Ein widerlegter Text geht an einen Menschen, der mit OK antwortet, bevor die Arbeit beginnt.
- Ein grünes Gate, das nichts bewies. In einem Monorepo ließ der Red-Proof Tests ohne die richtige Umgebung laufen. Jedes „scheitert auf dem Basis-Branch“ war ein Test, der gar nicht startete, kein echtes Rot. Ein paar Tage lang bestand dort jeder Red-Proof fälschlich. Heute laufen Tests über den Paketmanager des Repositorys, pro Paket, auf der festgelegten Node-Version.
Den letzten Punkt wiederholen wir am häufigsten: Ein Check, der nicht scheitern kann, ist kein Check. Mehr dazu in Red-Green-TDD mit KI-Agenten: erst muss der Test scheitern.
Wie schreiben Sie ein Issue, das ein Agent fertigstellt?
01
Ein Ergebnis
Verb und konkretes Objekt im Titel. Ein fertiges Ergebnis, ein PR.
02
Fertig als Ja oder Nein
Abnahmekriterien, die ein Reviewer mit Ja oder Nein beantwortet.
03
Beweis benennen
Welcher Test es beweist, oder welcher Mensch draufschauen muss.
04
Ergebnis benennen
PR, Bericht oder Dokument, und wo es liegen wird.
05
Prämisse prüfen
Vor der Arbeit vergleichen, was das Issue behauptet, mit dem Code.
Den letzten Schritt lassen Teams aus. Dabei ist er der billigste: ein Modellaufruf, der nur liest, bevor es eine Zeile Code gibt.
Wie der Rest der Ausrüstung eines Agenten aussieht, von Regeln bis Hooks, steht in Was ist ein Agent-Harness? Agent = Modell + Rahmen. Wann statt einer Spezifikation der eingebaute Planungsmodus reicht, steht in Claude Code Plan Mode.
Ist Ihr Issue bereit für einen Agenten?
Eine Schleife von der Spezifikation zum PR in Ihrem Team?
Diesen Vertrag und die Checks dahinter bauen wir direkt im Repository eines Teams, im Rahmen von AI-native SDLC für Entwicklerteams. Fehlen Ihnen eher Hände als Prozess? Sehen Sie sich einen Senior-Entwickler für Ihr Team an. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Was bedeutete „fertig“ im letzten Issue Ihres Teams, und wer hat es geprüft?
Kurz gesagt
- Spec-driven Development: was gebaut wird und woran Sie erkennen, dass es fertig ist, bevor der Agent Code schreibt.
- Unsere Spezifikation ist ein GitHub Issue: ein Ergebnis, ein Aufgabentyp, Abnahmekriterien und das Ergebnis.
- Ein Check, der nur liest, vergleicht das Issue schon vor der Arbeit mit dem Code.
- Ein Gate prüft, ob das Ergebnis existiert: erst roter, dann grüner Test, Quellen mit Zitaten, QA-Bericht.
- Ein Check, der nicht scheitern kann, ist kein Check.
Häufige Fragen
Was ist Spec-driven Development?
Bevor jemand Code schreibt, halten Sie fest, was gebaut wird, warum und woran Sie erkennen, dass es fertig ist. Daraus entstehen Plan, Aufgaben und Code. Bei KI-Agenten ist die Spezifikation zugleich der Kontext, aus dem der Agent arbeitet.
Brauche ich ein langes Spezifikationsdokument?
Nein. Für die meiste Arbeit genügt uns ein GitHub Issue: Titel, Aufgabentyp, Abnahmekriterien und wohin das Ergebnis kommt. Eine lange Spezifikation gehört in ein verlinktes Dokument, nicht ins Issue.
Was ist der Unterschied zwischen Spec-driven Development und Context Engineering?
Context Engineering ist alles, was der Agent sieht: Regeln, Dateien, Tools, Verlauf. Die Spezifikation ist der Teil davon, der sagt, was fertig bedeutet. Ohne sie bringt mehr Kontext nur ein selbstsichereres falsches Ergebnis.
Wie prüfen Sie, ob der Agent die Spezifikation erfüllt hat?
Mit Code, nicht mit Meinung. Vor der Arbeit vergleicht ein Check, der nur liest, das Issue mit dem Code. Nach der Arbeit prüft ein Gate, ob das versprochene Ergebnis existiert: ein PR mit einem Test, der vorher scheitert und danach besteht, Quellen mit wörtlichen Zitaten, ein QA-Bericht.
Wann lohnt sich keine Spezifikation?
Bei einem Ein-Zeilen-Fix ist der Titel die Spezifikation. Wo nur ein Mensch das Ergebnis beurteilen kann, etwa Text oder Optik, sagt die Spezifikation das, und die Arbeit geht an diesen Menschen.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity