Playwright MCP: Der KI-Agent beweist es im Browser
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer, Digitaliko
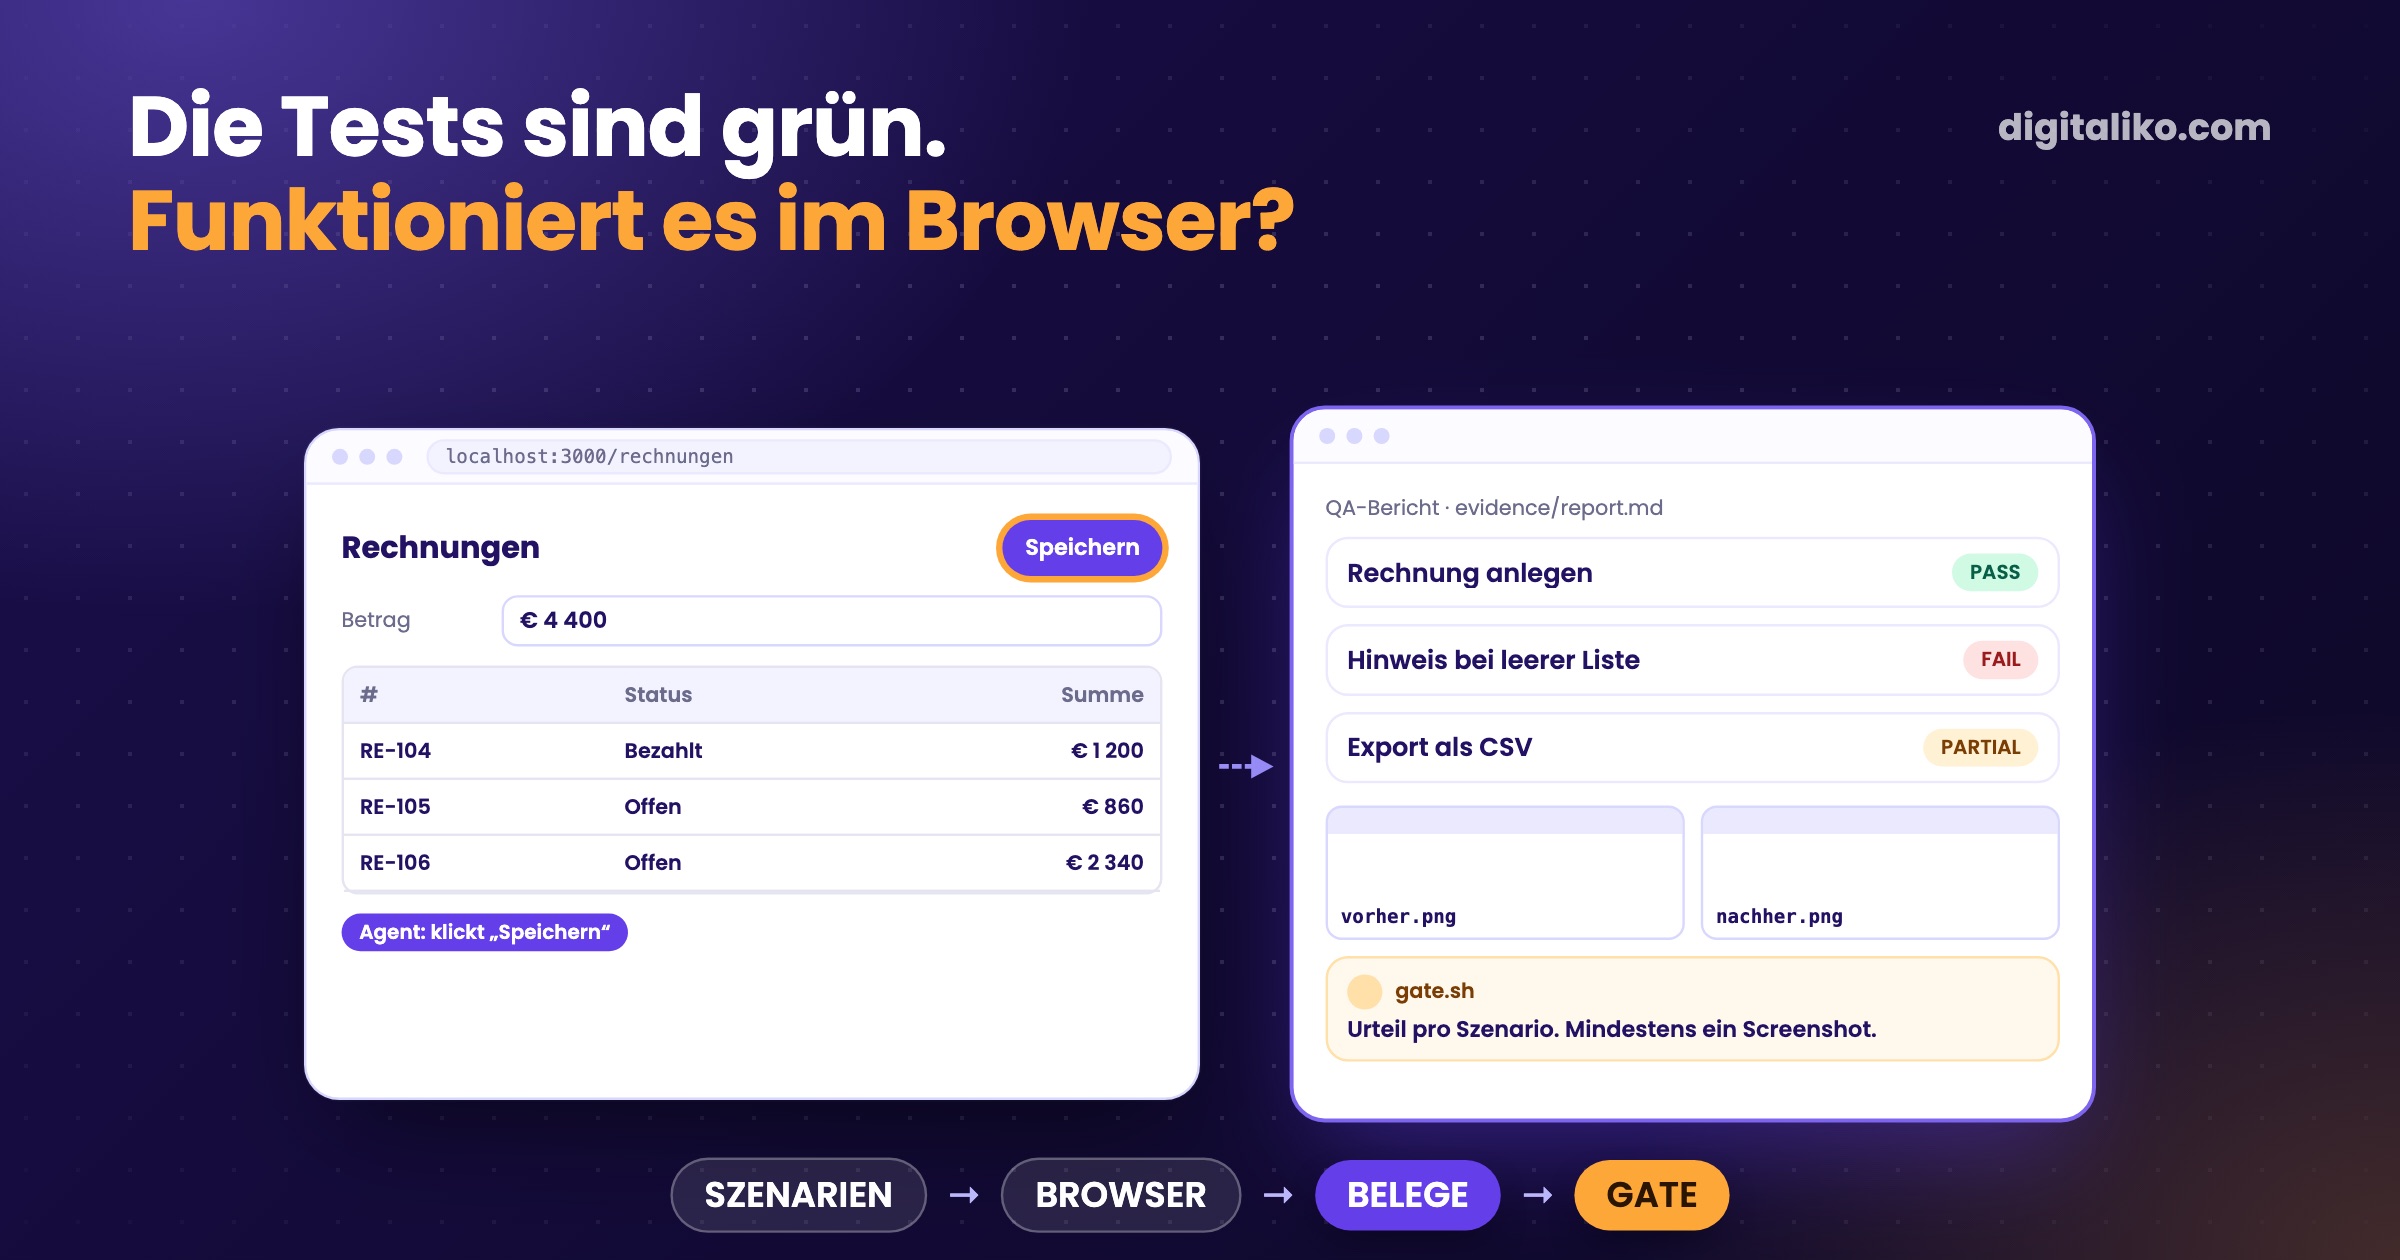
Playwright MCP ist ein MCP-Server von Microsoft, der einem KI-Agenten einen echten Browser gibt: Er öffnet Seiten, klickt, tippt und liest, was auf dem Bildschirm steht. Wir nutzen ihn für eine Aufgabe. Bevor jemand „fertig“ sagt, geht der Agent die Änderung in der laufenden App durch und gibt PASS oder FAIL pro Szenario zurück, mit Screenshots.
Ein grüner Typecheck beweist, dass der Code kompiliert. Ein bestandener Komponententest beweist, dass die Komponente in ihrer eigenen Testumgebung rendert. Keins von beiden beweist, dass die echte Seite mit echten Daten tut, was das Issue verlangt hat. Genau diese Lücke schließt die Prüfung im Browser.
Der schwierigste Schritt ist meistens der letzte. Zu prüfen, dass es wirklich funktioniert, von Anfang bis Ende.

Was ist Playwright MCP und wie funktioniert es?
MCP, das Model Context Protocol, ist der Weg, über den ein Agent wie Claude Code zusätzliche Werkzeuge bekommt. Der Playwright-MCP-Server fügt Browser-Werkzeuge auf Basis von Playwright hinzu: eine Adresse öffnen, klicken, tippen, ein Formular ausfüllen, Konsole und Netzwerkanfragen lesen, einen Screenshot machen.
In Claude Code ist es ein Befehl:
claude mcp add playwright npx @playwright/mcp@latest
Das entscheidende Detail: Der Agent schaut nicht auf Pixel. Laut README arbeitet er über „structured accessibility snapshots“, ohne Screenshots und ohne Bildmodelle. Er bekommt die Seite als Baum aus Buttons, Links, Überschriften und Formularfeldern mit ihren Beschriftungen. Er klickt den Button „Speichern“, nicht die Koordinaten, an denen früher ein Button war.
Daraus folgen zwei Dinge. Eine Seite, deren Buttons keinen zugänglichen Namen haben, ist auch für den Agenten schwer, die Prüfung ist also nebenbei ein kleines Accessibility-Review. Und wenn ein Mensch das Ergebnis sehen muss, kann der Agent trotzdem einen Screenshot machen.
Standardmäßig hält der Server ein dauerhaftes Browserprofil, ein Login überlebt also zwischen Sessions. Für Läufe, die sauber starten müssen, gibt es --isolated, und --storage-state lädt gespeicherte Cookies in diesen sauberen Kontext.
Wie lassen wir den Agenten seine eigene Änderung prüfen?
Die Methode steckt in unserem Skill browser-qa. Er ändert keinen App-Code. Er schreibt Belege:
01
Szenarien aus dem Issue
Ein Szenario pro Akzeptanzkriterium oder Feedbackpunkt, jeweils mit Quelle. Konkrete Schritte: X klicken, dann passiert Y.
02
Echte Daten, echter Login
Ein Lauf über Mock- oder leere Daten beweist das Layout, nicht das Verhalten. Zuerst meldet sich ein Mensch an. Der Agent fasst das Session-Token nie an.
03
Die App durchgehen
Öffnen, klicken, tippen, Screenshot. Was exakt stimmen muss, eine Farbe, eine Zahl, eine Beschriftung, liest der Agent aus der Seite, statt es aus einem Bild zu raten.
04
Urteil pro Szenario
PASS, FAIL oder PARTIAL, mit dem, was tatsächlich zu sehen war. Nie „sieht gut aus“.
05
Fehler als Issues
Jeder echte FAIL wird ein Bug-Issue mit Link zum Bericht. Eine Notiz nur im Bericht geht verloren.
Der Skill sagt auch, was zu tun ist, wenn die Automatisierung etwas nicht schafft. Ein Element, das so tief verschachtelt ist, dass ein Klick nicht zuverlässig auslöst, bekommt die Notiz „needs manual click“. Es wird nicht still als FAIL markiert und nicht übersprungen.
Nicht jede Prüfung kommt aus einem geschriebenen Szenario. Manchmal ist die beste die offene:
Ein Trick funktioniert bei uns gut. Wir schicken einen Agenten als bestimmten Kundentyp, als Persona, in das neue Feature und lassen ihn selbst erkunden.
Eine Persona findet, was niemand aufgeschrieben hat: eine verwirrende Beschriftung, eine Sackgasse, einen Schritt, der nur für den Sinn ergibt, der ihn gebaut hat.
Was gibt der Agent ab, und wer prüft es?
Ein Bericht, den der Agent über sich selbst schreibt, ist immer noch eine Behauptung. Deshalb ist die Form der Belege fest, und ein Skript prüft sie, kein Modell.
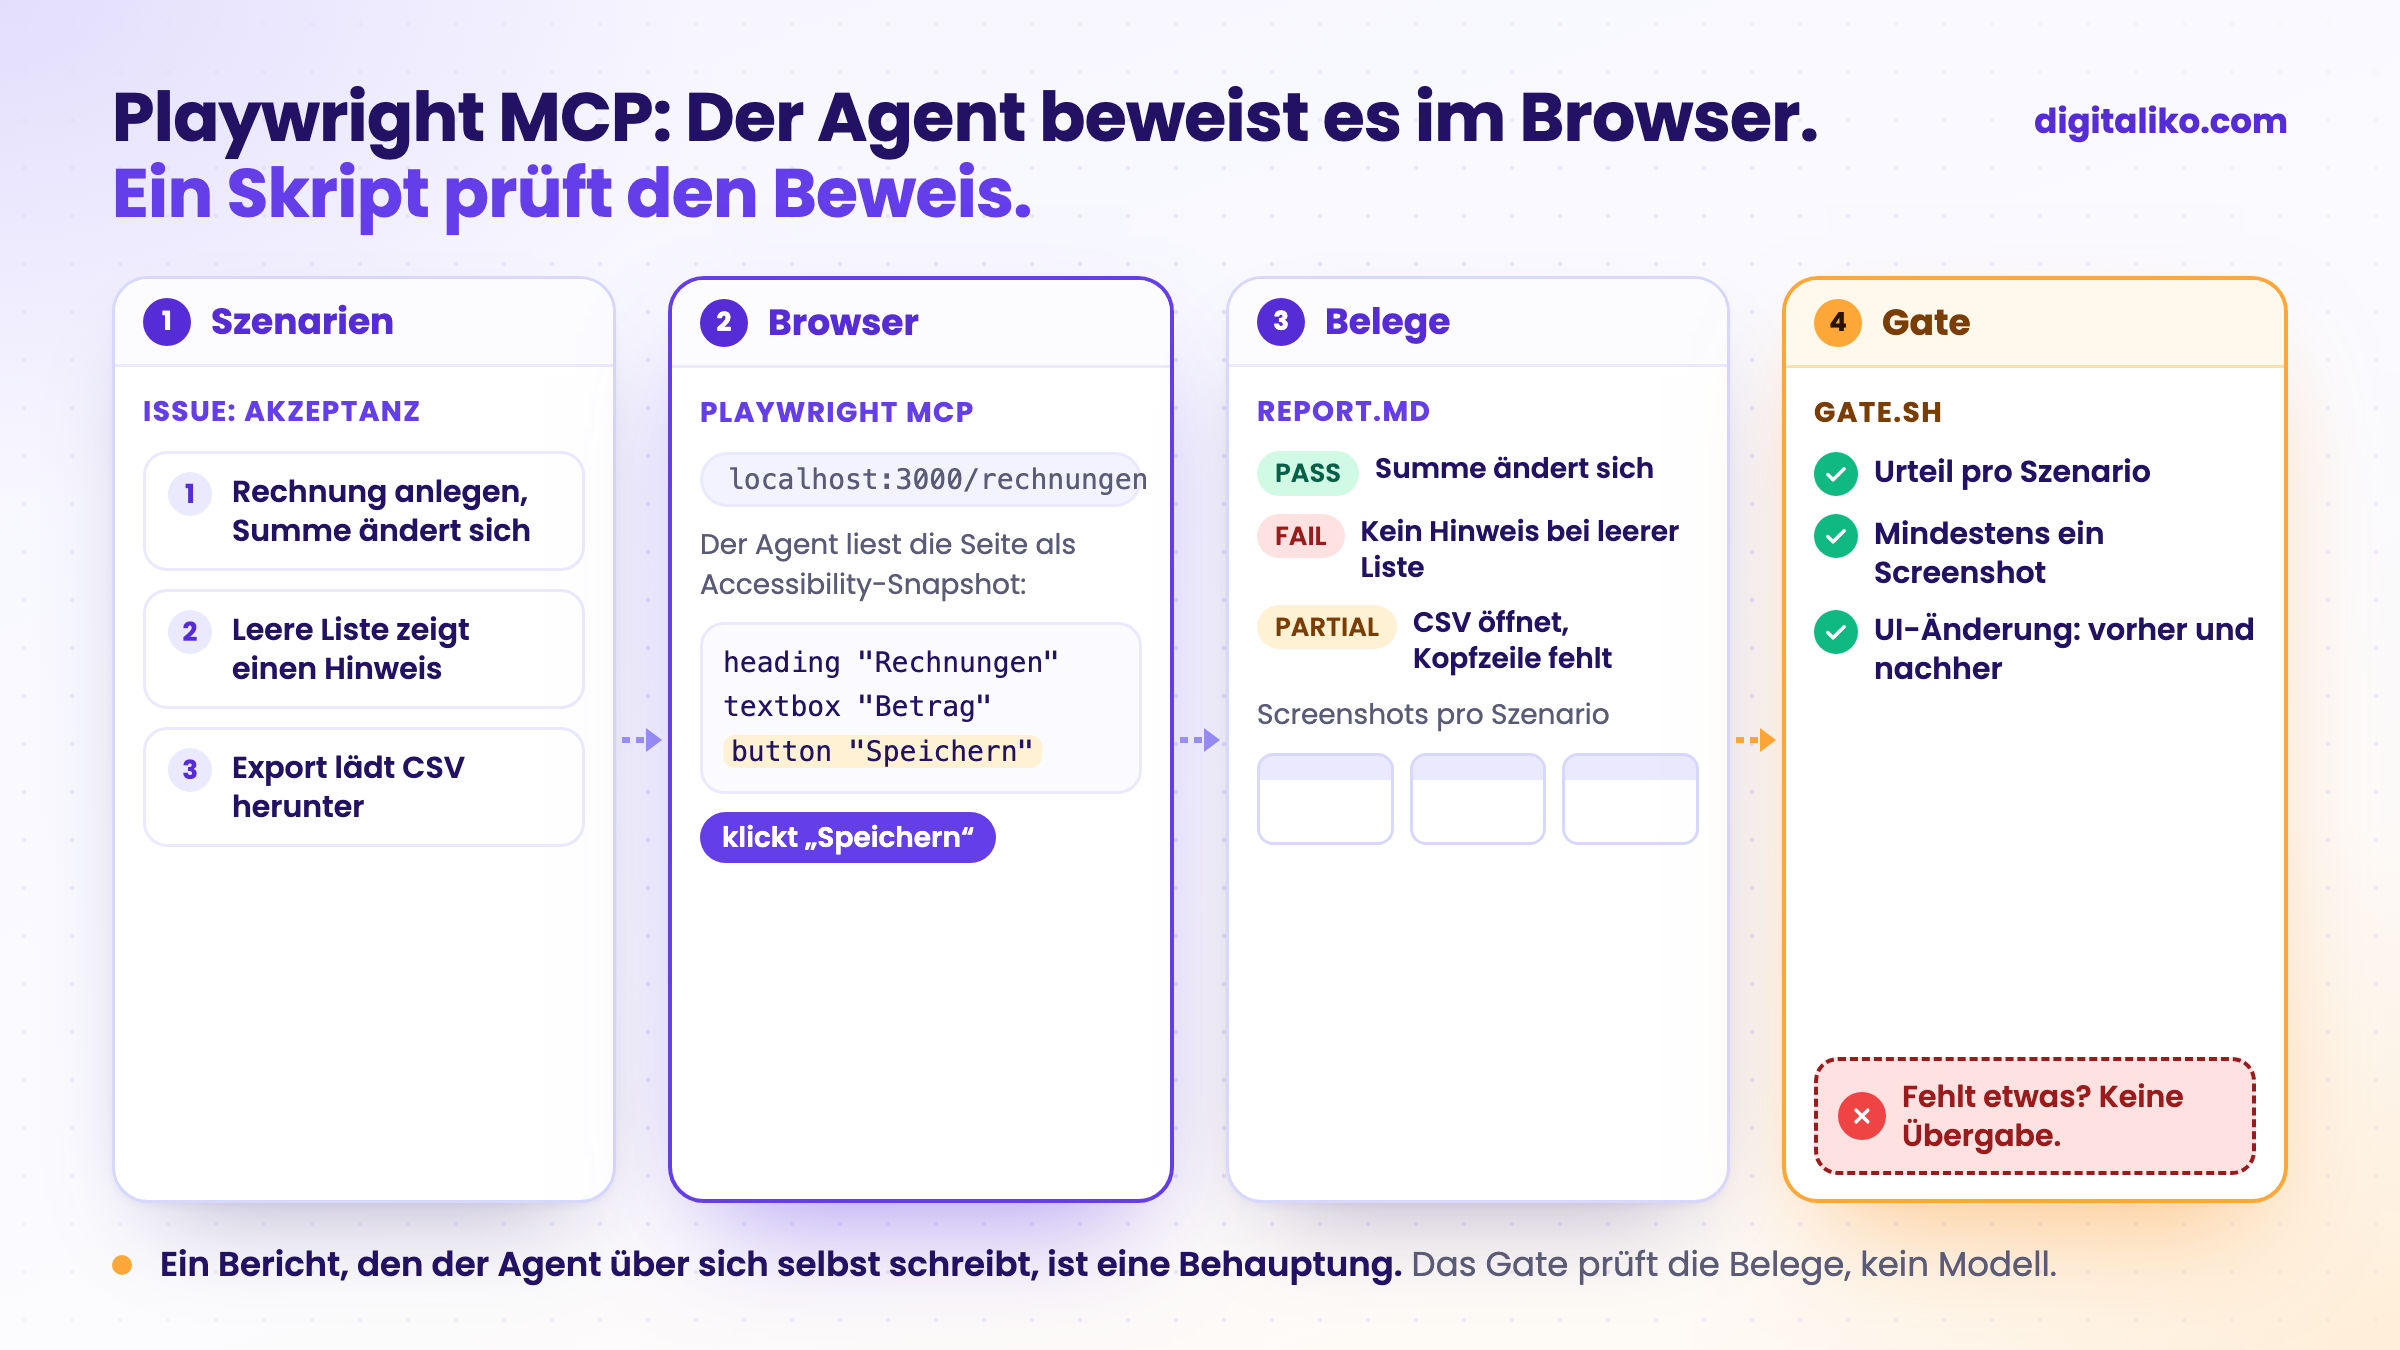
In unserem Agenten-Loop sagt eine QA-Aufgabe dem Agenten, die Browser-Werkzeuge von Playwright zu nutzen und alles in evidence/<issue>/ abzulegen: einen Screenshot pro Szenario, die Konsolen- und Netzwerkfehler und report.md. Den Rest erledigt gate.sh, ein einfaches Bash-Skript mit Exit-Codes:
n=$(grep -cE '\b(PASS|FAIL|PARTIAL)\b' "$tree/$rep"); shots=$(ls "$tree/$(dirname "$rep")"/*.png 2>/dev/null | wc -l | tr -d ' ')
[ "$n" -gt 0 ] && [ "$shots" -gt 0 ] || { echo "FAIL: report needs PASS/FAIL per scenario and screenshots" >> "$out"; exit 1; }
Kein Bericht, keine Urteilszeilen oder kein Screenshot heißt: Die Aufgabe ist nicht fertig, egal was der Agent sagt.
Für Code-Aufgaben gilt eine ähnliche Regel. Ändert ein Pull Request UI-Dateien, verlangt der Loop ein before-*.png und ein after-*.png. Gibt es einen guten Grund dagegen, muss der PR das in einer Zeile sagen, die mit No screenshots: beginnt. So sieht der Reviewer die Änderung, statt sie sich vorzustellen.
Diese Regel kam aus einem eigenen Fehler. Vor dem Fix zählte jedes PNG als Beweis, ein Screenshot von irgendetwas reichte also. Jetzt müssen es zwei sein, benannt nach dem, was sie zeigen.
Was findet eine Browser-Prüfung, was Unit-Tests übersehen?
Ein Unit-Test stellt eine enge Frage in einem kontrollierten Raum. Der Browser fragt, ob es den Raum überhaupt gibt.
| Frage | Unit- oder Komponententest | Agent in einem echten Browser |
|---|---|---|
| Liefert die Funktion den richtigen Wert? | Ja, schnell und wiederholbar | Nur indirekt |
| Ist die Route mit der Komponente verbunden? | Nein, der Test bindet die Komponente selbst ein | Ja, er öffnet die echte URL |
| Funktioniert es mit produktionsnahen Daten? | Nur mit der Fixture, die Sie geschrieben haben | Ja, wenn er auf echten Daten läuft |
| Hat der Button einen Namen, den ein Screenreader nutzen kann? | Nur wenn jemand diesen Test geschrieben hat | Ja, der Snapshot zeigt es |
| Gibt es Fehler in Konsole oder Netzwerk? | Selten geprüft | Ja, beides wird gelesen |
| Ergibt der Ablauf für einen Kunden Sinn? | Nein | Teilweise, mit einer Persona |
Beide Spalten zählen. Die Red-Green-Regel für Unit-Tests steht in Red-Green-TDD mit KI-Agenten. Die Browser-Prüfung sitzt darauf, nicht statt ihrer.
Ehrlich zu den Grenzen: Wir haben nicht gezählt, wie viele Fehler die Browser-Prüfungen im Vergleich zu den Tests finden. Was wir wissen, ist die Art: Dinge, die erst existieren, wenn alles zusammengesteckt ist.
Playwright MCP, Playwright-Skripte oder Chrome DevTools MCP?
Selbst das Playwright-Team sagt, dass das MCP nicht immer das richtige Werkzeug ist. Ihr README empfiehlt Coding-Agenten die Playwright CLI mit Skills, weil sie „more token-efficient“ ist. MCP, schreiben sie, „remains relevant for specialized agentic loops“, etwa für explorative Automatisierung oder lange autonome Abläufe.
Das passt zu dem, was wir sehen:
Playwright MCP
- Der Agent erkundet und wählt den nächsten Klick selbst
- Gut, um eine Änderung einmal zu prüfen, und für Persona-Läufe
- Kostet Kontext: Tool-Schemas und Seiten-Snapshots
Für alles, was Sie wiederholen
Playwright-Skripte und -Tests
- Dieselbe Prüfung bei jedem Lauf, in der CI
- Exakte Zahlen: berechnete Farben, Größen, Zeiten
- Jemand muss sie zuerst schreiben, oft der Agent
Chrome DevTools MCP
- Browser-Werkzeuge mit DevTools-Zugriff
- Was unser interaktiver QA-Skill jetzt zuerst versucht
- Gleiche Methode, anderer Treiber
Als wir diese Woche diese Website auditiert haben, haben wir das MCP gar nicht genutzt. Der Agent schrieb einfache Playwright-Skripte gegen einen lokalen Build: Textkontrast aus berechneten Farben, ein axe-Accessibility-Scan, jede Seite in Handybreite und Performance mit gedrosselter CPU. Das sind Prüfungen, die wir nach jeder Änderung wieder laufen lassen wollen. Ein Skript macht das jedes Mal gleich. Ein Agent, der Klicks improvisiert, nicht.
Und seit dieser Woche versucht unser interaktiver Skill browser-qa zuerst Chrome DevTools MCP, wenn die Session es hat. Die Methode hat sich überhaupt nicht geändert. Der Browsertreiber ist das austauschbare Teil.
Wo geht es schief?
Ein paar Fallen, die wir kennen, aus unseren Regeln oder aus eigenen Fehlern:
- Mock-Daten. Ein grüner Durchlauf über einer leeren Datenbank beweist das Layout, sonst nichts. Der Skill verbietet, das fertig zu nennen.
- Das Session-Token. Playwright MCP hat Werkzeuge, die Cookies und Local Storage lesen. Unsere Regel ist älter als jedes Werkzeug: Der Agent extrahiert, loggt oder übergibt nie ein Session-Token.
- Augenmaß. „Die Summe sieht richtig aus“ auf einem Screenshot ist geraten. Der Agent liest den Wert aus der Seite.
- Zwei Agenten, ein Profil. Ein dauerhaftes Profil kann nur ein Browser gleichzeitig nutzen. Parallele Läufe brauchen
--isolatedoder ein eigenes Profilverzeichnis.
Was sind Playwright Agents, und nutzen wir sie?
Playwright Agents, offiziell Playwright Test Agents, sind drei Agent-Definitionen, die direkt mit Playwright kommen. Laut Playwright-Dokumentation (Stand 24.10.2026) gilt: der Planner „explores the app and produces a Markdown test plan“, der Generator „transforms the Markdown plan into the Playwright Test files“ und der Healer „executes the test suite and automatically repairs failing tests“. In Claude Code fügen Sie sie mit einem Befehl hinzu:
npx playwright init-agents --loop=claude
Der Planner startet von einem Seed-Test, tests/seed.spec.ts, der die Umgebung vorbereitet, und schreibt den Plan nach specs/. Der Generator macht daraus Tests in tests/ und prüft Selektoren und Assertions live, während er die Szenarien durchgeht.
Ehrlich gesagt: Playwright Agents haben wir in unseren Projekten noch nicht eingesetzt. Unsere Agenten schreiben Playwright-Tests aus den Akzeptanzkriterien des Issues in unserer eigenen Schleife, und das Erkunden übernimmt der Skill browser-qa. Planner und Generator erledigen vieles davon im Playwright-eigenen Format. Für ein Team ohne eigene Schleife lohnt sich ein Versuch.
Beim Healer wären wir vorsichtig. Laut Dokumentation liefert er „a passing test, or a skipped test if the healer believes that functionality is broken“. In unserer Schleife beweist ein übersprungener Test nichts, und ein Test, der rot ist, weil das Produkt kaputt ist, muss rot bleiben. Wenn Sie den Healer ausprobieren, reviewen Sie jeden Locator und jede Assertion, die er ändert, wie jeden anderen Pull Request.
Ist Ihr Team bereit, einen Agenten im Browser prüfen zu lassen?
Gehen Sie durch, was Sie schon haben:
Wenn Sie eine fertige Basis wollen: Unser öffentlicher Claude Code production starter führt bereits einen Playwright-Smoke-Test in der CI aus und lädt bei einem Fehler den Bericht hoch. Wie der ganze Loop darum herum funktioniert, steht in Harness Engineering in der Praxis: vom Issue zum PR.
Möchten Sie Agenten, die ihre Arbeit in Ihrem Repository beweisen?
Browser-Prüfungen, Beleg-Regeln und die CI darum richten wir direkt im Repository eines Teams ein, als Teil von AI-native SDLC für Entwicklerteams. Fehlen Ihrem Team eher Hände als Prozesse? Sehen Sie sich einen Senior-Entwickler für Ihr Team an. KI schreibt heute unseren gesamten Code, und ein Senior steht für das ein, was in Produktion geht. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Wer in Ihrem Team prüft heute, dass eine Änderung im Browser funktioniert, und wie beweist er es?
Kurz gesagt
- Playwright MCP gibt einem Agenten einen echten Browser, den er als Accessibility-Snapshot liest.
- Bei uns geht der Agent Szenarien aus dem Issue auf echten Daten durch und gibt PASS oder FAIL mit Screenshots zurück.
- Ein Skript, kein Modell, stoppt die Übergabe, wenn Bericht oder Screenshots fehlen.
- Erkunden mit dem MCP. Prüfungen, die Sie wiederholen, als Playwright-Tests in die CI.
Häufige Fragen
Was ist Playwright MCP?
Ein MCP-Server von Microsoft, der einem KI-Agenten Browser-Werkzeuge auf Basis von Playwright gibt: eine Seite öffnen, klicken, tippen, ein Formular ausfüllen, Konsole und Netzwerkanfragen lesen, einen Screenshot machen. Der Agent liest die Seite als Accessibility-Snapshot, nicht als Pixel.
Wie füge ich Playwright MCP zu Claude Code hinzu?
Mit claude mcp add playwright npx @playwright/mcp@latest. Andere MCP-Clients nutzen denselben Server mit dem Befehl npx und dem Argument @playwright/mcp@latest.
Ersetzt Playwright MCP End-to-End-Tests?
Nein. Das MCP ist zum Erkunden und um eine Änderung einmal zu prüfen. Eine Prüfung, die Sie bei jedem Pull Request wollen, gehört in einen Playwright-Test oder ein Skript in der CI, wo niemand einen Agenten fragen muss.
Wie testet der Agent Seiten hinter einem Login?
Zuerst meldet sich ein Mensch an, im Browser, den der Agent nutzt, und der Agent arbeitet in dieser Session. Unsere Regel: Der Agent liest, loggt oder übergibt das Session-Token nie. Für isolierte Läufe kann Playwright MCP einen gespeicherten Storage State laden.
Reicht ein QA-Bericht des Agenten, um eine Änderung fertig zu nennen?
Nur mit Belegen: ein Urteil pro Szenario und die Screenshots daneben. In unserem Loop stoppt ein Gate-Skript die Übergabe, wenn Bericht oder Screenshots fehlen, und ein Mensch reviewt den Pull Request trotzdem.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity