TDD red-green con agentes de IA: primero el test debe fallar
Para CTO y desarrolladoresHarness y controles

Filip PapranecFundador de Digitaliko
Los agentes de IA escriben tests que pasan. Eso no es lo mismo que tests que demuestran algo, y un senior que tiene que distinguirlos en la revisión pierde el tiempo que la IA debía ahorrar. Por eso nuestra barrera ejecuta primero cada test nuevo contra el código antiguo. Si también pasa allí, el PR queda en rojo.
Esto es red-green-refactor impuesto por una máquina en vez de por disciplina. En nuestro caso, la IA escribe la mayor parte del código. Un senior revisa cada cambio y responde de producción. El red-proof es lo que permite a ese senior fiarse de un check en verde.
¿Por qué los tests escritos por IA son un riesgo?
Pídale a un agente que «añada tests» y obtendrá tests que se ponen en verde. Sin guía, tiende a escribirlos después del código y a medida del código, así que confirman lo que el código ya hace. Algunos ni siquiera llaman al código. Hemos visto tests que leían un archivo de código como texto y buscaban el nombre de una función. Pasan con cualquier versión que contenga esa palabra.
La cobertura sube. La prueba se queda donde estaba. El revisor se convierte en la última línea, y leer cada test con detalle es justo el trabajo que esperaba dejar de hacer.
¿Dónde está su equipo?
¿Qué es el red-proof?
El paso rojo de red-green-refactor, comprobado por un script:
- Rojo. El test nuevo debe fallar en la rama base, el código anterior al cambio.
- Verde. El mismo test debe pasar en la rama.
- Sin test, no hay cambio. Código modificado sin ningún test modificado es un fallo.
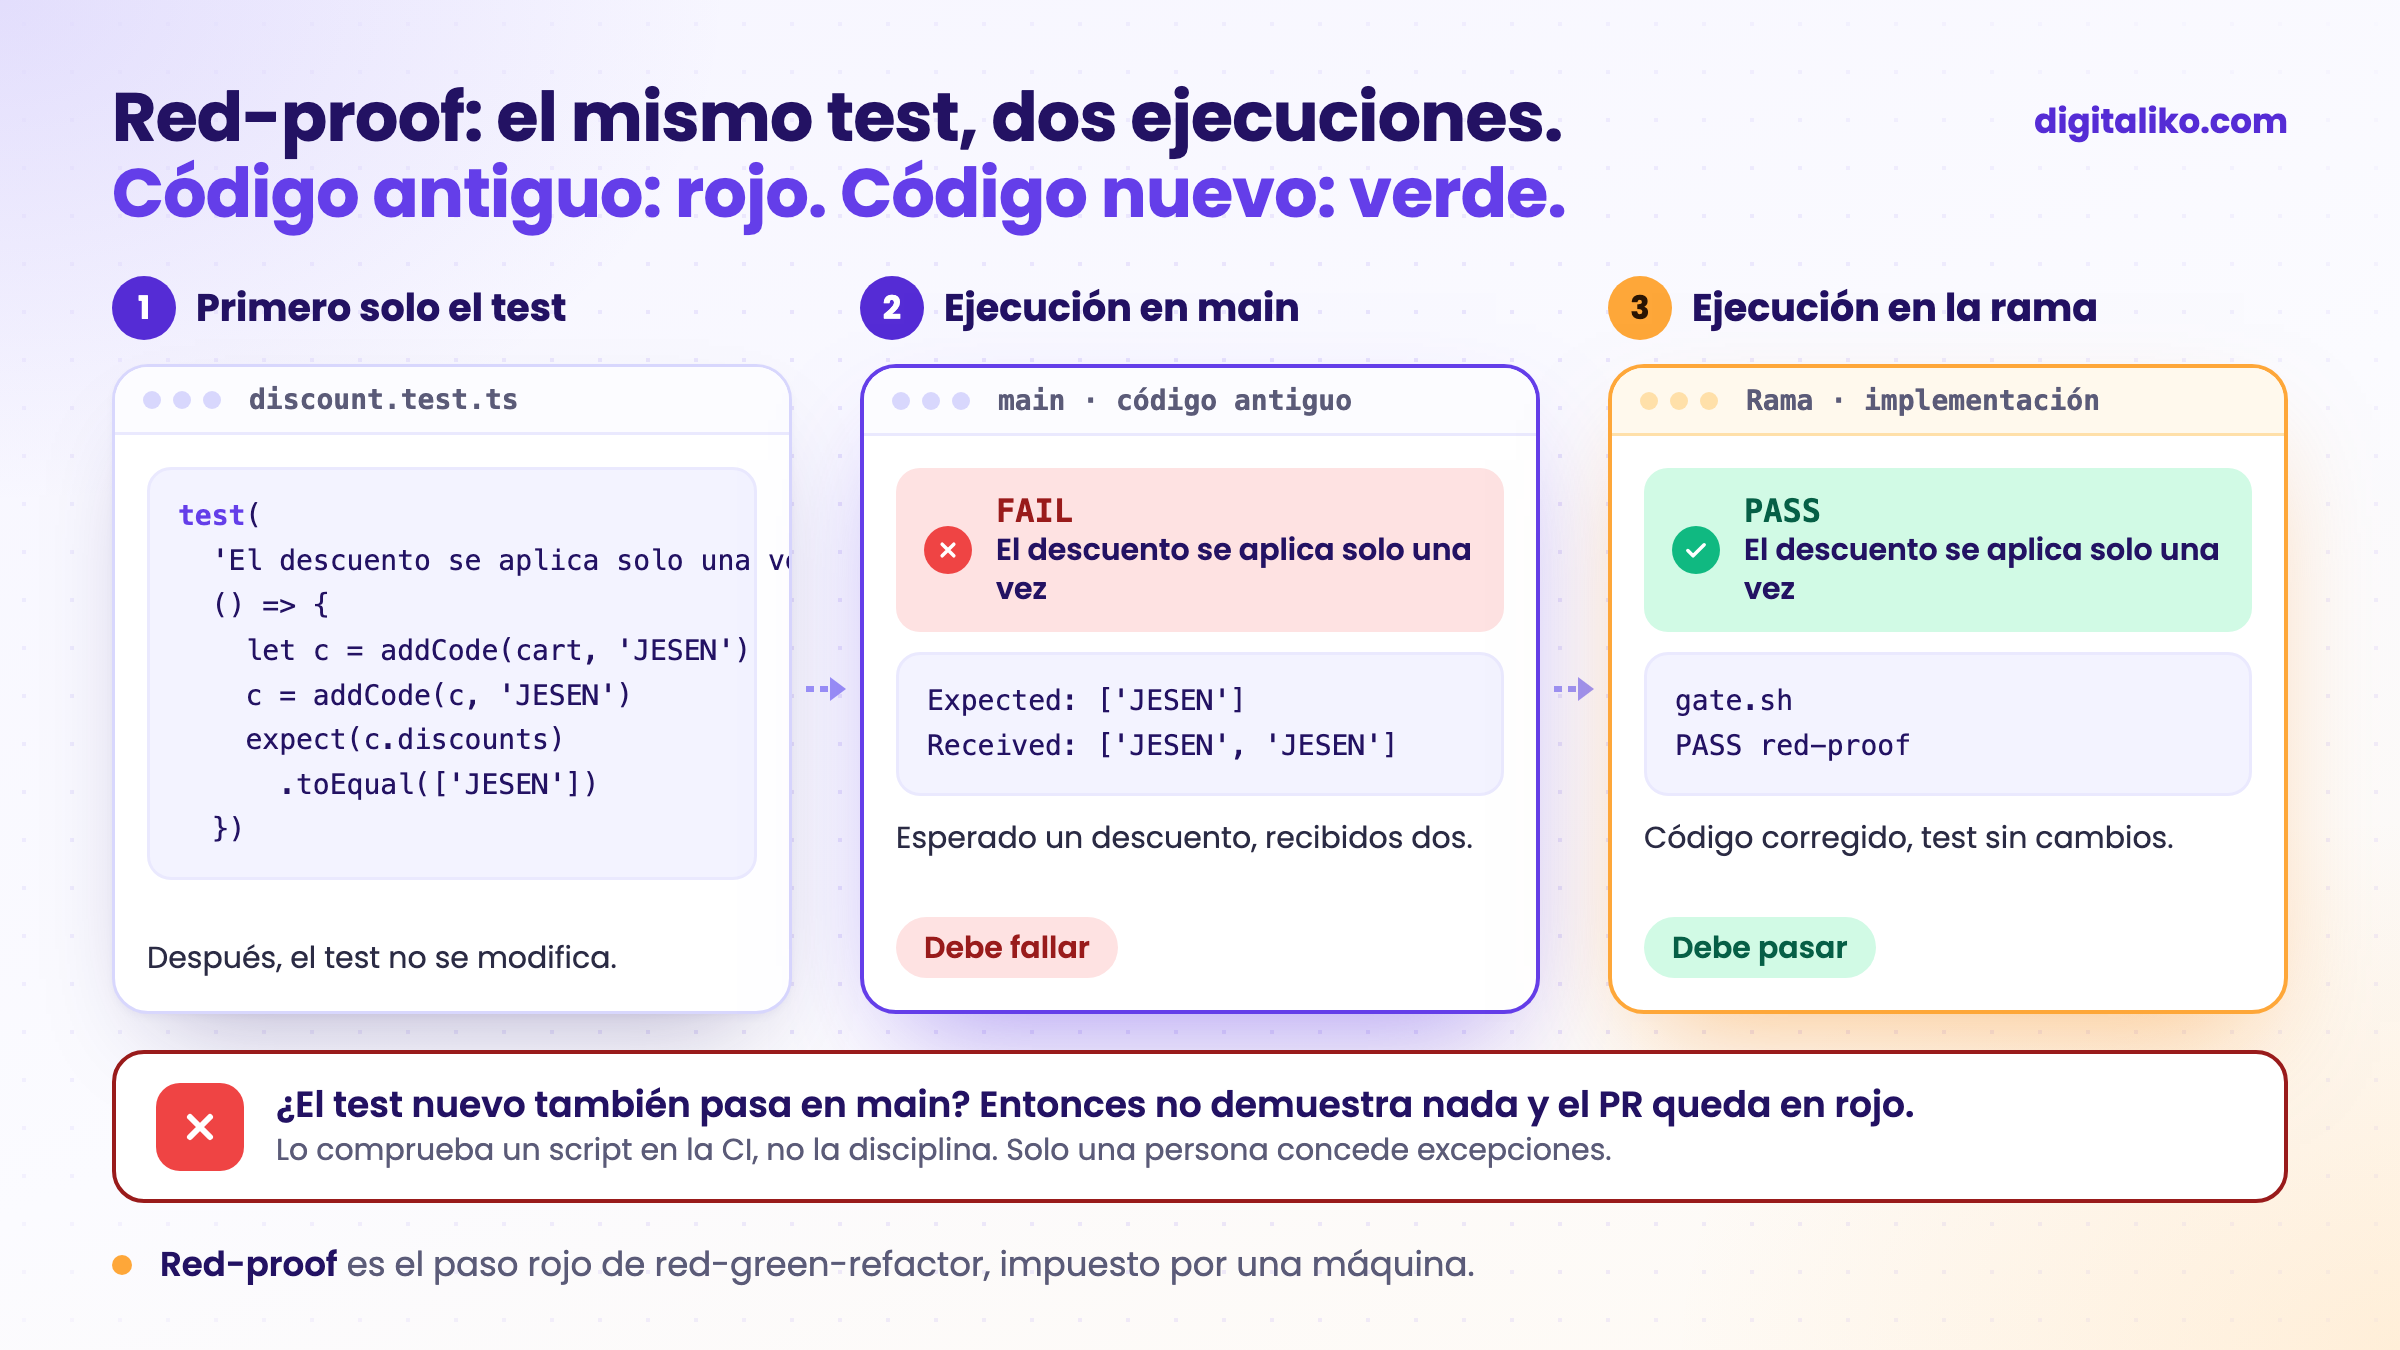
El brief que recibe nuestro agente para tareas de código dice lo mismo con palabras. Escriba un test para el criterio de mayor riesgo y haga commit de él solo. Debe fallar con el código sin modificar. Después implemente. No edite el test después de su commit.
Las palabras son una petición. La barrera es el cerrojo.
¿Cómo lo comprueba la barrera?
Es bash simple, gate.sh en el entorno de nuestro agente. El núcleo, resumido:
# red-proof: the branch's new/changed tests must FAIL on the base code, or they prove nothing
changed=$(git diff --name-only "$base"...HEAD; git ls-files --others --exclude-standard)
tests=$(printf '%s\n' "$changed" | grep -E '(^|/)(tests?|__tests__|spec)/|\.(test|spec)\.[a-z]+$')
src=$(printf '%s\n' "$changed" | grep -E '\.(ts|tsx|js|jsx|mjs|py|go|rs|php|rb)$' \
      | grep -vE '(^|/)(tests?|__tests__|spec)/|\.(test|spec)\.')
if [ -z "$tests" ]; then
    [ -n "$src" ] && echo "FAIL red-proof: source changed but no test was added or changed"
else
    cmd=$(jq -r .scripts.test package.json)
    git worktree add -q --detach "$W/base" "$base"      # the old code, next to the branch
    for t in $tests; do cp "$t" "$W/base/$t"; done      # the new tests, onto the old code
    if (cd "$W/base" && sh -c "$cmd") > "$W/red-test.log" 2>&1; then
        echo "FAIL red-proof: the new tests also pass on $base, so they do not prove the change"
    else
        echo "PASS red-proof: new tests fail on $base and pass on the branch"
    fi
fi
A su alrededor hay tres reglas:
- Los tests sin un script
testfallan. Nada los ejecutaría. - El revisor lee por qué fallaron los tests en la base. La barrera imprime las primeras aserciones de la ejecución en rojo. Un fallo por un archivo o un import que falta no es un red-proof, y el revisor lo dice.
- Los tests que leen el código como texto se devuelven. Las instrucciones del revisor los mencionan: un test debe llamar a la función, renderizar el componente o pedir la ruta.
La barrera no significa que más tests sea mejor. Borramos los tests sin sentido. A veces la solución es simplificar, no añadir.
Qué se rompió: un falso aprobado con main en rojo
La primera versión tenía un agujero. Cuando la rama base ya fallaba su propia batería de tests, cada test nuevo parecía rojo allí. La barrera daba PASS a tests que no demostraban nada.
La solución: si la batería base ya falla, se ejecutan solo los archivos de tests nuevos por separado. En la base deben fallar, en la rama deben pasar. Si no pueden ejecutarse solos, el resultado no es concluyente, y no concluyente es un fallo.
scoped=""
(cd "$W/base" && sh -c "$cmd") > "$W/base-test.log" 2>&1 || scoped=" $(echo $tests)"
El segundo agujero fue el entorno. En uno de nuestros proyectos, el red-proof ejecutaba los tests sin la configuración correcta: faltaba una herramienta (turbo: command not found) y se ejecutaba otra versión de Node. Los tests en la base fallaban antes incluso de empezar. La barrera lo tomaba como red-proof, así que cada red-proof allí era un falso aprobado.
La misma corrección endureció las capturas de pantalla. Un cambio visible en la interfaz pasaba antes con cualquier PNG adjunto. Ahora necesita un antes y un después.
¿Todo cambio necesita un test en rojo?
No. Un refactor puro o un cambio de configuración no tiene nada nuevo que demostrar. Todo lo demás pasa por la barrera:
| Cambio | Red-proof | Quién decide |
|---|---|---|
| Funcionalidad nueva o corrección de un error | Sí. El test nuevo falla en la rama base y pasa en la rama. | La barrera |
| Cambio de código sin test | Fallo, el PR queda en rojo. | La barrera |
| Refactor puro o configuración | Puede quedar exento: la etiqueta skip-red-proof de nuestro starter público. | Una persona, nunca el agente |
| Cambio visible en la interfaz | Una captura de antes y otra de después, además del test. | La barrera y el revisor |
Lo contrario vale para el software crítico que calcula precios o decide sobre personas. Ahí nunca desactivamos la barrera.
Hay una diferencia entre una app hecha deprisa a base de vibe coding y algo crítico. Aunque el código lo escriba un agente, ahí necesitas los tests y todas las barreras.

¿Cómo añadir el red-proof a su CI?
La misma barrera está en nuestro Claude Code production starter público, con licencia MIT. Ejecútela en local antes de dar algo por terminado:
bash scripts/gate.sh all origin/mainEl orden que recomendamos:
01
Primero el test
El agente escribe un test para el criterio de mayor riesgo y hace commit de él solo.
02
Barrera en local
Antes de dar algo por terminado, ejecuta gate.sh contra origin/main.
03
Job en la CI
Un job de red-proof propio en cada pull request.
04
Las excepciones, una persona
La etiqueta skip-red-proof solo para un refactor puro o configuración.
El starter incluye la versión más simple, sin la reejecución por separado, así que mantenga su rama principal en verde. Es un buen consejo de todos modos.
Reglas como «un test debe fallar primero» van en el repositorio, no en la cabeza de un senior. Más en CLAUDE.md y AGENTS.md: reglas para el código de IA en equipo. Por qué las comprobaciones alrededor del modelo importan más que el modelo lo explicamos en Harness engineering en la práctica: de la issue al PR.
¿Quiere tests de IA que demuestren algo?
Configuramos barreras así directamente en el repositorio del equipo como parte de AI-native SDLC para equipos de desarrollo. ¿A su equipo le faltan más manos que reglas? Vea un desarrollador senior para su equipo. Desde 2023 hemos entregado más de 15 proyectos en producción. Un senior se incorpora a su repositorio y a sus pull requests desde el primer día.
Le respondemos en dos días laborables con unas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Cuáles de sus tests seguirían pasando si borrara la funcionalidad?
En resumen
- Un test que pasa antes y después del cambio no demuestra el cambio.
- Red-proof: el test nuevo debe fallar en la rama base y pasar en la rama.
- Lo comprueba un script en la CI, no la disciplina. Solo una persona concede excepciones.
- Si main ya falla, ejecute los archivos de tests nuevos por separado. No concluyente es un fallo.
Preguntas frecuentes
¿Qué es red-green-refactor?
Un ciclo de desarrollo guiado por tests: escribir un test que falla (rojo), escribir el código que lo hace pasar (verde) y después limpiar (refactor). El paso rojo demuestra que el test comprueba el comportamiento nuevo.
¿Cómo se hace desarrollo guiado por tests con agentes de IA?
Haga que el agente escriba primero un test y haga commit de él solo, y después implemente. Impóngalo en la CI: el test nuevo debe fallar en la rama base y pasar en la rama. Si no, el PR queda en rojo.
¿Por qué un test nuevo debe fallar en la rama base?
Un test que pasa antes y después del cambio no prueba el cambio. Puede que no pruebe nada en absoluto, o solo un comportamiento que ya existía.
¿Qué pasa si la rama principal ya tiene tests que fallan?
Entonces toda la batería falla en la rama base y cada test nuevo parece rojo. Ejecute solo los archivos de tests nuevos por separado. Si no pueden ejecutarse solos, trate el resultado como un fallo, no como un aprobado.
¿Puede un agente saltarse el red-proof?
No por su cuenta. Un refactor puro o un cambio de configuración puede quedar exento, pero eso lo decide una persona, con una etiqueta en el pull request.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

