Context engineering para agentes de programación: qué va en el repo
Para CTO y desarrolladoresHarness y controles

Filip PapranecFundador de Digitaliko
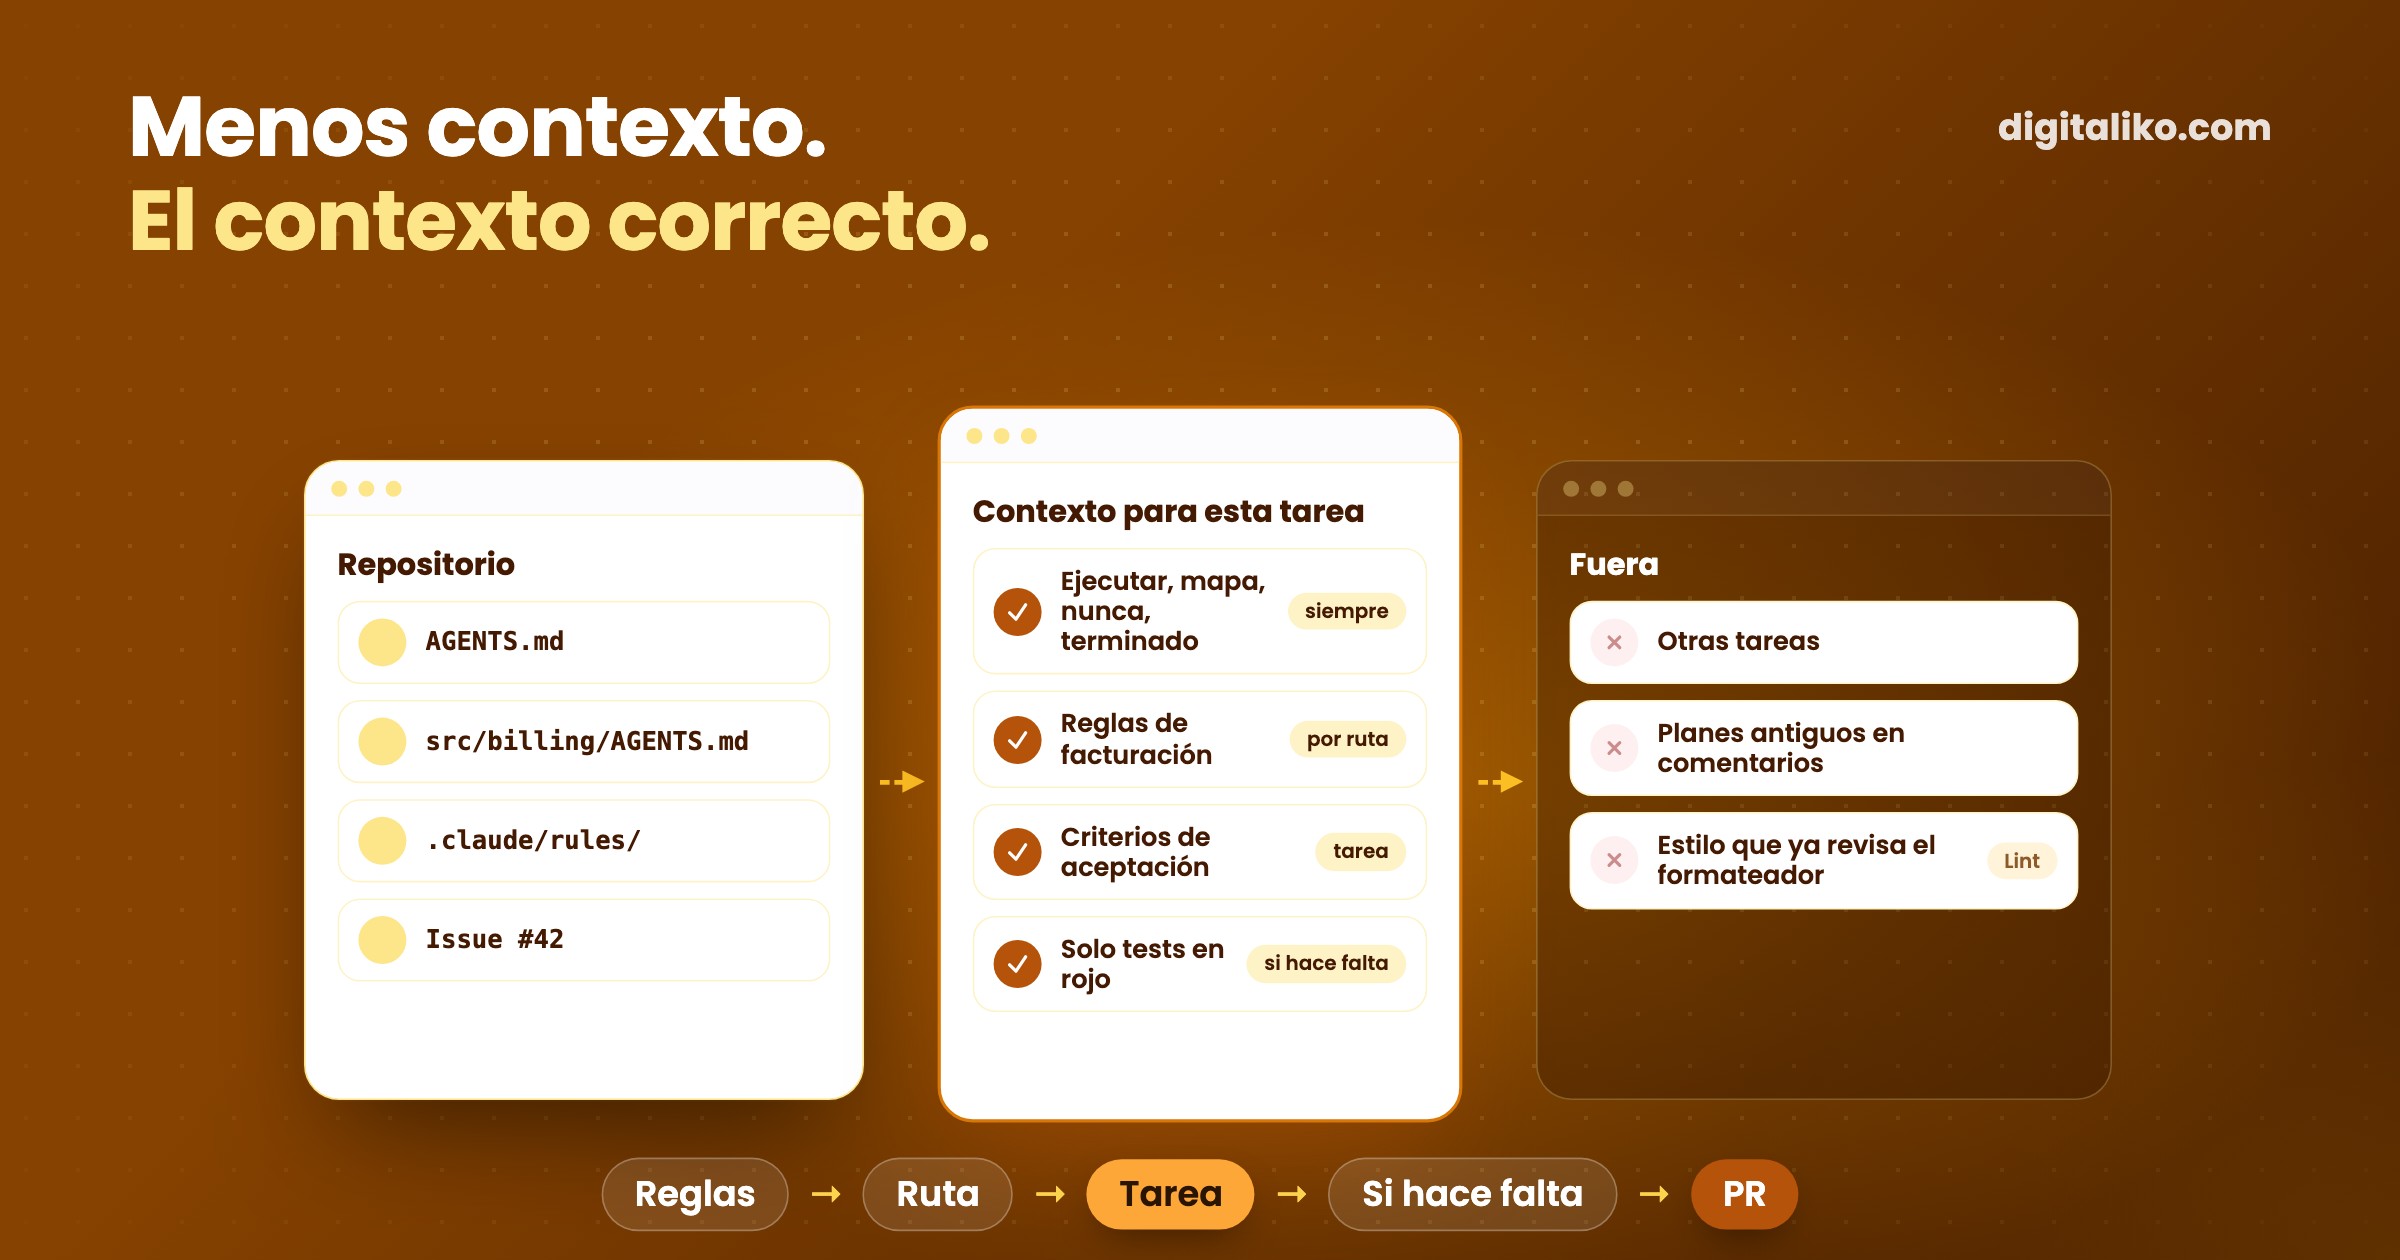
Context engineering es decidir qué ve un agente de programación con IA antes y durante su trabajo: los archivos de reglas, la tarea, el código que abre y la salida de sus herramientas. En un repositorio se reduce a tres cosas. Un archivo corto que siempre se carga (AGENTS.md o CLAUDE.md), reglas que se cargan solo donde aplican y una tarea escrita con criterios de aceptación. Todo lo demás el agente debe buscarlo cuando lo necesite, no cargarlo desde el principio.
En Digitaliko la mayor parte del código la escribe la IA. Un sénior revisa cada cambio y responde de lo que llega a producción. A continuación verá qué va en cada capa, con ejemplos genéricos que puede copiar, cómo mantenemos el contexto pequeño y qué eliminamos porque empeoraba al agente.
Good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.
¿Qué es el context engineering?
Un modelo solo sabe lo que hay en su ventana de contexto en esa llamada. En un agente de programación esa ventana se llena rápido: el prompt de sistema, los archivos de reglas, la tarea, cada archivo que lee, cada comando que ejecuta y la salida que recibe.
La ventana es un presupuesto, no un cubo. Anthropic describe el context rot: a medida que crece el contexto, baja la capacidad del modelo de recordar lo que contiene. Una regla en la línea 400 de un archivo largo está ahí técnicamente y desaparece en la práctica.
Por eso el context engineering son sobre todo dos decisiones. Qué entra por defecto. Y qué se queda fuera hasta que el agente lo pide.
Contexto, prompt o especificación: ¿qué diferencia hay?
Los tres términos se confunden. Describen capas distintas de lo mismo.
| Prompt | Contexto | Especificación | |
|---|---|---|---|
| Qué es | Un mensaje al modelo | Todo lo que el modelo ve para la tarea | La parte del contexto que dice qué significa terminado |
| Quién lo escribe | Quien pregunta | El equipo, el harness y las herramientas | El responsable de la tarea |
| Dónde vive | El chat | Archivos del repositorio, salida de herramientas, historial | El issue o un documento enlazado |
| Cuánto dura | Un turno | Una sesión | Hasta que la tarea se fusiona |
| Qué falla | Redacción vaga | Demasiado, desactualizado o contradictorio | Faltan criterios de aceptación |
La especificación merece su propio artículo, y lo tiene: spec-driven development con agentes de IA. Aquí nos quedamos en el repositorio: qué tiene que haber en él para que cada sesión del agente empiece con el contexto correcto.
¿Qué va en el archivo que siempre se carga?
AGENTS.md (o CLAUDE.md en Claude Code) se carga en cada tarea. Eso lo convierte en el texto más caro del repositorio. Solo debe estar ahí lo que el agente no puede deducir del código.
Un ejemplo genérico que sirve para la mayoría de repositorios:
# AGENTS.md

## Run
- Install: `pnpm install`
- Check everything: `pnpm check` (typecheck, lint, tests)
- One test file: `pnpm test path/to/file.test.ts`

## Map
- `src/billing/` holds the invoice rules. It has its own AGENTS.md.
- `src/generated/` is generated. Never edit it by hand.
- Tests sit next to the code as `*.test.ts`.

## Never
- Touch the production database or `.env*` files.
- Change a migration that is already merged. Add a new one.
- Push to `main`. Open a pull request.

## Done means
- `pnpm check` is green.
- New behaviour has a test that failed before the change.
- The PR says what changed and how it was checked.
Cuatro apartados: cómo ejecutarlo, dónde está cada cosa, qué está prohibido y qué significa terminado. Si su equipo usa Claude Code junto a otras herramientas, mantenga un solo archivo. Claude Code lee hoy AGENTS.md directamente, y donde no lo hace, un CLAUDE.md con la única línea @AGENTS.md lo importa.
Qué no va ahí: el estilo que ya impone el formateador, ensayos de arquitectura, la historia de una decisión y reglas que solo aplican en una carpeta. Cómo decidir dónde vive cada regla, y cuáles deberían ser lint en lugar de texto, lo explicamos en CLAUDE.md y AGENTS.md: reglas para el código de IA en un equipo.
¿Cómo se cargan las reglas solo donde aplican?
Mediante la estructura de carpetas. Una regla que solo importa para la facturación no debería costar nada mientras el agente edita la página de inicio de sesión.
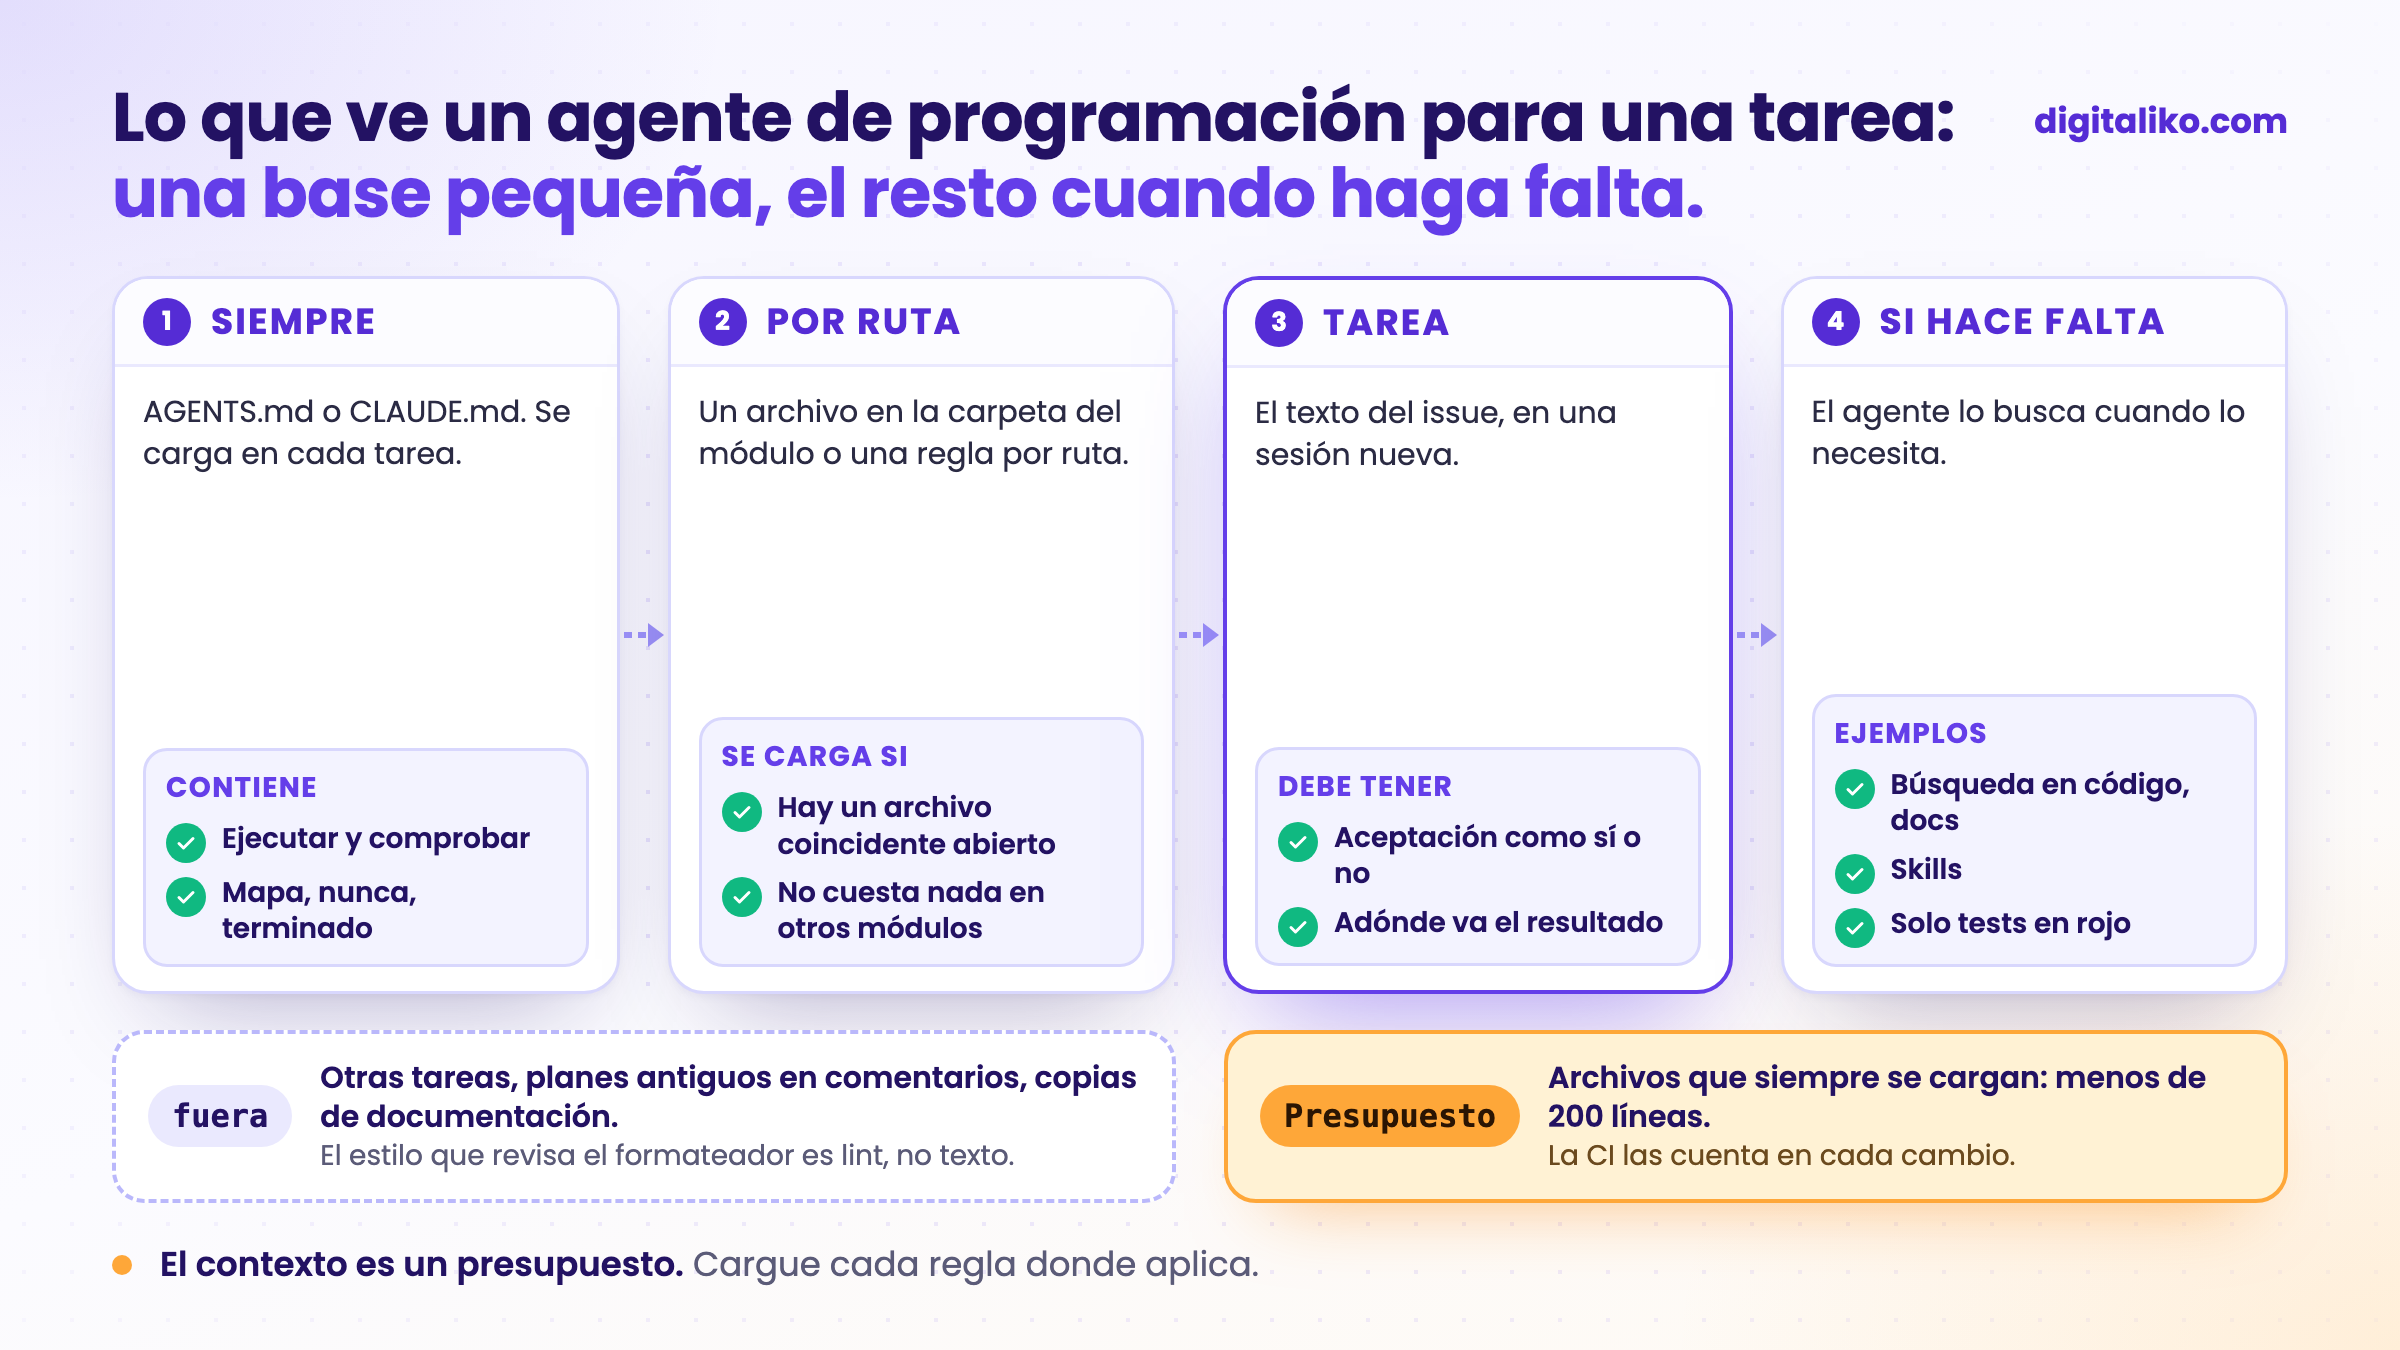
Hay tres mecanismos, y funcionan en este orden:
- Un archivo en la carpeta del módulo.
src/billing/AGENTS.mdosrc/billing/CLAUDE.md. Claude Code lo carga cuando hace falta, en cuanto el agente lee o edita un archivo de esa carpeta. - Reglas por ruta. Un archivo de reglas en
.claude/rules/con un campopathsen su frontmatter se carga solo cuando el agente toca un archivo que coincide:
---
paths:
  - "src/billing/**/*.ts"
---

# Billing rules
- Money is integer cents. Never floats.
- Every price change writes an audit row.
- Skills y documentos enlazados. Un flujo de trabajo como "cómo escribimos una migración" vive en una skill o en un documento. El agente ve una descripción de una línea y carga el contenido solo cuando la tarea lo necesita.
Una trampa: una importación @path no ahorra contexto. El archivo importado se carga junto con el que lo importa. Las importaciones mantienen ordenado un archivo largo. No lo hacen más corto.
¿Qué ve el agente para una tarea?
Para nosotros, una tarea es un issue de GitHub, una sesión nueva y un pull request. Así se monta el contexto de esa sesión.
01
Una sesión nueva
Sin historial de otras tareas. Cada issue empieza limpio en su propio worktree.
02
El archivo que siempre se carga
Ejecutar, mapa, nunca, terminado. Lo bastante corto para leerlo en un minuto.
03
La tarea
El cuerpo del issue: qué cambiar, criterios de aceptación, adónde va el resultado.
04
Reglas por ruta
Las reglas del módulo se cargan solo cuando el agente abre archivos de ese módulo.
05
Lo que busca cuando lo necesita
Búsqueda en el código, documentación, skills y salida de los tests, cuando el agente los necesita.
La tarea es la parte que los equipos subestiman. Un issue mínimo que un agente puede terminar:
## What
Add CSV export to the invoice list.

## Acceptance
- An empty list exports the header row only.
- Totals in the file match the invoice detail.

## Output
One PR with a test that fails on main and passes on the branch.
Hay dos reglas más que conviene tener en cualquier ciclo. El texto de fuera, como los comentarios de un issue o los correos pegados, llega al modelo marcado como datos, no como instrucciones. Y el revisor recibe su propio contexto nuevo con herramientas de solo lectura. Ve la tarea, el diff y las comprobaciones, no el razonamiento del agente que escribió el código. De eso se trata: juzga el resultado, no la historia. Más sobre esto en harness engineering en la práctica.
¿Cómo se mantiene pequeño el contexto?
La mayor parte del contexto no se añade a propósito. Se acumula. Estos hábitos lo mantienen a raya:
- Referencias, no copias. "Las reglas de la API están en
docs/api.md" cuesta una línea. Pegar el documento cuesta cien, y se queda desactualizado. - Un presupuesto que comprueba el build. "Que sea corto" dura unas dos semanas. Un recuento de líneas en la CI dura.
- Una tarea por sesión. Una sesión larga arrastra cada tarea anterior a la siguiente. Una sesión nueva sale más barata que un resumen.
- Búsquedas en un subagente. Deje que un agente auxiliar lea veinte archivos y devuelva diez líneas. La sesión principal recibe la respuesta, no la búsqueda.
- Salida corta de las herramientas. Un test runner que solo imprime los fallos da al agente lo que necesita. Dos mil líneas de tests que pasan le dan ruido.
Una comprobación de presupuesto son unas pocas líneas. Anthropic recomienda menos de 200 líneas por CLAUDE.md:
# fail CI when the always-loaded agent files grow past the budget
total=$(cat AGENTS.md CLAUDE.md 2>/dev/null | wc -l)
[ "$total" -le 200 ] || { echo "Agent context: $total lines (max 200)"; exit 1; }La nuestra cuenta juntos el archivo raíz y todas las reglas que se cargan sin condiciones, así que su límite es de 300 líneas, no de 200. Se ejecuta en la CI de nuestros repositorios. Cómo encaja en la configuración de un equipo lo explicamos en buenas prácticas de Claude Code para equipos.
¿Qué eliminamos del contexto?
Más de lo que añadimos. Los cambios que más ayudaron fueron eliminaciones:
- Planes antiguos en los comentarios de los issues. Nuestra comprobación de preparación leía todo el hilo del issue. Un plan desactualizado en un comentario le hacía rechazar issues que estaban bien. Ahora solo el cuerpo del issue cuenta como tarea. El contexto desactualizado es peor que ninguno.
- Copias de las reglas. Las reglas copiadas en varios repositorios se fueron separando en pocas semanas. Ahora una única fuente versionada se carga en todas partes.
- Flujos de trabajo en el archivo raíz. Las secciones largas de instrucciones pasaron a skills que se cargan solo cuando se usan. En el archivo raíz quedó solo el texto que aplica a cada tarea.
- Las reglas más importantes, como texto. Las importantes se convirtieron en lint, tests y hooks. Ya no necesitan estar en el contexto, porque detienen por sí solas un cambio incorrecto.
Un texto el agente lo puede interpretar a su manera. Una comprobación, no.

Ese último punto es el límite del context engineering. El contexto hace probable el camino correcto. Las comprobaciones hacen imposible el incorrecto. Necesita ambos.
¿Está en forma el contexto de su repositorio?
¿Quiere esto configurado en su repositorio?
Configuramos los archivos de reglas, las reglas por ruta, el formato de los issues y las comprobaciones directamente en el repositorio del equipo dentro de AI-native SDLC para equipos de desarrollo. Desde 2023 hemos entregado más de 15 proyectos en producción. Un sénior se incorpora a su repositorio y a sus pull requests desde el primer día.
Le respondemos en un plazo de dos días laborables con unas preguntas sobre su trabajo. Después acordamos qué abordamos primero.
Si prefiere hablar antes, reserve una llamada introductoria de 15 minutos.
¿Qué lee hoy primero su agente, y cuándo borró alguien por última vez una línea de ahí?
En resumen
- El context engineering decide qué ve un agente de programación: archivos de reglas, la tarea, los archivos que abre y la salida de las herramientas.
- El AGENTS.md o CLAUDE.md que siempre se carga contiene cuatro cosas: ejecutar, mapa, nunca, terminado. Manténgalo por debajo de 200 líneas.
- Las reglas de un módulo se cargan solo donde aplican: un archivo en la carpeta o una regla por ruta.
- Una tarea por sesión nueva, con una tarea escrita y criterios de aceptación.
- Más contexto no es mejor. Elimine el texto desactualizado y convierta las reglas más importantes en comprobaciones.
Preguntas frecuentes
¿Qué es el context engineering?
Decidir qué ve un modelo de IA antes y durante su trabajo: instrucciones, archivos de reglas, la tarea, los archivos que abre, la salida de las herramientas y el historial. En un agente de programación, la mayor parte de ese contexto está en el repositorio, así que el context engineering es sobre todo trabajo en el repositorio.
¿Qué diferencia hay entre context engineering y prompt engineering?
El prompt engineering afina un mensaje. El context engineering gestiona todo lo demás que el modelo ve durante una tarea completa: qué reglas se cargan, qué archivos lee, qué devuelve una herramienta y qué se descarta. Un buen prompt no arregla un agente que nunca ve sus convenciones.
¿Qué va en AGENTS.md o CLAUDE.md?
Lo que el agente no puede deducir del código: cómo ejecutar y comprobar el proyecto, dónde está cada cosa, qué no debe hacer nunca y qué significa terminado. Manténgalo corto, porque se carga en cada tarea. Las reglas de un módulo van en ese módulo, no en el archivo raíz.
¿Más contexto es mejor para un agente de programación?
No. Cada línea compite por la atención del modelo y su capacidad de recordar baja a medida que crece el contexto. Dé al agente una base pequeña y relevante y deje que busque el resto cuando lo necesite.
¿Qué relación hay entre context engineering y una especificación?
La especificación es la parte del contexto que dice qué significa terminado. En nuestro caso es el issue: qué cambiar, criterios de aceptación y adónde va el resultado. Sin ella, más contexto solo produce un resultado erróneo con más seguridad.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

