Playwright MCP: que el agente de IA demuestre que funciona
Para CTO y desarrolladoresHarness y controles

Filip PapranecFundador de Digitaliko
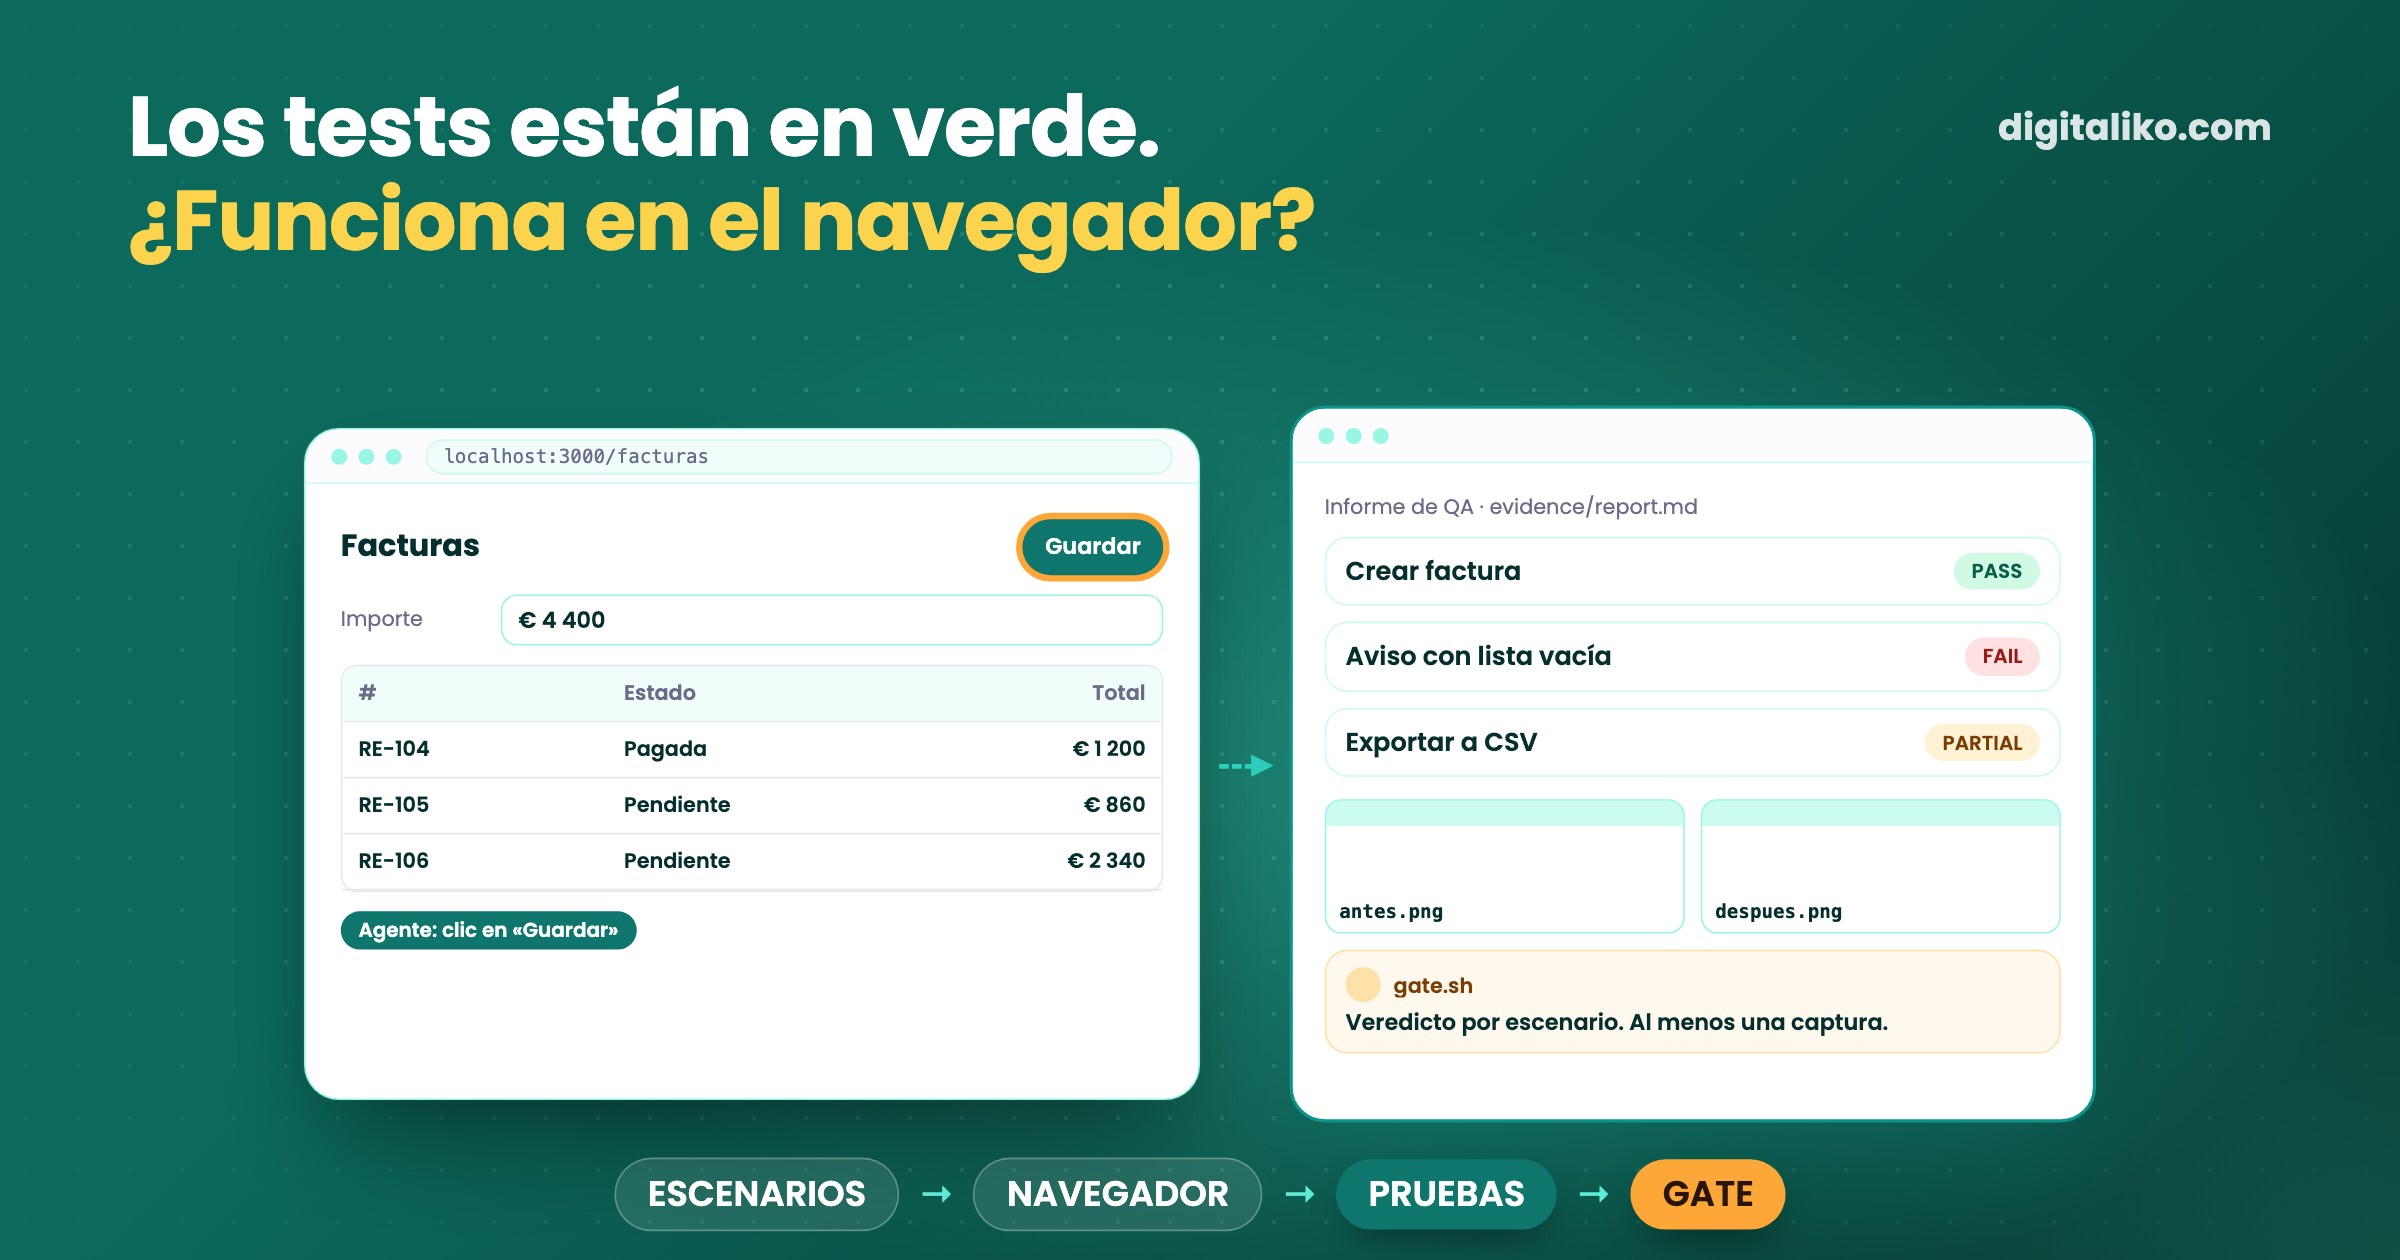
Playwright MCP es un servidor MCP de Microsoft que da a un agente de IA un navegador real: abre páginas, hace clic, escribe y lee lo que hay en pantalla. Lo usamos para una sola tarea. Antes de que nadie diga "terminado", el agente recorre el cambio en la app en marcha y entrega PASS o FAIL por escenario, con capturas.
Un typecheck en verde demuestra que el código compila. Un test de componente que pasa demuestra que el componente se renderiza en su propio entorno de pruebas. Ninguno demuestra que la página real, con datos reales, hace lo que pedía el issue. Ese hueco es el que cierra la comprobación en el navegador.
El paso más difícil suele ser el último. Comprobar que de verdad funciona, de principio a fin.

¿Qué es Playwright MCP y cómo funciona?
MCP, el Model Context Protocol, es la forma en que un agente como Claude Code obtiene herramientas adicionales. El servidor Playwright MCP añade herramientas de navegador basadas en Playwright: navegar, hacer clic, escribir, rellenar un formulario, leer la consola y las peticiones de red, hacer una captura.
En Claude Code es un solo comando:
claude mcp add playwright npx @playwright/mcp@latestEl detalle importante: el agente no mira píxeles. Según el README, trabaja "through structured accessibility snapshots, bypassing the need for screenshots or visually-tuned models", es decir, con snapshots estructurados de accesibilidad, sin capturas ni modelos de visión. El agente recibe la página como un árbol de botones, enlaces, encabezados y campos de formulario con sus etiquetas. Hace clic en el botón llamado "Guardar", no en el punto de las coordenadas donde antes había un botón.
De ahí salen dos efectos secundarios. Una página cuyos botones no tienen nombre accesible también es difícil para el agente, así que la comprobación sirve a la vez de pequeña revisión de accesibilidad. Y el agente puede seguir haciendo una captura cuando una persona necesita ver el resultado.
Por defecto, el servidor mantiene un perfil de navegador persistente, así que un inicio de sesión sobrevive entre sesiones. Para ejecuciones que deben empezar de cero existe --isolated, y --storage-state carga cookies guardadas en ese contexto limpio.
¿Cómo hacemos que el agente compruebe su propio cambio?
El método está en nuestro skill browser-qa. No cambia código de la app. Escribe pruebas:
01
Escenarios desde el issue
Un escenario por criterio de aceptación o comentario, cada uno vinculado a su origen. Pasos concretos: clic en X, entonces pasa Y.
02
Datos reales, login real
Una ejecución con datos simulados o vacíos demuestra el diseño, no el comportamiento. Primero inicia sesión una persona. El agente nunca toca el token de sesión.
03
Recorrer la app
Navegar, hacer clic, escribir, hacer una captura. Todo lo que tiene que ser exacto, un color, un número, una etiqueta, se lee de la página, no se adivina en una imagen.
04
Veredicto por escenario
PASS, FAIL o PARTIAL, con lo que realmente se vio. Nunca "parece correcto".
05
Registrar los fallos
Cada FAIL real se convierte en un issue de bug que enlaza el informe. Una nota solo en el informe se pierde.
El skill también dice qué hacer cuando la automatización no puede con algo. Un elemento tan anidado que un clic no se dispara de forma fiable recibe la nota "needs manual click". No se marca en silencio como FAIL ni se salta.
No todas las comprobaciones salen de un escenario escrito. A veces la mejor es abierta:
Un truco nos funciona bien. Enviamos a un agente a la funcionalidad como un tipo de cliente, una persona, y le dejamos explorar por su cuenta.
Un recorrido con una persona encuentra lo que nadie escribió: una etiqueta confusa, un callejón sin salida, un paso que solo tiene sentido si usted lo construyó.
¿Qué entrega el agente y quién lo comprueba?
Un informe que el agente escribe sobre sí mismo sigue siendo una afirmación. Por eso la forma de las pruebas es fija, y la comprueba un script, no un modelo.
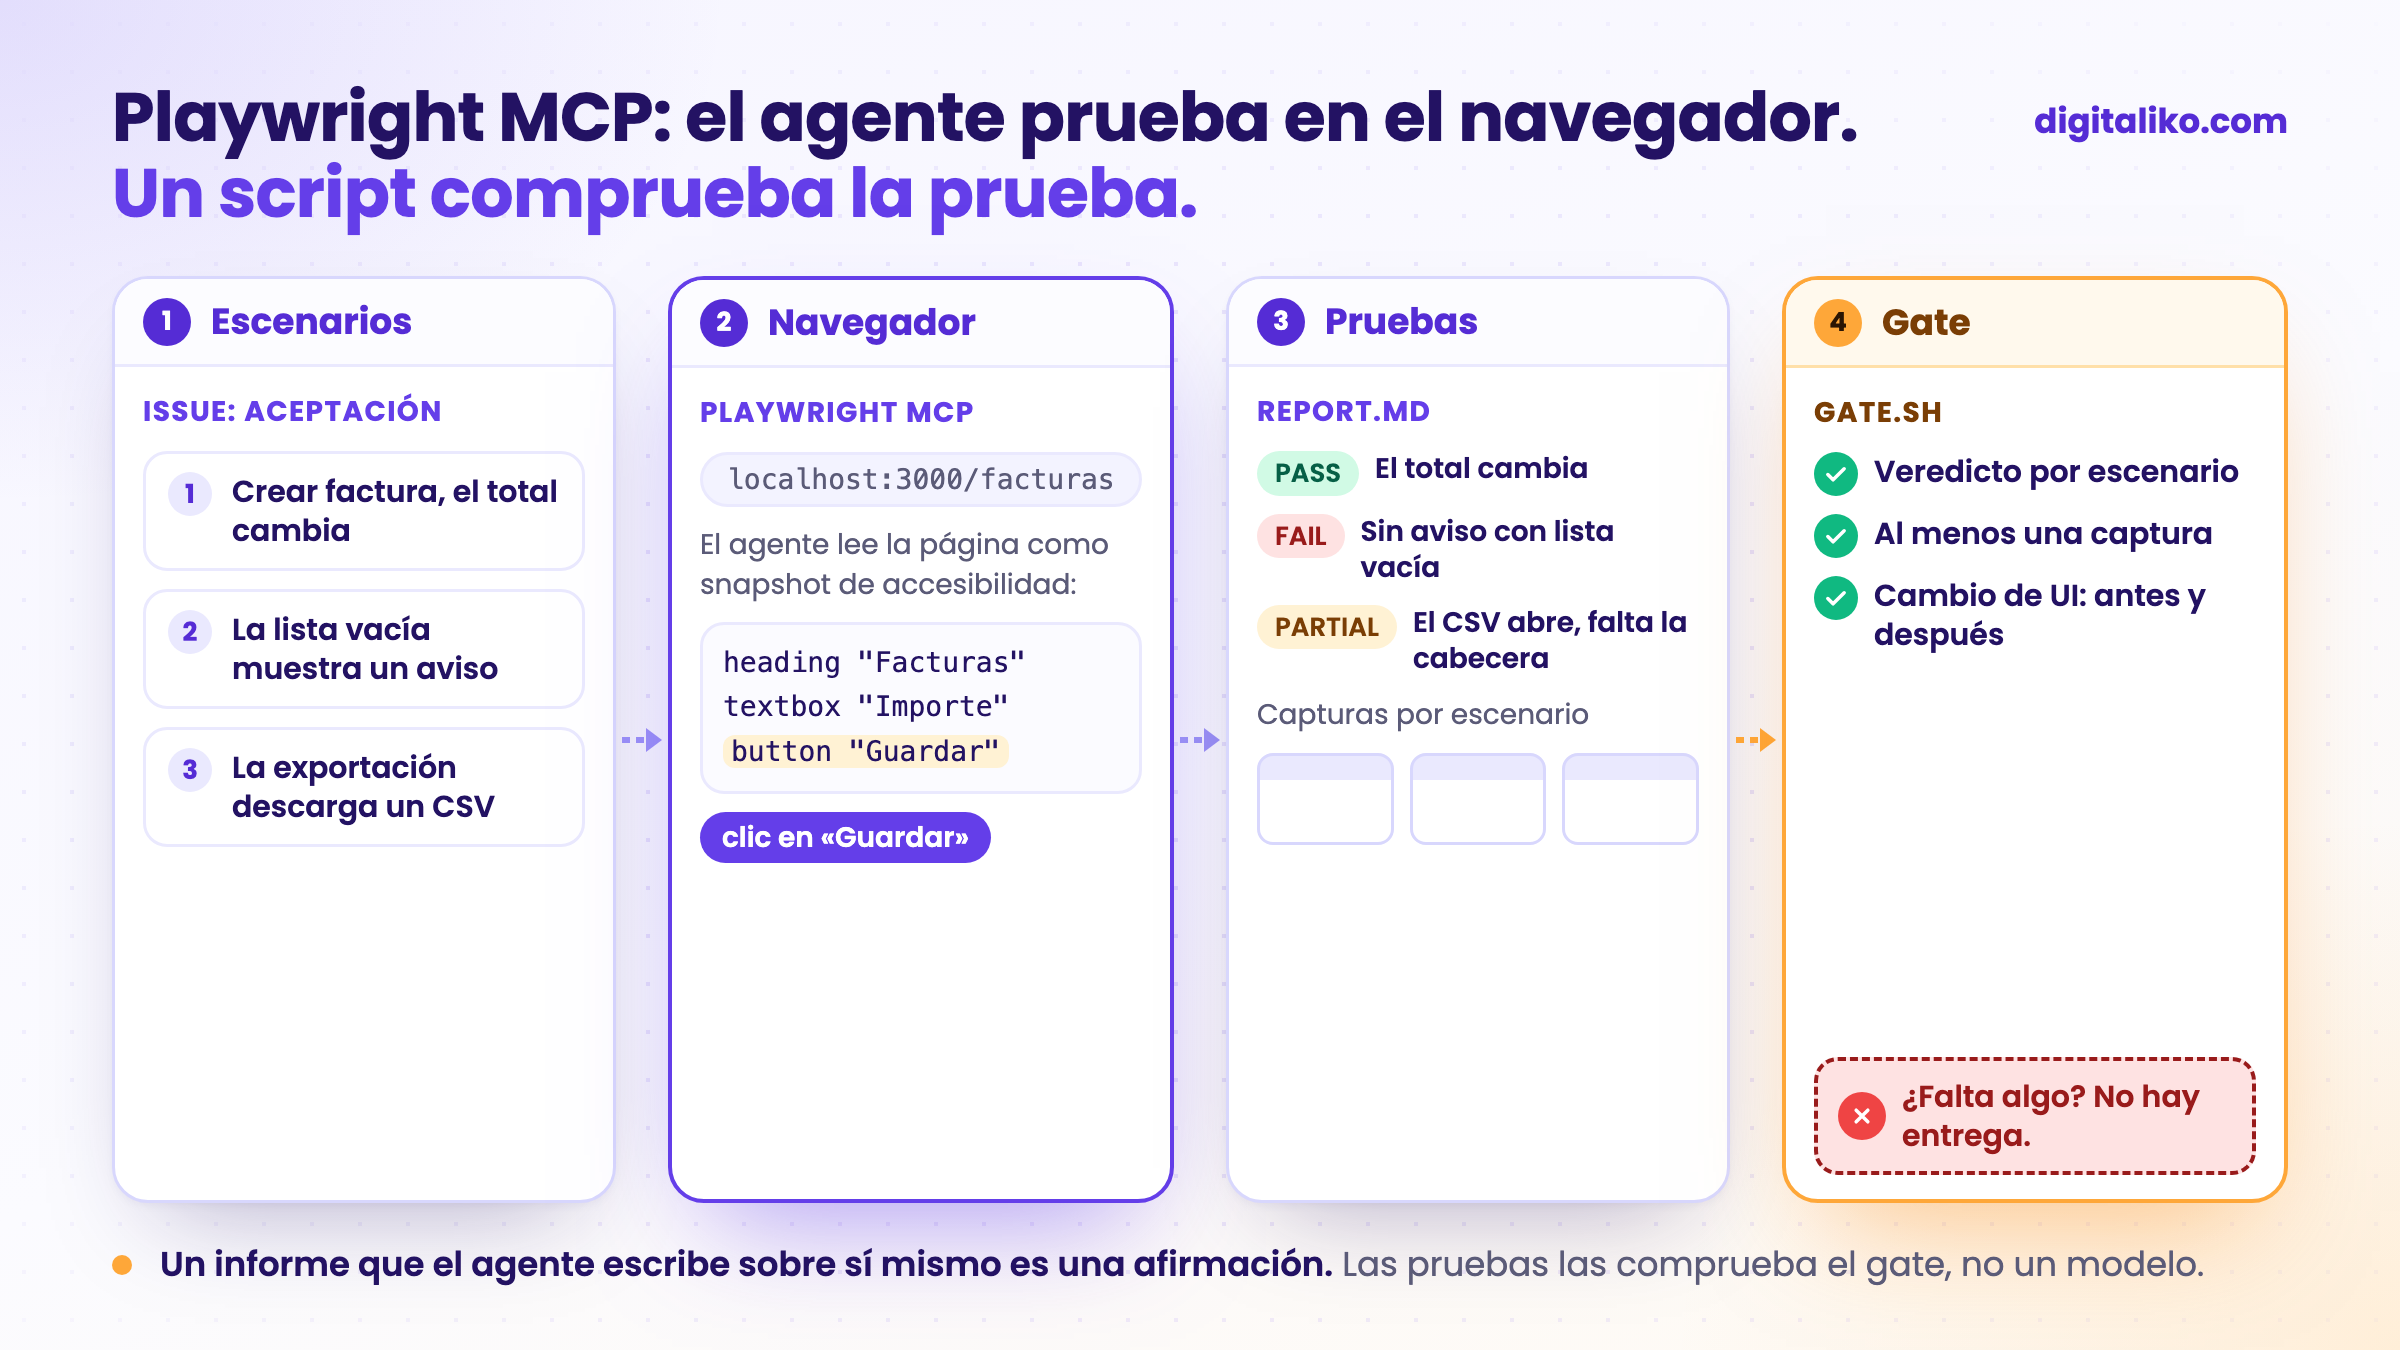
En nuestro bucle de agentes, una tarea de QA indica al agente que use las herramientas de navegador de Playwright y que guarde todo en evidence/<issue>/: una captura por escenario, los errores de consola y de red, y report.md. Después gate.sh, un simple script de bash con códigos de salida, hace el resto:
n=$(grep -cE '\b(PASS|FAIL|PARTIAL)\b' "$tree/$rep"); shots=$(ls "$tree/$(dirname "$rep")"/*.png 2>/dev/null | wc -l | tr -d ' ')
[ "$n" -gt 0 ] && [ "$shots" -gt 0 ] || { echo "FAIL: report needs PASS/FAIL per scenario and screenshots" >> "$out"; exit 1; }
Sin informe, sin líneas de veredicto o sin captura, la tarea no está terminada, diga lo que diga el agente.
Las tareas de código tienen una regla parecida. Cuando un pull request cambia archivos de interfaz, el bucle exige un before-*.png y un after-*.png. Si hay un buen motivo para no tenerlos, el PR tiene que decirlo en una línea que empiece por No screenshots:. Así quien revisa ve el cambio en lugar de imaginárselo.
Esa regla nació de un bug nuestro. Antes del arreglo, cualquier PNG contaba como prueba, así que bastaba una captura de cualquier cosa. Ahora tiene que haber dos, y con un nombre que diga lo que muestran.
¿Qué detecta una comprobación en el navegador que los tests unitarios no ven?
Un test unitario hace una pregunta estrecha en una sala controlada. El navegador pregunta si la sala existe.
| Pregunta | Test unitario o de componente | Agente en un navegador real |
|---|---|---|
| ¿Devuelve la función el valor correcto? | Sí, rápido y repetible | Solo indirectamente |
| ¿Está la ruta conectada al componente? | No, el test monta el componente él mismo | Sí, abre la URL real |
| ¿Funciona con datos parecidos a producción? | Solo con el fixture que usted escribió | Sí, si se ejecuta con datos reales |
| ¿Tiene el botón un nombre que pueda usar un lector de pantalla? | Solo si alguien escribió ese test | Sí, el snapshot lo muestra |
| ¿Hay errores de consola o de red? | Rara vez se comprueba | Sí, se leen ambos |
| ¿Tiene sentido el flujo para un cliente? | No | En parte, con un recorrido con persona |
Las dos columnas importan. La regla red-green para tests unitarios está en Red-green TDD con agentes de IA. La comprobación en el navegador va encima, no en su lugar.
Siendo sinceros sobre los límites: no hemos contado cuántos bugs detectan las comprobaciones en el navegador frente a los tests. Lo que sabemos es de qué tipo son: cosas que solo existen cuando todo está conectado.
¿Playwright MCP, scripts de Playwright o Chrome DevTools MCP?
Incluso el equipo de Playwright dice que el MCP no siempre es la herramienta adecuada. Su README recomienda para agentes de programación la Playwright CLI con skills, porque es "more token-efficient", es decir, gasta menos tokens. El MCP, escriben, "remains relevant for specialized agentic loops": sigue teniendo sentido en bucles de agentes especializados, como la automatización exploratoria o los flujos autónomos de larga duración.
Coincide con lo que vemos:
Playwright MCP
- El agente explora y decide él mismo el siguiente clic
- Bueno para comprobar un cambio una vez y para recorridos con persona
- Cuesta contexto: esquemas de herramientas y snapshots de página
Para todo lo que repite
Scripts y tests de Playwright
- La misma comprobación en cada ejecución, en CI
- Números exactos: colores calculados, tamaños, tiempos
- Alguien tiene que escribirlos primero, a menudo el agente
Chrome DevTools MCP
- Herramientas de navegador con acceso a DevTools
- Lo que nuestro skill interactivo de QA prueba ahora primero
- El mismo método, otro controlador
Cuando auditamos esta web esta semana, no usamos el MCP en absoluto. El agente escribió scripts simples de Playwright contra una build local: contraste del texto medido a partir de colores calculados, un escaneo de accesibilidad con axe, cada página renderizada con ancho de móvil y rendimiento con la CPU limitada. Son comprobaciones que queremos repetir después de cada cambio. Un script lo hace igual cada vez. Un agente que improvisa clics, no.
Y desde esta semana nuestro skill interactivo browser-qa prueba primero Chrome DevTools MCP cuando la sesión lo tiene. El método no ha cambiado en nada. El controlador del navegador es la parte sustituible.
¿Dónde sale mal?
Algunas trampas que conocemos, por nuestras reglas o por nuestros propios errores:
- Datos simulados. Un recorrido en verde sobre una base de datos vacía demuestra el diseño, nada más. El skill prohíbe darlo por terminado.
- El token de sesión. Playwright MCP tiene herramientas que leen cookies y local storage. Nuestra regla es más antigua que cualquier herramienta: el agente nunca extrae, registra ni transmite un token de sesión.
- A ojo. "El total parece correcto" en una captura es una suposición. El agente lee el valor de la página.
- Dos agentes, un perfil. Un perfil persistente solo lo puede usar un navegador a la vez. Las ejecuciones en paralelo necesitan
--isolatedo su propio directorio de perfil.
¿Qué son los agentes de Playwright y los usamos?
Los agentes de Playwright, oficialmente Playwright Test Agents, son tres definiciones de agente que vienen con el propio Playwright. Según la documentación de Playwright (a 24/10/2026): el planner "explores the app and produces a Markdown test plan", es decir, explora la app y escribe un plan de pruebas en Markdown; el generator "transforms the Markdown plan into the Playwright Test files", convierte el plan en archivos de Playwright Test; y el healer "executes the test suite and automatically repairs failing tests", ejecuta la suite y repara automáticamente los tests que fallan. Para Claude Code se añaden con un comando:
npx playwright init-agents --loop=claudeEl planner parte de un seed test, tests/seed.spec.ts, que prepara el entorno, y escribe el plan en specs/. El generator convierte el plan en tests en tests/ y comprueba en vivo los selectores y las aserciones mientras recorre los escenarios.
Siendo sinceros: todavía no hemos usado los agentes de Playwright en nuestros proyectos. Nuestros agentes escriben tests de Playwright a partir de los criterios de aceptación del issue dentro de nuestro propio bucle, y el skill browser-qa se encarga de explorar. El planner y el generator hacen buena parte de lo mismo en el formato propio de Playwright, así que vale la pena probarlos en un equipo que no tiene bucle propio.
El healer es el que vigilaríamos. La documentación dice que su resultado es "a passing test, or a skipped test if the healer believes that functionality is broken", es decir, un test que pasa o un test omitido si cree que la funcionalidad está rota. En nuestro bucle un test omitido no demuestra nada, y un test en rojo porque el producto se rompió tiene que seguir en rojo. Si prueba el healer, revise cada localizador o aserción que cambie como cualquier otro pull request.
¿Está su equipo listo para dejar que un agente compruebe en el navegador?
Repase lo que ya tiene:
Si quiere una base lista, nuestro Claude Code production starter público ya ejecuta un smoke test de Playwright en CI y sube el informe cuando falla. Cómo funciona todo el bucle a su alrededor lo cuenta Harness engineering en la práctica: del issue al PR.
¿Quiere agentes que demuestren su trabajo en su repositorio?
Configuramos comprobaciones en el navegador, reglas de pruebas y el CI a su alrededor directamente en el repositorio del equipo como parte de AI-native SDLC para equipos de desarrollo. ¿A su equipo le faltan manos más que procesos? Vea un desarrollador sénior para su equipo. La IA escribe la mayor parte de nuestro código. Un sénior revisa cada cambio y responde de lo que llega a producción. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en un plazo de dos días laborables con algunas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Quién comprueba hoy en su equipo que un cambio funciona en el navegador, y cómo lo demuestra?
En resumen
- Playwright MCP da a un agente un navegador real que lee como un snapshot de accesibilidad.
- Hacemos que el agente recorra escenarios del issue con datos reales y entregue PASS o FAIL con capturas.
- Un script, no un modelo, bloquea la entrega cuando faltan el informe o las capturas.
- Explore con el MCP. Convierta las comprobaciones que repite en tests de Playwright en CI.
Preguntas frecuentes
¿Qué es Playwright MCP?
Un servidor MCP de Microsoft que da a un agente de IA herramientas de navegador basadas en Playwright: abrir una página, hacer clic, escribir, rellenar un formulario, leer la consola y las peticiones de red, hacer una captura. El agente lee la página como un snapshot de accesibilidad, no como píxeles.
¿Cómo añado Playwright MCP a Claude Code?
Ejecute claude mcp add playwright npx @playwright/mcp@latest. Otros clientes MCP usan el mismo servidor con el comando npx y el argumento @playwright/mcp@latest en su configuración.
¿Sustituye Playwright MCP a los tests end-to-end?
No. El MCP sirve para explorar y para comprobar un cambio una vez. Una comprobación que quiere en cada pull request va en un test o script de Playwright que se ejecuta en CI, sin que nadie tenga que pedírselo a un agente.
¿Cómo prueba el agente páginas detrás de un login?
Primero una persona inicia sesión en el navegador que usa el agente, y el agente trabaja en esa sesión. Nuestra regla: el agente nunca lee, registra ni transmite el token de sesión. Para ejecuciones aisladas, Playwright MCP puede cargar un storage state guardado.
¿Basta un informe de QA de un agente para dar un cambio por terminado?
Solo con pruebas: un veredicto por escenario y las capturas al lado. En nuestro bucle, un script gate bloquea la entrega cuando faltan el informe o las capturas, y una persona sigue revisando el pull request.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

