Playwright MCP: niech agent AI udowodni, że to działa
Dla CTO i programistówHarness i kontrole

Filip PapranecZałożyciel Digitaliko
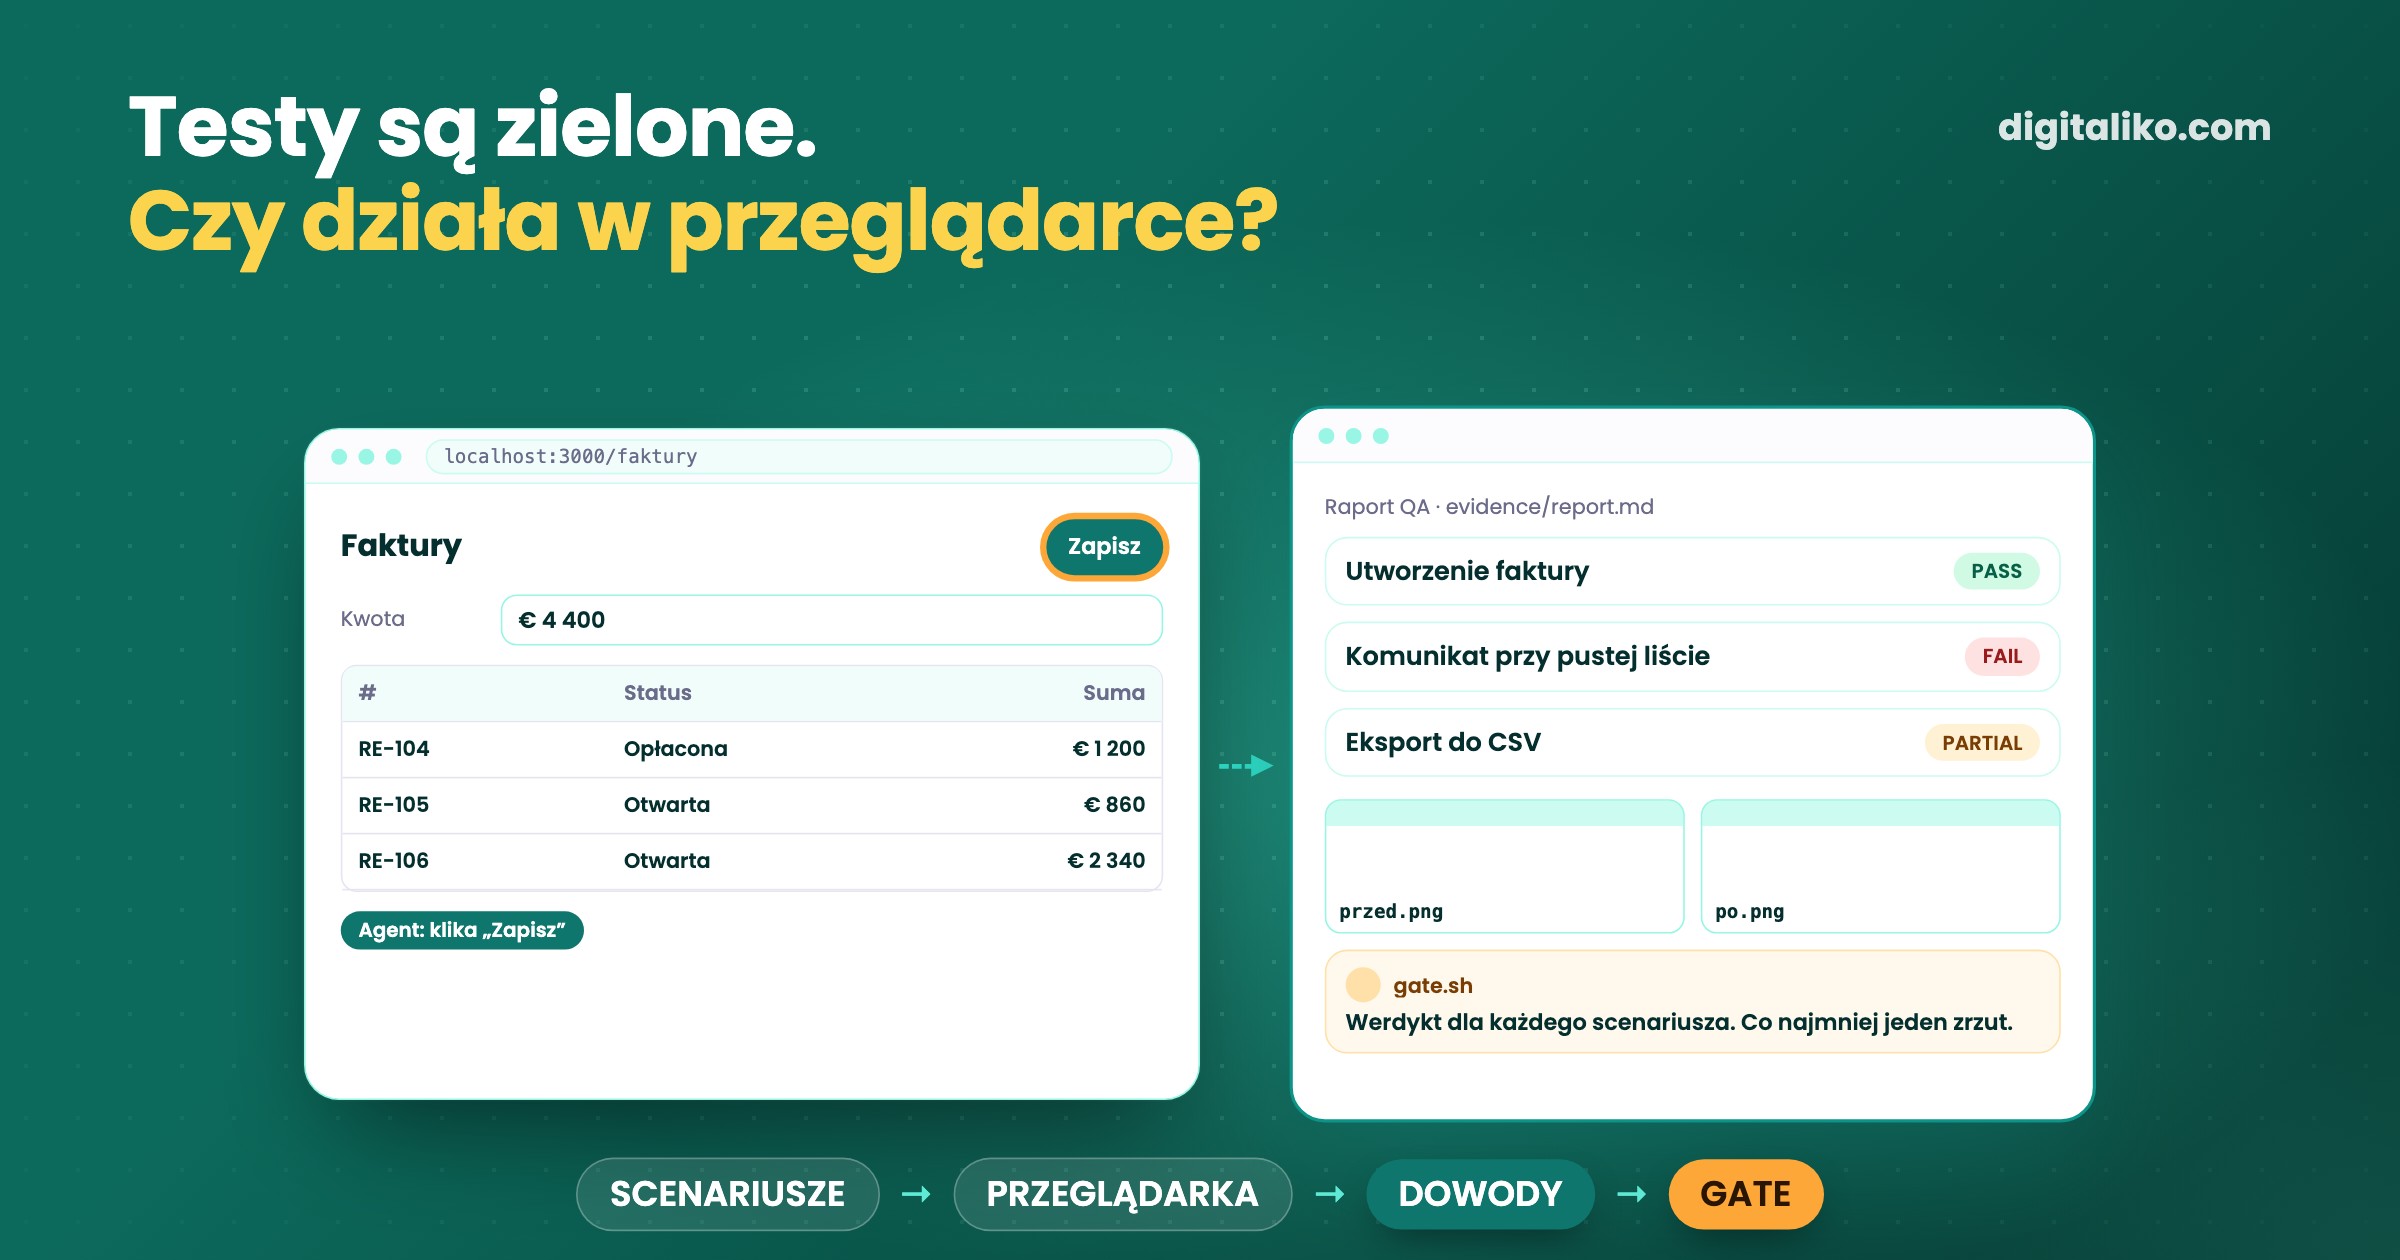
Playwright MCP to serwer MCP od Microsoftu, który daje agentowi AI prawdziwą przeglądarkę: otwiera strony, klika, wpisuje tekst i czyta, co jest na ekranie. Używamy go do jednego zadania. Zanim ktokolwiek powie „gotowe”, agent przechodzi zmianę w działającej aplikacji i oddaje PASS lub FAIL dla każdego scenariusza, ze zrzutami ekranu.
Zielony typecheck dowodzi, że kod się kompiluje. Przechodzący test komponentu dowodzi, że komponent renderuje się we własnym środowisku testowym. Żaden z nich nie dowodzi, że prawdziwa strona z prawdziwymi danymi robi to, o co prosiło issue. Tę lukę zamyka kontrola w przeglądarce.
Najtrudniejszy jest zwykle ostatni krok. Sprawdzenie, że to naprawdę działa, od początku do końca.

Czym jest Playwright MCP i jak działa?
MCP, czyli Model Context Protocol, to sposób, w jaki agent taki jak Claude Code dostaje dodatkowe narzędzia. Serwer Playwright MCP dodaje narzędzia przeglądarki oparte na Playwright: nawigację, klikanie, wpisywanie, wypełnianie formularzy, odczyt konsoli i żądań sieciowych, zrzuty ekranu.
W Claude Code to jedno polecenie:
claude mcp add playwright npx @playwright/mcp@latestKluczowy szczegół: agent nie patrzy na piksele. Według README pracuje „through structured accessibility snapshots, bypassing the need for screenshots or visually-tuned models”, czyli przez ustrukturyzowane snapshoty dostępności, bez zrzutów i modeli wizyjnych. Agent dostaje stronę jako drzewo przycisków, linków, nagłówków i pól formularza z ich etykietami. Klika przycisk o nazwie „Zapisz”, a nie punkt o współrzędnych, gdzie kiedyś był przycisk.
Wynikają z tego dwa efekty uboczne. Strona, której przyciski nie mają dostępnej nazwy, jest trudna także dla agenta, więc kontrola jest przy okazji małym przeglądem dostępności. A agent nadal może zrobić zrzut ekranu, gdy człowiek musi zobaczyć wynik.
Domyślnie serwer trzyma trwały profil przeglądarki, więc logowanie przetrwa między sesjami. Do uruchomień, które muszą zaczynać od zera, jest --isolated, a --storage-state wczytuje zapisane ciasteczka do tego czystego kontekstu.
Jak sprawiamy, że agent sprawdza własną zmianę?
Metoda jest w naszym skillu browser-qa. Nie zmienia kodu aplikacji. Zapisuje dowody:
01
Scenariusze z issue
Jeden scenariusz na kryterium akceptacji lub uwagę, każdy powiązany ze źródłem. Konkretne kroki: klik w X, wtedy dzieje się Y.
02
Prawdziwe dane, prawdziwe logowanie
Uruchomienie na danych testowych lub pustych dowodzi układu, nie zachowania. Najpierw loguje się człowiek. Agent nigdy nie dotyka tokena sesji.
03
Przejście aplikacji
Nawigacja, klik, wpisanie, zrzut ekranu. Wszystko, co musi być dokładne, kolor, liczba, etykieta, jest odczytywane ze strony, a nie zgadywane z obrazka.
04
Werdykt dla każdego scenariusza
PASS, FAIL lub PARTIAL, z tym, co naprawdę było widać. Nigdy „wygląda dobrze”.
05
Zgłoszenie błędów
Każdy prawdziwy FAIL staje się issue z błędem, które linkuje raport. Notatka tylko w raporcie ginie.
Skill mówi też, co robić, gdy automatyzacja czegoś nie potrafi. Element zagnieżdżony tak głęboko, że kliknięcie nie działa niezawodnie, dostaje notatkę „needs manual click”. Nie jest po cichu oznaczany jako FAIL ani pomijany.
Nie każda kontrola wynika ze spisanego scenariusza. Czasem najlepsza jest otwarta:
Jeden trik dobrze się u nas sprawdza. Wysyłamy agenta do funkcji jako konkretny typ klienta, personę, i pozwalamy mu eksplorować samodzielnie.
Przejście jako persona znajduje to, czego nikt nie zapisał: mylącą etykietę, ślepy zaułek, krok, który ma sens tylko dla tego, kto go zbudował.
Co oddaje agent i kto to sprawdza?
Raport, który agent pisze sam o sobie, jest nadal tylko twierdzeniem. Dlatego kształt dowodów jest stały i sprawdza go skrypt, a nie model.
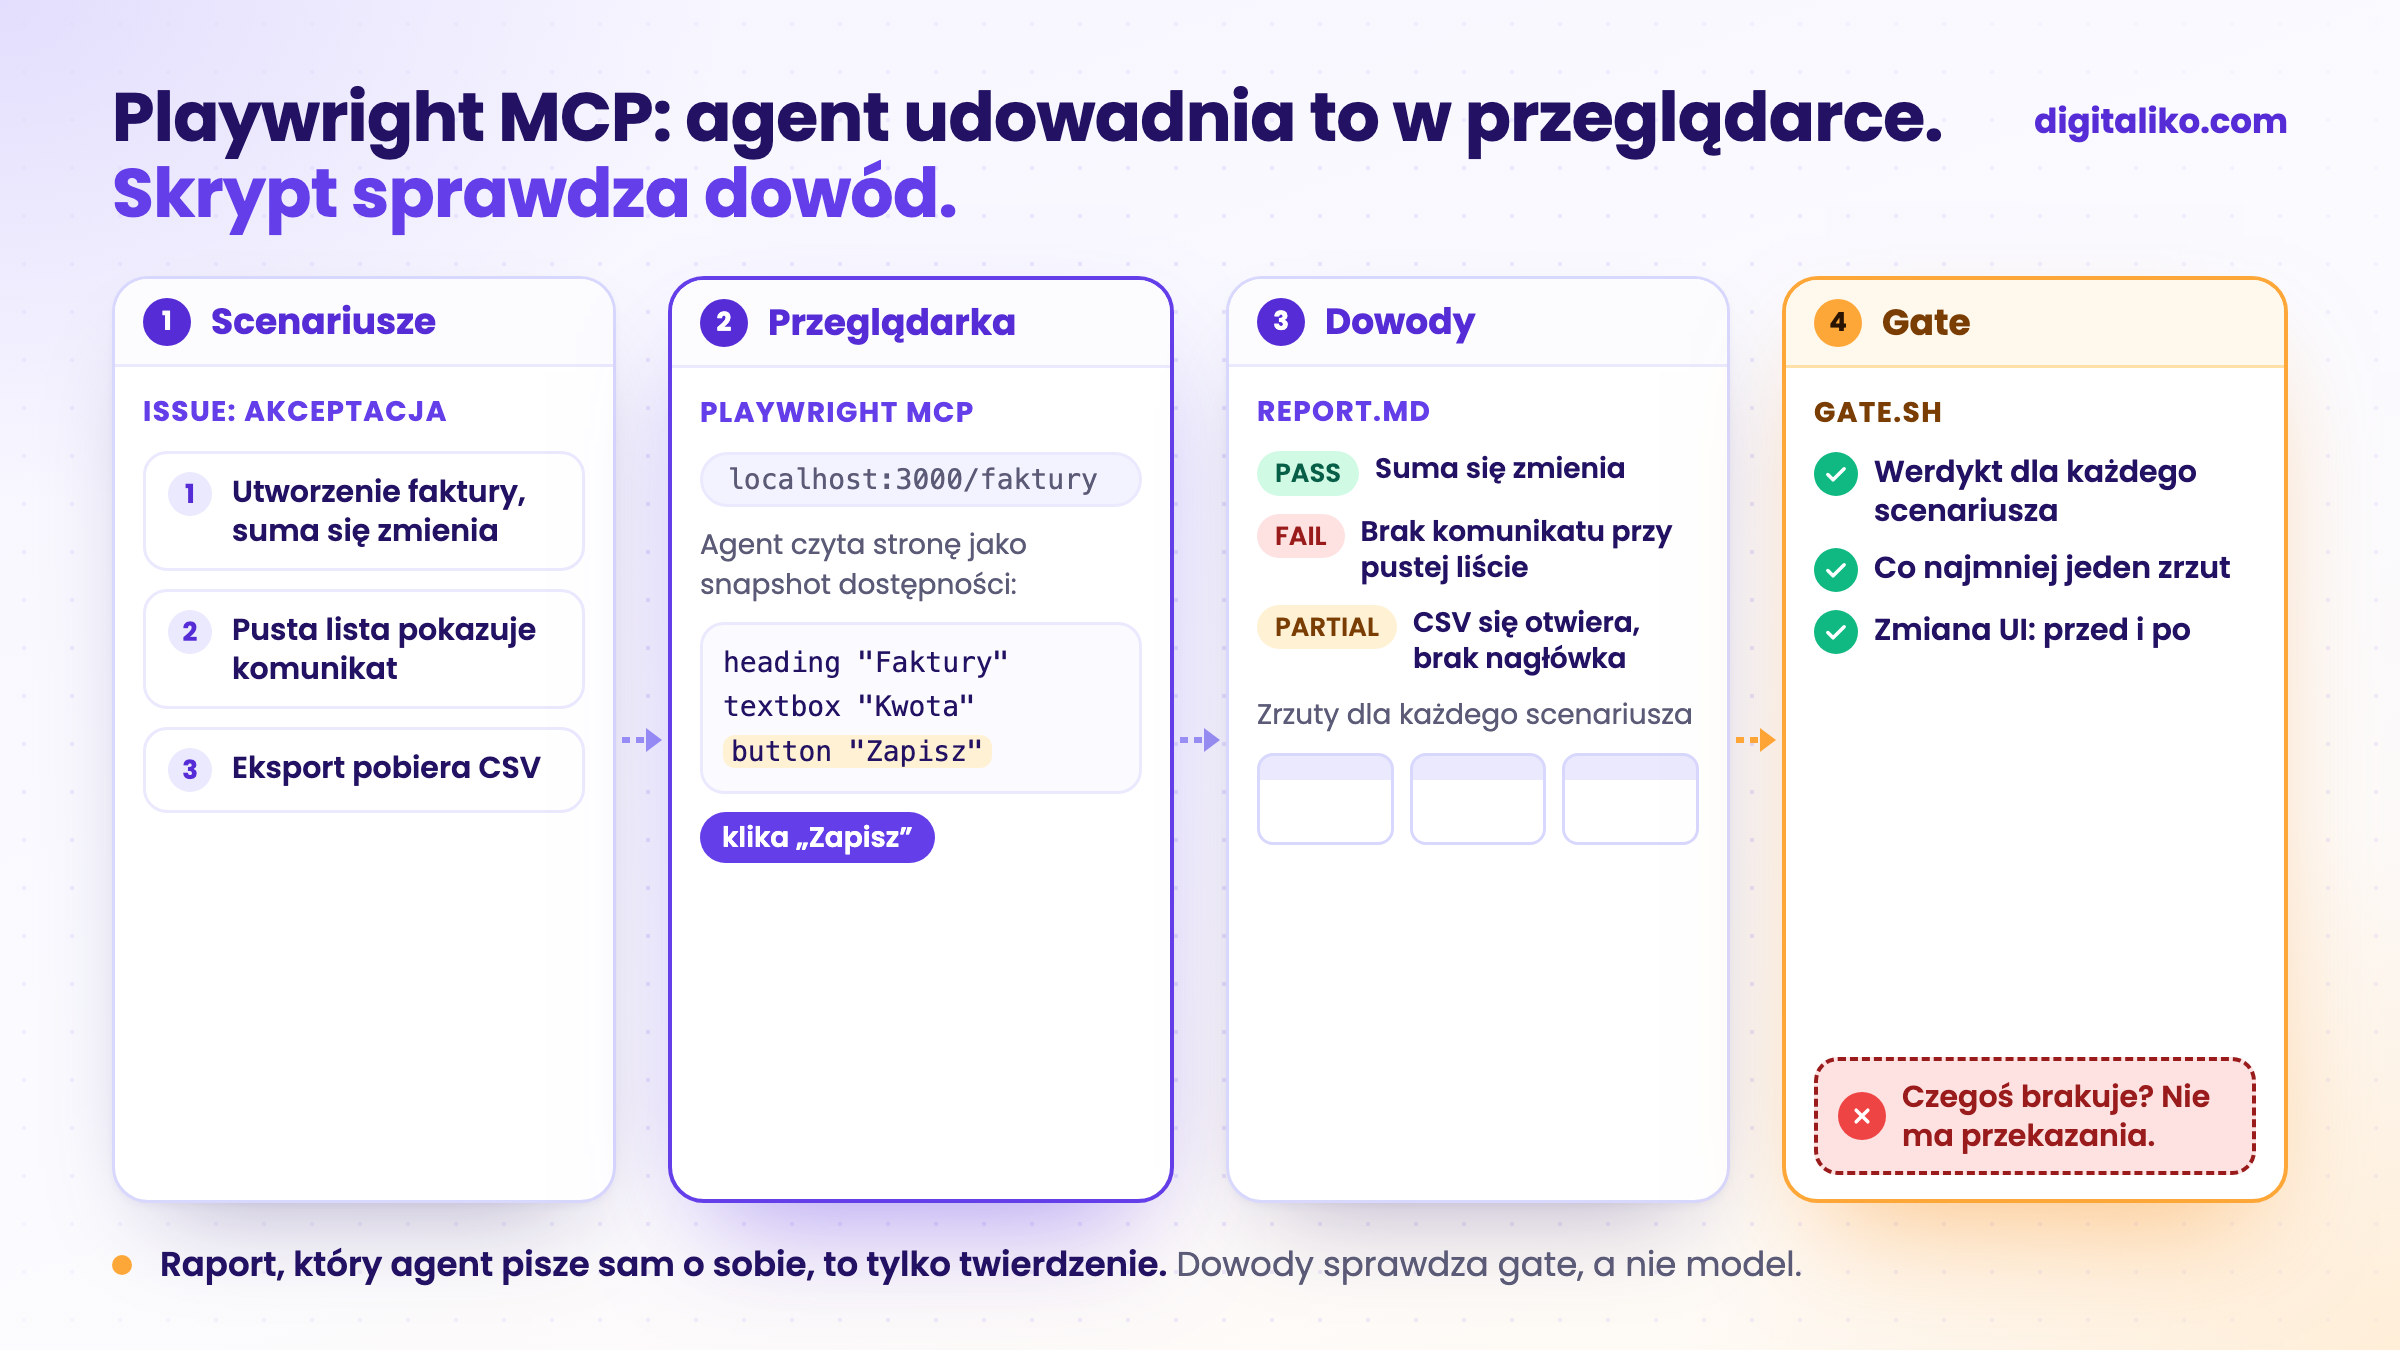
W naszej pętli agentów zadanie QA każe agentowi używać narzędzi przeglądarki Playwright i zapisać wszystko w evidence/<issue>/: zrzut ekranu dla każdego scenariusza, błędy konsoli i sieci oraz report.md. Resztę robi gate.sh, zwykły skrypt bash z kodami wyjścia:
n=$(grep -cE '\b(PASS|FAIL|PARTIAL)\b' "$tree/$rep"); shots=$(ls "$tree/$(dirname "$rep")"/*.png 2>/dev/null | wc -l | tr -d ' ')
[ "$n" -gt 0 ] && [ "$shots" -gt 0 ] || { echo "FAIL: report needs PASS/FAIL per scenario and screenshots" >> "$out"; exit 1; }
Brak raportu, brak linii z werdyktem albo brak zrzutu oznacza, że zadanie nie jest gotowe, cokolwiek mówi agent.
Zadania z kodem mają podobną zasadę. Gdy pull request zmienia pliki interfejsu, pętla wymaga before-*.png i after-*.png. Jeśli jest dobry powód, by ich nie było, PR musi to powiedzieć w linii zaczynającej się od No screenshots:. Recenzent widzi wtedy zmianę, zamiast ją sobie wyobrażać.
Ta zasada wzięła się z naszego własnego błędu. Przed poprawką każdy PNG liczył się jako dowód, więc wystarczył jeden zrzut czegokolwiek. Teraz muszą być dwa i muszą mieć nazwy mówiące, co pokazują.
Co wychwytuje kontrola w przeglądarce, a czego nie widzą testy jednostkowe?
Test jednostkowy zadaje wąskie pytanie w kontrolowanym pokoju. Przeglądarka pyta, czy ten pokój w ogóle istnieje.
| Pytanie | Test jednostkowy lub komponentu | Agent w prawdziwej przeglądarce |
|---|---|---|
| Czy funkcja zwraca właściwą wartość? | Tak, szybko i powtarzalnie | Tylko pośrednio |
| Czy trasa jest podłączona do komponentu? | Nie, test sam montuje komponent | Tak, otwiera prawdziwy URL |
| Czy działa z danymi podobnymi do produkcyjnych? | Tylko z fixture'em, który Państwo napisali | Tak, jeśli działa na prawdziwych danych |
| Czy przycisk ma nazwę, której użyje czytnik ekranu? | Tylko jeśli ktoś napisał taki test | Tak, snapshot to pokazuje |
| Czy są błędy konsoli lub sieci? | Rzadko sprawdzane | Tak, odczytywane są oba |
| Czy przepływ ma sens dla klienta? | Nie | Częściowo, przy przejściu jako persona |
Obie kolumny są ważne. Zasada red-green dla testów jednostkowych jest w artykule Red-green TDD z agentami AI. Kontrola w przeglądarce stoi na niej, a nie zamiast niej.
Uczciwie o granicach: nie liczyliśmy, ile błędów wychwytują kontrole w przeglądarce w porównaniu z testami. Wiemy, jakiego rodzaju są: to rzeczy, które istnieją dopiero wtedy, gdy wszystko jest połączone.
Playwright MCP, skrypty Playwright czy Chrome DevTools MCP?
Nawet zespół Playwright mówi, że MCP nie zawsze jest właściwym narzędziem. Ich README poleca agentom programistycznym Playwright CLI ze skillami, bo jest „more token-efficient”, czyli zużywa mniej tokenów. MCP, jak piszą, „remains relevant for specialized agentic loops”: ma sens w wyspecjalizowanych pętlach agentów, takich jak automatyzacja eksploracyjna czy długotrwałe autonomiczne przepływy.
To zgadza się z tym, co widzimy:
Playwright MCP
- Agent eksploruje i sam decyduje o następnym kliknięciu
- Dobry do jednorazowego sprawdzenia zmiany i przejść jako persona
- Kosztuje kontekst: schematy narzędzi i snapshoty stron
Do wszystkiego, co się powtarza
Skrypty i testy Playwright
- Ta sama kontrola przy każdym uruchomieniu, w CI
- Dokładne liczby: obliczone kolory, rozmiary, czasy
- Ktoś musi je najpierw napisać, często agent
Chrome DevTools MCP
- Narzędzia przeglądarki z dostępem do DevTools
- To, co nasz interaktywny skill QA próbuje teraz najpierw
- Ta sama metoda, inny sterownik
Gdy w tym tygodniu audytowaliśmy tę stronę, w ogóle nie użyliśmy MCP. Agent napisał zwykłe skrypty Playwright na lokalnym buildzie: kontrast tekstu mierzony z obliczonych kolorów, skan dostępności axe, każdą stronę wyrenderowaną w szerokości telefonu i wydajność przy spowolnionym CPU. To kontrole, które chcemy powtarzać po każdej zmianie. Skrypt robi to za każdym razem tak samo. Agent improwizujący kliknięcia nie.
A od tego tygodnia nasz interaktywny skill browser-qa najpierw próbuje Chrome DevTools MCP, jeśli sesja go ma. Metoda nie zmieniła się wcale. Sterownik przeglądarki to część wymienna.
Gdzie to się psuje?
Kilka pułapek, które znamy z naszych zasad albo z własnych błędów:
- Dane testowe. Zielone przejście po pustej bazie danych dowodzi układu i niczego więcej. Skill zabrania uznawać to za gotowe.
- Token sesji. Playwright MCP ma narzędzia, które czytają ciasteczka i local storage. Nasza zasada jest starsza niż jakiekolwiek narzędzie: agent nigdy nie wyciąga, nie loguje ani nie przekazuje tokena sesji.
- Ocena na oko. „Suma wygląda dobrze” na zrzucie to zgadywanie. Agent odczytuje wartość ze strony.
- Dwóch agentów, jeden profil. Z trwałego profilu może naraz korzystać tylko jedna przeglądarka. Uruchomienia równoległe potrzebują
--isolatedalbo własnego katalogu profilu.
Czym są agenci Playwright i czy ich używamy?
Agenci Playwright, oficjalnie Playwright Test Agents, to trzy definicje agentów dostarczane razem z Playwright. Według dokumentacji Playwright (stan na 24.10.2026): planner „explores the app and produces a Markdown test plan”, czyli eksploruje aplikację i pisze plan testów w Markdown; generator „transforms the Markdown plan into the Playwright Test files”, czyli zamienia plan w pliki Playwright Test; a healer „executes the test suite and automatically repairs failing tests”, czyli uruchamia testy i automatycznie naprawia te, które nie przechodzą. Do Claude Code dodaje się je jednym poleceniem:
npx playwright init-agents --loop=claudePlanner zaczyna od seed testu, tests/seed.spec.ts, który przygotowuje środowisko, i zapisuje plan w specs/. Generator zamienia plan w testy w tests/ i na żywo sprawdza selektory i asercje, przechodząc scenariusze.
Uczciwie: w naszych projektach nie używaliśmy jeszcze agentów Playwright. Nasi agenci piszą testy Playwright z kryteriów akceptacji issue we własnej pętli, a eksplorowaniem zajmuje się skill browser-qa. Planner i generator robią w dużej mierze to samo we własnym formacie Playwright, więc warto je wypróbować w zespole, który nie ma własnej pętli.
Na healera uważalibyśmy. Dokumentacja mówi, że jego wynikiem jest „a passing test, or a skipped test if the healer believes that functionality is broken”, czyli przechodzący test albo test pominięty, jeśli uzna, że funkcja jest zepsuta. W naszej pętli pominięty test niczego nie dowodzi, a test czerwony dlatego, że produkt się zepsuł, musi zostać czerwony. Jeśli wypróbują Państwo healera, proszę przeglądać każdy zmieniony przez niego lokator czy asercję jak każdy inny pull request.
Czy Państwa zespół jest gotowy, by agent sprawdzał w przeglądarce?
Proszę przejść przez to, co już Państwo mają:
Jeśli chcą Państwo gotowej bazy, nasz publiczny Claude Code production starter już uruchamia smoke test Playwright w CI i wysyła raport, gdy test nie przejdzie. Jak działa cała pętla wokół niego, opisuje artykuł Harness engineering w praktyce: od issue do PR.
Chcą Państwo agentów, którzy udowadniają swoją pracę w Państwa repozytorium?
Kontrole w przeglądarce, zasady dowodów i CI wokół nich ustawiamy bezpośrednio w repozytorium zespołu w ramach AI-native SDLC dla zespołów deweloperskich. Państwa zespołowi brakuje bardziej rąk niż procesu? Proszę zobaczyć seniora dla Państwa zespołu. Większość naszego kodu pisze AI. Senior sprawdza każdą zmianę i odpowiada za to, co trafia na produkcję. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Kto w Państwa zespole sprawdza dziś, że zmiana działa w przeglądarce, i jak to udowadnia?
W skrócie
- Playwright MCP daje agentowi prawdziwą przeglądarkę, którą czyta jako snapshot dostępności.
- Agent przechodzi scenariusze z issue na prawdziwych danych i oddaje PASS lub FAIL ze zrzutami ekranu.
- Skrypt, a nie model, blokuje przekazanie, gdy brakuje raportu lub zrzutów.
- Eksplorować z MCP. Powtarzane kontrole zamienić w testy Playwright w CI.
Najczęstsze pytania
Czym jest Playwright MCP?
Serwerem MCP od Microsoftu, który daje agentowi AI narzędzia przeglądarki oparte na Playwright: otworzyć stronę, kliknąć, wpisać tekst, wypełnić formularz, odczytać konsolę i żądania sieciowe, zrobić zrzut ekranu. Agent czyta stronę jako snapshot dostępności, a nie jako piksele.
Jak dodać Playwright MCP do Claude Code?
Proszę uruchomić claude mcp add playwright npx @playwright/mcp@latest. Inni klienci MCP używają tego samego serwera z poleceniem npx i argumentem @playwright/mcp@latest w konfiguracji.
Czy Playwright MCP zastępuje testy end-to-end?
Nie. MCP służy do eksplorowania i jednorazowego sprawdzenia jednej zmiany. Kontrola, której chcą Państwo przy każdym pull requeście, należy do testu lub skryptu Playwright uruchamianego w CI, bez proszenia o to agenta.
Jak agent testuje strony za logowaniem?
Najpierw człowiek loguje się w przeglądarce, której używa agent, a agent pracuje w tej sesji. Nasza zasada: agent nigdy nie czyta, nie loguje ani nie przekazuje tokena sesji. Przy odizolowanych uruchomieniach Playwright MCP może wczytać zapisany storage state.
Czy raport QA od agenta wystarczy, by uznać zmianę za gotową?
Tylko z dowodami: werdykt dla każdego scenariusza i zrzuty ekranu obok. W naszej pętli skrypt gate blokuje przekazanie, gdy brakuje raportu lub zrzutów, a pull request i tak przegląda człowiek.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

