Context engineering dla agentów kodujących: co trzymać w repo
Dla CTO i programistówHarness i kontrole

Filip PapranecZałożyciel Digitaliko
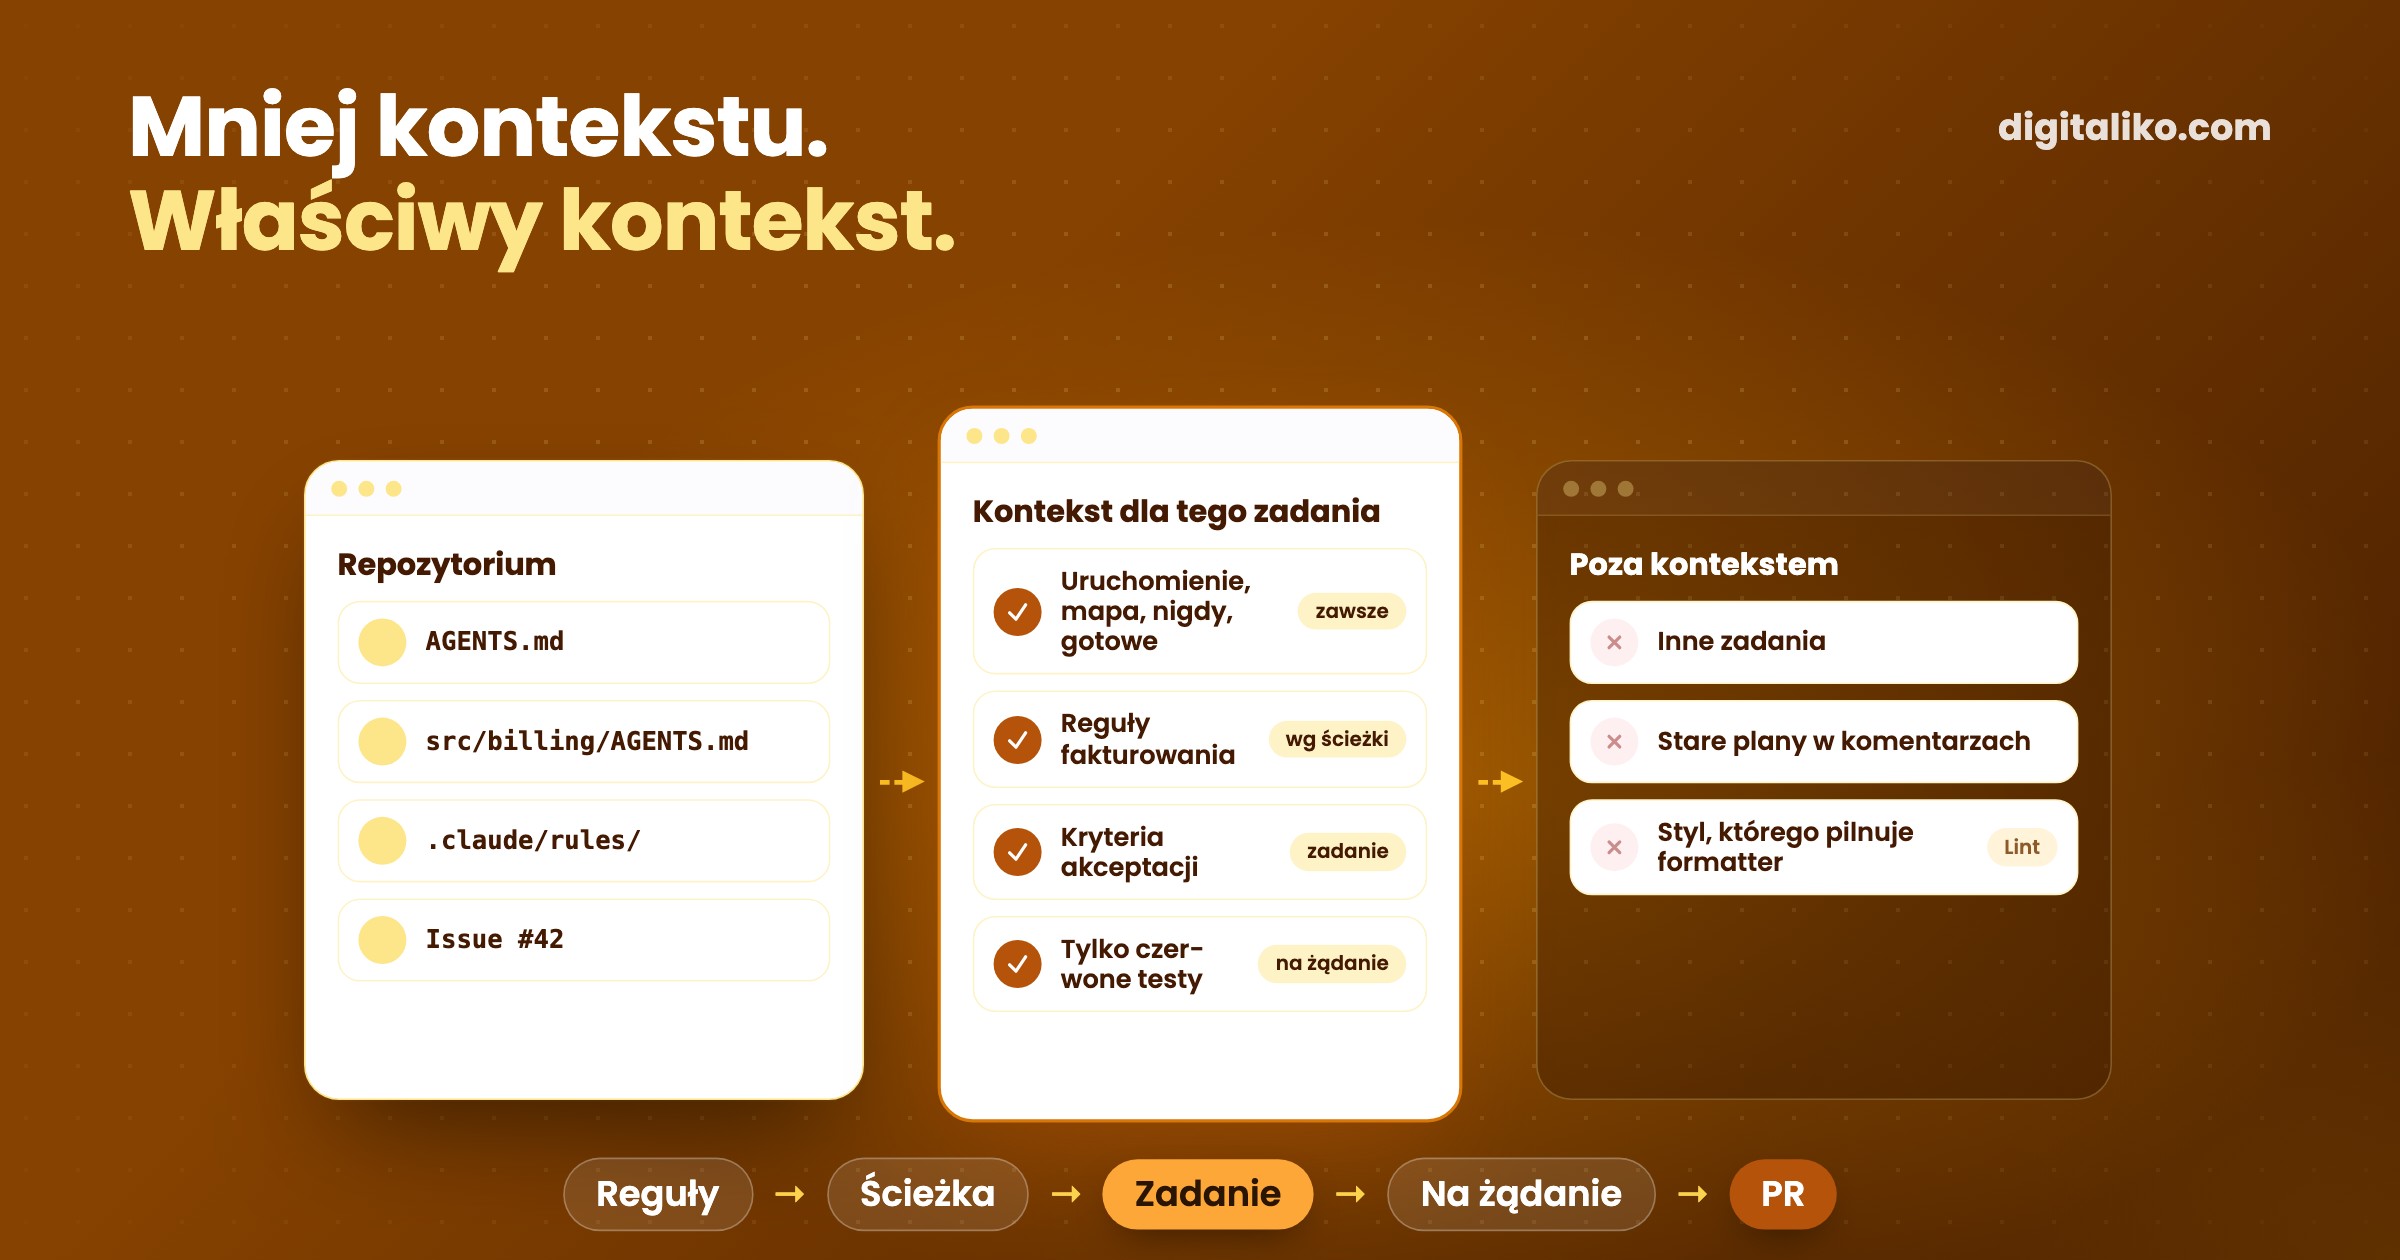
Context engineering to decyzja, co agent AI piszący kod widzi przed pracą i w jej trakcie: pliki reguł, zadanie, otwierany kod i wyniki jego narzędzi. W repozytorium sprowadza się to do trzech rzeczy. Krótkiego pliku, który ładuje się zawsze (AGENTS.md lub CLAUDE.md), reguł ładowanych tylko tam, gdzie obowiązują, i spisanego zadania z kryteriami akceptacji. Całą resztę agent powinien pobierać, gdy jej potrzebuje, a nie nosić ze sobą od początku.
Większość naszego kodu pisze AI. Każdą zmianę sprawdza senior i to on odpowiada za to, co trafia na produkcję. Poniżej opisujemy, co trafia do każdej warstwy, z ogólnymi przykładami do skopiowania, jak utrzymujemy mały kontekst i co usunęliśmy, bo pogarszało pracę agenta.
Good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.
Czym jest context engineering?
Model wie tylko to, co jest w jego oknie kontekstu przy danym wywołaniu. U agenta kodującego to okno szybko się zapełnia: prompt systemowy, pliki reguł, zadanie, każdy przeczytany plik, każde uruchomione polecenie i wynik, który wraca.
Okno to budżet, nie kosz. Anthropic opisuje context rot: gdy kontekst rośnie, spada zdolność modelu do przypomnienia sobie, co w nim jest. Reguła w linii 400 długiego pliku technicznie tam jest, a praktycznie znika.
Context engineering to więc głównie dwie decyzje. Co trafia do kontekstu domyślnie. I co zostaje poza nim, dopóki agent o to nie poprosi.
Kontekst, prompt czy specyfikacja: czym się różnią?
Te trzy pojęcia często się mylą. Opisują różne warstwy tego samego.
| Prompt | Kontekst | Specyfikacja | |
|---|---|---|---|
| Co to jest | Jedna wiadomość do modelu | Wszystko, co model widzi przy zadaniu | Część kontekstu, która mówi, co oznacza „gotowe” |
| Kto to pisze | Osoba, która pyta | Zespół, harness i narzędzia | Właściciel zadania |
| Gdzie żyje | Czat | Pliki repozytorium, wyniki narzędzi, historia | Issue lub podlinkowany dokument |
| Jak długo żyje | Jedną turę | Jedną sesję | Do zmergowania zadania |
| Co się psuje | Niejasne sformułowania | Za dużo, nieaktualne lub sprzeczne | Brak kryteriów akceptacji |
Specyfikacja zasługuje na osobny artykuł i go ma: spec-driven development z agentami AI. Tutaj zostajemy przy repozytorium: co musi w nim być, żeby każda sesja agenta zaczynała się od właściwego kontekstu.
Co trafia do pliku, który ładuje się zawsze?
AGENTS.md (lub CLAUDE.md w Claude Code) ładuje się przy każdym zadaniu. To czyni go najdroższym tekstem w repozytorium. Należy tam tylko to, czego agent nie wywnioskuje z kodu.
Ogólny przykład, który pasuje do większości repozytoriów:
# AGENTS.md

## Run
- Install: `pnpm install`
- Check everything: `pnpm check` (typecheck, lint, tests)
- One test file: `pnpm test path/to/file.test.ts`

## Map
- `src/billing/` holds the invoice rules. It has its own AGENTS.md.
- `src/generated/` is generated. Never edit it by hand.
- Tests sit next to the code as `*.test.ts`.

## Never
- Touch the production database or `.env*` files.
- Change a migration that is already merged. Add a new one.
- Push to `main`. Open a pull request.

## Done means
- `pnpm check` is green.
- New behaviour has a test that failed before the change.
- The PR says what changed and how it was checked.
Cztery nagłówki: jak to uruchomić, gdzie co leży, co jest zabronione i co oznacza „gotowe”. Jeśli Państwa zespół używa Claude Code obok innych narzędzi, proszę trzymać jeden plik. Obecny Claude Code czyta AGENTS.md bezpośrednio, a tam, gdzie nie, CLAUDE.md z jedną linią @AGENTS.md go importuje.
Co tam nie pasuje: styl, którego pilnuje już formatter, eseje o architekturze, historia decyzji i reguły obowiązujące tylko w jednym folderze. Jak zdecydować, gdzie ma żyć każda reguła i które powinny być lintem zamiast tekstu, opisujemy w CLAUDE.md i AGENTS.md: reguły dla kodu AI w zespole.
Jak sprawić, żeby reguły ładowały się tylko tam, gdzie obowiązują?
Przez strukturę folderów. Reguła ważna tylko dla fakturowania nie powinna nic kosztować, gdy agent edytuje stronę logowania.
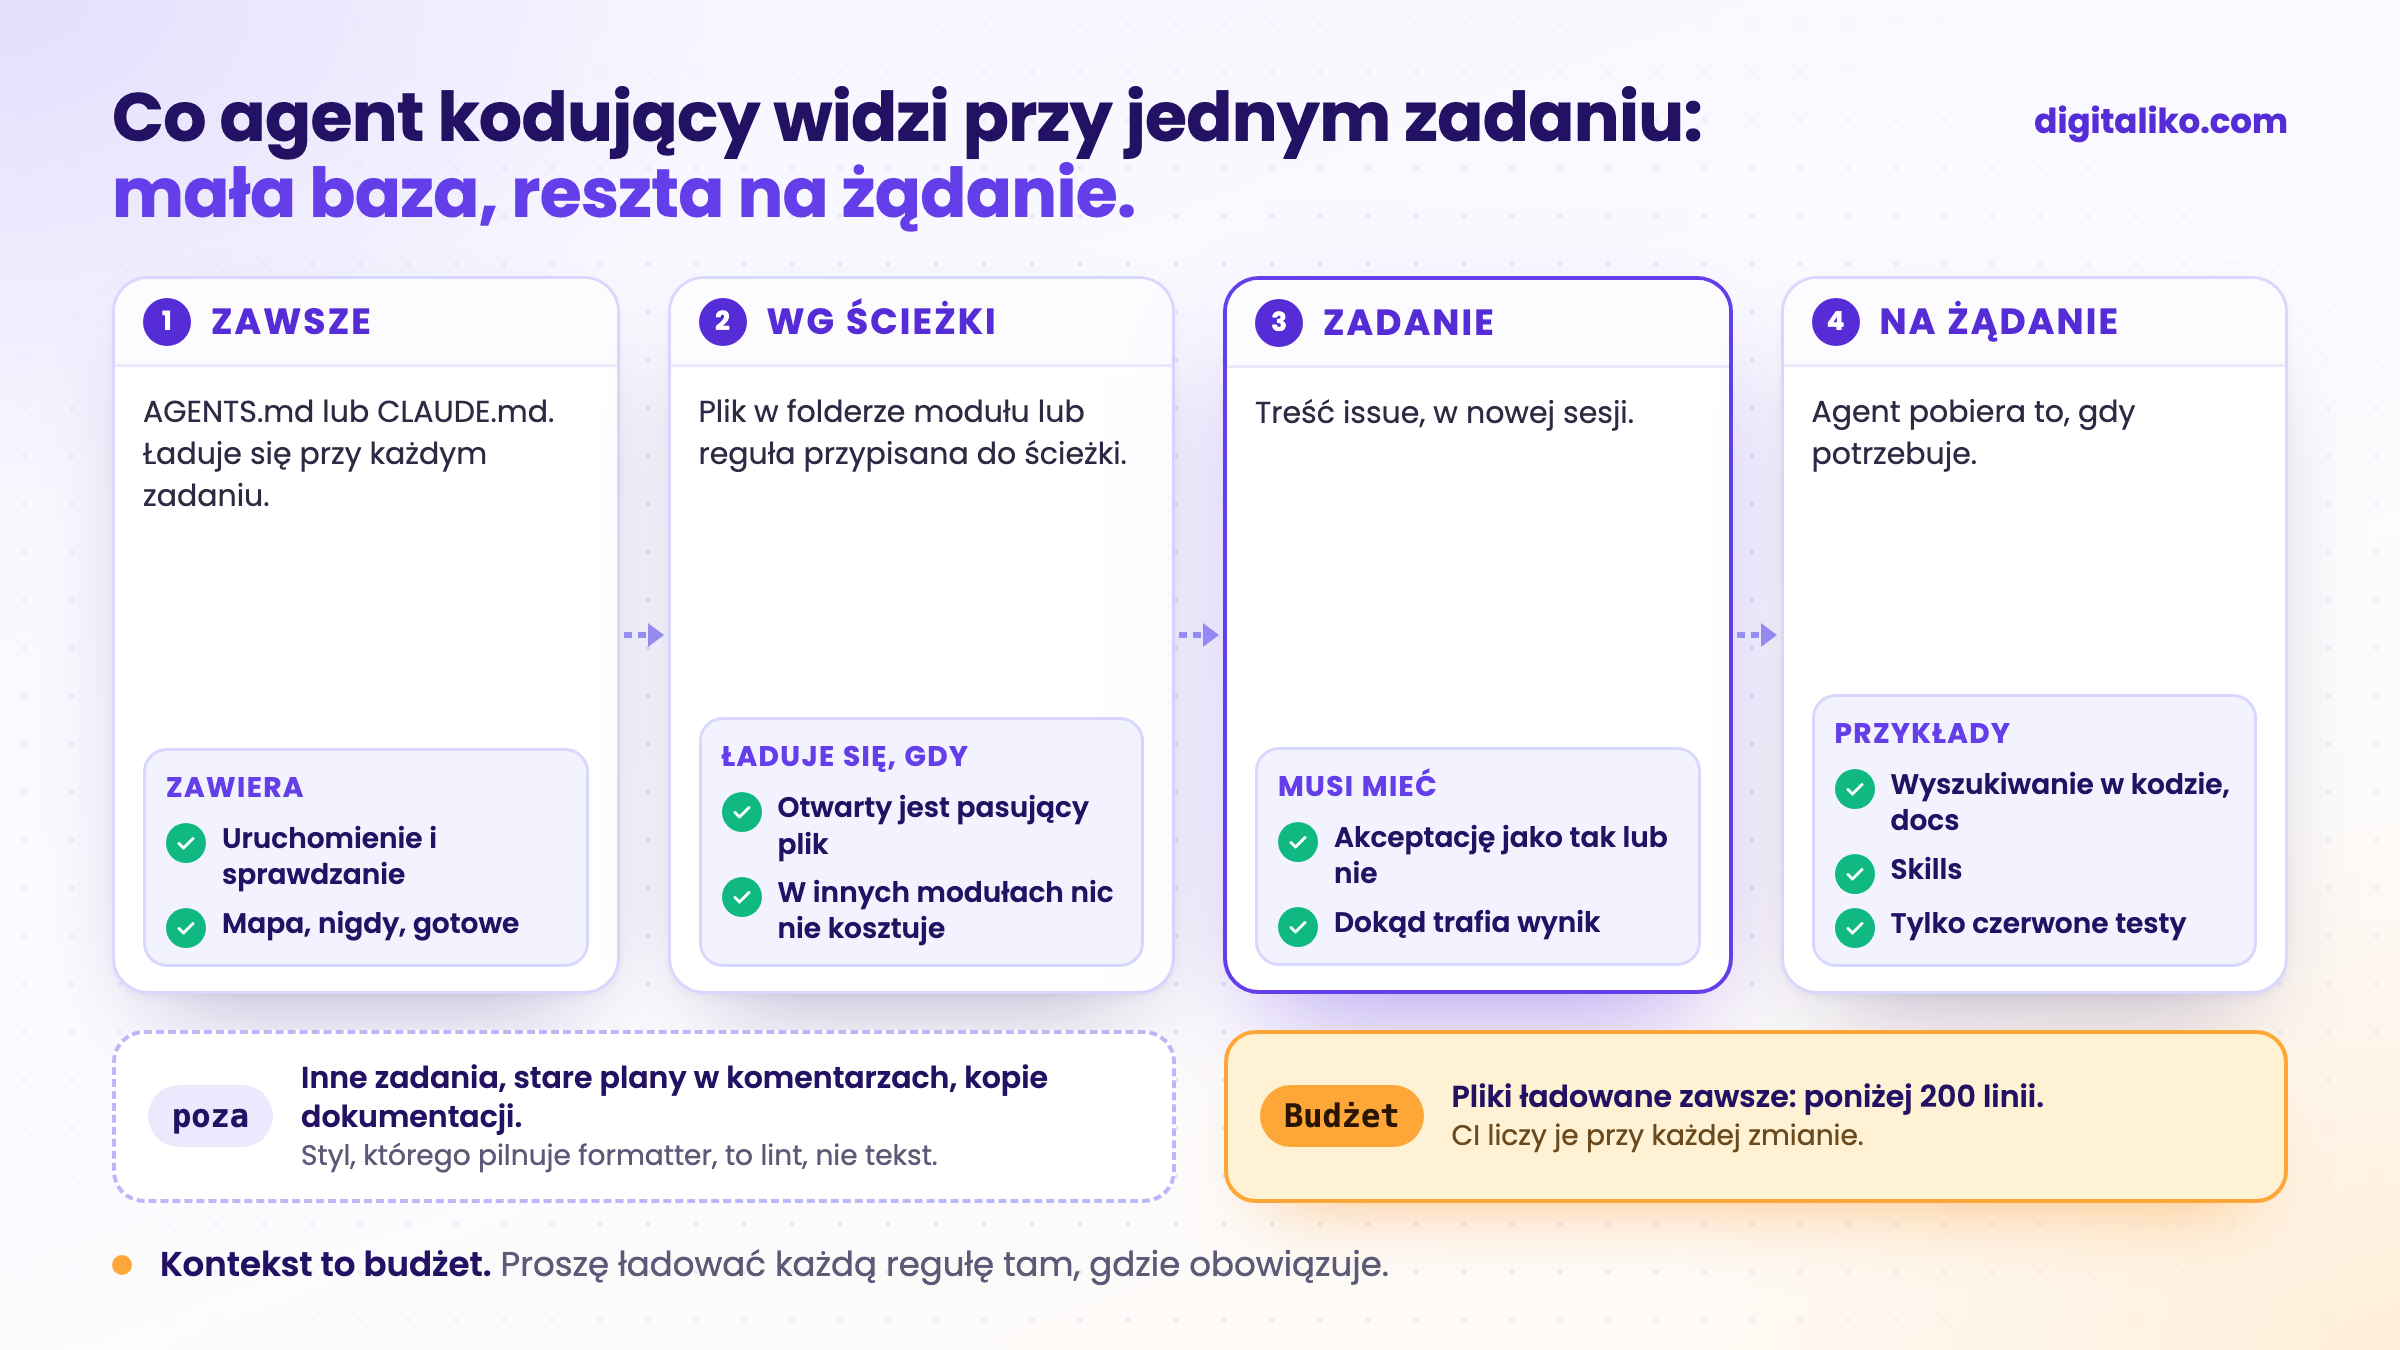
Są trzy mechanizmy i działają w tej kolejności:
- Plik w folderze modułu.
src/billing/AGENTS.mdlubsrc/billing/CLAUDE.md. Claude Code ładuje go na żądanie, gdy tylko agent przeczyta lub zmieni plik w tym folderze. - Reguły przypisane do ścieżek. Plik reguł w
.claude/rules/z polempathswe frontmatterze ładuje się tylko wtedy, gdy agent dotknie pasującego pliku:
---
paths:
  - "src/billing/**/*.ts"
---

# Billing rules
- Money is integer cents. Never floats.
- Every price change writes an audit row.
- Skille i podlinkowane dokumenty. Proces w stylu „jak piszemy migrację” mieszka w skillu lub dokumencie. Agent widzi jednolinijkowy opis i ładuje treść dopiero wtedy, gdy zadanie jej wymaga.
Jedna pułapka: import @path nie oszczędza kontekstu. Importowany plik ładuje się razem z plikiem, który go importuje. Importy porządkują długi plik. Nie skracają go.
Co agent widzi przy jednym zadaniu?
U nas jedno zadanie to jedno issue na GitHubie, jedna nowa sesja i jeden pull request. Tak składa się kontekst tej sesji.
01
Nowa sesja
Bez historii innych zadań. Każde issue zaczyna od zera we własnym worktree.
02
Plik, który ładuje się zawsze
Uruchomienie, mapa, nigdy, gotowe. Na tyle krótki, że da się go przeczytać w minutę.
03
Zadanie
Treść issue: co zmienić, kryteria akceptacji, dokąd trafia wynik.
04
Reguły według ścieżki
Reguły modułu ładują się tylko wtedy, gdy agent otworzy pliki w tym module.
05
Pobierane na żądanie
Wyszukiwanie w kodzie, dokumentacja, skille i wyniki testów, gdy agent ich potrzebuje.
Zadanie to część, którą zespoły nie doceniają. Minimalne issue, które agent jest w stanie dokończyć:
## What
Add CSV export to the invoice list.

## Acceptance
- An empty list exports the header row only.
- Totals in the file match the invoice detail.

## Output
One PR with a test that fails on main and passes on the branch.
W każdej pętli warto mieć jeszcze dwie reguły. Tekst z zewnątrz, np. komentarze w issue i wklejone e-maile, trafia do modelu oznaczony jako dane, nie instrukcje. A reviewer dostaje własny, nowy kontekst z narzędziami tylko do odczytu. Widzi zadanie, diff i testy, a nie tok rozumowania agenta, który pisał kod. O to właśnie chodzi: ocenia wynik, nie opowieść. Więcej w harness engineering w praktyce.
Jak utrzymać mały kontekst?
Większość kontekstu nie jest dodawana celowo. Narasta sama. Te nawyki trzymają ją w ryzach:
- Wskaźniki, nie kopie. „Reguły API są w
docs/api.md” kosztuje jedną linię. Wklejenie dokumentu kosztuje sto i z czasem się dezaktualizuje. - Budżet, który sprawdza build. „Niech będzie krótko” wytrzymuje około dwóch tygodni. Licznik linii w CI wytrzymuje.
- Jedno zadanie na sesję. Długa sesja wciąga każde wcześniejsze zadanie do następnego. Nowa sesja jest tańsza niż podsumowanie.
- Wyszukiwanie w subagencie. Proszę pozwolić pomocniczemu agentowi przeczytać dwadzieścia plików i zwrócić dziesięć linii. Główna sesja dostaje odpowiedź, nie samo wyszukiwanie.
- Krótki wynik narzędzi. Test runner, który wypisuje tylko błędy, daje agentowi to, czego potrzebuje. Dwa tysiące linii zaliczonych testów dają mu szum.
Kontrola budżetu to kilka linii. Anthropic zaleca poniżej 200 linii na CLAUDE.md:
# fail CI when the always-loaded agent files grow past the budget
total=$(cat AGENTS.md CLAUDE.md 2>/dev/null | wc -l)
[ "$total" -le 200 ] || { echo "Agent context: $total lines (max 200)"; exit 1; }Nasza kontrola liczy razem plik główny i każdą regułę ładowaną bezwarunkowo, więc jej limit to 300 linii, nie 200. Działa w CI naszych repozytoriów. Jak to wpasować w konfigurację zespołu, opisujemy w dobrych praktykach Claude Code dla zespołu.
Co usunęliśmy z kontekstu?
Więcej, niż dodaliśmy. Najbardziej pomogły zmiany polegające na usuwaniu:
- Stare plany w komentarzach issue. Nasza kontrola gotowości czytała cały wątek issue. Nieaktualny plan w komentarzu sprawiał, że odrzucała issue, które były w porządku. Teraz za zadanie uznajemy tylko treść issue. Nieaktualny kontekst jest gorszy niż żaden.
- Kopie reguł. Reguły skopiowane do kilku repozytoriów rozjechały się w ciągu kilku tygodni. Teraz jedno wersjonowane źródło ładuje się wszędzie.
- Procesy w pliku głównym. Długie instrukcje przenieśliśmy do skilli, które ładują się tylko przy użyciu. W pliku głównym został tylko tekst, który dotyczy każdego zadania.
- Najważniejsze reguły w formie tekstu. Te ważne stały się lintem, testami i hookami. Nie muszą już być w kontekście, bo same zatrzymują złą zmianę.
Tekst agent może zinterpretować po swojemu. Test już nie.

Ten ostatni punkt to granica context engineeringu. Kontekst sprawia, że właściwa ścieżka jest prawdopodobna. Testy sprawiają, że zła ścieżka jest niemożliwa. Potrzebne jest jedno i drugie.
Czy kontekst Państwa repozytorium jest w dobrej formie?
Chcą Państwo mieć to skonfigurowane w swoim repozytorium?
Pliki reguł, reguły przypisane do ścieżek, format issue i testy konfigurujemy bezpośrednio w repozytorium zespołu w ramach AI-native SDLC dla zespołów deweloperskich. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych. Senior dołącza do Państwa repozytorium i pull requestów od pierwszego dnia.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, czym zajmiemy się najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Co Państwa agent czyta dziś jako pierwsze i kiedy ktoś ostatnio usunął stamtąd choć jedną linię?
W skrócie
- Context engineering decyduje, co widzi agent kodujący: pliki reguł, zadanie, otwierane pliki i wyniki narzędzi.
- Zawsze ładowany AGENTS.md lub CLAUDE.md zawiera cztery rzeczy: uruchomienie, mapę, czego nigdy nie robić i co oznacza „gotowe”. Poniżej 200 linii.
- Reguły modułu ładują się tylko tam, gdzie obowiązują: plik w folderze lub reguła przypisana do ścieżki.
- Jedno zadanie na nową sesję, ze spisanym zadaniem i kryteriami akceptacji.
- Więcej kontekstu to nie lepiej. Proszę usuwać nieaktualny tekst, a najważniejsze reguły zamienić w testy.
Najczęstsze pytania
Czym jest context engineering?
To decyzja, co model AI widzi przed pracą i w jej trakcie: instrukcje, pliki reguł, zadanie, otwierane pliki, wyniki narzędzi i historię. U agenta kodującego większość tego kontekstu mieszka w repozytorium, więc context engineering to w dużej mierze praca w repozytorium.
Czym różni się context engineering od prompt engineeringu?
Prompt engineering dopracowuje jedną wiadomość. Context engineering zarządza wszystkim innym, co model widzi w trakcie całego zadania: które reguły się ładują, które pliki czyta, co zwraca narzędzie i co zostaje odrzucone. Dobry prompt nie naprawi agenta, który nigdy nie widzi Państwa konwencji.
Co powinno trafić do AGENTS.md lub CLAUDE.md?
To, czego agent nie wywnioskuje z kodu: jak uruchomić i sprawdzić projekt, gdzie co leży, czego nie wolno mu robić nigdy i co oznacza „gotowe”. Plik powinien być krótki, bo ładuje się przy każdym zadaniu. Reguły jednego modułu trafiają do tego modułu, nie do pliku głównego.
Czy więcej kontekstu jest lepsze dla agenta kodującego?
Nie. Każda linia konkuruje o uwagę modelu, a jego zdolność przypominania sobie treści spada, gdy kontekst rośnie. Proszę dać agentowi małą, trafną bazę i pozwolić mu pobrać resztę, gdy jej potrzebuje.
Jak context engineering ma się do specyfikacji?
Specyfikacja to ta część kontekstu, która mówi, co oznacza „gotowe”. U nas jest nią issue: co zmienić, kryteria akceptacji i dokąd trafia wynik. Bez niej więcej kontekstu daje tylko pewniejszy siebie błędny wynik.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

