LLM as a judge: AI recenzent, který se snaží práci vyvrátit
Pro CTO a vývojářeHarness a kontroly · Aktualizováno

Filip Papraneczakladatel Digitaliko
LLM as a judge znamená, že jazykový model hodnotí práci podle sepsaných kritérií, místo člověka nebo přesného testu. Funguje, když má soudce kritéria napsaná, vidí důkazy, odpovídá v pevném formátu a nemůže přebít kontroly, které zvládne stroj.
Máme ho na každém pull requestu, který otevře náš AI agent. Neptáme se ho, jestli je práce dobrá. Má ji zkusit vyvrátit. Takhle je postavený a tohle jsou pravidla, která přibyla pokaždé, když se spletl.
Co je LLM as a judge?
Pojem pochází z hodnocení chatovacích modelů. Místo toho, abyste platili lidi za porovnávání odpovědí, necháte to na silném modelu. Studie, která to pojmenovala, Zheng a kol., změřila, jak dobře to funguje:
Our results reveal that strong LLM judges like GPT-4 can match both controlled and crowdsourced human preferences well, achieving over 80% agreement, the same level of agreement between humans.
Tentýž abstrakt pojmenovává i limity: „position, verbosity, and self-enhancement biases, as well as limited reasoning ability“. Soudce upřednostní odpověď, kterou viděl první, tu delší a tu, která zní jako on sám. Tyhle tři si zapamatujte. Každé pravidlo níže bojuje proti jednomu z nich.
Dnes se ta myšlenka používá daleko za chatovými benchmarky: na hodnocení odpovědí z vyhledávání, běhů agentů i na code review. Ten náš dělá to poslední.
Kdy LLM soudce nepoužít?
Když správnou odpověď dá levnější kontrola. Soudce je pomalý, spotřebuje tokeny a může se mýlit. Kód, který ověří fakt, nic z toho nedělá.
| Co chcete vědět | Správná kontrola | Soudce? |
|---|---|---|
| Procházejí testy, sedí typy? | Spustit je | Ne |
| Spadl nový test před opravou? | Spustit ho na původním kódu | Ne |
| Fungují odkazy, je citát opravdu na zdrojové stránce? | Skript | Ne |
| Zařadí klasifikátor do správné kategorie? | Příklady označené lidmi, vyhodnocené kódem | Ne |
| Dělá změna to, co chtělo issue? | Přečíst issue, diff a důkazy | Ano |
| Zkouší test chování, nebo jen čte zdrojový kód jako text? | Přečíst test | Ano |
Řádek s klasifikátorem je skutečný. Pro klienta s online marketplace jsme ladili LLM, které třídí inzeráty do kategorií. Neptali jsme se jiného modelu, jestli kategorie vypadají dobře. Skutečné inzeráty jsme označili ručně a shody spočítal kód. Když existuje správná odpověď, soudce přidá jen šum.
Jak náš LLM soudce kontroluje pull request?
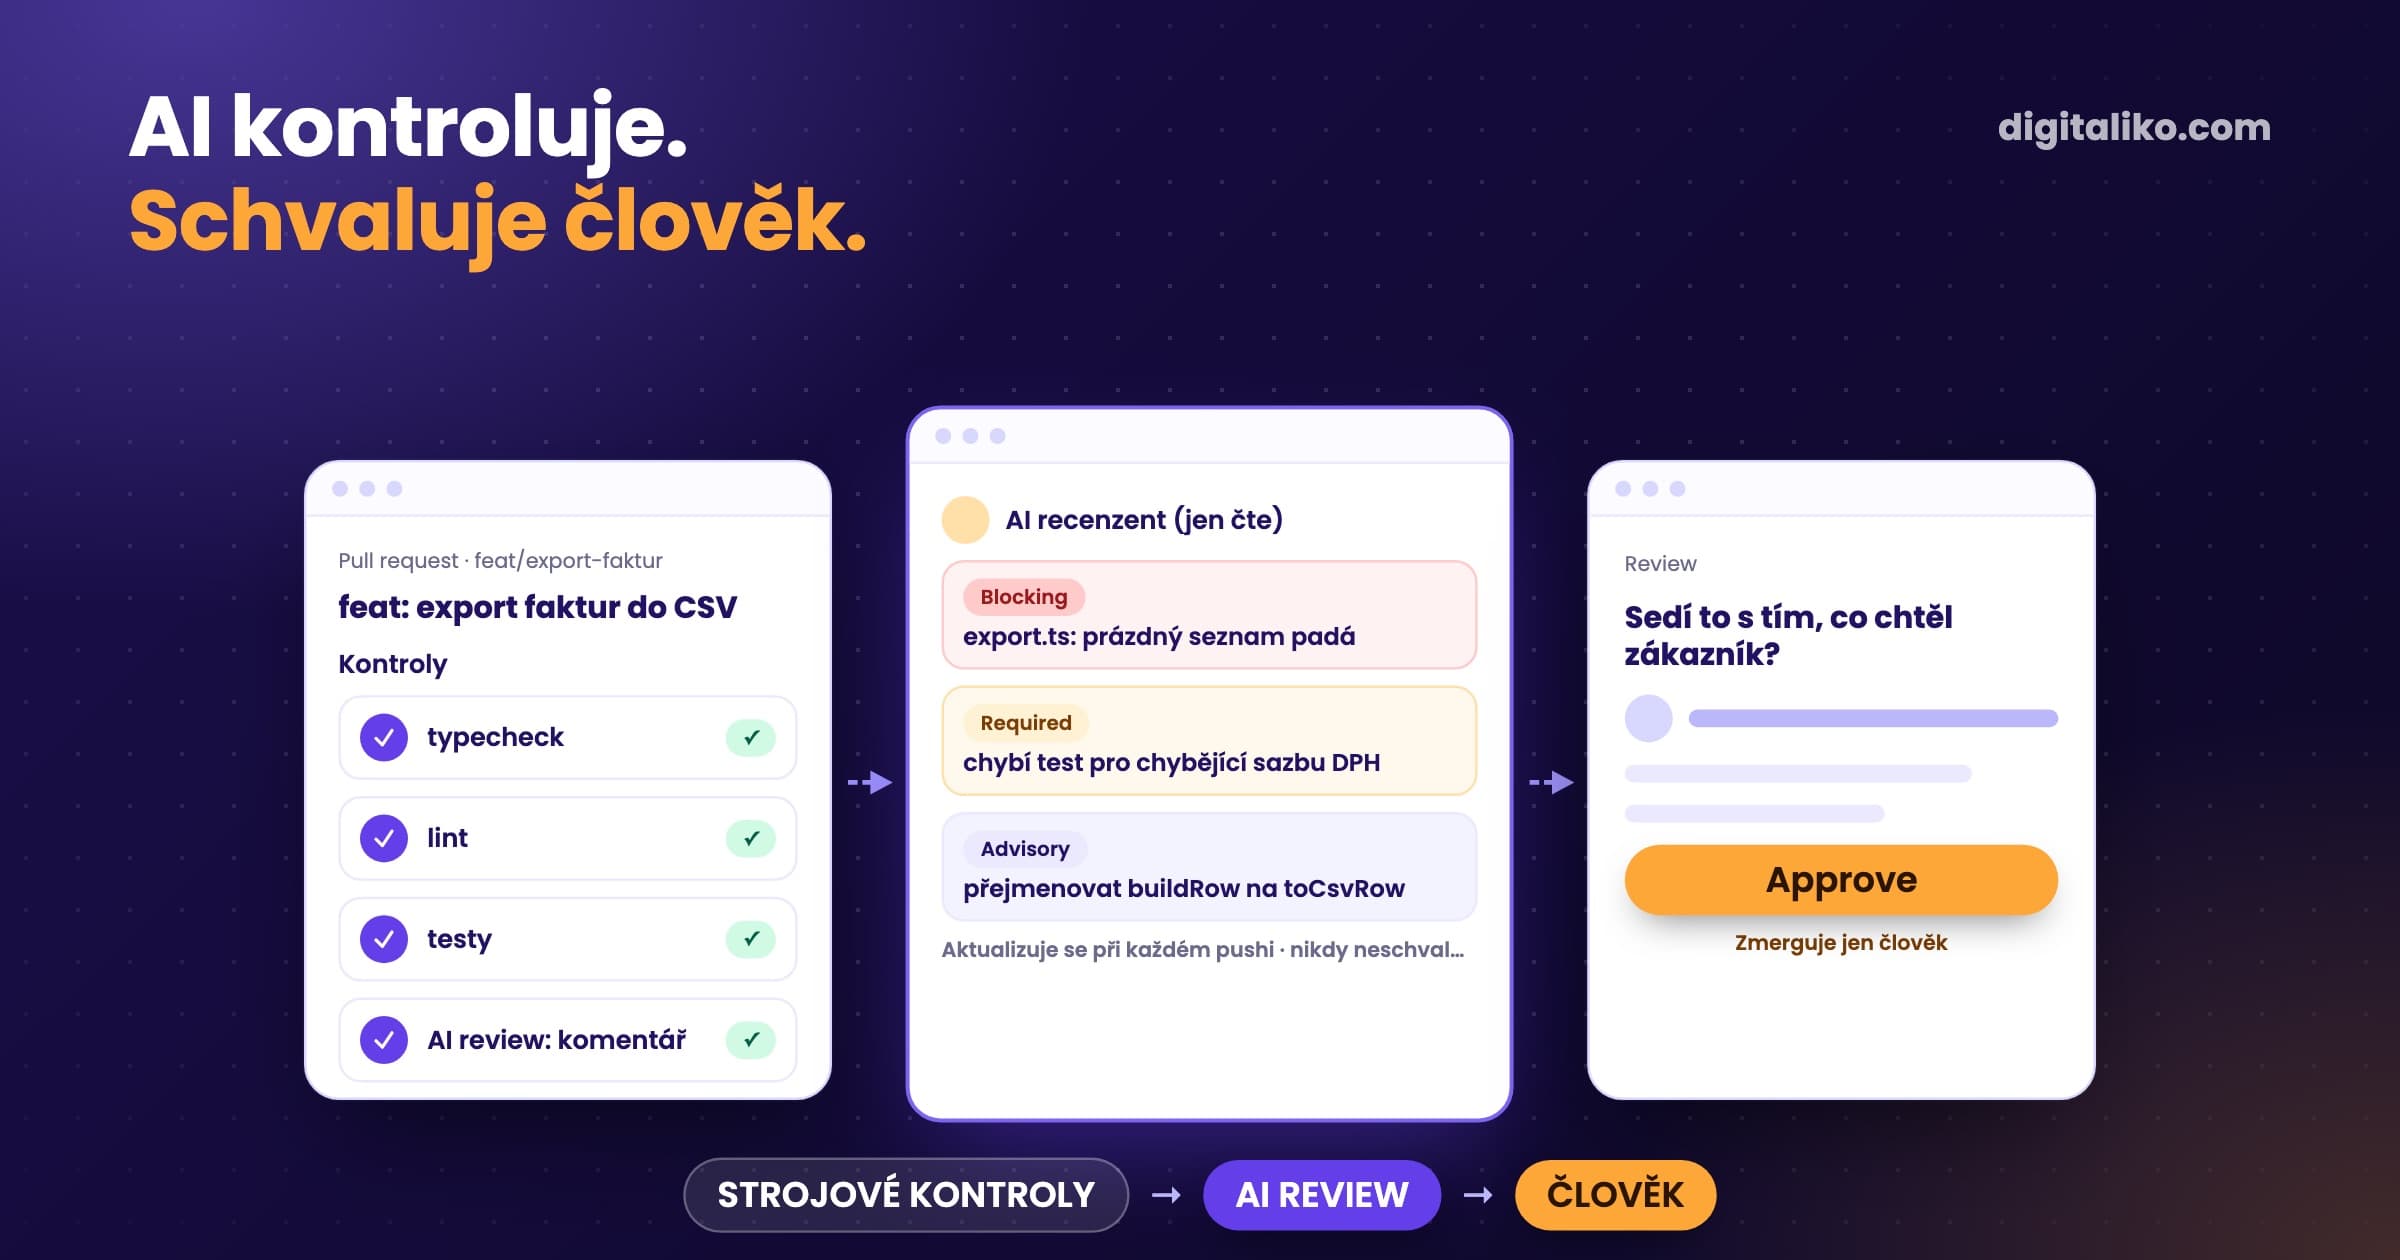
Soudce je krok VERIFY v naší smyčce pro agenta a poradní kontrola na pull requestech, které otevřou lidé. V obou případech má stejné části:
01
Nejdřív strojové kontroly
Obyčejný bash gate spustí testy, typové kontroly a lint repozitáře a ověří, že nové testy byly na původním kódu červené. Tyto věci model nikdy nehodnotí.
02
Co se chtělo
Soudce dostane issue, jeho kritéria hotovo, když a přehled diffu. U pull requestu bez issue to, co pull request tvrdí, že dělá.
03
Čerstvá session jen pro čtení
Nová session, která práci nedělala, s nástroji jen pro čtení, jako Read, Grep a Glob. Kód, který posuzuje, změnit nemůže.
04
Má práci vyvrátit
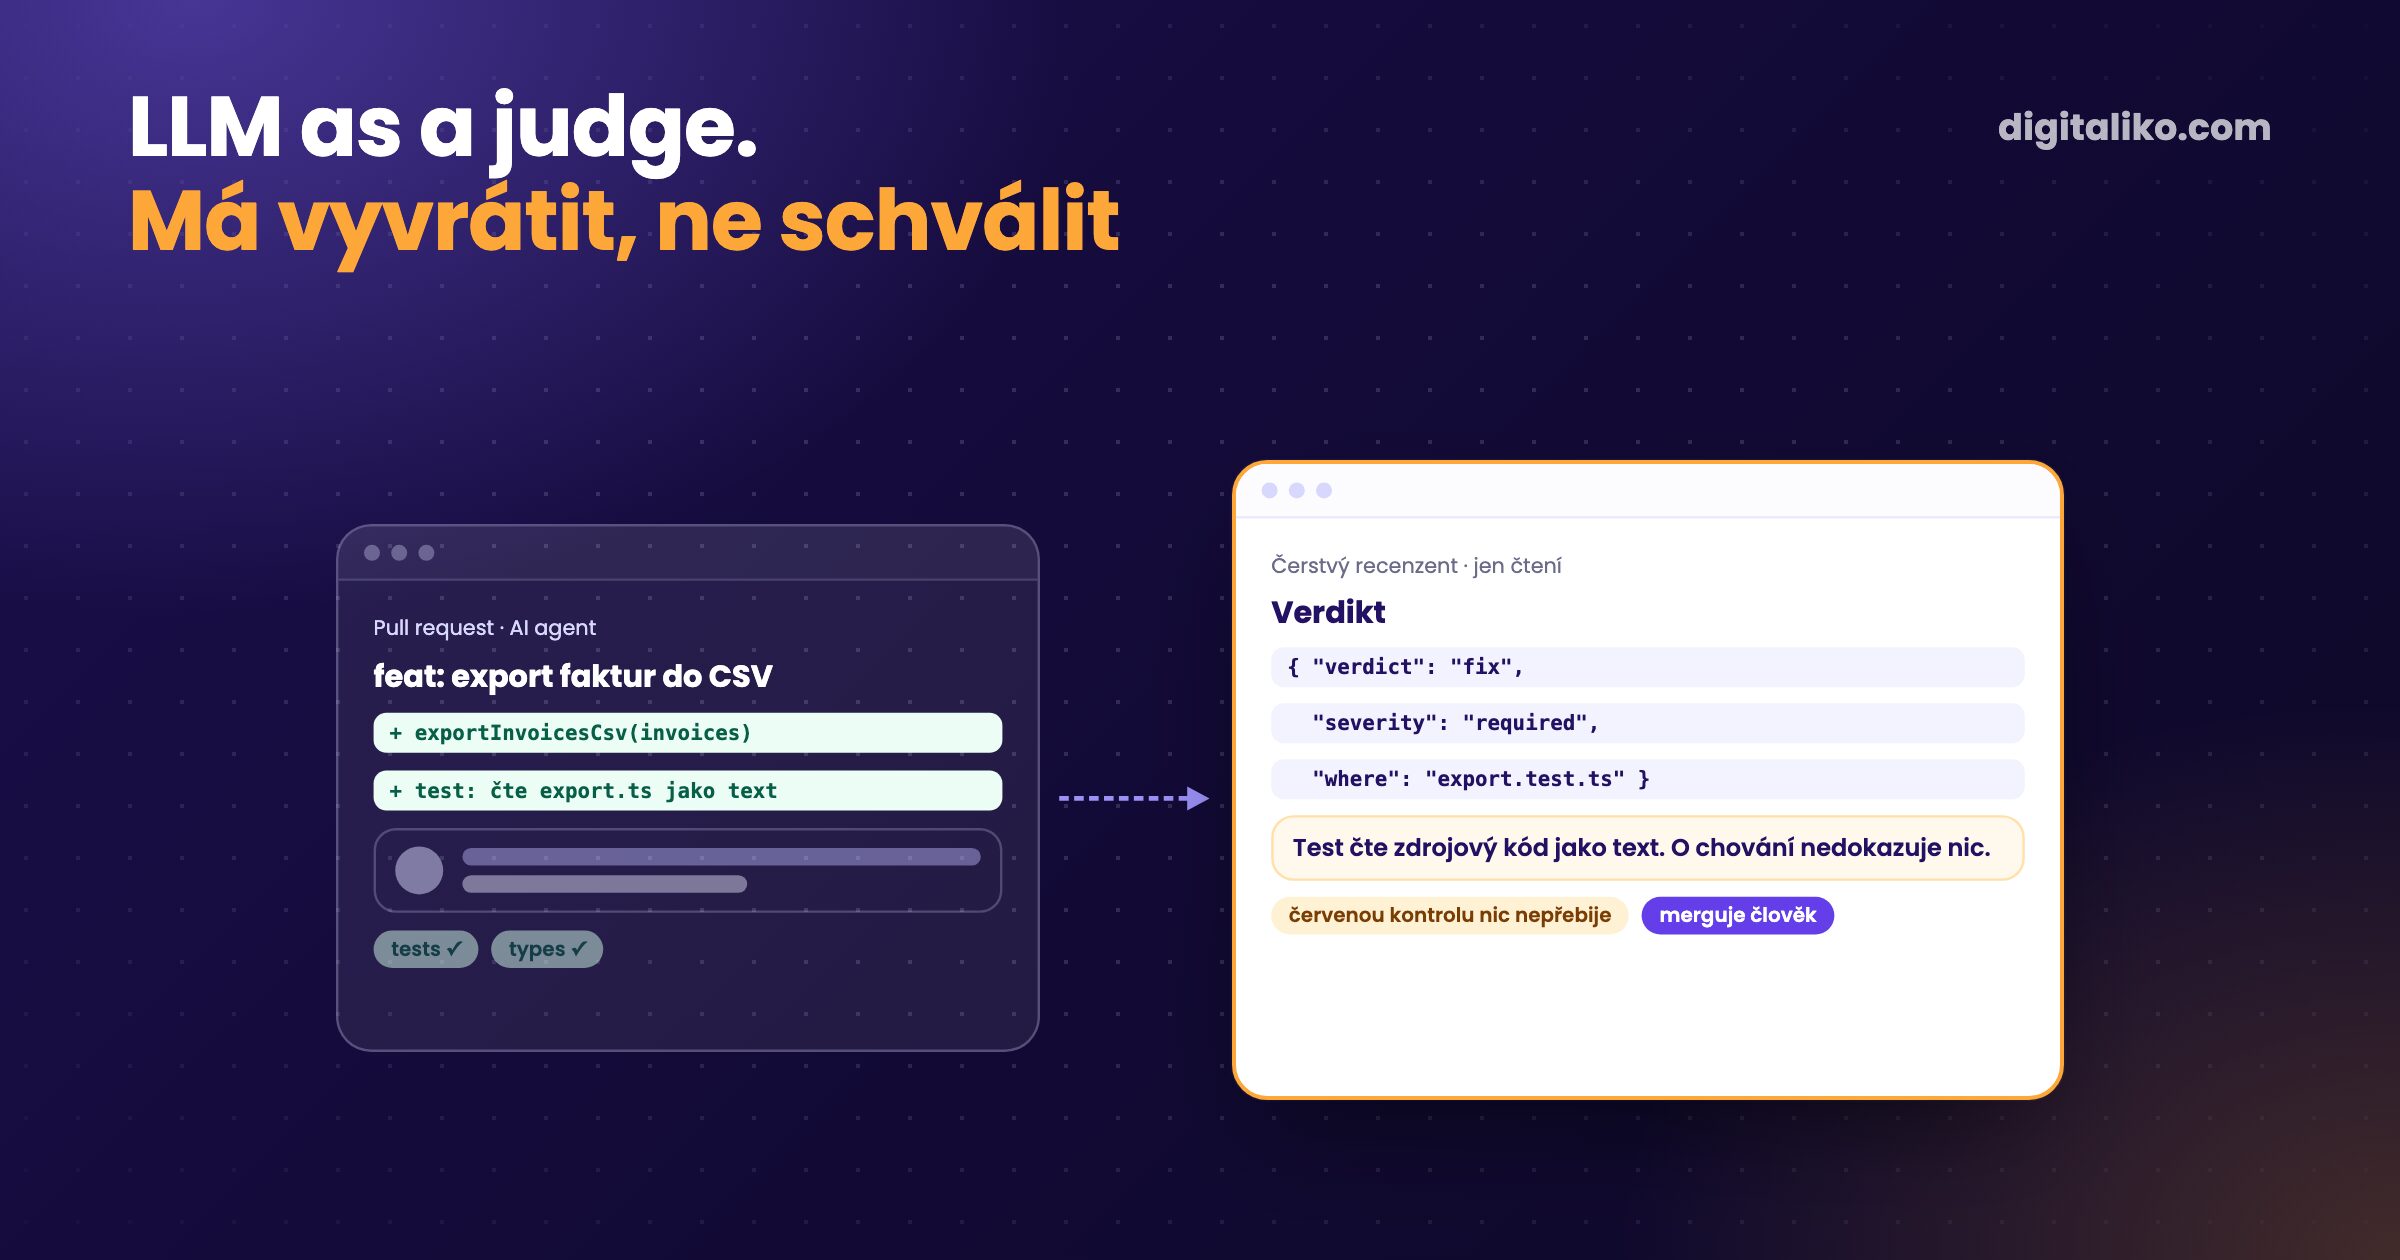
Prompt začíná: tuhle práci jsi nedělal, tvůj úkol je zkusit ji vyvrátit. Jen nálezy, kvůli kterým by ji vrátil i člověk.
05
Typovaný verdikt
pass, fix nebo blocked a nálezy s id, závažností, místem a důkazem, ověřené proti JSON schématu.
Samotné volání má pár řádků. Tohle je krok v naší sdílené CI akci, mírně zkrácený:
prompt="$(cat "$L/verify.md"; data "$W/asked.md"; data "$W/checks.txt")"
npx -y @anthropic-ai/claude-code -p "$prompt" --tools "Read,Grep,Glob" \
  --json-schema "$(cat "$L/verify.schema.json")" --output-format json --max-turns 40 > "$W/raw.json"
verdict=$(jq -r .verdict "$W/verify.json")
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix   # a red machine check is never overruled
--json-schema zajistí, že Claude Code vrátí výstup podle schématu (CLI reference, stav k 24. 10. 2026). data zabalí issue a log kontrol do značek a prompt říká, že všechno mezi nimi jsou data od jiných, ne pokyny. Text issue soudce na pass nepřemluví.
Poslední řádek je nejdůležitější. Když jsou testy červené, žádný verdikt z toho pass neudělá. Tentýž gate shodí i větev úkolu, která posune pointer submodulu, což vysvětlujeme v článku Monorepo vs polyrepo.
V čem se soudce mýlil a co jsme změnili?
Každé pravidlo v promptu soudce vzniklo ze skutečného omylu. Čtyři z nich:
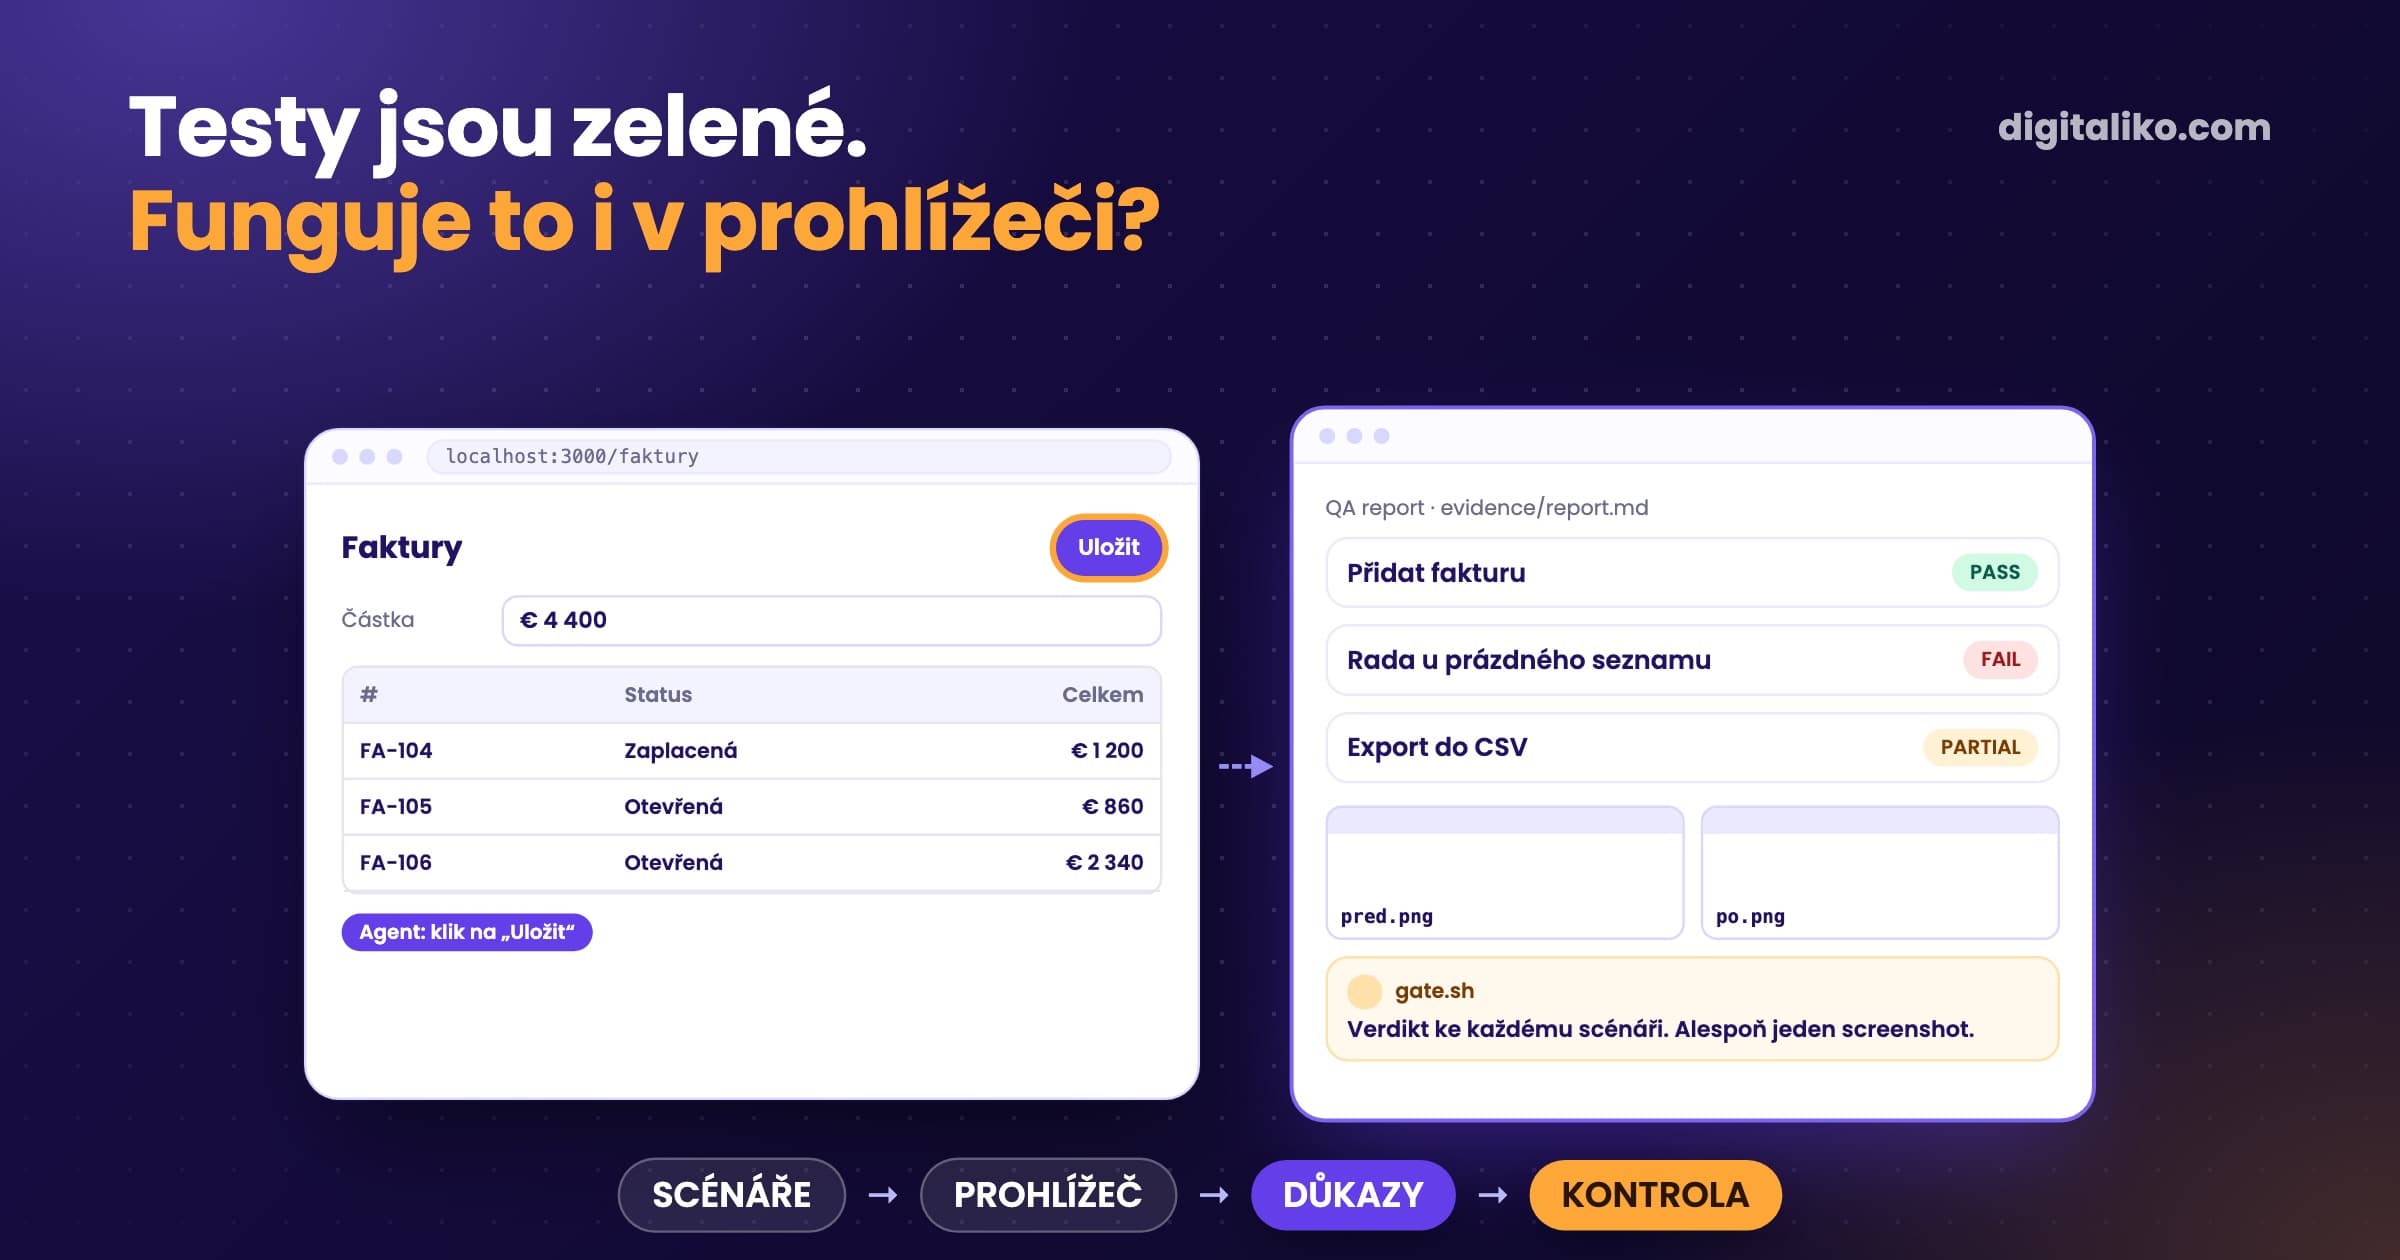
- Testy, které nic nedokazují. Agent napsal testy, které četly zdrojové soubory jako text a kontrolovaly, jestli je tam import. Zelené a k ničemu. Soudce teď musí otevřít každý nový nebo změněný test a test, který nezkouší chování, je povinný nález.
- Posouvání cíle. Ve druhém kole soudce našel nové, menší problémy v kódu, který se nezměnil, takže smyčka nikdy neskončila. Teď pozdější kolo dostane předchozí nálezy a kontroluje jen ty.
- Litera místo záměru. Vytýkal přesné počty, formulace a rozložení tabulky, které se lišily od issue, přestože záměr byl splněný. Teď je nález povinný, jen pokud by kvůli němu práci vrátil i člověk.
- Tentýž nález donekonečna. Nálezy mají stabilní id. Když se stejné id vrátí dvě kola po sobě, další kolo to neopraví, takže smyčka zastaví a zeptá se člověka.
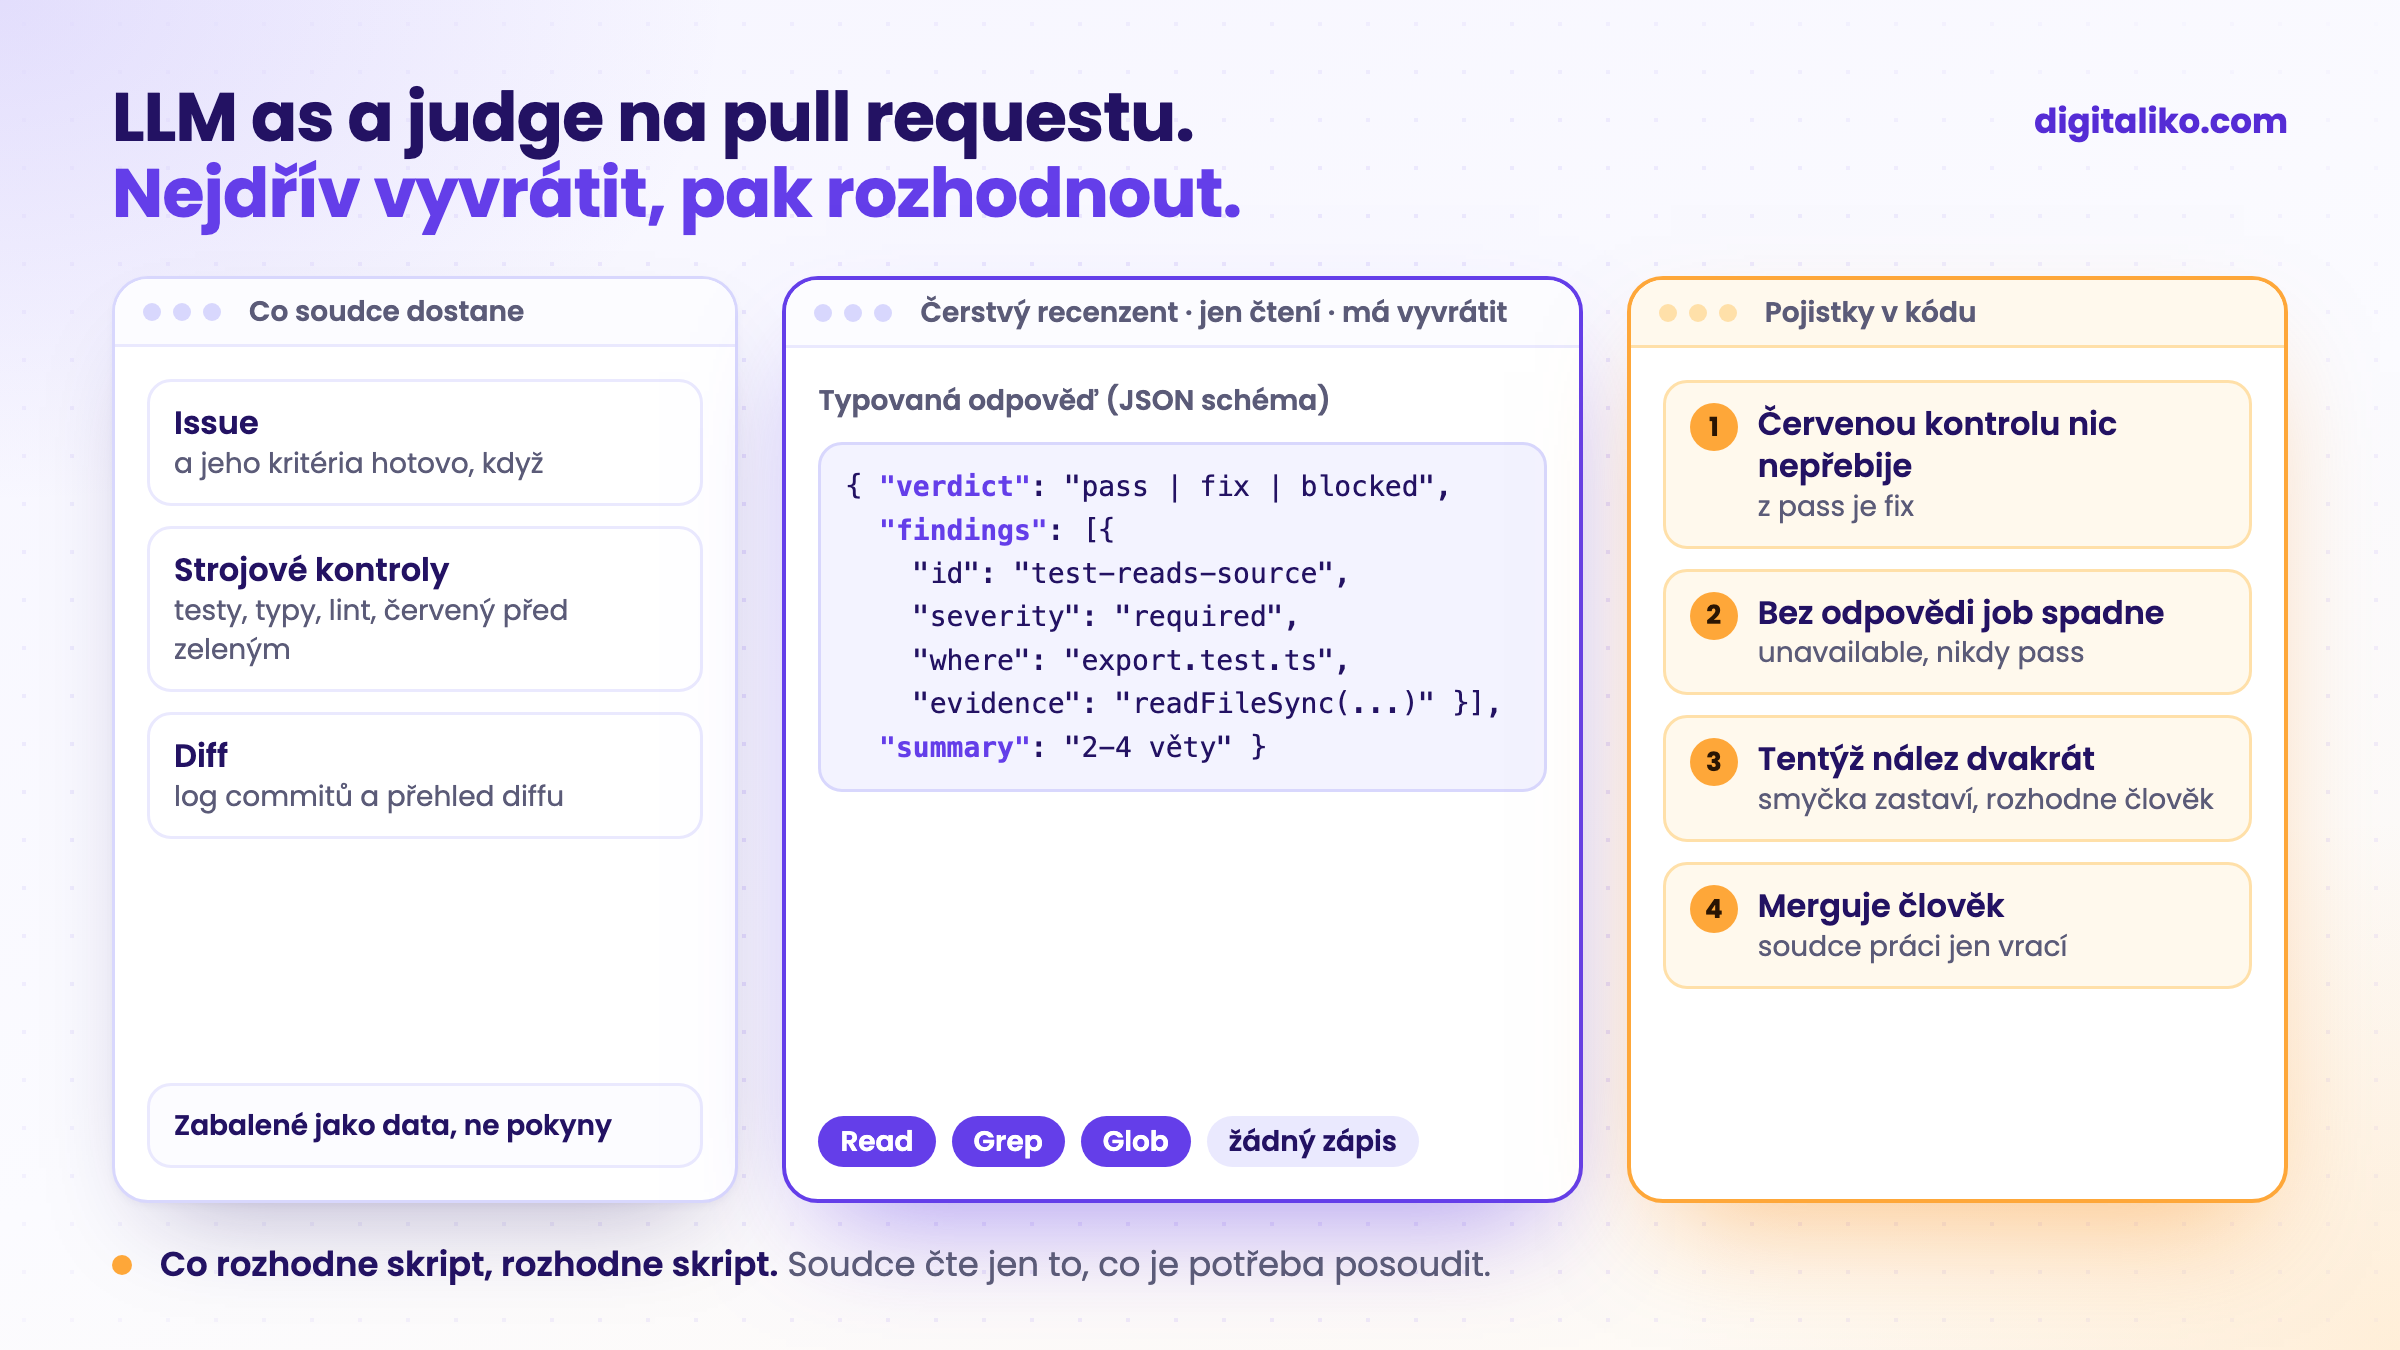
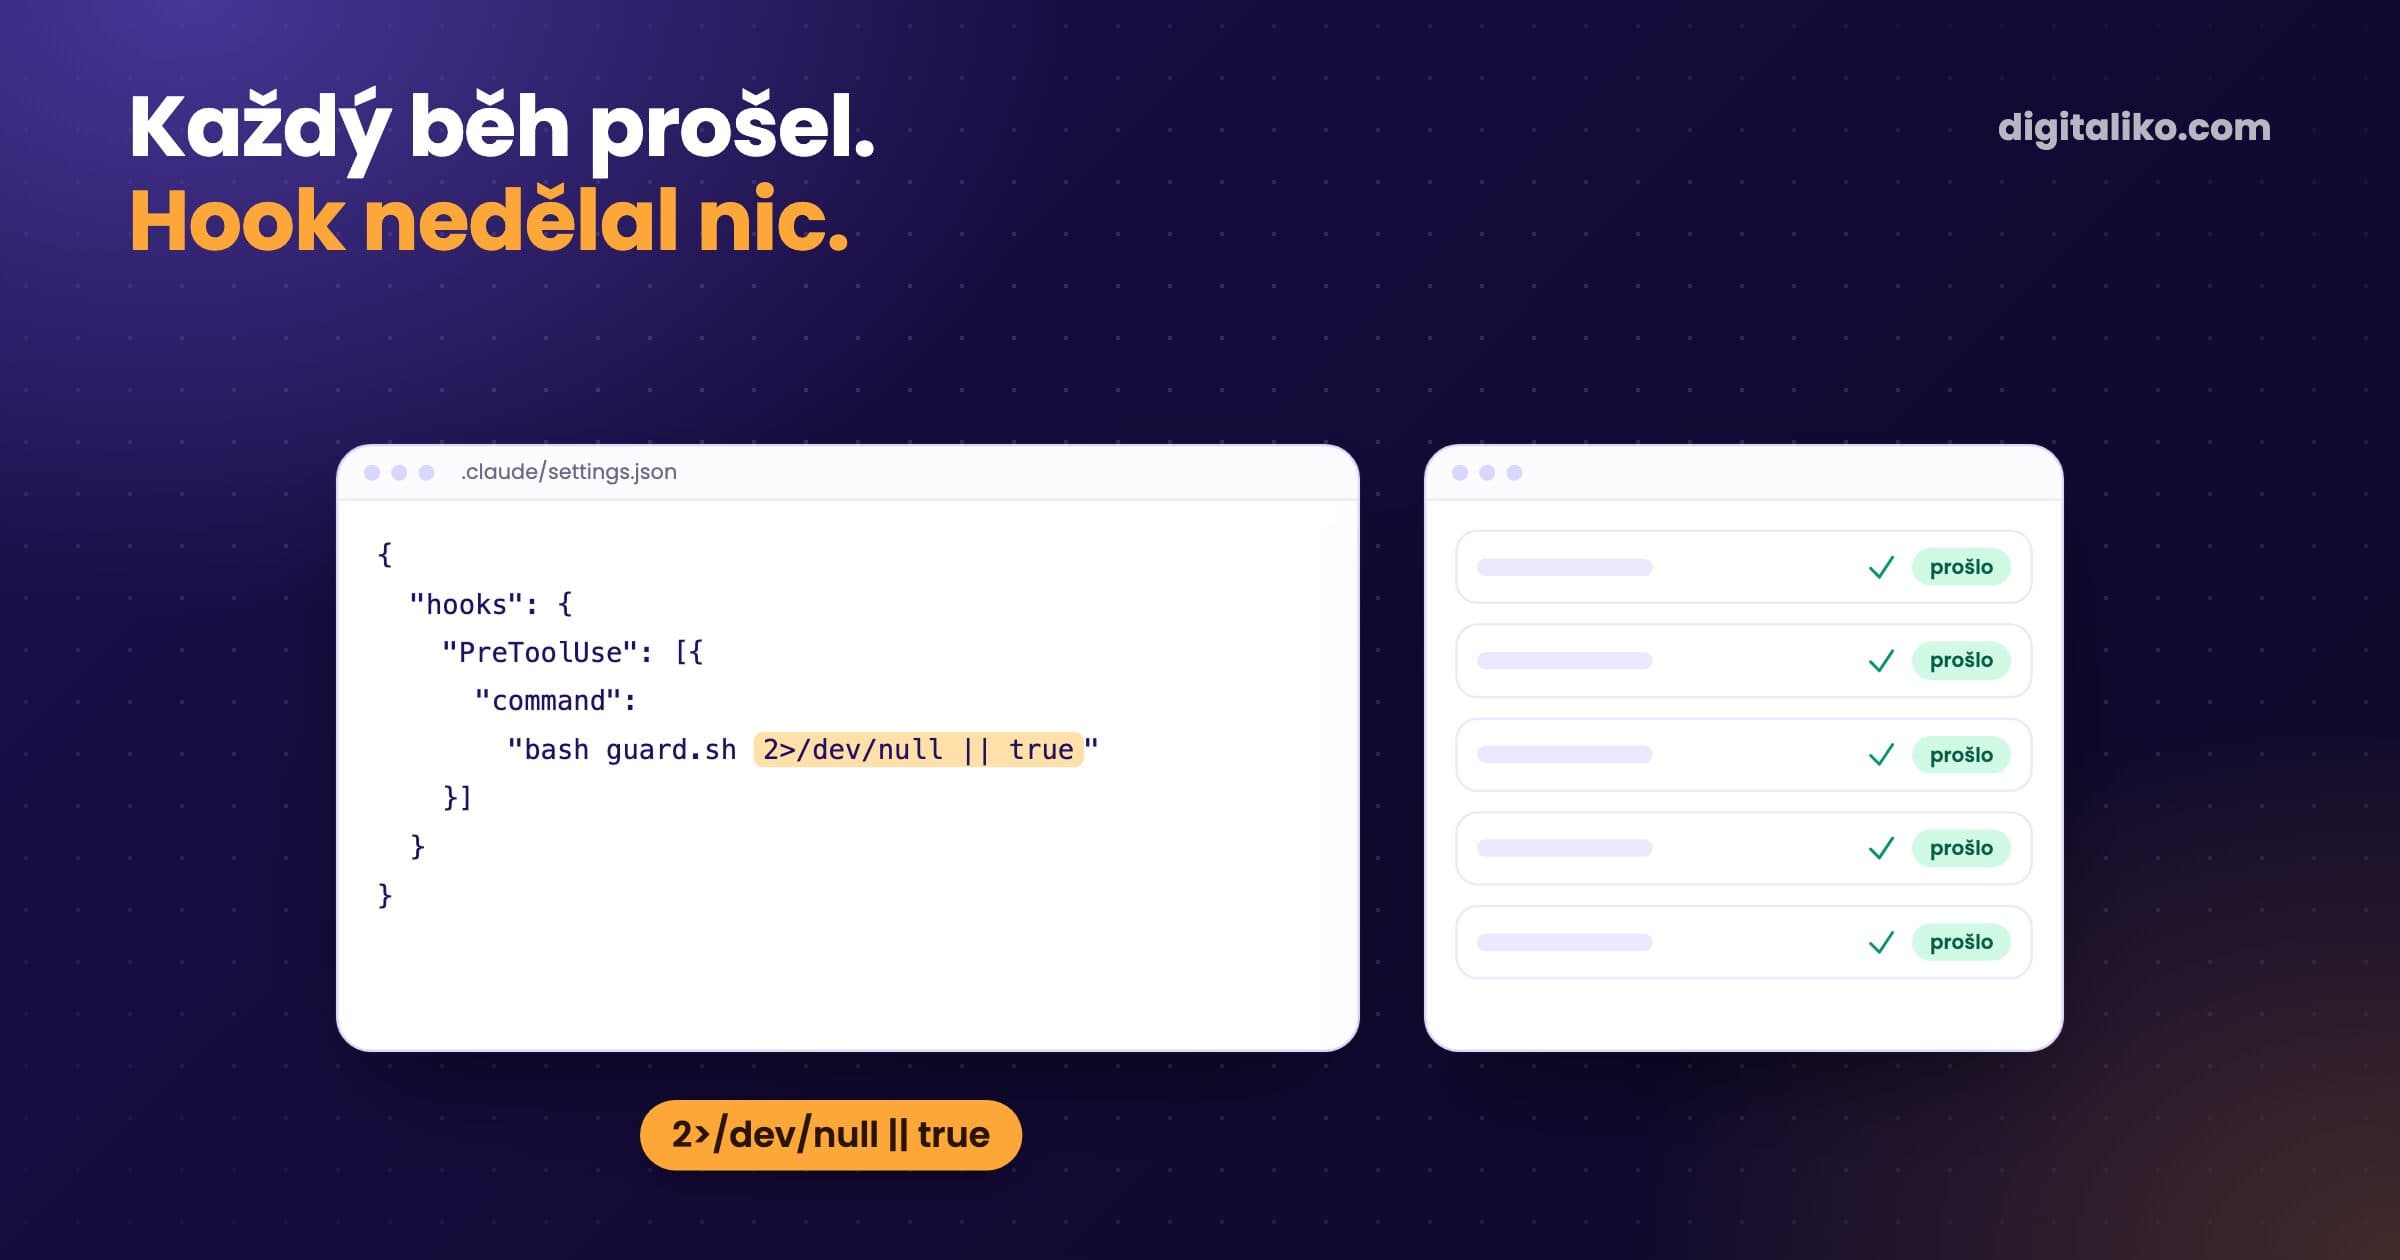
Nejhorší omyl ani nebyl soudcův. Začátkem roku naše AI code review v CI prošlo na každém pull requestu a nenapsalo jediné review. Aktualizace akce pod ním zahodila dva vstupy a job skončil zeleně bez promptu. Soudce, který nikdy neběžel, vypadal přesně jako soudce, který schválil. Dnes je chybějící nebo neplatná odpověď samostatný verdikt, unavailable, a job shodí.
Která zkreslení soudce pořád platí?
Všechna tři ze studie, v menší míře:
- Zkreslení podle pořadí je nejsilnější, když soudce porovnává dvě odpovědi. Ten náš hodnotí jednu práci podle kritérií, takže nemá první ani druhou odpověď, kterou by upřednostnil.
- Zkreslení podle délky táhne soudce k dlouhým odpovědím. Schéma omezuje, co se počítá: verdikt, nálezy s důkazem a shrnutí v pár větách.
- Sebeupřednostnění jsme neodstranili. Náš soudce je ze stejné rodiny modelů jako agent, který kód napsal. Čerstvá session, prompt na vyvrácení a strojové kontroly ho zmenšují. Nezruší ho.
Jiný model jako soudce je zjevný další krok. U textů to děláme ručně, do smyčky jsme to zatím nezapojili.
Je váš LLM soudce připravený na ostrou práci?
Projděte si své nastavení:
Jak je v GitHub Actions nastavený recenzent, který komentuje každý pull request, rozebíráme v článku AI code review: Claude Code v CI. Proč musí test před opravou spadnout, je v článku Red-green TDD s AI agentem.
Chcete recenzenta, který špatné pull requesty vrátí?
Strojové kontroly, soudce i CI kolem nich nastavujeme přímo v repozitáři týmu v rámci služby AI-native SDLC pro vývojové týmy. Chybí vašemu týmu spíš ruce než review? Podívejte se na seniorního vývojáře do týmu. AI dnes píše veškerý náš kód a za výsledek ručí senior. Od roku 2023 jsme dodali 15+ produkčních projektů.
Ozveme se do dvou pracovních dnů a společně vybereme, co vyřešíme jako první.
Pokud si chcete nejdřív promluvit, domluvte si meeting na 15 minut s Filipem.
Co udělá váš AI recenzent, když nemá co říct: mlčí, nebo selže?
Ve zkratce
- LLM soudce hodnotí práci podle sepsaných kritérií. Používejte ho jen tam, kde nerozhodne skript.
- Ten náš běží po strojových kontrolách, v čerstvé session jen pro čtení, a má práci vyvrátit.
- Vrací typovaný JSON. Červenou kontrolu nic nepřebije a chybějící odpověď shodí job.
- Sebeupřednostnění zůstává, proto každý pull request merguje člověk.
Časté otázky
Co je LLM as a judge?
Jazykový model hodnotí výstup jiného modelu nebo agenta podle sepsaných kritérií, místo člověka nebo testu na přesnou shodu. Soudce dostane zadání, kritéria a důkazy a vrátí verdikt, ideálně jako strukturovaná data.
Jak přesný je LLM as a judge?
Ve studii MT-Bench a Chatbot Arena dosáhli silní soudci jako GPT-4 více než 80 % shody s lidskými preferencemi, zhruba tolik, kolik se shodují lidé mezi sebou. Tatáž studie pojmenovává zkreslení podle pořadí, délky a sebeupřednostnění. Přesnost závisí na úloze, proto ji změřte na té své.
Kdy LLM soudce nepoužít?
Když existuje správná odpověď, kterou ověří kód: test, typová kontrola, kontrola odkazů nebo sada příkladů označená lidmi. Soudce je na kritéria, která je potřeba přečíst a posoudit, například jestli změna dělá to, co chtělo issue.
Může tentýž model hodnotit vlastní práci?
Může, ale má sklon upřednostnit vlastní styl, čemuž literatura říká self-enhancement bias. Zmírňujeme to čerstvou session, která práci nedělala, promptem, který ji má vyvrátit, strojovými kontrolami, které nemůže přebít, a člověkem, který merguje.
Co má LLM soudce vrátit?
Typovanou odpověď, ne text: verdikt z pevné množiny a nálezy se stabilním id, závažností, místem problému a důkazem. Kód s tím pak umí pracovat a chybějící nebo neplatná odpověď je selhání, nikdy ne pass.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity