Playwright MCP: AI agent ověří změnu v prohlížeči
Pro CTO a vývojářeHarness a kontroly · Aktualizováno

Filip PapranecZakladatel, Digitaliko
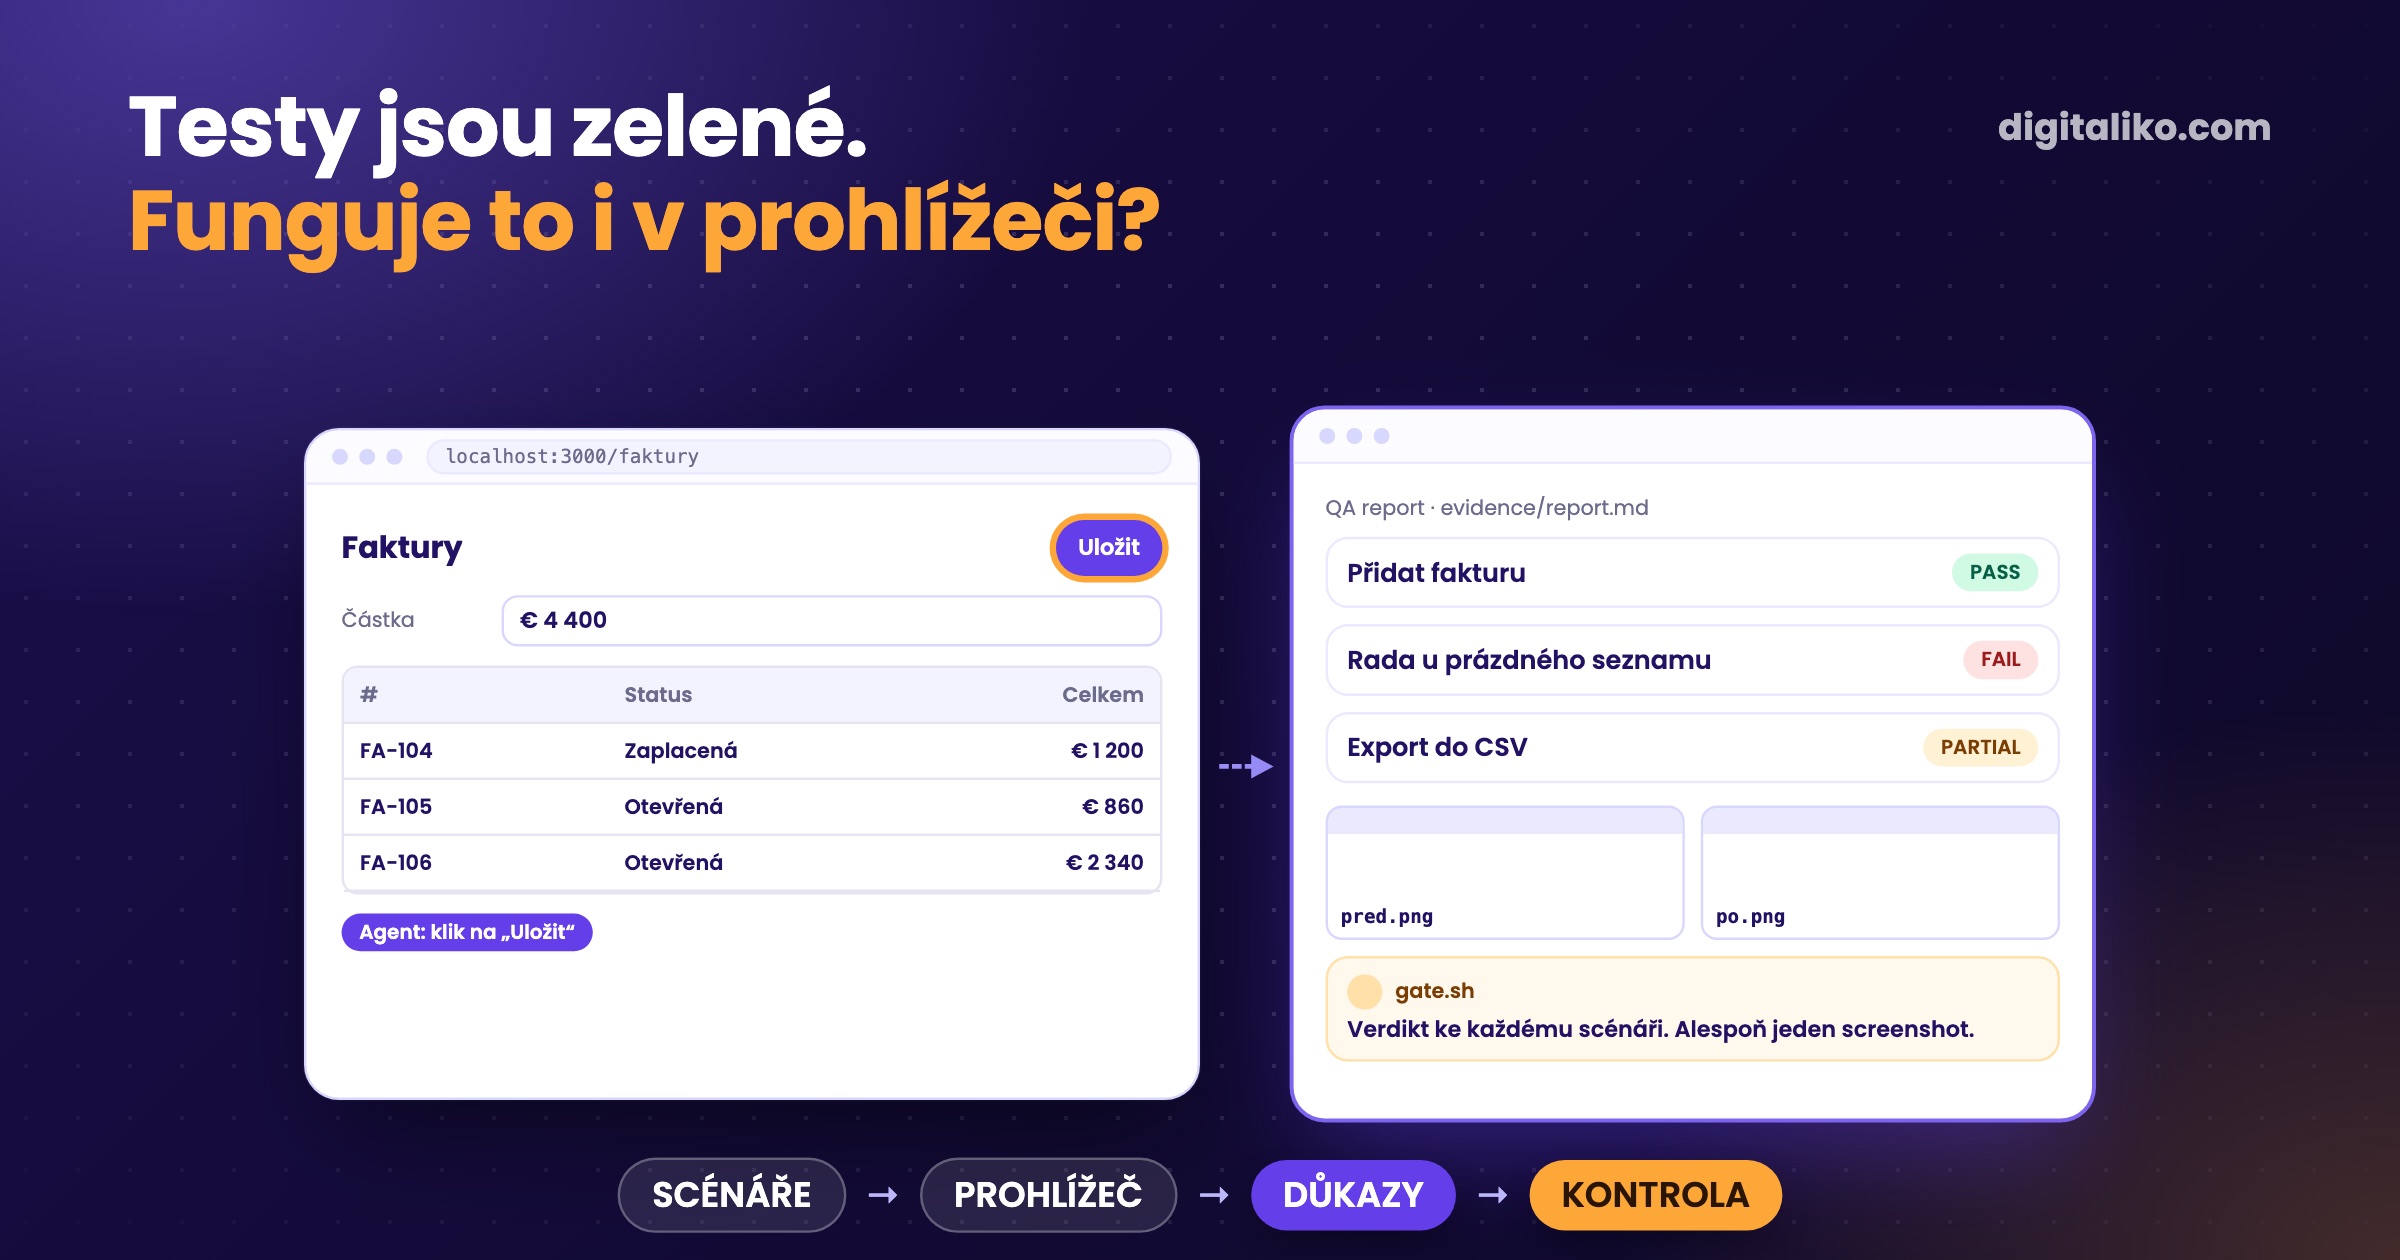
Playwright MCP je MCP server od Microsoftu, který dává AI agentovi skutečný prohlížeč: otevírá stránky, kliká, píše a čte, co je na obrazovce. Používáme ho na jednu věc. Než kdokoli řekne „hotovo“, agent projde změnu v běžící aplikaci a vrátí PASS nebo FAIL pro každý scénář, se screenshoty.
Zelený typecheck dokazuje, že se kód zkompiluje. Prošlý test komponenty dokazuje, že se komponenta vykreslí ve vlastním testovacím prostředí. Ani jedno nedokazuje, že skutečná stránka se skutečnými daty dělá to, co chtělo issue. Přesně tuhle mezeru zavře kontrola v prohlížeči.
Nejtěžší je obvykle poslední krok. Ověřit, že to opravdu funguje, od začátku do konce.

Co je Playwright MCP a jak funguje?
MCP, Model Context Protocol, je způsob, jakým agent jako Claude Code dostane další nástroje. Playwright MCP server přidá nástroje prohlížeče postavené na Playwrightu: otevřít adresu, kliknout, psát, vyplnit formulář, číst konzoli a síťové požadavky, pořídit screenshot.
V Claude Code je to jeden příkaz:
claude mcp add playwright npx @playwright/mcp@latest
Podstatný detail: agent se nedívá na pixely. Podle README pracuje přes „structured accessibility snapshots“, bez screenshotů a bez modelů na vidění. Stránku dostane jako strom tlačítek, odkazů, nadpisů a formulářových polí s jejich popisky. Klikne na tlačítko „Uložit“, ne na souřadnice, kde kdysi nějaké tlačítko bylo.
Z toho plynou dvě věci. Stránka, jejíž tlačítka nemají přístupný název, je těžká i pro agenta, takže kontrola je zároveň malá revize přístupnosti. A když výsledek potřebuje vidět člověk, agent screenshot pořídit umí.
Server ve výchozím stavu drží trvalý profil prohlížeče, takže přihlášení přežije mezi sessions. Pro běhy, které musí začít načisto, je --isolated a --storage-state do takového čistého kontextu načte uložené cookies.
Jak necháme agenta ověřit jeho vlastní změnu?
Metoda je v našem skillu browser-qa. Kód aplikace nemění. Píše důkazy:
01
Scénáře z issue
Jeden scénář na každé akceptační kritérium nebo připomínku, s odkazem na zdroj. Konkrétní kroky: kliknu na X, stane se Y.
02
Skutečná data, skutečné přihlášení
Běh nad falešnými nebo prázdnými daty dokazuje rozložení, ne chování. Nejdřív se přihlásí člověk. Agent na session token nesáhne.
03
Projít aplikaci
Otevřít, kliknout, psát, pořídit screenshot. Co musí sedět přesně, barva, číslo, popisek, agent přečte ze stránky, nehádá z obrázku.
04
Verdikt pro každý scénář
PASS, FAIL nebo PARTIAL a co agent opravdu viděl. Nikdy „vypadá to dobře“.
05
Chyby do issues
Každý skutečný FAIL je bug issue s odkazem na report. Poznámka jen v reportu se ztratí.
Skill říká i to, co dělat, když automatizace něco nezvládne. Prvek vnořený tak hluboko, že klik spolehlivě nefunguje, dostane poznámku „needs manual click“. Neoznačí se potichu jako FAIL a nepřeskočí se.
Ne každá kontrola vychází z napsaného scénáře. Někdy je nejlepší ta otevřená:
Osvědčil se nám jeden trik. Pošleme agenta do nové funkce jako určitý typ zákazníka, personu, a necháme ho, ať ji sám prozkoumá.
Persona najde věci, které nikdo nenapsal: matoucí popisek, slepou uličku, krok, který dává smysl jen tomu, kdo ho stavěl.
Co agent předá a kdo to zkontroluje?
Report, který agent napíše sám o sobě, je pořád jen tvrzení. Proto je tvar důkazů pevný a kontroluje ho skript, ne model.
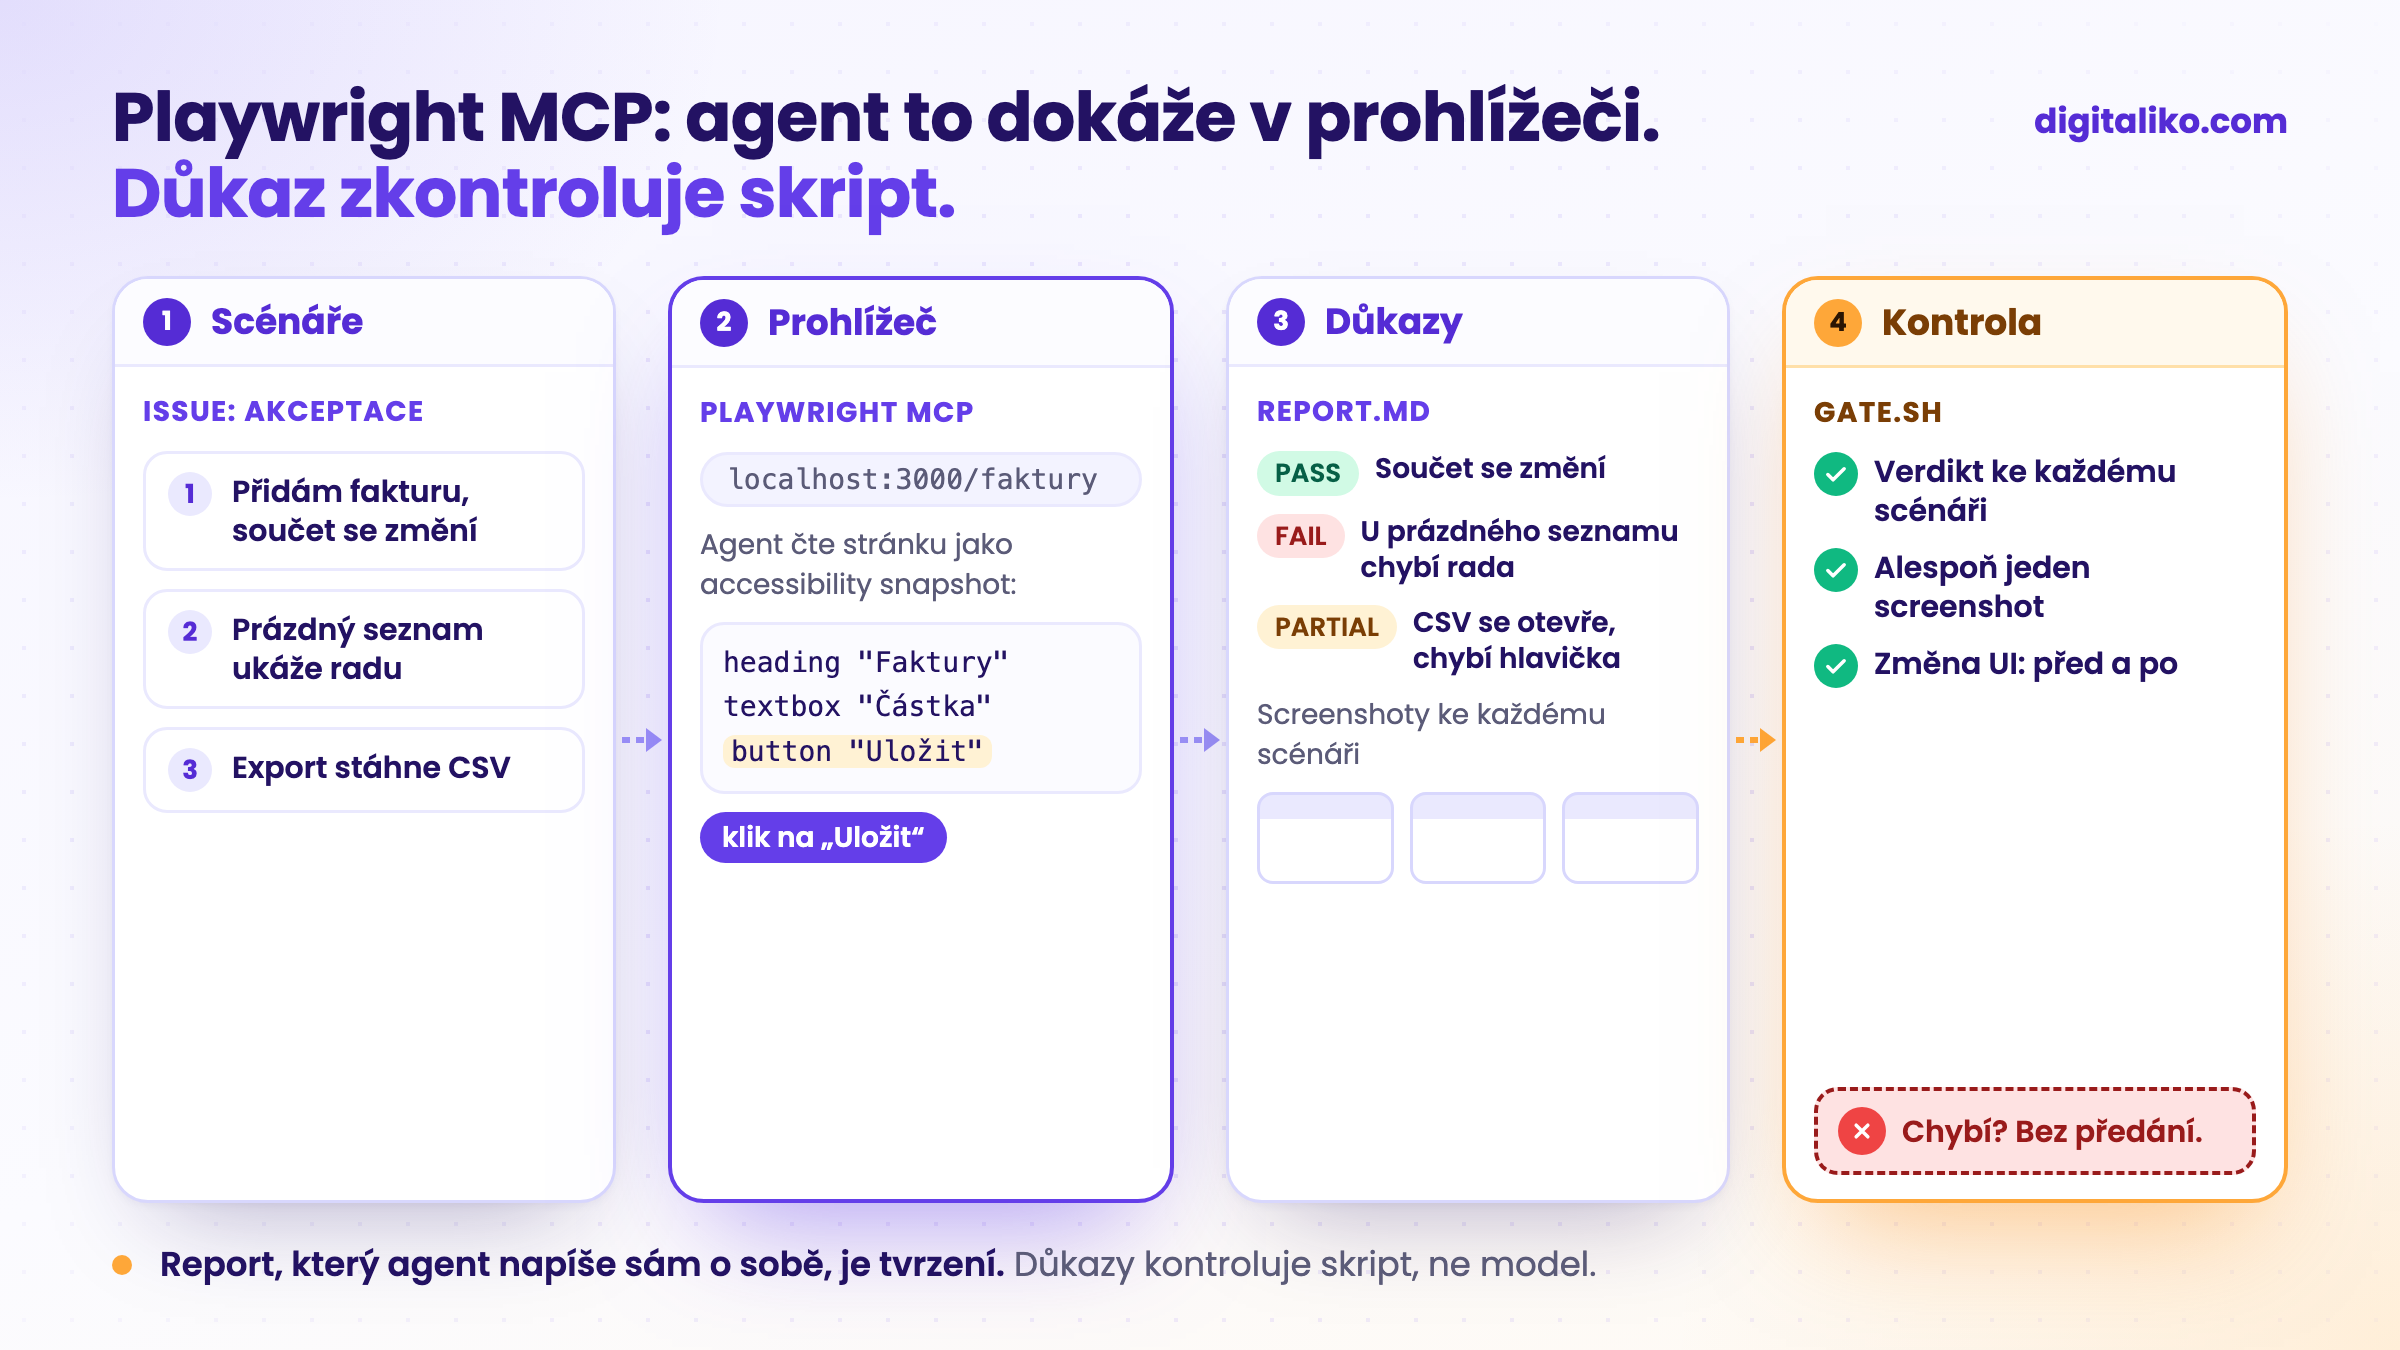
V naší smyčce agentů QA úkol říká agentovi, ať použije nástroje prohlížeče od Playwrightu a všechno uloží do evidence/<issue>/: screenshot pro každý scénář, chyby z konzole a sítě a report.md. Zbytek udělá gate.sh, obyčejný bash skript s exit kódy:
n=$(grep -cE '\b(PASS|FAIL|PARTIAL)\b' "$tree/$rep"); shots=$(ls "$tree/$(dirname "$rep")"/*.png 2>/dev/null | wc -l | tr -d ' ')
[ "$n" -gt 0 ] && [ "$shots" -gt 0 ] || { echo "FAIL: report needs PASS/FAIL per scenario and screenshots" >> "$out"; exit 1; }
Bez reportu, bez řádků s verdiktem nebo bez screenshotu úkol není hotový, ať agent tvrdí cokoli.
Podobné pravidlo platí pro úkoly s kódem. Když pull request mění UI soubory, smyčka chce before-*.png a after-*.png. Pokud je dobrý důvod, proč nejsou, PR to musí říct v řádku, který začíná No screenshots:. Recenzent tak změnu vidí, nemusí si ji představovat.
To pravidlo vzniklo z naší vlastní chyby. Před opravou stačil jako důkaz jakýkoli PNG, tedy jeden screenshot čehokoli. Teď musí být dva a musí být pojmenované podle toho, co ukazují.
Co chytí kontrola v prohlížeči, co unit testy ne?
Unit test se ptá úzkou otázku v kontrolované místnosti. Prohlížeč se ptá, jestli ta místnost vůbec existuje.
| Otázka | Unit nebo komponentový test | Agent ve skutečném prohlížeči |
|---|---|---|
| Vrátí funkce správnou hodnotu? | Ano, rychle a opakovatelně | Jen nepřímo |
| Je route napojená na komponentu? | Ne, test si komponentu připojí sám | Ano, otevře skutečnou adresu |
| Funguje to s daty jako v produkci? | Jen s fixture, kterou jste napsali | Ano, pokud běží nad skutečnými daty |
| Má tlačítko název, který přečte čtečka obrazovky? | Jen pokud někdo napsal takový test | Ano, ukáže to snapshot |
| Jsou v konzoli nebo v síti chyby? | Kontroluje se zřídka | Ano, čte obojí |
| Dává postup smysl zákazníkovi? | Ne | Částečně, s personou |
Platí oba sloupce. Pravidlo red-green pro unit testy je v článku Red-green TDD s AI agentem. Kontrola v prohlížeči stojí nad ním, ne místo něj.
Upřímně k limitům: nepočítali jsme, kolik chyb chytí kontroly v prohlížeči ve srovnání s testy. Víme, jaký druh chyb to je: věci, které existují až ve chvíli, kdy je všechno propojené.
Playwright MCP, Playwright skripty, nebo Chrome DevTools MCP?
I tým Playwrightu říká, že MCP není vždy správný nástroj. Jejich README doporučuje coding agentům Playwright CLI se skilly, protože je „more token-efficient“. MCP podle nich „remains relevant for specialized agentic loops“, například pro průzkumnou automatizaci nebo dlouhé autonomní běhy.
To sedí s tím, co vidíme my:
Playwright MCP
- Agent zkoumá a další klik si volí sám
- Dobré na jednorázové ověření změny a na personu
- Stojí kontext: schémata nástrojů a snapshoty stránek
Na všechno, co opakujete
Playwright skripty a testy
- Stejná kontrola při každém běhu, v CI
- Přesná čísla: vypočtené barvy, rozměry, časy
- Někdo je musí nejdřív napsat, často agent
Chrome DevTools MCP
- Nástroje prohlížeče s přístupem k DevTools
- To, co náš interaktivní QA skill dnes zkouší jako první
- Stejná metoda, jiný ovladač
Když jsme tento týden dělali audit tohoto webu, MCP jsme nepoužili vůbec. Agent napsal obyčejné Playwright skripty nad lokálním buildem: kontrast textu z vypočtených barev, sken přístupnosti přes axe, každou stránku v šířce mobilu a výkon se zpomaleným CPU. Jsou to kontroly, které chceme spustit znovu po každé změně. Skript je udělá pokaždé stejně. Agent, který improvizuje kliky, ne.
A od tohoto týdne náš interaktivní skill browser-qa zkouší nejdřív Chrome DevTools MCP, pokud ho session má. Metoda se nezměnila vůbec. Ovladač prohlížeče je vyměnitelná část.
Kde se to pokazí?
Pár pastí, které známe z našich pravidel nebo z vlastních chyb:
- Falešná data. Zelený průchod nad prázdnou databází dokazuje rozložení, nic víc. Skill zakazuje nazvat to hotovým.
- Session token. Playwright MCP má nástroje, které čtou cookies a local storage. Naše pravidlo je starší než jakýkoli nástroj: agent session token nikdy nevytahuje, neloguje ani neposílá dál.
- Odhad od oka. „Součet vypadá dobře“ na screenshotu je tip. Agent hodnotu přečte ze stránky.
- Dva agenti, jeden profil. Trvalý profil může najednou používat jen jeden prohlížeč. Paralelní běhy potřebují
--isolatednebo vlastní složku profilu.
Co jsou Playwright agents a používáme je?
Playwright agents, oficiálně Playwright Test Agents, jsou tři definice agentů, které přicházejí přímo s Playwrightem. Podle dokumentace Playwrightu (stav k 24. 10. 2026) planner „explores the app and produces a Markdown test plan“, generator „transforms the Markdown plan into the Playwright Test files“ a healer „executes the test suite and automatically repairs failing tests“. Do Claude Code je přidáte jedním příkazem:
npx playwright init-agents --loop=claude
Planner vychází ze seed testu tests/seed.spec.ts, který připraví prostředí, a plán zapíše do specs/. Generator z plánu udělá testy v tests/ a selektory i aserce ověřuje naživo, zatímco prochází scénáře.
Upřímně: Playwright agents jsme v našich projektech zatím nepoužili. Naši agenti píšou Playwright testy z akceptačních kritérií issue v naší vlastní smyčce a zkoumání dělá skill browser-qa. Planner a generator dělají velkou část téhož ve formátu Playwrightu, takže se vyplatí je vyzkoušet v týmu, který vlastní smyčku nemá.
Pozor bychom si dali na healer. Podle dokumentace je jeho výstupem „a passing test, or a skipped test if the healer believes that functionality is broken“. V naší smyčce přeskočený test nic nedokazuje a test, který je červený, protože se rozbil produkt, musí zůstat červený. Pokud healer zkusíte, každý lokátor nebo aserci, kterou změní, reviewujte jako jakýkoli jiný pull request.
Je váš tým připravený nechat agenta ověřovat v prohlížeči?
Projděte si, co už máte:
Pokud chcete hotový základ, náš veřejný Claude Code production starter už v CI spouští Playwright smoke test a při chybě nahraje report. Jak funguje celá smyčka kolem, je v článku Harness engineering v praxi: AI agent od issue k PR.
Chcete agenty, kteří ve vašem repozitáři dokážou svou práci?
Kontroly v prohlížeči, pravidla pro důkazy a CI kolem nich nastavujeme přímo v repozitáři týmu v rámci služby AI-native SDLC pro vývojové týmy. Chybí vašemu týmu spíš ruce než proces? Podívejte se na seniorního vývojáře do vašeho týmu. Dnes píše AI veškerý náš kód a za to, co jde do produkce, ručí senior. Od roku 2023 jsme dodali 15+ produkčních projektů.
Ozveme se do dvou pracovních dnů a společně vybereme, co vyřešíme jako první.
Pokud si chcete nejdřív promluvit, domluvte si meeting na 15 minut s Filipem.
Kdo ve vašem týmu dnes ověřuje, že změna funguje v prohlížeči, a jak to dokáže?
Ve zkratce
- Playwright MCP dává agentovi skutečný prohlížeč, který čte jako accessibility snapshot.
- Agent u nás projde scénáře z issue nad skutečnými daty a vrátí PASS nebo FAIL se screenshoty.
- Předání zastaví skript, ne model, když report nebo screenshoty chybí.
- Zkoumejte přes MCP. Kontroly, které opakujete, přepište na Playwright testy v CI.
Časté otázky
Co je Playwright MCP?
MCP server od Microsoftu, který dává AI agentovi nástroje prohlížeče postavené na Playwrightu: otevřít stránku, kliknout, psát, vyplnit formulář, číst konzoli a síťové požadavky, pořídit screenshot. Stránku agent čte jako accessibility snapshot, ne jako pixely.
Jak přidám Playwright MCP do Claude Code?
Příkazem claude mcp add playwright npx @playwright/mcp@latest. Jiní MCP klienti používají stejný server s příkazem npx a argumentem @playwright/mcp@latest.
Nahradí Playwright MCP end-to-end testy?
Ne. MCP slouží k průzkumu a k jednorázovému ověření jedné změny. Kontrola, kterou chcete u každého pull requestu, patří do Playwright testu nebo skriptu v CI, kde se nikdo nemusí ptát agenta.
Jak agent otestuje stránky za přihlášením?
Nejdřív se přihlásí člověk, v prohlížeči, který agent používá, a agent pracuje v té session. Naše pravidlo: agent session token nikdy nečte, neloguje ani nikomu neposílá. Pro izolované běhy umí Playwright MCP načíst uložený storage state.
Stačí QA report od agenta k tomu, aby byla změna hotová?
Jen s důkazy: verdikt pro každý scénář a screenshoty vedle něj. V naší smyčce kontrolní skript zastaví předání, když report nebo screenshoty chybí, a pull request stejně zkontroluje člověk.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity