LLM as a judge: AI recenzent, ktorý sa snaží prácu vyvrátiť
Pre CTO a vývojárovHarness a kontroly · Aktualizované

Filip Papraneczakladateľ Digitaliko
LLM as a judge znamená, že jazykový model hodnotí prácu podľa spísaných kritérií, namiesto človeka alebo presného testu. Funguje, keď má sudca kritériá napísané, vidí dôkazy, odpovedá v pevnom formáte a nemôže prebiť kontroly, ktoré zvládne stroj.
Máme ho na každom pull requeste, ktorý otvorí náš AI agent. Nepýtame sa ho, či je práca dobrá. Má ju skúsiť vyvrátiť. Takto je postavený a toto sú pravidlá, ktoré pribudli vždy, keď sa pomýlil.
Čo je LLM as a judge?
Pojem pochádza z hodnotenia chatovacích modelov. Namiesto toho, aby ste platili ľudí za porovnávanie odpovedí, necháte to na silný model. Štúdia, ktorá to pomenovala, Zheng a kol., zmerala, ako dobre to funguje:
Our results reveal that strong LLM judges like GPT-4 can match both controlled and crowdsourced human preferences well, achieving over 80% agreement, the same level of agreement between humans.
Ten istý abstrakt pomenúva aj limity: „position, verbosity, and self-enhancement biases, as well as limited reasoning ability“. Sudca uprednostní odpoveď, ktorú videl prvú, tú dlhšiu a tú, ktorá znie ako on sám. Tieto tri si zapamätajte. Každé pravidlo nižšie bojuje proti jednému z nich.
Dnes sa myšlienka používa ďaleko mimo chatových benchmarkov: na hodnotenie odpovedí z vyhľadávania, behov agentov aj na code review. Ten náš robí to posledné.
Kedy LLM sudcu nepoužiť?
Keď správnu odpoveď dá lacnejšia kontrola. Sudca je pomalý, míňa tokeny a môže sa mýliť. Kód, ktorý overí fakt, nič z toho nerobí.
| Čo chcete vedieť | Správna kontrola | Sudca? |
|---|---|---|
| Prechádzajú testy, sedia typy? | Spustiť ich | Nie |
| Padol nový test pred opravou? | Spustiť ho na pôvodnom kóde | Nie |
| Fungujú odkazy, je citát naozaj na zdrojovej stránke? | Skript | Nie |
| Zaradí klasifikátor do správnej kategórie? | Príklady označené ľuďmi, vyhodnotené kódom | Nie |
| Robí zmena to, čo chcelo issue? | Prečítať issue, diff a dôkazy | Áno |
| Skúša test správanie, alebo len číta zdrojový kód ako text? | Prečítať test | Áno |
Riadok s klasifikátorom je skutočný. Pre klienta s online marketplace sme ladili LLM, ktoré triedi inzeráty do kategórií. Nepýtali sme sa iného modelu, či kategórie vyzerajú dobre. Skutočné inzeráty sme označili ručne a zhody spočítal kód. Keď existuje správna odpoveď, sudca pridá len šum.
Ako náš LLM sudca kontroluje pull request?
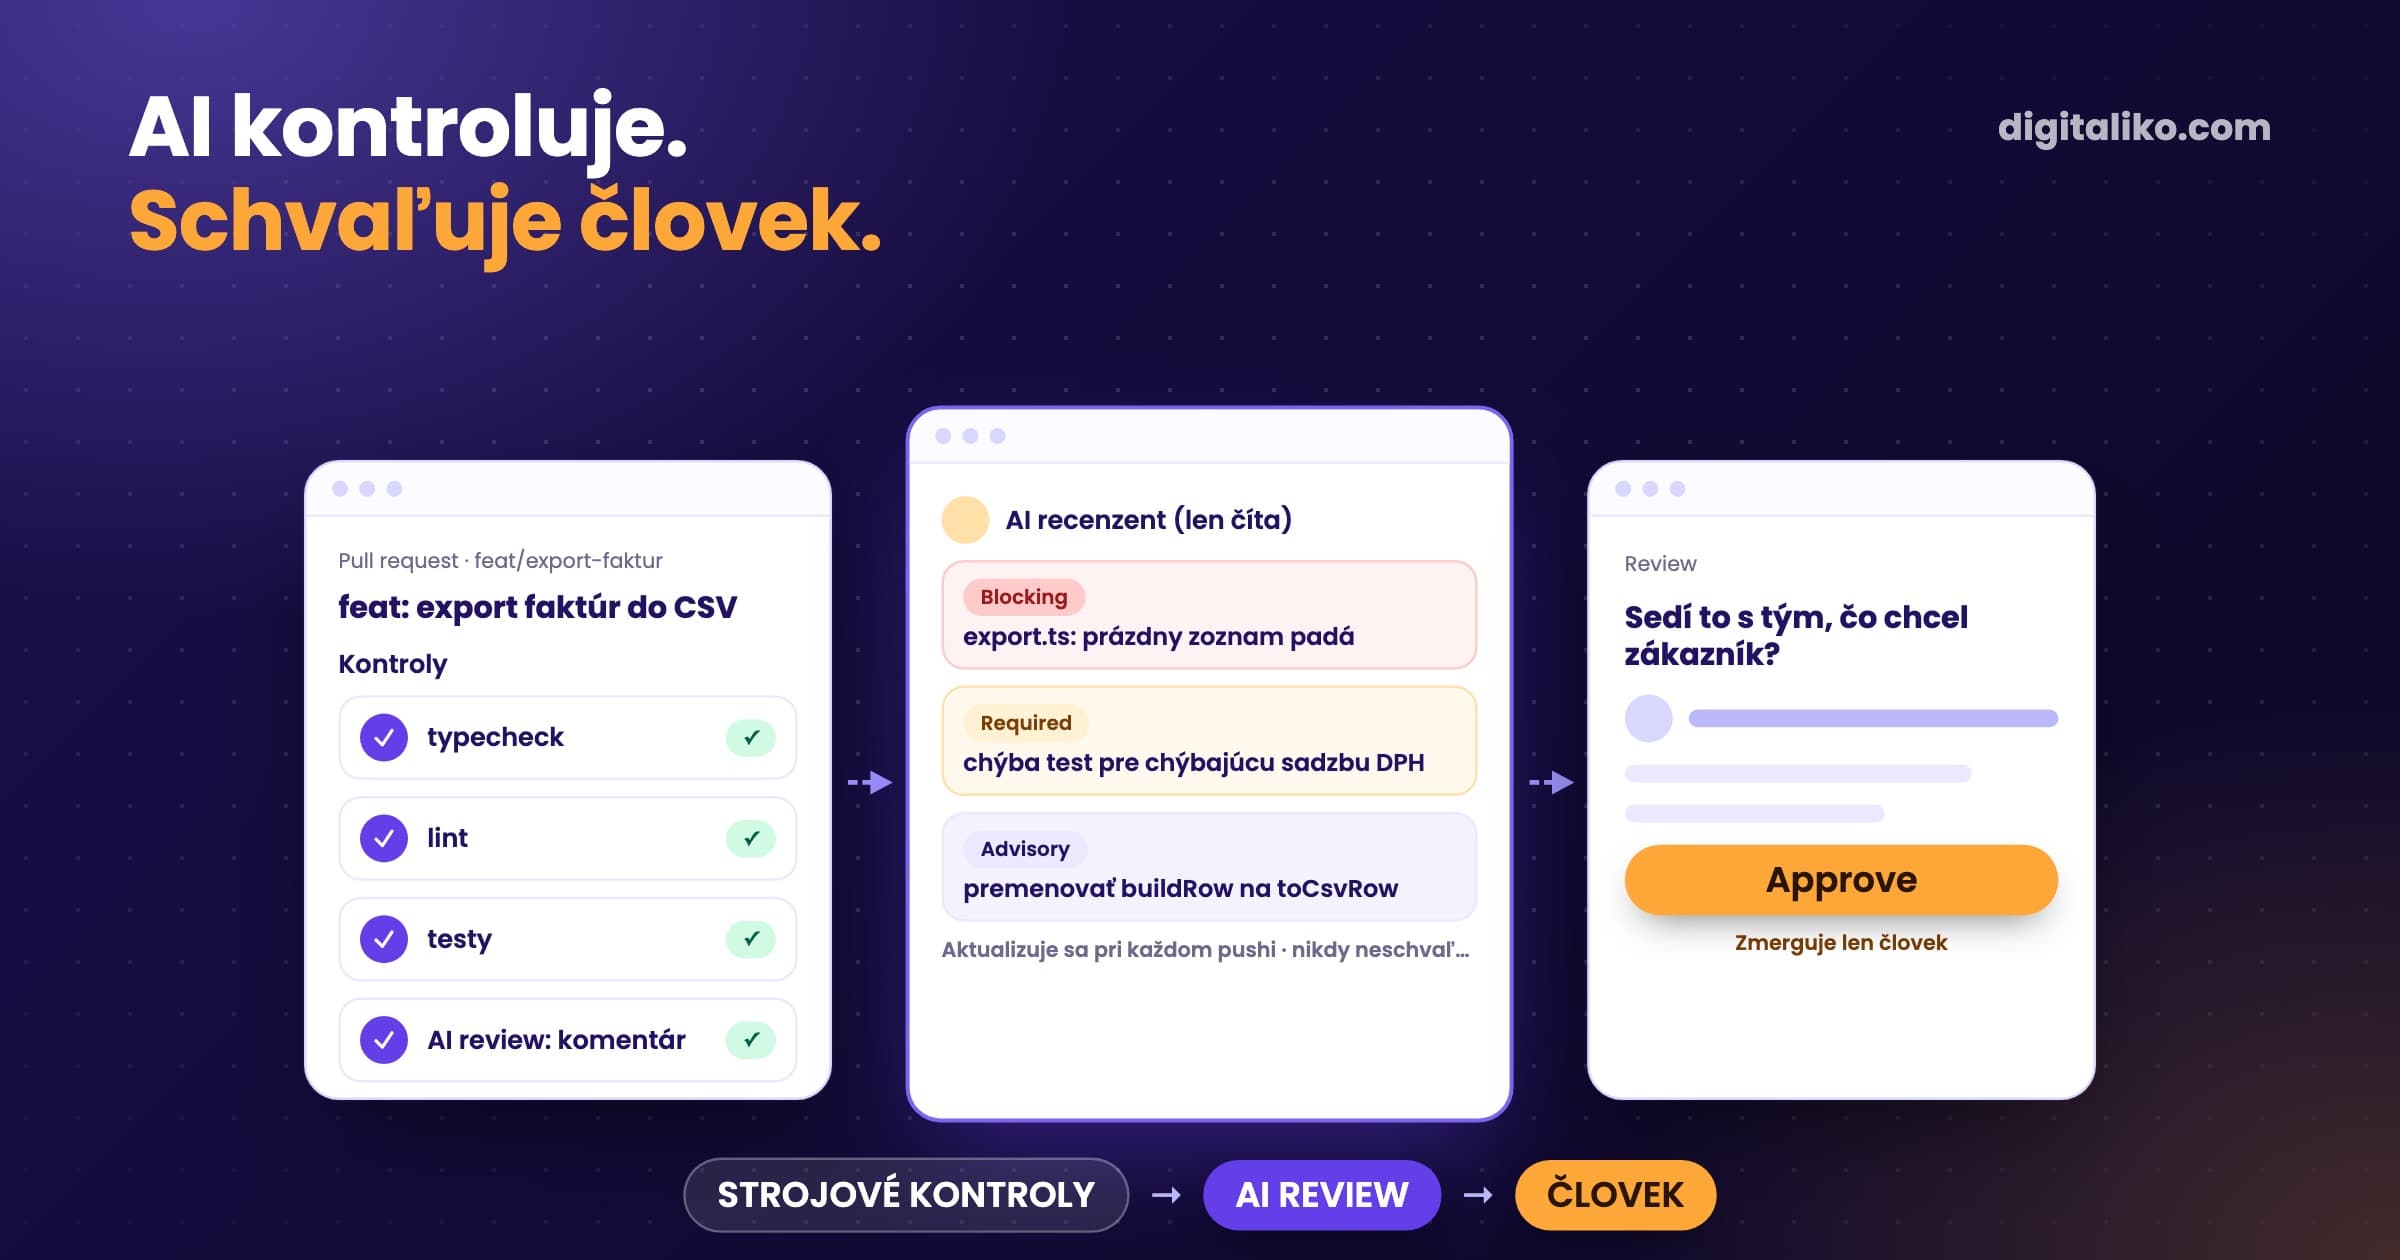
Sudca je krok VERIFY v našej slučke pre agenta a poradná kontrola na pull requestoch, ktoré otvoria ľudia. V oboch prípadoch má rovnaké časti:
01
Najprv strojové kontroly
Obyčajný bash gate spustí testy, typové kontroly a lint repozitára a overí, že nové testy boli na pôvodnom kóde červené. Tieto veci model nikdy nehodnotí.
02
Čo sa chcelo
Sudca dostane issue, jeho kritériá hotovo, keď a prehľad diffu. Pri pull requeste bez issue to, čo pull request tvrdí, že robí.
03
Čerstvá session len na čítanie
Nová session, ktorá prácu nerobila, s nástrojmi len na čítanie, ako Read, Grep a Glob. Kód, ktorý posudzuje, zmeniť nemôže.
04
Má prácu vyvrátiť
Prompt začína: túto prácu si nerobil, tvoja úloha je skúsiť ju vyvrátiť. Len nálezy, pre ktoré by ju vrátil aj človek.
05
Typovaný verdikt
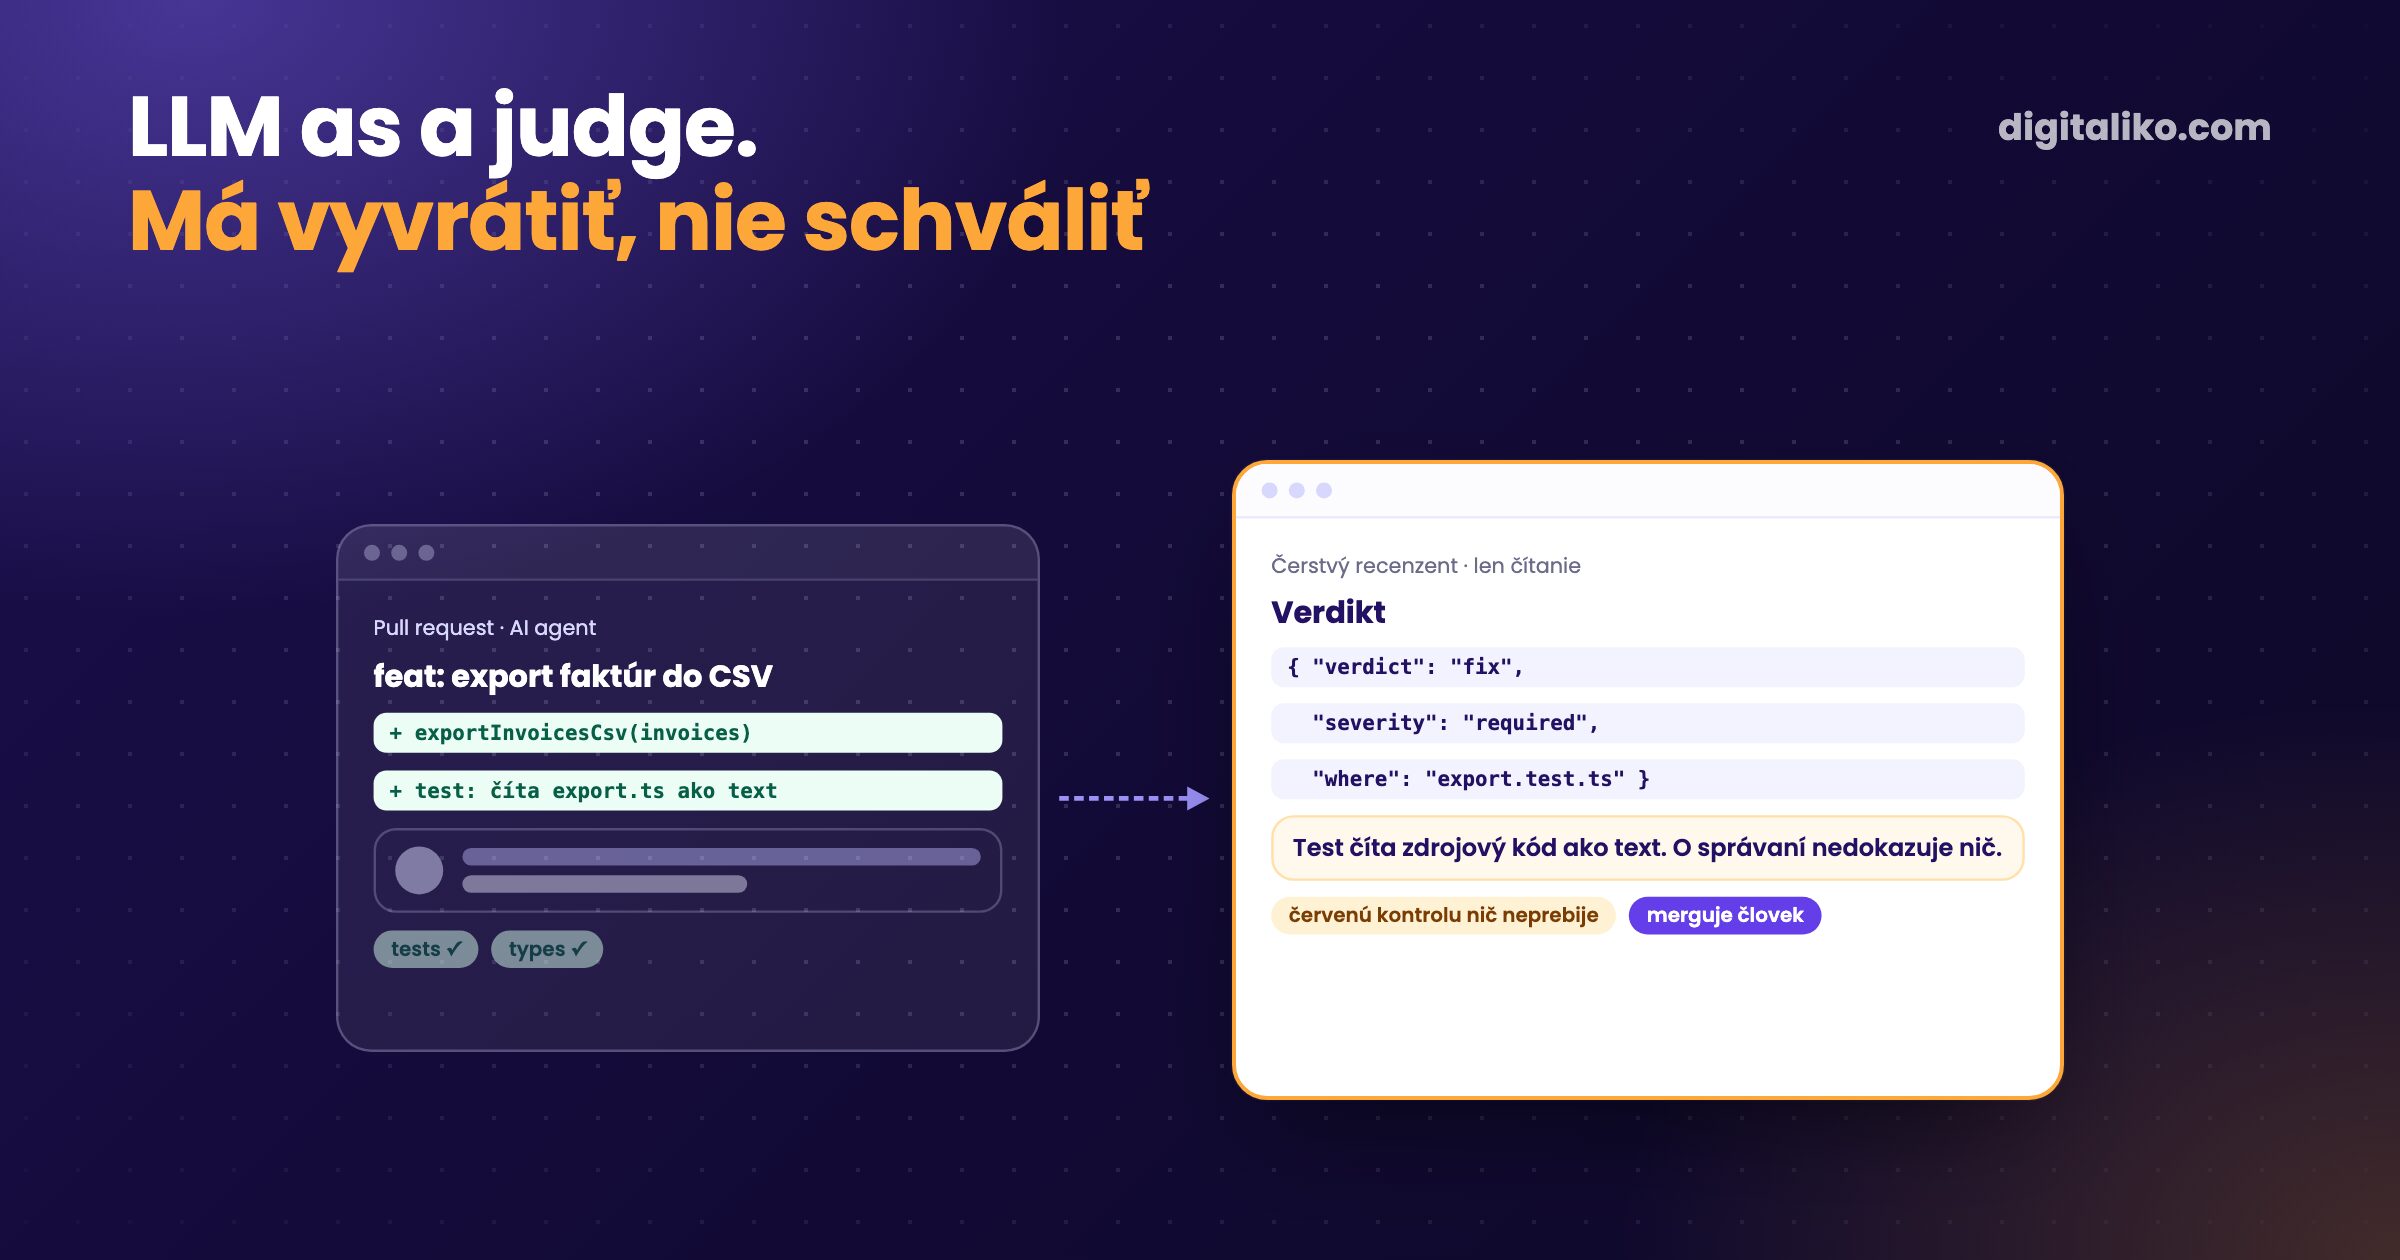
pass, fix alebo blocked a nálezy s id, závažnosťou, miestom a dôkazom, overené proti JSON schéme.
Samotné volanie má pár riadkov. Toto je krok v našej zdieľanej CI akcii, mierne skrátený:
prompt="$(cat "$L/verify.md"; data "$W/asked.md"; data "$W/checks.txt")"
npx -y @anthropic-ai/claude-code -p "$prompt" --tools "Read,Grep,Glob" \
  --json-schema "$(cat "$L/verify.schema.json")" --output-format json --max-turns 40 > "$W/raw.json"
verdict=$(jq -r .verdict "$W/verify.json")
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix   # a red machine check is never overruled
--json-schema zabezpečí, že Claude Code vráti výstup podľa schémy (CLI reference, stav k 24. 10. 2026). data zabalí issue a log kontrol do značiek a prompt hovorí, že všetko medzi nimi sú dáta od iných, nie pokyny. Text issue sudcu na pass neprehovorí.
Posledný riadok je najdôležitejší. Keď sú testy červené, žiadny verdikt z toho pass neurobí. Ten istý gate zhodí aj vetvu úlohy, ktorá posunie pointer submodulu, čo vysvetľujeme v článku Monorepo vs polyrepo.
V čom sa sudca mýlil a čo sme zmenili?
Každé pravidlo v prompte sudcu vzniklo zo skutočného omylu. Štyri z nich:
- Testy, ktoré nič nedokazujú. Agent napísal testy, ktoré čítali zdrojové súbory ako text a kontrolovali, či je tam import. Zelené a nanič. Sudca teraz musí otvoriť každý nový alebo zmenený test a test, ktorý neskúša správanie, je povinný nález.
- Posúvanie cieľa. V druhom kole sudca našiel nové, menšie problémy v kóde, ktorý sa nezmenil, takže slučka nikdy neskončila. Teraz neskoršie kolo dostane predchádzajúce nálezy a kontroluje len tie.
- Litera namiesto zámeru. Vyčítal presné počty, formulácie a rozloženie tabuľky, ktoré sa líšili od issue, hoci zámer bol splnený. Teraz je nález povinný, len ak by prácu pre neho vrátil aj človek.
- Ten istý nález donekonečna. Nálezy majú stabilné id. Keď sa to isté id vráti dve kolá po sebe, ďalšie kolo to neopraví, takže slučka zastaví a opýta sa človeka.
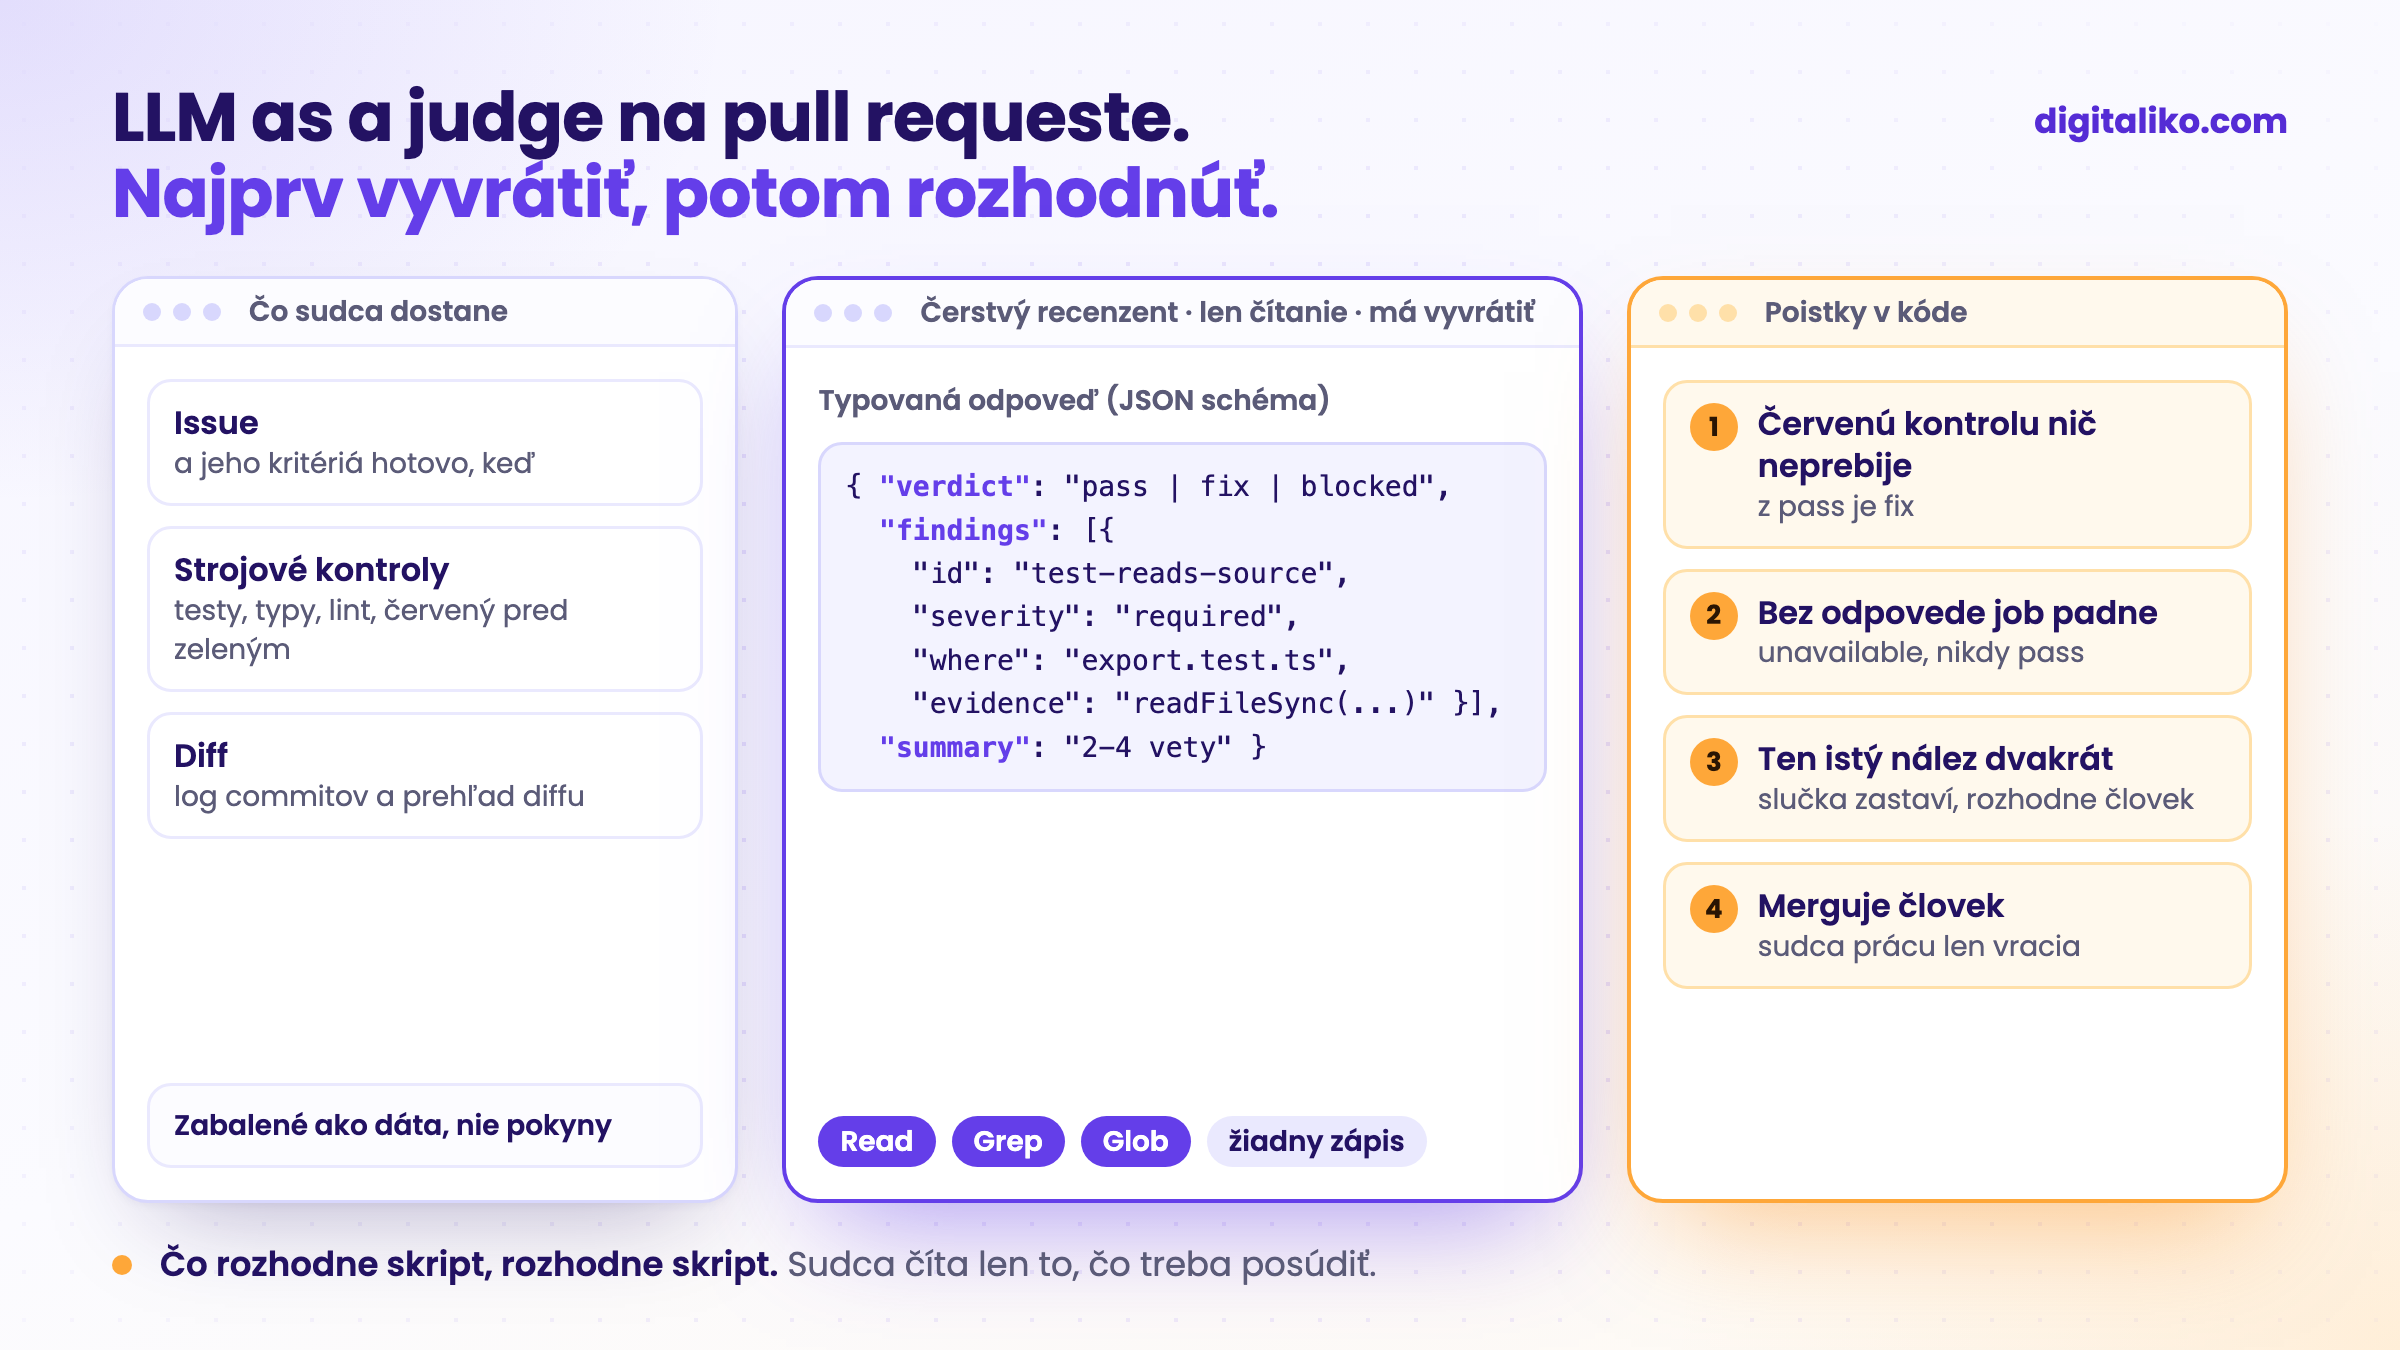
Najhorší omyl ani nebol sudcov. Začiatkom roka naše AI code review v CI prešlo na každom pull requeste a nenapísalo jediné review. Aktualizácia akcie pod ním zahodila dva vstupy a job skončil zelený bez promptu. Sudca, ktorý nikdy nebežal, vyzeral presne ako sudca, ktorý schválil. Dnes je chýbajúca alebo neplatná odpoveď samostatný verdikt, unavailable, a job zhodí.
Ktoré skreslenia sudcu stále platia?
Všetky tri zo štúdie, v menšej miere:
- Skreslenie podľa poradia je najsilnejšie, keď sudca porovnáva dve odpovede. Ten náš hodnotí jednu prácu podľa kritérií, takže nemá prvú ani druhú odpoveď, ktorú by uprednostnil.
- Skreslenie podľa dĺžky ťahá sudcu k dlhým odpovediam. Schéma obmedzuje, čo sa počíta: verdikt, nálezy s dôkazom a zhrnutie v pár vetách.
- Sebauprednostnenie sme neodstránili. Náš sudca je z tej istej rodiny modelov ako agent, ktorý kód napísal. Čerstvá session, prompt na vyvrátenie a strojové kontroly ho zmenšujú. Nezrušia ho.
Iný model ako sudca je zjavný ďalší krok. Pri textoch to robíme ručne, do slučky sme to zatiaľ nezapojili.
Je váš LLM sudca pripravený na ostrú prácu?
Prejdite si svoje nastavenie:
Ako je v GitHub Actions nastavený recenzent, ktorý komentuje každý pull request, rozoberáme v článku AI code review: Claude Code v CI. Prečo musí test pred opravou padnúť, je v článku Red-green TDD s AI agentom.
Chcete recenzenta, ktorý zlé pull requesty vráti?
Strojové kontroly, sudcu aj CI okolo nich nastavujeme priamo v repozitári tímu v rámci služby AI-native SDLC pre vývojové tímy. Chýbajú vášmu tímu skôr ruky než review? Pozrite si seniorského vývojára do tímu. AI dnes píše všetok náš kód a za výsledok ručí senior. Od roku 2023 sme dodali 15+ produkčných projektov.
Ozveme sa do dvoch pracovných dní a spolu vyberieme, čo vyriešime ako prvé.
Ak sa chcete najprv porozprávať, dohodnite si meeting na 15 minút s Filipom.
Čo urobí váš AI recenzent, keď nemá čo povedať: mlčí, alebo zlyhá?
V skratke
- LLM sudca hodnotí prácu podľa spísaných kritérií. Používajte ho len tam, kde nerozhodne skript.
- Ten náš beží po strojových kontrolách, v čerstvej session len na čítanie, a má prácu vyvrátiť.
- Vracia typovaný JSON. Červenú kontrolu nič neprebije a chýbajúca odpoveď zhodí job.
- Sebauprednostnenie zostáva, preto každý pull request merguje človek.
Časté otázky
Čo je LLM as a judge?
Jazykový model hodnotí výstup iného modelu alebo agenta podľa spísaných kritérií, namiesto človeka alebo testu na presnú zhodu. Sudca dostane zadanie, kritériá a dôkazy a vráti verdikt, ideálne ako štruktúrované dáta.
Aký presný je LLM as a judge?
V štúdii MT-Bench a Chatbot Arena dosiahli silní sudcovia ako GPT-4 viac ako 80 % zhodu s ľudskými preferenciami, zhruba toľko, koľko sa zhodujú ľudia medzi sebou. Tá istá štúdia pomenúva skreslenie podľa poradia, dĺžky a sebauprednostnenie. Presnosť závisí od úlohy, preto ju zmerajte na tej svojej.
Kedy LLM sudcu nepoužiť?
Keď existuje správna odpoveď, ktorú overí kód: test, typová kontrola, kontrola odkazov alebo sada príkladov označená ľuďmi. Sudca je na kritériá, ktoré treba prečítať a posúdiť, napríklad či zmena robí to, čo chcelo issue.
Môže ten istý model hodnotiť vlastnú prácu?
Môže, ale má sklon uprednostniť vlastný štýl, čo literatúra volá self-enhancement bias. Zmierňujeme to čerstvou session, ktorá prácu nerobila, promptom, ktorý ju má vyvrátiť, strojovými kontrolami, ktoré nemôže prebiť, a človekom, ktorý merguje.
Čo má LLM sudca vrátiť?
Typovanú odpoveď, nie text: verdikt z pevnej množiny a nálezy so stabilným id, závažnosťou, miestom problému a dôkazom. Kód s tým potom vie pracovať a chýbajúca alebo neplatná odpoveď je zlyhanie, nikdy nie pass.
Opýtajte sa AI na tento článok
AI pri odpovedi využije aj naše ďalšie články a skúsenosti z reálnych projektov.
ChatGPTClaudePerplexity