Context Engineering für Coding-Agenten: was ins Repo gehört
Für CTOs und EntwicklerHarness und Prüfungen

Filip PapranecGründer von Digitaliko
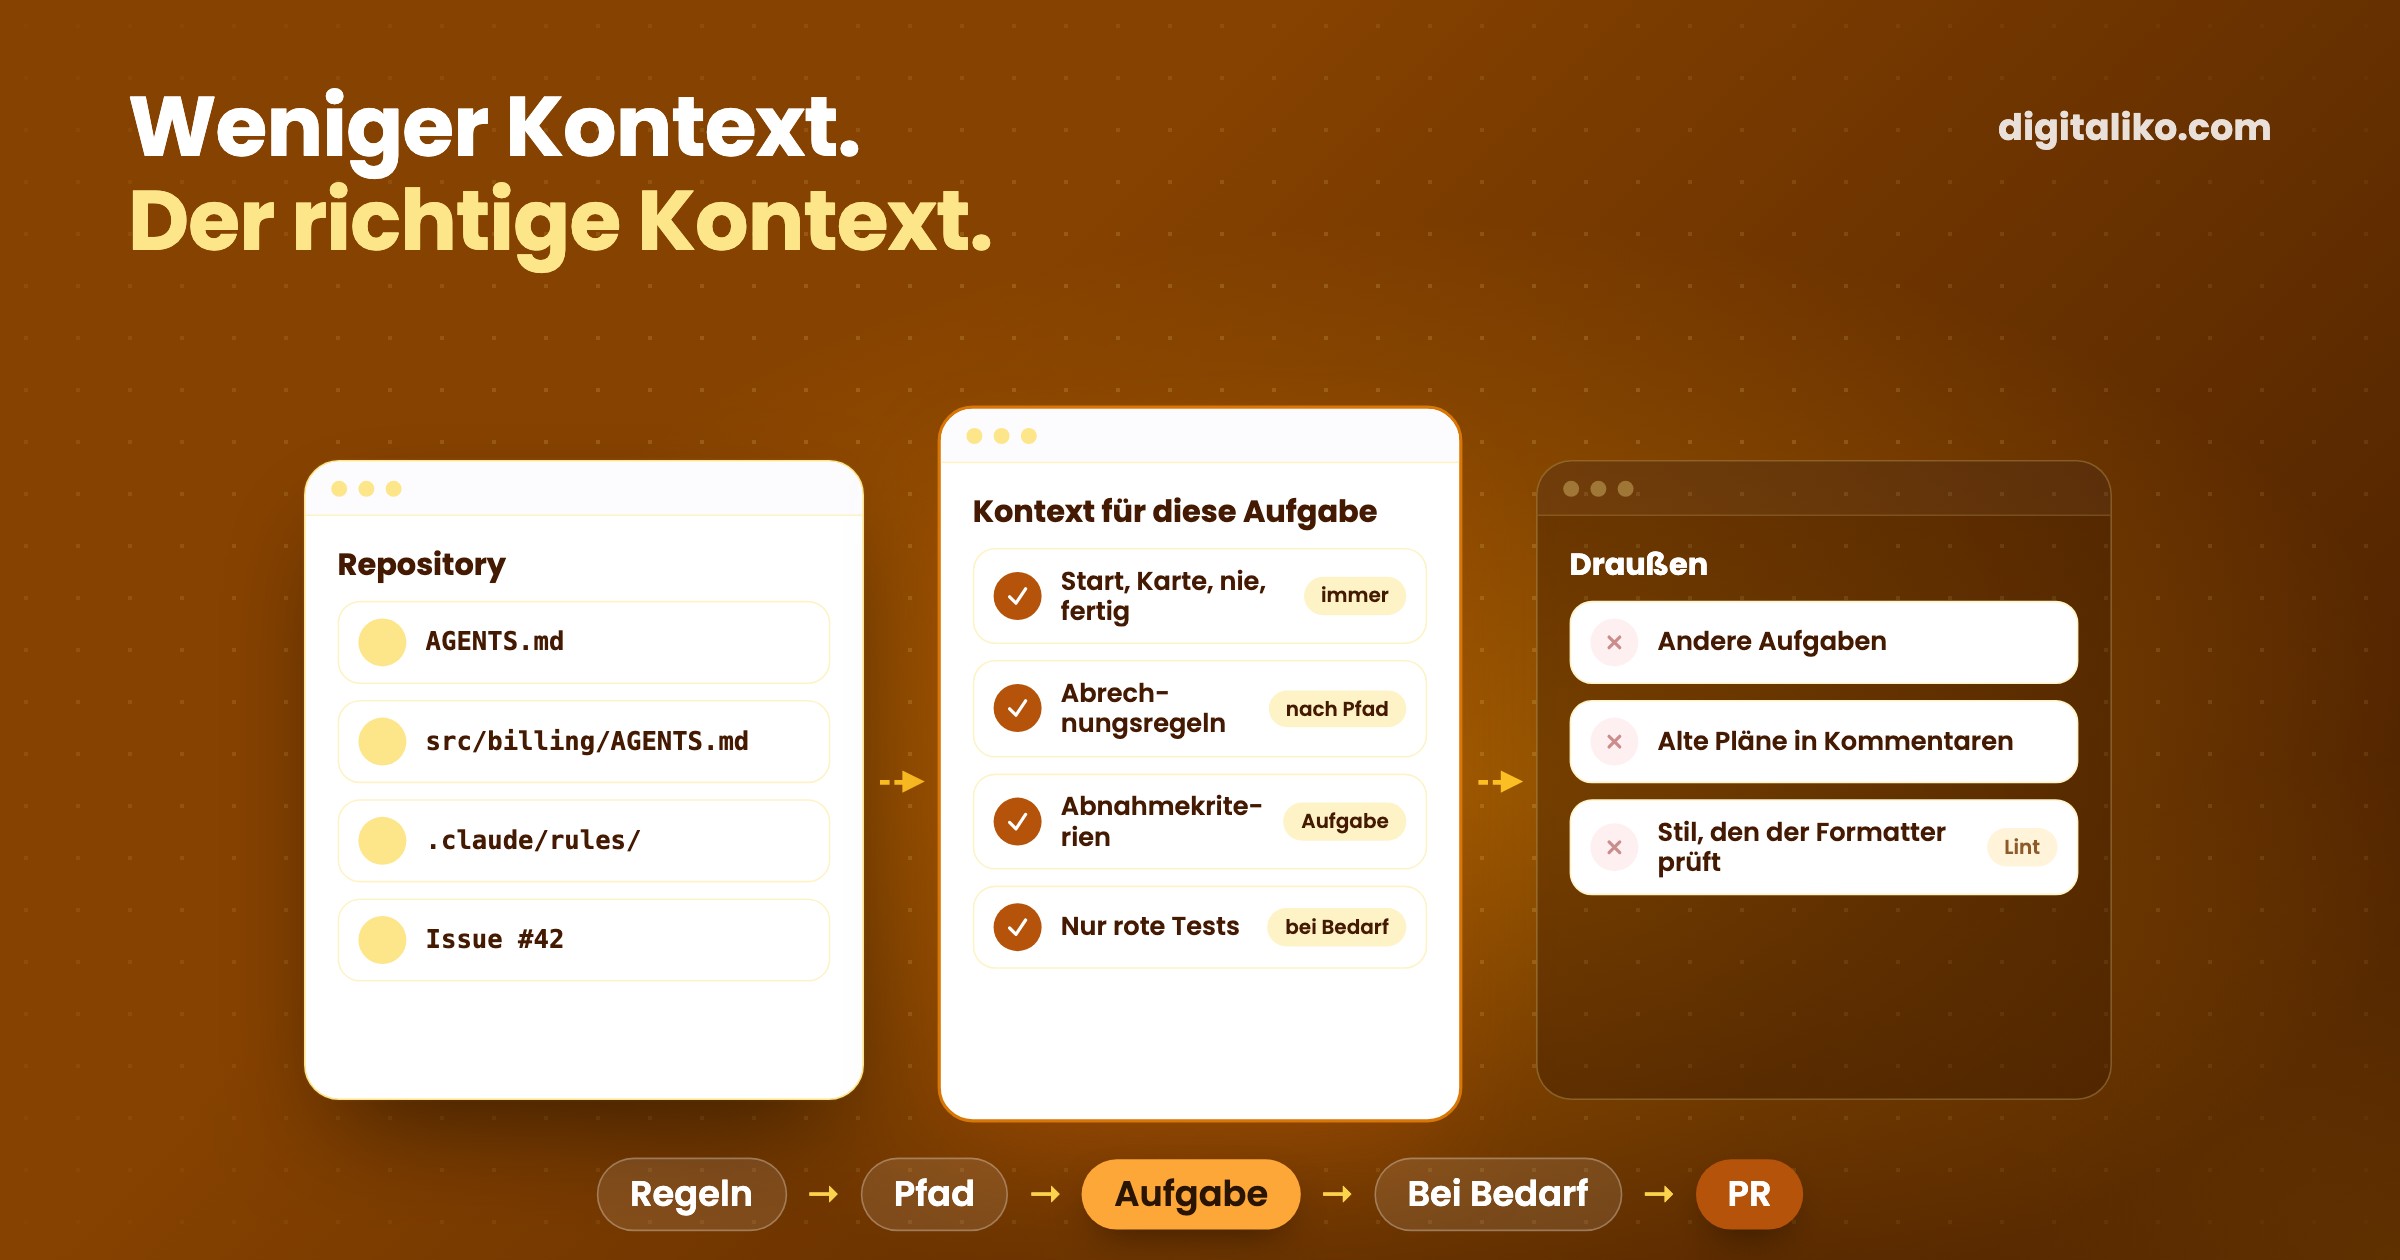
Context Engineering ist die Entscheidung, was ein KI-Coding-Agent vor und während der Arbeit sieht: die Regeldateien, die Aufgabe, den Code, den er öffnet, und die Ausgaben seiner Werkzeuge. Im Repository läuft das auf drei Dinge hinaus. Eine kurze Datei, die immer lädt (AGENTS.md oder CLAUDE.md), Regeln, die nur dort laden, wo sie gelten, und eine schriftliche Aufgabe mit Abnahmekriterien. Alles andere soll der Agent holen, wenn er es braucht, nicht von Anfang an mitschleppen.
Code schreibt bei uns vor allem KI. Jede Änderung prüft ein Senior, der für das einsteht, was in Produktion geht. Unten steht, was in welche Schicht gehört, mit allgemeinen Beispielen zum Kopieren, wie wir den Kontext klein halten und was wir gestrichen haben, weil es den Agenten schlechter machte.
Good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.
Was ist Context Engineering?
Ein Modell weiß nur, was bei diesem Aufruf in seinem Kontextfenster steht. Bei einem Coding-Agenten füllt sich das Fenster schnell: der System-Prompt, die Regeldateien, die Aufgabe, jede gelesene Datei, jeder ausgeführte Befehl und die Ausgabe, die zurückkommt.
Das Fenster ist ein Budget, kein Mülleimer. Anthropic beschreibt Context Rot: Je größer der Kontext, desto schlechter erinnert sich das Modell an das, was darin steht. Eine Regel in Zeile 400 einer langen Datei ist technisch da und praktisch weg.
Context Engineering besteht also vor allem aus zwei Entscheidungen. Was standardmäßig hineinkommt. Und was draußen bleibt, bis der Agent danach fragt.
Kontext, Prompt oder Spezifikation: was ist der Unterschied?
Die drei Begriffe werden oft verwechselt. Sie beschreiben verschiedene Schichten derselben Sache.
| Prompt | Kontext | Spezifikation | |
|---|---|---|---|
| Was es ist | Eine Nachricht an das Modell | Alles, was das Modell für die Aufgabe sieht | Der Teil des Kontexts, der sagt, was fertig bedeutet |
| Wer es schreibt | Wer fragt | Das Team, der Harness und die Werkzeuge | Wem die Aufgabe gehört |
| Wo es lebt | Im Chat | Dateien im Repository, Werkzeugausgaben, Verlauf | Im Issue oder einem verlinkten Dokument |
| Wie lange es lebt | Eine Runde | Eine Session | Bis die Aufgabe gemergt ist |
| Was schiefgeht | Vage Formulierung | Zu viel, veraltet oder widersprüchlich | Fehlende Abnahmekriterien |
Die Spezifikation verdient einen eigenen Artikel, und sie hat einen: Spec-driven Development mit KI-Agenten. Hier bleiben wir beim Repository: was darin liegt, damit jede Session des Agenten mit dem richtigen Kontext startet.
Was gehört in die Datei, die immer lädt?
AGENTS.md (bei Claude Code CLAUDE.md) lädt bei jeder Aufgabe. Damit ist sie der teuerste Text im Repository. Hinein gehört nur, was der Agent nicht aus dem Code ablesen kann.
Ein allgemeines Beispiel, das die meisten Repositories abdeckt:
# AGENTS.md

## Run
- Install: `pnpm install`
- Check everything: `pnpm check` (typecheck, lint, tests)
- One test file: `pnpm test path/to/file.test.ts`

## Map
- `src/billing/` holds the invoice rules. It has its own AGENTS.md.
- `src/generated/` is generated. Never edit it by hand.
- Tests sit next to the code as `*.test.ts`.

## Never
- Touch the production database or `.env*` files.
- Change a migration that is already merged. Add a new one.
- Push to `main`. Open a pull request.

## Done means
- `pnpm check` is green.
- New behaviour has a test that failed before the change.
- The PR says what changed and how it was checked.
Vier Überschriften: wie man es startet, wo was liegt, was verboten ist, was fertig bedeutet. Nutzt Ihr Team Claude Code neben anderen Werkzeugen, halten Sie eine Datei. Das aktuelle Claude Code liest AGENTS.md direkt, und wo nicht, importiert sie eine CLAUDE.md mit der einen Zeile @AGENTS.md.
Was nicht hineingehört: Stil, den der Formatter schon prüft, Architektur-Essays, die Geschichte einer Entscheidung und Regeln, die nur in einem Ordner gelten. Wie man entscheidet, wohin welche Regel gehört und welche besser Lint als Text ist, steht in CLAUDE.md und AGENTS.md: Regeln für KI-Code im Team.
Wie laden Regeln nur dort, wo sie gelten?
Über die Ordnerstruktur. Eine Regel, die nur für die Abrechnung gilt, soll nichts kosten, während der Agent die Login-Seite bearbeitet.
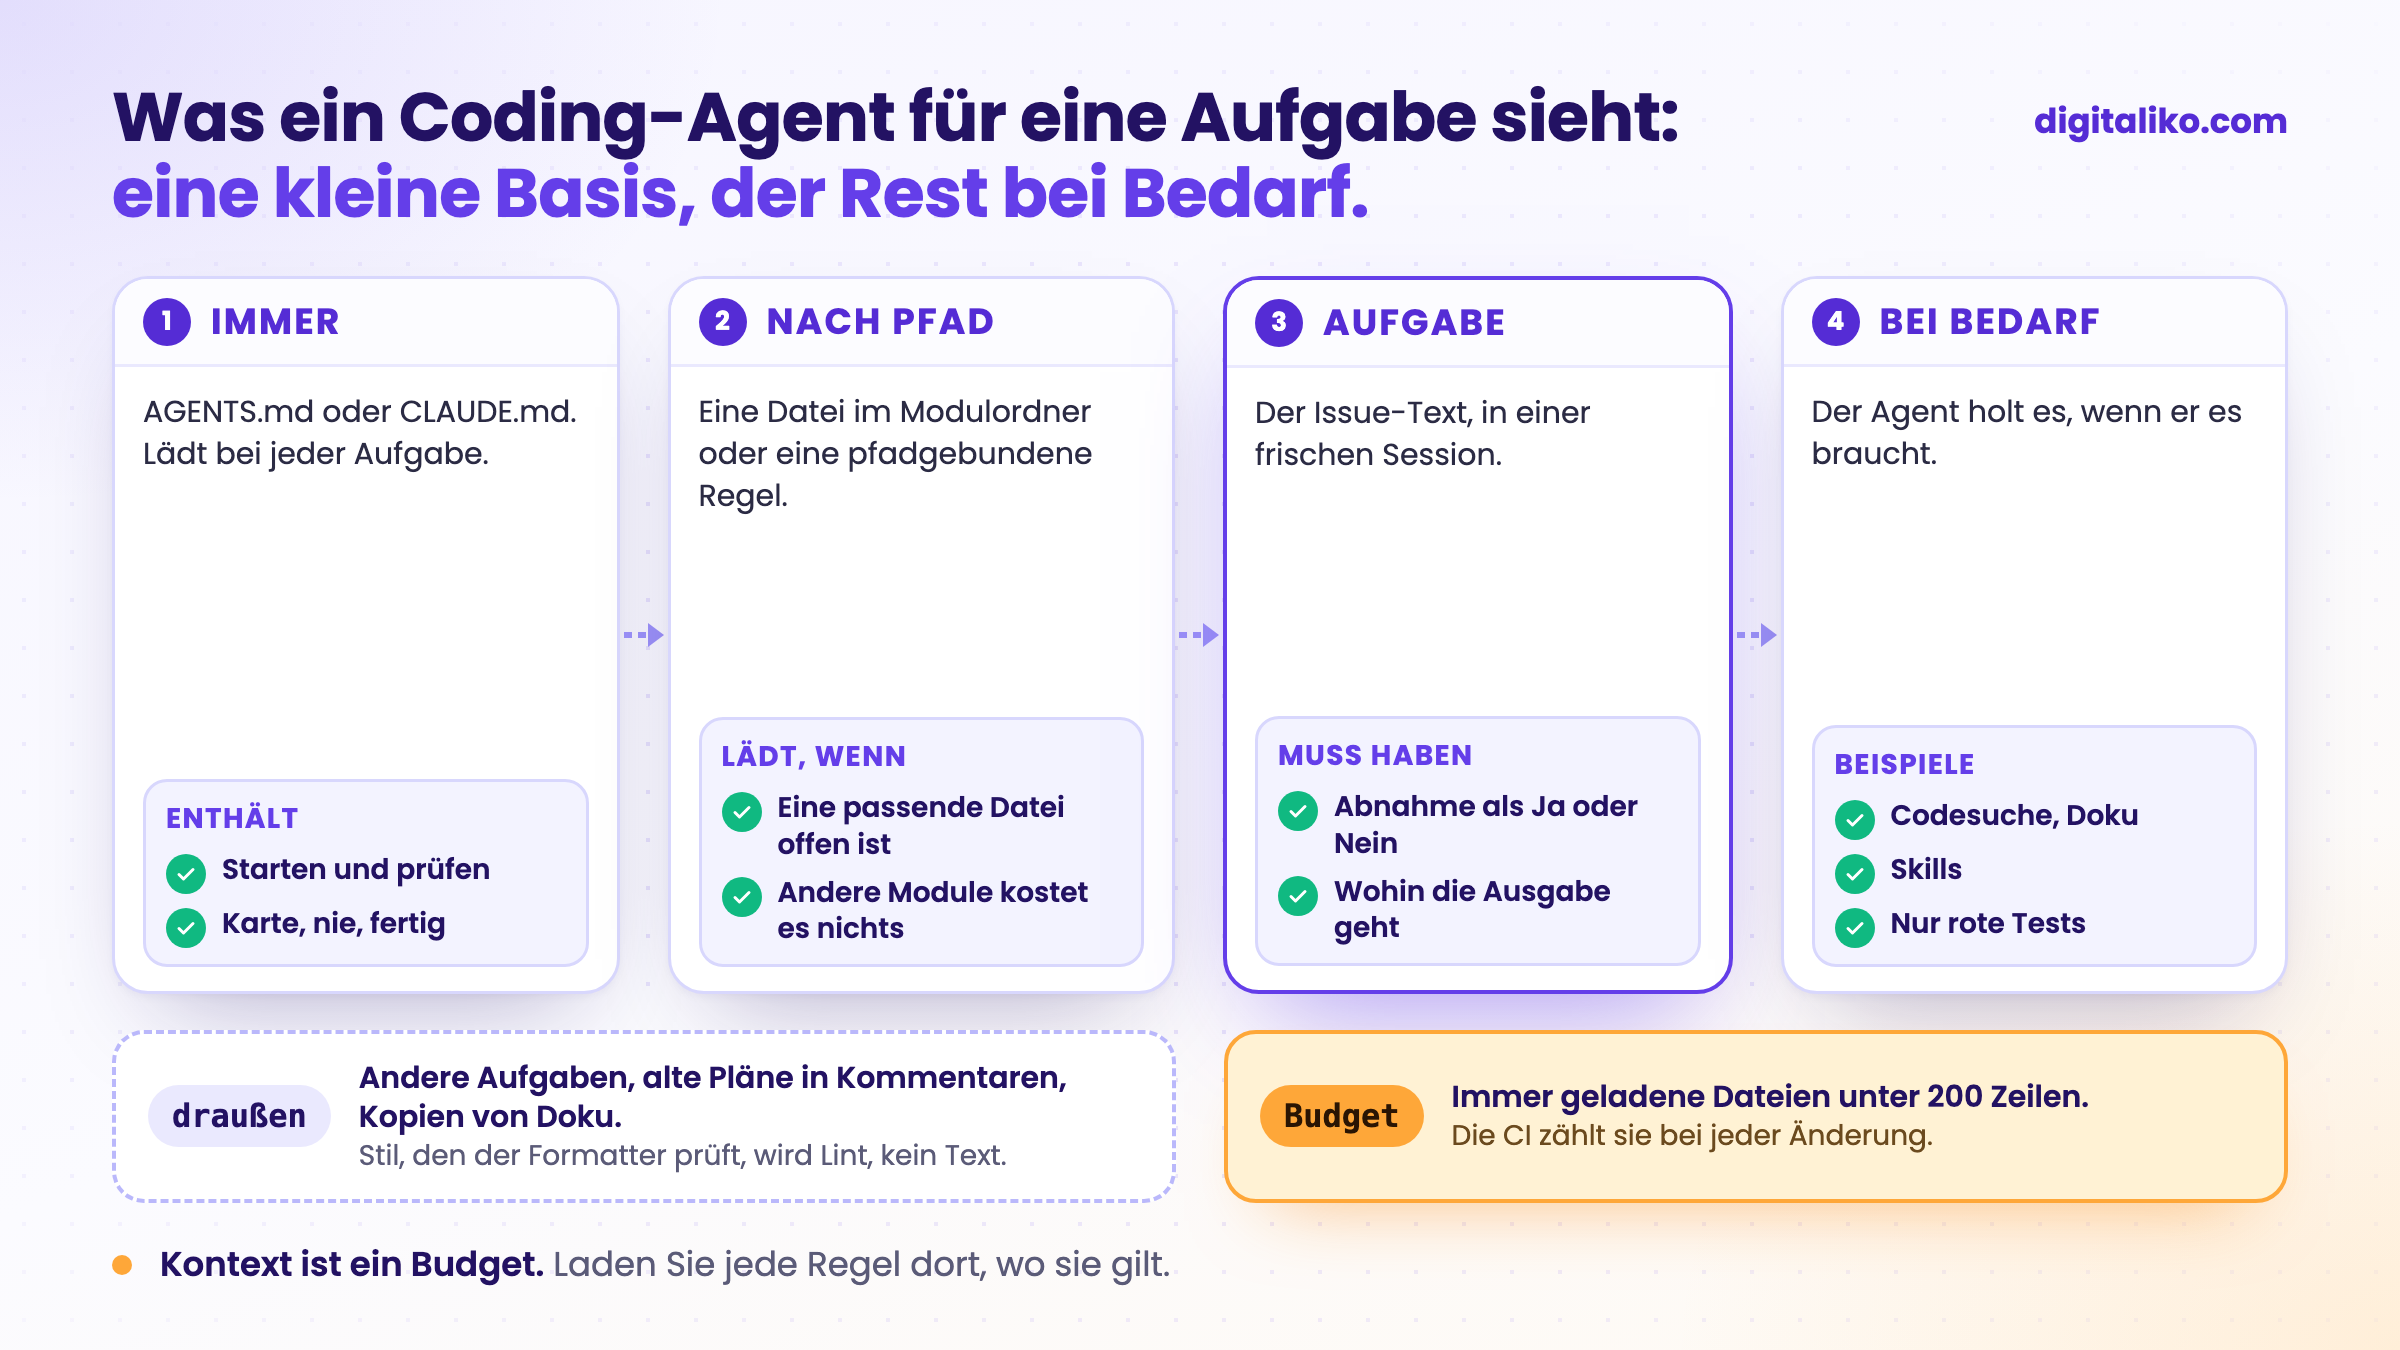
Es gibt drei Mechanismen, und sie greifen in dieser Reihenfolge:
- Eine Datei im Modulordner.
src/billing/AGENTS.mdodersrc/billing/CLAUDE.md. Claude Code lädt sie bei Bedarf, sobald der Agent eine Datei in diesem Ordner liest oder bearbeitet. - Pfadgebundene Regeln. Eine Regeldatei unter
.claude/rules/mit einem Feldpathsim Frontmatter lädt nur, wenn der Agent eine passende Datei anfasst:
---
paths:
  - "src/billing/**/*.ts"
---

# Billing rules
- Money is integer cents. Never floats.
- Every price change writes an audit row.
- Skills und verlinkte Dokumente. Ein Ablauf wie „so schreiben wir eine Migration“ lebt in einem Skill oder Dokument. Der Agent sieht eine einzeilige Beschreibung und lädt den Inhalt nur, wenn die Aufgabe ihn braucht.
Eine Falle: Ein @path-Import spart keinen Kontext. Die importierte Datei lädt zusammen mit der Datei, die sie importiert. Importe halten eine lange Datei übersichtlich. Kürzer machen sie sie nicht.
Was sieht der Agent für eine Aufgabe?
Bei uns heißt eine Aufgabe: ein GitHub-Issue, eine frische Session, ein Pull Request. So wird der Kontext für diese Session zusammengesetzt.
01
Eine frische Session
Kein Verlauf aus anderen Aufgaben. Jedes Issue startet sauber in seinem eigenen Worktree.
02
Die Datei, die immer lädt
Start, Karte, nie, fertig. Kurz genug, um sie in einer Minute zu lesen.
03
Die Aufgabe
Der Issue-Text: was sich ändern soll, Abnahmekriterien, wohin die Ausgabe geht.
04
Regeln nach Pfad
Modulregeln laden erst, wenn der Agent Dateien in diesem Modul öffnet.
05
Bei Bedarf geholt
Codesuche, Doku, Skills und Testausgaben, wenn der Agent sie braucht.
Die Aufgabe ist der Teil, den Teams unterschätzen. Ein minimales Issue, das ein Agent abschließen kann:
## What
Add CSV export to the invoice list.

## Acceptance
- An empty list exports the header row only.
- Totals in the file match the invoice detail.

## Output
One PR with a test that fails on main and passes on the branch.
Zwei weitere Regeln lohnen sich in jeder Schleife. Text von außen, etwa Issue-Kommentare und eingefügte E-Mails, erreicht das Modell als Daten markiert, nicht als Anweisungen. Und der Reviewer bekommt einen eigenen frischen Kontext mit Werkzeugen nur zum Lesen. Er sieht die Aufgabe, den Diff und die Prüfungen, nicht die Überlegungen des Agenten, der den Code geschrieben hat. Genau darum geht es: Er beurteilt das Ergebnis, nicht die Geschichte. Mehr dazu in Harness Engineering in der Praxis.
Wie bleibt der Kontext klein?
Den meisten Kontext fügt niemand absichtlich hinzu. Er sammelt sich an. Diese Gewohnheiten halten ihn im Zaum:
- Verweise statt Kopien. „API-Regeln stehen in
docs/api.md“ kostet eine Zeile. Das eingefügte Dokument kostet hundert und veraltet. - Ein Budget, das der Build prüft. „Fasst euch kurz“ hält etwa zwei Wochen. Eine Zeilenzählung in der CI hält.
- Eine Aufgabe pro Session. Eine lange Session schleppt jede frühere Aufgabe in die nächste. Eine frische Session ist billiger als eine Zusammenfassung.
- Suchen in einem Subagenten. Ein Nebenagent liest zwanzig Dateien und gibt zehn Zeilen zurück. Die Hauptsession bekommt die Antwort, nicht die Suche.
- Kurze Werkzeugausgaben. Ein Test-Runner, der nur Fehler ausgibt, liefert dem Agenten, was er braucht. Zweitausend Zeilen bestandener Tests liefern Rauschen.
Eine Budgetprüfung hat ein paar Zeilen. Anthropic empfiehlt unter 200 Zeilen pro CLAUDE.md:
# fail CI when the always-loaded agent files grow past the budget
total=$(cat AGENTS.md CLAUDE.md 2>/dev/null | wc -l)
[ "$total" -le 200 ] || { echo "Agent context: $total lines (max 200)"; exit 1; }
Unsere Prüfung zählt die Datei im Root und alle Regeln, die ohne Bedingung laden, zusammen, deshalb liegt ihre Grenze bei 300 Zeilen, nicht 200. Sie läuft in unseren Repositories in der CI. Wie das in das Setup eines Teams passt, steht in Claude Code Best Practices fürs Team.
Was haben wir aus dem Kontext gestrichen?
Mehr, als wir hinzugefügt haben. Am meisten halfen Löschungen:
- Alte Pläne in Issue-Kommentaren. Unsere Bereitschaftsprüfung las den ganzen Issue-Verlauf. Ein veralteter Plan in einem Kommentar brachte sie dazu, Issues zu widerlegen, die in Ordnung waren. Heute zählt nur der Issue-Text als Aufgabe. Veralteter Kontext ist schlimmer als keiner.
- Kopien der Regeln. In mehrere Repositories kopierte Regeln liefen innerhalb weniger Wochen auseinander. Heute laden sie überall aus einer versionierten Quelle.
- Abläufe in der Datei im Root. Lange Anleitungen wanderten in Skills, die nur bei Bedarf laden. In der Datei blieb nur Text, der für jede Aufgabe gilt.
- Die wichtigsten Regeln als Text. Die entscheidenden wurden zu Lint, Tests und Hooks. Sie müssen gar nicht mehr im Kontext stehen, weil sie eine schlechte Änderung selbst stoppen.
Einen Text kann der Agent auslegen, wie er will. Eine Prüfung nicht.

Mit dem letzten Punkt endet Context Engineering. Kontext macht den richtigen Weg wahrscheinlich. Prüfungen machen den falschen Weg unmöglich. Sie brauchen beides.
Ist der Kontext in Ihrem Repository in Ordnung?
Wollen Sie das in Ihrem Repository eingerichtet haben?
Regeldateien, pfadgebundene Regeln, das Issue-Format und die Prüfungen richten wir direkt im Repository eines Teams ein, als Teil von AI-native SDLC für Entwicklerteams. Seit 2023 haben wir 15+ Produktionsprojekte geliefert. Ein Senior steigt vom ersten Tag an in Ihr Repository und Ihre Pull Requests ein.
Wir melden uns innerhalb von zwei Arbeitstagen mit ein paar Fragen zu Ihrer Arbeit. Danach bekommen Sie eine Liste: was fertig wird und wie Sie es prüfen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-minütiges Erstgespräch.
Was liest Ihr Agent heute zuerst, und wann hat zuletzt jemand eine Zeile daraus gelöscht?
Kurz gesagt
- Context Engineering entscheidet, was ein Coding-Agent sieht: Regeldateien, die Aufgabe, die Dateien, die er öffnet, und Werkzeugausgaben.
- Die AGENTS.md oder CLAUDE.md, die immer lädt, hat vier Teile: Start, Karte, nie, fertig. Unter 200 Zeilen.
- Modulregeln laden nur dort, wo sie gelten: eine Datei im Ordner oder eine pfadgebundene Regel.
- Eine Aufgabe pro frischer Session, mit schriftlicher Aufgabe und Abnahmekriterien.
- Mehr Kontext ist nicht besser. Löschen Sie veralteten Text und machen Sie die wichtigsten Regeln zu Prüfungen.
Häufige Fragen
Was ist Context Engineering?
Die Entscheidung, was ein KI-Modell sieht, während es arbeitet: Anweisungen, Regeldateien, die Aufgabe, die Dateien, die es öffnet, Ausgaben von Werkzeugen und den Verlauf. Bei einem Coding-Agenten liegt der Großteil davon im Repository, Context Engineering ist also vor allem Arbeit am Repository.
Was ist der Unterschied zwischen Context Engineering und Prompt Engineering?
Prompt Engineering feilt an einer Nachricht. Context Engineering steuert alles andere, was das Modell über eine ganze Aufgabe sieht: welche Regeln laden, welche Dateien es liest, was ein Werkzeug zurückgibt und was wegfällt. Ein guter Prompt rettet keinen Agenten, der Ihre Konventionen nie sieht.
Was gehört in AGENTS.md oder CLAUDE.md?
Was der Agent nicht aus dem Code ablesen kann: wie man das Projekt startet und prüft, wo was liegt, was er nie tun darf und was fertig bedeutet. Halten Sie die Datei kurz, sie lädt bei jeder Aufgabe. Regeln eines Moduls gehören in dieses Modul, nicht in die Datei im Root.
Ist mehr Kontext für einen Coding-Agenten besser?
Nein. Jede Zeile konkurriert um die Aufmerksamkeit des Modells, und mit wachsendem Kontext erinnert es sich schlechter. Geben Sie dem Agenten eine kleine, relevante Basis und lassen Sie ihn den Rest holen, wenn er ihn braucht.
Wie hängt Context Engineering mit einer Spezifikation zusammen?
Die Spezifikation ist der Teil des Kontexts, der sagt, was fertig bedeutet. Bei uns ist das das Issue: was sich ändern soll, Abnahmekriterien und wohin die Ausgabe geht. Ohne sie bringt mehr Kontext nur ein selbstsichereres falsches Ergebnis.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity

