Monorepo czy polyrepo: dlaczego używamy obu
Dla CTO i programistówDecyzje CTO

Filip PapranecZałożyciel Digitaliko
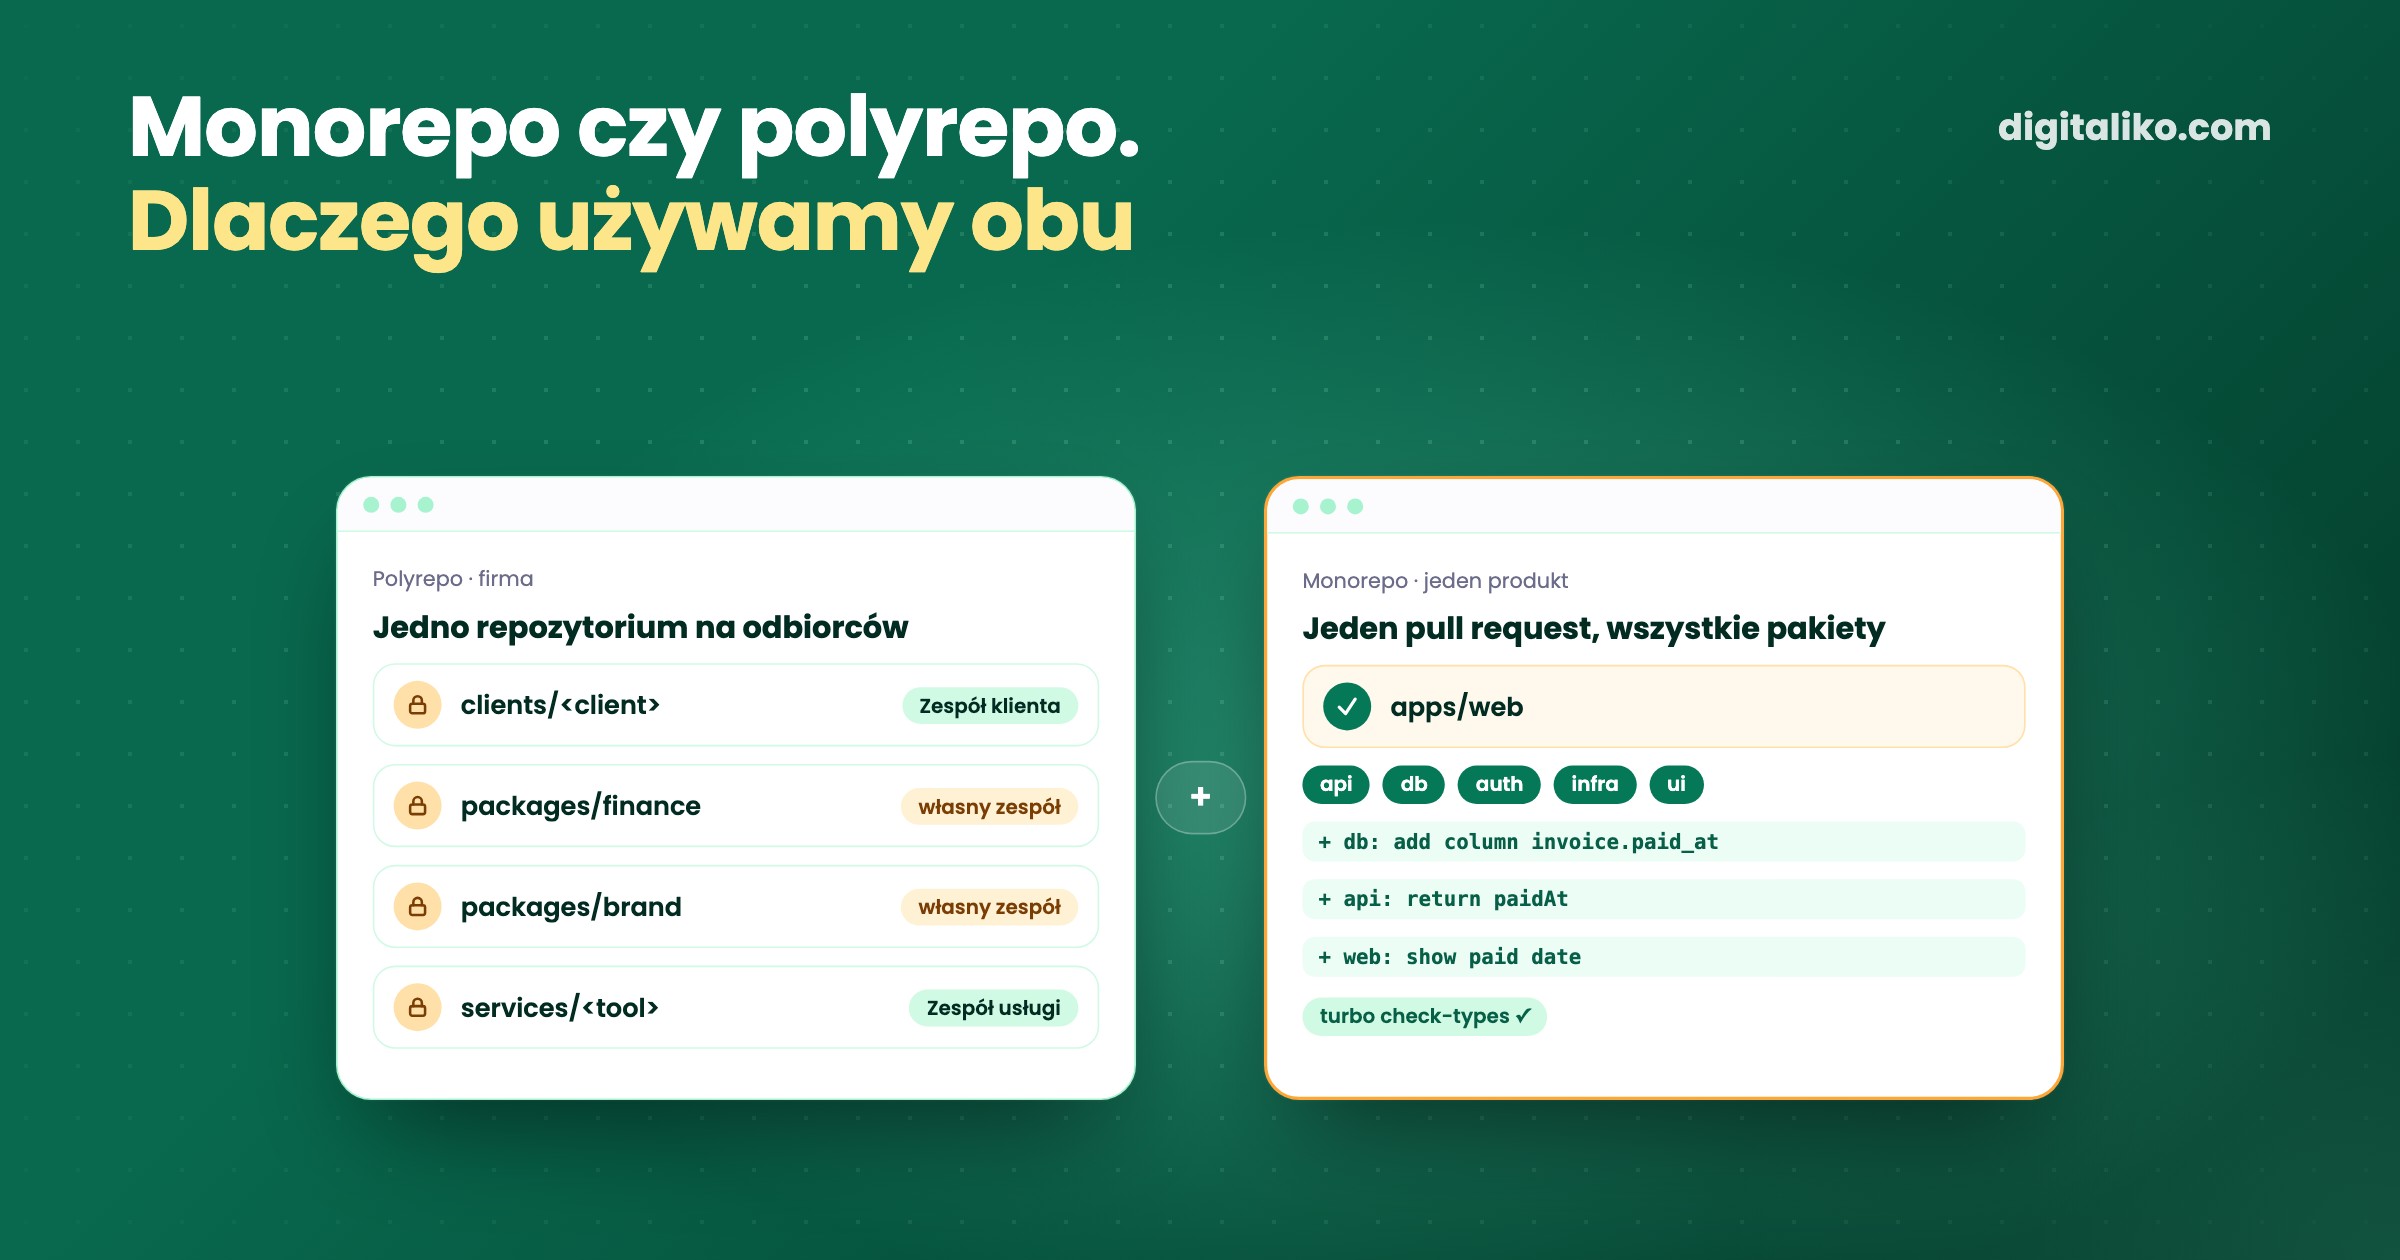
Monorepo czy polyrepo to pytanie o to, jakiej granicy Państwo potrzebują. Monorepo umieszcza wiele pakietów w jednym repozytorium, więc jedna zmiana może przejść przez wszystkie. Polyrepo daje każdemu projektowi własne repozytorium, więc każdy może mieć własny dostęp, własne CI i własny release.
Używamy obu celowo. Każdy produkt, który budujemy, to monorepo na Turborepo. Sama firma to polyrepo: każdy klient, każda usługa i każdy poufny obszar to osobne repozytorium, połączone przez git submodules. Agent AI pracuje w obu codziennie.
Jaka jest różnica między monorepo a polyrepo?
W skrócie: monorepo wyznacza granicę kodu wokół pakietów, polyrepo wyznacza granicę dostępu wokół repozytoriów.
| Monorepo | Polyrepo | |
|---|---|---|
| Jedna zmiana w wielu częściach | Jeden commit, jeden pull request | Jeden pull request na repozytorium |
| Wspólny kod | Pakiet z workspace, importowany bezpośrednio | Opublikowany pakiet albo kopia |
| Kto może czytać co | Każdy z dostępem widzi wszystko | Dostęp per repozytorium |
| CI | Jeden pipeline, narzędzie do buildu pomija to, co się nie zmieniło | Jeden pipeline na repozytorium |
| Wersje zależności | Jeden lockfile, jedna wersja na pakiet | Każde repozytorium rozjeżdża się samo |
| Kontekst dla agenta AI | Cały system w jednym checkoucie | Tylko to, czego potrzebuje zadanie, reszta przez nawigację |
Większość artykułów na ten temat broni jednej kolumny. Naszym zdaniem obie mają rację, dla różnych jednostek. Pytanie brzmi, wokół czego wyznaczają Państwo granicę.
Dlaczego każdy produkt to monorepo?
Produkt to kod, który jest wydawany razem. Nasz szablon i wizrd, nasz wewnętrzny plugin i CLI do Claude Code (niepubliczny), wyglądają tak samo: jedna aplikacja i pakiety, z których się składa.
{
  "packageManager": "bun@1.3.13",
  "workspaces": {
    "packages": ["apps/*", "packages/*"],
    "catalog": { "zod": "^4.1.13", "typescript": "^6", "better-auth": "1.5.5" }
  },
  "scripts": { "build": "turbo build", "check-types": "turbo check-types", "deploy": "turbo -F @wizrd/infra deploy" }
}
apps/web to aplikacja. packages/ zawiera api, db, auth, infra, ui, env i kilka innych. Aplikacja importuje je jako workspace:*, więc nie ma czego publikować. catalog raz przypina wspólne wersje, więc API i aplikacja nigdy nie działają na dwóch różnych wersjach tej samej biblioteki.
Na wierzchu siedzi Turborepo z krótkim turbo.json:
{
  "tasks": {
    "build": { "dependsOn": ["^build"], "outputs": ["dist/**"] },
    "check-types": { "dependsOn": ["^check-types"] },
    "dev": { "cache": false, "persistent": true },
    "deploy": { "cache": false }
  }
}
^build oznacza: najpierw zbuduj to, od czego zależę. Buildy, sprawdzanie typów i lint są cache’owane. Deploye i zmiany w bazie danych nigdy. Cache to powód, który dokumentacja Turborepo podaje jako sens jego używania:
Turborepo uses caching to speed up builds, ensuring you never do the same work twice.
Prawdziwą korzyścią nie jest jednak szybkość. Jest nią jeden pull request. Gdy zmienia się schemat bazy danych, API, typy i ekran zmieniają się w tym samym commicie, a check-types nie przejdzie, jeśli coś pominięto. Dla agenta AI to złoto: kompilator typów mówi mu, co zepsuł, zanim musi to zrobić człowiek.
Marketplace internetowy jednego z klientów działa w tym samym kształcie, a każda jego usługa to kolejna aplikacja w monorepo.
Dlaczego firma to polyrepo?
Bo dostęp to granica, która liczy się dla nas najbardziej, a GitHub nadaje dostęp per repozytorium. Nie ma uprawnienia do odczytu pojedynczego folderu. Dlatego wszystko, co potrzebuje innych odbiorców, ma własne repozytorium:
- Repozytoria klientów dla każdego klienta, czytelne dla zespołu, który dla niego pracuje. Firma spedycyjna, dla której zbudowaliśmy i utrzymujemy system, ma własne repozytorium klienta z repozytoriami usług w środku jako submodułami.
- Pokoje dla obszarów poufnych, takich jak finanse i marka, każdy czytelny tylko dla własnego zespołu w GitHubie.
- Repozytoria usług dla naszych własnych narzędzi, takich jak plugin i harness, z których korzystają nasi agenci.
Repozytorium firmy w katalogu głównym łączy je przez git submodules. Nikt domyślnie nie dostaje całego drzewa. Sesja bez dostępu do finansów nie przeczyta finansów, cokolwiek mówi jej prompt.
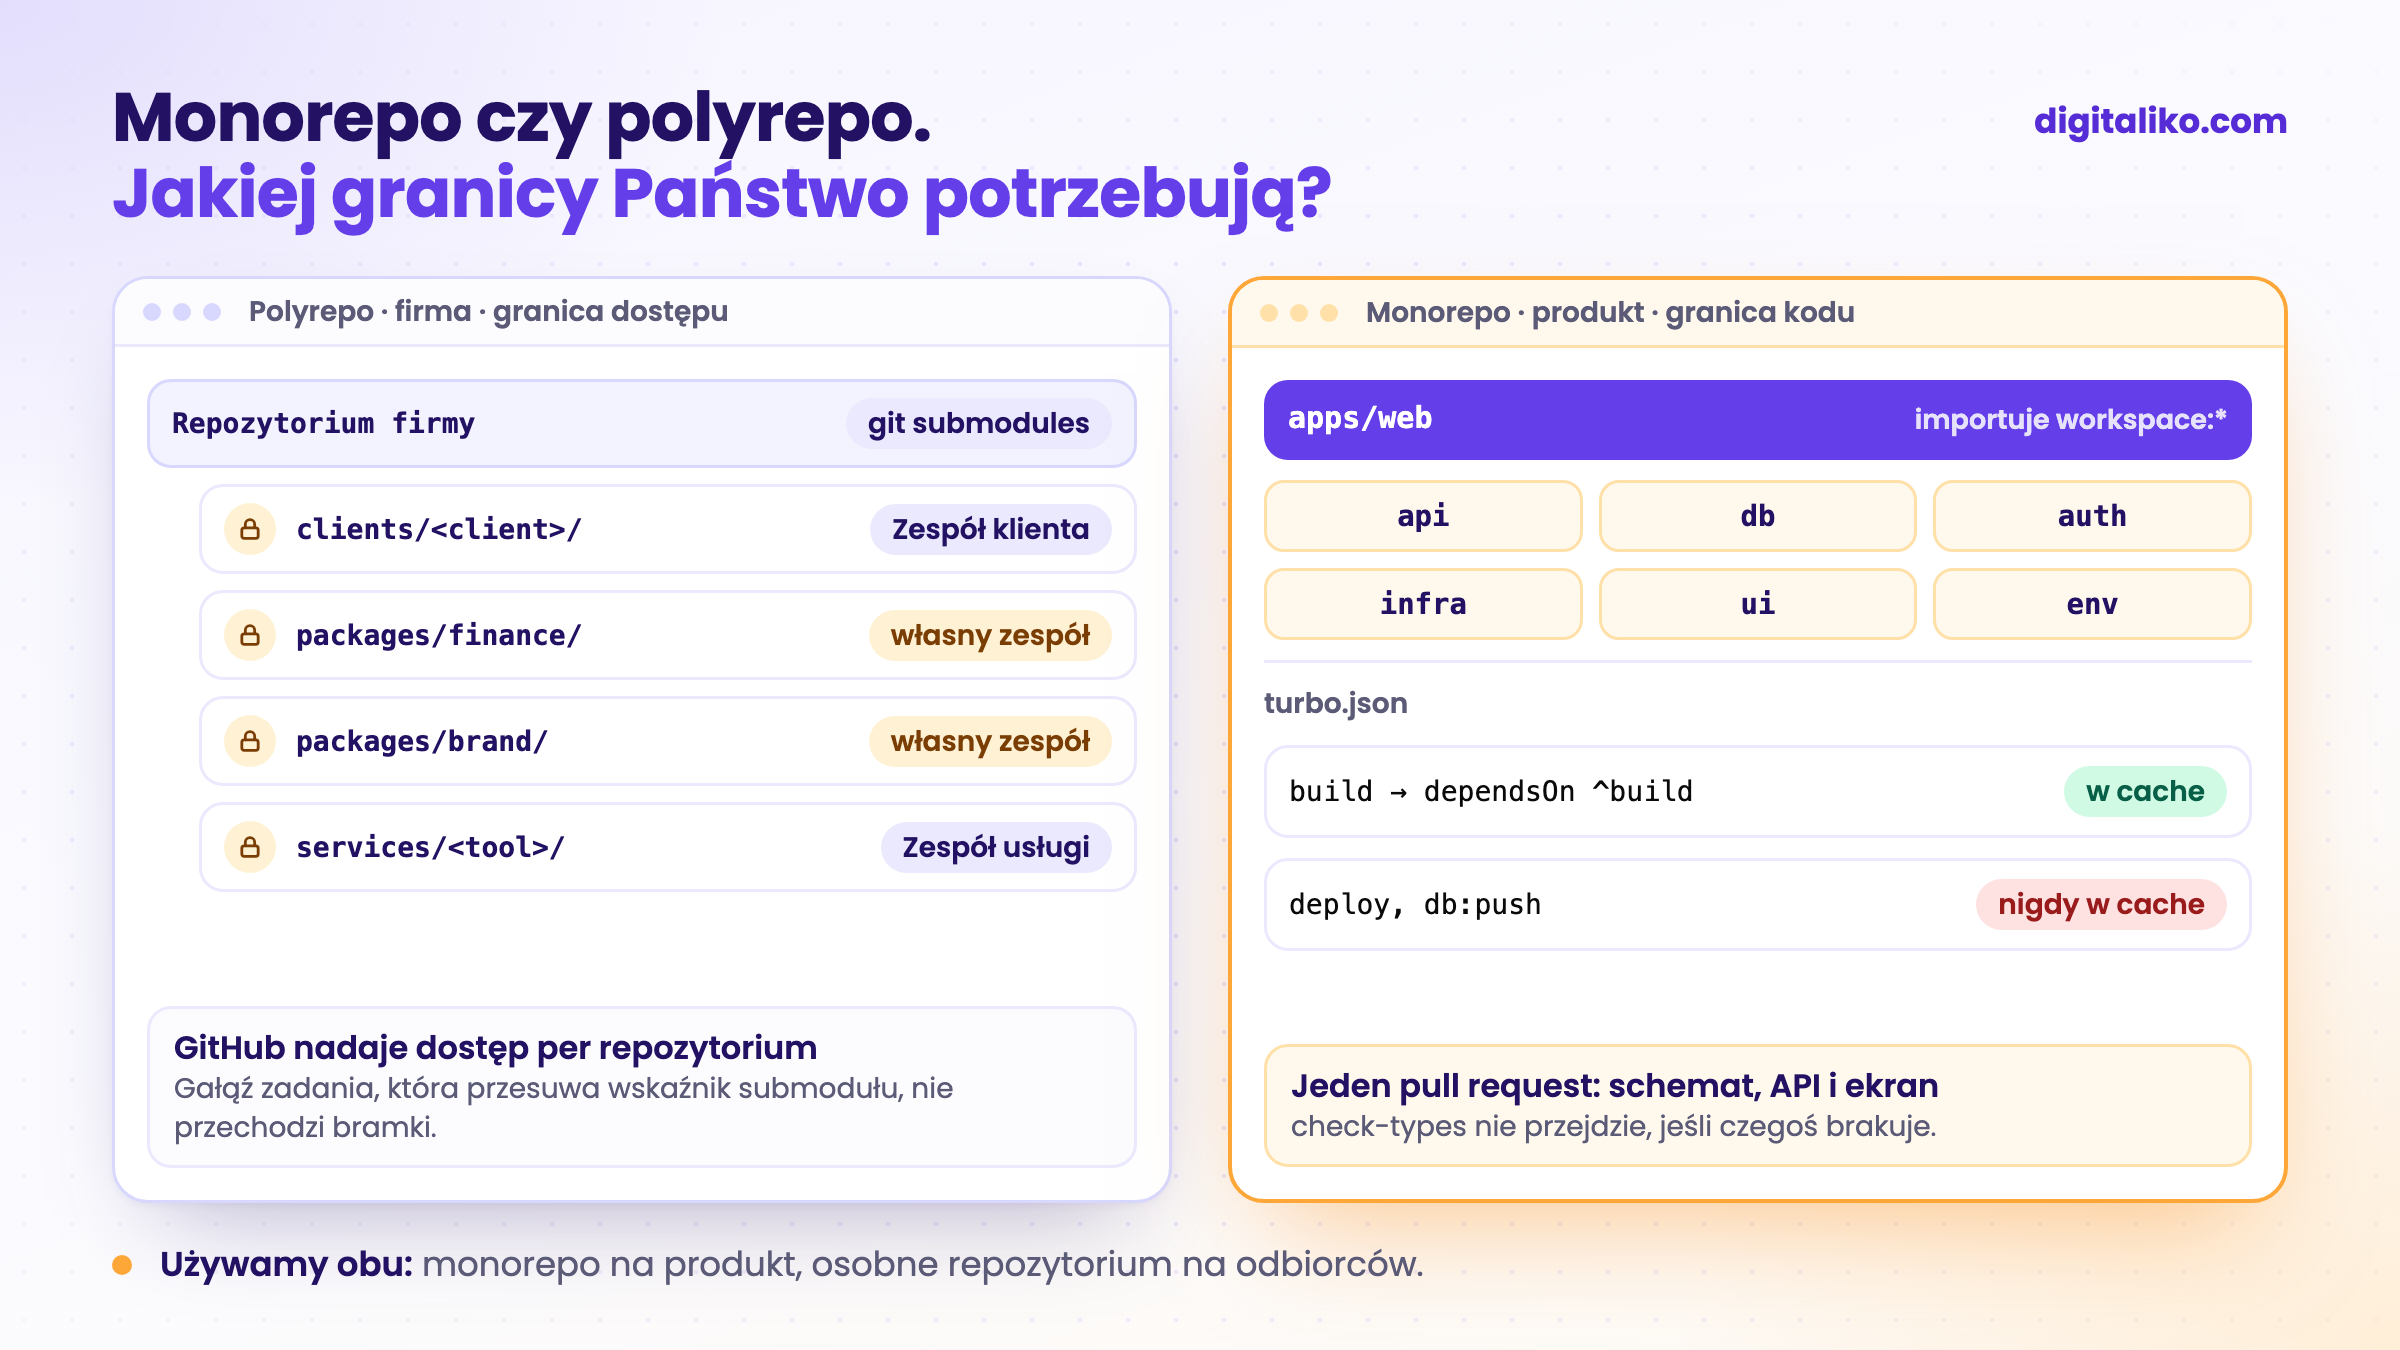
Tego monorepo nie da. Monorepo z zasadą „proszę nie otwierać folderu z finansami” to zasada. Osobne repozytorium z własnym zespołem to zamek.
Jak agent AI pracuje w obu?
Agent przestrzega tych samych kilku zasad na laptopie człowieka i na własnej maszynie:
01
Nawigować, nigdy nie klonować
Każde repozytorium to submoduł w drzewie. Agent wchodzi do clients/<x>/ albo services/<y>/, zamiast klonować drugą kopię gdzie indziej.
02
Jeden worktree na zadanie
Każde zadanie dostaje własny git worktree. Usługa klienta jest zagnieżdżona w worktree repozytorium tego klienta, więc sesja wczytuje każdy CLAUDE.md w górę łańcucha.
03
Praca w jednym repozytorium
Commity i pull requesty trafiają do repozytorium, do którego należy zmiana: praca dla klienta do klienta, praca nad usługą do usługi.
04
Wskaźniki przesuwa się osobno
Gałąź zadania nigdy nie przesuwa wskaźnika submodułu. Robi to osobny krok synchronizacji, po merge’u pracy.
Ostatnią zasadę egzekwuje skrypt, a nie zaufanie. Nasza bramka odrzuca gałąź zadania, która zmienia gitlink, czyli obiekt git za wskaźnikiem submodułu:
moved=$(git diff --raw "$base"...HEAD | awk '$1 ~ /160000/ || $2 == "160000" {print $NF}')
[ -z "$moved" ] || { echo "FAIL submodule pointer changed: pointers move only via sync"; exit 1; }
Bez niej agent, który w jednym zadaniu dotknął dwóch repozytoriów, po cichu przesunąłby wskaźnik w repozytorium nadrzędnym na commit bez merge’a. Wszyscy pozostali pobieraliby wtedy kod, który istnieje tylko na gałęzi.
Zagnieżdżony worktree to drugi szczegół, który zajął nam trochę czasu. Zwykły worktree usługi nie widziałby CLAUDE.md klienta piętro wyżej, więc agent pracowałby bez zasad klienta. Zagnieżdżenie usługi w worktree jej klienta zachowuje cały łańcuch kontekstu.
Ile kosztuje polyrepo?
Nie jest za darmo i nie będziemy udawać, że jest:
- Zmiany w wielu repozytoriach to kilka pull requestów. Zasada, która zmienia się dla wszystkich klientów, oznacza pull request w każdym repozytorium klienta.
- Submoduły mają swoje ostre krawędzie. Świeży checkout potrzebuje
git submodule update --init, a nieaktualny wskaźnik pokazuje stary kod bez żadnego ostrzeżenia. - CI konfiguruje się wiele razy. Każde repozytorium potrzebuje własnych workflow.
Ostatnie rozwiązaliśmy, nie kopiując CI. Każde repozytorium wywołuje cienkie, wspólne akcje z jednego repozytorium narzędzi, przypięte do przesuwanego tagu wersji głównej. Nowe sprawdzenie walidacyjne trafia w jedno miejsce i dociera do każdego repozytorium przy jego następnym uruchomieniu. Wszystkie działają na jednym self-hosted runnerze GitHub dla całej organizacji.
Monorepo czy polyrepo: jak zdecydować w Państwa zespole?
Proszę przejrzeć, co jest dziś prawdą w Państwa kodzie:
Następne pytanie to zwykle Turborepo czy Nx. Szczera odpowiedź: używamy Turborepo, bo nasze monorepo to aplikacje w TypeScript na Bun workspaces i krótki turbo.json to wszystko, czego potrzebują. Nx nie używaliśmy na produkcji, więc nie będziemy ich szeregować.
Jak uruchamiamy kilku agentów równolegle z worktree, opisujemy w artykule Subagenci i worktree w Claude Code. Całą pętlę od issue do pull requestu pokazuje Harness engineering w praktyce.
Potrzebują Państwo repozytoriów, w których agent może bezpiecznie pracować?
Strukturę repozytoriów, wspólne CI i zasady dla agenta konfigurujemy bezpośrednio w kodzie zespołu, w ramach usługi AI-native SDLC dla zespołów deweloperskich. Państwa zespołowi brakuje raczej rąk niż struktury? Proszę zobaczyć senior developera dla Państwa zespołu. Większość naszego kodu pisze AI. Senior przegląda każdą zmianę i odpowiada za produkcję. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Gdzie Państwa kod potrzebuje granicy kodu, a gdzie granicy dostępu?
W skrócie
- Monorepo wyznacza granicę kodu, polyrepo granicę dostępu.
- Każdy nasz produkt to monorepo na Turborepo: jeden pull request zmienia razem schemat, API i ekran.
- Firma to polyrepo z submodułów, bo GitHub nadaje dostęp per repozytorium.
- Agent nawiguje zamiast klonować, pracuje w zagnieżdżonym worktree, a bramka blokuje przesuwanie wskaźników submodułów.
Najczęstsze pytania
Jaka jest różnica między monorepo a polyrepo?
Monorepo trzyma wiele projektów albo pakietów w jednym repozytorium git z jedną historią. Polyrepo daje każdemu projektowi własne repozytorium. W monorepo jeden commit może zmienić kilka pakietów naraz. W polyrepo każde repozytorium ma własny dostęp, własne CI i własny release.
Kiedy lepszym wyborem jest monorepo?
Gdy części są wydawane razem i dzielą kod: aplikacja webowa, jej API, schemat bazy danych i komponenty UI. Jeden pull request zmienia je wszystkie, a typy wyłapują to, co przestało pasować, zanim cokolwiek zostanie wdrożone.
Kiedy lepszym wyborem jest polyrepo?
Gdy różne osoby mogą widzieć różne części. GitHub nadaje dostęp per repozytorium, a nie per folder, więc kod klientów, finanse i narzędzia wewnętrzne, które potrzebują różnych odbiorców, należą do różnych repozytoriów.
Turborepo czy Nx?
Używamy Turborepo z Bun workspaces, bo nasze monorepo to aplikacje w TypeScript, a Turborepo potrzebuje tylko małego turbo.json nad workspaces. Nx nie używaliśmy na produkcji, więc nie porównamy ich z doświadczenia.
Czy agent AI może pracować w polyrepo z git submodules?
Tak, jeśli ma zasady. Nasz wchodzi do submodułu zamiast klonować kopię, pracuje we własnym worktree dla każdego zadania, a bramka blokuje każdą gałąź zadania, która przesuwa wskaźnik submodułu.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

