Monorepo vs. polyrepo: por qué usamos los dos
Para CTO y desarrolladoresDecisiones de CTO

Filip PapranecFundador de Digitaliko
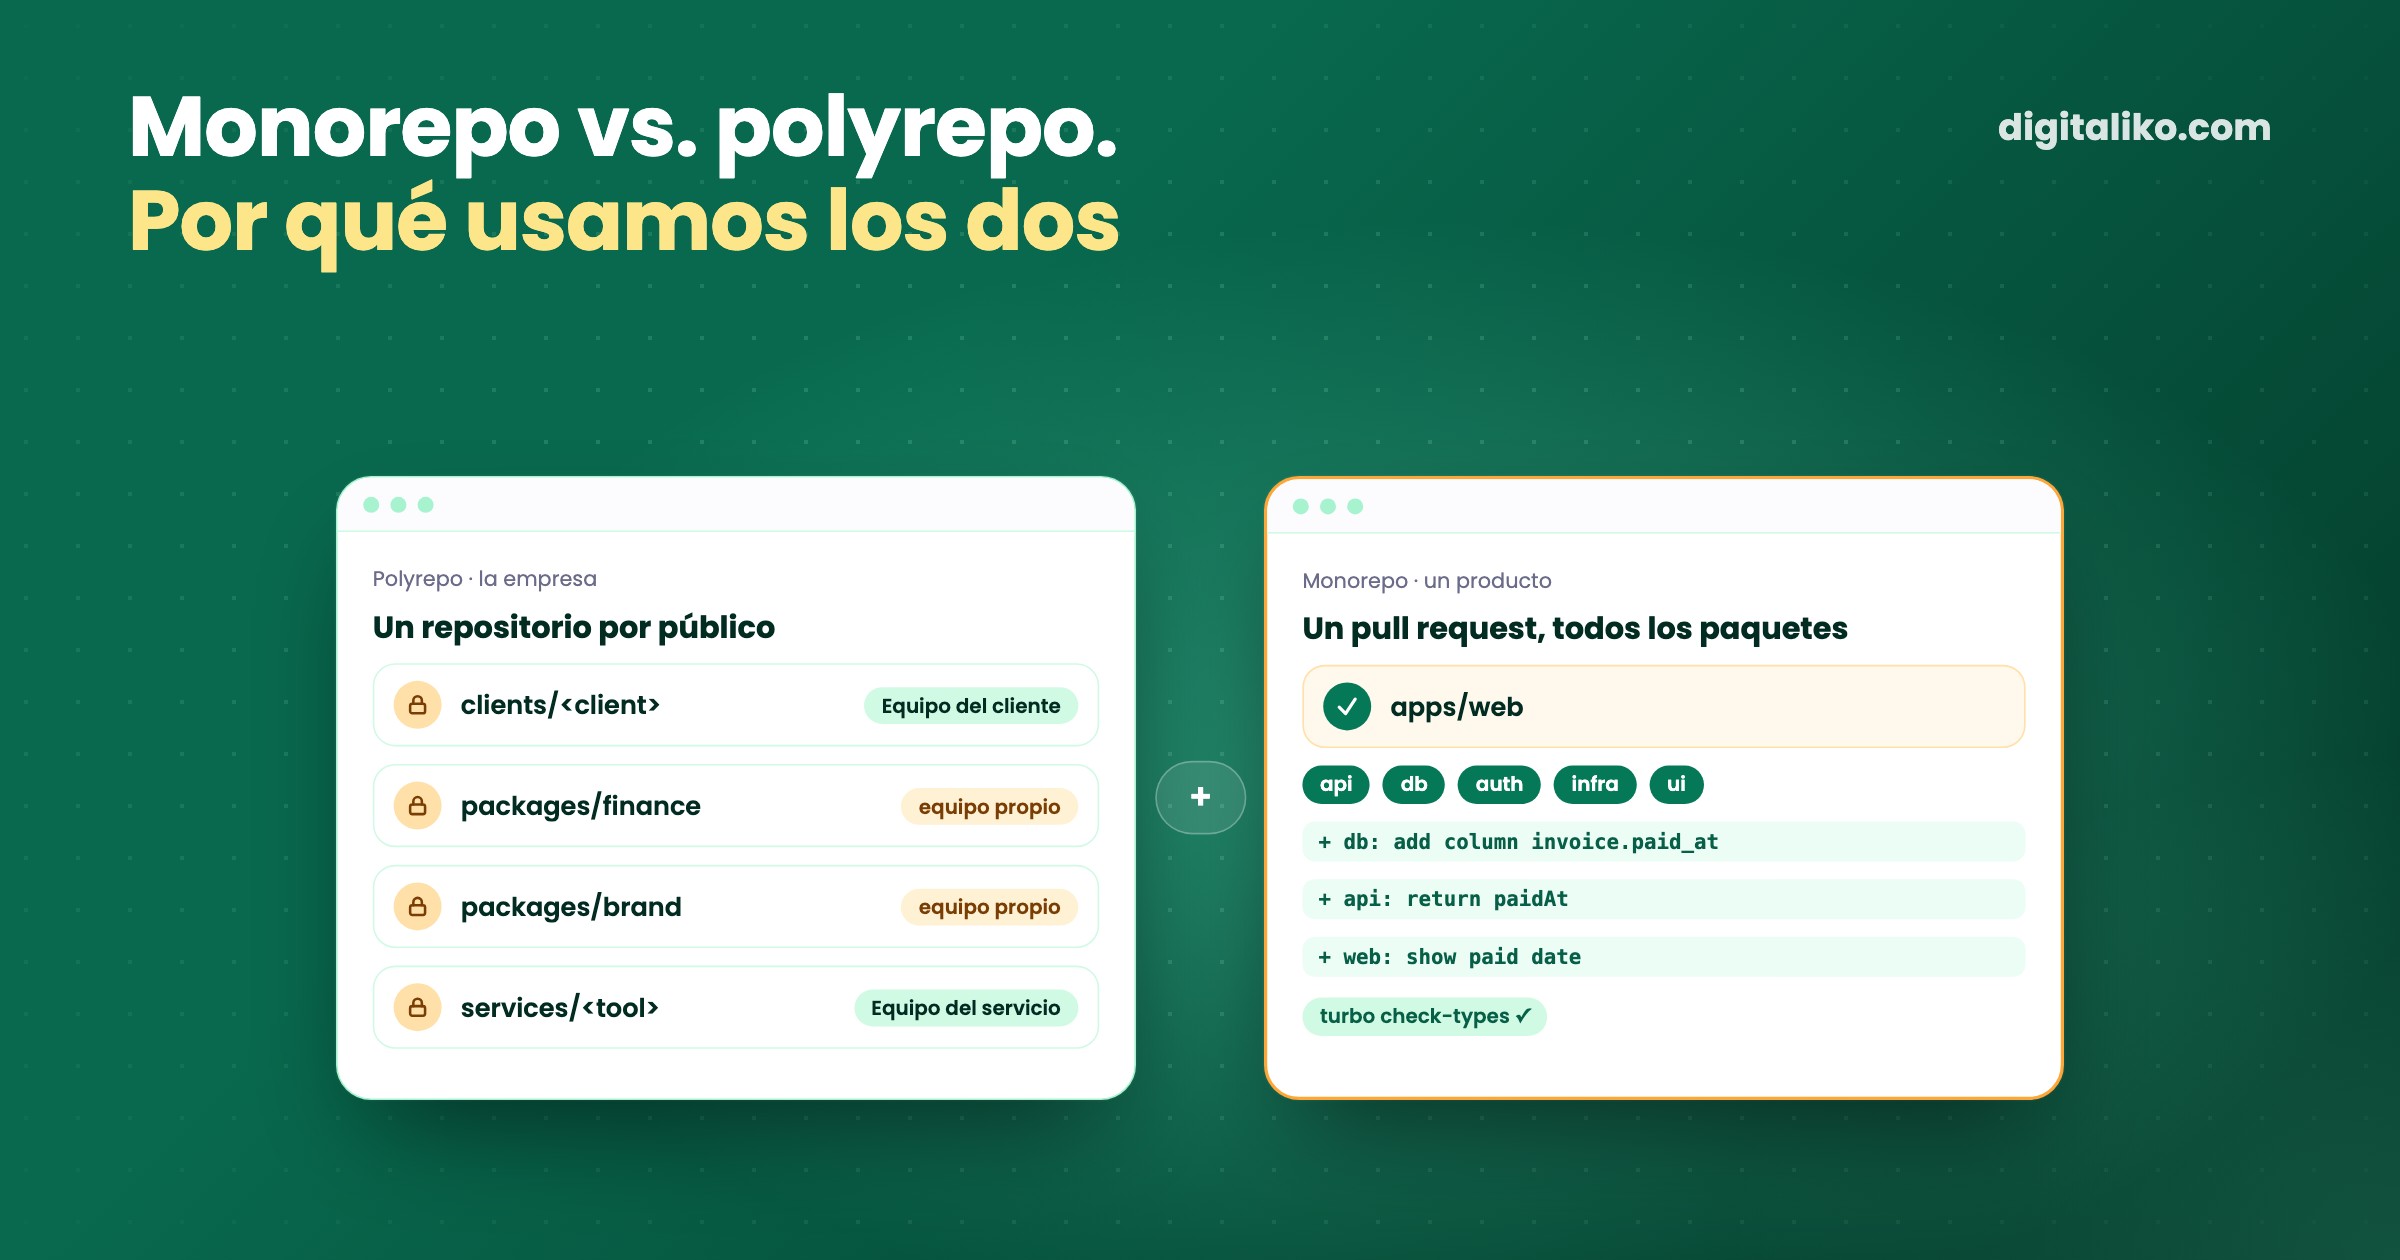
Monorepo vs. polyrepo es una cuestión de qué límite necesita. Un monorepo pone muchos paquetes en un repositorio, así que un cambio puede atravesarlos todos. Un polyrepo da a cada proyecto su propio repositorio, así que cada uno puede tener su propio acceso, su propia CI y su propio release.
Usamos los dos a propósito. Cada producto que construimos es un monorepo con Turborepo. La propia empresa es un polyrepo: cada cliente, cada servicio y cada área confidencial es su propio repositorio, unidos con git submodules. Un agente de IA trabaja en ambos cada día.
¿Cuál es la diferencia entre un monorepo y un polyrepo?
La versión corta: un monorepo traza un límite de código alrededor de los paquetes; un polyrepo traza un límite de acceso alrededor de los repositorios.
| Monorepo | Polyrepo | |
|---|---|---|
| Un cambio en muchas partes | Un commit, un pull request | Un pull request por repositorio |
| Código compartido | Un paquete del workspace, importado directamente | Un paquete publicado o una copia |
| Quién puede leer qué | Todo el que tiene acceso lo ve todo | Acceso por repositorio |
| CI | Un pipeline; una herramienta de build salta lo que no ha cambiado | Un pipeline por repositorio |
| Versiones de dependencias | Un lockfile, una versión por paquete | Cada repositorio se desvía por su cuenta |
| Contexto para un agente de IA | Todo el sistema en un checkout | Solo lo que necesita la tarea; el resto, navegando |
La mayoría de los artículos sobre este tema defienden una columna. Nosotros creemos que las dos tienen razón, para unidades distintas. La pregunta es alrededor de qué traza la línea.
¿Por qué cada producto es un monorepo?
Un producto es código que se publica junto. Nuestra plantilla y wizrd, nuestro plugin y CLI interno para Claude Code (no es público), tienen el mismo aspecto: una aplicación y los paquetes de los que está hecha.
{
  "packageManager": "bun@1.3.13",
  "workspaces": {
    "packages": ["apps/*", "packages/*"],
    "catalog": { "zod": "^4.1.13", "typescript": "^6", "better-auth": "1.5.5" }
  },
  "scripts": { "build": "turbo build", "check-types": "turbo check-types", "deploy": "turbo -F @wizrd/infra deploy" }
}
apps/web es la aplicación. packages/ contiene api, db, auth, infra, ui, env y algunos más. La aplicación los importa como workspace:*, así que no hay nada que publicar. El catalog fija las versiones compartidas una sola vez, así que la API y la aplicación nunca ejecutan dos versiones distintas de la misma librería.
Turborepo va encima con un turbo.json corto:
{
  "tasks": {
    "build": { "dependsOn": ["^build"], "outputs": ["dist/**"] },
    "check-types": { "dependsOn": ["^check-types"] },
    "dev": { "cache": false, "persistent": true },
    "deploy": { "cache": false }
  }
}
^build significa: compila primero aquello de lo que dependo. Los builds, las comprobaciones de tipos y el lint se cachean. Los despliegues y los push a la base de datos, nunca. La caché es la razón que da la documentación de Turborepo para usarlo:
Turborepo uses caching to speed up builds, ensuring you never do the same work twice.
Pero la verdadera ventaja no es la velocidad. Es el pull request único. Cuando cambia el esquema de la base de datos, la API, los tipos y la pantalla cambian en el mismo commit, y check-types falla si se olvidó alguno. Para un agente de IA eso vale oro: el comprobador de tipos le dice qué ha roto antes de que tenga que hacerlo una persona.
El marketplace online de un cliente funciona con la misma forma, con cada uno de sus servicios como una aplicación más dentro del monorepo.
¿Por qué la empresa es un polyrepo?
Porque el acceso es el límite que más nos importa, y GitHub concede el acceso por repositorio. No existe un permiso de lectura para una sola carpeta. Así que todo lo que necesita un público distinto tiene su propio repositorio:
- Repositorios de clientes para cada cliente, que puede leer el equipo que trabaja para ese cliente. Una empresa de transporte para la que construimos y operamos un sistema tiene su propio repositorio de cliente, con sus repositorios de servicios dentro como submódulos.
- Salas para áreas confidenciales como finanzas y marca, cada una legible solo por su propio equipo de GitHub.
- Repositorios de servicios para nuestras propias herramientas, como el plugin y el harness que usan nuestros agentes.
El repositorio de la empresa en la raíz los une con git submodules. Nadie recibe el árbol completo por defecto. Una sesión sin acceso a finanzas no puede leer finanzas, diga lo que diga su prompt.
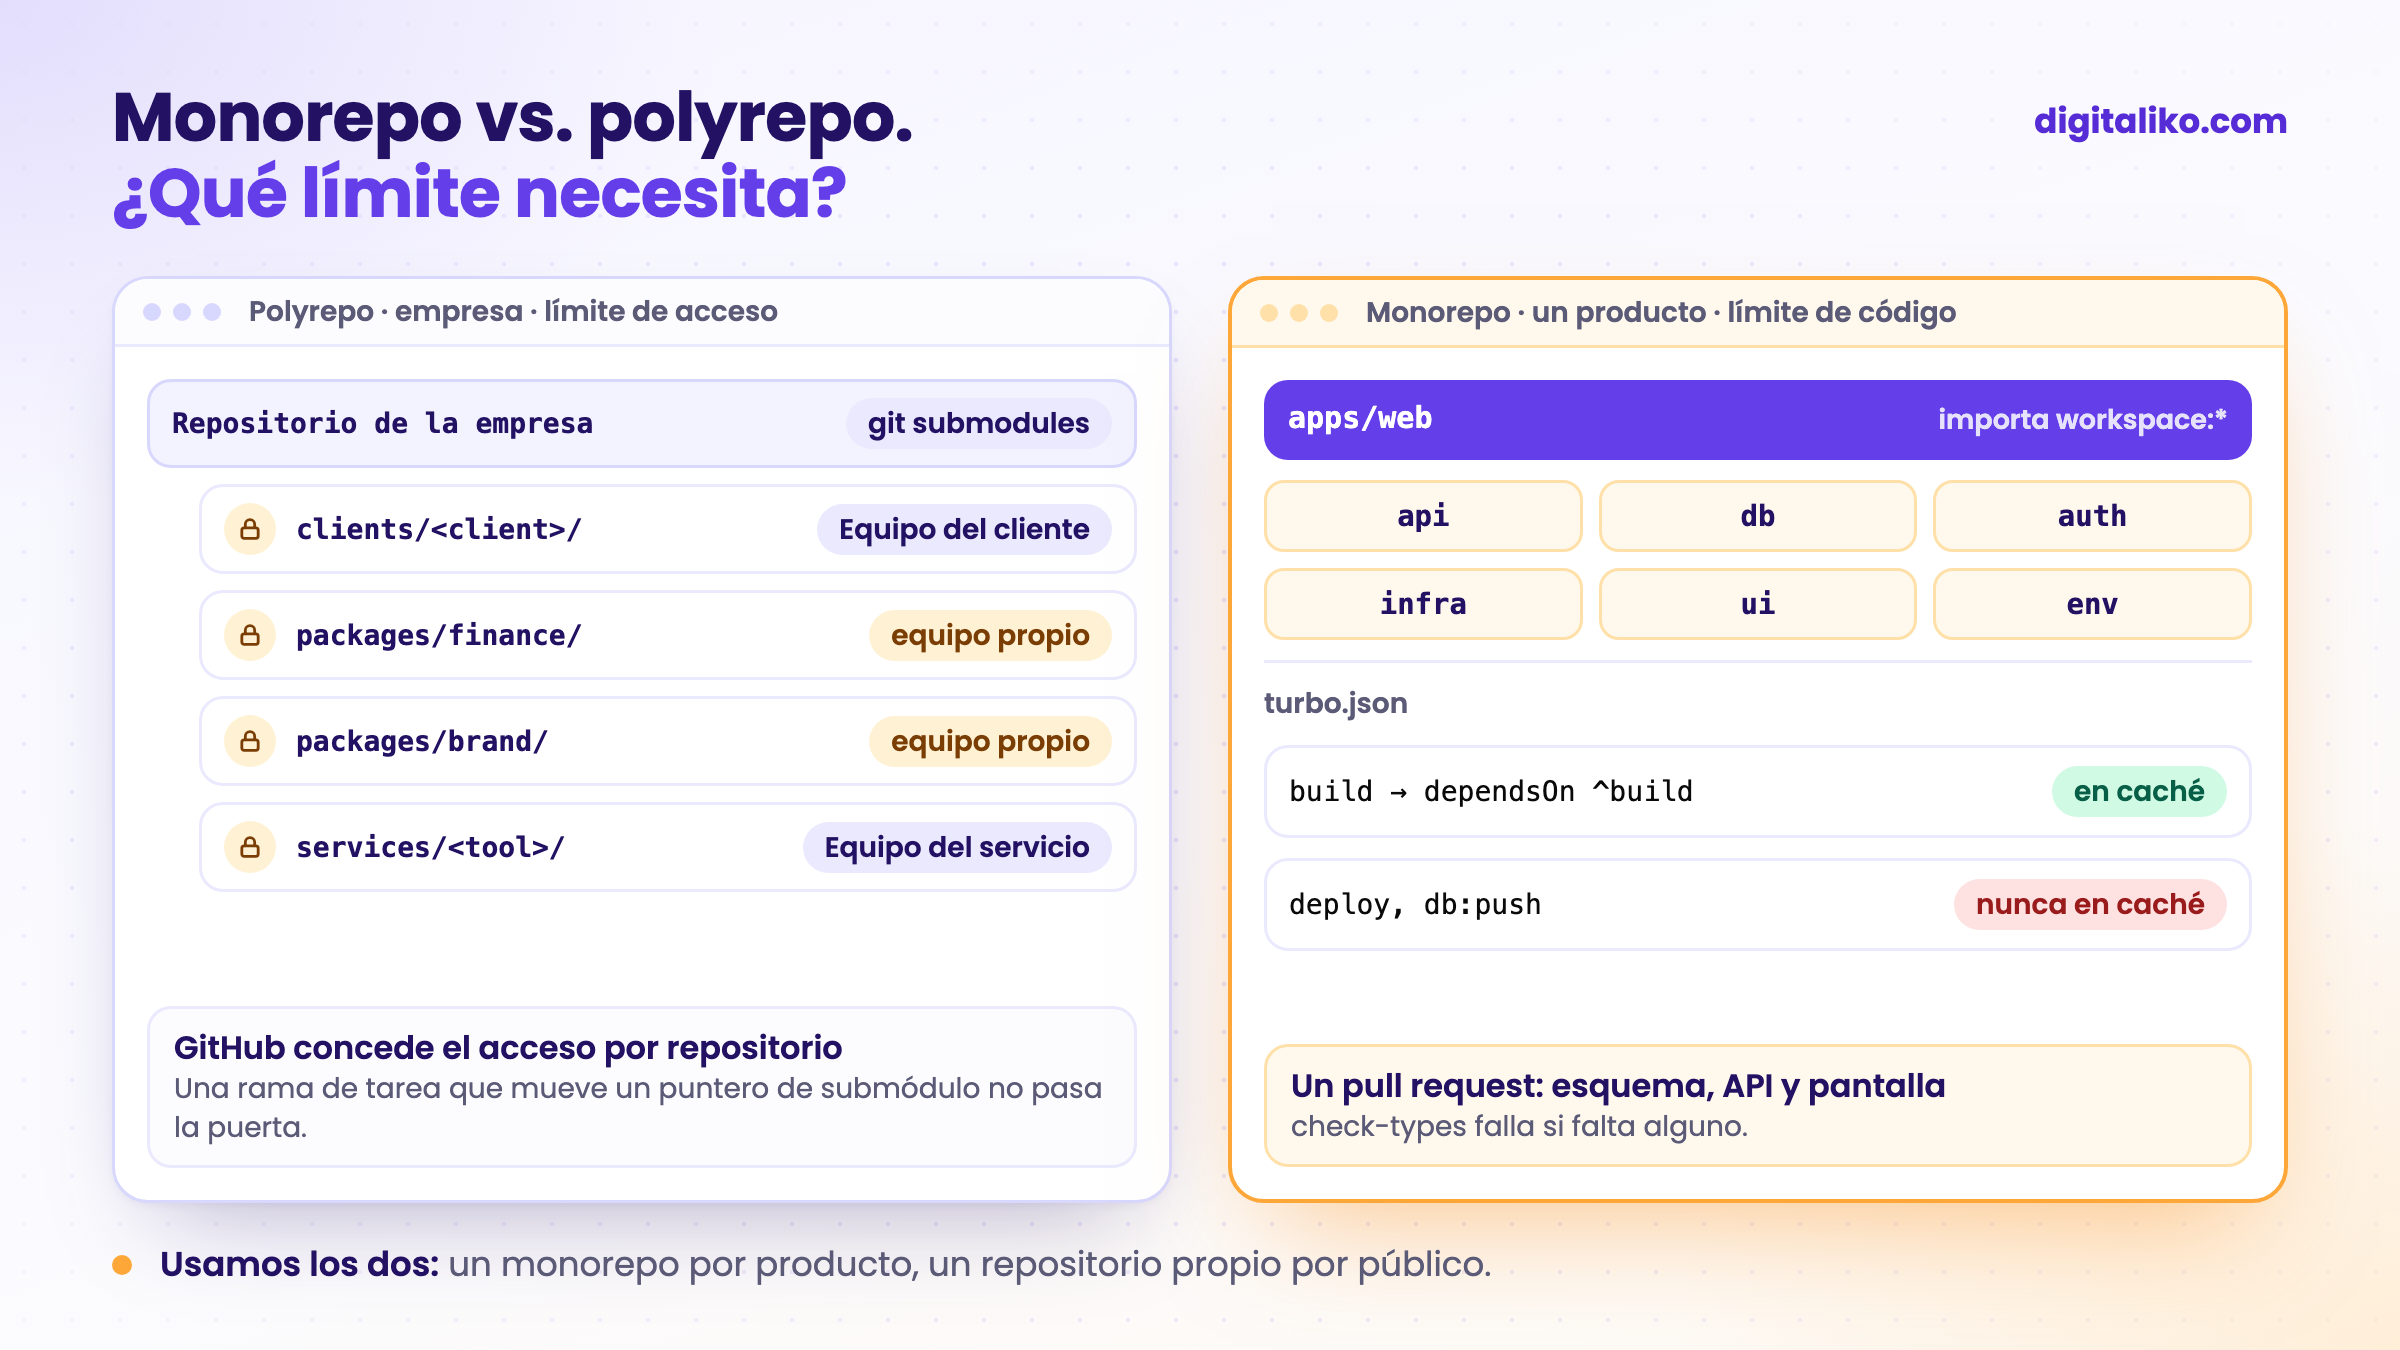
Esta es la parte que un monorepo no le puede dar. Un monorepo con la regla «por favor, no abra la carpeta de finanzas» es una regla. Un repositorio separado con su propio equipo es un candado.
¿Cómo trabaja un agente de IA en ambos?
El agente sigue las mismas pocas reglas en el portátil de una persona y en su propia máquina:
01
Navegar, nunca clonar
Cada repositorio es un submódulo del árbol. El agente va a clients/<x>/ o services/<y>/ en lugar de clonar una segunda copia en otro sitio.
02
Un worktree por tarea
Cada tarea tiene su propio git worktree. Un servicio de un cliente va anidado dentro de un worktree del repositorio de ese cliente, así que la sesión carga cada CLAUDE.md de la cadena hacia arriba.
03
Trabajar en un repositorio
Los commits y pull requests van al repositorio al que pertenece el cambio: el trabajo del cliente al cliente, el del servicio al servicio.
04
Los punteros se mueven aparte
Una rama de tarea nunca mueve un puntero de submódulo. Eso lo hace un paso de sincronización aparte, después de hacer merge del trabajo.
La última regla la impone un script, no la confianza. Nuestra puerta hace fallar una rama de tarea que cambia un gitlink, el objeto de git que hay detrás de un puntero de submódulo:
moved=$(git diff --raw "$base"...HEAD | awk '$1 ~ /160000/ || $2 == "160000" {print $NF}')
[ -z "$moved" ] || { echo "FAIL submodule pointer changed: pointers move only via sync"; exit 1; }
Sin ella, un agente que tocara dos repositorios en una tarea movería sin hacer ruido el puntero del padre a un commit sin merge. Todos los demás harían checkout de código que solo existe en una rama.
El worktree anidado es el otro detalle que nos llevó tiempo. Un worktree normal de un servicio no vería el CLAUDE.md del cliente una carpeta más arriba, así que el agente trabajaría sin las reglas del cliente. Anidar el servicio dentro de un worktree de su cliente mantiene toda la cadena de contexto.
¿Qué cuesta un polyrepo?
No es gratis, y no vamos a fingir lo contrario:
- Los cambios entre repositorios requieren varios pull requests. Una regla que cambia para todos los clientes significa un pull request por cada repositorio de cliente.
- Los submódulos tienen sus asperezas. Un checkout nuevo necesita
git submodule update --init, y un puntero desactualizado muestra código antiguo sin ningún aviso. - La CI se configura muchas veces. Cada repositorio necesita sus propios workflows.
Lo último lo resolvimos sin copiar la CI. Cada repositorio llama a acciones compartidas y ligeras de un repositorio de herramientas, fijadas a una etiqueta de versión mayor que se va moviendo. Una comprobación de validación nueva llega a un solo sitio y alcanza a todos los repositorios en su siguiente ejecución. Todos se ejecutan en un runner self-hosted de GitHub para toda la organización.
Monorepo o polyrepo: ¿cómo decidir para su equipo?
Repase lo que se cumple hoy en su código:
Lo siguiente que suele salir es Turborepo vs. Nx. Respuesta honesta: usamos Turborepo porque nuestros monorepos son aplicaciones en TypeScript sobre Bun workspaces y no necesitan más que un turbo.json corto. No hemos usado Nx en producción, así que no los vamos a clasificar.
Cómo ejecutamos varios agentes en paralelo con worktrees está en Subagentes y worktrees en Claude Code. El ciclo completo del issue al pull request está en Harness engineering en la práctica.
¿Necesita repositorios en los que un agente pueda trabajar con seguridad?
Configuramos la estructura de repositorios, la CI compartida y las reglas del agente directamente en el código de un equipo, como parte de AI-native SDLC para equipos de desarrollo. ¿A su equipo le faltan manos más que estructura? Vea un desarrollador senior para su equipo. La IA escribe la mayor parte de nuestro código. Un senior revisa cada cambio y responde de la producción. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en un plazo de dos días hábiles con algunas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar antes, reserve una llamada introductoria de 15 minutos.
¿Dónde necesita su código un límite de código, y dónde un límite de acceso?
En resumen
- Un monorepo traza un límite de código; un polyrepo, un límite de acceso.
- Cada uno de nuestros productos es un monorepo con Turborepo: un pull request cambia a la vez el esquema, la API y la pantalla.
- La empresa es un polyrepo de submódulos, porque GitHub concede el acceso por repositorio.
- El agente navega en lugar de clonar, trabaja en un worktree anidado y una puerta bloquea los movimientos de punteros de submódulo.
Preguntas frecuentes
¿Cuál es la diferencia entre un monorepo y un polyrepo?
Un monorepo guarda muchos proyectos o paquetes en un solo repositorio git con un único historial. Un polyrepo da a cada proyecto su propio repositorio. En un monorepo, un solo commit puede cambiar varios paquetes a la vez. En un polyrepo, cada repositorio tiene su propio acceso, su propia CI y su propio release.
¿Cuándo es mejor un monorepo?
Cuando las partes se publican juntas y comparten código: una aplicación web, su API, su esquema de base de datos y sus componentes de UI. Un solo pull request las cambia todas, y los tipos detectan lo que ya no encaja antes de desplegar nada.
¿Cuándo es mejor un polyrepo?
Cuando distintas personas pueden ver distintas partes. GitHub concede el acceso por repositorio, no por carpeta, así que el código de clientes, las finanzas y las herramientas internas que necesitan públicos distintos van en repositorios distintos.
¿Turborepo o Nx?
Usamos Turborepo con Bun workspaces, porque nuestros monorepos son aplicaciones en TypeScript y Turborepo solo necesita un pequeño turbo.json encima de los workspaces. No hemos usado Nx en producción, así que no podemos compararlos por experiencia.
¿Puede un agente de IA trabajar en un polyrepo con git submodules?
Sí, si tiene reglas. El nuestro navega dentro del submódulo en lugar de clonar una copia, trabaja en su propio worktree por tarea y una puerta bloquea cualquier rama de tarea que mueva un puntero de submódulo.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

