Playwright MCP: AI agent overí zmenu v prehliadači
Pre CTO a vývojárovHarness a kontroly · Aktualizované

Filip PapranecZakladateľ, Digitaliko
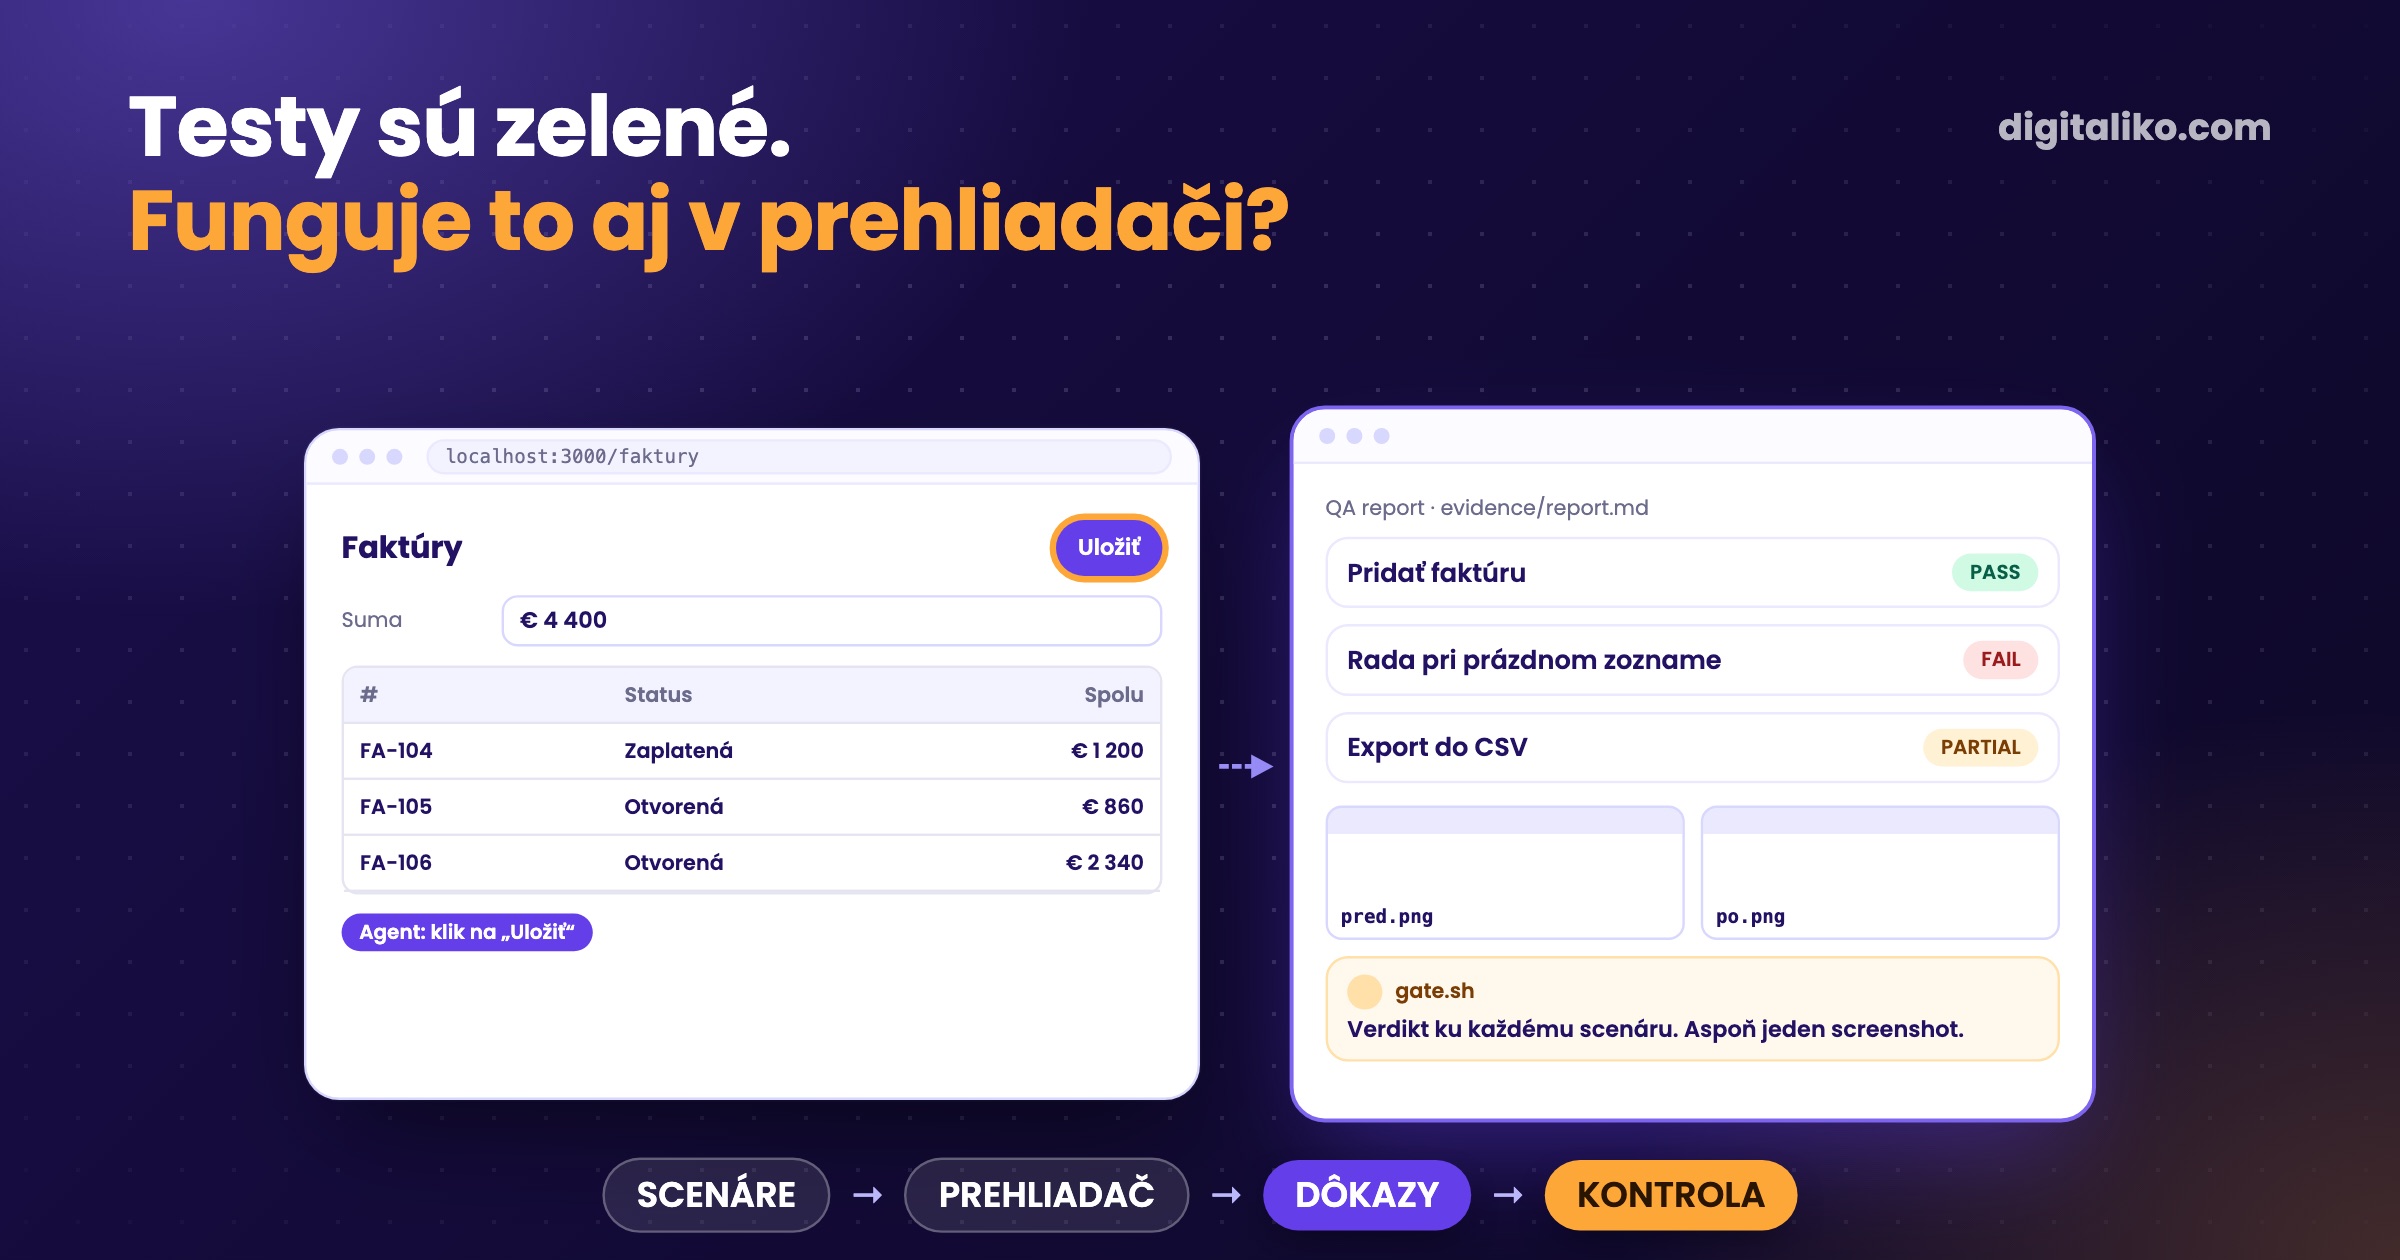
Playwright MCP je MCP server od Microsoftu, ktorý dáva AI agentovi skutočný prehliadač: otvára stránky, kliká, píše a číta, čo je na obrazovke. Používame ho na jednu vec. Skôr než niekto povie „hotovo“, agent prejde zmenu v bežiacej aplikácii a vráti PASS alebo FAIL pre každý scenár, so screenshotmi.
Zelený typecheck dokazuje, že sa kód skompiluje. Prejdený test komponentu dokazuje, že sa komponent vykreslí vo vlastnom testovacom prostredí. Ani jedno nedokazuje, že skutočná stránka so skutočnými dátami robí to, čo chcelo issue. Presne túto medzeru zatvára kontrola v prehliadači.
Najťažší je zvyčajne posledný krok. Overiť, že to naozaj funguje, od začiatku do konca.

Čo je Playwright MCP a ako funguje?
MCP, Model Context Protocol, je spôsob, akým agent ako Claude Code dostane ďalšie nástroje. Playwright MCP server pridá nástroje prehliadača postavené na Playwrighte: otvoriť adresu, kliknúť, písať, vyplniť formulár, čítať konzolu a sieťové požiadavky, urobiť screenshot.
V Claude Code je to jeden príkaz:
claude mcp add playwright npx @playwright/mcp@latest
Podstatný detail: agent sa nepozerá na pixely. Podľa README pracuje cez „structured accessibility snapshots“, bez screenshotov a bez modelov na videnie. Stránku dostane ako strom tlačidiel, odkazov, nadpisov a formulárových polí s ich popismi. Klikne na tlačidlo „Uložiť“, nie na súradnice, kde kedysi nejaké tlačidlo bolo.
Z toho plynú dve veci. Stránka, ktorej tlačidlá nemajú prístupný názov, je ťažká aj pre agenta, takže kontrola je zároveň malá revízia prístupnosti. A keď výsledok potrebuje vidieť človek, agent screenshot urobiť vie.
Server predvolene drží trvalý profil prehliadača, takže prihlásenie ostane aj medzi sessions. Pre behy, ktoré musia začať načisto, je --isolated a --storage-state do takého čistého kontextu načíta uložené cookies.
Ako necháme agenta overiť jeho vlastnú zmenu?
Metóda je v našom skille browser-qa. Kód aplikácie nemení. Píše dôkazy:
01
Scenáre z issue
Jeden scenár na každé akceptačné kritérium alebo pripomienku, s odkazom na zdroj. Konkrétne kroky: kliknem na X, stane sa Y.
02
Skutočné dáta, skutočné prihlásenie
Beh nad falošnými alebo prázdnymi dátami dokazuje rozloženie, nie správanie. Najprv sa prihlási človek. Agent na session token nesiahne.
03
Prejsť aplikáciu
Otvoriť, kliknúť, písať, urobiť screenshot. Čo musí sedieť presne (farba, číslo, popis), agent prečíta zo stránky, nehádá z obrázka.
04
Verdikt pre každý scenár
PASS, FAIL alebo PARTIAL a čo agent naozaj videl. Nikdy „vyzerá to dobre“.
05
Chyby do issues
Každý skutočný FAIL je bug issue s odkazom na report. Poznámka iba v reporte sa stratí.
Skill hovorí aj to, čo robiť, keď automatizácia niečo nezvládne. Prvok vnorený tak hlboko, že klik spoľahlivo nefunguje, dostane poznámku „needs manual click“. Neoznačí sa potichu ako FAIL a nepreskočí sa.
Nie každá kontrola vychádza z napísaného scenára. Niekedy je najlepšia tá otvorená:
Osvedčil sa nám jeden trik. Pošleme agenta do novej funkcie ako určitý typ zákazníka, personu, a necháme ho, nech ju sám preskúma.
Persona nájde veci, ktoré nikto nenapísal: mätúci popis, slepú uličku, krok, ktorý dáva zmysel len tomu, kto ho staval.
Čo agent odovzdá a kto to skontroluje?
Report, ktorý agent napíše sám o sebe, je stále len tvrdenie. Preto je tvar dôkazov pevný a kontroluje ho skript, nie model.
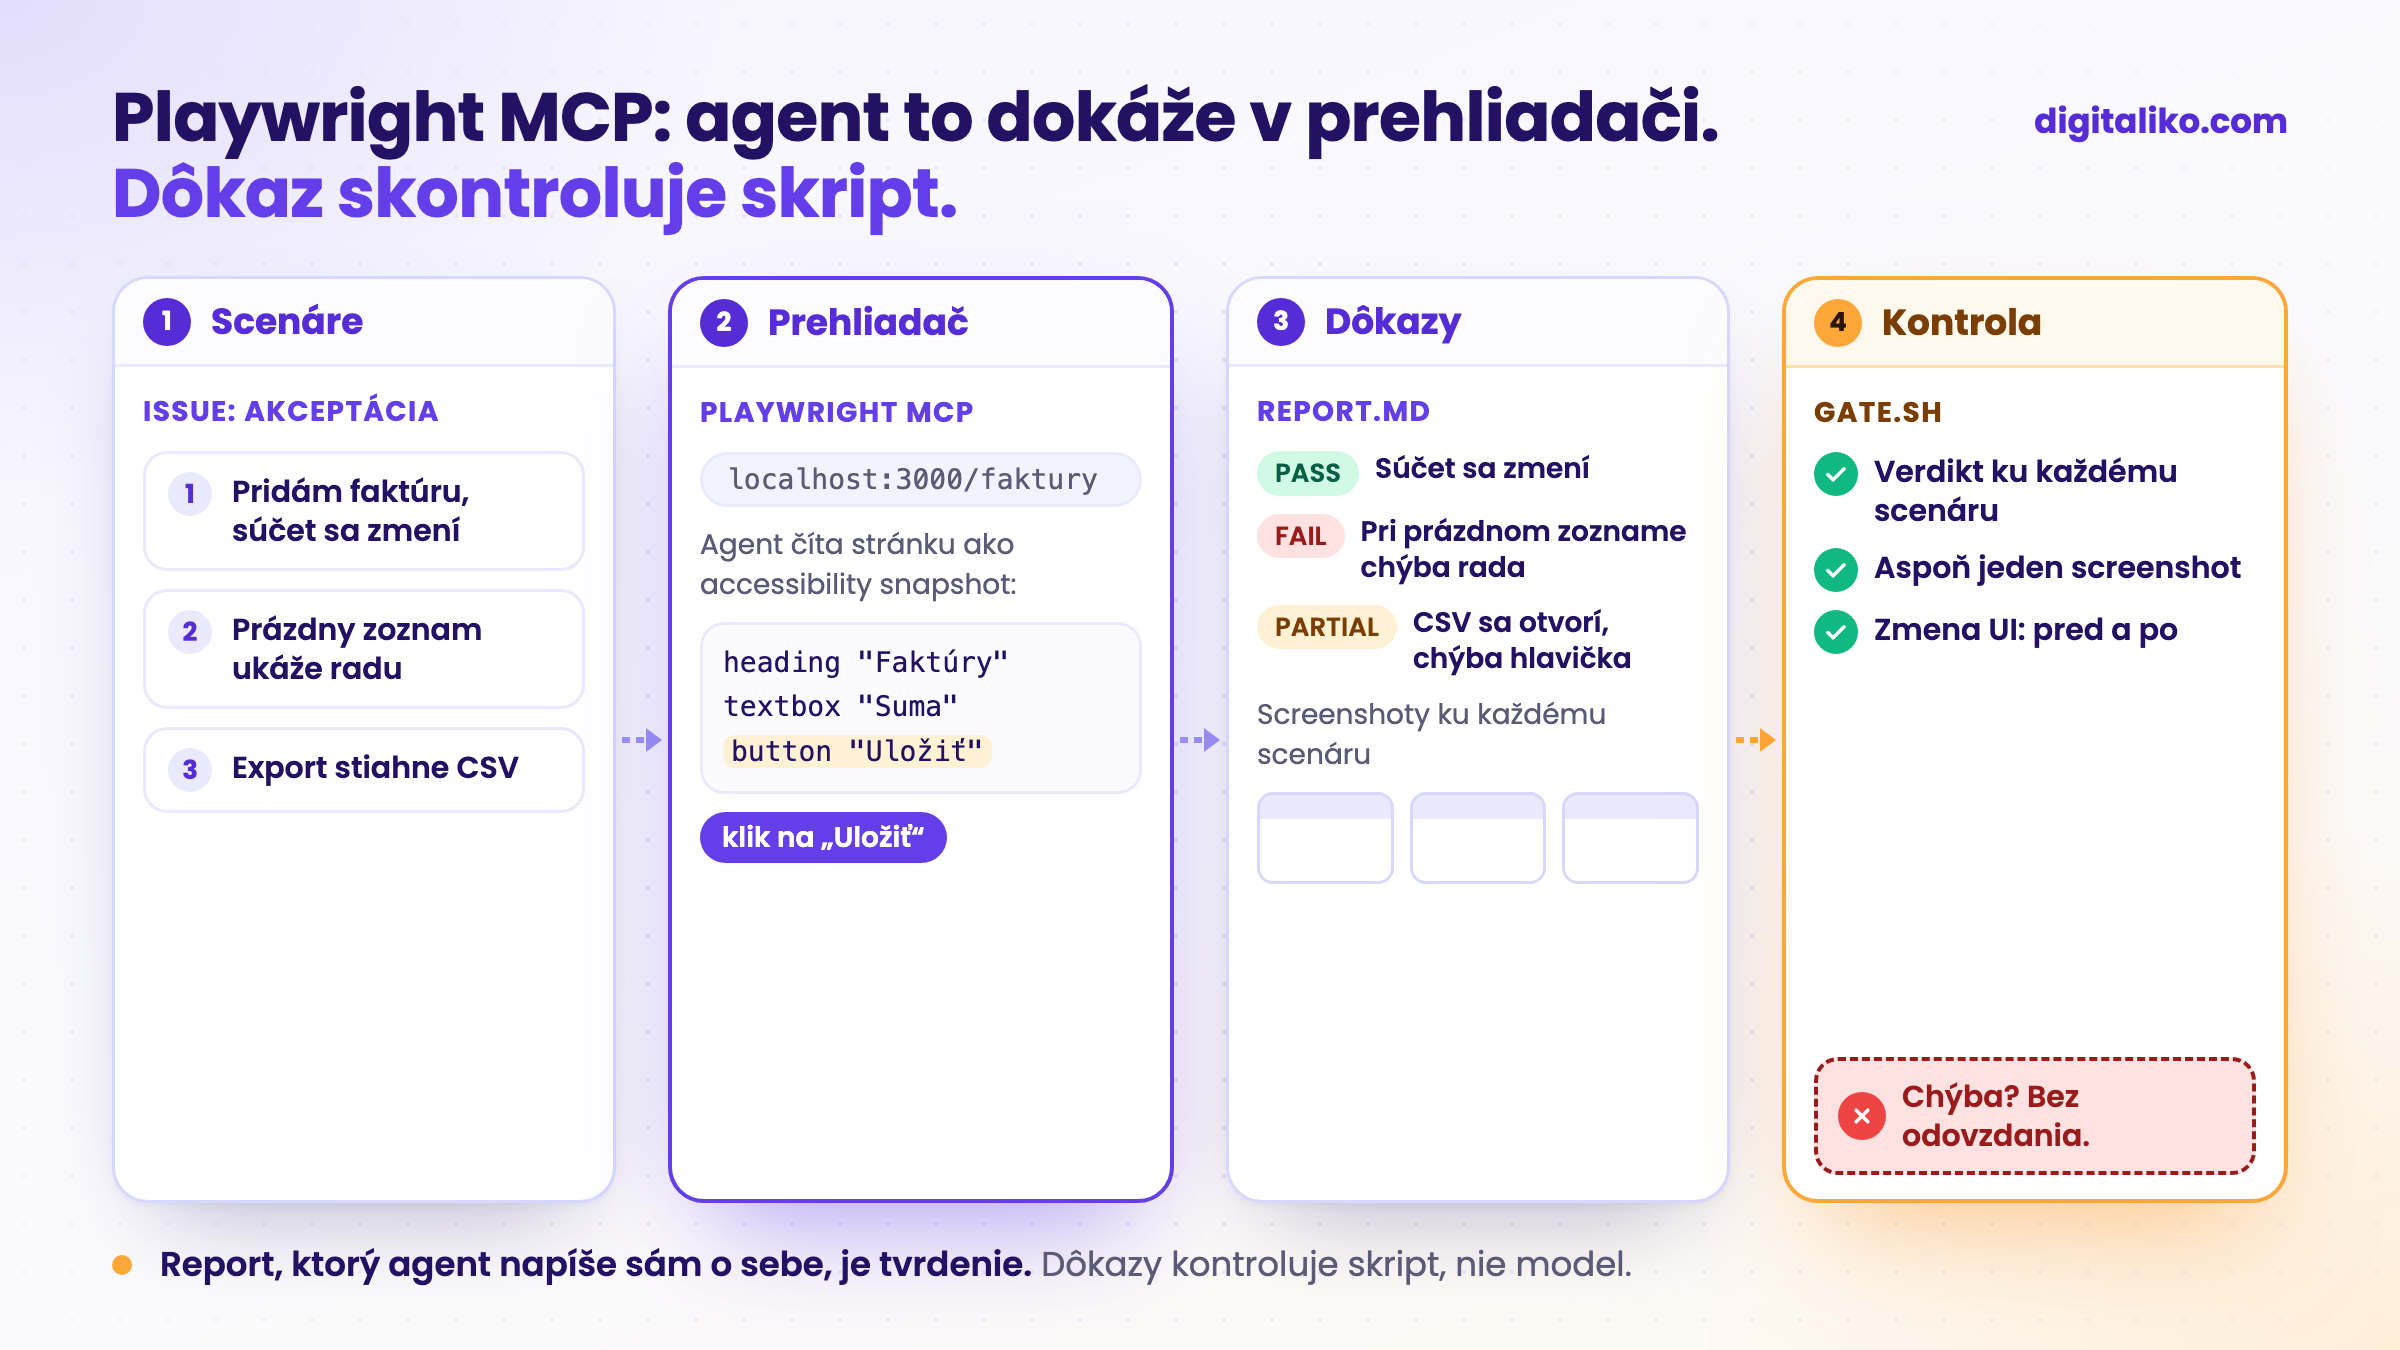
V našej slučke agentov QA úloha hovorí agentovi, aby použil nástroje prehliadača od Playwrightu a všetko uložil do evidence/<issue>/: screenshot pre každý scenár, chyby z konzoly a siete a report.md. Zvyšok urobí gate.sh, obyčajný bash skript s exit kódmi:
n=$(grep -cE '\b(PASS|FAIL|PARTIAL)\b' "$tree/$rep"); shots=$(ls "$tree/$(dirname "$rep")"/*.png 2>/dev/null | wc -l | tr -d ' ')
[ "$n" -gt 0 ] && [ "$shots" -gt 0 ] || { echo "FAIL: report needs PASS/FAIL per scenario and screenshots" >> "$out"; exit 1; }
Bez reportu, bez riadkov s verdiktom alebo bez screenshotu úloha nie je hotová, nech agent tvrdí čokoľvek.
Podobné pravidlo platí pre úlohy s kódom. Keď pull request mení UI súbory, slučka chce before-*.png a after-*.png. Ak je dobrý dôvod, prečo nie sú, PR to musí povedať v riadku, ktorý začína No screenshots:. Recenzent tak zmenu vidí, nemusí si ju predstavovať.
To pravidlo vzniklo z našej vlastnej chyby. Pred opravou stačil ako dôkaz akýkoľvek PNG, teda jeden screenshot čohokoľvek. Teraz musia byť dva a musia byť pomenované podľa toho, čo ukazujú.
Čo chytí kontrola v prehliadači, čo unit testy nie?
Unit test kladie úzku otázku v kontrolovanej miestnosti. Prehliadač sa pýta, či tá miestnosť vôbec existuje.
| Otázka | Unit alebo komponentový test | Agent v skutočnom prehliadači |
|---|---|---|
| Vráti funkcia správnu hodnotu? | Áno, rýchlo a opakovateľne | Len nepriamo |
| Je route napojená na komponent? | Nie, test si komponent pripojí sám | Áno, otvorí skutočnú adresu |
| Funguje to s dátami ako v produkcii? | Len s fixture, ktorú ste napísali | Áno, ak beží nad skutočnými dátami |
| Má tlačidlo názov, ktorý prečíta čítačka obrazovky? | Len ak niekto napísal taký test | Áno, ukáže to snapshot |
| Sú v konzole alebo v sieti chyby? | Kontroluje sa zriedka | Áno, číta oboje |
| Dáva postup zmysel zákazníkovi? | Nie | Čiastočne, s personou |
Platia oba stĺpce. Pravidlo red-green pre unit testy je v článku Red-green TDD s AI agentom. Kontrola v prehliadači stojí nad ním, nie namiesto neho.
Úprimne k limitom: nepočítali sme, koľko chýb chytia kontroly v prehliadači v porovnaní s testami. Vieme, aký druh chýb to je: veci, ktoré existujú až vtedy, keď je všetko pospájané.
Playwright MCP, Playwright skripty alebo Chrome DevTools MCP?
Aj tím Playwrightu hovorí, že MCP nie je vždy správny nástroj. Ich README odporúča coding agentom Playwright CLI so skillmi, lebo je „more token-efficient“. MCP podľa nich „remains relevant for specialized agentic loops“, napríklad na prieskumnú automatizáciu alebo dlhé autonómne behy.
To sedí s tým, čo vidíme my:
Playwright MCP
- Agent skúma a ďalší klik si volí sám
- Dobré na jednorazové overenie zmeny a na personu
- Spotrebuje kontext: schémy nástrojov a snapshoty stránok
Na všetko, čo opakujete
Playwright skripty a testy
- Tá istá kontrola pri každom behu, v CI
- Presné čísla: vypočítané farby, rozmery, časy
- Niekto ich musí najprv napísať, často agent
Chrome DevTools MCP
- Nástroje prehliadača s prístupom k DevTools
- To, čo náš interaktívny QA skill dnes skúša ako prvé
- Rovnaká metóda, iný ovládač
Keď sme tento týždeň robili audit tohto webu, MCP sme nepoužili vôbec. Agent napísal obyčajné Playwright skripty nad lokálnym buildom: kontrast textu z vypočítaných farieb, sken prístupnosti cez axe, každú stránku v šírke mobilu a výkon so spomaleným CPU. Sú to kontroly, ktoré chceme spustiť znova po každej zmene. Skript ich urobí zakaždým rovnako. Agent, ktorý improvizuje kliky, nie.
A od tohto týždňa náš interaktívny skill browser-qa skúša najprv Chrome DevTools MCP, ak ho session má. Metóda sa nezmenila vôbec. Ovládač prehliadača je vymeniteľná časť.
Kde sa to pokazí?
Pár pascí, ktoré poznáme z našich pravidiel alebo z vlastných chýb:
- Falošné dáta. Zelený prechod nad prázdnou databázou dokazuje rozloženie, nič viac. Skill zakazuje označiť to za hotové.
- Session token. Playwright MCP má nástroje, ktoré čítajú cookies a local storage. Naše pravidlo je staršie ako akýkoľvek nástroj: agent session token nikdy nevyťahuje, neloguje ani neposiela ďalej.
- Odhad od oka. „Súčet vyzerá dobre“ na screenshote je tip. Agent hodnotu prečíta zo stránky.
- Dvaja agenti, jeden profil. Trvalý profil môže naraz používať len jeden prehliadač. Paralelné behy potrebujú
--isolatedalebo vlastný priečinok profilu.
Čo sú Playwright agents a používame ich?
Playwright agents, oficiálne Playwright Test Agents, sú tri definície agentov, ktoré prichádzajú priamo s Playwrightom. Podľa dokumentácie Playwrightu (stav k 24. 10. 2026) planner „explores the app and produces a Markdown test plan“, generator „transforms the Markdown plan into the Playwright Test files“ a healer „executes the test suite and automatically repairs failing tests“. Do Claude Code ich pridáte jedným príkazom:
npx playwright init-agents --loop=claude
Planner vychádza zo seed testu tests/seed.spec.ts, ktorý pripraví prostredie, a plán zapíše do specs/. Generator z plánu spraví testy v tests/ a selektory aj asercie overuje naživo, kým prechádza scenáre.
Úprimne: Playwright agents sme v našich projektoch zatiaľ nepoužili. Naši agenti píšu Playwright testy z akceptačných kritérií issue v našej vlastnej slučke a skúmanie robí skill browser-qa. Planner a generator robia veľkú časť toho istého vo formáte Playwrightu, takže sa oplatí ich vyskúšať v tíme, ktorý vlastnú slučku nemá.
Pozor by sme si dali na healer. Podľa dokumentácie je jeho výstupom „a passing test, or a skipped test if the healer believes that functionality is broken“. V našej slučke preskočený test nič nedokazuje a test, ktorý je červený, lebo sa pokazil produkt, musí ostať červený. Ak healer skúsite, každý lokátor alebo aserciu, ktorú zmení, skontrolujte ako ktorýkoľvek iný pull request.
Je váš tím pripravený nechať agenta overovať v prehliadači?
Prejdite si, čo už máte:
Ak chcete hotový základ, náš verejný Claude Code production starter už v CI spúšťa Playwright smoke test a pri chybe nahrá report. Ako funguje celá slučka okolo, je v článku Harness engineering v praxi: AI agent od issue po PR.
Chcete agentov, ktorí vo vašom repozitári dokážu svoju prácu?
Kontroly v prehliadači, pravidlá pre dôkazy a CI okolo nich nastavujeme priamo v repozitári tímu v rámci služby AI-native SDLC pre vývojové tímy. Chýbajú vášmu tímu skôr ruky než proces? Pozrite si seniorského vývojára do vášho tímu. Dnes píše AI všetok náš kód a za to, čo ide do produkcie, ručí senior. Od roku 2023 sme dodali 15+ produkčných projektov.
Ozveme sa do dvoch pracovných dní a spolu vyberieme, čo vyriešime ako prvé.
Ak sa chcete najprv porozprávať, dohodnite si meeting na 15 minút s Filipom.
Kto vo vašom tíme dnes overuje, že zmena funguje v prehliadači, a ako to dokáže?
V skratke
- Playwright MCP dáva agentovi skutočný prehliadač, ktorý číta ako accessibility snapshot.
- Agent u nás prejde scenáre z issue nad skutočnými dátami a vráti PASS alebo FAIL so screenshotmi.
- Odovzdanie zastaví skript, nie model, keď report alebo screenshoty chýbajú.
- Skúmajte cez MCP. Kontroly, ktoré opakujete, prepíšte na Playwright testy v CI.
Časté otázky
Čo je Playwright MCP?
MCP server od Microsoftu, ktorý dáva AI agentovi nástroje prehliadača postavené na Playwrighte: otvoriť stránku, kliknúť, písať, vyplniť formulár, čítať konzolu a sieťové požiadavky, urobiť screenshot. Stránku agent číta ako accessibility snapshot, nie ako pixely.
Ako pridám Playwright MCP do Claude Code?
Príkazom claude mcp add playwright npx @playwright/mcp@latest. Iní MCP klienti používajú ten istý server s príkazom npx a argumentom @playwright/mcp@latest.
Nahradí Playwright MCP end-to-end testy?
Nie. MCP slúži na skúmanie a na jednorazové overenie jednej zmeny. Kontrola, ktorú chcete pri každom pull requeste, patrí do Playwright testu alebo skriptu v CI, kde sa nikto nemusí pýtať agenta.
Ako agent otestuje stránky za prihlásením?
Najprv sa človek prihlási v prehliadači, ktorý agent používa, a agent potom pracuje v tej session. Naše pravidlo: agent session token nikdy nečíta, neloguje ani nikomu neposiela. Pre izolované behy vie Playwright MCP načítať uložený storage state.
Stačí QA report od agenta na to, aby bola zmena hotová?
Len s dôkazmi: verdikt pre každý scenár a screenshoty vedľa neho. V našej slučke kontrolný skript zastaví odovzdanie, keď report alebo screenshoty chýbajú, a pull request aj tak skontroluje človek.
Opýtajte sa AI na tento článok
AI pri odpovedi využije aj naše ďalšie články a skúsenosti z reálnych projektov.
ChatGPTClaudePerplexity