Playwright vs Puppeteer na testy a scraping
Pro CTO a vývojářeWeb scraping a crawlery · Aktualizováno

Filip PapranecZakladatel, Digitaliko
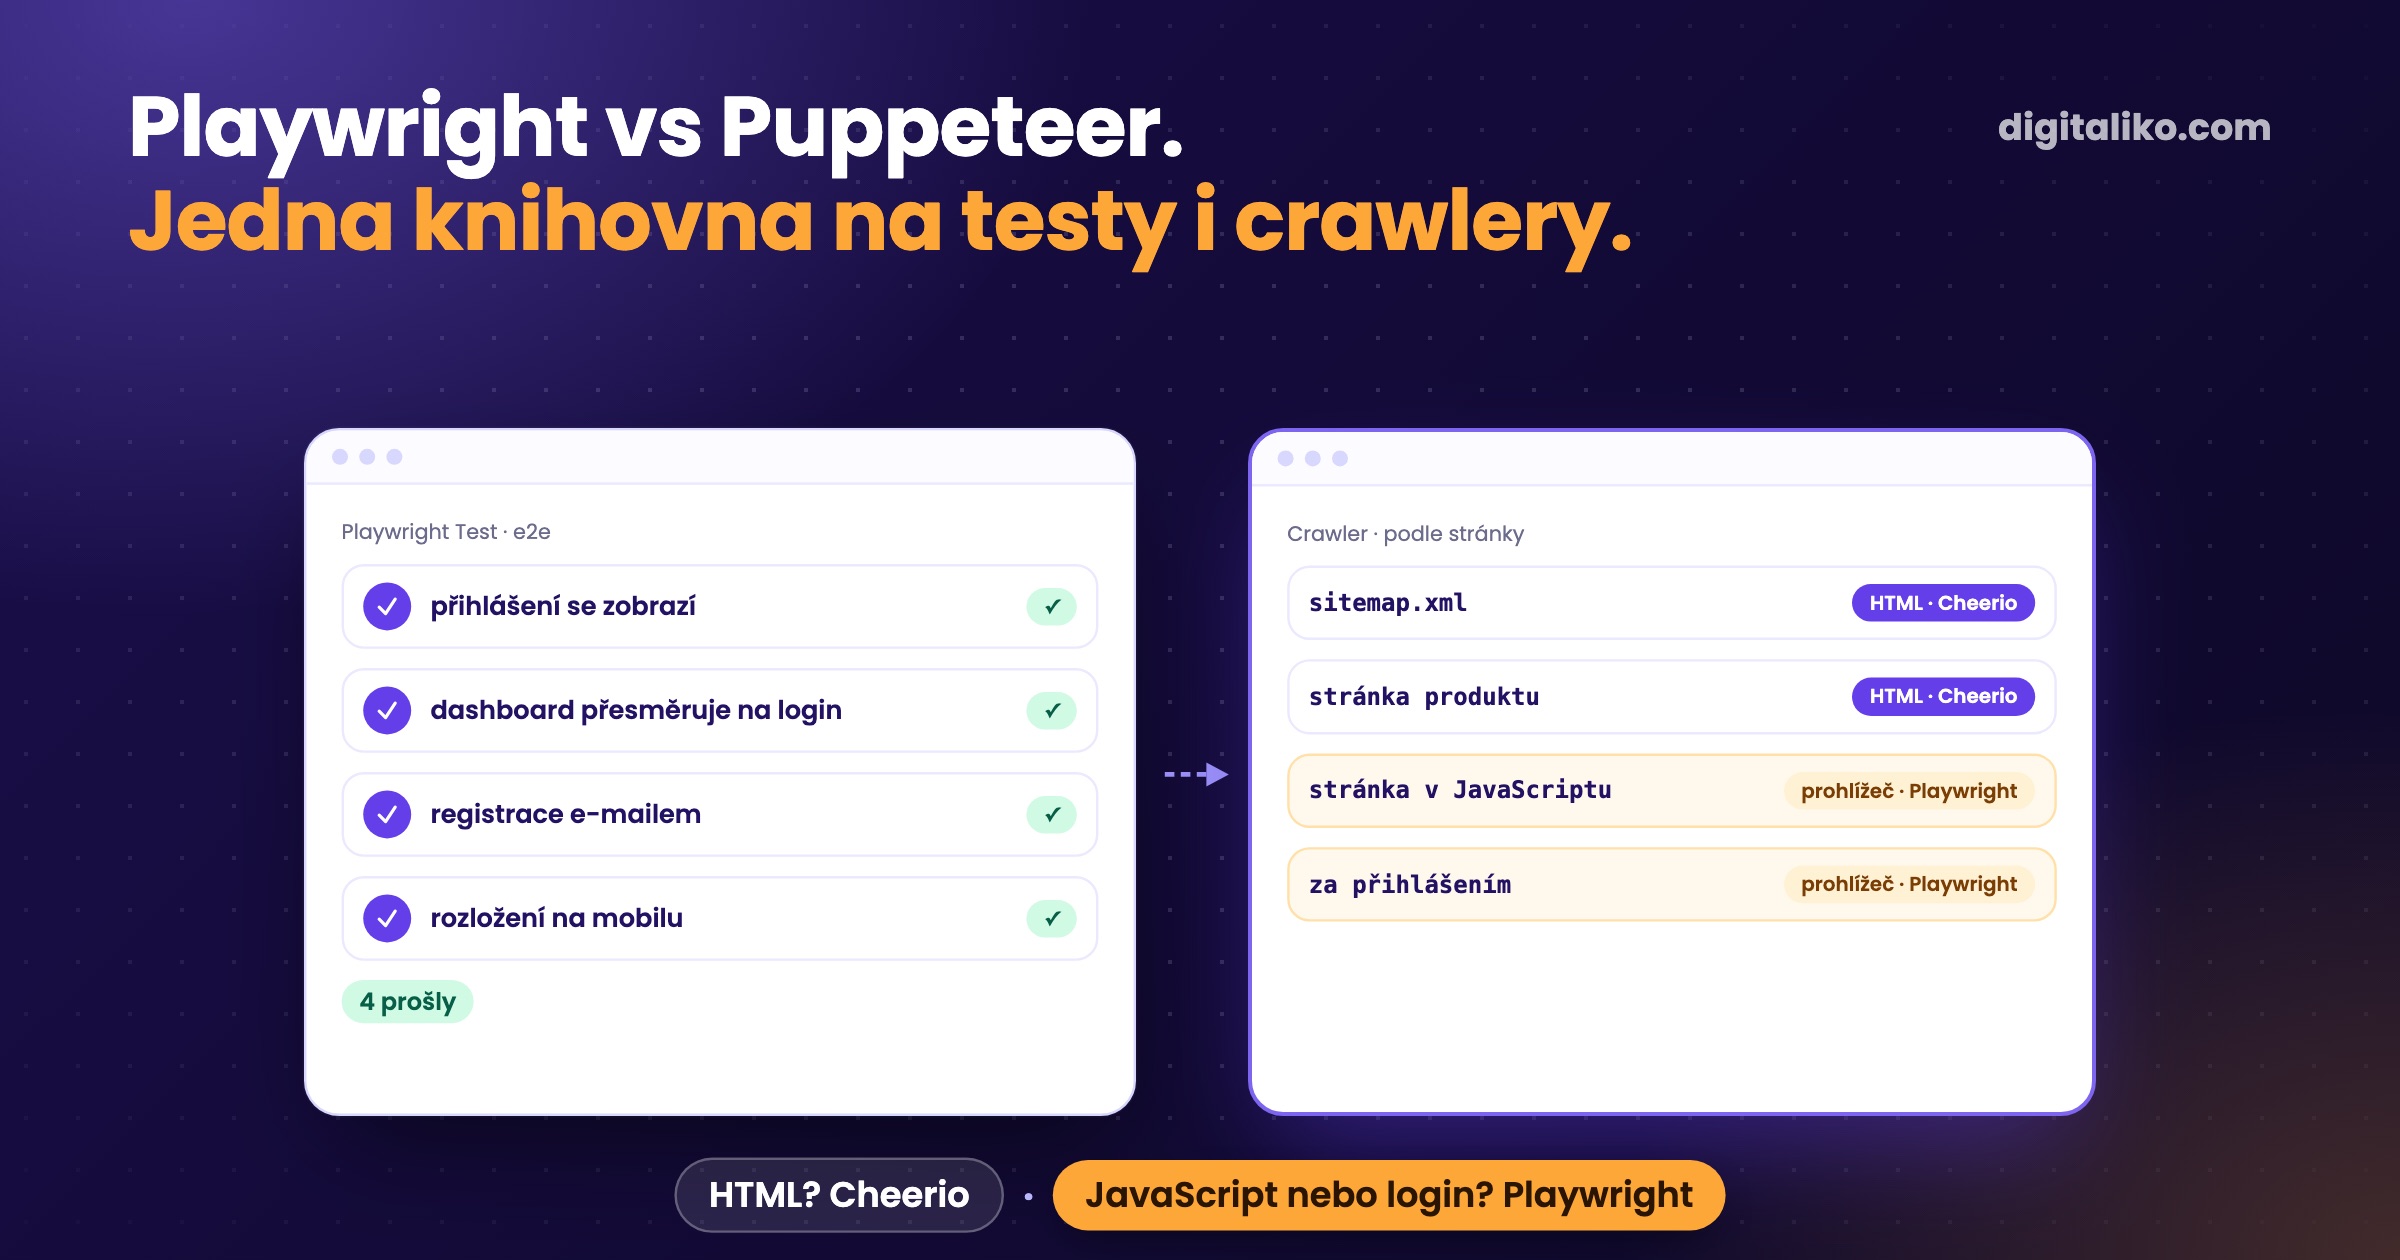
Playwright vs Puppeteer je otázka dvou úloh: testů a scrapingu. My používáme Playwright na obojí, na end-to-end testy, audit webu i na crawlery, které potřebují skutečný prohlížeč. Na novou práci bychom sáhli po Playwrightu, pokud neovládáte jen Chrome z Node skriptu a nemáte už fungující kód v Puppeteeru.
Nejdřív upřímně: Puppeteer máme jen v jednom starém projektu a nikdy jsme ty dva nástroje neporovnávali vedle sebe. Tenhle článek proto není benchmark. Ukazuje, co nám běží, proč nám stačil jeden nástroj, a rozhodnutí, které u scrapingu váží víc: jestli prohlížeč vůbec potřebujete.
Jaký je rozdíl mezi Playwright a Puppeteer?
Oba ovládají skutečný prohlížeč z kódu. Liší se dosahem. Puppeteer je podle vlastní dokumentace JavaScriptová knihovna, která ovládá Chrome nebo Firefox přes DevTools Protocol nebo WebDriver BiDi (pptr.dev, stav k 24. 10. 2026). Playwright podporuje Chromium, WebKit a Firefox na Windows, Linuxu i macOS (playwright.dev, stav k 24. 10. 2026).
| Playwright | Puppeteer | |
|---|---|---|
| Prohlížeče | Chromium, WebKit, Firefox | Chrome, Firefox |
| Jazyky | JavaScript/TypeScript, Python, Java, .NET (dokumentace) | JavaScript/TypeScript |
| Test runner | Playwright Test, v balíku | žádný, vlastní |
| Čekání | lokátory čekají samy | waitForSelector a podobné, ručně |
| V Crawlee | PlaywrightCrawler | PuppeteerCrawler |
| Kde ho používáme | e2e testy, audity, crawlery | jeden starý projekt |
Zdroje tabulky: stránky výše a návod Playwrightu na migraci z Puppeteeru, vše stav k 24. 10. 2026.
U nás rozhodl řádek s test runnerem. Jedna knihovna, která dá prohlížeč i test runner, znamená jeden nástroj na učení, jednu instalaci prohlížeče v CI a jednu sadu selektorů.
Jak používáme Playwright na testy?
Na třech místech, od nejpřísnějšího po nejvolnější.
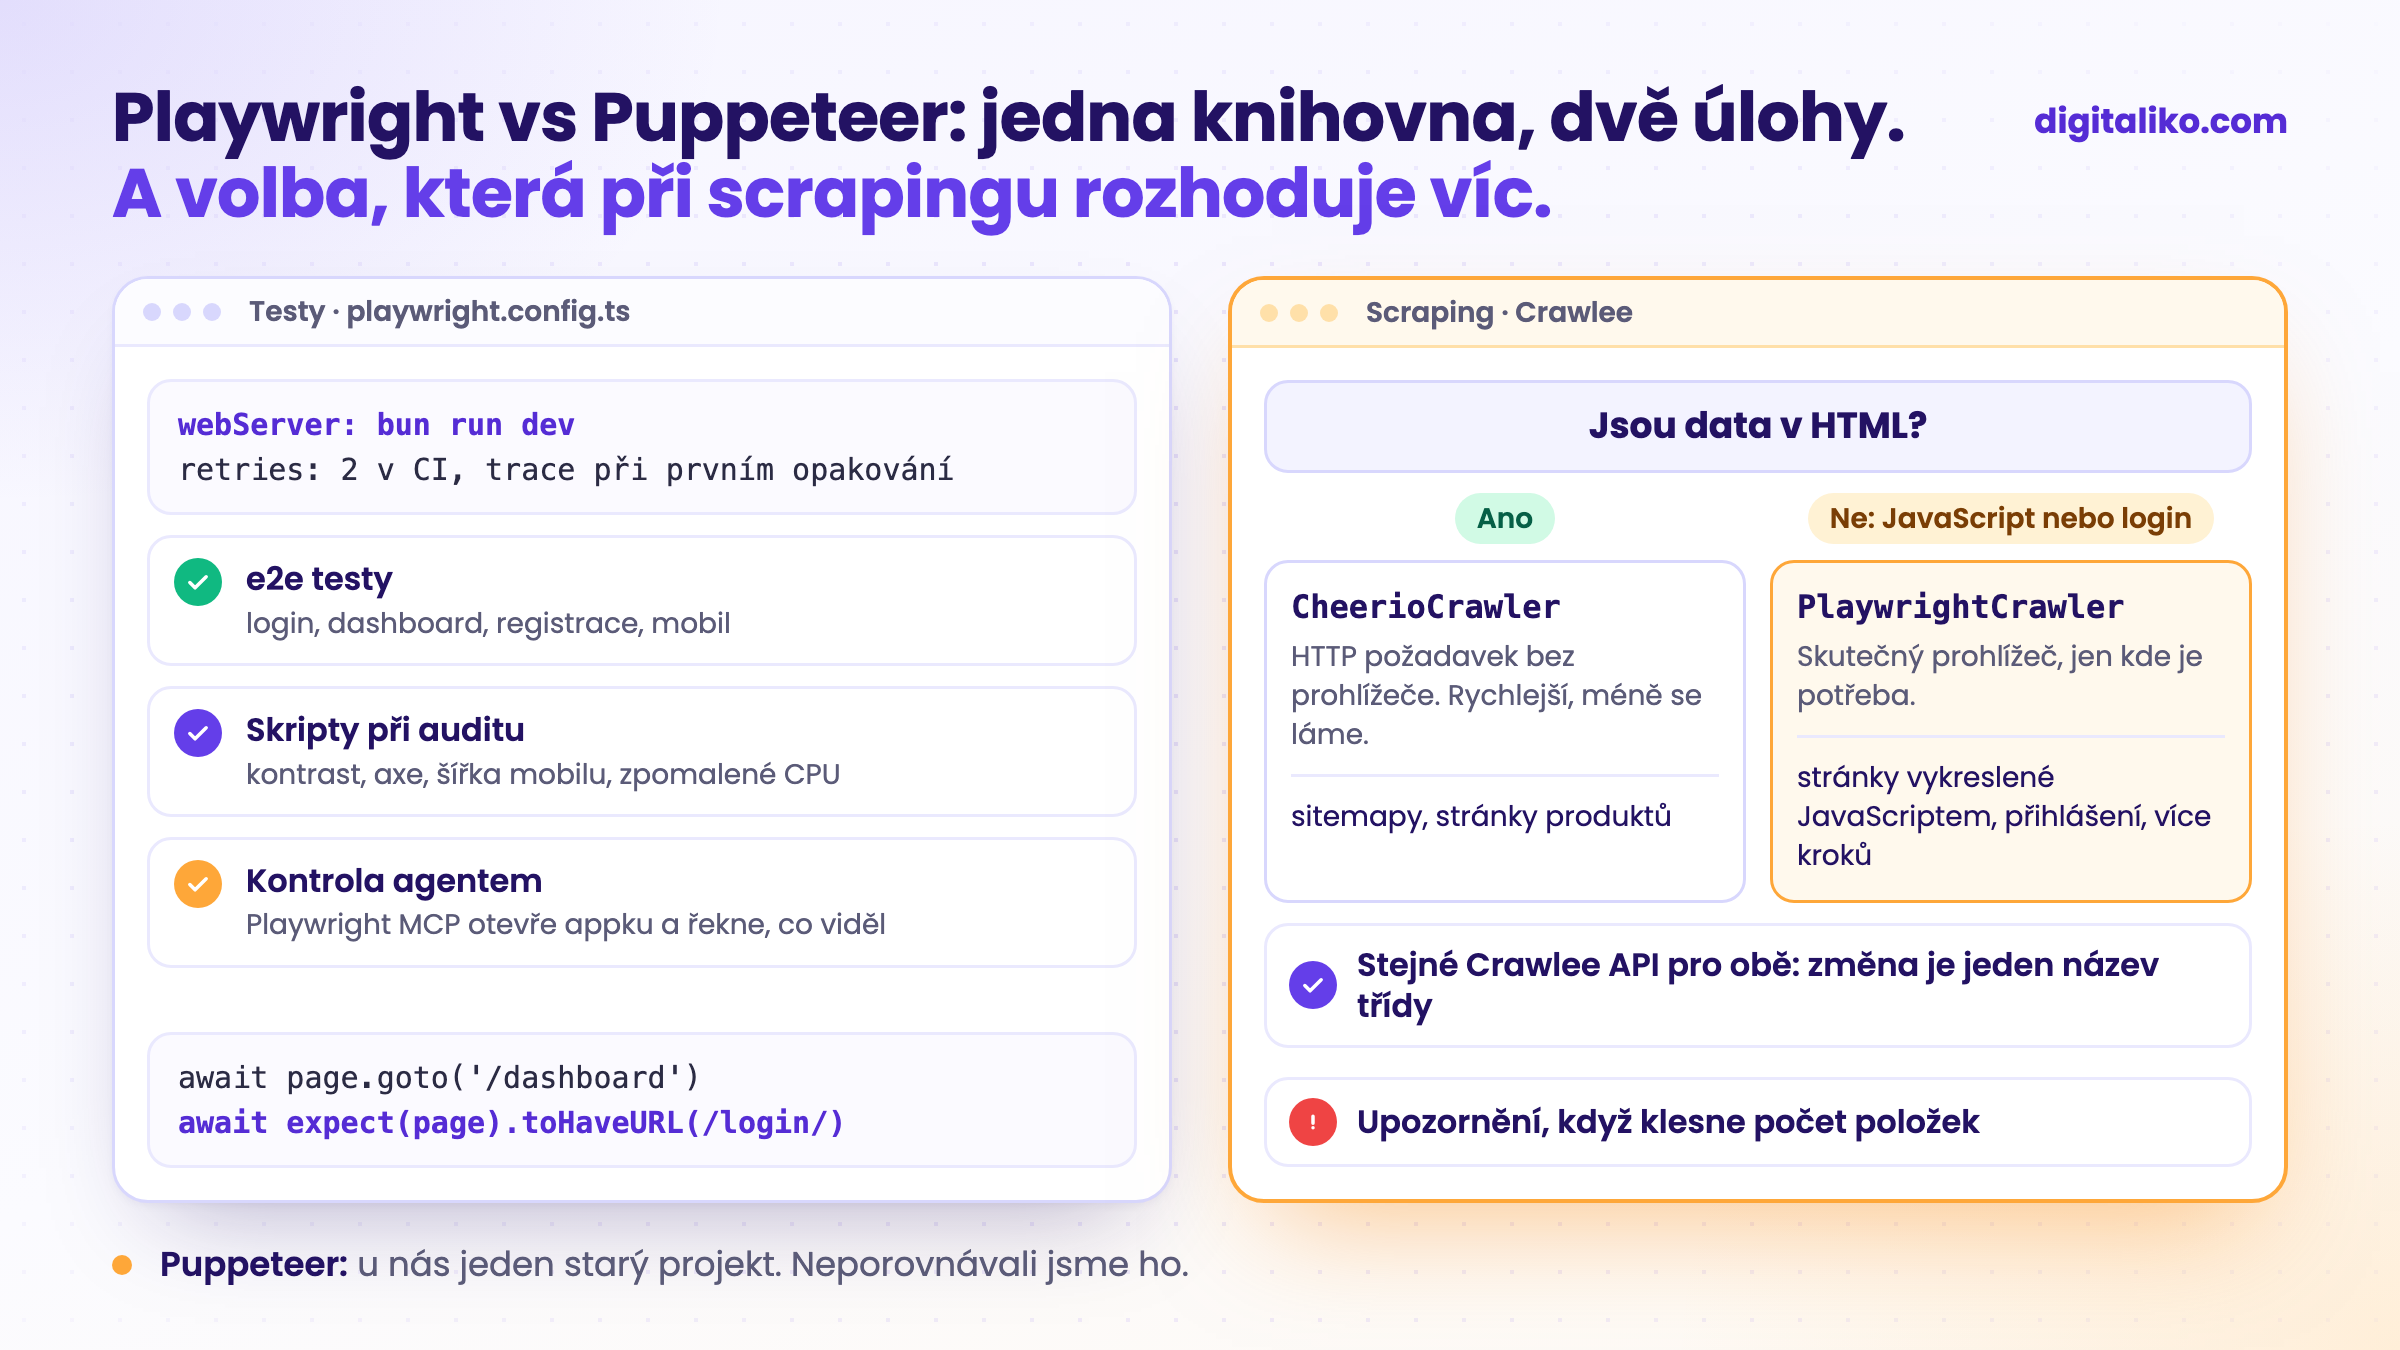
End-to-end testy. Naše startovací šablona pouští Playwright Test proti dev serveru. Zkrácená konfigurace:
// playwright.config.ts
import { defineConfig } from '@playwright/test'

export default defineConfig({
  testDir: './e2e',
  forbidOnly: !!process.env.CI,
  retries: process.env.CI ? 2 : 0,
  use: { baseURL: 'http://localhost:3001', trace: 'on-first-retry' },
  projects: [{ name: 'chromium', use: { browserName: 'chromium' } }],
  webServer: { command: 'bun run dev', url: 'http://localhost:3001', reuseExistingServer: !process.env.CI },
})
A jeden z testů:
test('dashboard redirects to login when not authenticated', async ({ page }) => {
  await page.goto('/dashboard')
  await expect(page).toHaveURL(/login/)
})
Žádné uspávání, žádné ruční čekání. expect(page).toHaveURL zkouší znovu, dokud neprojde nebo nevyprší čas. Přesně tohle byste v Puppeteeru psali sami.
Audit webu. Když jsme auditovali tenhle web, kontroly byly obyčejné Playwright skripty: kontrast textu z vypočtených barev, pravidla přístupnosti z axe, rozložení na šířce mobilu, načítání při zpomaleném CPU. Jednorázové skripty, ne testovací sada.
AI agent kontroluje vlastní změnu. Agent otevře aplikaci přes Playwright MCP a napíše, co viděl. Jak to funguje, je v článku Playwright MCP: AI agent ověří změnu v prohlížeči.
Jak používáme Playwright na scraping?
Přes Crawlee, které obaluje obě knihovny. Crawlee má podle dokumentace tři hlavní třídy crawlerů: CheerioCrawler, PuppeteerCrawler a PlaywrightCrawler (crawlee.dev, stav k 24. 10. 2026). Výměna Puppeteeru za Playwright je tam hlavně název třídy. Skutečná volba je o krok dřív: HTTP, nebo prohlížeč.
Náš produkční crawler, který musí projít stránkou plnou JavaScriptu, používá PlaywrightCrawler. Zjednodušeně:
import { PlaywrightCrawler } from 'crawlee'
import { router } from './routes.js'

const crawler = new PlaywrightCrawler({
  maxRequestsPerCrawl,
  requestHandlerTimeoutSecs: 360,
  navigationTimeoutSecs: 60,
  maxRequestRetries: 4,
  requestHandler: router,
  launchContext: {
    launchOptions: { args: ['--disable-gpu'] }, // pády GPU v Dockeru
  },
})

await crawler.run(startUrls)
Crawler pro klienta s online marketplace prohlížeč nemá vůbec. Sitemapy a stránky produktů čte přes CheerioCrawler, protože data jsou v HTML. Jeden klientský prototyp kombinuje obojí: Cheerio na veřejné seznamy, Playwright jen na kroky za přihlášením.
Jak se rozhodujeme u každého typu stránky:
01
Otevřete stránku s vypnutým JavaScriptem
Nebo ji stáhněte přes curl. Pokud jsou potřebná data v HTML, prohlížeč není potřeba.
02
Podívejte se, jestli nejde JSON požadavek
Hodně stránek v JavaScriptu si data tahá z API. Zavolat ho přímo je lepší než stránku vykreslovat.
03
Kde to jde, použijte Cheerio
HTTP crawler je rychlejší, sní méně paměti a láme se méně často než prohlížeč.
04
Kde je to nutné, použijte Playwright
Stránky vykreslované v prohlížeči, přihlášení a postupy na více kroků dostanou PlaywrightCrawler.
05
Hlídejte to v obou případech
Crawler, který potichu přestane, stojí víc než špatná knihovna. Upozornění, když klesne počet položek.
Poslední krok není teorie. Když v prosinci 2025 umřel crawler marketplace, měsíční zobrazení klesla z 250 000 na 66 000 dřív, než si toho někdo všiml. Byl to Cheerio crawler, takže knihovna problém nebyla. Chybělo upozornění. Celý příběh je v článku Crawlee na web scraping: co se rozbije v produkci.
Proč jsme Puppeteer nikdy nepotřebovali?
Protože když už byl v repozitáři Playwright, každou úlohu, kterou jsme měli, pokryl. Testy potřebovaly runner, Playwright ho má. Crawlery potřebovaly prohlížeč jen na některých stránkách a Crawlee nám dá Playwright i Cheerio za jedním API. Druhá knihovna na prohlížeč by přidala instalaci, ne schopnost.
The APIs have similarities, but Playwright offers much more possibilities for web testing and cross-browser automation.
Tu větu napsal tým Playwrightu, takže je to pohled dodavatele. Na práci jen s Chromem zůstává Puppeteer rozumná volba.
Kdy by byl lepší volbou Puppeteer?
Podle dokumentace, ne podle našich běhů:
- Potřebujete jen Chrome z Node skriptu a máte fungující kód v Puppeteeru. Přepis vám dá málo.
- Pracujete blízko Chrome DevTools Protocol a chcete knihovnu postavenou kolem něj.
- Testy už běží v jiném frameworku a potřebujete jen ovladač prohlížeče, ne runner.
Pokud potřebujete i WebKit, Python nebo test runner v tomtéž nástroji, pokryje to Playwright. Podle jeho návodu jde většina API z Puppeteeru při migraci použít tak, jak je, takže přechod bývá malý.
Playwright, nebo Puppeteer: co na váš projekt?
Odpovězte si dřív, než vyberete. Každé „ano“ ukazuje na Playwright:
Potřebujete testy nebo crawler, který v produkci vydrží?
Automatizace a crawlery, které běží samy a řeknou vám, když se zastaví, stavíme v rámci služby automatizace firmy. AI dnes píše veškerý náš kód a za výsledek ručí senior. Od roku 2023 jsme dodali 15+ produkčních projektů.
Ozveme se do dvou pracovních dnů a společně vybereme, co vyřešíme jako první.
Pokud si chcete nejdřív promluvit, domluvte si meeting na 15 minut s Filipem.
Které vaše stránky opravdu potřebují prohlížeč?
Ve zkratce
- Playwright ovládá Chromium, WebKit i Firefox a má vlastní test runner. Puppeteer ovládá Chrome a Firefox z JavaScriptu.
- Playwright nám běží v e2e testech, auditech, kontrolách agentem a v crawlerech, které potřebují prohlížeč.
- U scrapingu je větší volba HTTP s Cheeriem, nebo skutečný prohlížeč, stránku po stránce.
- Puppeteer jsme neměřili. Fungující skript jen pro Chrome si nechte.
Časté otázky
Jaký je rozdíl mezi Playwright a Puppeteer?
Puppeteer je JavaScriptová knihovna pro Chrome a Firefox. Playwright ovládá Chromium, WebKit i Firefox, má verze pro JavaScript, Python, Javu a .NET a vlastní test runner s lokátory, které čekají samy. Na novou práci s testy nebo více prohlížeči pokryje víc Playwright.
Je Playwright lepší než Puppeteer na web scraping?
U scrapingu je důležitější, jestli prohlížeč vůbec potřebujete. Většina stránek, které crawlujeme, je čisté HTML a jde do HTTP crawleru s Cheeriem. Prohlížeč dostanou jen stránky vykreslené JavaScriptem nebo za přihlášením, a tam používáme Playwright přes Crawlee. Výkon proti Puppeteeru jsme neměřili.
Dá se přejít z Puppeteeru na Playwright?
Ano. Playwright má návod na migraci a píše, že většinu API z Puppeteeru lze použít tak, jak je. Větší změna je přechod z element handlů a ručního čekání na lokátory a web-first aserce.
Podporuje Puppeteer Firefox a Safari?
Puppeteer ovládá Chrome nebo Firefox přes DevTools Protocol nebo WebDriver BiDi. WebKit neovládá, takže na testy chování v Safari je potřeba Playwright nebo jiný nástroj.
Potřebuji na web scraping headless prohlížeč?
Často ne. Pokud jsou data v HTML, které vrátí server, stačí HTTP požadavek a parser HTML. Je to rychlejší a levnější na provoz. Prohlížeč použijte jen u stránek, které data vykreslují JavaScriptem nebo jsou za přihlášením.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity