Crawlee na web scraping: co se rozbije v produkci
Pro CTO a vývojářeWeb scraping a crawlery · Aktualizováno

Filip Papraneczakladatel Digitaliko
Crawlee je open-source knihovna na web crawling a scraping. Její dokumentace slibuje, že „covers your crawling and scraping end-to-end“, tedy pokryje crawling a scraping od začátku do konce: rychlý HTTP crawling s Cheerio nebo JSDOM, skutečné prohlížeče s Playwright nebo Puppeteer za stejným rozhraním, trvalou frontu požadavků, opakování pokusů, sessions a střídání proxy. Crawler s ní rozjedete rychle. Udržet ho v chodu je ta těžší část.
Naučili jsme se to na crawleru na Crawlee, který provozujeme pro klienta s online marketplace. V prosinci 2025 crawler umřel a zjistili jsme to pozdě, až z grafu. Níže je, jak Crawlee používáme, co se v produkci rozbilo a jaké kontroly jsme přidali.
Co je Crawlee a který crawler si vybrat?
Crawlee řeší instalatérskou práci, kterou potřebuje každý crawler: frontu URL, která přežije restart, opakování pokusů, limity souběžnosti, sessions a proxy. Vy napíšete handler, který ze stránky udělá záznam.
Hlavní volba je třída crawleru:
Začněte tady
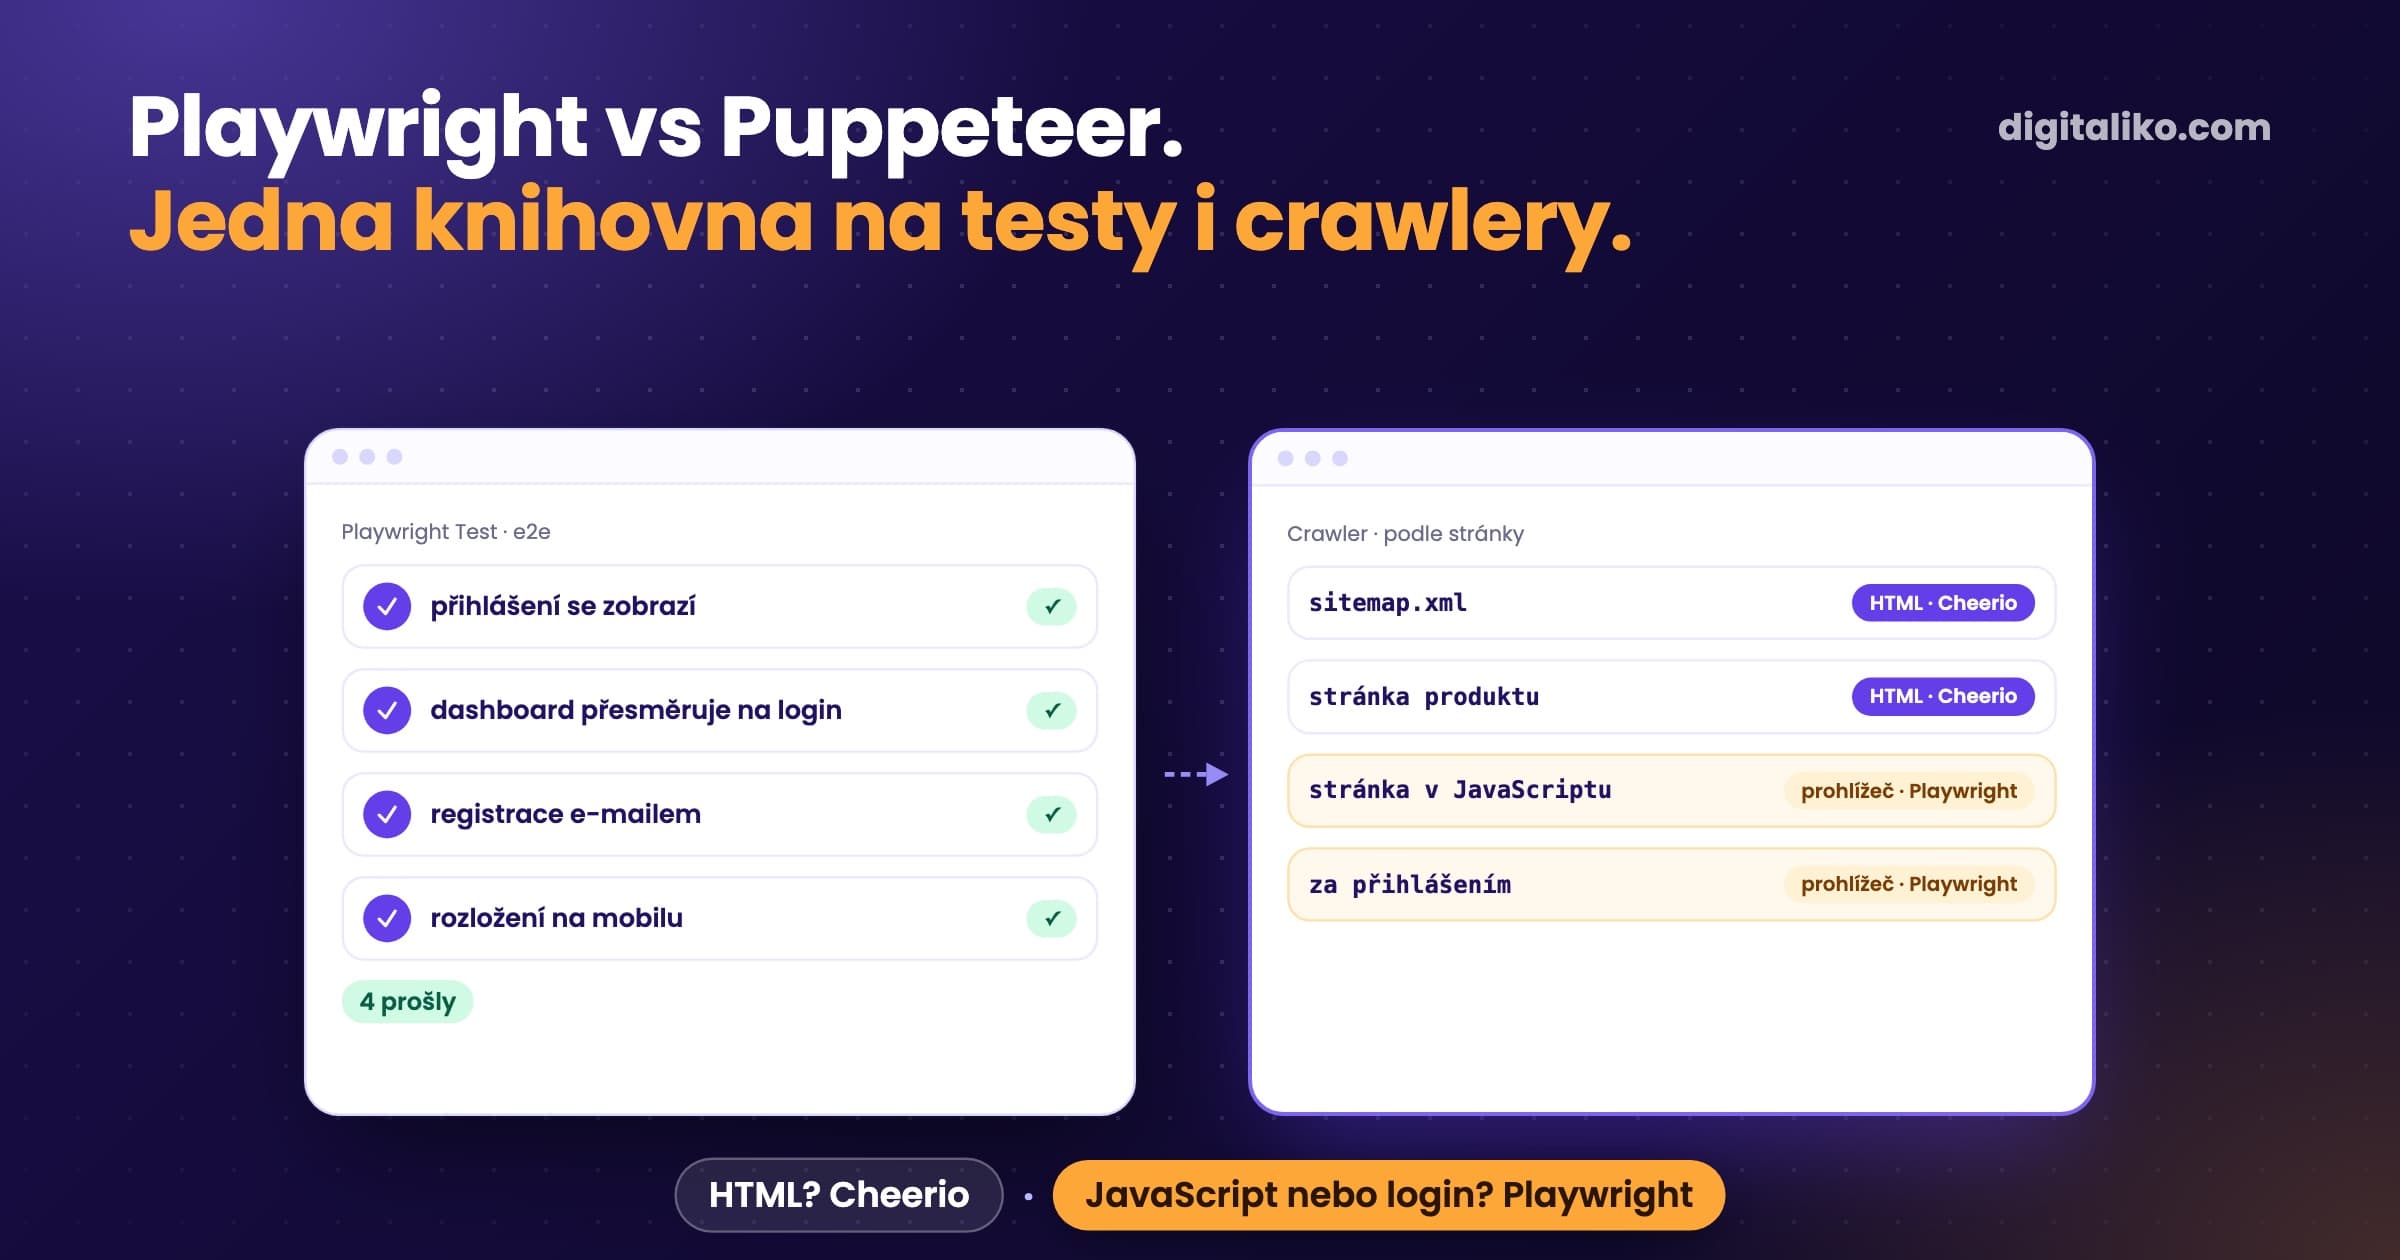
CheerioCrawler
- Stáhne HTML a rozparsuje ho.
- Rychlý a nenáročný na paměť.
- Stačí na stránky vykreslené na serveru a sitemapy.
- Tohle používáme u většiny zdrojů.
PlaywrightCrawler
- Spustí skutečný prohlížeč.
- Na stránky poskládané JavaScriptem nebo za klikáním.
- Pomalejší a těžší na stránku.
- Jen tam, kde HTML nestačí.
Oba používají stejný router i frontu požadavků. Můžete začít s Cheerio a jeden těžký zdroj později přesunout do prohlížeče.
Jak vypadá minimální crawler na Crawlee?
Router se dvěma handlery: stránky se seznamem zařadí detaily do fronty, stránky s detailem uloží záznam.
import { CheerioCrawler, createCheerioRouter, Dataset } from 'crawlee'

const router = createCheerioRouter()

router.addDefaultHandler(async ({ enqueueLinks }) => {
  await enqueueLinks({ selector: 'a.listing', label: 'DETAIL' })
})

router.addHandler('DETAIL', async ({ request, $ }) => {
  await Dataset.pushData({
    url: request.loadedUrl,
    title: $('h1').text().trim(),
    price: $('.price').text().trim(),
  })
})

const crawler = new CheerioCrawler({
  requestHandler: router,
  maxConcurrency: 4,
  maxRequestRetries: 2,
  failedRequestHandler: async ({ request }) => console.error('gave up', request.url),
})

await crawler.run(['https://example.com/listings'])
Naše produkční crawlery k tomu přidávají jednu myšlenku. Začínají ze sitemap a pamatují si, kde poslední běh skončil, takže každý běh stáhne jen to, co se od té doby změnilo. Procházet při každém běhu celý velký katalog je přesně způsob, jak crawler narazí na časový limit.
Co se rozbije v produkci?
Ani jedno z toho nebyla chyba Crawlee. Je to to, co se děje kolem každého crawleru, který běží každý den:
| Co se stalo | Co jsme viděli | Co jsme přidali |
|---|---|---|
| Běh skončil zeleně a neuložil skoro nic | zelený dashboard, zmenšující se katalog | kontrolu výnosu: nové záznamy ve srovnání s posledními běhy |
| Plánovač spustil běh, zatímco předchozí visel | zaseknuté běhy, které držely spojení do databáze | zámek pro každý zdroj a tvrdý časový limit na běh |
| Proces byl násilně ukončený | běh navždy označený jako běžící | krok, který před každým během označí staré běhy jako selhané |
| Hledání URL nikdy neskončilo | časový limit bez jediného uloženého záznamu | časového strážce na hledání, inkrementální sitemapy |
| Placené API při obohacování vrátilo chybu platby | worker skončil jako úspěšný | samostatnou kontrolu zdraví, která na to upozorní |
| Plán v repozitáři nebyl ten na serveru | běhy ve špatnou dobu | plán synchronizovaný z repozitáře na server |
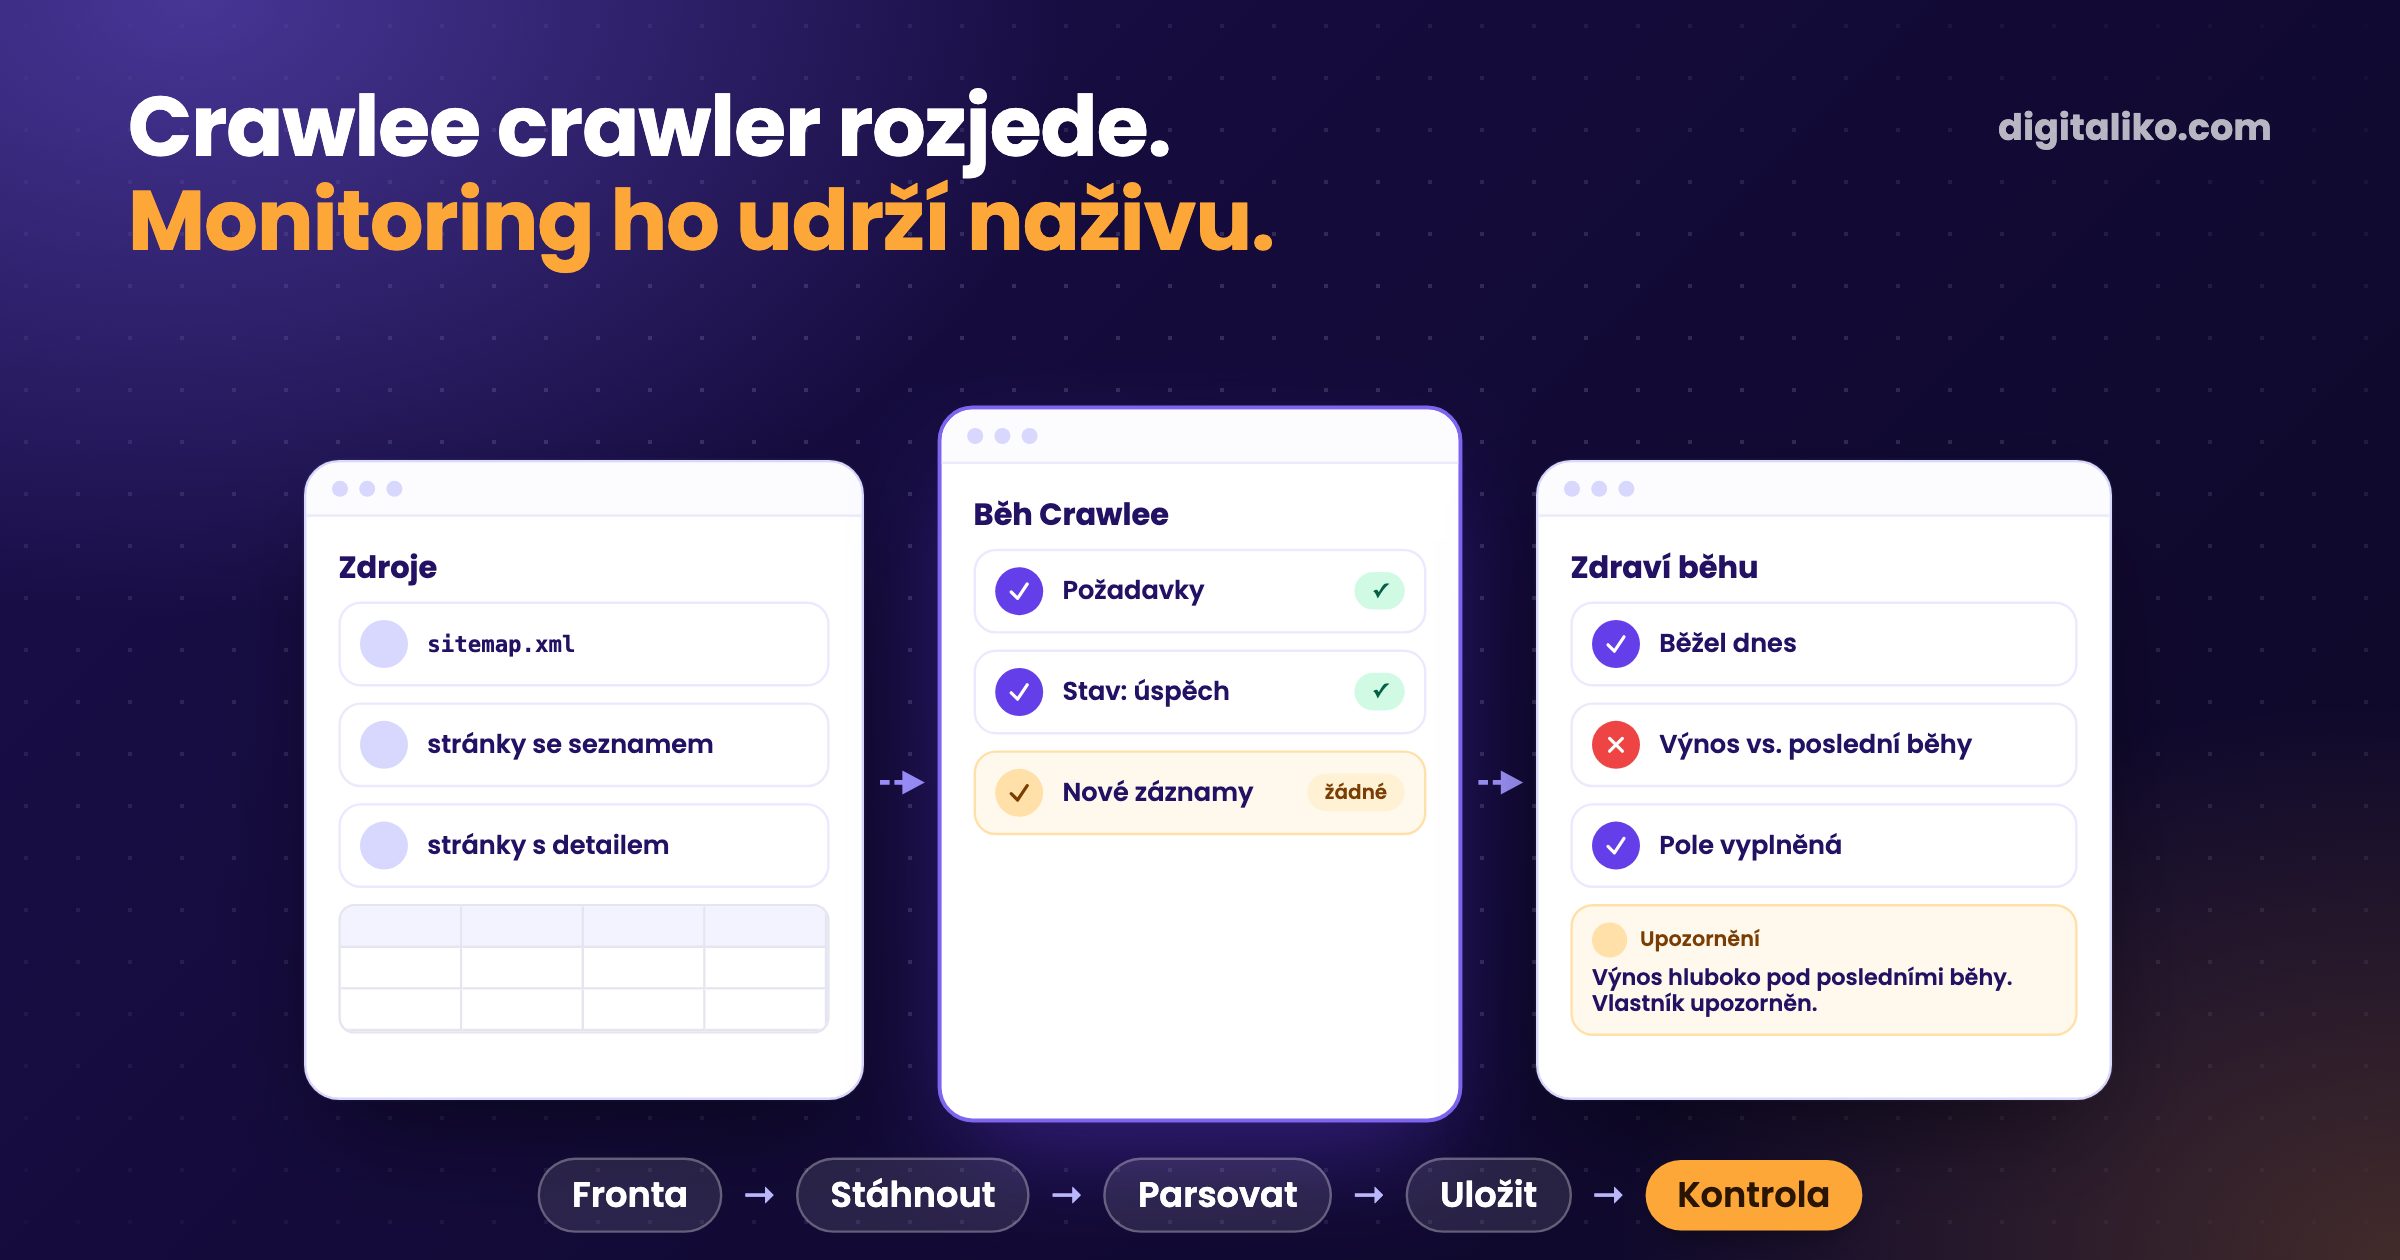
Ten první řádek bolel nejvíc. Náš monitorovací kód dnes začíná přesně tímhle případem: crawl, který doběhne zeleně, ale nepřinese skoro žádné nové inzeráty.
Jak monitorovat crawler na Crawlee?
Crawlee vám řekne o požadavcích, které selhaly. Po vyčerpání pokusů skončí požadavek ve failedRequestHandler a můžete ho zalogovat nebo spočítat. Neřekne vám ale, že běh, který uspěl, nepřinesl nic. Tahle kontrola je na vás.
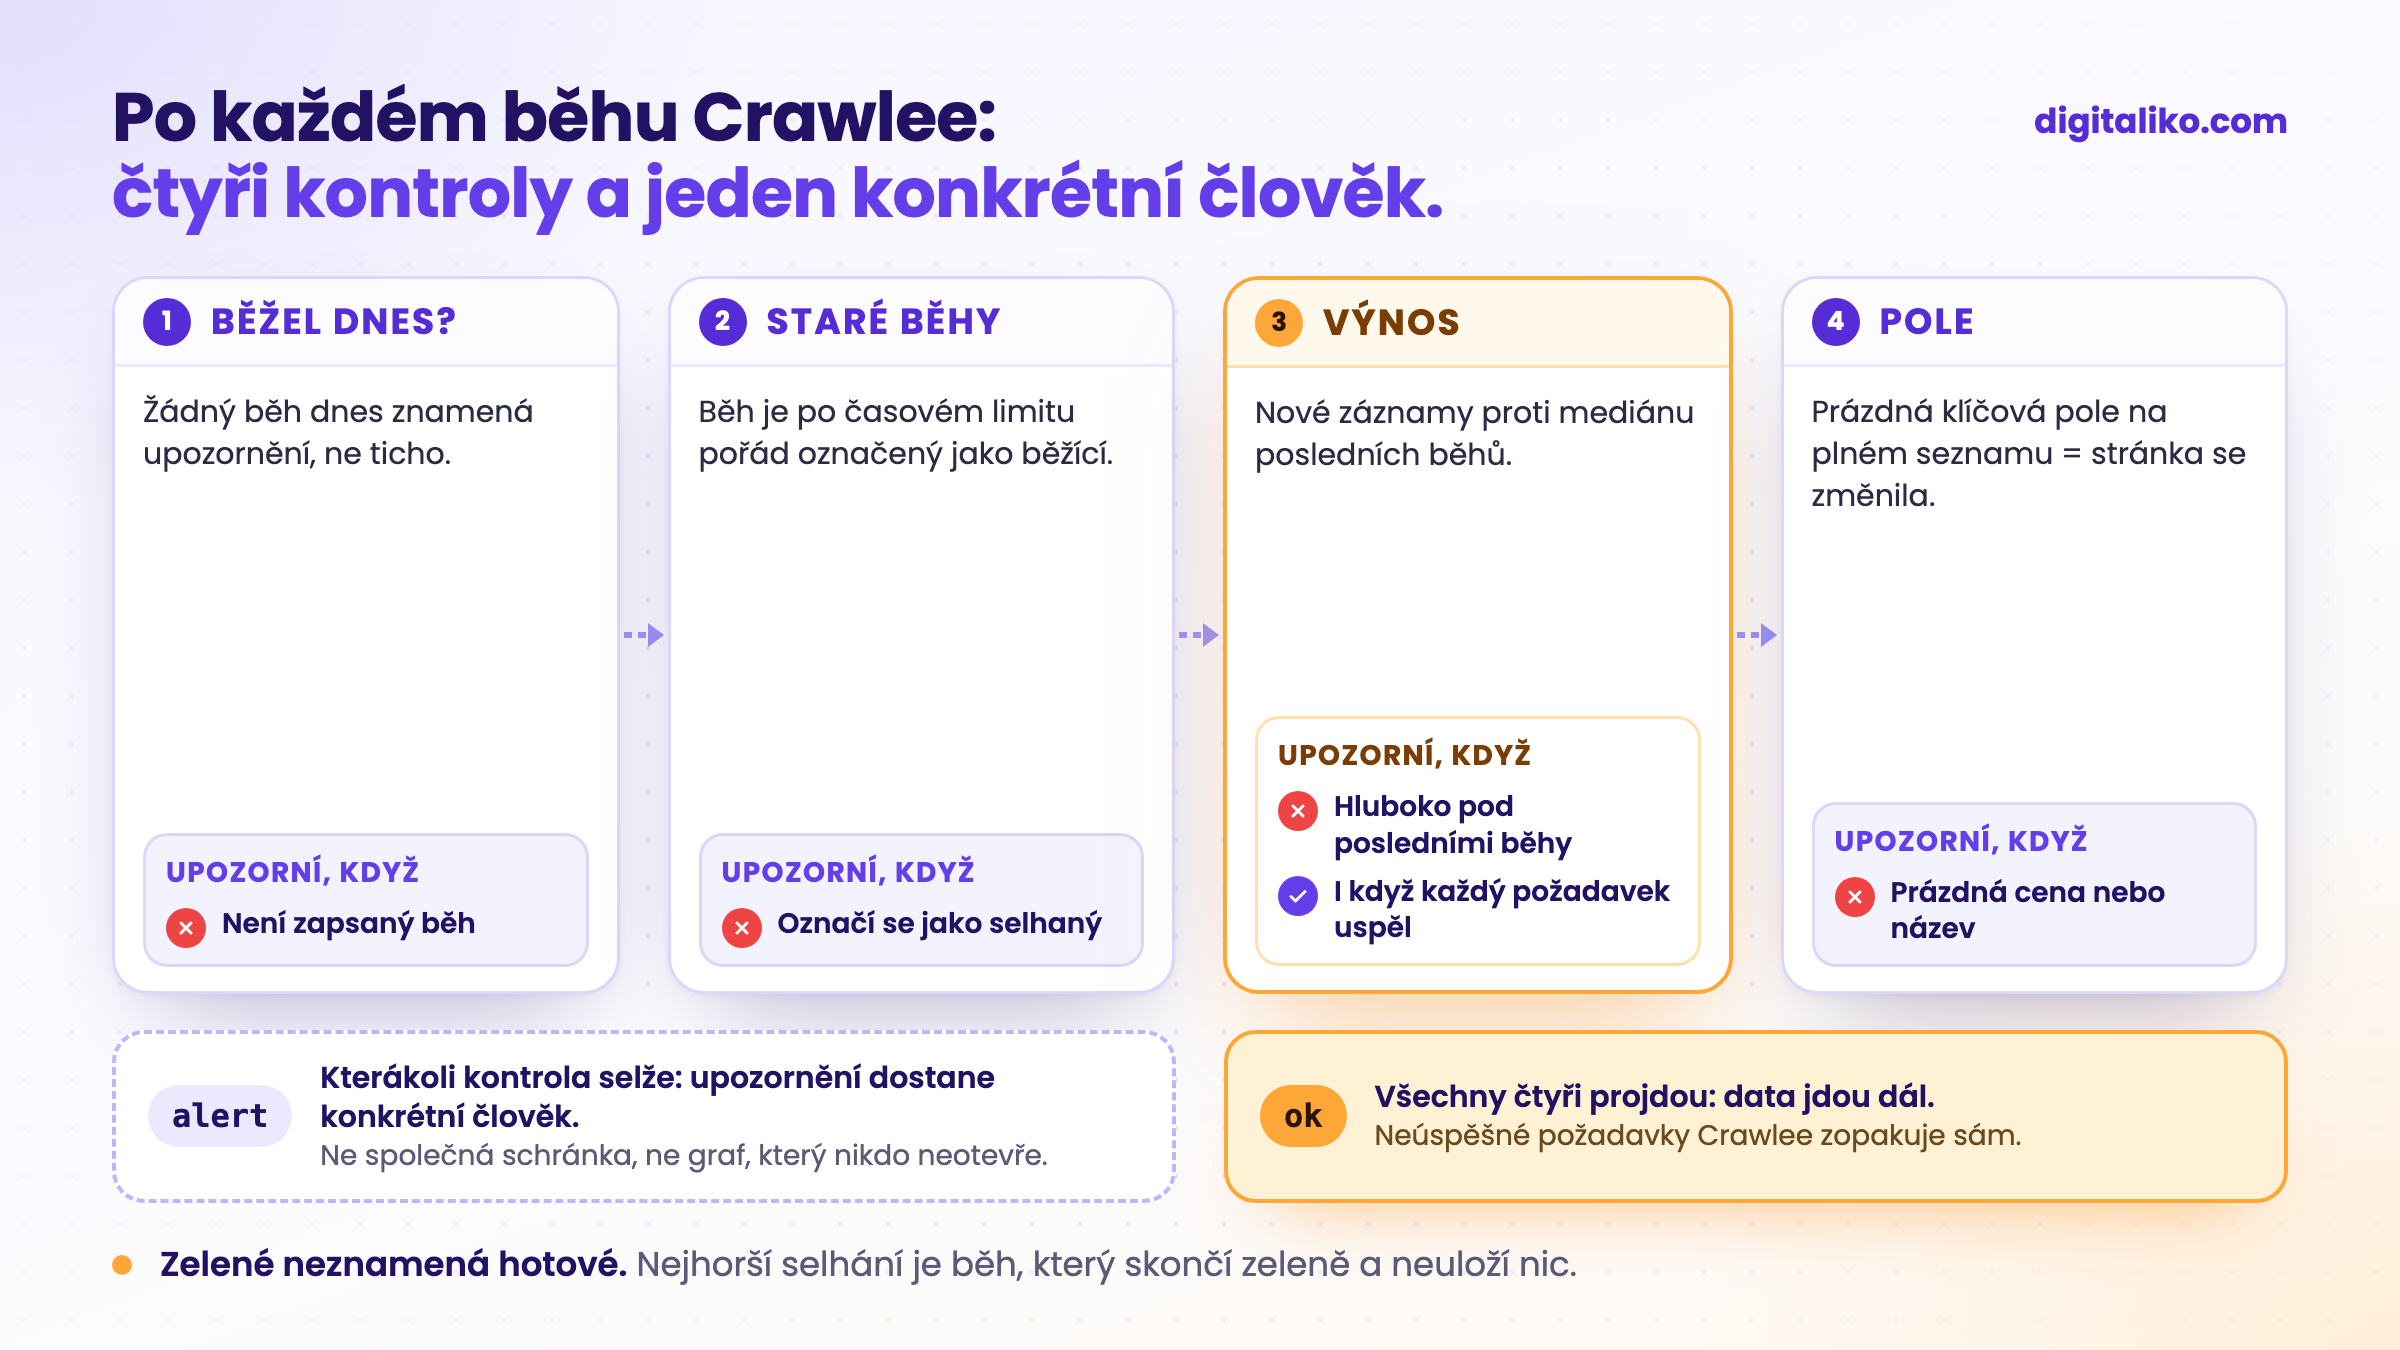
Každý běh porovnáváme s mediánem posledních běhů, ne s pevným číslem. Zdroj, který obvykle přinese hodně nových inzerátů a najednou jen pár, je selhání, i když každý požadavek uspěl. Běh, který je dlouho po časovém limitu pořád označený jako běžící, je taky selhání, protože násilně ukončený proces svůj konec nikdy nezapíše.
Kolik stál mrtvý crawler?
Marketplace žije z čerstvých inzerátů. Když crawler přestal běžet, nic nahlas neselhalo. Nové inzeráty přestaly přibývat a návštěvnost šla za nimi.
- zobrazení měsíčně na online marketplace klienta po pádu crawleru (prosinec 2025)
- 250K → 66K
Tím to neskončilo. Později přišly další výpadky crawleru a každý přidal řádek do tabulky výše. Dnes se každé nasazení po merge ověří a otestuje a pád crawleru upozorní člověka, místo aby čekal, až se někdo podívá na graf.
Dotáhnout něco do stabilní produkce je jiný level: architektura, infrastruktura a lidi, kteří vědí, co se může pokazit.

Jak připravit crawler na Crawlee do produkce?
01
Představte se
Vlastní User-Agent se stránkou, která říká, kdo sbírá a proč.
02
Zámek a limit
Pro každý zdroj najednou jen jeden běh, s tvrdým časovým limitem.
03
Crawlujte inkrementálně
Začněte ze sitemap a stahujte jen to, co se od posledního běhu změnilo.
04
Kontrolujte výnos
Porovnejte nové záznamy a prázdná pole s posledními běhy.
05
Upozorněte jméno
Upozornění dostane konkrétní člověk, ne společná schránka.
První krok je o slušnosti a o právu. Náš crawler se stránkám představuje vlastním jménem a odkazem na stránku, která vysvětluje, kdo sbírá a proč. Jeden zdroj jsme vypnuli, protože jeho podmínky automatizaci zakazují. Co je u scrapingu legální a kdy se crawler vůbec vyplatí, je v článku Web scraping pro firmy: kdy se crawler vyplatí.
Kdy je Crawlee špatný nástroj?
- Zdroj má API nebo export. Použijte ho. Je stabilnější a podmínky má sepsané.
- Data potřebujete jednou. Stačí jednorázový skript nebo ruční kopírování.
- Data jsou za přihlášením nebo podmínky sběr zakazují. Domluvte si přístup se zdrojem.
- Váš tým píše v Pythonu. Vezměte Scrapy nebo Crawlee pro Python. Crawler v jazyce, který nikdo neudržuje, umře při prvním redesignu.
Za většinou našich incidentů je stejný vzor, o kterém píšeme v článku Claude Code hooks: proč naše hooky nedělaly nic: zelené neznamená, že to fungovalo.
Je váš crawler připravený na produkci?
Potřebujete crawler, který se ozve, když přestane?
Crawlery a to, co z nich jde dál, stavíme s monitoringem od prvního dne v rámci služby automatizace firmy. Od roku 2023 jsme dodali 15+ produkčních projektů.
Ozveme se do dvou pracovních dnů a společně vybereme, co vyřešíme jako první.
Pokud si chcete nejdřív promluvit, domluvte si meeting na 15 minut s Filipem.
Jak byste dnes zjistili, že váš crawler v noci nepřinesl nic?
Ve zkratce
- Crawlee dá crawleru základ: frontu, opakování pokusů, sessions, proxy, Cheerio nebo skutečný prohlížeč.
- Začněte s CheerioCrawler. Prohlížeč jen tam, kde HTML nestačí.
- V produkci je nejhorší selhání zelený běh, který neuloží nic.
- Každý běh zamkněte, omezte časem, crawlujte inkrementálně a výnos porovnejte s posledními běhy.
- Upozornění dostane konkrétní člověk.
Časté otázky
Co je Crawlee?
Open-source knihovna na web crawling a scraping. Dává jedno rozhraní na rychlý HTTP crawling s HTML parsery i na skutečné prohlížeče s Playwright nebo Puppeteer a k tomu trvalou frontu požadavků, opakování pokusů, sessions a střídání proxy.
CheerioCrawler, nebo PlaywrightCrawler?
Začněte s CheerioCrawler. Stáhne HTML a rozparsuje ho, což je rychlé a nenáročné. Zdroj přesuňte na PlaywrightCrawler, jen když jeho stránky vykreslují obsah JavaScriptem nebo je potřeba klikat. Oba používají stejný router i frontu.
Crawlee, nebo Scrapy?
Vyberte jazyk, který bude váš tým udržovat, protože crawler je potřeba opravovat znovu a znovu. Tým v TypeScriptu vezme Crawlee. Tým v Pythonu vezme Scrapy nebo Crawlee pro Python.
Proč crawler na Crawlee přestane fungovat?
Stránka se změní nebo vás zablokuje, nebo selže samotný běh: časový limit, násilně ukončený proces, plán spouštění, který není takový, jak si myslíte. Nejhorší případ je běh, který skončí zeleně a neuloží nic. Proto po každém běhu kontrolujeme výnos.
Jak monitorovat crawler?
Po každém běhu ověřte, že běžel, kolik nových záznamů přinesl ve srovnání s posledními běhy a že jsou vyplněná klíčová pole. Upozornění dostane konkrétní člověk. Běh, který je dlouho po časovém limitu pořád označený jako běžící, je selhání.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity