Playwright vs. Puppeteer für Tests und Scraping
Für CTOs und EntwicklerWeb-Scraping und Crawler · Aktualisiert

Filip PapranecGründer, Digitaliko
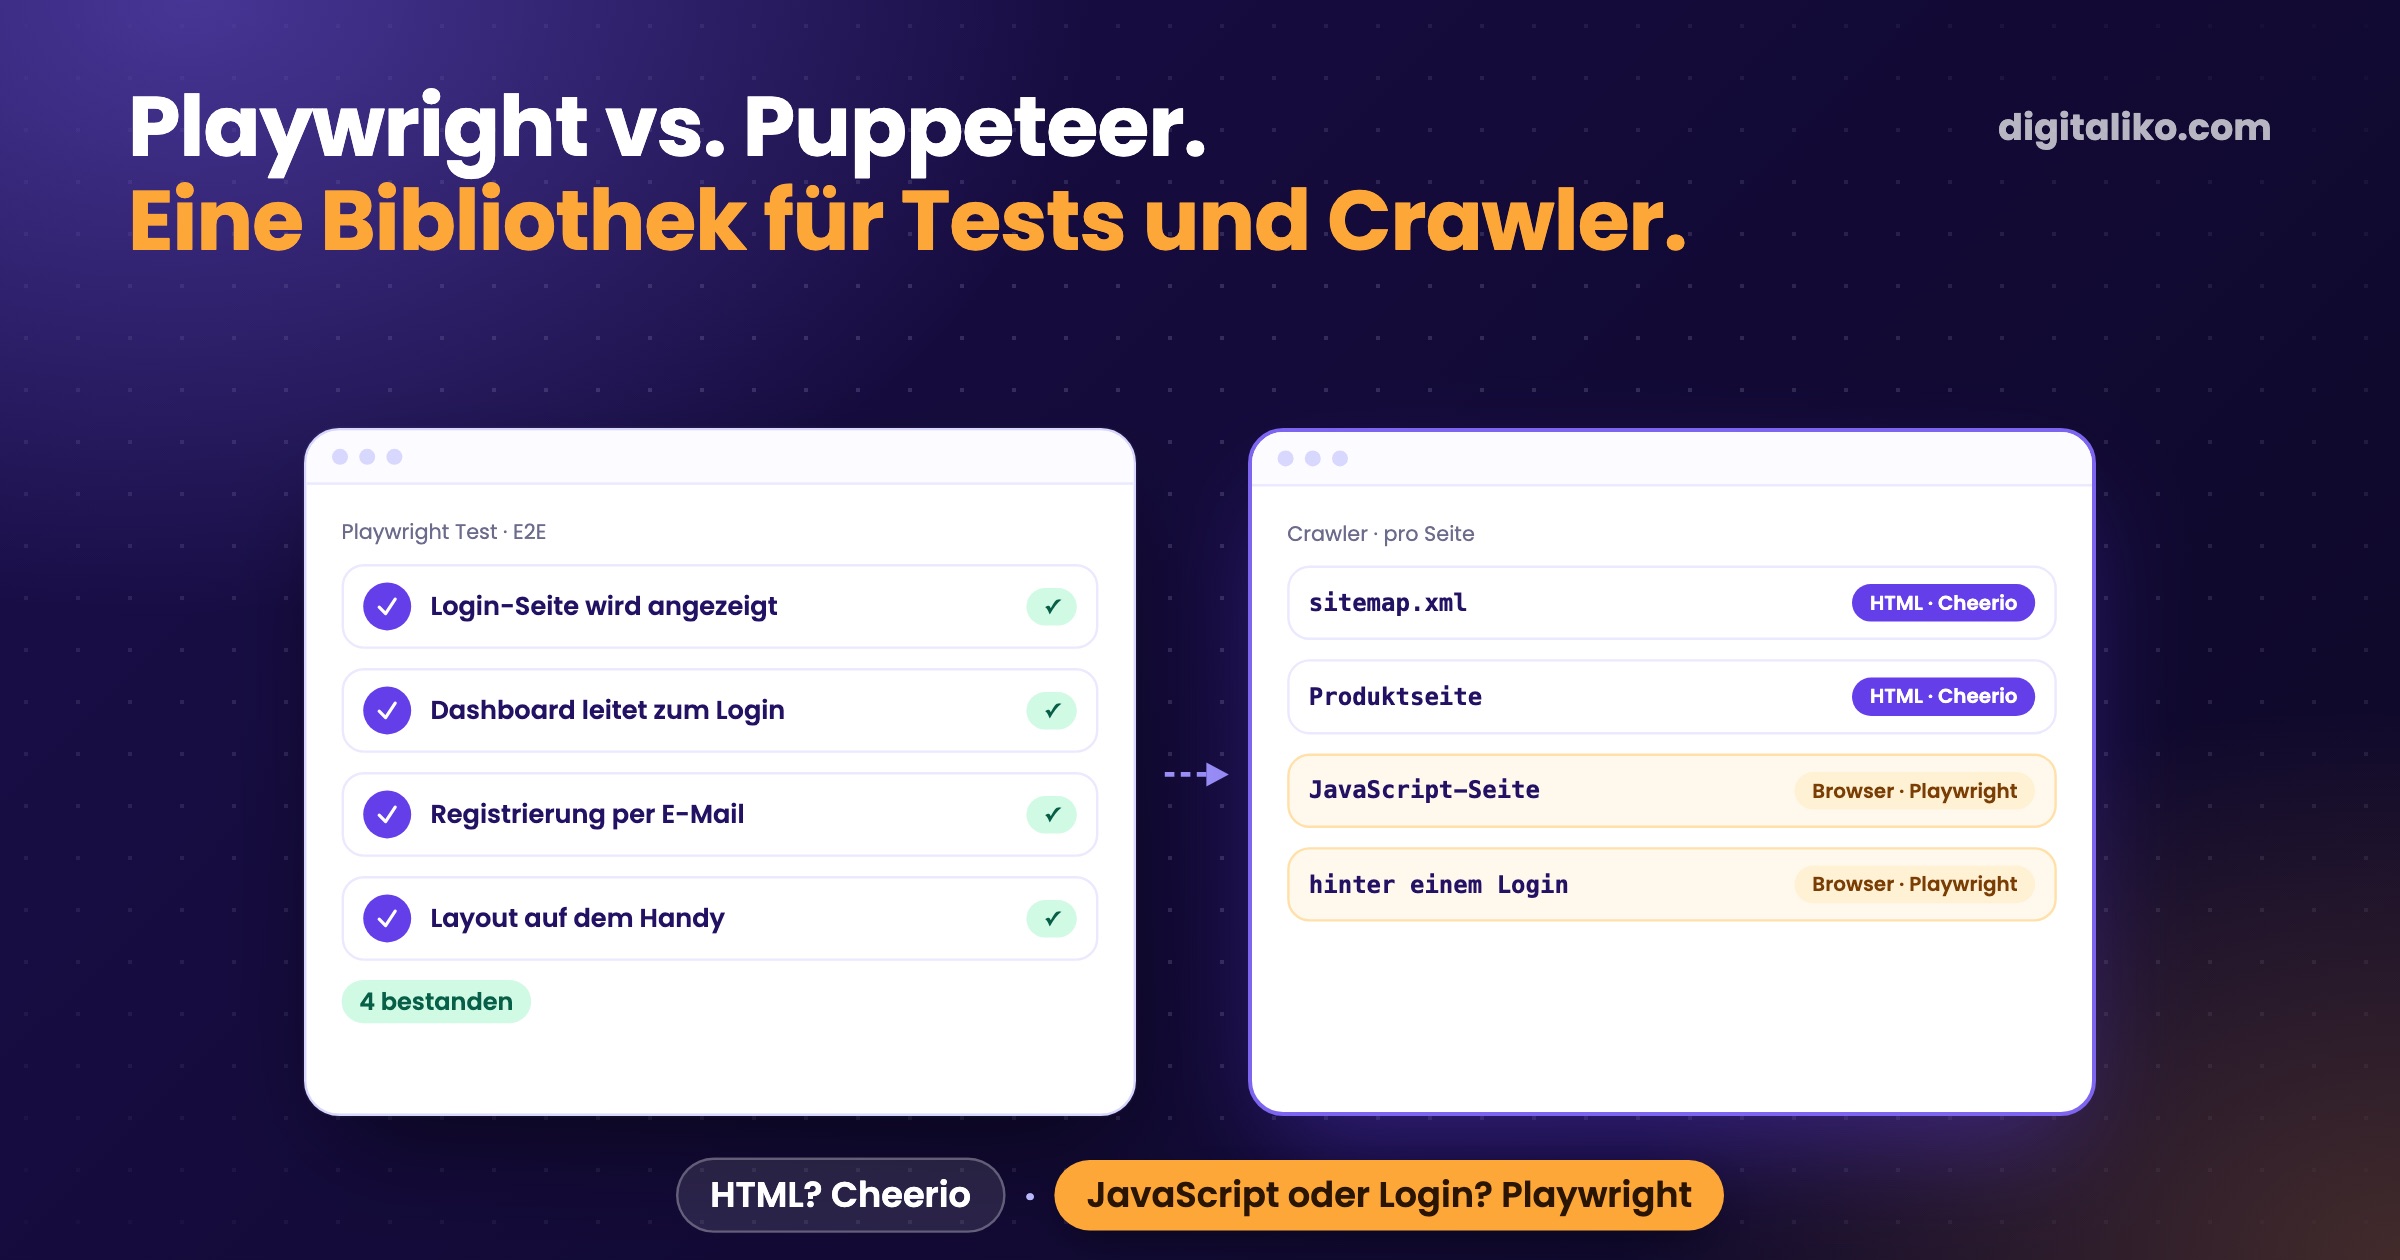
Playwright vs. Puppeteer ist eine Frage nach zwei Aufgaben: Testen und Scraping. Wir nutzen Playwright für beides, für End-to-End-Tests, Website-Audits und die Crawler, die einen echten Browser brauchen. Für neue Arbeit würden wir Playwright wählen, außer Sie steuern nur Chrome aus einem Node-Skript und haben bereits funktionierenden Puppeteer-Code.
Zuerst ehrlich: Puppeteer steckt bei uns in genau einem alten Projekt, und wir haben die beiden nie nebeneinander laufen lassen. Dieser Artikel ist also kein Benchmark. Er zeigt, was bei uns läuft, warum ein Werkzeug gereicht hat, und die Entscheidung, die beim Scraping mehr zählt: ob Sie überhaupt einen Browser brauchen.
Was ist der Unterschied zwischen Playwright und Puppeteer?
Beide steuern einen echten Browser aus Code. Sie unterscheiden sich in der Reichweite. Puppeteer ist laut eigener Dokumentation eine JavaScript-Bibliothek, die Chrome oder Firefox über das DevTools Protocol oder WebDriver BiDi steuert (pptr.dev, Stand 24.10.2026). Playwright unterstützt Chromium, WebKit und Firefox unter Windows, Linux und macOS (playwright.dev, Stand 24.10.2026).
| Playwright | Puppeteer | |
|---|---|---|
| Browser | Chromium, WebKit, Firefox | Chrome, Firefox |
| Sprachen | JavaScript/TypeScript, Python, Java, .NET (Doku) | JavaScript/TypeScript |
| Test-Runner | Playwright Test, eingebaut | keiner, selbst mitbringen |
| Warten | Locators warten selbst | waitForSelector und Ähnliches, von Hand |
| In Crawlee | PlaywrightCrawler | PuppeteerCrawler |
| Wo wir es nutzen | E2E-Tests, Audits, Crawler | ein altes Projekt |
Quellen der Tabelle: die Seiten oben und Playwrights Migrationsanleitung von Puppeteer, alle Stand 24.10.2026.
Den Ausschlag gab für uns die Zeile mit dem Test-Runner. Eine Bibliothek, die Browser und Test-Runner liefert, heißt: ein Werkzeug zum Lernen, eine Browser-Installation in der CI und ein Satz Selektoren.
Wie nutzen wir Playwright zum Testen?
An drei Stellen, von streng bis locker.
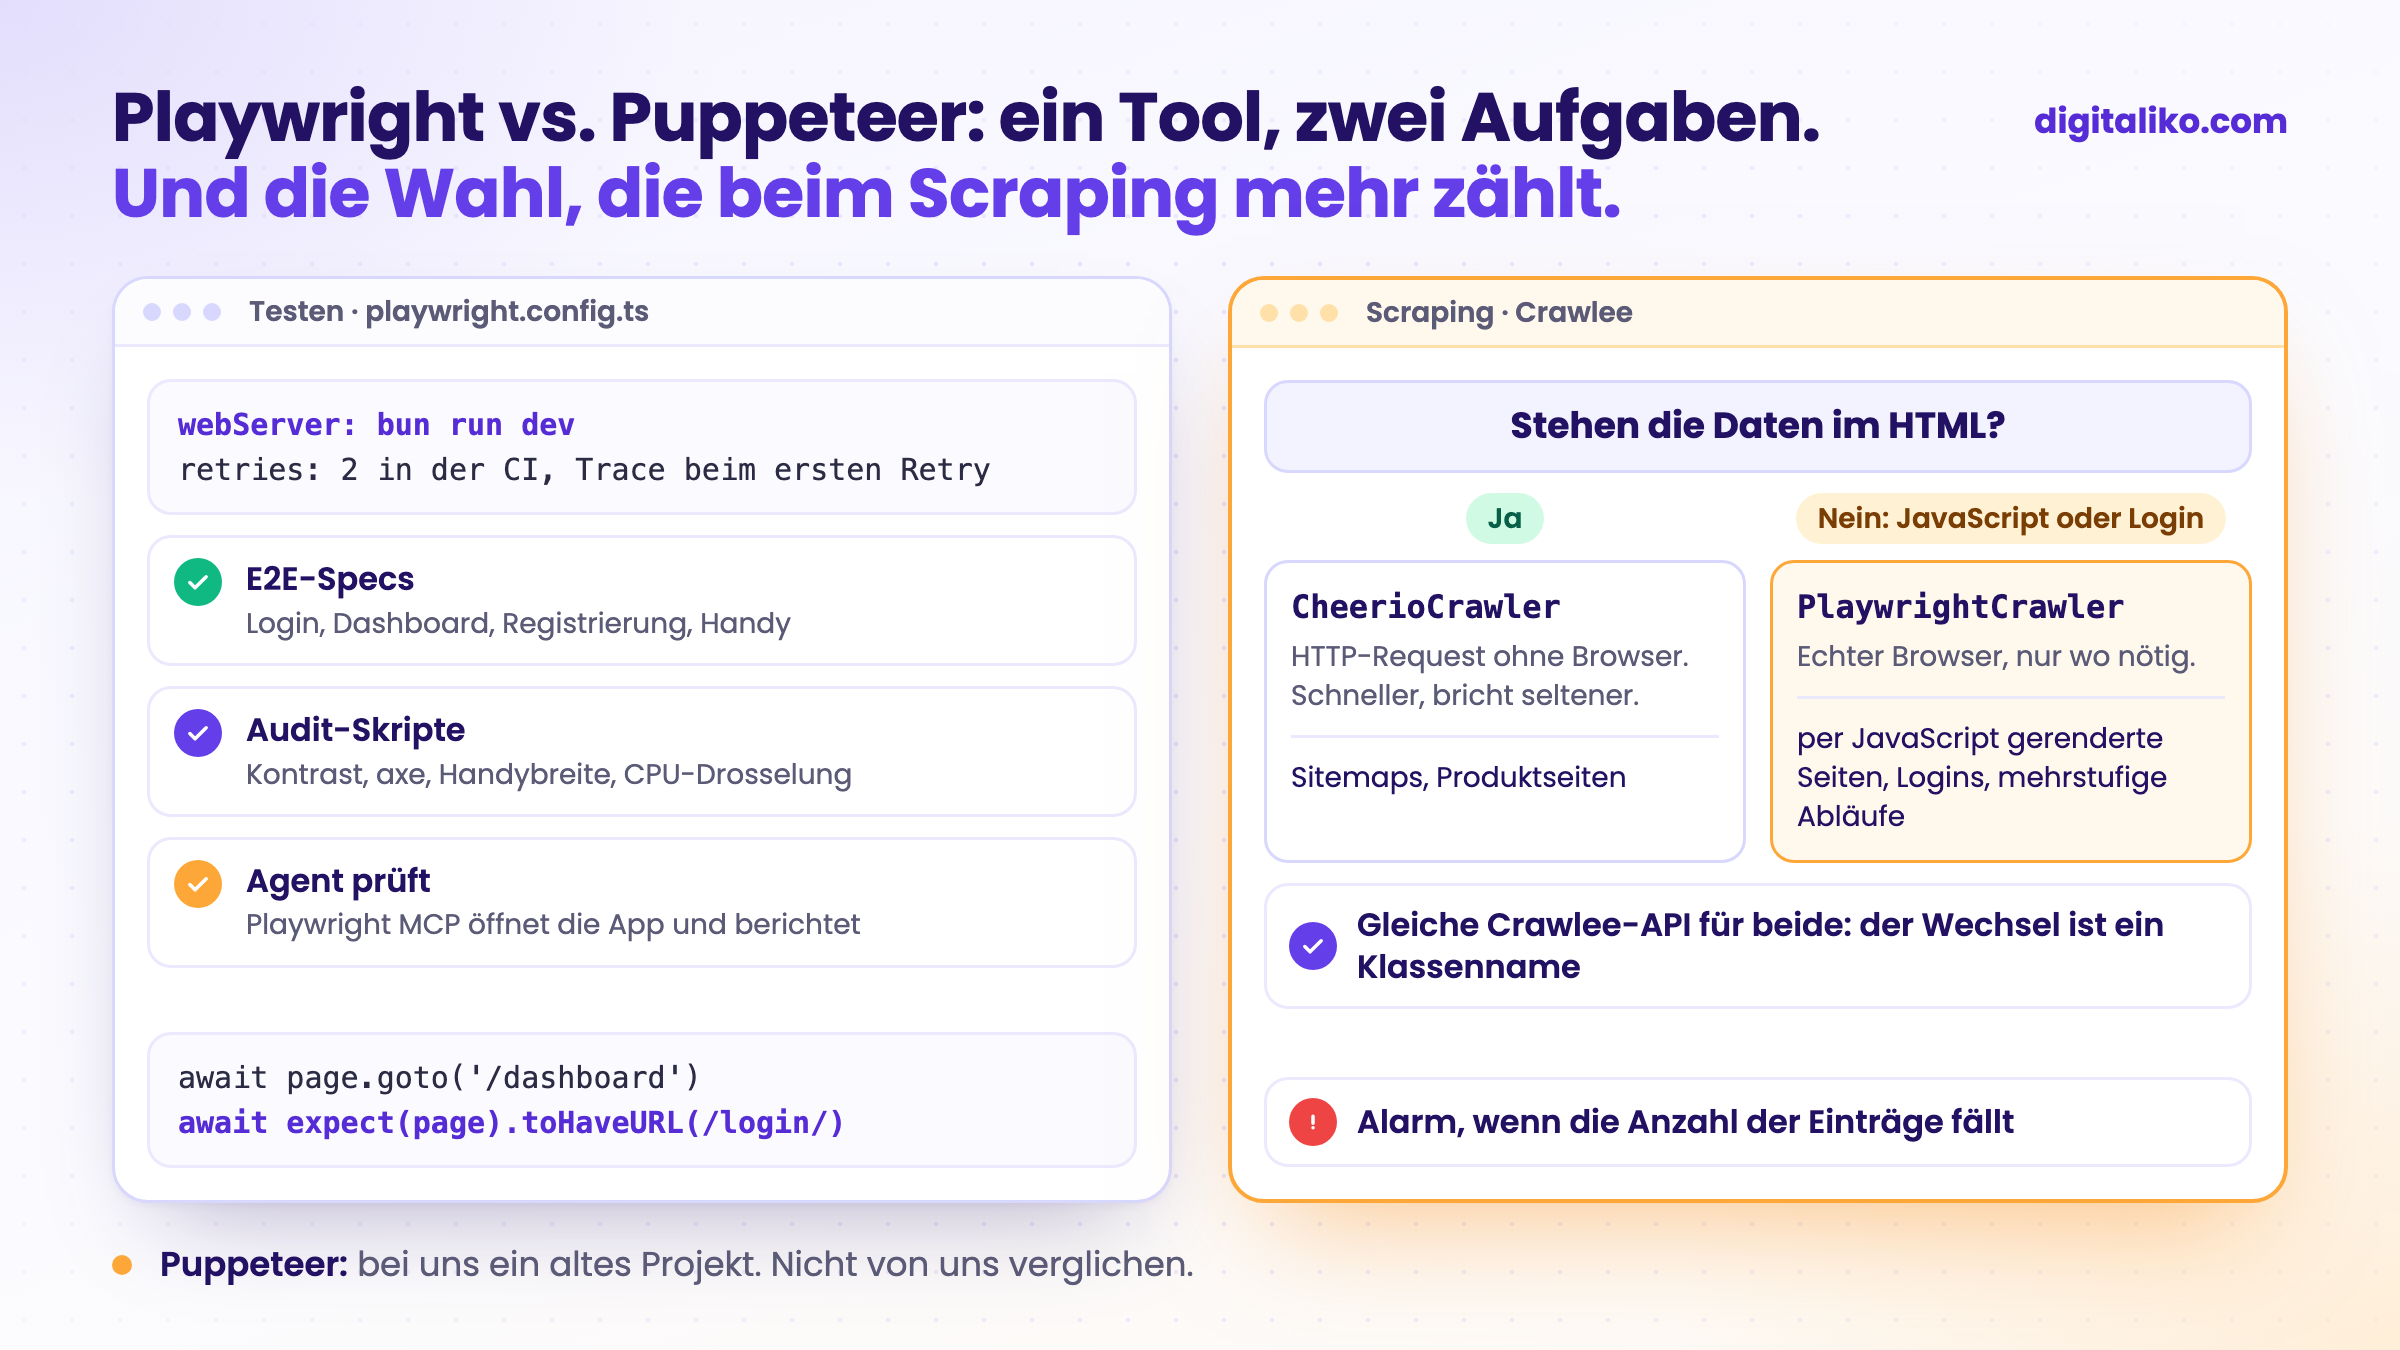
End-to-End-Tests. Unsere Starter-Vorlage lässt Playwright Test gegen den Dev-Server laufen. Die Konfiguration, gekürzt:
// playwright.config.ts
import { defineConfig } from '@playwright/test'

export default defineConfig({
  testDir: './e2e',
  forbidOnly: !!process.env.CI,
  retries: process.env.CI ? 2 : 0,
  use: { baseURL: 'http://localhost:3001', trace: 'on-first-retry' },
  projects: [{ name: 'chromium', use: { browserName: 'chromium' } }],
  webServer: { command: 'bun run dev', url: 'http://localhost:3001', reuseExistingServer: !process.env.CI },
})
Und eine der Specs:
test('dashboard redirects to login when not authenticated', async ({ page }) => {
  await page.goto('/dashboard')
  await expect(page).toHaveURL(/login/)
})
Kein Sleep, kein manuelles Warten. expect(page).toHaveURL versucht es erneut, bis es passt oder die Zeit abläuft. Genau das würden Sie in Puppeteer selbst schreiben.
Website-Audits. Als wir diese Website geprüft haben, waren die Checks einfache Playwright-Skripte: Textkontrast aus berechneten Farben, Barrierefreiheitsregeln mit axe, Layout auf Handybreite, Laden mit gedrosselter CPU. Wegwerfskripte, keine Testsuite.
Der KI-Agent prüft seine eigene Änderung. Der Agent öffnet die App über Playwright MCP und berichtet, was er gesehen hat. Wie das funktioniert, steht in Playwright MCP: Der KI-Agent beweist es im Browser.
Wie nutzen wir Playwright zum Scraping?
Über Crawlee, das beide Bibliotheken kapselt. Laut Dokumentation hat Crawlee drei Haupt-Crawler-Klassen: CheerioCrawler, PuppeteerCrawler und PlaywrightCrawler (crawlee.dev, Stand 24.10.2026). Puppeteer gegen Playwright zu tauschen ist dort vor allem ein Klassenname. Die eigentliche Wahl kommt einen Schritt früher: HTTP oder Browser.
Einer unserer produktiven Crawler, der durch eine JavaScript-lastige Seite muss, nutzt PlaywrightCrawler, vereinfacht:
import { PlaywrightCrawler } from 'crawlee'
import { router } from './routes.js'

const crawler = new PlaywrightCrawler({
  maxRequestsPerCrawl,
  requestHandlerTimeoutSecs: 360,
  navigationTimeoutSecs: 60,
  maxRequestRetries: 4,
  requestHandler: router,
  launchContext: {
    launchOptions: { args: ['--disable-gpu'] }, // GPU-Abstürze in Docker
  },
})

await crawler.run(startUrls)
Der Crawler für den Online-Marktplatz eines Kunden hat gar keinen Browser. Er liest Sitemaps und Produktseiten mit CheerioCrawler, weil die Daten im HTML stehen. Ein Kunden-Prototyp mischt beides: Cheerio für die öffentlichen Listen, Playwright nur für die Schritte hinter einem Login.
So entscheiden wir pro Seitentyp:
01
Seite mit ausgeschaltetem JavaScript öffnen
Oder per curl holen. Stehen die Daten im HTML, brauchen Sie keinen Browser.
02
Nach einem JSON-Request suchen
Viele JavaScript-Seiten laden ihre Daten über einen API-Aufruf. Ihn direkt aufzurufen ist besser, als die Seite zu rendern.
03
Cheerio, wo es geht
Ein HTTP-Crawler ist schneller, braucht weniger Speicher und bricht seltener als ein Browser.
04
Playwright, wo es sein muss
Im Browser gerenderte Seiten, Logins und mehrstufige Abläufe bekommen den PlaywrightCrawler.
05
In beiden Fällen überwachen
Ein Crawler, der still stehen bleibt, kostet mehr als die falsche Bibliothek. Alarm, wenn die Anzahl der Einträge fällt.
Der letzte Schritt ist keine Theorie. Als der Crawler des Marktplatzes im Dezember 2025 ausfiel, fielen die monatlichen Seitenaufrufe von 250.000 auf 66.000, bevor es jemand bemerkte. Es war ein Cheerio-Crawler, die Bibliothek war also nicht das Problem. Der fehlende Alarm war es. Die ganze Geschichte steht in Crawlee für Web Scraping: was in Produktion kaputtgeht.
Warum haben wir Puppeteer nie gebraucht?
Weil jede Aufgabe, die wir hatten, abgedeckt war, sobald Playwright im Repository war. Tests brauchten einen Runner, Playwright hat einen. Crawler brauchten nur auf manchen Seiten einen Browser, und Crawlee gibt uns Playwright und Cheerio hinter einer API. Eine zweite Browser-Bibliothek hätte eine Installation hinzugefügt, keine Fähigkeit.
The APIs have similarities, but Playwright offers much more possibilities for web testing and cross-browser automation.
Der Satz stammt vom Playwright-Team, ist also die Sicht eines Anbieters. Für reine Chrome-Arbeit bleibt Puppeteer eine solide Wahl.
Wann wäre Puppeteer die bessere Wahl?
Nach der Dokumentation, nicht nach unseren Läufen:
- Sie brauchen nur Chrome aus einem Node-Skript und haben funktionierenden Puppeteer-Code. Ein Umschreiben bringt wenig.
- Sie arbeiten nah am Chrome DevTools Protocol und wollen eine Bibliothek, die darum gebaut ist.
- Ihre Tests laufen schon in einem anderen Framework, und Sie brauchen nur einen Browser-Treiber, keinen Runner.
Brauchen Sie auch WebKit, Python oder einen Test-Runner im selben Werkzeug, deckt Playwright das ab. Laut der Anleitung lassen sich die meisten Puppeteer-APIs bei der Migration unverändert nutzen, der Wechsel ist also meist klein.
Playwright oder Puppeteer: was passt zu Ihrem Projekt?
Beantworten Sie das, bevor Sie wählen. Jedes „Ja“ spricht für Playwright:
Brauchen Sie Tests oder einen Crawler, der in Produktion hält?
Automatisierungen und Crawler, die von selbst laufen und Ihnen sagen, wenn sie stehen bleiben, bauen wir im Rahmen der Prozessautomatisierung. KI schreibt heute unseren gesamten Code, und ein Senior steht für das Ergebnis gerade. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Welche Ihrer Seiten brauchen wirklich einen Browser?
Kurz gesagt
- Playwright steuert Chromium, WebKit und Firefox und bringt einen Test-Runner mit. Puppeteer steuert Chrome und Firefox aus JavaScript.
- Wir nutzen Playwright für E2E-Tests, Audits, Agent-Checks und die Crawler, die einen Browser brauchen.
- Beim Scraping ist die größere Wahl HTTP mit Cheerio oder ein echter Browser, Seite für Seite.
- Puppeteer haben wir nicht gemessen. Ein funktionierendes Chrome-Skript behalten Sie.
Häufige Fragen
Was ist der Unterschied zwischen Playwright und Puppeteer?
Puppeteer ist eine JavaScript-Bibliothek für Chrome und Firefox. Playwright steuert Chromium, WebKit und Firefox, gibt es für JavaScript, Python, Java und .NET und bringt einen eigenen Test-Runner mit Locators mit, die selbst warten. Für neue Arbeit mit Tests oder mehreren Browsern deckt Playwright mehr ab.
Ist Playwright besser als Puppeteer für Web Scraping?
Beim Scraping zählt weniger die Bibliothek als die Frage, ob Sie überhaupt einen Browser brauchen. Die meisten Seiten, die wir crawlen, sind reines HTML und gehen an einen HTTP-Crawler mit Cheerio. Nur per JavaScript gerenderte Seiten oder Seiten hinter einem Login bekommen einen echten Browser, und dort nutzen wir Playwright über Crawlee. Einen Benchmark gegen Puppeteer haben wir nicht gemacht.
Kann ich von Puppeteer auf Playwright migrieren?
Ja. Playwright hat eine Migrationsanleitung und schreibt, dass sich die meisten Puppeteer-APIs unverändert nutzen lassen. Die größere Umstellung ist der Wechsel von Element-Handles und manuellem Warten zu Locators und Web-First-Assertions.
Unterstützt Puppeteer Firefox und Safari?
Puppeteer steuert Chrome oder Firefox über das DevTools Protocol oder WebDriver BiDi. WebKit steuert es nicht, für Tests des Safari-Verhaltens brauchen Sie also Playwright oder ein anderes Werkzeug.
Brauche ich für Web Scraping einen Headless-Browser?
Oft nicht. Stehen die Daten im HTML, das der Server liefert, reichen ein HTTP-Request und ein HTML-Parser. Das ist schneller und günstiger im Betrieb. Einen Browser brauchen Sie nur für Seiten, die Daten per JavaScript rendern oder hinter einem Login liegen.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity