Crawlee für Web Scraping: was in Produktion kaputtgeht
Für CTOs und EntwicklerWeb-Scraping und Crawler · Aktualisiert

Filip PapranecGründer von Digitaliko
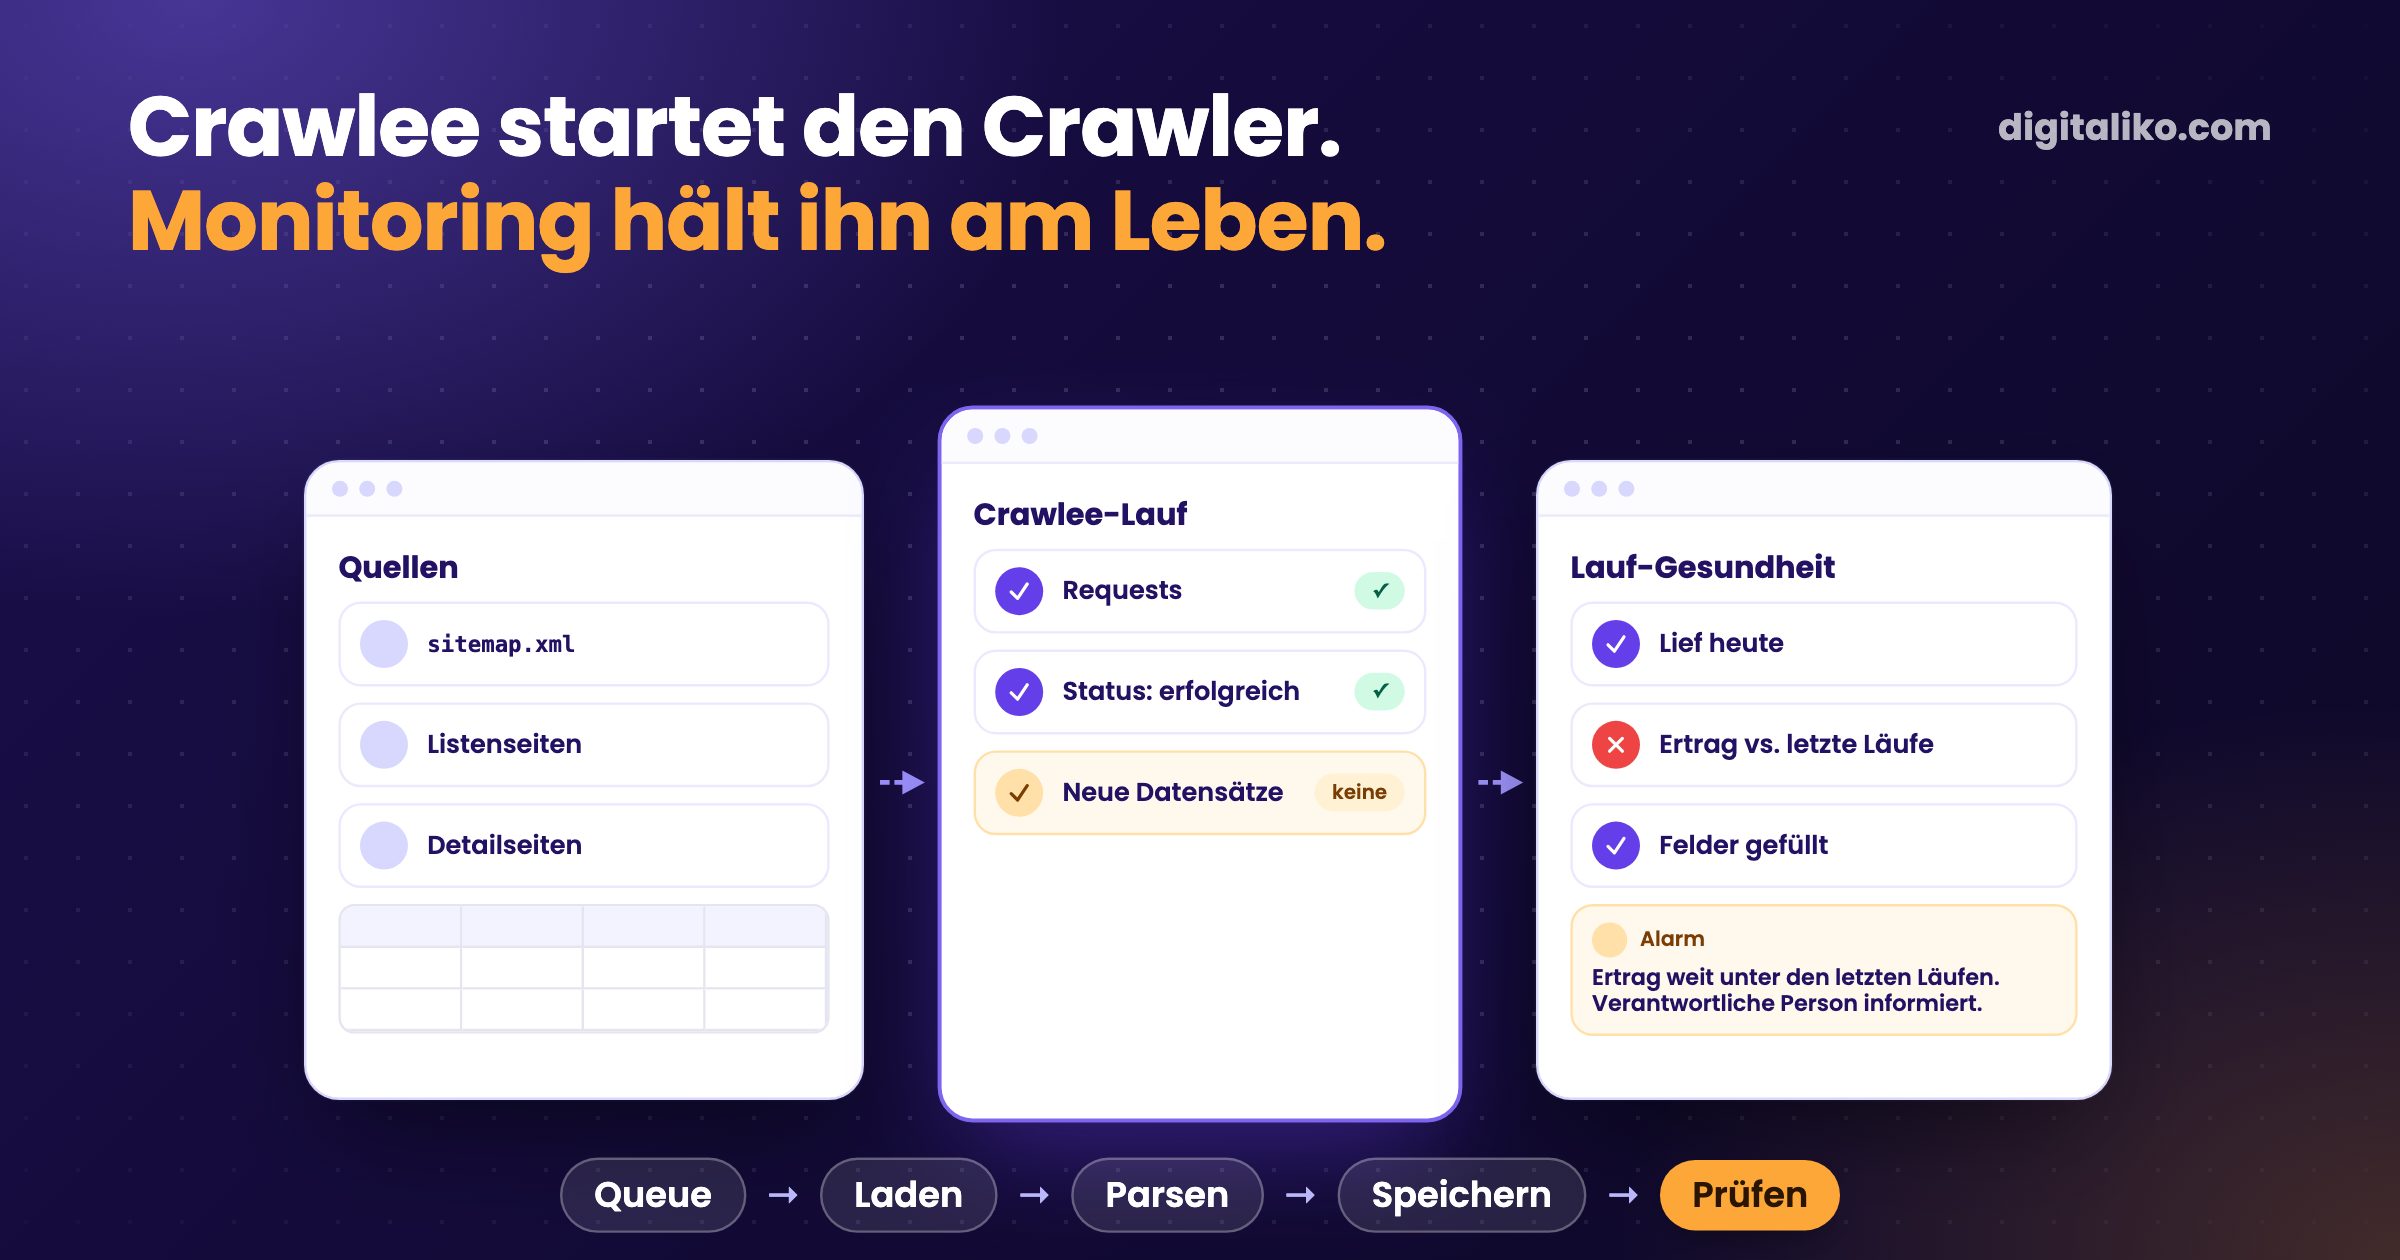
Crawlee ist eine Open-Source-Bibliothek für Web Crawling und Scraping. Ihre Dokumentation verspricht, dass sie „covers your crawling and scraping end-to-end“, also Crawling und Scraping von Anfang bis Ende abdeckt: schnelles HTTP-Crawling mit Cheerio oder JSDOM, echte Browser mit Playwright oder Puppeteer hinter derselben Schnittstelle, eine persistente Request-Queue, Wiederholungen, Sessions und Proxy-Rotation. Ein Crawler läuft damit schnell. Ihn am Laufen zu halten, ist der schwere Teil.
Das haben wir an einem Crawlee-Crawler gelernt, den wir für einen Kunden mit einem Online-Marktplatz betreiben. Im Dezember 2025 starb der Crawler, und wir haben es spät bemerkt, erst an einem Diagramm. Unten steht, wie wir Crawlee nutzen, was in Produktion kaputtging und welche Checks wir ergänzt haben.
Was ist Crawlee und welchen Crawler sollten Sie wählen?
Crawlee übernimmt die Grundarbeit, die jeder Crawler braucht: eine URL-Queue, die Neustarts übersteht, Wiederholungen, Limits für Parallelität, Sessions und Proxys. Sie schreiben den Handler, der aus einer Seite einen Datensatz macht.
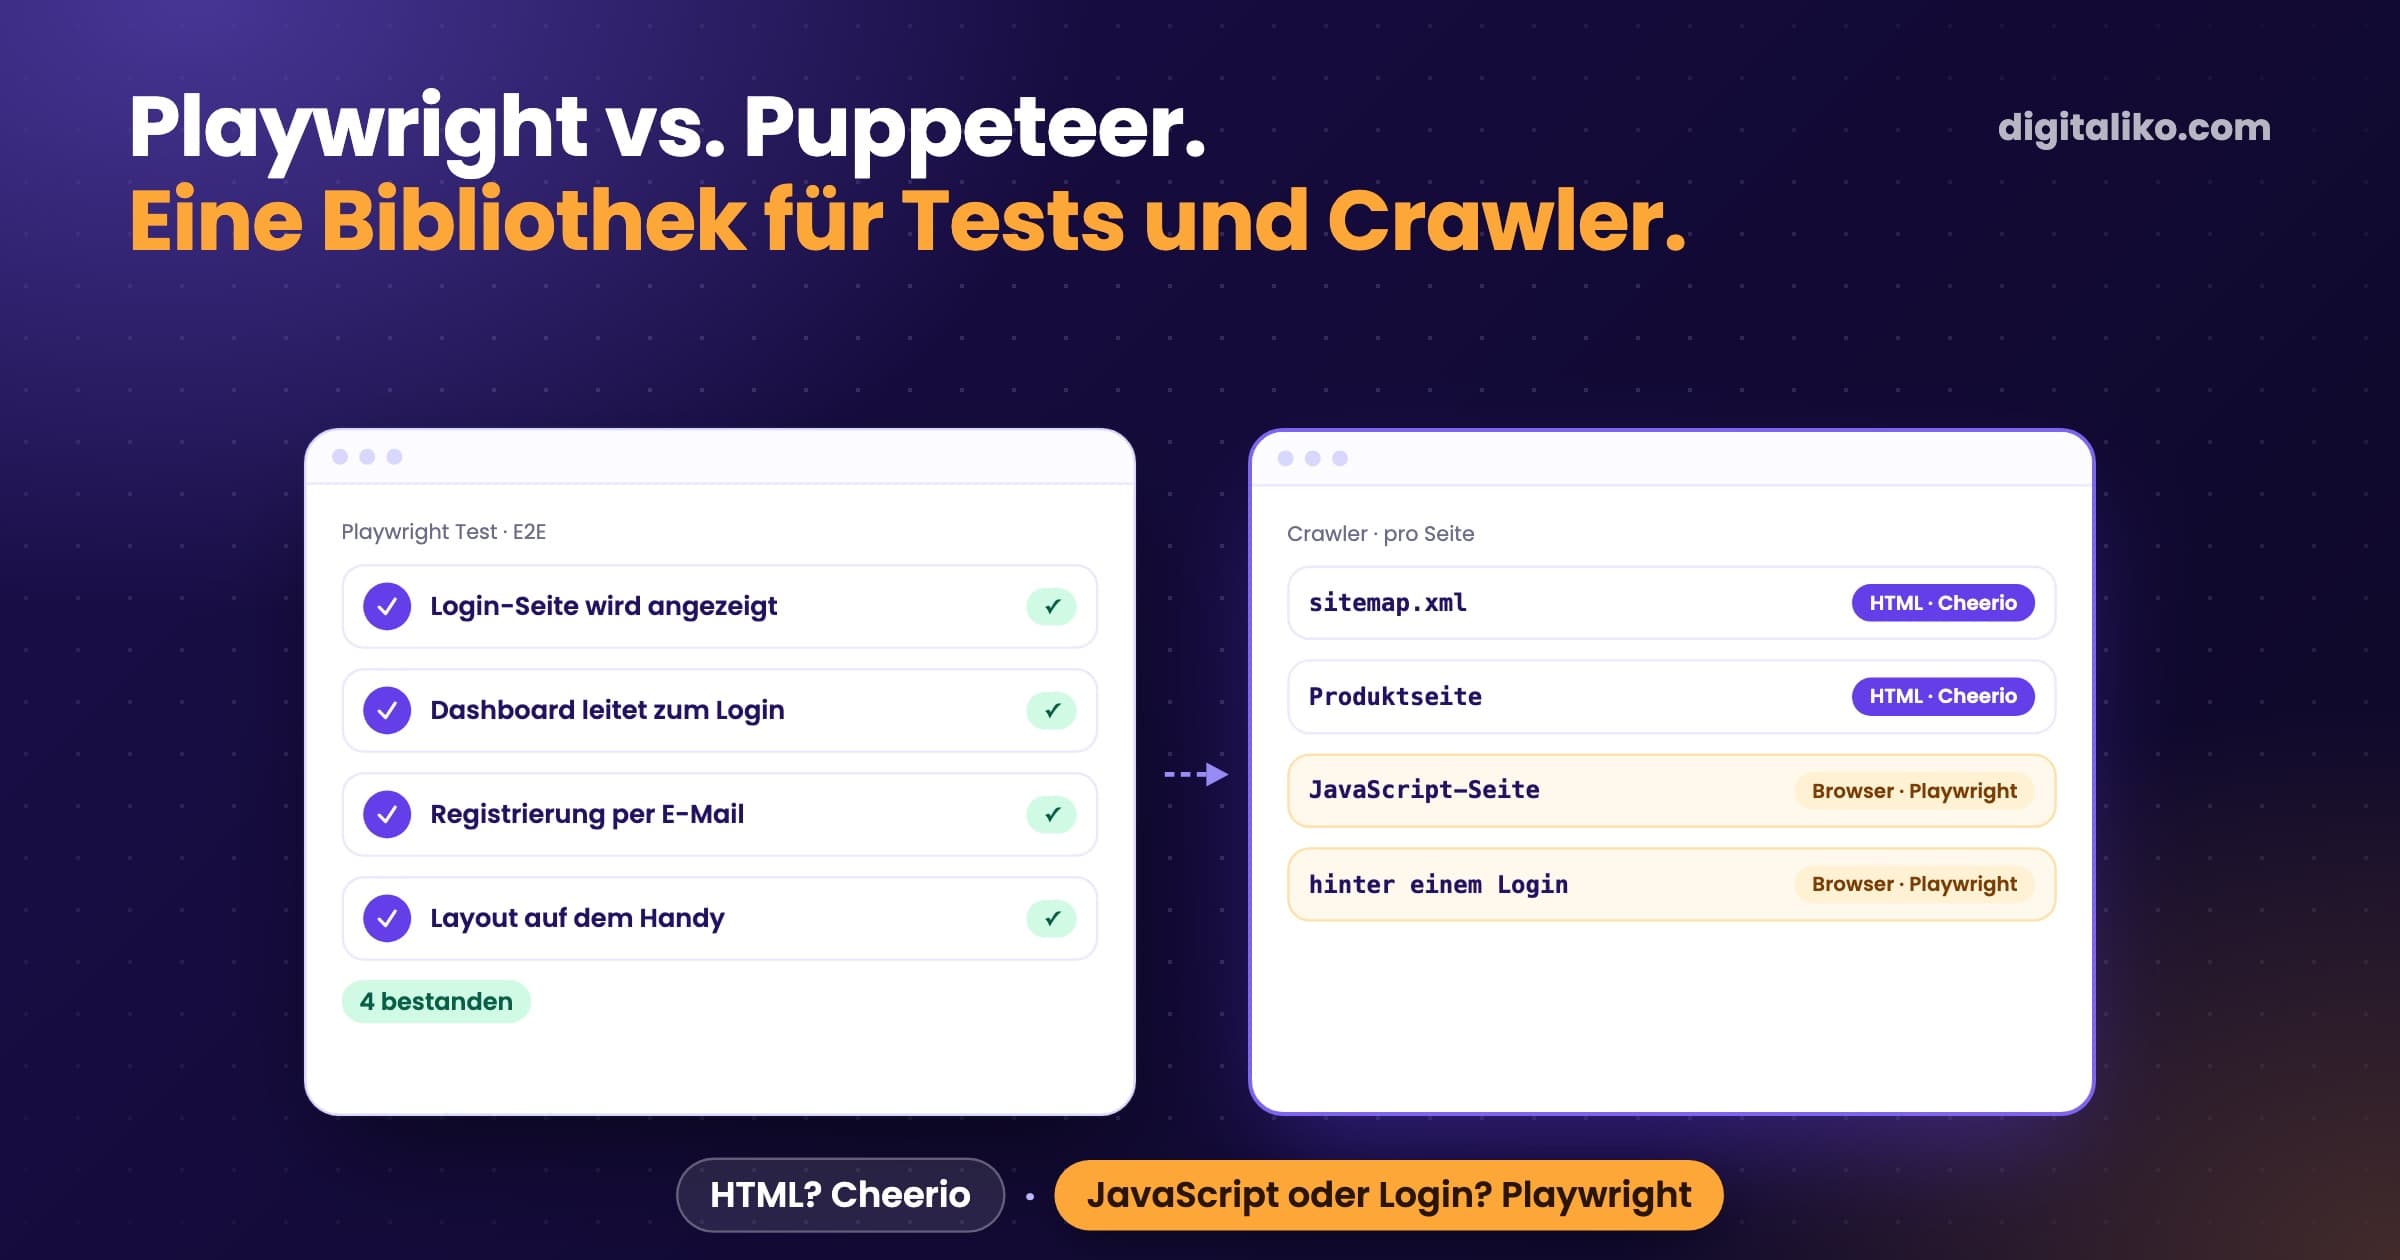
Die wichtigste Wahl ist die Crawler-Klasse:
Hier anfangen
CheerioCrawler
- Lädt das HTML und parst es.
- Schnell und sparsam im Speicher.
- Reicht für serverseitig gerenderte Seiten und Sitemaps.
- Das nutzen wir für die meisten Quellen.
PlaywrightCrawler
- Startet einen echten Browser.
- Für Seiten aus JavaScript oder hinter Klicks.
- Langsamer und schwerer pro Seite.
- Nur dort, wo das HTML nicht reicht.
Beide nutzen denselben Router und dieselbe Request-Queue. Sie können mit Cheerio starten und eine einzelne schwierige Quelle später in einen Browser verlegen.
Wie sieht ein minimaler Crawlee-Crawler aus?
Ein Router mit zwei Handlern: Listenseiten reihen Detailseiten ein, Detailseiten speichern einen Datensatz.
import { CheerioCrawler, createCheerioRouter, Dataset } from 'crawlee'

const router = createCheerioRouter()

router.addDefaultHandler(async ({ enqueueLinks }) => {
  await enqueueLinks({ selector: 'a.listing', label: 'DETAIL' })
})

router.addHandler('DETAIL', async ({ request, $ }) => {
  await Dataset.pushData({
    url: request.loadedUrl,
    title: $('h1').text().trim(),
    price: $('.price').text().trim(),
  })
})

const crawler = new CheerioCrawler({
  requestHandler: router,
  maxConcurrency: 4,
  maxRequestRetries: 2,
  failedRequestHandler: async ({ request }) => console.error('gave up', request.url),
})

await crawler.run(['https://example.com/listings'])
Unsere Produktions-Crawler ergänzen eine Idee. Sie starten von Sitemaps und merken sich, wo der letzte Lauf aufgehört hat, sodass jeder Lauf nur holt, was sich seitdem geändert hat. Bei jedem Lauf den ganzen großen Katalog abzulaufen, ist genau der Weg, auf dem ein Crawler sein Zeitlimit reißt.
Was geht in Produktion kaputt?
Nichts davon war ein Fehler in Crawlee. Es ist das, was rund um jeden Crawler passiert, der täglich läuft:
| Was passierte | Was wir sahen | Was wir ergänzt haben |
|---|---|---|
| Ein Lauf endete grün und speicherte fast nichts | grünes Dashboard, schrumpfender Katalog | einen Ertrags-Check: neue Datensätze im Vergleich zu den letzten Läufen |
| Der Scheduler startete einen Lauf, während der letzte hing | hängende Läufe, die Datenbankverbindungen hielten | eine Sperre pro Quelle und ein hartes Zeitlimit pro Lauf |
| Der Prozess wurde hart beendet | ein Lauf für immer auf laufend | einen Schritt, der vor jedem Lauf alte Läufe als gescheitert markiert |
| Die URL-Suche endete nie | Zeitlimit erreicht, nichts gespeichert | einen Zeitwächter für die Suche, inkrementelle Sitemaps |
| Eine bezahlte API bei der Anreicherung meldete einen Zahlungsfehler | der Worker endete als erfolgreich | einen eigenen Health-Check, der darauf alarmiert |
| Der Zeitplan im Repo war nicht der auf dem Server | Läufe zu falschen Zeiten | den Zeitplan vom Repo auf den Server synchronisiert |
Die erste Zeile hat am meisten wehgetan. Unser Monitoring-Code beginnt heute genau mit diesem Fall: ein Crawl, der grün durchläuft, aber kaum neue Inserate bringt.
Wie überwacht man einen Crawlee-Crawler?
Crawlee meldet Ihnen Requests, die gescheitert sind. Nach den Wiederholungen landet ein Request im failedRequestHandler, und Sie können ihn loggen oder zählen. Es meldet Ihnen aber nicht, dass ein erfolgreicher Lauf nichts gebracht hat. Dieser Check liegt bei Ihnen.
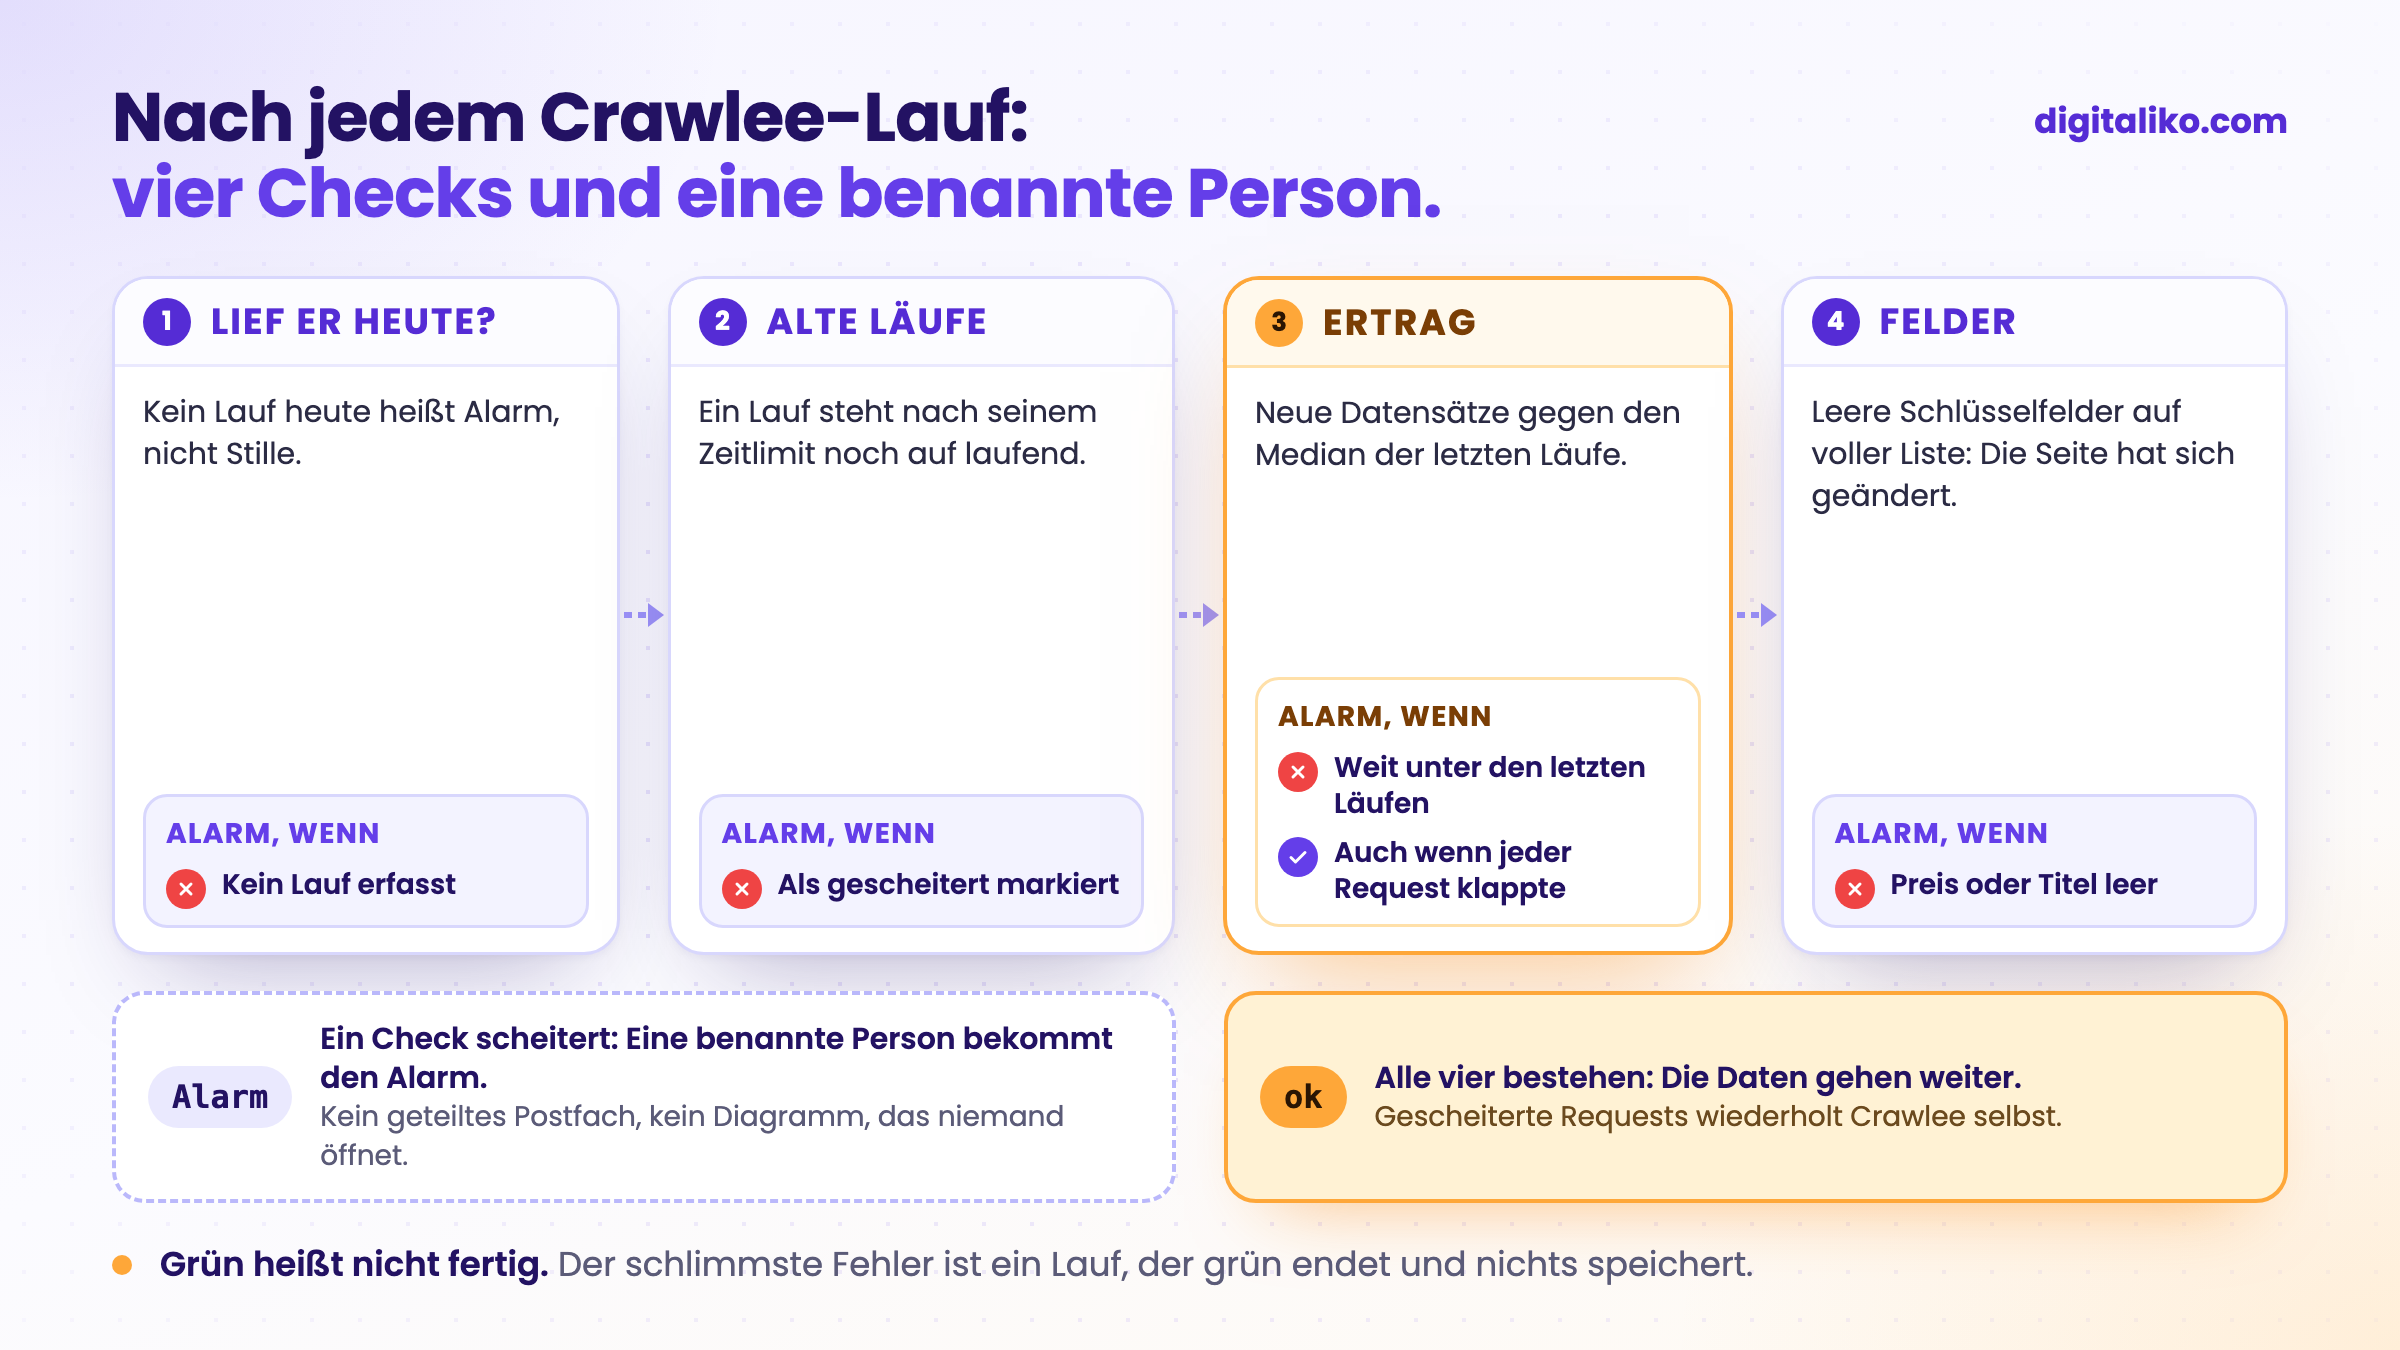
Wir vergleichen jeden Lauf mit dem Median der letzten Läufe, nicht mit einer festen Zahl. Eine Quelle, die sonst viele neue Inserate bringt und plötzlich nur eine Handvoll, ist ein Fehler, auch wenn jeder Request erfolgreich war. Ein Lauf, der lange nach seinem Zeitlimit noch auf laufend steht, ist ebenfalls ein Fehler, denn ein hart beendeter Prozess schreibt sein Ende nie selbst.
Was hat ein toter Crawler gekostet?
Der Marktplatz lebt von frischen Inseraten. Als der Crawler stehen blieb, scheiterte nichts laut. Neue Inserate kamen nicht mehr, und der Traffic folgte.
- Seitenaufrufe pro Monat auf dem Online-Marktplatz eines Kunden, nachdem sein Crawler starb (Dezember 2025)
- 250K → 66K
Damit war es nicht vorbei. Später kamen weitere Crawler-Ausfälle, und jeder fügte der Tabelle oben eine Zeile hinzu. Heute wird jedes Deployment nach dem Merge verifiziert und per Smoke-Test geprüft, und Crawler-Ausfälle alarmieren einen Menschen, statt darauf zu warten, dass jemand auf ein Diagramm schaut.
Etwas in eine stabile Produktion zu bringen, ist ein anderes Level: Architektur, Infrastruktur und Leute, die wissen, was schiefgehen kann.

Wie machen Sie einen Crawlee-Crawler produktionsreif?
01
Stellen Sie sich vor
Ein eigener User-Agent mit einer Seite, die sagt, wer sammelt und warum.
02
Sperre und Limit
Pro Quelle nur ein Lauf gleichzeitig, mit hartem Zeitlimit.
03
Inkrementell crawlen
Von Sitemaps starten und nur holen, was sich seit dem letzten Lauf geändert hat.
04
Ertrag prüfen
Neue Datensätze und leere Felder mit den letzten Läufen vergleichen.
05
Einen Namen alarmieren
Den Alarm bekommt eine benannte Person, kein geteiltes Postfach.
Beim ersten Schritt geht es um Anstand und Recht. Unser Crawler stellt sich mit eigenem Namen und einem Link auf eine Seite vor, die erklärt, wer sammelt und warum. Eine Quelle haben wir abgeschaltet, weil ihre Bedingungen Automatisierung verbieten. Was beim Scraping erlaubt ist und wann sich ein Crawler überhaupt lohnt, steht in Web Scraping für Unternehmen: wann sich ein Crawler lohnt.
Wann ist Crawlee das falsche Werkzeug?
- Die Quelle hat eine API oder einen Export. Nutzen Sie den. Er ist stabiler, und die Bedingungen sind schriftlich festgelegt.
- Sie brauchen die Daten einmal. Ein einmaliges Skript oder Kopieren von Hand reicht.
- Die Daten liegen hinter einem Login oder die Bedingungen verbieten das Sammeln. Vereinbaren Sie den Zugang mit der Quelle.
- Ihr Team schreibt Python. Nehmen Sie Scrapy oder Crawlee für Python. Ein Crawler in einer Sprache, die niemand pflegt, stirbt beim ersten Redesign.
Hinter den meisten unserer Vorfälle steckt dasselbe Muster wie in Claude Code Hooks, die still nichts tun: Grün heißt nicht, dass es funktioniert hat.
Ist Ihr Crawler produktionsreif?
Brauchen Sie einen Crawler, der sich meldet, wenn er stehen bleibt?
Crawler und das, was sie weiter speisen, bauen wir mit Monitoring ab dem ersten Tag, im Rahmen der Prozessautomatisierung. Seit 2023 haben wir 15+ Produktionsprojekte geliefert.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Wie würden Sie heute erfahren, dass Ihr Crawler letzte Nacht nichts gebracht hat?
Kurz gesagt
- Crawlee liefert die Crawler-Grundlagen: Queue, Wiederholungen, Sessions, Proxys, Cheerio oder einen echten Browser.
- Starten Sie mit CheerioCrawler. Einen Browser nur dort, wo das HTML nicht reicht.
- In Produktion ist der schlimmste Fehler ein grüner Lauf, der nichts speichert.
- Jeden Lauf sperren, zeitlich begrenzen, inkrementell crawlen und den Ertrag mit den letzten Läufen vergleichen.
- Den Alarm bekommt eine benannte Person.
Häufige Fragen
Was ist Crawlee?
Eine Open-Source-Bibliothek für Web Crawling und Scraping. Sie bietet eine Schnittstelle für schnelles HTTP-Crawling mit HTML-Parsern und für echte Browser mit Playwright oder Puppeteer, dazu eine persistente Request-Queue, Wiederholungen, Sessions und Proxy-Rotation.
CheerioCrawler oder PlaywrightCrawler?
Starten Sie mit CheerioCrawler. Er lädt das HTML und parst es, das ist schnell und leicht. Wechseln Sie für eine Quelle nur dann zu PlaywrightCrawler, wenn ihre Seiten Inhalte per JavaScript rendern oder Klicks brauchen. Beide nutzen denselben Router und dieselbe Queue.
Crawlee oder Scrapy?
Wählen Sie die Sprache, die Ihr Team pflegen wird, denn ein Crawler muss immer wieder repariert werden. Ein TypeScript-Team nimmt Crawlee. Ein Python-Team nimmt Scrapy oder Crawlee für Python.
Warum hört ein Crawlee-Crawler auf zu funktionieren?
Die Website ändert sich oder blockiert Sie, oder der Lauf selbst scheitert: ein Zeitlimit, ein hart beendeter Prozess, ein Zeitplan, der nicht der ist, den Sie annehmen. Am schlimmsten ist ein Lauf, der grün endet und nichts speichert. Deshalb prüfen wir nach jedem Lauf den Ertrag.
Wie überwacht man einen Crawler?
Prüfen Sie nach jedem Lauf, dass er lief, wie viele neue Datensätze er im Vergleich zu den letzten Läufen brachte und dass die wichtigen Felder gefüllt sind. Alarmieren Sie eine benannte Person. Ein Lauf, der lange nach seinem Zeitlimit noch auf laufend steht, gilt als gescheitert.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity