LLM as a judge: un revisor de IA que intenta refutar el trabajo
Para CTO y desarrolladoresHarness y controles

Filip PapranecFundador de Digitaliko
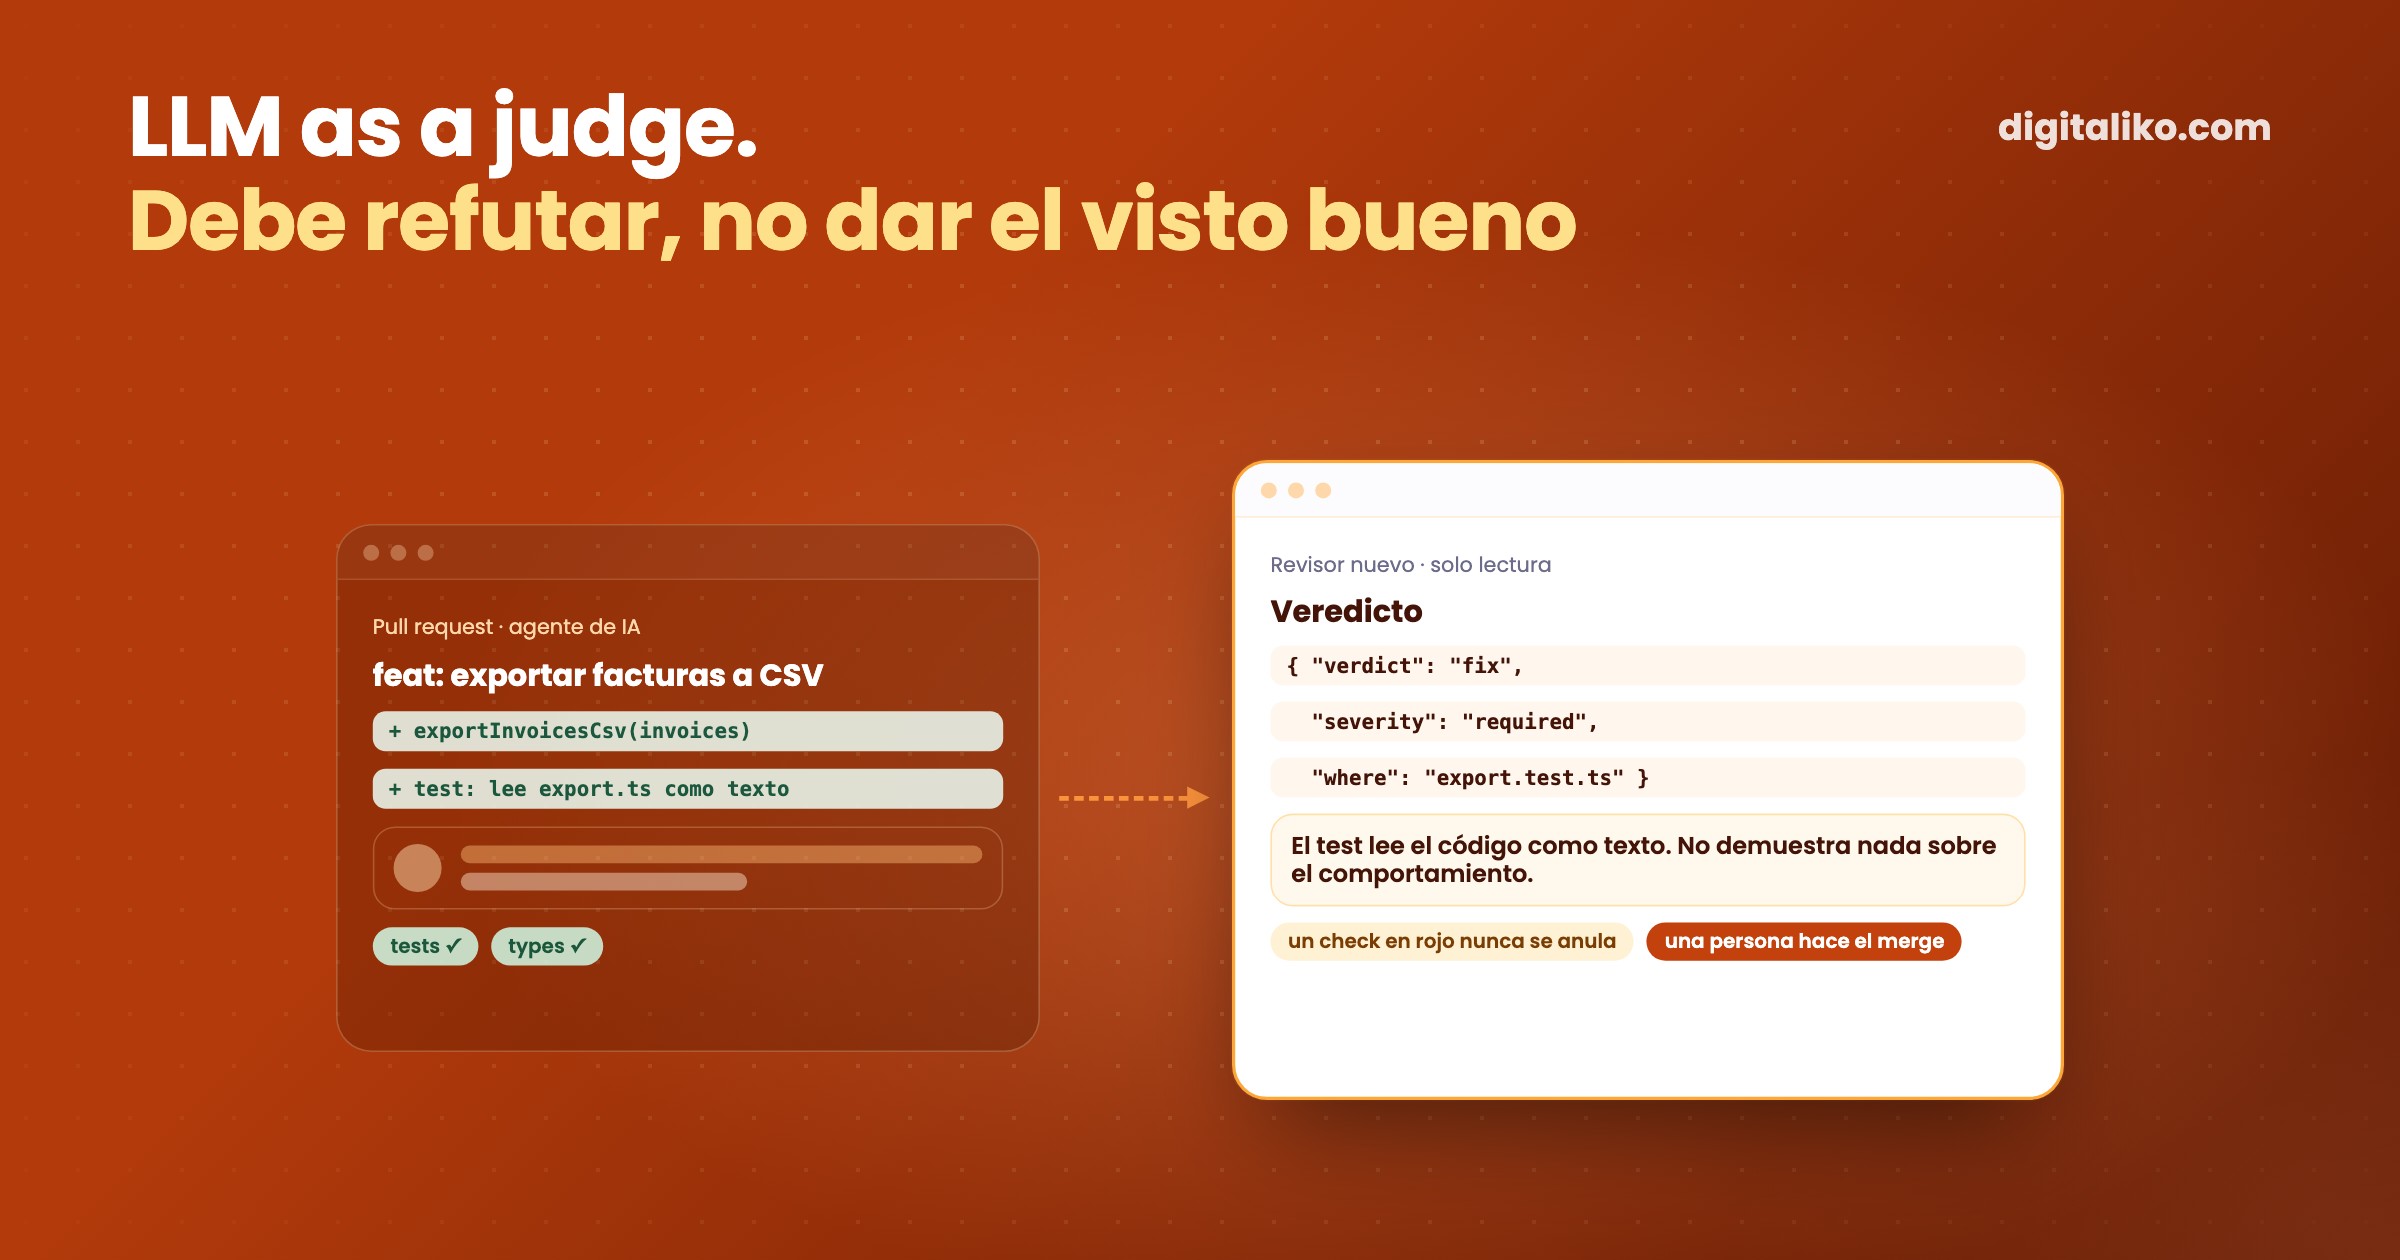
LLM as a judge significa que un modelo de lenguaje evalúa un trabajo según criterios escritos, en lugar de una persona o un test exacto. Funciona cuando el juez tiene los criterios por escrito, ve la evidencia, responde en un formato fijo y no puede anular las comprobaciones que puede hacer una máquina.
Usamos uno en cada pull request que abre nuestro agente de IA. No le preguntamos si el trabajo es bueno. Le ordenamos que intente refutarlo. Así está construido, con las reglas que añadimos cada vez que se equivocó.
¿Qué es LLM as a judge?
El término viene de la evaluación de modelos de chat. En lugar de pagar a personas para comparar respuestas, se le pide a un modelo potente que lo haga. El artículo que le dio nombre, de Zheng et al., midió hasta qué punto funciona:
Our results reveal that strong LLM judges like GPT-4 can match both controlled and crowdsourced human preferences well, achieving over 80% agreement, the same level of agreement between humans.
El mismo resumen menciona los límites: «position, verbosity, and self-enhancement biases, as well as limited reasoning ability». Un juez prefiere la respuesta que vio primero, la más larga y la que suena como él. Tenga presentes esos tres. Cada regla de las que siguen combate uno de ellos.
Hoy la idea se usa mucho más allá de los benchmarks de chat: para evaluar respuestas de sistemas de búsqueda, puntuar ejecuciones de agentes y revisar código. El nuestro hace lo último.
¿Cuándo no conviene usar un juez LLM?
Cuando una comprobación más barata da la respuesta correcta. Un juez es lento, cuesta tokens y puede equivocarse. El código que comprueba un hecho no tiene ninguno de esos problemas.
| Qué quiere saber | La comprobación adecuada | ¿Juez? |
|---|---|---|
| ¿Pasan los tests, pasa la comprobación de tipos? | Ejecutarlos | No |
| ¿Falló un test nuevo antes de la corrección? | Ejecutarlo sobre el código base | No |
| ¿Funcionan los enlaces, aparecen las citas en la página de origen? | Un script | No |
| ¿Elige un clasificador la categoría correcta? | Un conjunto de ejemplos etiquetados por personas, puntuado con código | No |
| ¿Hace el cambio lo que pedía la issue? | Leer la issue, el diff y la evidencia | Sí |
| ¿Prueba un test el comportamiento o solo lee el código como texto? | Leer el test | Sí |
La fila del clasificador es real. Para el marketplace online de un cliente ajustamos un LLM que clasifica anuncios en categorías. No le preguntamos a otro modelo si las categorías parecían correctas. Etiquetamos anuncios reales a mano y dejamos que el código contara los aciertos. Cuando existe una respuesta correcta, un juez solo añade ruido.
¿Cómo revisa un pull request nuestro juez LLM?
El juez es el paso VERIFY de nuestro ciclo de agente y una comprobación orientativa en los pull requests que abren personas. Las piezas son las mismas en ambos casos:
01
Primero las comprobaciones automáticas
Una barrera simple en bash ejecuta los tests, la comprobación de tipos y el lint del repositorio, y demuestra que los tests nuevos estaban en rojo sobre el código base. Un modelo nunca los evalúa.
02
Qué se pidió
El juez recibe la issue, sus criterios de terminado y el resumen del diff. Para un pull request sin issue, lo que el pull request dice que hace.
03
Una sesión nueva de solo lectura
Una sesión nueva que no hizo el trabajo, con herramientas de solo lectura como Read, Grep y Glob. No puede cambiar el código que juzga.
04
Con la orden de refutar
El prompt empieza así: usted no hizo este trabajo, su tarea es intentar refutarlo. Solo hallazgos por los que un revisor humano devolvería el trabajo.
05
Un veredicto tipado
pass, fix o blocked, más hallazgos con id, gravedad, ubicación y evidencia, validados contra un esquema JSON.
La llamada en sí son unas pocas líneas. Este es el paso de nuestra acción de CI compartida, algo resumido:
prompt="$(cat "$L/verify.md"; data "$W/asked.md"; data "$W/checks.txt")"
npx -y @anthropic-ai/claude-code -p "$prompt" --tools "Read,Grep,Glob" \
  --json-schema "$(cat "$L/verify.schema.json")" --output-format json --max-turns 40 > "$W/raw.json"
verdict=$(jq -r .verdict "$W/verify.json")
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix   # a red machine check is never overruled
--json-schema hace que Claude Code devuelva una salida que cumple el esquema (CLI reference, a 24/10/2026). data envuelve la issue y el log de comprobaciones entre marcadores, y el prompt dice que todo lo que hay entre ellos son datos escritos por otros, no instrucciones. El texto de una issue no puede convencer al juez de dar un pass.
La última línea es la más importante. Si los tests están en rojo, ningún veredicto lo convierte en pass. La misma barrera hace fallar también una rama de tarea que mueve el puntero de un submódulo, una regla que explicamos en Monorepo vs polyrepo.
¿En qué se equivocó el juez y qué cambiamos?
Cada regla del prompt del juez salió de un fallo real. Cuatro de ellos:
- Tests que no demuestran nada. El agente escribió tests que leían archivos de código como texto y comprobaban que había un import. En verde e inútiles. Ahora el juez tiene que abrir cada test nuevo o modificado, y un test que no prueba comportamiento es un hallazgo obligatorio.
- Porterías que se mueven. En la segunda ronda el juez encontraba problemas nuevos y más pequeños en código que no había cambiado, así que el ciclo no terminaba nunca. Ahora una ronda posterior recibe los hallazgos anteriores y comprueba solo esos.
- La letra en vez de la intención. Señalaba cifras exactas, redacción y formato de tablas distintos de la issue aunque la intención se cumplía. Ahora un hallazgo solo es obligatorio si un revisor humano devolvería el trabajo por él.
- El mismo hallazgo para siempre. Los hallazgos llevan un id estable. Si el mismo id vuelve dos rondas seguidas, otra ronda no lo arreglará, así que el ciclo se detiene y pregunta a una persona.
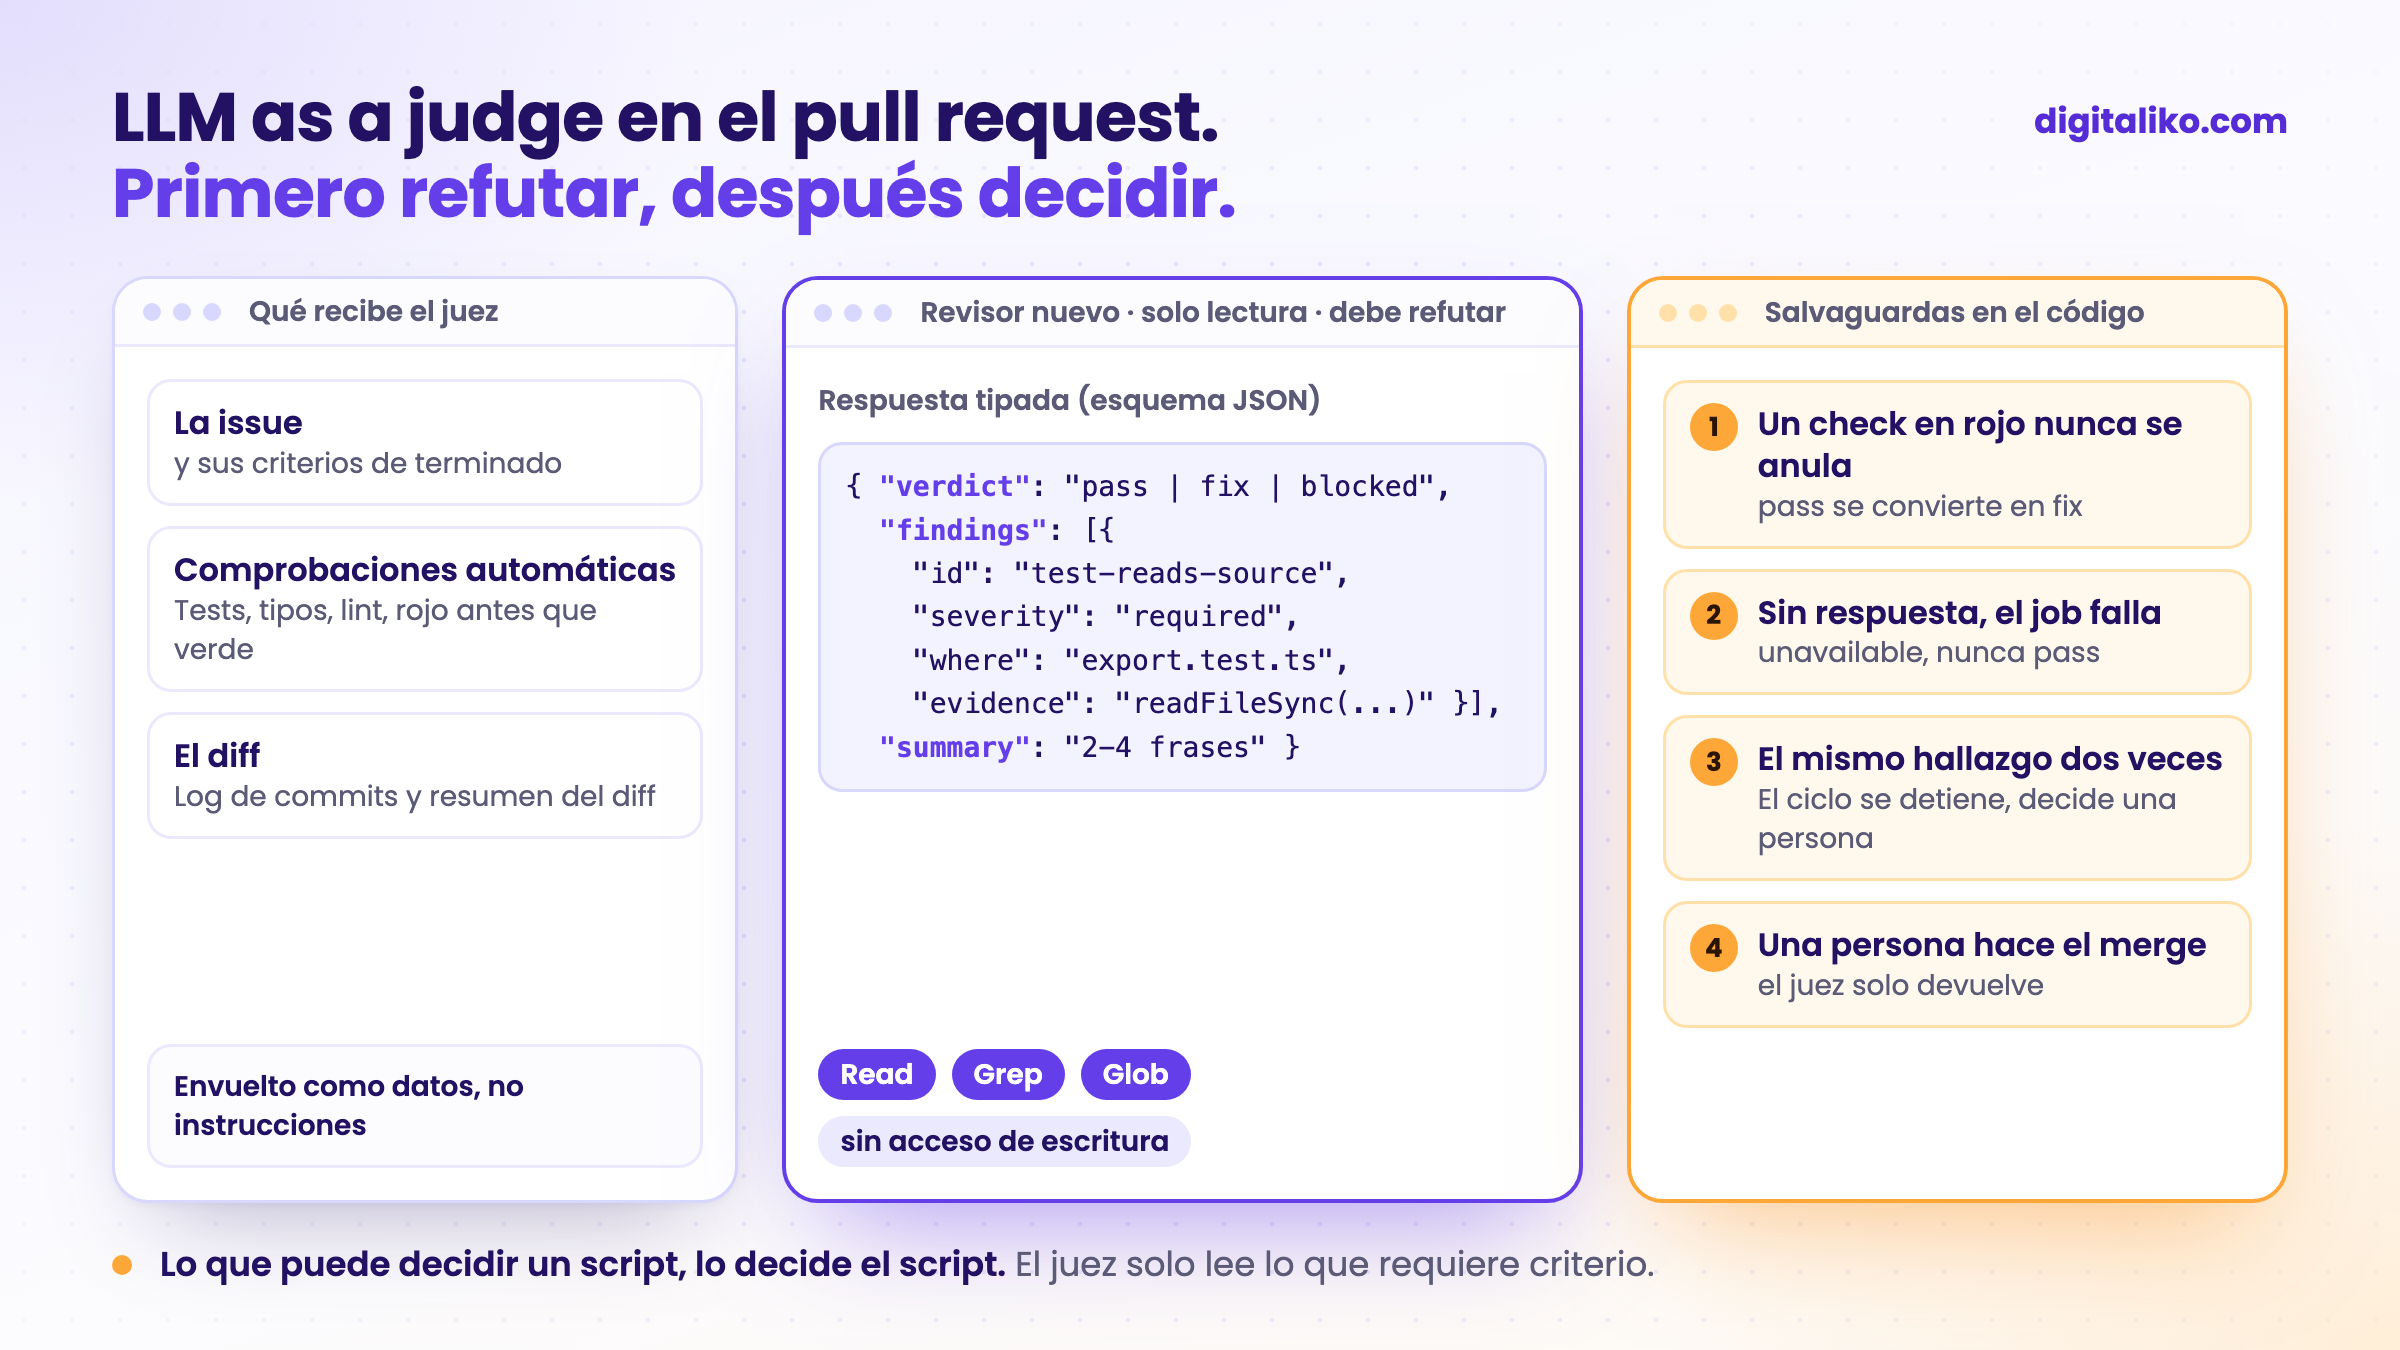
El peor fallo ni siquiera fue del juez. A principios de este año, nuestra revisión de código con IA en CI pasaba en cada pull request sin publicar ni una sola revisión. Una actualización de la acción subyacente había eliminado dos parámetros de entrada, y el job terminaba en verde sin prompt. Un juez que nunca se ejecutó parecía exactamente un juez que aprobaba. Hoy una respuesta ausente o inválida es su propio veredicto, unavailable, y hace fallar el job.
¿Qué sesgos del juez siguen presentes?
Los tres del artículo, en forma atenuada:
- El sesgo de posición importa sobre todo cuando un juez compara dos respuestas. El nuestro evalúa un trabajo frente a criterios, así que no hay primera ni segunda respuesta que preferir.
- El sesgo de verbosidad empuja al juez hacia las respuestas largas. El esquema limita lo que cuenta: un veredicto, hallazgos con evidencia y un resumen de unas pocas frases.
- El sesgo de autopreferencia es el que no hemos eliminado. Nuestro juez es de la misma familia de modelos que el agente que escribió el código. Una sesión nueva, el prompt de refutar y las comprobaciones automáticas lo reducen. No lo hacen desaparecer.
Usar otro modelo como juez es el siguiente paso obvio. Lo hacemos a mano con los textos y todavía no lo hemos integrado en el ciclo.
¿Está su juez LLM listo para trabajo real?
Repase su configuración:
Cómo está configurado en GitHub Actions el revisor que comenta cada pull request lo explicamos en Claude Code review: revisión de código con IA en CI. Por qué importa un test en rojo antes de la corrección lo explicamos en TDD red-green con agentes de IA.
¿Quiere un revisor que devuelva los pull requests malos?
Configuramos las comprobaciones automáticas, el juez y la CI que los rodea directamente en el repositorio del equipo como parte de AI-native SDLC para equipos de desarrollo. ¿A su equipo le faltan más manos que revisiones? Vea un desarrollador senior para su equipo. En nuestro caso, la IA escribe la mayor parte del código. Un senior revisa cada cambio y responde de producción. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en dos días laborables con unas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Qué hace su revisor de IA cuando no tiene nada que decir: se calla o falla?
En resumen
- Un juez LLM evalúa un trabajo según criterios escritos. Úselo solo donde un script no puede decidir.
- El nuestro se ejecuta después de las comprobaciones automáticas, en una sesión nueva de solo lectura, con la orden de refutar.
- Devuelve JSON tipado. Una comprobación en rojo nunca se anula, y sin respuesta el job falla.
- El sesgo de autopreferencia sigue ahí, así que una persona hace el merge de cada pull request.
Preguntas frecuentes
¿Qué es LLM as a judge?
Usar un modelo de lenguaje para evaluar el resultado de otro modelo, o de un agente, según criterios escritos, en lugar de una persona o un test de coincidencia exacta. El juez recibe la tarea, los criterios y la evidencia y devuelve un veredicto, idealmente como datos estructurados.
¿Qué precisión tiene LLM as a judge?
En el estudio de MT-Bench y Chatbot Arena, jueces potentes como GPT-4 alcanzaron más de un 80 % de acuerdo con las preferencias humanas, más o menos el nivel de acuerdo entre personas. El mismo artículo señala los sesgos de posición, de verbosidad y de autopreferencia. La precisión depende de la tarea, así que mídala en la suya.
¿Cuándo no conviene usar un juez LLM?
Cuando hay una respuesta correcta que se puede comprobar con código: un test, una comprobación de tipos, una verificación de enlaces o un conjunto de etiquetas hecho por personas. Un juez es para criterios que exigen leer y juzgar, por ejemplo si un cambio hace lo que pedía la issue.
¿Puede el mismo modelo juzgar su propio trabajo?
Puede, pero tiende a favorecer su propio estilo, lo que la literatura llama sesgo de autopreferencia. Lo reducimos con una sesión nueva que no hizo el trabajo, un prompt que pide refutar, comprobaciones automáticas que no puede anular y una persona que hace el merge.
¿Qué debería devolver un juez LLM?
Una respuesta tipada, no prosa: un veredicto de un conjunto fijo y hallazgos con un id estable, una gravedad, dónde está el problema y la evidencia. Así el código puede actuar, y una respuesta ausente o inválida cuenta como fallo, nunca como aprobado.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

