Vibe coding a agentic engineering: na czym polega różnica?
Dla CTO i programistówHarness i kontrole

Filip PapranecZałożyciel Digitaliko
Vibe coding oznacza, że wpisują Państwo prompt do AI i akceptują wynik, gdy tylko wygląda na gotowy. Agentic engineering używa tych samych agentów AI w systemie: specyfikacja, testy, hooki, bramka review i człowiek, który robi merge. Ten sam model, to samo AI. Różnica to zamknięta pętla wokół niego, i to ona decyduje, czy kod przetrwa produkcję.
Tak pracujemy na co dzień. Większość naszego kodu pisze AI. Senior przegląda każdą zmianę i odpowiada za to, co trafia na produkcję. Ten artykuł rozwija karuzelę na LinkedInie, którą Filip opublikował w maju 2026 roku, i pokazuje kod, który uruchamiamy za każdym stwierdzeniem.
Czym jest vibe coding, a czym agentic engineering?
Andrej Karpathy ukuł termin „vibe coding” w lutym 2025 roku: poddajemy się vibe’om i zapominamy, że kod w ogóle istnieje. Simon Willison wyraźnie wyznacza granicę w swoim przewodniku Agentic Engineering Patterns: „I use the term agentic engineering to describe the practice of developing software with the assistance of coding agents.” Vibe coding w jego węższym znaczeniu to nieprzejrzany kod o jakości prototypu. Agentic engineering to kod doprowadzony do standardu produkcyjnego, z review i weryfikacją.
Najwyższe wyniki dla tego pytania kończą się na definicji. Tak wygląda różnica w repozytorium:
| Vibe coding | Agentic engineering | |
|---|---|---|
| Kto decyduje, że jest gotowe | Ten, kto ogląda demo | Kody wyjścia, potem recenzent, który nie pisał tego kodu |
| Testy | Opcjonalne, pisane później, jeśli w ogóle | Pisane najpierw; muszą nie przechodzić na starym kodzie |
| Zabezpieczenia | Dobre maniery modelu | Hooki pod agentem, których nie może edytować |
| Błędy | Powtarzają się w następnej sesji | Raz zamieniają się w regułę albo sprawdzenie |
| Kto robi merge | Ten, kto pisał prompt | Człowiek, który robi review |
| Do czego się nadaje | Dema, eksperymenty, narzędzia jednorazowe | Oprogramowanie, na którym działa firma |
Dlaczego działający kod to jeszcze nie oprogramowanie produkcyjne?
AI przełamało barierę składni. Każdy może opisać, czego chce, i dostać kod, który działa. To prawda i korzystamy z tego codziennie.
- projektów produkcyjnych od 2023 roku
- 15+
Ale działający kod i oprogramowanie produkcyjne, na którym działa Państwa firma, to dwie bardzo różne rzeczy. Oprogramowanie produkcyjne ma użytkowników, którzy wpisują nie to, co trzeba, dane, które nie mogą wyciec, płatności, które muszą się zgadzać, i kolejnego programistę, który musi je zrozumieć. Demo nie ma nic z tych rzeczy. Musi zadziałać raz, na jednym laptopie, gdy ktoś patrzy.
Nasze szersze spojrzenie na tę lukę, dla założycieli, znajdą Państwo w artykule Od vibe codingu do produkcji: czego brakuje prototypowi.
Co się psuje bez systemu wokół AI?
Sześć rzeczy, w kolejności, w jakiej zwykle bolą:
- Brak zamkniętej pętli. Wynik idzie prosto do „akceptuj”. Nic nie sprawdza go testem, zanim zdecyduje człowiek.
- Brak zabezpieczeń. Agent może uruchomić każde polecenie, które uzna za przydatne, także takie, na które nigdy by Państwo nie pozwolili.
- Brak granic. Nie ma reguł architektury, więc każda sesja wymyśla własną strukturę.
- Brak nauki. Bez systemu AI nie uczy się na własnych błędach. Ten sam bug wraca w następnym tygodniu, bo nic nie zamieniło poprawki z zeszłego tygodnia w regułę.
- Akceptowanie wyniku, który tylko wygląda na gotowy. Ładnie wyglądający interfejs to nie zielony zestaw testów.
- Brak eksperckiego osądu. Nikt, kto rozumie domenę, nie prowadzi pracy do właściwego wyniku.
Żadne z tych zagadnień nie jest problemem modelu. Mocniejszy model sprawia tylko, że wynik wygląda na jeszcze bardziej gotowy. Rozwiązanie leży wokół modelu, nie w nim.
Jak wygląda zamknięta pętla agentowa?
W naszych repozytoriach jedno zadanie przechodzi przez jedną pętlę: specyfikacja, agent AI, bramka, poprawka, merge. Łączy ją wizrd, nasz wewnętrzny plugin i CLI do Claude Code (niepubliczny). Reguła projektowa stoi na samej górze dispatchera:
# Deterministic on purpose: code decides WHAT to take and WHEN it is done, models only do the work.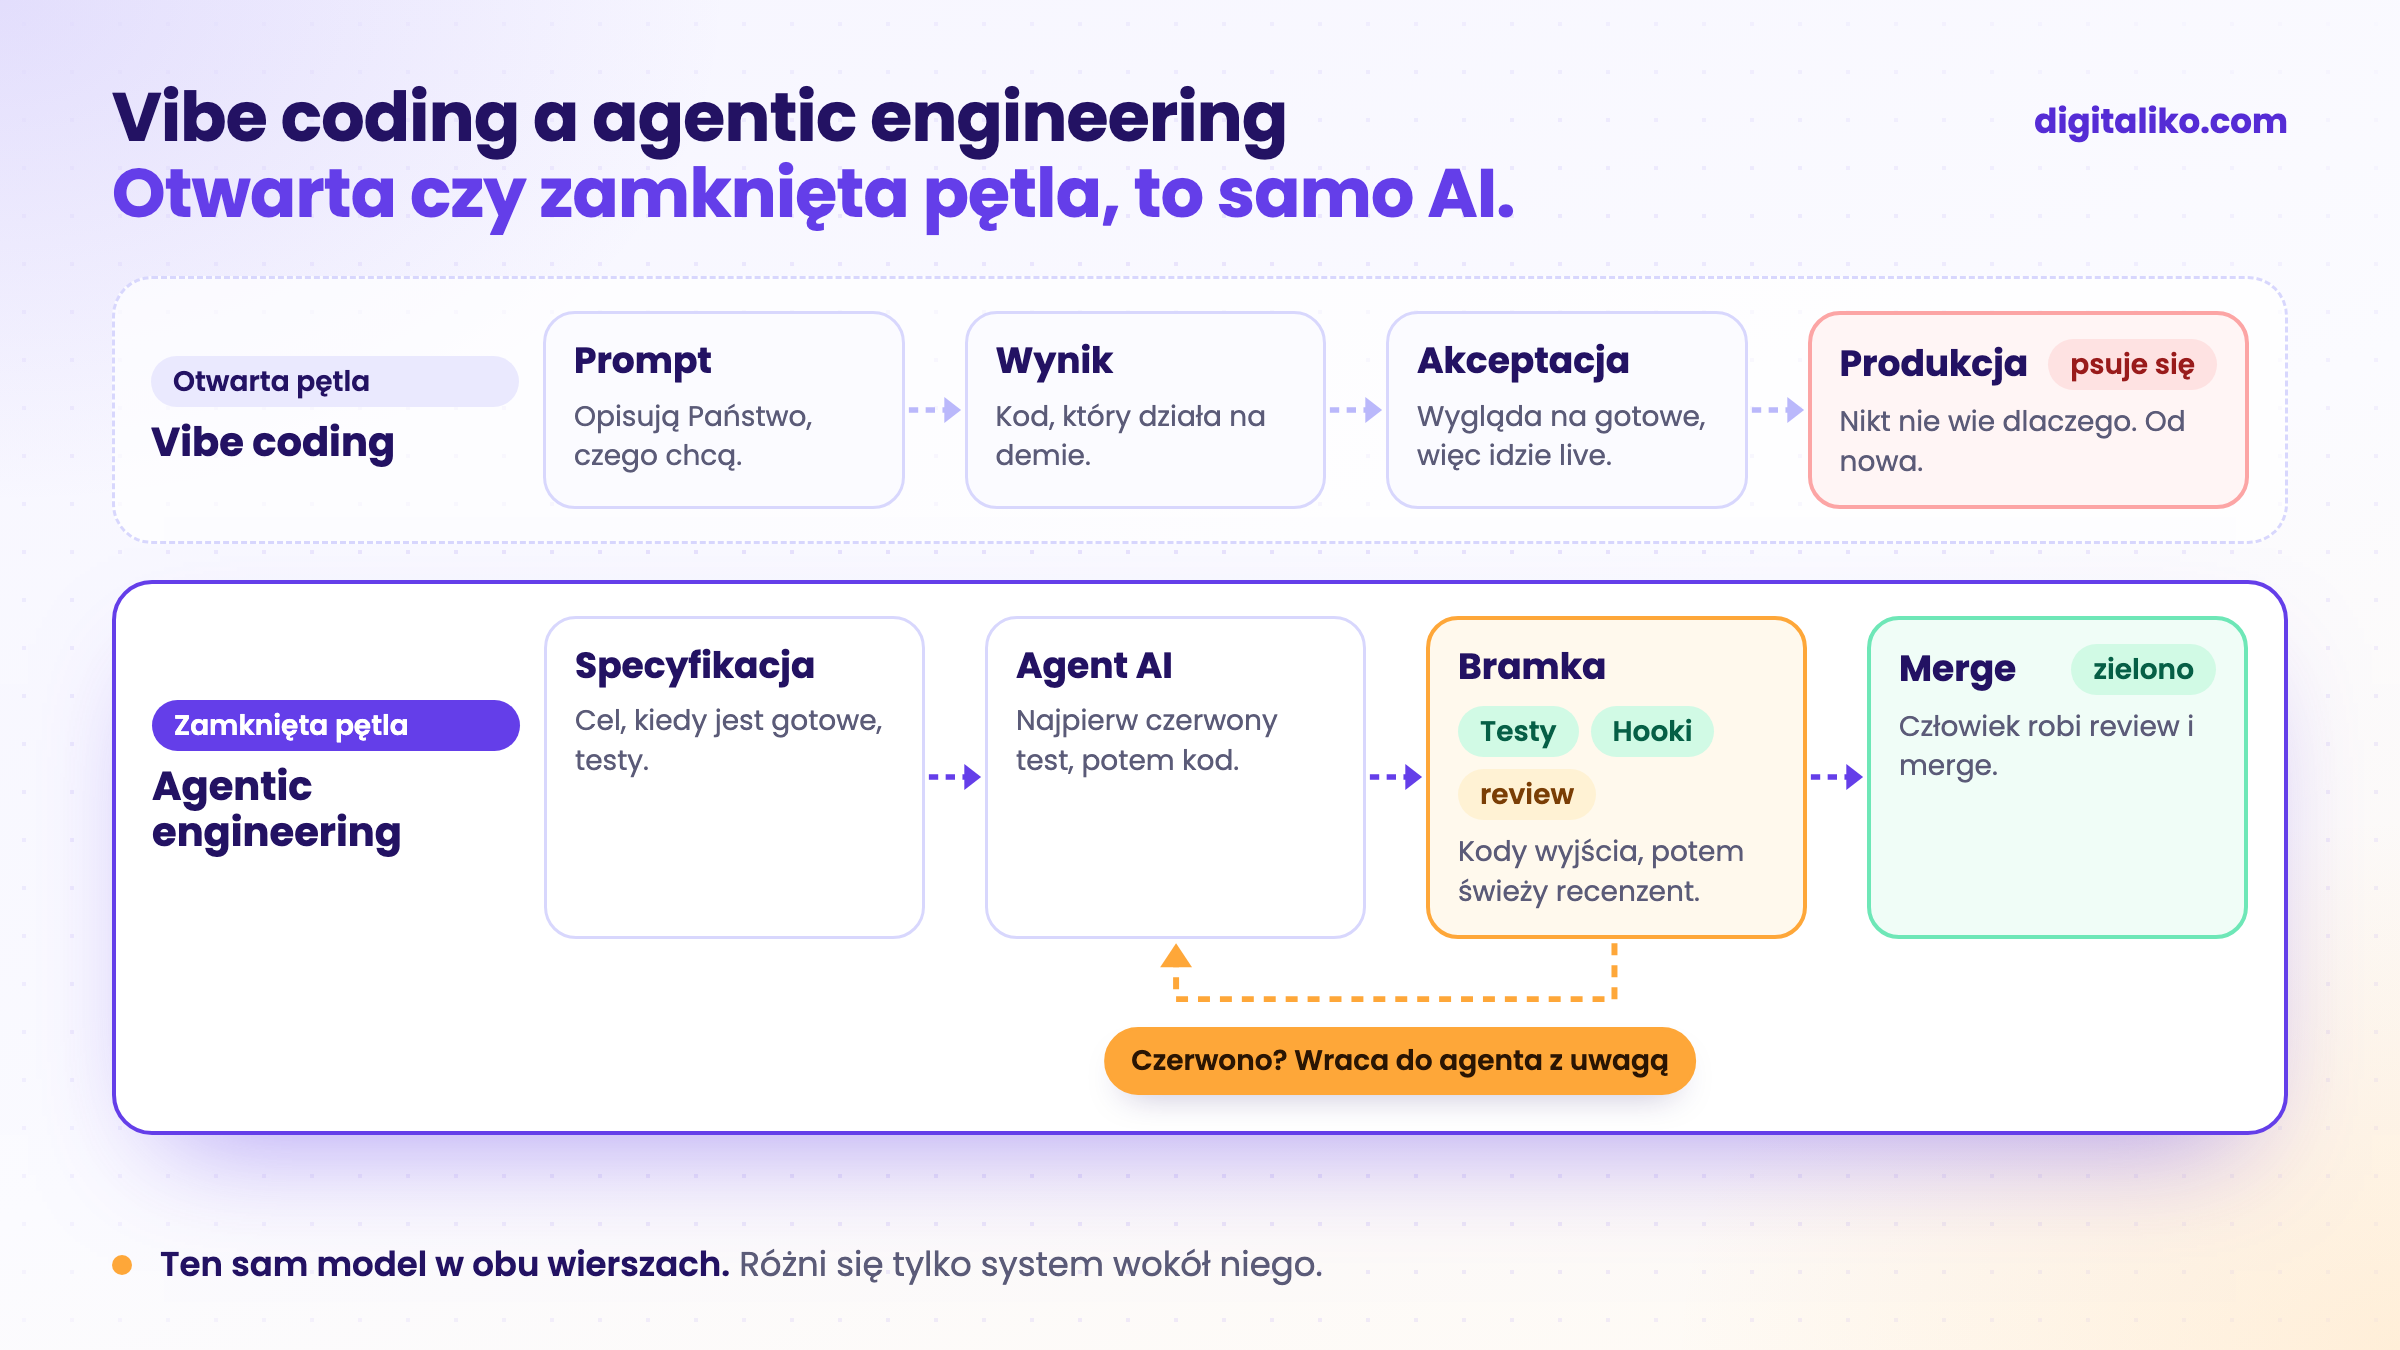
Bramka to skrypt bash, gate.sh. Uruchamia własne skrypty repozytorium do typecheck, lint, testów i buildu, a potem sprawdzenie red-proof: nowe testy muszą nie przechodzić na gałęzi bazowej, inaczej niczego nie dowodzą. Exit 0 to zielony, exit 1 czerwony. Tej części nigdy nie ocenia model.
Ta sama bramka działa w sesji agenta jako Stop hook w Claude Code. Gdy agent próbuje skończyć przy czerwonych sprawdzeniach, hook blokuje zakończenie i przekazuje mu błędy. W skrócie:
bash "$HARNESS/loop/gate.sh" "$type" "$tree" "$base" "$out" "$W" && exit 0
jq -n --arg r "Executable checks are red. Fix this before you finish:
$(head -c 3000 "$out")" '{decision: "block", reason: $r}'
Po bramce przychodzi świeży recenzent: wywołanie modelu tylko z narzędziami do odczytu, któremu mówimy, że nie wykonał tej pracy i że jego zadaniem jest próbować ją obalić. Jedna linia trzyma go w uczciwości:
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix # a red executable check is never overruled to passUwagi wracają do tej samej sesji agenta. To jest strzałka „poprawka”. Gdy recenzent zgłosi tę samą uwagę dwa razy z rzędu, pętla się zatrzymuje, a człowiek dostaje zadanie z tą uwagą. Całą pętlę krok po kroku opisujemy w artykule Harness engineering w praktyce: od issue do PR.
Czy ktoś poza Państwa repozytoriami tak robi?
Tak, w dużo większej skali. 11 lutego 2026 roku OpenAI opisało produkt, który ich zespół zbudował z Codexem: około miliona linii kodu, według ich własnej oceny w mniej więcej jednej dziesiątej czasu, i ani jednej linii napisanej ręcznie. Ich puenta pasuje do karuzeli: nie lepsze prompty, lecz lepszy system wokół tego samego AI, które mają wszyscy. Reguły, lintery, testy strukturalne i pętle feedbacku.
Na czym polega prawdziwa różnica?
Proszę postawić oba produkty obok siebie kilka miesięcy po starcie.
Produkt z vibe codingu
- Działa na demie.
- Psuje się na produkcji.
- Nikt nie wie dlaczego.
- Za kilka miesięcy zaczynają Państwo od nowa.
To samo AI, z systemem
Produkt zbudowany inżynieryjnie
- Szybko trafia na produkcję.
- Sam się koryguje: czerwone sprawdzenia odsyłają pracę z powrotem.
- Rośnie z czasem: każdy błąd staje się regułą albo testem.
- Działa na nim Państwa firma.
W obu kolumnach to samo AI. Jedno ma system, drugie nie. Model, który Państwo wynajmują, wynajmuje też konkurencja, więc nie może być Państwa przewagą. To, co zbudują Państwo wokół niego, już tak.
Państwa AI jest takie samo jak u wszystkich innych. Prawdziwą przewagą jest system wokół niego.

Jak przejść od vibe codingu do agentic engineeringu?
Proszę zacząć od bramek, nie od mądrzejszego agenta. W kolejności, w jakiej byśmy je dodawali:
01
Reguły w repozytorium
Krótki CLAUDE.md albo AGENTS.md: polecenia, architektura i to, czego agent nie może robić nigdy.
02
Hooki pod agentem
Blokują niebezpieczne polecenia, zanim się uruchomią. Agent nie może ich edytować.
03
Testy red-proof
Nowy test musi najpierw nie przejść na starym kodzie. Dopiero poprawka robi go zielonym.
04
Bramka, która mówi nie
Stop hook i CI odmawiają „gotowe”, dopóki jakiekolwiek sprawdzenie jest czerwone.
05
Merge robi człowiek
Review koncepcji i ryzyka, nie każdej linii. Potem merge.
Każdy krok zamyka jedną z sześciu luk opisanych wyżej. Reguły dają granice. Hooki dają zabezpieczenia. Testy red-proof i bramka zamykają pętlę. A gdy ten sam błąd pojawi się dwa razy, staje się nową regułą albo sprawdzeniem: tak uczy się system, a nie model.
Pierwsze cztery zebraliśmy w małym publicznym repozytorium, Claude Code production starter: reguły dla agenta, hooki, bramka CI z testami red-proof, review przez AI i checklista przed startem. Licencja MIT. Zanim skopiują Państwo hooki, warto przeczytać dwa artykuły: Hooki Claude Code, które nic nie robią i Red-green TDD z agentami AI.
Czy Państwa zespół robi vibe coding, czy inżynierię?
Krótki autotest. Proszę zaznaczyć, co Państwa repozytorium ma już dziś.
Chcą Państwo takiego systemu w swoim repozytorium?
Taką pętlę budujemy bezpośrednio w repozytorium zespołu, w ramach usługi AI-native SDLC dla zespołów deweloperskich. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych. Senior od pierwszego dnia pracuje w Państwa repozytorium i pull requestach.
Zbudowali Państwo produkt samodzielnie w Lovable, Cursorze albo Claude i teraz musi wytrzymać? To inna ścieżka: zob. pomoc dla vibe coderów.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Która z sześciu luk najbardziej boli dziś Państwa zespół?
W skrócie
- Vibe coding akceptuje wynik, który wygląda na gotowy. Agentic engineering sprawdza go w zamkniętej pętli.
- W obu ten sam model. Różnicą jest system wokół niego.
- Pętla: specyfikacja, agent AI, bramka z testami, hookami i review, poprawka, potem merge robi człowiek.
- Proszę zacząć od bramek: reguły, hooki, testy red-proof, Stop hook i CI.
Najczęstsze pytania
Jaka jest różnica między vibe codingiem a agentic engineeringiem?
Vibe coding to wpisanie promptu do AI i zaakceptowanie wyniku, który wygląda na gotowy. Agentic engineering używa tych samych agentów AI w systemie: specyfikacja, testy, hooki, bramka review i człowiek, który robi merge. Model jest ten sam. To system wokół niego decyduje, czy wynik przetrwa produkcję.
Czy agentic engineering to to samo co agentic coding?
To prawie ta sama idea. Agentic coding to zwykle agent AI, który sam edytuje pliki i uruchamia polecenia. Agentic engineering dodaje wokół niego dyscyplinę: co uznajemy za gotowe, które sprawdzenia muszą przejść i kto odpowiada za to, co trafia na produkcję.
Czym jest pętla agentowa w tworzeniu oprogramowania?
To pętla, w której agent pracuje, maszyna sprawdza wynik, a czerwone sprawdzenie odsyła uwagę do agenta, dopóki nie przejdzie. Nasza wygląda tak: specyfikacja, agent, bramka, poprawka, merge. Bramka to prosty kod z kodami wyjścia, więc model nie przekona czerwonego sprawdzenia, żeby zrobiło się zielone.
Czy vibe coding jest zły?
Nie. To szybki sposób, żeby przetestować pomysł albo zbudować demo. Problem zaczyna się, gdy na demie zaczyna działać firma: prawdziwi użytkownicy, prawdziwe pieniądze, prawdziwe dane. Wtedy potrzebują Państwo testów, zabezpieczeń i człowieka, który rozumie kod.
Jak przeprowadzić zespół od vibe codingu do agentic engineeringu?
Proszę zacząć od bramek, nie od agenta: reguły dla agenta w repozytorium, hooki blokujące niebezpieczne polecenia, Stop hook, który odmawia „gotowe”, dopóki sprawdzenia są czerwone, i bramka CI z testami, które muszą najpierw nie przejść. Publiczny Claude Code production starter ma wszystkie cztery.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

