Vibe Coding vs. Agentic Engineering: der Unterschied
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer von Digitaliko
Vibe Coding heißt: Sie geben der KI einen Prompt und akzeptieren den Output, sobald er fertig aussieht. Agentic Engineering nutzt dieselben KI-Agenten in einem System: Spezifikation, Tests, Hooks, ein Review-Gate und ein Mensch, der merged. Gleiches Modell, gleiche KI. Der Unterschied ist ein geschlossener Loop darum herum, und dieser Loop entscheidet, ob der Code die Produktion übersteht.
So arbeiten wir jeden Tag. Heute schreibt KI unseren gesamten Code, und ein Senior verantwortet, was in Produktion geht. Dieser Artikel folgt einem LinkedIn-Karussell, das Filip im Mai 2026 veröffentlicht hat, mit dem Code, der hinter jeder Aussage läuft.
Was ist Vibe Coding, und was ist Agentic Engineering?
Andrej Karpathy prägte „Vibe Coding“ im Februar 2025: Man gibt sich den Vibes hin und vergisst, dass der Code überhaupt existiert. Simon Willison zieht die Linie in seinem Leitfaden Agentic Engineering Patterns: „I use the term agentic engineering to describe the practice of developing software with the assistance of coding agents.“ Vibe Coding ist bei ihm ungeprüfter Code in Prototypqualität. Agentic Engineering ist Code auf Produktionsniveau, mit Review und Verifikation.
Die Top-Ergebnisse zu dieser Frage hören bei der Definition auf. So sieht der Unterschied im Repository aus:
| Vibe Coding | Agentic Engineering | |
|---|---|---|
| Wer entscheidet, dass es fertig ist | Wer sich die Demo ansieht | Exit-Codes, dann ein Reviewer, der den Code nicht geschrieben hat |
| Tests | Optional, nachträglich, wenn überhaupt | Zuerst geschrieben; müssen auf dem alten Code fehlschlagen |
| Leitplanken | Die guten Manieren des Modells | Hooks unterhalb des Agenten, die er nicht ändern kann |
| Fehler | Wiederholen sich in der nächsten Session | Werden einmal zu einer Regel oder einem Check |
| Wer merged | Wer den Prompt geschrieben hat | Ein Mensch, der reviewt |
| Wofür es passt | Demos, Experimente, Wegwerf-Tools | Software, auf der ein Unternehmen läuft |
Warum ist funktionierender Code noch keine Produktionssoftware?
KI hat die Syntax-Barriere durchbrochen. Jeder kann beschreiben, was er will, und bekommt Code, der läuft. Das ist echt, und wir nutzen es jeden Tag.
- Produktionsprojekte seit 2023
- 15+
- Zeilen unseres Codes schreibt heute KI, ein Senior verantwortet die Produktion
- Alle
Aber funktionierender Code und Produktionssoftware, auf der Ihr Unternehmen läuft, sind zwei sehr verschiedene Dinge. Produktionssoftware hat Nutzer, die Unerwartetes eingeben, Daten, die nicht abfließen dürfen, Zahlungen, die stimmen müssen, und einen nächsten Entwickler, der sie verstehen muss. Eine Demo hat nichts davon. Sie muss nur einmal funktionieren, auf einem Laptop, während jemand zusieht.
Unsere ausführlichere Sicht für Gründer steht in Vom Vibe Coding in die Produktion: was fehlt.
Was bricht ohne ein System um die KI?
Sechs Dinge, in der Reihenfolge, in der sie meist wehtun:
- Kein geschlossener Loop. Der Output geht direkt auf „akzeptieren“. Nichts prüft ihn gegen einen Test, bevor ein Mensch entscheidet.
- Keine Leitplanken. Der Agent kann jeden Befehl ausführen, den er für nützlich hält, auch die, die Sie nie erlauben würden.
- Keine Grenzen. Ohne Architekturregeln erfindet jede Session ihre eigene Struktur.
- Kein Lernen. Ohne System lernt KI nicht aus eigenen Fehlern. Derselbe Bug kommt nächste Woche zurück, weil niemand aus dem Fix der letzten Woche eine Regel gemacht hat.
- Output akzeptieren, der nur fertig aussieht. Eine gut aussehende UI ist keine grüne Testsuite.
- Kein Expertenurteil. Niemand, der die Domäne versteht, lenkt die Arbeit zum richtigen Ergebnis.
Nichts davon ist ein Modellproblem. Ein stärkeres Modell macht den Output nur noch fertiger aussehend. Die Lösung liegt um das Modell herum, nicht darin.
Wie sieht ein geschlossener Agentic Loop aus?
In unseren Repositories läuft eine Aufgabe durch einen Loop: Spezifikation, KI-Agent, Gate, Fix, Merge. Verdrahtet wird er von wizrd, unserem internen Claude-Code-Plugin und CLI (nicht öffentlich). Die Designregel steht ganz oben im Dispatcher:
# Deterministic on purpose: code decides WHAT to take and WHEN it is done, models only do the work.
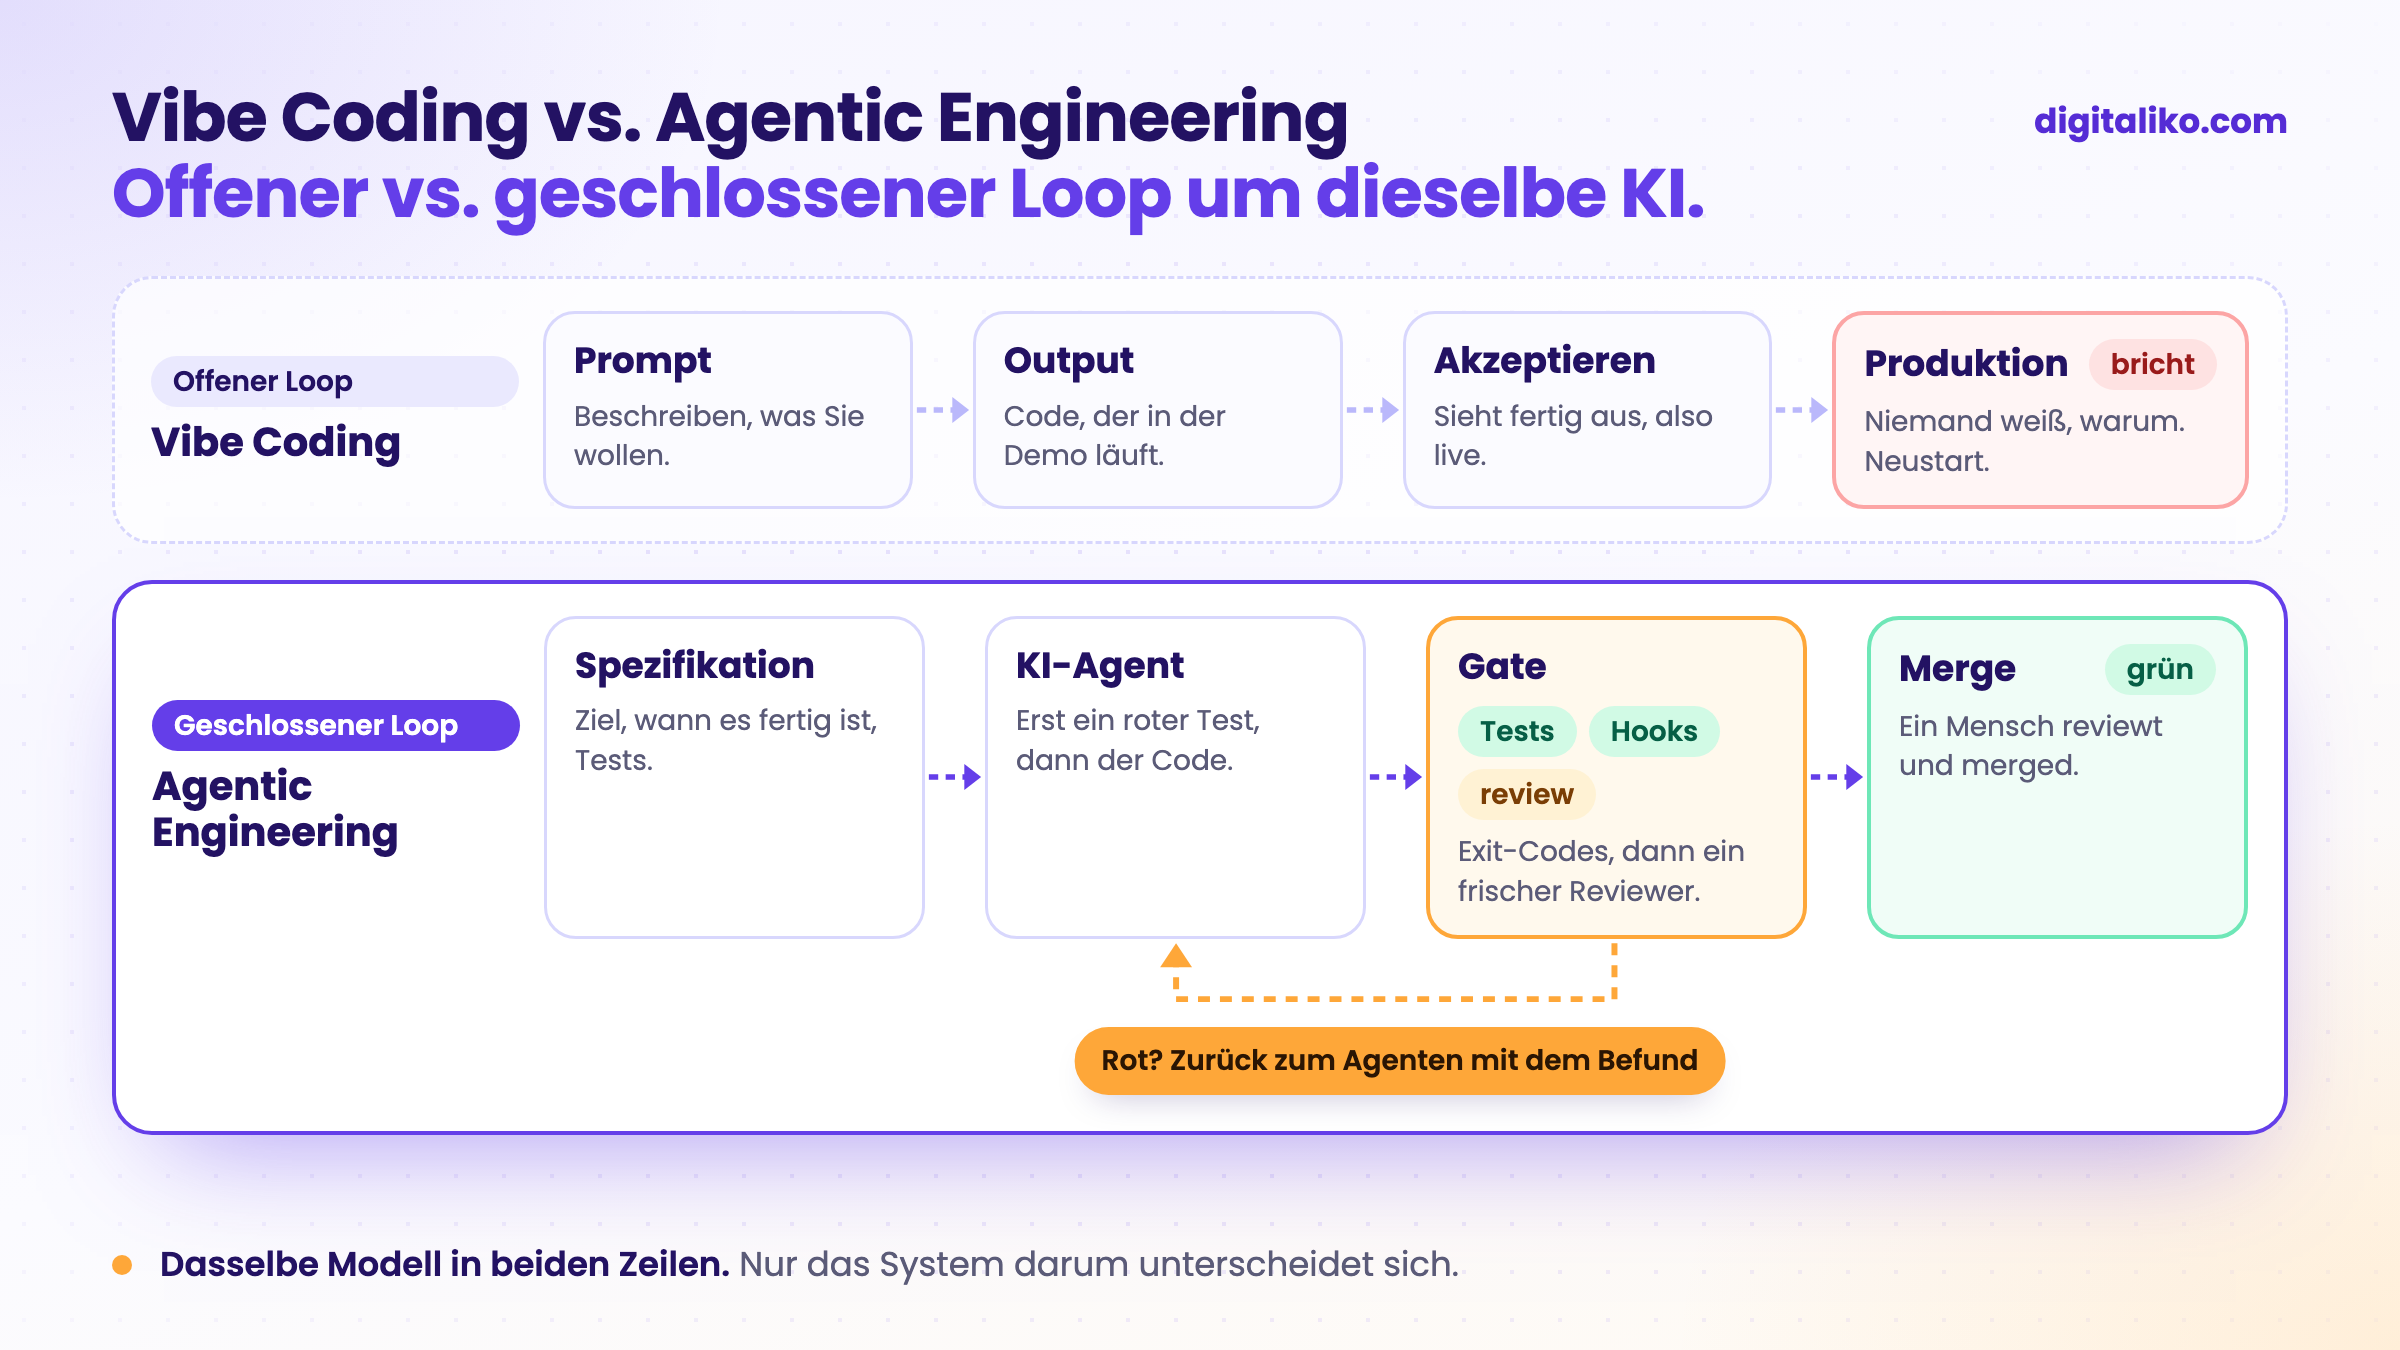
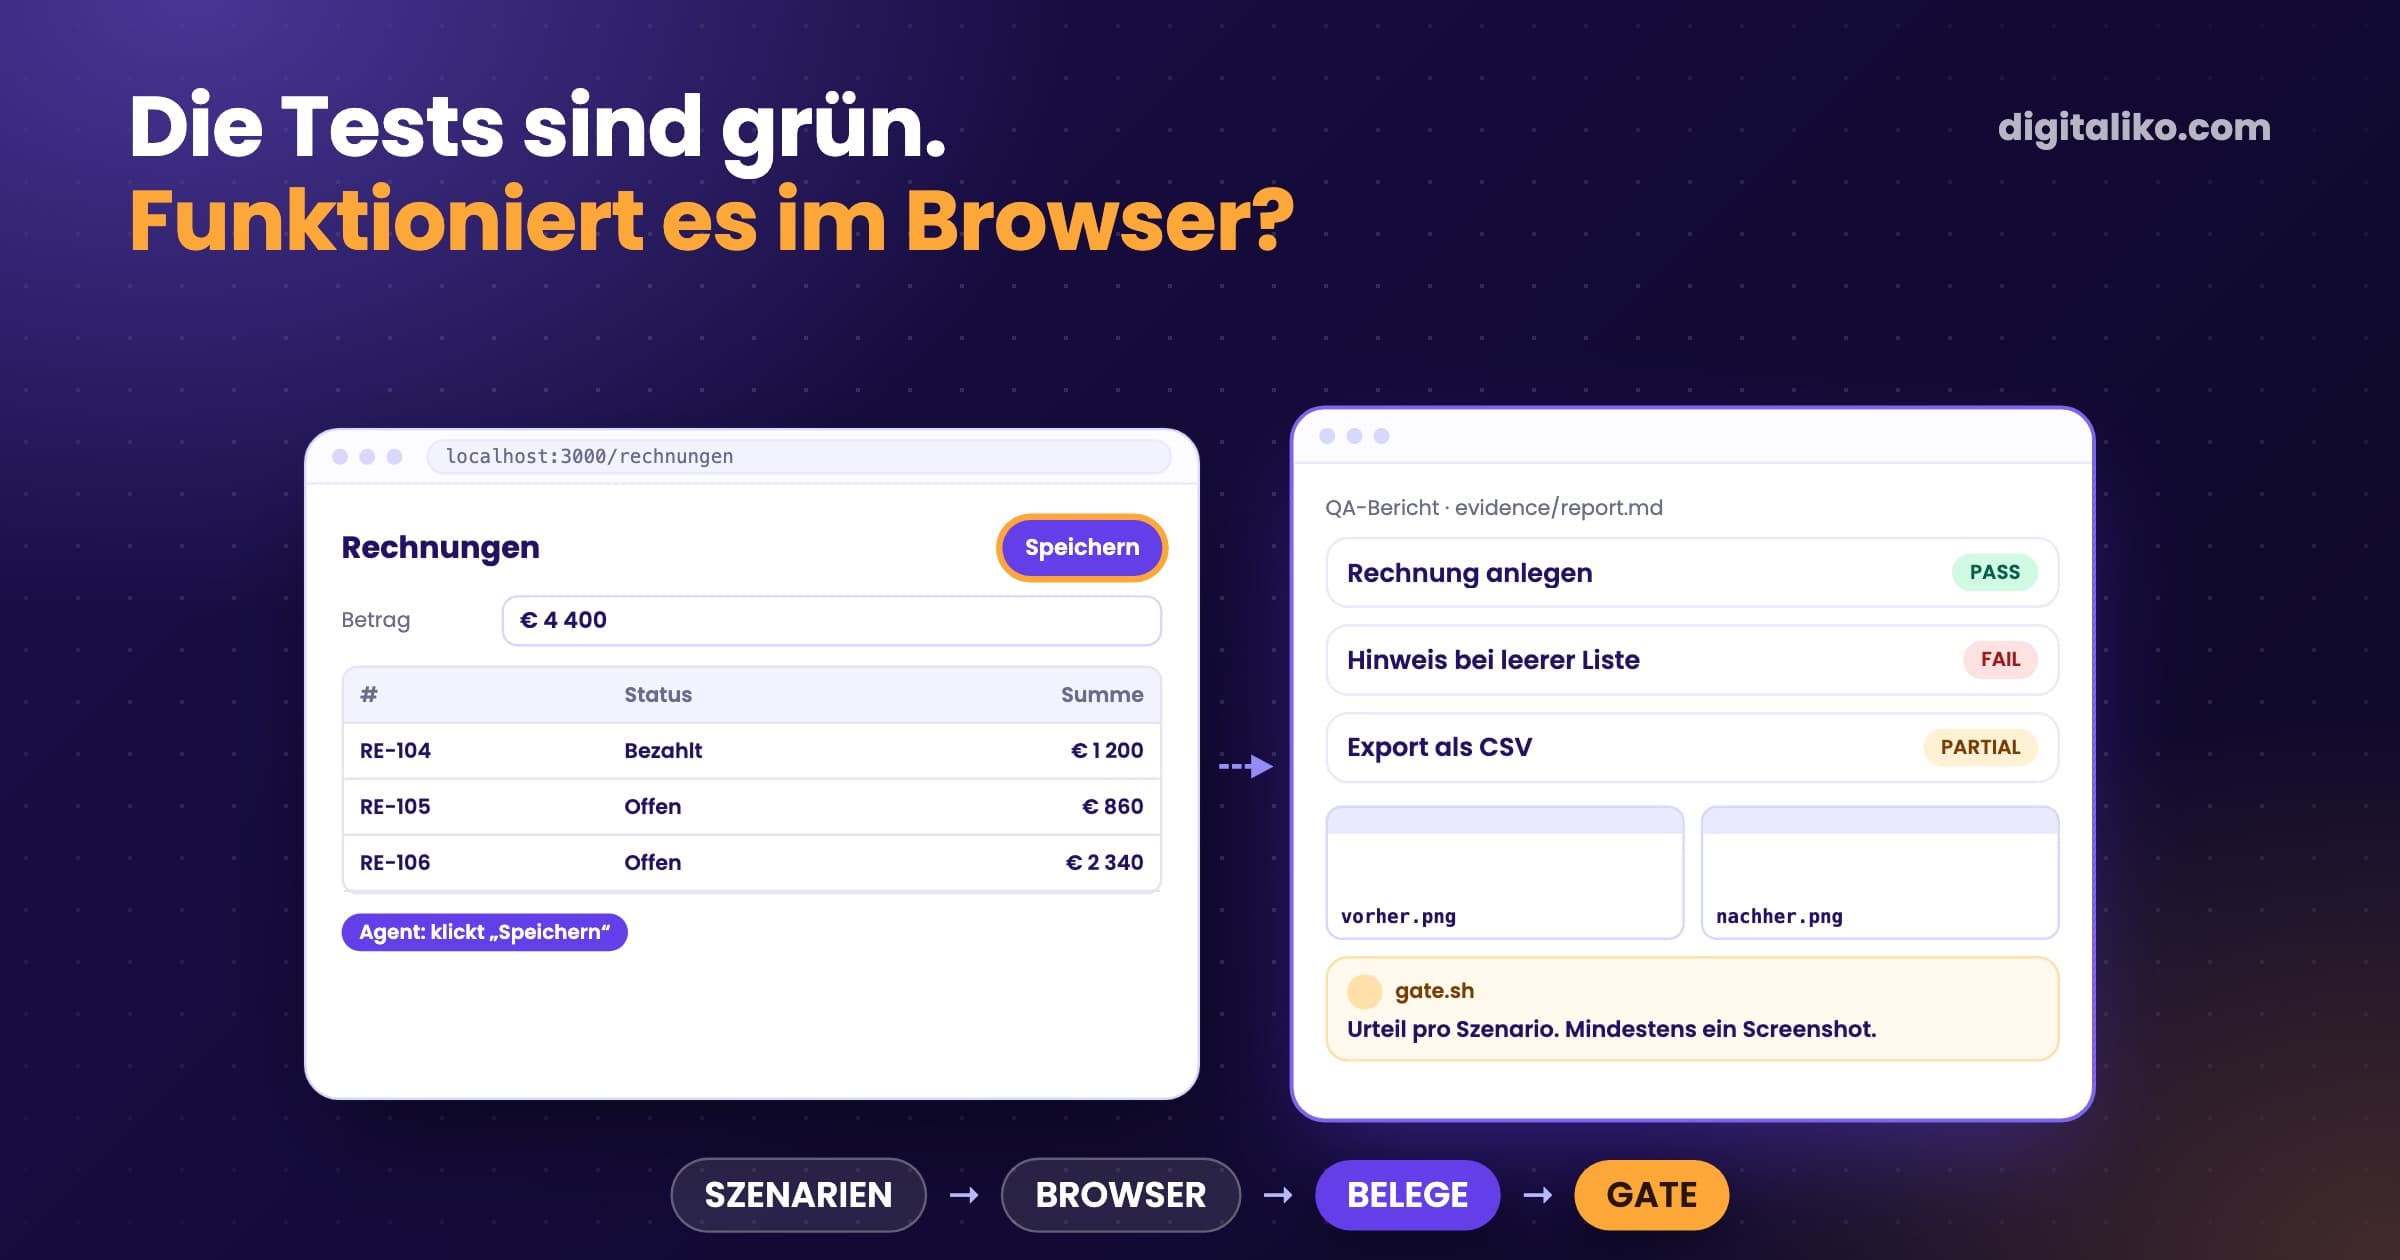
Das Gate ist ein Bash-Skript, gate.sh. Es führt die eigenen Typecheck-, Lint-, Test- und Build-Skripte des Repositorys aus, dann einen Red-Proof-Check: Neue Tests müssen auf dem Basis-Branch fehlschlagen, sonst beweisen sie nichts. Exit 0 ist grün, Exit 1 rot. Diesen Teil bewertet nie ein Modell.
Dasselbe Gate läuft auch in der Session des Agenten als Claude-Code-Stop-Hook. Will der Agent mit roten Checks aufhören, blockiert der Hook das Beenden und gibt ihm die Fehler mit. Gekürzt:
bash "$HARNESS/loop/gate.sh" "$type" "$tree" "$base" "$out" "$W" && exit 0
jq -n --arg r "Executable checks are red. Fix this before you finish:
$(head -c 3000 "$out")" '{decision: "block", reason: $r}'
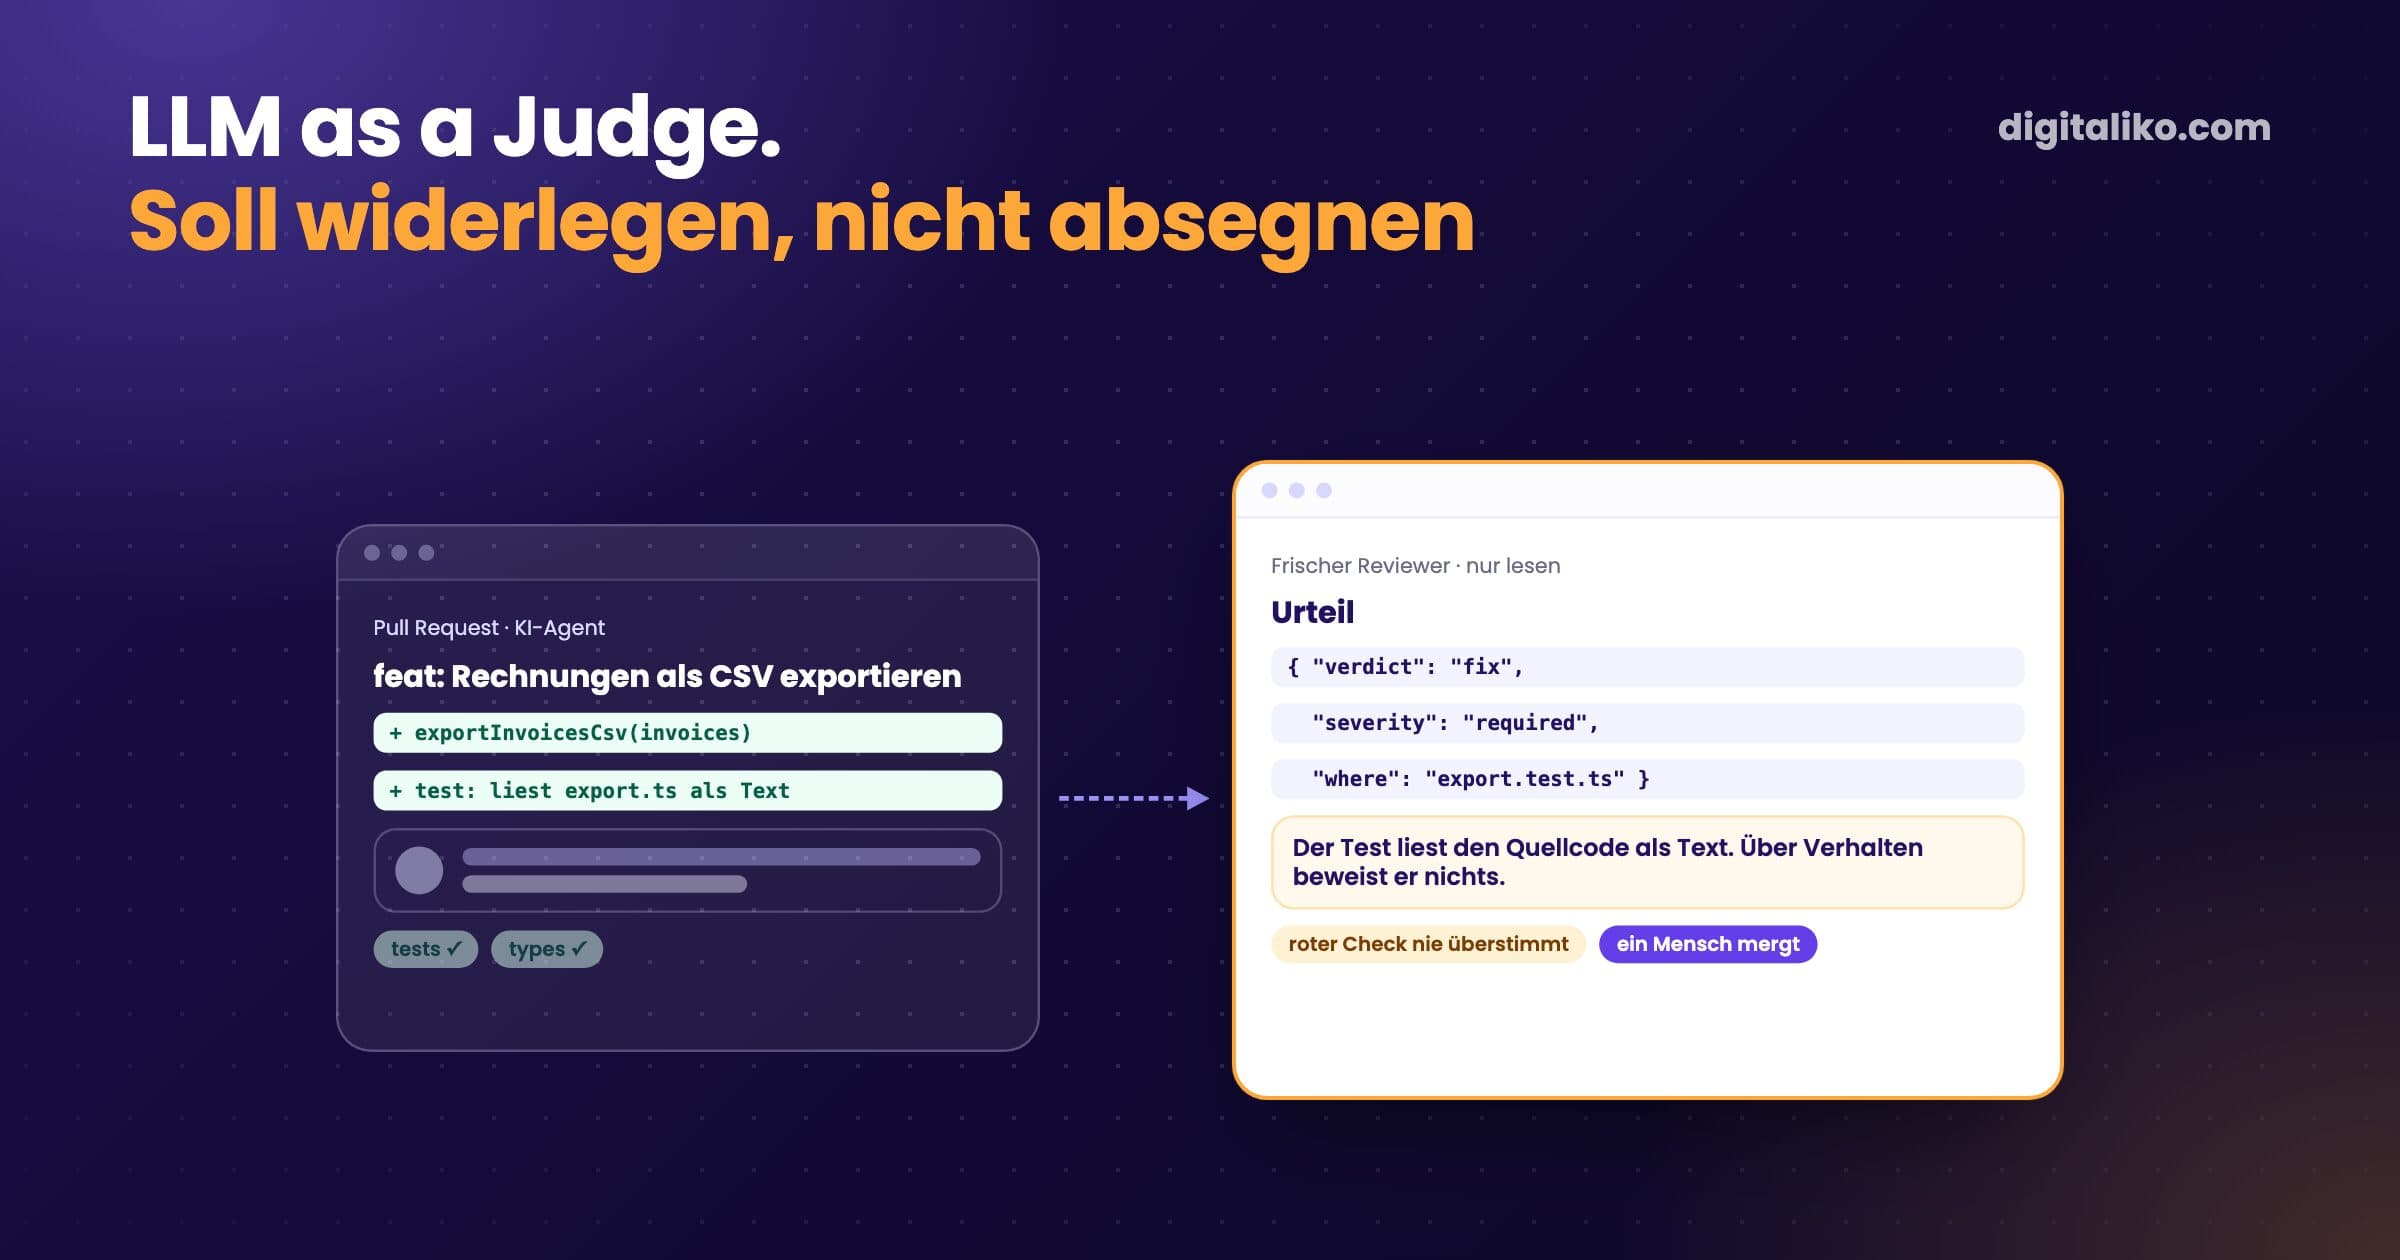
Nach dem Gate kommt ein frischer Reviewer: ein Modellaufruf nur mit Lesewerkzeugen, dem wir sagen, dass er die Arbeit nicht gemacht hat und sie widerlegen soll. Eine Zeile hält ihn ehrlich:
[ "$mrc" != 0 ] && [ "$verdict" = pass ] && verdict=fix # a red executable check is never overruled to pass
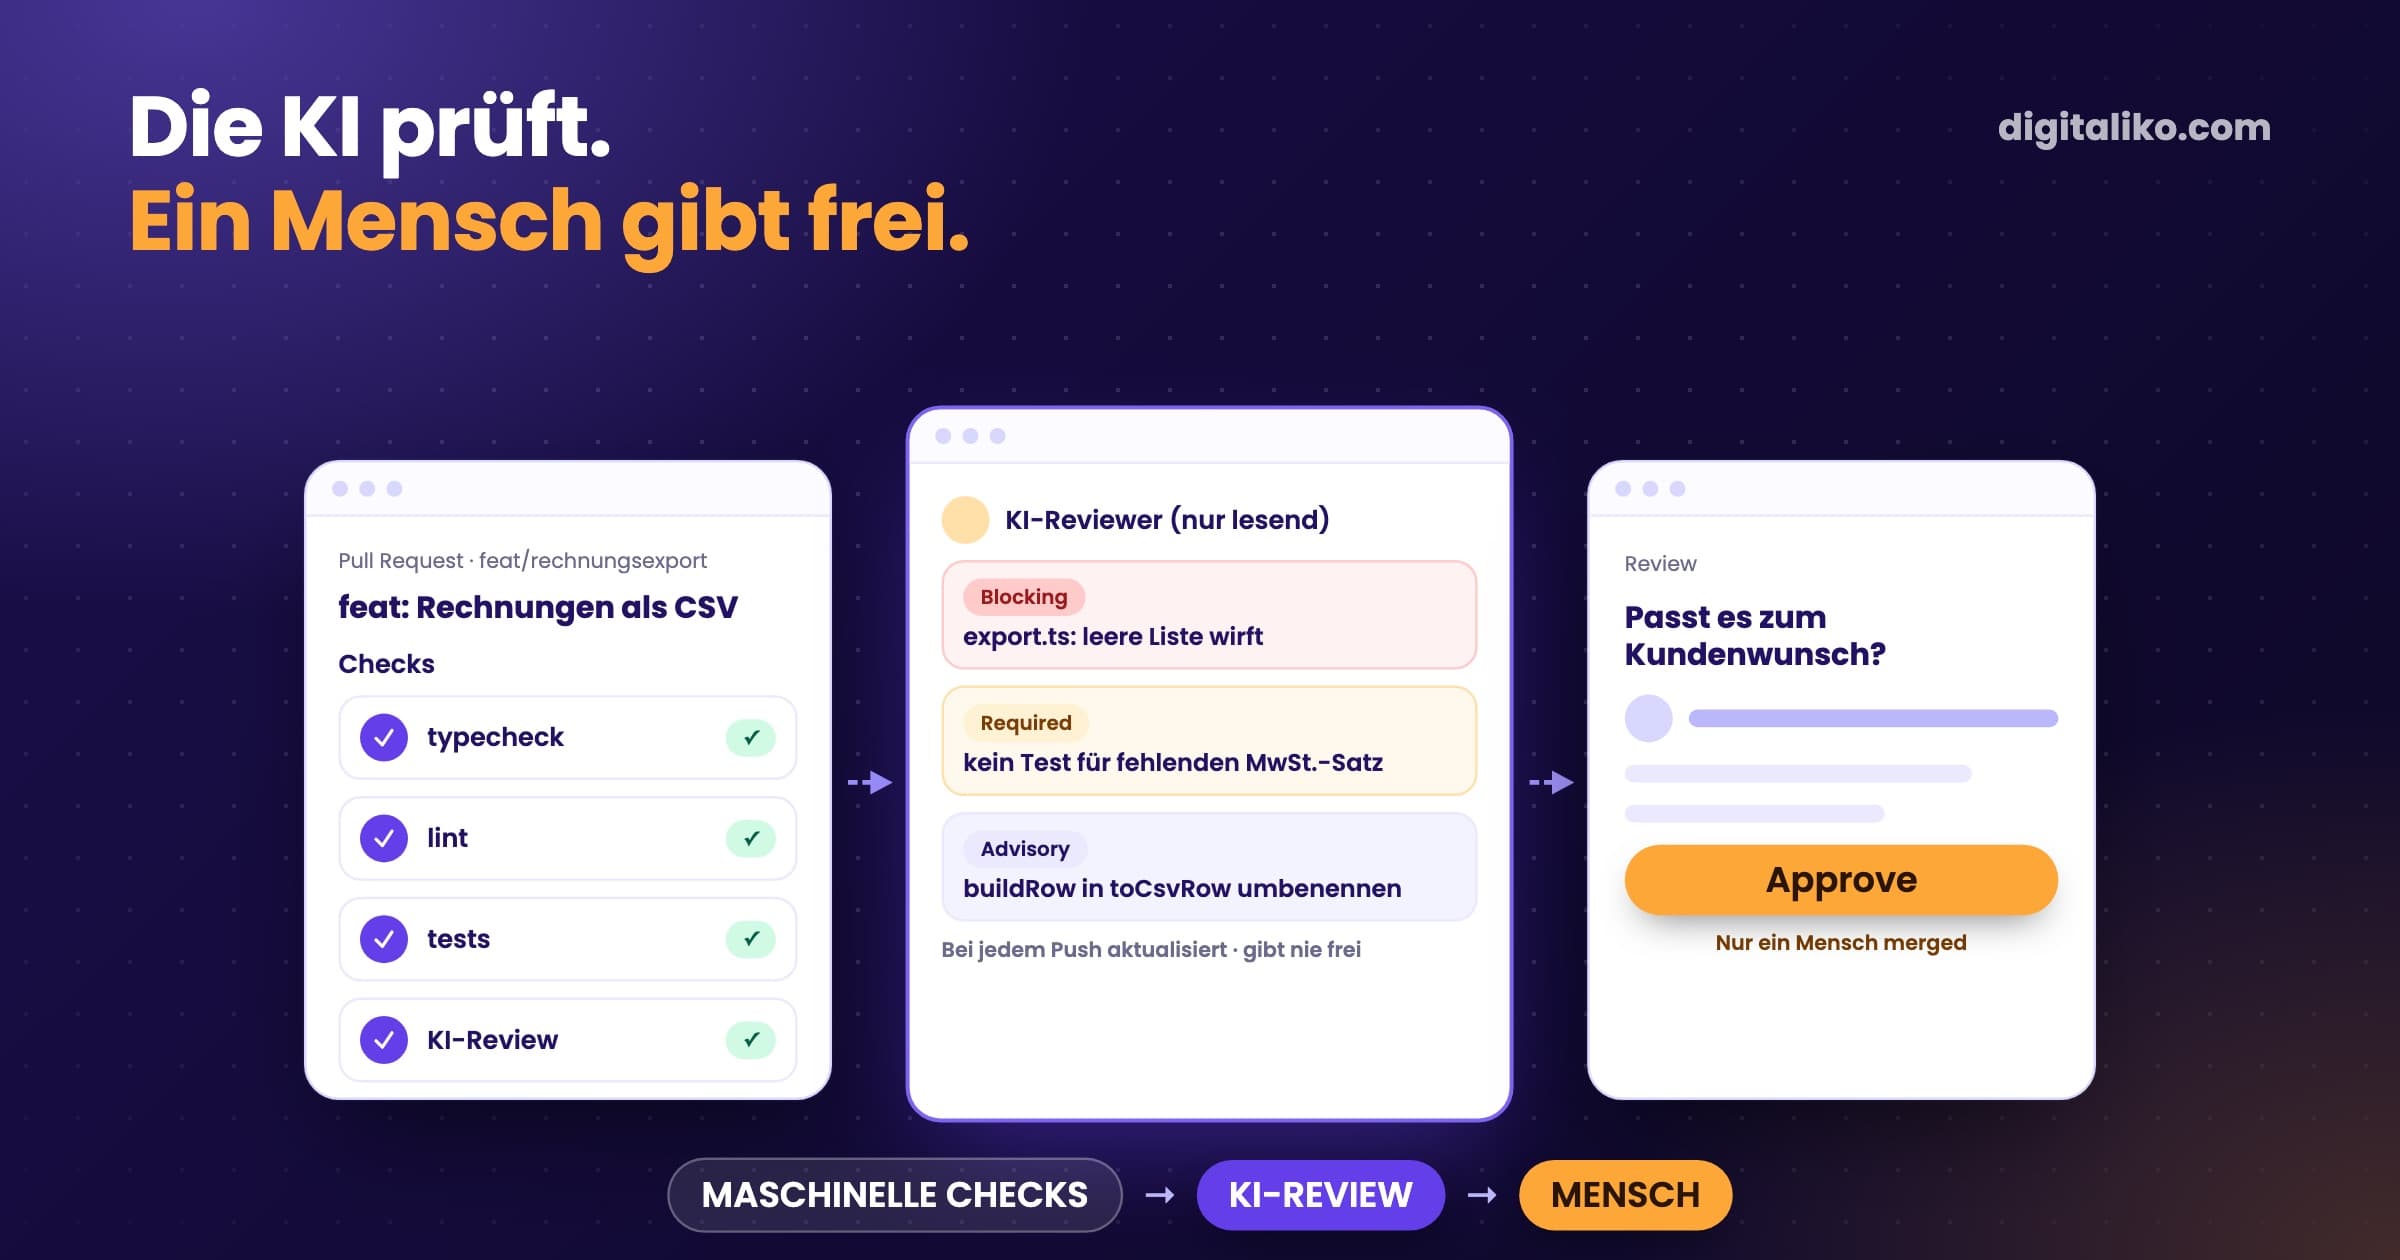
Befunde gehen zurück in dieselbe Session des Agenten. Das ist der Pfeil „Fix“. Meldet der Reviewer denselben Befund zweimal hintereinander, stoppt der Loop, und ein Mensch bekommt die Aufgabe mit diesem Befund. Den ganzen Loop Schritt für Schritt beschreiben wir in Harness Engineering in der Praxis: vom Issue zum PR.
Macht das jemand auch außerhalb Ihrer Repositories?
Ja, in viel größerem Maßstab. Am 11. Februar 2026 beschrieb OpenAI ein Produkt, das sein Team mit Codex gebaut hat: rund eine Million Zeilen Code, nach eigener Schätzung in etwa einem Zehntel der Zeit, und keine einzige Zeile von Hand geschrieben. Ihre Pointe passt zum Karussell: nicht bessere Prompts, sondern ein besseres System um dieselbe KI, die alle haben. Regeln, Linter, Strukturtests und Feedback-Loops.
Was ist der eigentliche Unterschied?
Stellen Sie beide Produkte ein paar Monate nach dem Launch nebeneinander.
Vibe-codiertes Produkt
- Funktioniert in der Demo.
- Bricht in Produktion.
- Niemand weiß, warum.
- In ein paar Monaten fangen Sie neu an.
Gleiche KI, mit System
Sauber gebautes Produkt
- Geht schnell live.
- Korrigiert sich selbst: rote Checks schicken die Arbeit zurück.
- Wächst mit: jeder Fehler wird eine Regel oder ein Test.
- Ihr Unternehmen läuft darauf.
In beiden Spalten steckt dieselbe KI. Eine hat ein System, die andere nicht. Das Modell, das Sie mieten, mieten auch Ihre Wettbewerber, also kann es nicht Ihr Vorsprung sein. Was Sie darum bauen, schon.
Ihre KI ist dieselbe wie bei allen anderen. Der eigentliche Vorsprung ist das System um sie herum.

Wie kommt man von Vibe Coding zu Agentic Engineering?
Beginnen Sie mit den Gates, nicht mit einem klügeren Agenten. In der Reihenfolge, in der wir sie hinzufügen würden:
01
Regeln im Repo
Eine kurze CLAUDE.md oder AGENTS.md: die Befehle, die Architektur, was der Agent nie tun darf.
02
Hooks unter dem Agenten
Gefährliche Befehle stoppen, bevor sie laufen. Der Agent kann sie nicht ändern.
03
Red-Proof-Tests
Ein neuer Test muss zuerst auf dem alten Code fehlschlagen. Erst der Fix macht ihn grün.
04
Ein Gate, das Nein sagt
Ein Stop-Hook und CI verweigern „fertig“, solange ein Check rot ist.
05
Ein Mensch merged
Review von Konzept und Risiko, nicht jeder Zeile. Dann Merge.
Jeder Schritt schließt eine der sechs Lücken oben. Regeln geben Grenzen. Hooks geben Leitplanken. Red-Proof-Tests und das Gate schließen den Loop. Und wenn derselbe Fehler zweimal auftaucht, wird er zu einer neuen Regel oder einem Check. So lernt das System, nicht das Modell.
Die ersten vier haben wir in ein kleines öffentliches Repository gepackt, den Claude Code Production Starter: Agentenregeln, Hooks, ein CI-Gate mit Red-Proof-Tests, KI-Review und eine Launch-Checkliste. MIT-Lizenz. Bevor Sie Hooks kopieren, lohnen sich Claude Code Hooks, die nichts tun und Red-Green-TDD mit KI-Agenten.
Macht Ihr Team Vibe Coding oder Engineering?
Ein kurzer Selbsttest. Haken Sie ab, was Ihr Repository heute schon hat.
Wollen Sie dieses System in Ihrem Repository?
Einen solchen Loop bauen wir direkt im Repository eines Teams auf, im Rahmen von AI-native SDLC für Entwicklerteams. Seit 2023 haben wir 15+ Produktionsprojekte geliefert. Ein Senior arbeitet ab dem ersten Tag in Ihrem Repository und Ihren Pull Requests mit.
Sie haben selbst ein Produkt mit Lovable, Cursor oder Claude gebaut, und jetzt muss es halten? Das ist ein anderer Weg: siehe Hilfe für Vibe Coder.
Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Welche der sechs Lücken schmerzt Ihr Team gerade am meisten?
Kurz gesagt
- Vibe Coding akzeptiert Output, der fertig aussieht. Agentic Engineering prüft ihn in einem geschlossenen Loop.
- In beiden steckt dasselbe Modell. Der Unterschied ist das System darum.
- Der Loop: Spezifikation, KI-Agent, ein Gate mit Tests, Hooks und Review, Fix, dann merged ein Mensch.
- Beginnen Sie mit den Gates: Regeln, Hooks, Red-Proof-Tests, Stop-Hook und CI.
Häufige Fragen
Was ist der Unterschied zwischen Vibe Coding und Agentic Engineering?
Vibe Coding heißt: der KI einen Prompt geben und den Output akzeptieren, der fertig aussieht. Agentic Engineering nutzt dieselben KI-Agenten in einem System: Spezifikation, Tests, Hooks, ein Review-Gate und ein Mensch, der merged. Das Modell ist dasselbe. Ob das Ergebnis die Produktion übersteht, entscheidet das System darum herum.
Ist Agentic Engineering dasselbe wie Agentic Coding?
Fast. Agentic Coding meint meist einen KI-Agenten, der selbst Dateien ändert und Befehle ausführt. Agentic Engineering ergänzt die Disziplin darum: was als fertig gilt, welche Checks bestehen müssen und wer für das verantwortlich ist, was in Produktion geht.
Was ist ein Agentic Loop in der Softwareentwicklung?
Ein Loop, in dem der Agent arbeitet, eine Maschine das Ergebnis prüft und ein roter Check den Befund an den Agenten zurückgibt, bis er besteht. Unserer läuft: Spezifikation, Agent, Gate, Fix, Merge. Das Gate ist einfacher Code mit Exit-Codes, ein Modell kann einen roten Check also nicht grün reden.
Ist Vibe Coding schlecht?
Nein. Es ist ein schneller Weg, eine Idee auszuprobieren oder eine Demo zu bauen. Zum Problem wird es, wenn auf der Demo plötzlich ein Unternehmen läuft: echte Nutzer, echtes Geld, echte Daten. Dann brauchen Sie Tests, Leitplanken und einen Menschen, der den Code versteht.
Wie bringe ich ein Team von Vibe Coding zu Agentic Engineering?
Beginnen Sie mit den Gates, nicht mit dem Agenten: Agentenregeln im Repository, Hooks, die gefährliche Befehle blockieren, ein Stop-Hook, der „fertig“ verweigert, solange Checks rot sind, und ein CI-Gate mit Tests, die zuerst fehlschlagen müssen. Der öffentliche Claude Code Production Starter hat alle vier.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity