Playwright vs Puppeteer do testów i scrapingu
Dla CTO i programistówWeb scraping i crawlery

Filip PapranecZałożyciel Digitaliko
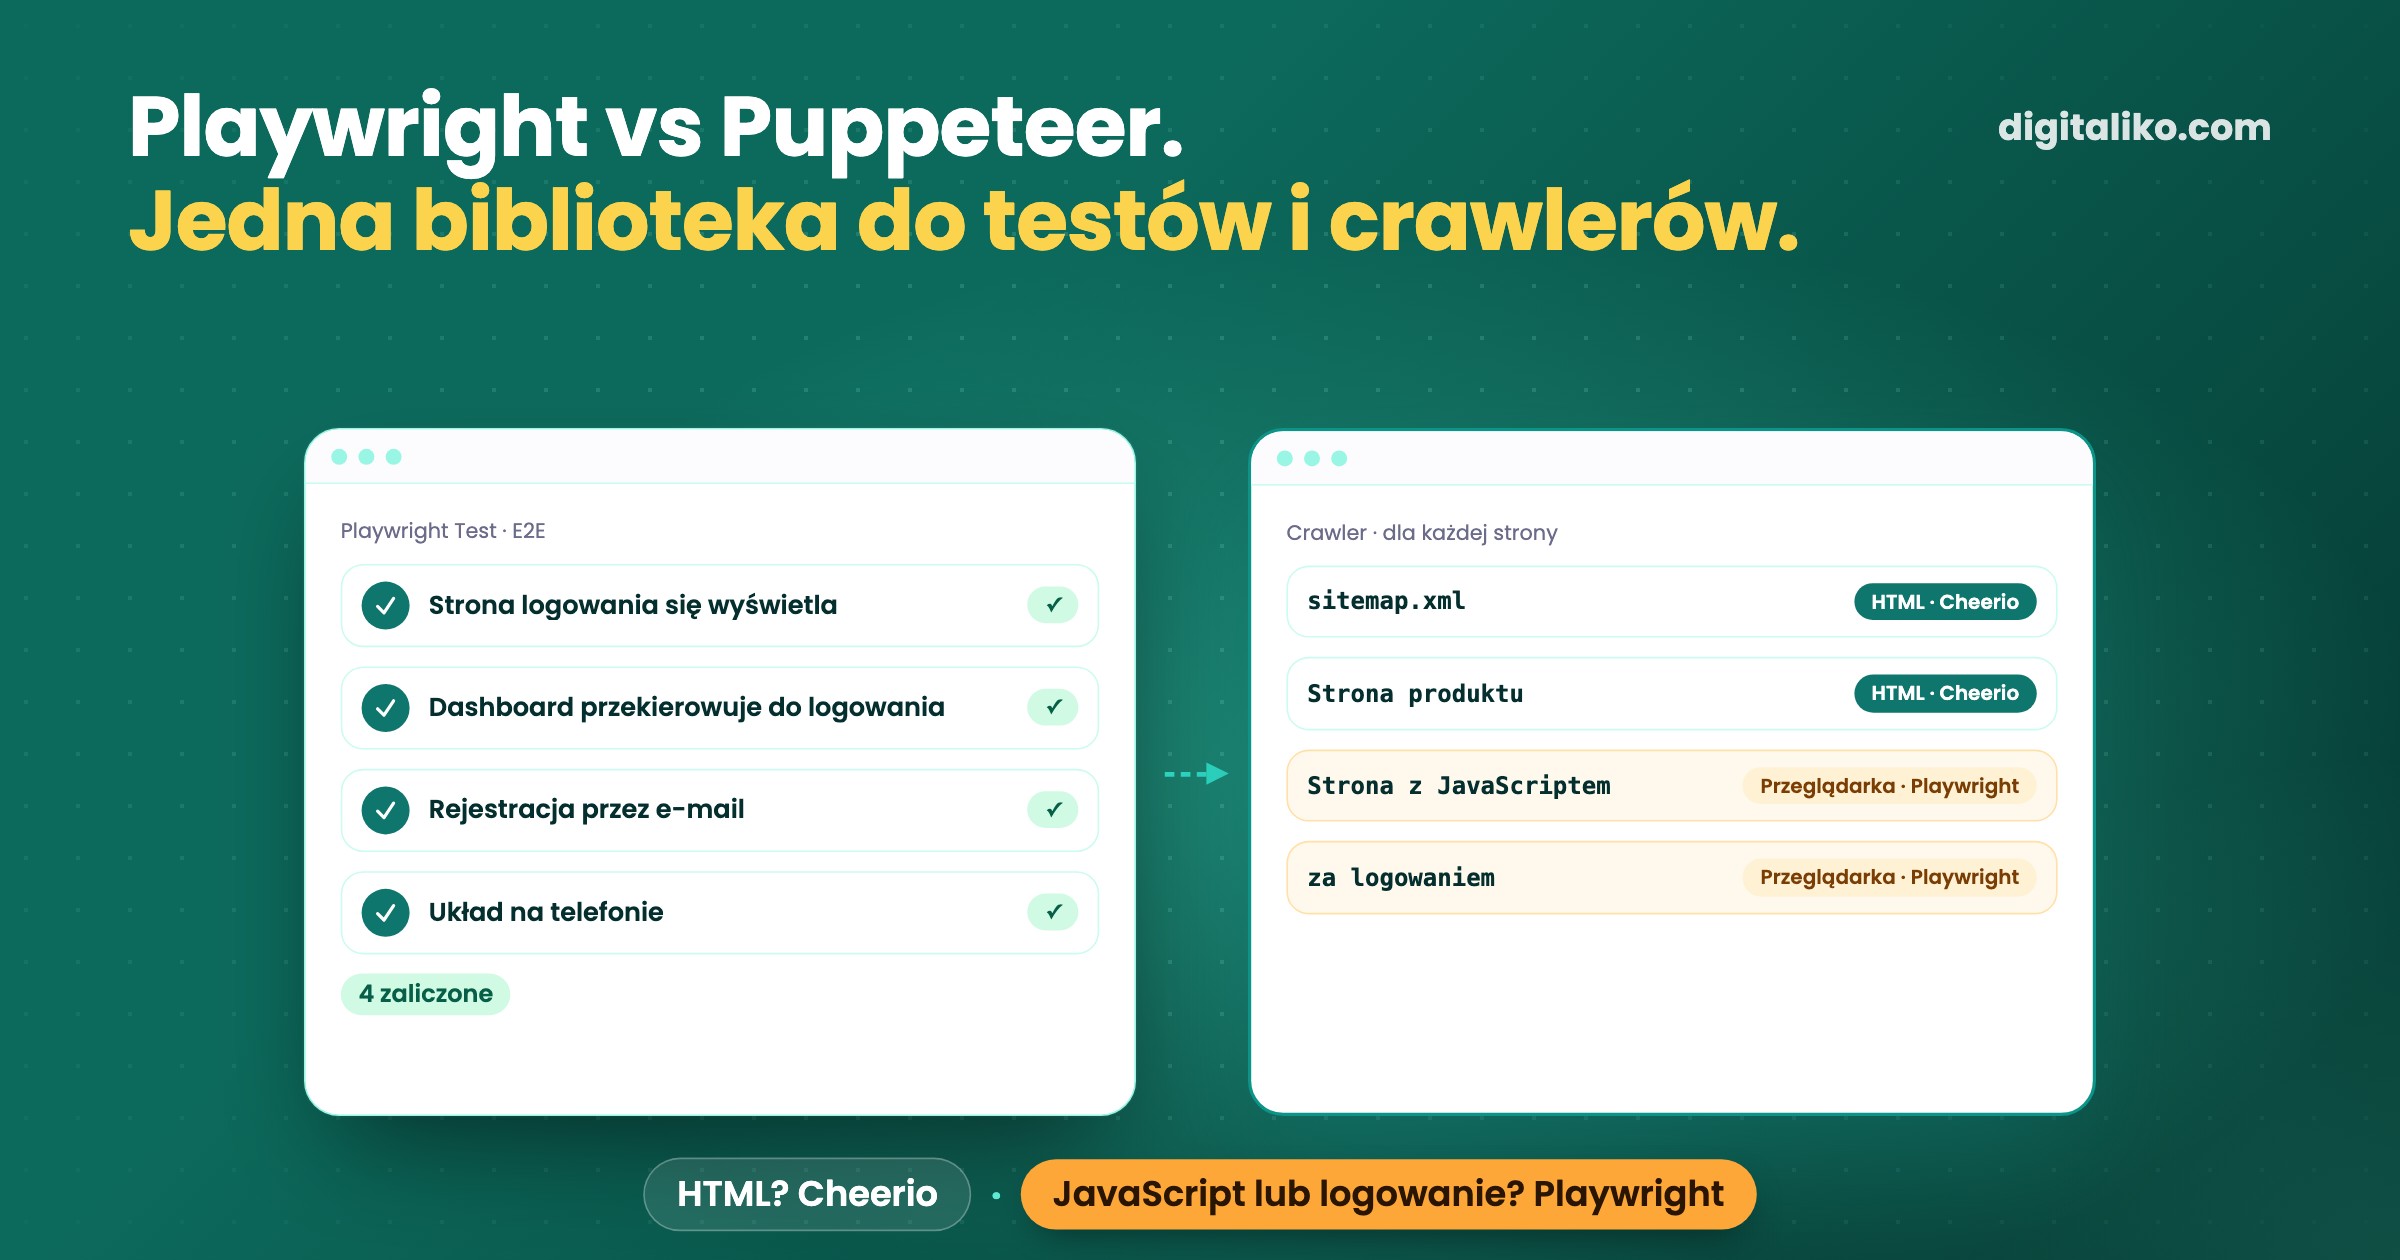
Playwright vs Puppeteer to pytanie o dwa zadania: testy i scraping. Playwrighta używamy do testów end-to-end i audytów stron. To samo narzędzie nadaje się też do scrapingu stron, które potrzebują prawdziwej przeglądarki. Do nowej pracy wybralibyśmy Playwrighta, chyba że sterują Państwo tylko Chrome ze skryptu w Node i mają już działający kod w Puppeteerze.
Najpierw uczciwe zastrzeżenie: Puppeteer występuje w dokładnie jednym naszym starym projekcie i nigdy nie uruchamialiśmy obu obok siebie. Ten artykuł nie jest więc benchmarkiem. Pokazuje, czego używamy, dlaczego wystarczyło nam jedno narzędzie, i decyzję, która w scrapingu liczy się bardziej: czy przeglądarka jest w ogóle potrzebna.
Czym różni się Playwright od Puppeteera?
Oba sterują prawdziwą przeglądarką z kodu. Różnią się zasięgiem. Puppeteer to „a JavaScript library which provides a high-level API to control Chrome or Firefox over the DevTools Protocol or WebDriver BiDi” (pptr.dev, dostęp 2026-10-24). Playwright „supports Chromium, WebKit and Firefox on Windows, Linux and macOS” (playwright.dev, dostęp 2026-10-24).
| Playwright | Puppeteer | |
|---|---|---|
| Przeglądarki | Chromium, WebKit, Firefox | Chrome, Firefox |
| Języki | JavaScript/TypeScript, Python, Java, .NET (docs) | JavaScript/TypeScript |
| Test runner | Playwright Test, wbudowany | brak, trzeba dołożyć własny |
| Czekanie | lokatory, które same czekają | waitForSelector i podobne, ręcznie |
| W Crawlee | PlaywrightCrawler | PuppeteerCrawler |
| Gdzie go używamy | testy e2e, audyty | jeden stary projekt |
Źródła tabeli: powyższe strony i przewodnik migracji z Puppeteera Playwrighta, wszystkie z dostępem 2026-10-24.
O wyborze zdecydował u nas wiersz z test runnerem. Jedna biblioteka, która daje i przeglądarkę, i test runner, to jedno narzędzie do nauki, jedna instalacja przeglądarki w CI i jeden zestaw selektorów.
Jak używamy Playwrighta do testów?
W trzech miejscach, od najbardziej rygorystycznego do najluźniejszego.
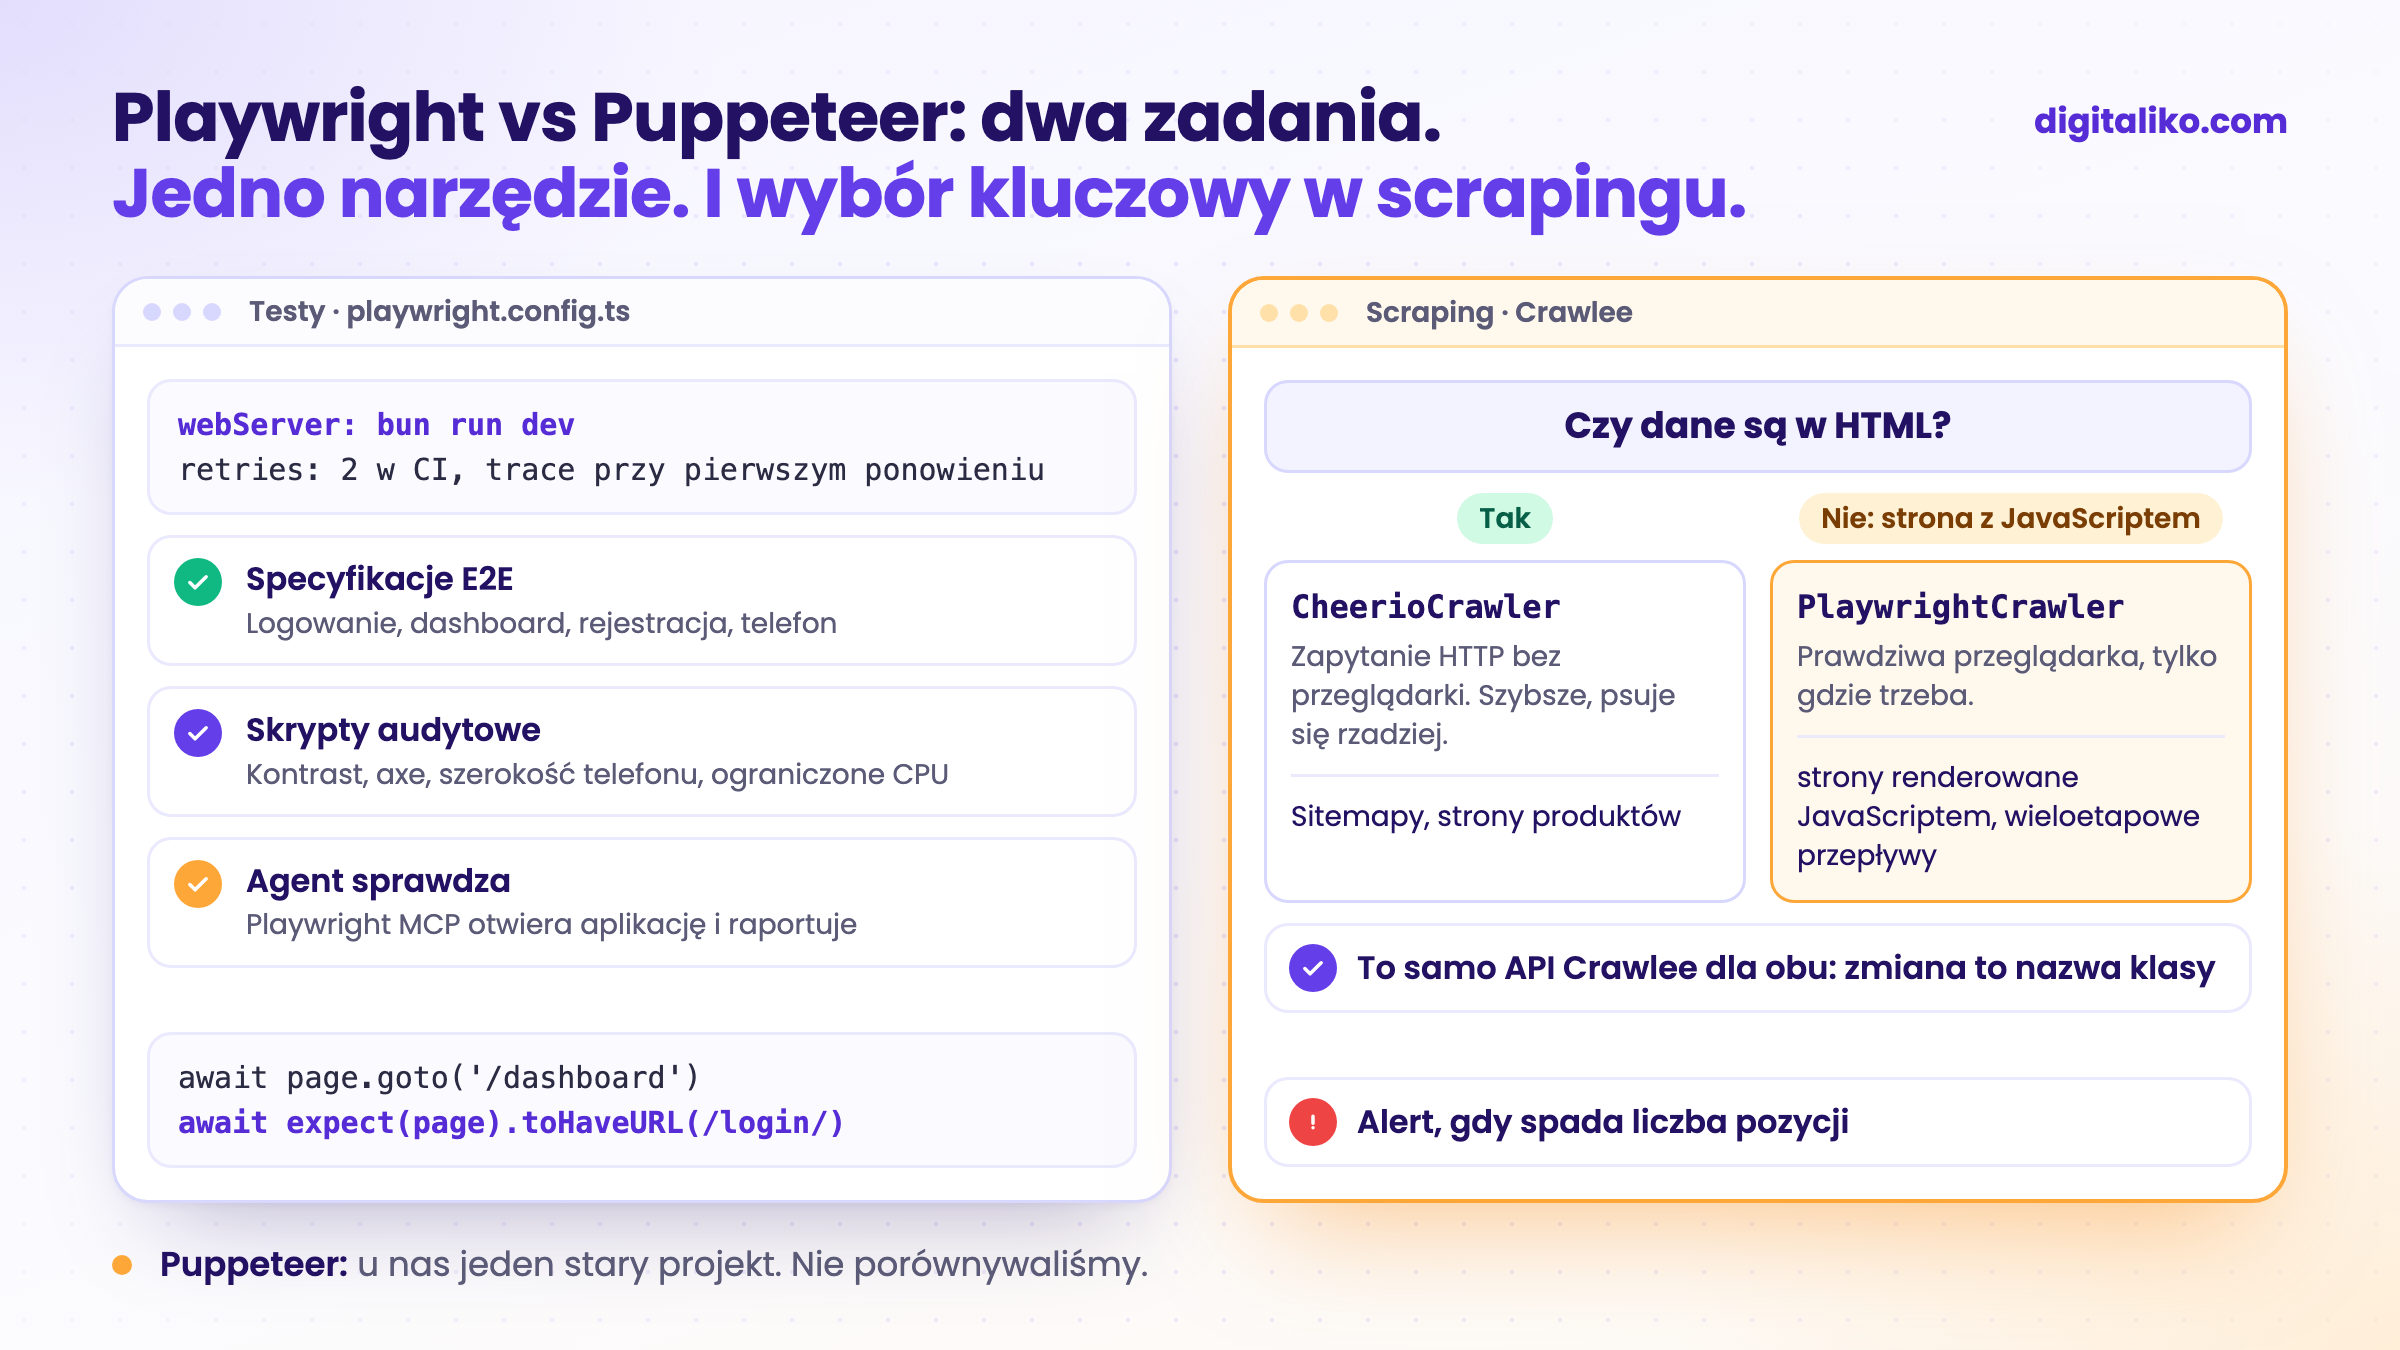
Testy end-to-end. Nasz szablon startowy uruchamia Playwright Test na serwerze deweloperskim. Konfiguracja w skrócie:
// playwright.config.ts
import { defineConfig } from '@playwright/test'

export default defineConfig({
  testDir: './e2e',
  forbidOnly: !!process.env.CI,
  retries: process.env.CI ? 2 : 0,
  use: { baseURL: 'http://localhost:3001', trace: 'on-first-retry' },
  projects: [{ name: 'chromium', use: { browserName: 'chromium' } }],
  webServer: { command: 'bun run dev', url: 'http://localhost:3001', reuseExistingServer: !process.env.CI },
})
I jedna ze specyfikacji:
test('dashboard redirects to login when not authenticated', async ({ page }) => {
  await page.goto('/dashboard')
  await expect(page).toHaveURL(/login/)
})
Bez sleepów, bez ręcznego czekania. expect(page).toHaveURL ponawia próbę, aż przejdzie albo minie limit czasu. To ta część, którą w Puppeteerze pisze się ręcznie.
Audyty stron. Gdy audytowaliśmy tę stronę, sprawdzenia były zwykłymi skryptami Playwrighta: kontrast tekstu z wyliczonych kolorów, reguły dostępności axe, układ przy szerokości telefonu, ładowanie przy ograniczonym CPU. Skrypty jednorazowe, nie zestaw testów.
Agent AI sprawdza własną zmianę. Agent otwiera aplikację przez Playwright MCP i raportuje, co zobaczył. Jak to działa, opisujemy w Playwright MCP: agent AI udowadnia, że działa.
Jak używa się Playwrighta do scrapingu?
Przez Crawlee, które opakowuje obie biblioteki. Jak mówi dokumentacja, „Crawlee comes with three main crawler classes: CheerioCrawler, PuppeteerCrawler and PlaywrightCrawler” (crawlee.dev, dostęp 2026-10-24). Zamiana Puppeteera na Playwrighta to tam głównie zmiana nazwy klasy. Prawdziwy wybór to pierwsza klasa: HTTP czy przeglądarka.
Do strony z dużą ilością JavaScriptu pasuje PlaywrightCrawler. Uproszczony przykład:
import { PlaywrightCrawler } from 'crawlee'
import { router } from './routes.js'

const crawler = new PlaywrightCrawler({
  maxRequestsPerCrawl,
  requestHandlerTimeoutSecs: 360,
  navigationTimeoutSecs: 60,
  maxRequestRetries: 4,
  requestHandler: router,
  launchContext: {
    launchOptions: { args: ['--disable-gpu'] }, // GPU się wysypuje w Dockerze
  },
})

await crawler.run(startUrls)
Jeśli dane są w HTML, przeglądarka w ogóle nie jest potrzebna. CheerioCrawler czyta sitemapy i strony produktów.
Jak decydować dla każdego typu strony:
01
Otworzyć stronę z wyłączonym JavaScriptem
Albo pobrać ją curlem. Jeśli potrzebne dane są w HTML, przeglądarka nie jest potrzebna.
02
Cheerio, gdzie się da
Crawler HTTP jest szybszy, zużywa mniej pamięci i psuje się rzadziej niż przeglądarka.
03
Playwright, gdzie trzeba
Strony renderowane w przeglądarce i wieloetapowe przepływy dostają PlaywrightCrawler.
04
Monitorować w obu przypadkach
Crawler, który po cichu staje, kosztuje więcej niż zła biblioteka. Alert, gdy spada liczba pozycji.
Ostatni krok liczy się najbardziej. Żadna biblioteka nie uratuje crawlera, który po cichu staje, uratuje go tylko alert. Więcej w Crawlee do web scrapingu: co psuje się na produkcji.
Dlaczego nigdy nie potrzebowaliśmy Puppeteera?
Bo każde nasze zadanie było pokryte, gdy tylko Playwright trafił do repozytorium. Testy potrzebowały runnera, Playwright go ma. Druga biblioteka przeglądarkowa dodałaby instalację, a nie możliwości.
The APIs have similarities, but Playwright offers much more possibilities for web testing and cross-browser automation.
To zdanie pochodzi od zespołu Playwrighta, więc warto je czytać jako zdanie dostawcy. Do pracy wyłącznie z Chrome Puppeteer pozostaje solidnym wyborem.
Kiedy Puppeteer byłby lepszym wyborem?
Na podstawie dokumentacji, nie naszych przebiegów:
- Potrzebują Państwo tylko Chrome ze skryptu w Node i mają już działający kod w Puppeteerze. Przepisanie niewiele da.
- Pracują Państwo blisko Chrome DevTools Protocol i chcą biblioteki zbudowanej wokół niego.
- Testy działają już w innym frameworku i potrzebny jest tylko driver przeglądarki, nie runner.
Jeśli potrzebny jest też WebKit, Python albo test runner w tym samym narzędziu, Playwright to pokrywa. Playwright podaje, że większości API Puppeteera „can be used as is” przy migracji (przewodnik), więc zmiana zwykle jest niewielka.
Playwright czy Puppeteer: co do Państwa projektu?
Proszę odpowiedzieć na te pytania przed wyborem. Każde „tak” wskazuje na Playwrighta:
Potrzebują Państwo testów lub crawlera, które wytrzymają produkcję?
Jeśli regularnie potrzebują Państwo danych, których zbieranie źródło dopuszcza, zbudujemy zbieranie z monitoringiem, który zaalarmuje, gdy przestanie działać. Robimy to w ramach automatyzacji procesów biznesowych. Większość naszego kodu pisze AI. Każdą zmianę przegląda senior i odpowiada za produkcję. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Które z Państwa stron naprawdę potrzebują przeglądarki?
W skrócie
- Playwright steruje Chromium, WebKitem i Firefoksem i ma test runner. Puppeteer steruje Chrome i Firefoksem z JavaScriptu.
- Playwrighta używamy do testów e2e, audytów i sprawdzeń agenta.
- W scrapingu ważniejszy wybór to HTTP z Cheerio albo prawdziwa przeglądarka, strona po stronie.
- Puppeteera nie porównywaliśmy w benchmarku. Działający skrypt tylko dla Chrome warto zostawić.
Najczęstsze pytania
Czym różni się Playwright od Puppeteera?
Puppeteer to biblioteka JavaScript dla Chrome i Firefoksa. Playwright steruje Chromium, WebKitem i Firefoksem, ma bindingi dla JavaScriptu, Pythona, Javy i .NET oraz własny test runner z lokatorami, które same czekają. Przy nowej pracy, która wymaga testów lub więcej niż jednej przeglądarki, Playwright pokrywa więcej.
Czy Playwright jest lepszy od Puppeteera do web scrapingu?
W scrapingu biblioteka ma mniejsze znaczenie niż to, czy przeglądarka jest w ogóle potrzebna. Większość publicznych stron to zwykły HTML i wystarczy crawler HTTP z Cheerio. Prawdziwej przeglądarki potrzebują tylko strony renderowane JavaScriptem i tam pasuje Playwright przez Crawlee. Puppeteera z nim nie porównywaliśmy w benchmarku.
Czy mogę przejść z Puppeteera na Playwrighta?
Tak. Playwright publikuje przewodnik migracji i podaje, że większości API Puppeteera można używać bez zmian. Większa zmiana to przejście z element handles i ręcznego czekania na lokatory i asercje web-first.
Czy Puppeteer obsługuje Firefoksa i Safari?
Puppeteer steruje Chrome lub Firefoksem przez DevTools Protocol albo WebDriver BiDi. Nie steruje WebKitem, więc do testowania zachowania Safari potrzebny jest Playwright lub inne narzędzie.
Czy do web scrapingu potrzebuję przeglądarki headless?
Często nie. Jeśli dane są w HTML, który zwraca serwer, zapytanie HTTP z parserem HTML jest szybsze i tańsze w utrzymaniu. Przeglądarki warto używać tylko dla stron, które renderują dane JavaScriptem.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

