Crawlee do web scrapingu: co psuje się na produkcji
Dla CTO i programistówWeb scraping i crawlery

Filip PapranecZałożyciel Digitaliko
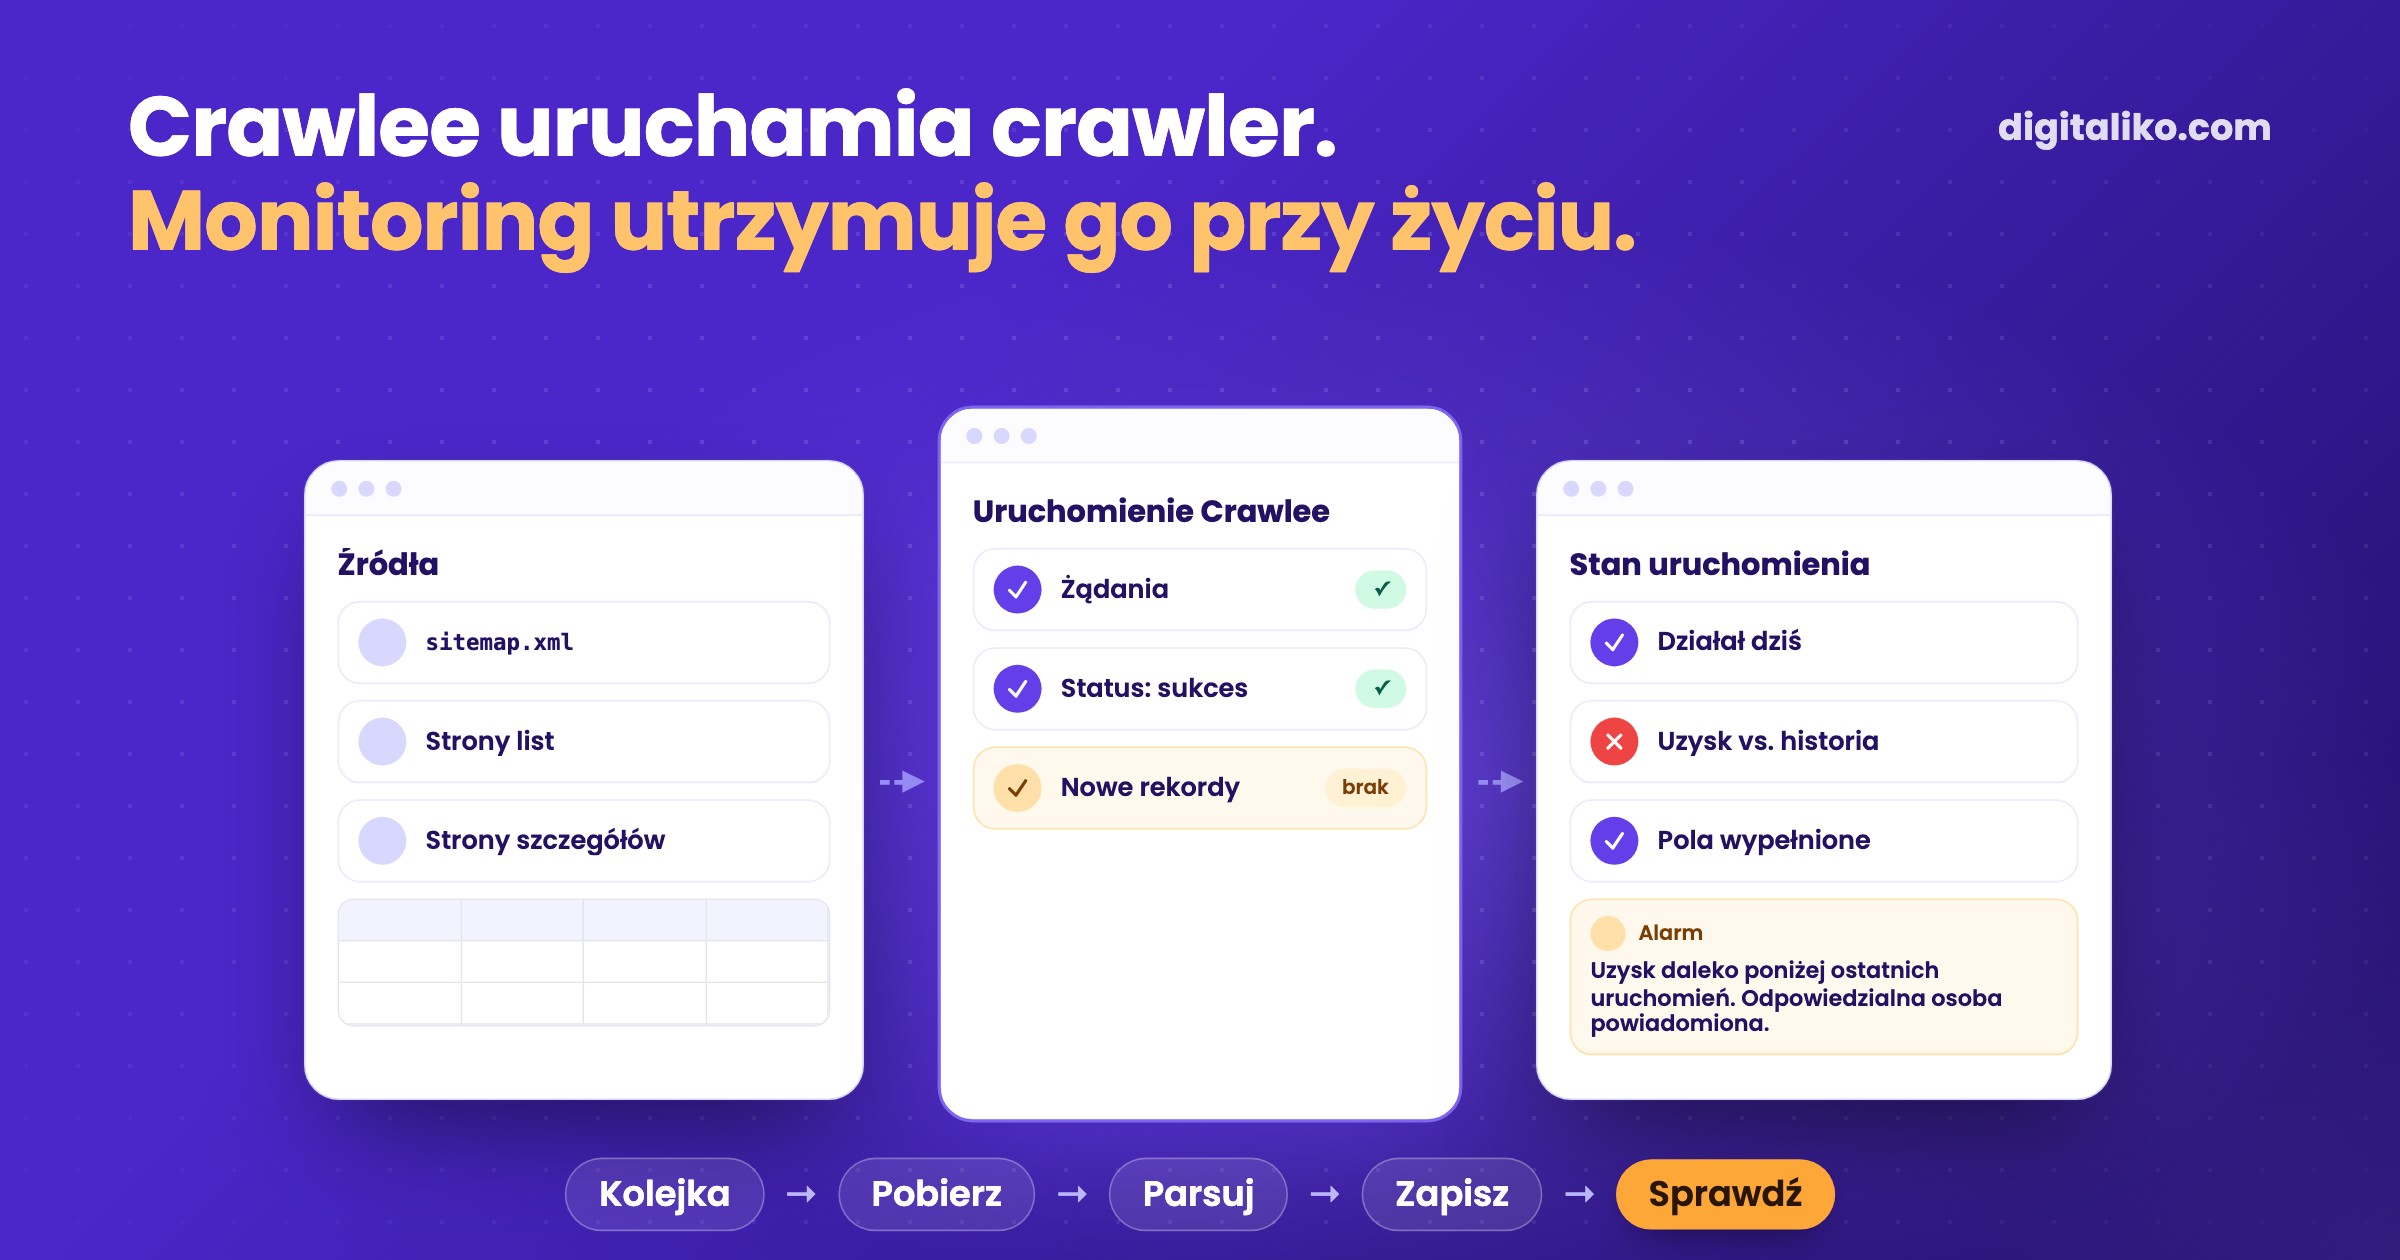
Crawlee to biblioteka open source do web crawlingu i scrapingu. Jej dokumentacja obiecuje, że „covers your crawling and scraping end-to-end”, czyli obejmuje crawling i scraping od początku do końca: szybki crawling HTTP z Cheerio lub JSDOM, prawdziwe przeglądarki z Playwright lub Puppeteer za tym samym interfejsem, trwałą kolejkę żądań, ponowienia i sesje. Crawler rusza dzięki niej szybko. Utrzymanie go w ruchu to ta trudna część.
Poniżej opisujemy, jak działa Crawlee, co psuje się wokół crawlerów na produkcji i jakie kontrole to wychwytują.
Czym jest Crawlee i jaki crawler wybrać?
Crawlee zajmuje się instalacją, której potrzebuje każdy crawler: kolejką adresów URL, która przetrwa restart, ponowieniami, limitami współbieżności i sesjami. Państwo piszą handler, który zamienia stronę w rekord.
Główny wybór to klasa crawlera:
Proszę zacząć tu
CheerioCrawler
- Pobiera HTML i go parsuje.
- Szybki i oszczędny w pamięci.
- Wystarcza do stron renderowanych na serwerze i sitemap.
- Wystarcza do większości źródeł.
PlaywrightCrawler
- Uruchamia prawdziwą przeglądarkę.
- Do stron budowanych JavaScriptem lub ukrytych za kliknięciami.
- Wolniejszy i cięższy na stronę.
- Tylko tam, gdzie HTML nie wystarcza.
Oba używają tego samego routera i kolejki żądań. Można zacząć od Cheerio i później przenieść jedno trudne źródło do przeglądarki.
Jak wygląda minimalny crawler w Crawlee?
Router z dwoma handlerami: strony list dodają do kolejki strony szczegółów, a strony szczegółów zapisują rekord.
import { CheerioCrawler, createCheerioRouter, Dataset } from 'crawlee'

const router = createCheerioRouter()

router.addDefaultHandler(async ({ enqueueLinks }) => {
  await enqueueLinks({ selector: 'a.listing', label: 'DETAIL' })
})

router.addHandler('DETAIL', async ({ request, $ }) => {
  await Dataset.pushData({
    url: request.loadedUrl,
    title: $('h1').text().trim(),
    price: $('.price').text().trim(),
  })
})

const crawler = new CheerioCrawler({
  requestHandler: router,
  maxConcurrency: 4,
  maxRequestRetries: 2,
  failedRequestHandler: async ({ request }) => console.error('gave up', request.url),
})

await crawler.run(['https://example.com/listings'])
Crawler produkcyjny potrzebuje jeszcze jednej rzeczy. Zaczyna od sitemap i pamięta, gdzie skończyło się ostatnie uruchomienie, więc każde uruchomienie pobiera tylko to, co zmieniło się od tamtej pory. Pełne przejście dużego katalogu przy każdym uruchomieniu to prosta droga do przekroczenia limitu czasu.
Co psuje się na produkcji?
Żadna z tych rzeczy nie jest błędem Crawlee. Tak dzieje się wokół każdego crawlera, który działa codziennie:
| Co się dzieje | Jak to wygląda | Co pomaga |
|---|---|---|
| Uruchomienie kończy się na zielono i prawie nic nie zapisuje | zielony panel, kurczący się katalog | kontrola uzysku: nowe rekordy w porównaniu z ostatnimi uruchomieniami |
| Harmonogram startuje uruchomienie, gdy poprzednie wisi | zablokowane uruchomienia trzymające połączenia z bazą danych | blokada na źródło i twardy timeout na uruchomienie |
| Proces zostaje brutalnie zabity | uruchomienie oznaczone jako „trwające” na zawsze | krok, który przed każdym uruchomieniem oznacza stare uruchomienia jako nieudane |
| Wyszukiwanie adresów nigdy się nie kończy | limit czasu osiągnięty, nic nie zapisane | limit czasu na wyszukiwanie, przyrostowe sitemapy |
| Płatne API do wzbogacania danych zwraca błąd rozliczeń | worker kończy się sukcesem | osobna kontrola stanu, która o tym alarmuje |
| Harmonogram w repozytorium to nie ten na serwerze | uruchomienia o złych porach | harmonogram synchronizowany z repozytorium na serwer |
Pierwszy wiersz jest najbardziej zdradliwy: crawl, który działa na zielono, ale nie przynosi prawie żadnych nowych rekordów. Monitoring powinien zaczynać się właśnie od tego przypadku.
Jak monitorować crawler w Crawlee?
Crawlee informuje o żądaniach, które się nie powiodły. Po ponowieniach żądanie trafia do failedRequestHandler, gdzie można je zalogować lub policzyć. Nie powie jednak, że uruchomienie, które się powiodło, nic nie przyniosło. Ta kontrola należy do Państwa.
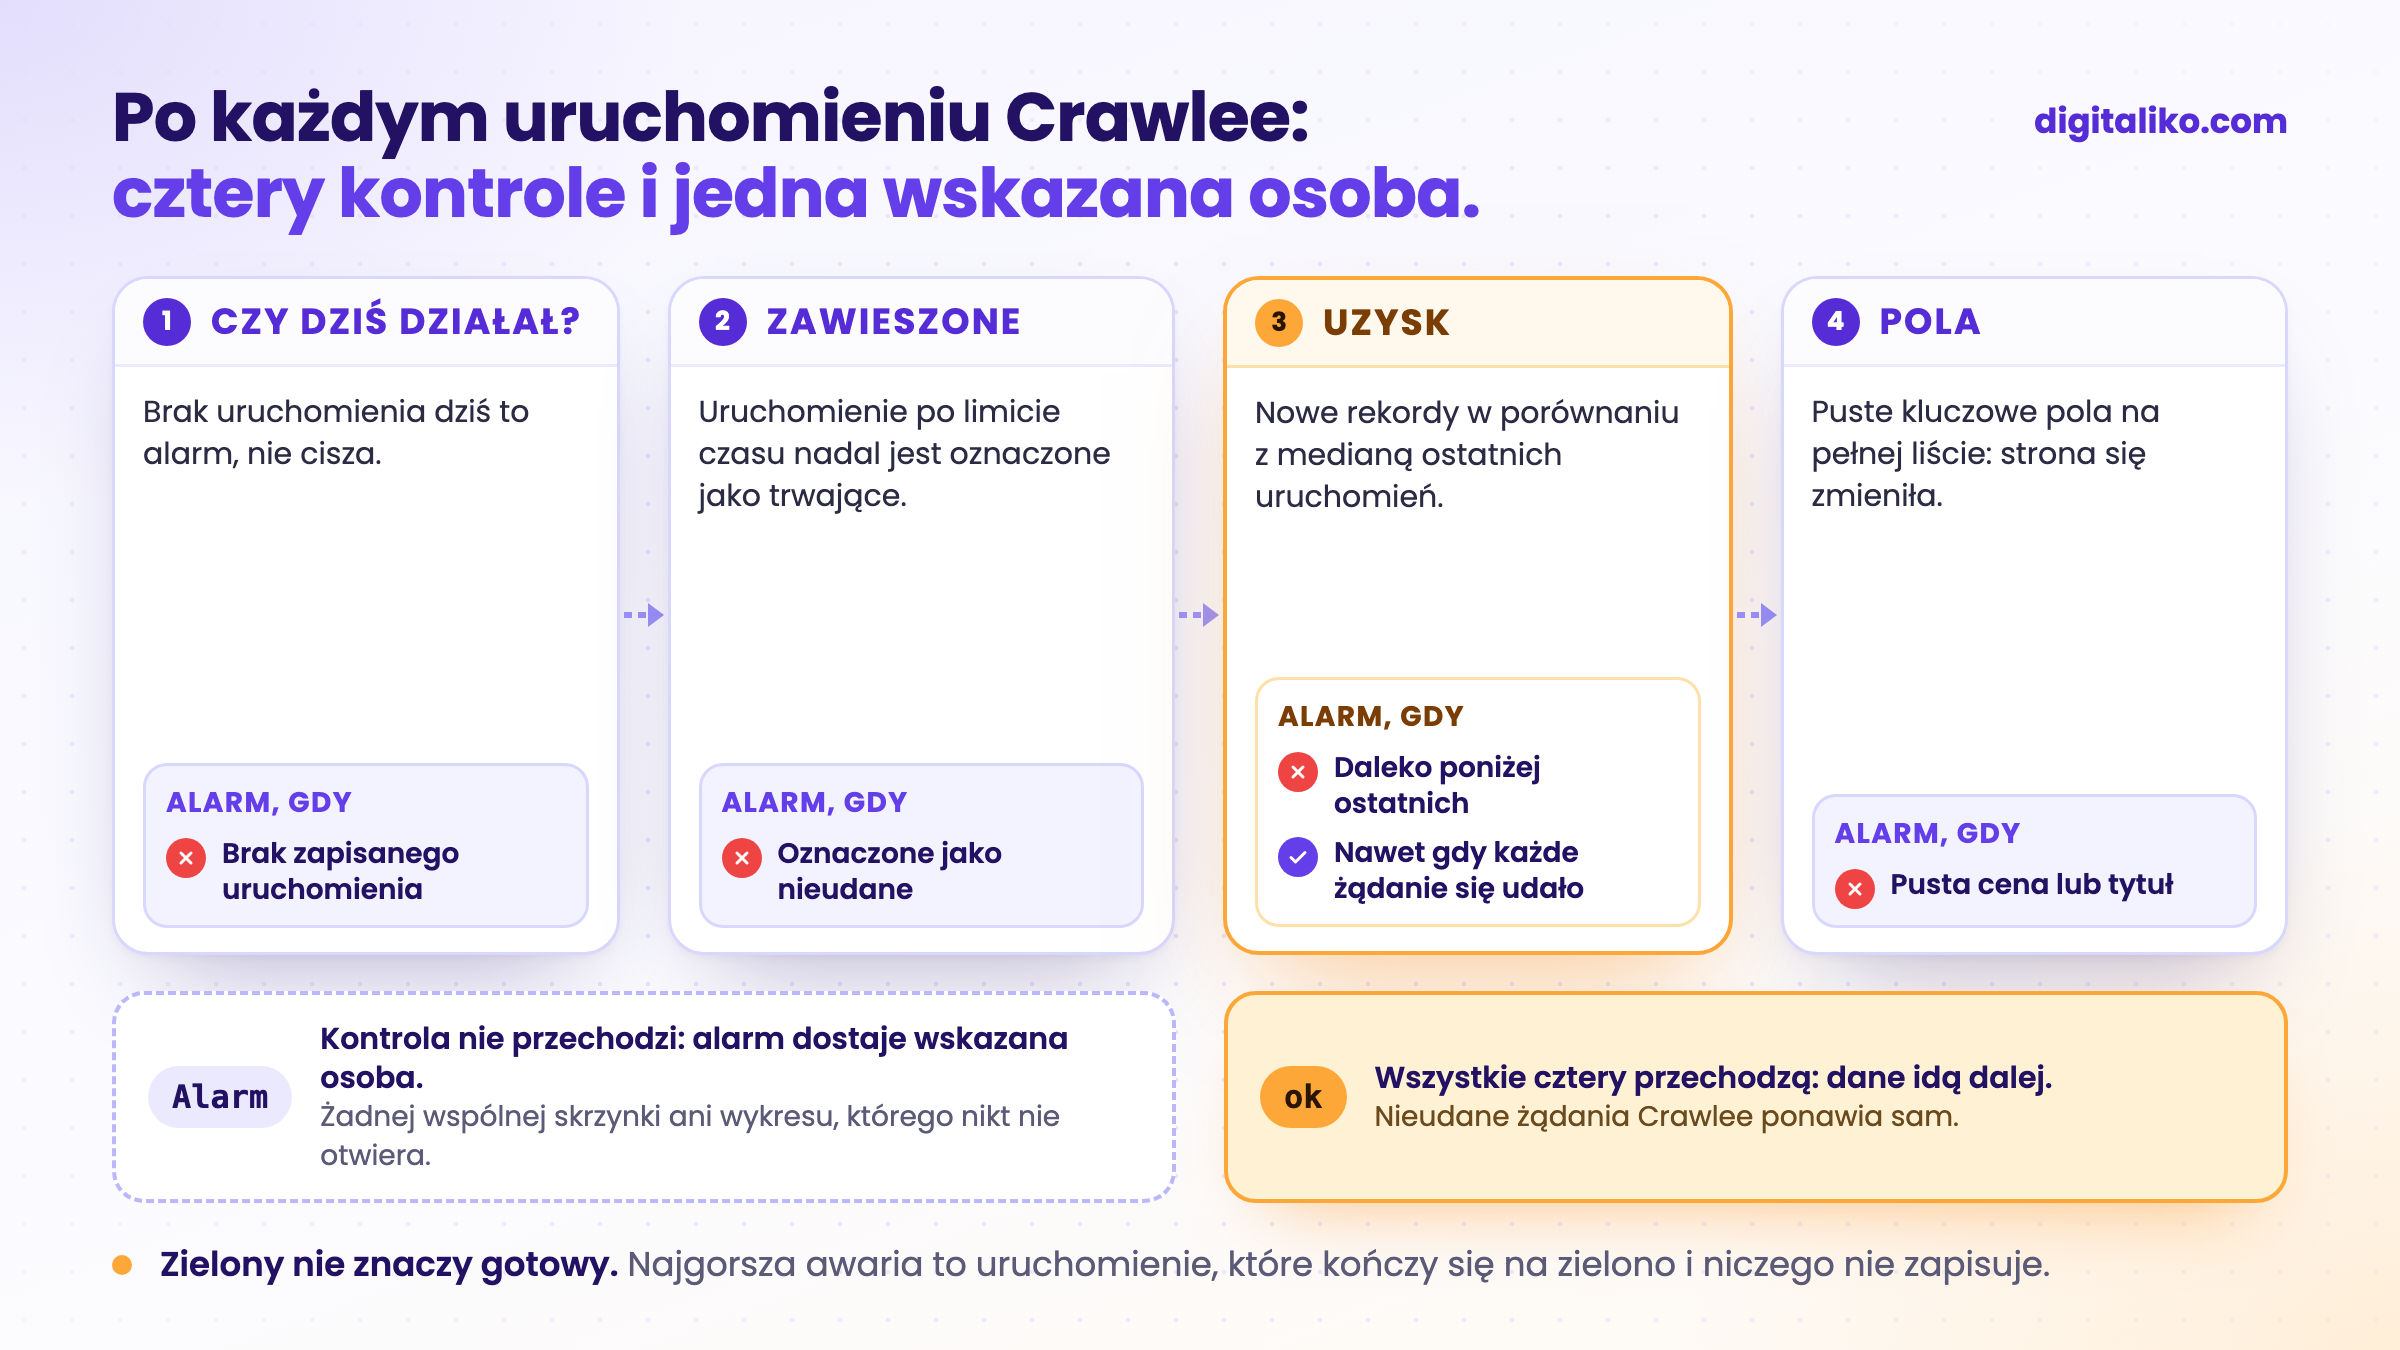
Każde uruchomienie proszę porównywać z medianą ostatnich uruchomień, a nie ze stałą liczbą. Źródło, które zwykle przynosi wiele nowych rekordów, a nagle przynosi garstkę, to awaria, nawet jeśli każde żądanie się powiodło. Uruchomienie oznaczone jako trwające długo po limicie czasu to też awaria, bo zabity proces nigdy nie zapisze własnego końca.
Doprowadzenie czegoś do stabilnej produkcji to inny poziom: architektura, infrastruktura i ludzie, którzy wiedzą, co może pójść nie tak.

Jak przygotować crawler w Crawlee do produkcji?
01
Proszę się przedstawić
Własny User-Agent ze stroną, która mówi, kto zbiera dane i po co.
02
Blokada i timeout
Jedno uruchomienie na źródło naraz, z twardym limitem czasu.
03
Crawling przyrostowy
Start od sitemap i pobieranie tylko tego, co zmieniło się od ostatniego uruchomienia.
04
Kontrola uzysku
Porównanie nowych rekordów i pustych pól z ostatnimi uruchomieniami.
05
Alarm do konkretnej osoby
Alarm dostaje wskazana osoba, a nie wspólna skrzynka.
Pierwszy krok dotyczy dobrych obyczajów i prawa. Crawler powinien przedstawiać się własną nazwą i linkiem do strony, która wyjaśnia, kto zbiera dane i po co. Jeśli regulamin źródła zabrania automatyzacji, proszę z niego nie zbierać. Co jest legalne w scrapingu i kiedy crawler w ogóle się opłaca, opisujemy w artykule Web scraping dla firm: kiedy crawler się opłaca.
Kiedy Crawlee to złe narzędzie?
- Źródło ma API lub eksport. Proszę z niego korzystać. Jest stabilniejsze, a warunki są spisane.
- Dane są potrzebne tylko raz. Wystarczy jednorazowy skrypt albo ręczne kopiowanie.
- Dane są za logowaniem albo regulamin zabrania ich zbierania. Lepiej uzgodnić dostęp ze źródłem.
- Państwa zespół pisze w Pythonie. Proszę wybrać Scrapy albo Crawlee dla Pythona. Crawler w języku, którego nikt nie utrzymuje, umiera przy pierwszym redesignie.
Wzorzec stojący za większością takich incydentów jest ten sam, o którym pisaliśmy w artykule Hooki Claude Code, które po cichu nic nie robią: zielony nie znaczy, że zadziałało.
Czy Państwa crawler jest gotowy na produkcję?
Potrzebują Państwo crawlera, który da znać, gdy stanie?
Jeśli regularnie potrzebują Państwo danych, które źródło pozwala zbierać, zbudujemy ich zbieranie z monitoringiem, który zaalarmuje, gdy przestanie działać. Robimy to w ramach automatyzacji procesów biznesowych. Od 2023 roku dostarczyliśmy ponad 15 projektów produkcyjnych.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Jak dowiedzieliby się Państwo dziś, że crawler nic nie przyniósł zeszłej nocy?
W skrócie
- Crawlee daje instalację crawlera: kolejkę, ponowienia, sesje, Cheerio albo prawdziwą przeglądarkę.
- Proszę zacząć od CheerioCrawler. Przeglądarka tylko tam, gdzie HTML nie wystarcza.
- Na produkcji najgorsza awaria to zielone uruchomienie, które niczego nie zapisuje.
- Każde uruchomienie z blokadą i timeoutem, crawling przyrostowy i porównanie uzysku z ostatnimi uruchomieniami.
- Alarm dostaje konkretna osoba.
Najczęstsze pytania
Czym jest Crawlee?
Biblioteką open source do web crawlingu i scrapingu. Daje jeden interfejs do szybkiego crawlingu HTTP z parserami HTML i do prawdziwych przeglądarek z Playwright lub Puppeteer, a do tego trwałą kolejkę żądań, ponowienia i sesje.
CheerioCrawler czy PlaywrightCrawler?
Proszę zacząć od CheerioCrawler. Pobiera HTML i go parsuje, co jest szybkie i lekkie. Źródło warto przenieść do PlaywrightCrawler dopiero wtedy, gdy jego strony renderują treść JavaScriptem albo wymagają kliknięć. Oba używają tego samego routera i kolejki.
Crawlee czy Scrapy?
Proszę wybrać język, który Państwa zespół będzie utrzymywał, bo crawler wymaga poprawek raz za razem. Zespół TypeScript bierze Crawlee. Zespół Python bierze Scrapy albo Crawlee dla Pythona.
Dlaczego crawler w Crawlee przestaje działać?
Strona się zmienia albo Państwa blokuje, albo zawodzi samo uruchomienie: limit czasu, zabity proces, harmonogram, który nie jest taki, jak Państwo myślą. Najgorszy przypadek to uruchomienie, które kończy się na zielono i niczego nie zapisuje. Dlatego po każdym uruchomieniu trzeba sprawdzać uzysk.
Jak monitorować crawler?
Po każdym uruchomieniu proszę sprawdzić, czy się uruchomił, ile nowych rekordów przyniósł w porównaniu z ostatnimi uruchomieniami i czy kluczowe pola są wypełnione. Alarm powinna dostać konkretna osoba. Uruchomienie, które długo po limicie czasu nadal jest oznaczone jako trwające, liczy się jako nieudane.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

