Playwright vs Puppeteer para pruebas y scraping
Para CTO y desarrolladoresWeb scraping y crawlers

Filip PapranecFundador de Digitaliko
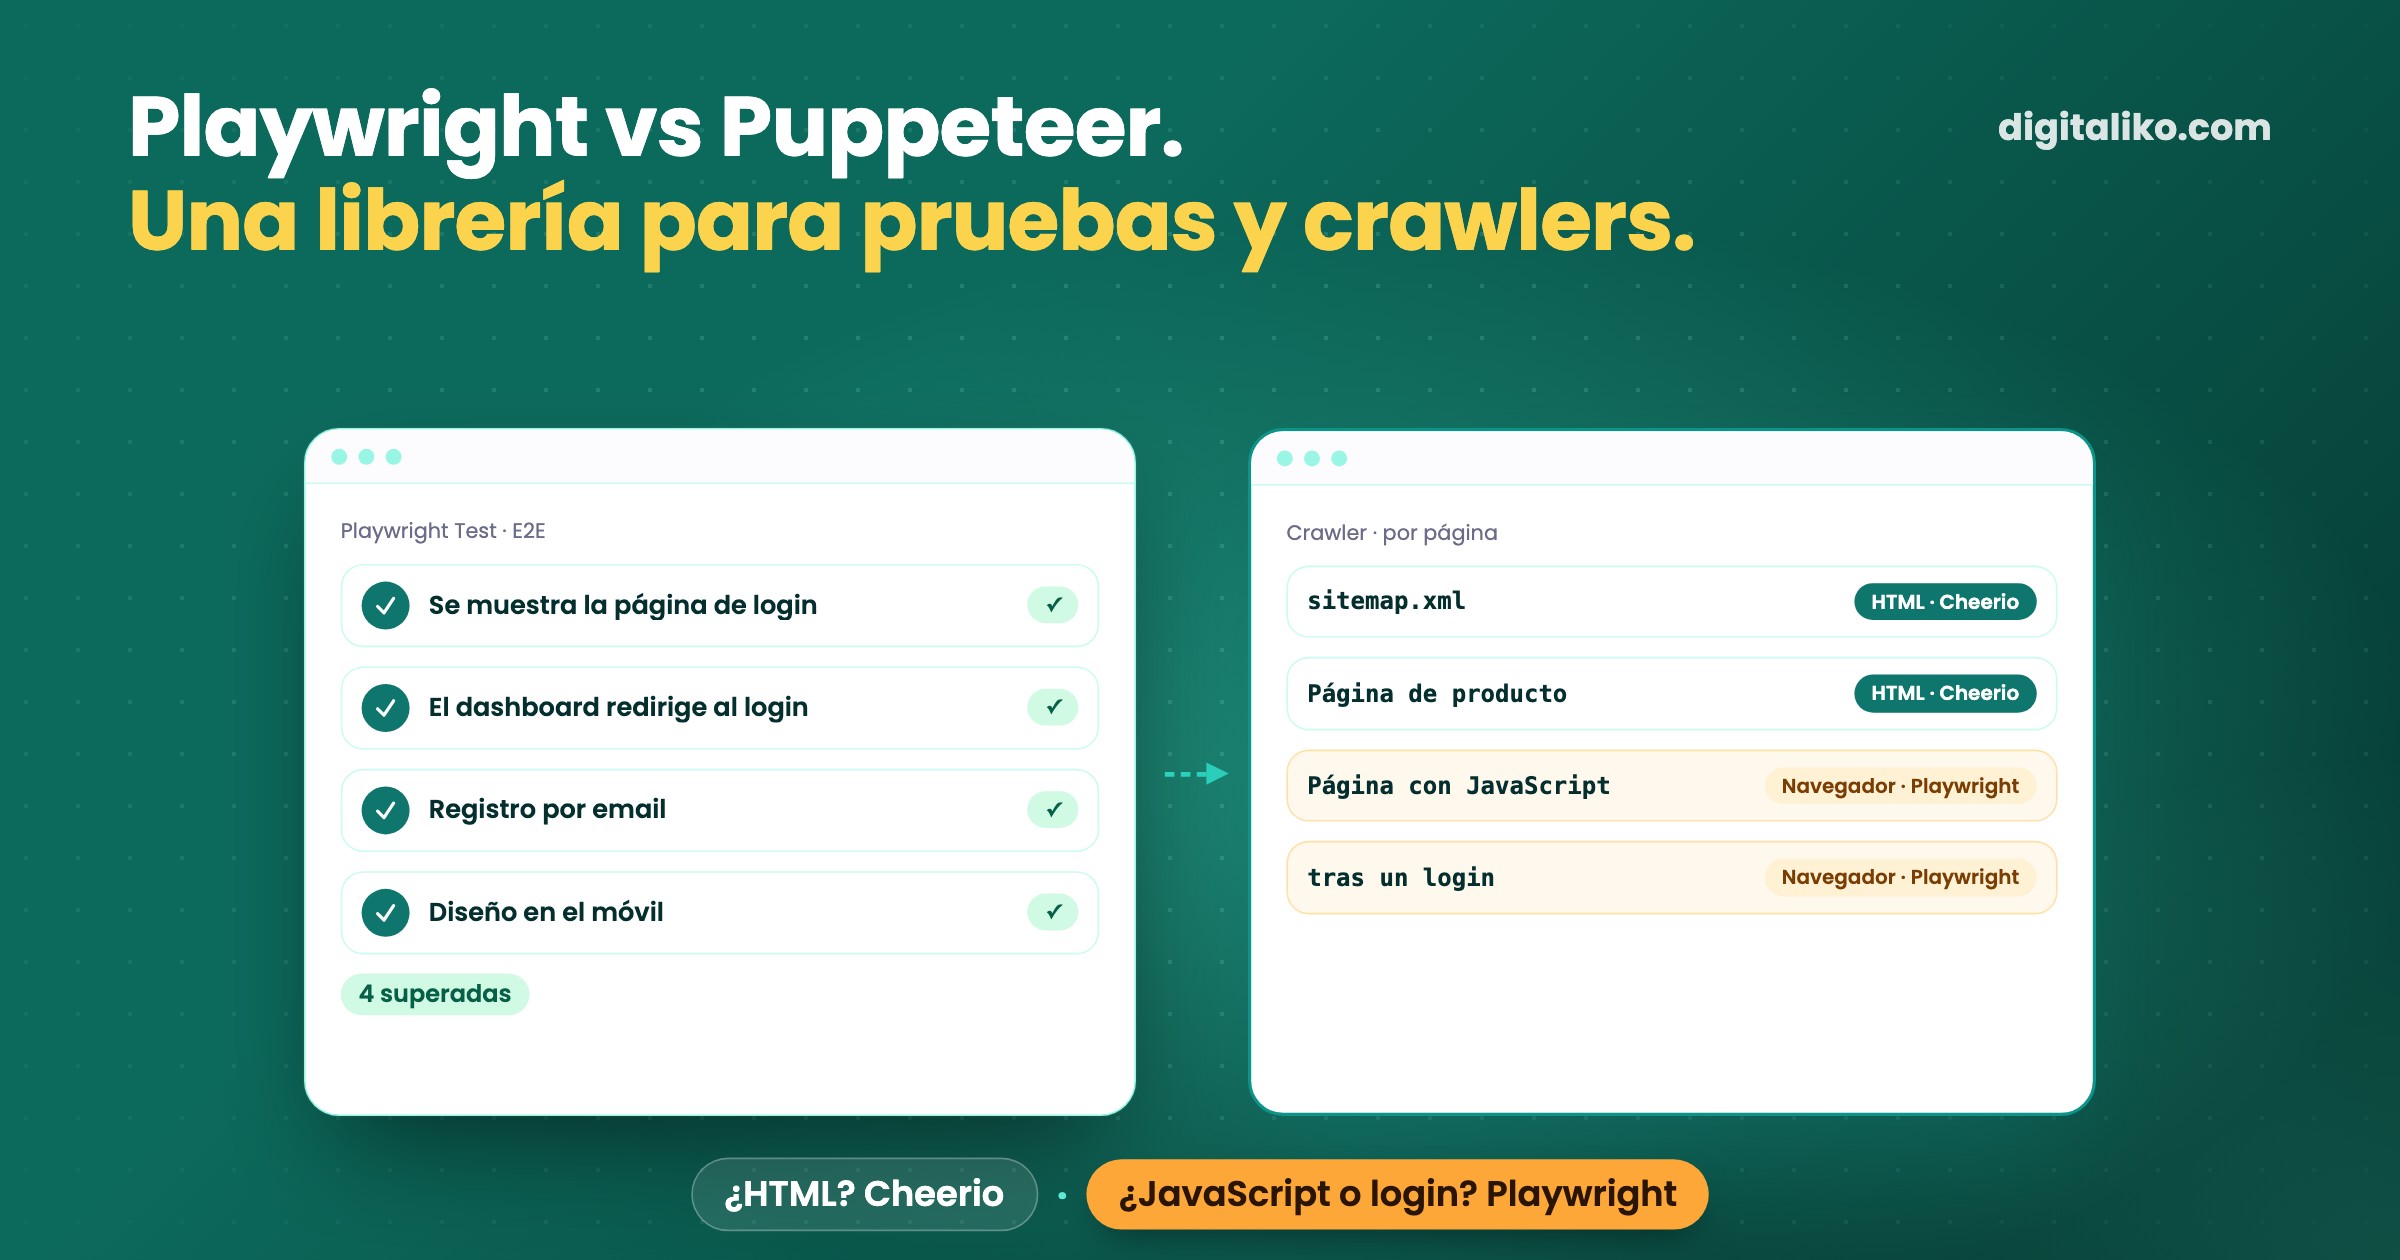
Playwright vs Puppeteer es una pregunta sobre dos trabajos: pruebas y scraping. Usamos Playwright para pruebas end-to-end y auditorías web. La misma herramienta sirve también para hacer scraping de páginas que necesitan un navegador real. Para un trabajo nuevo elegiríamos Playwright, salvo que solo controle Chrome desde un script de Node y ya tenga código de Puppeteer que funciona.
Primero, un límite sincero: Puppeteer aparece en un único proyecto antiguo nuestro, y nunca ejecutamos los dos en paralelo. Así que este artículo no es un benchmark. Muestra lo que usamos, por qué nos bastó una herramienta y la decisión que más importa en scraping: si necesita un navegador.
¿Qué diferencia hay entre Playwright y Puppeteer?
Los dos controlan un navegador real desde código. Se diferencian en el alcance. Puppeteer es "a JavaScript library which provides a high-level API to control Chrome or Firefox over the DevTools Protocol or WebDriver BiDi" (pptr.dev, consultado el 2026-10-24). Playwright "supports Chromium, WebKit and Firefox on Windows, Linux and macOS" (playwright.dev, consultado el 2026-10-24).
| Playwright | Puppeteer | |
|---|---|---|
| Navegadores | Chromium, WebKit, Firefox | Chrome, Firefox |
| Lenguajes | JavaScript/TypeScript, Python, Java, .NET (docs) | JavaScript/TypeScript |
| Test runner | Playwright Test, integrado | ninguno, hay que traer uno propio |
| Esperas | locators que esperan automáticamente | waitForSelector y similares, a mano |
| En Crawlee | PlaywrightCrawler | PuppeteerCrawler |
| Dónde lo usamos | pruebas e2e, auditorías | un proyecto antiguo |
Fuentes de la tabla: las páginas anteriores y la guía de migración desde Puppeteer de Playwright, todas consultadas el 2026-10-24.
La fila que decidió por nosotros es el test runner. Una librería que nos da a la vez el navegador y el test runner significa una herramienta que aprender, una instalación de navegador en CI y un único conjunto de selectores.
¿Cómo usamos Playwright para pruebas?
En tres sitios, de más estricto a más flexible.
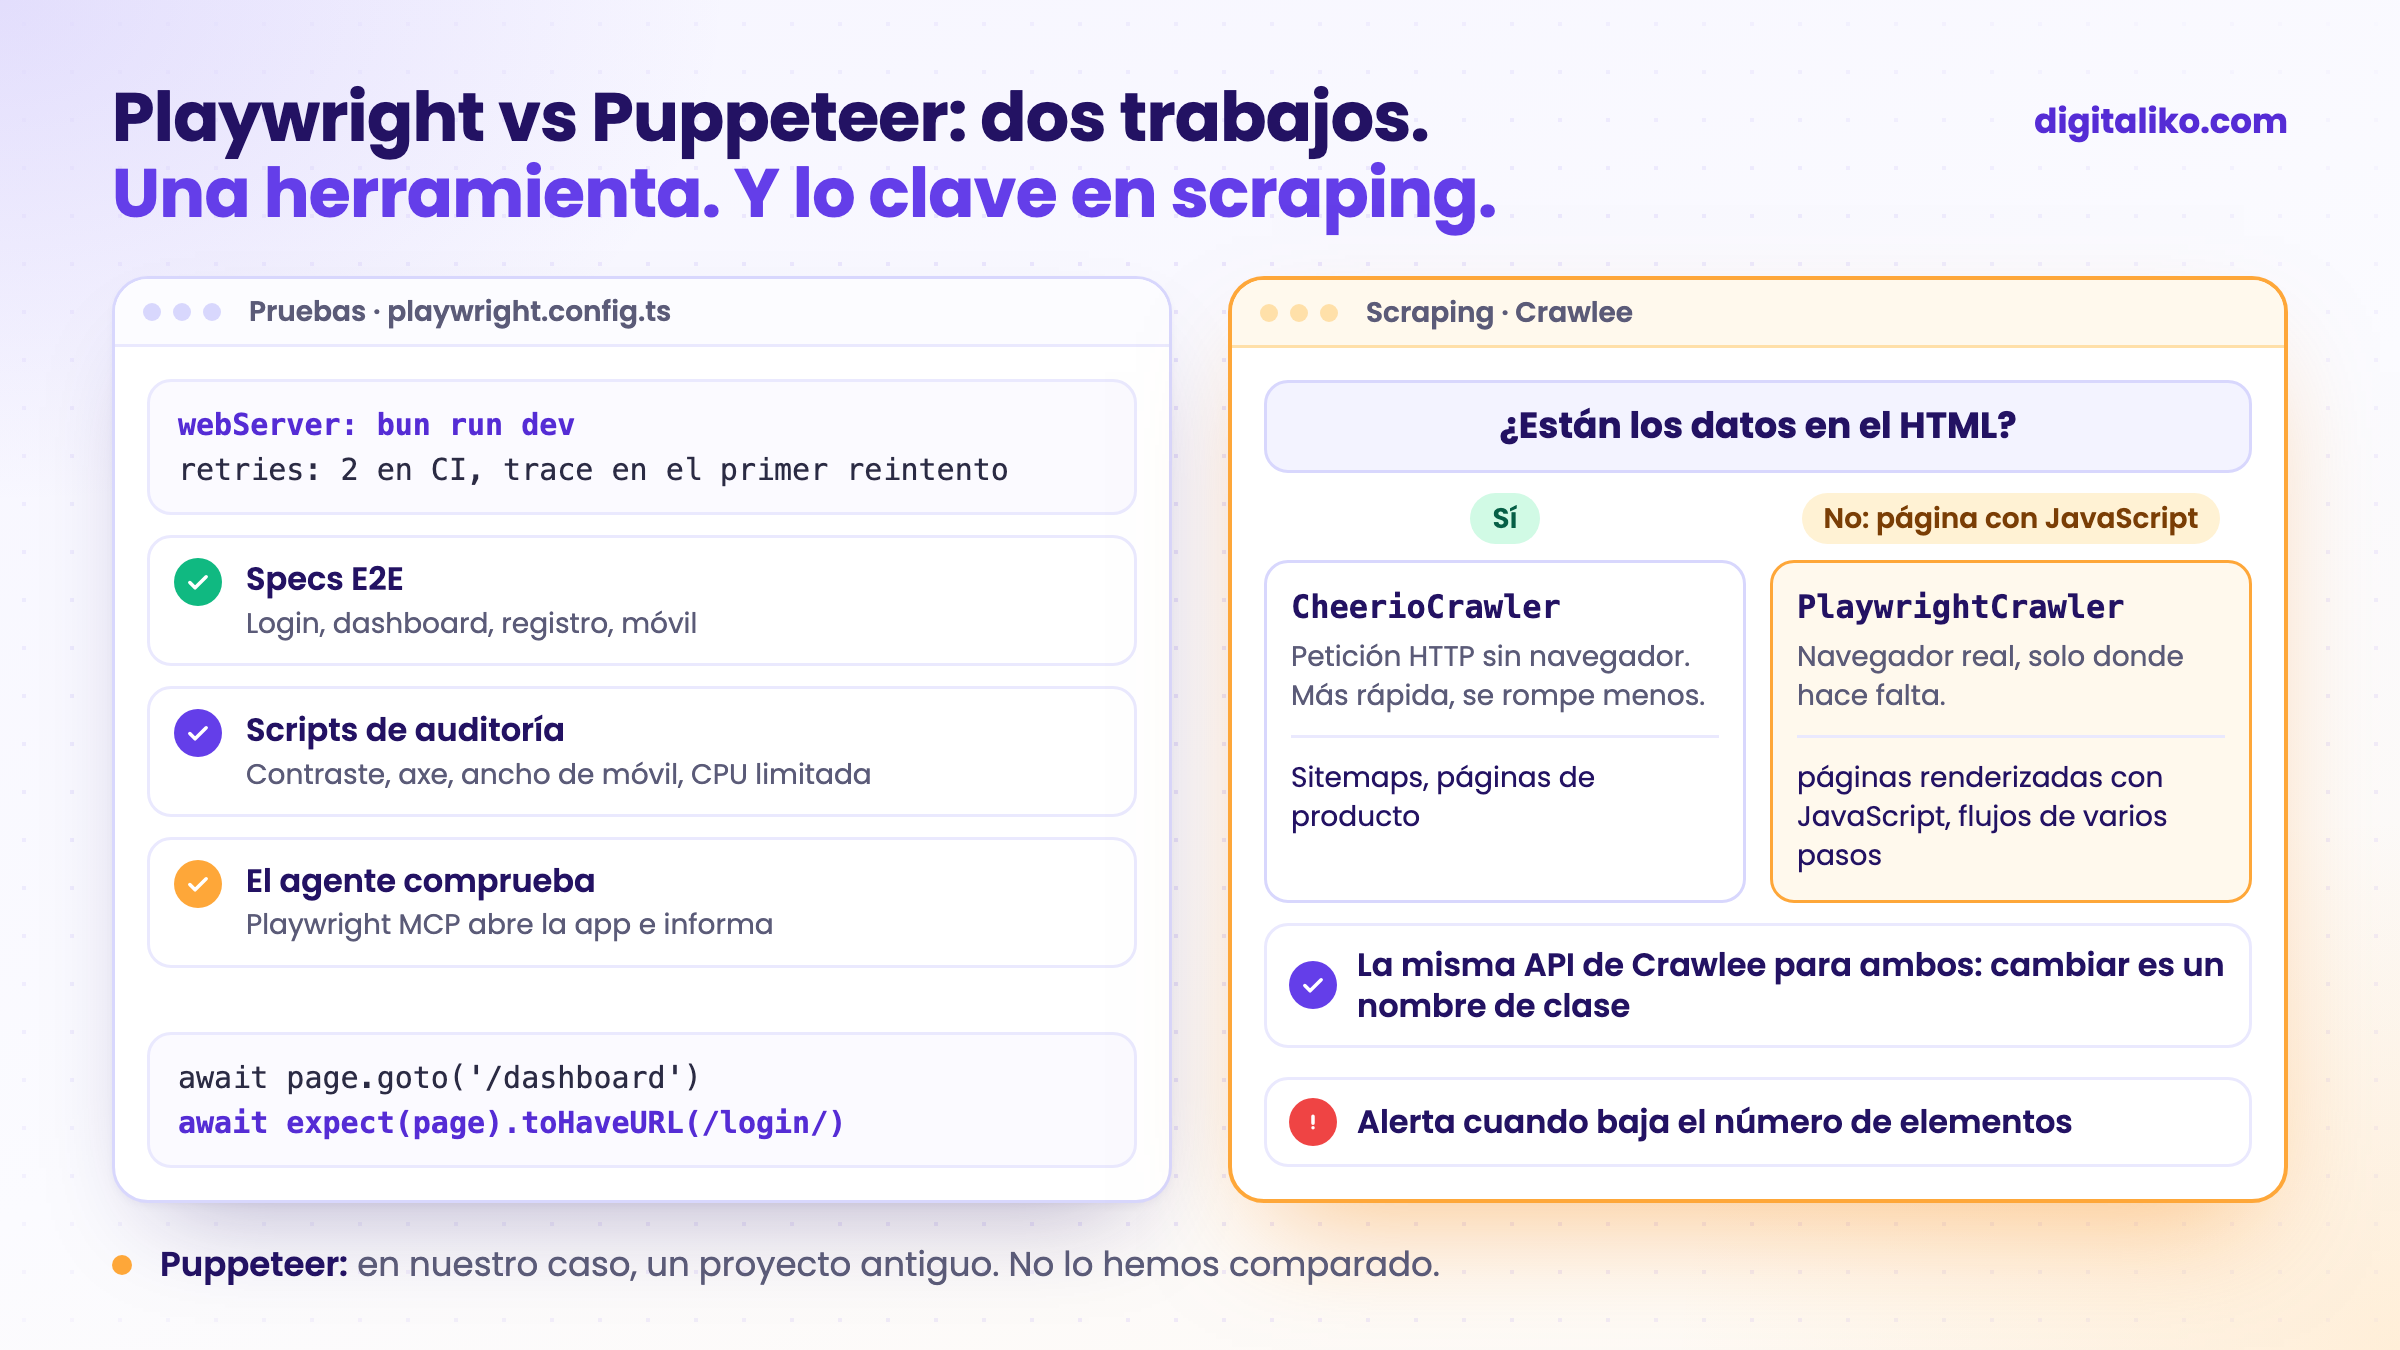
Pruebas end-to-end. Nuestra plantilla base ejecuta Playwright Test contra el servidor de desarrollo. La configuración, abreviada:
// playwright.config.ts
import { defineConfig } from '@playwright/test'

export default defineConfig({
  testDir: './e2e',
  forbidOnly: !!process.env.CI,
  retries: process.env.CI ? 2 : 0,
  use: { baseURL: 'http://localhost:3001', trace: 'on-first-retry' },
  projects: [{ name: 'chromium', use: { browserName: 'chromium' } }],
  webServer: { command: 'bun run dev', url: 'http://localhost:3001', reuseExistingServer: !process.env.CI },
})
Y una de las specs:
test('dashboard redirects to login when not authenticated', async ({ page }) => {
  await page.goto('/dashboard')
  await expect(page).toHaveURL(/login/)
})
Sin sleeps ni esperas manuales. expect(page).toHaveURL reintenta hasta que pasa o se agota el tiempo. Esa es la parte que en Puppeteer escribiría a mano.
Auditorías web. Cuando auditamos esta web, las comprobaciones eran scripts sencillos de Playwright: contraste del texto a partir de los colores calculados, reglas de accesibilidad de axe, maquetación en ancho de móvil, carga con la CPU limitada. Scripts de usar y tirar, no una suite de tests.
El agente de IA comprobando su propio cambio. El agente abre la aplicación a través de Playwright MCP e informa de lo que ha visto. Cómo funciona lo explicamos en Playwright MCP: que el agente de IA demuestre que funciona.
¿Cómo se usa Playwright para scraping?
A través de Crawlee, que envuelve ambas librerías. Como dice su documentación, "Crawlee comes with three main crawler classes: CheerioCrawler, PuppeteerCrawler and PlaywrightCrawler" (crawlee.dev, consultado el 2026-10-24). Cambiar ahí Puppeteer por Playwright es sobre todo cambiar el nombre de una clase. La elección real es la primera clase: HTTP o navegador.
Para una página con mucho JavaScript encaja PlaywrightCrawler. Un ejemplo simplificado:
import { PlaywrightCrawler } from 'crawlee'
import { router } from './routes.js'

const crawler = new PlaywrightCrawler({
  maxRequestsPerCrawl,
  requestHandlerTimeoutSecs: 360,
  navigationTimeoutSecs: 60,
  maxRequestRetries: 4,
  requestHandler: router,
  launchContext: {
    launchOptions: { args: ['--disable-gpu'] }, // la GPU falla en Docker
  },
})

await crawler.run(startUrls)
Si los datos están en el HTML, no necesita ningún navegador. CheerioCrawler lee sitemaps y páginas de producto.
Cómo decidir, por tipo de página:
01
Abrir la página con JavaScript desactivado
O descargarla con curl. Si los datos que necesita están en el HTML, no necesita un navegador.
02
Cheerio donde se pueda
Un crawler HTTP es más rápido, usa menos memoria y se rompe menos que un navegador.
03
Playwright donde haga falta
Las páginas renderizadas en el navegador y los flujos de varios pasos van con PlaywrightCrawler.
04
Monitorizar en ambos casos
Un crawler que se para en silencio cuesta más que la librería equivocada. Alerte cuando baje el número de elementos.
El último paso es el que más importa. Ninguna librería salva a un crawler que se para en silencio; solo lo hace una alerta. Más en Crawlee para web scraping: qué se rompe en producción.
¿Por qué nunca necesitamos Puppeteer?
Porque todos nuestros trabajos quedaban cubiertos en cuanto Playwright estaba en el repositorio. Las pruebas necesitaban un runner, y Playwright lo tiene. Una segunda librería de navegador habría añadido una instalación, no una capacidad.
The APIs have similarities, but Playwright offers much more possibilities for web testing and cross-browser automation.
Esa frase es del equipo de Playwright, así que léala como la opinión de un proveedor. Para trabajo solo con Chrome, Puppeteer sigue siendo una opción sólida.
¿Cuándo sería Puppeteer la mejor opción?
Según la documentación, no según nuestras ejecuciones:
- Solo necesita Chrome, desde un script de Node, y ya tiene código de Puppeteer que funciona. Reescribirlo aporta poco.
- Trabaja cerca del Chrome DevTools Protocol y quiere una librería construida a su alrededor.
- Sus pruebas ya funcionan en otro framework y solo necesita un driver de navegador, no un runner.
Si además necesita WebKit, Python o un test runner en la misma herramienta, Playwright lo cubre. Playwright dice que la mayoría de las APIs de Puppeteer "can be used as is" en una migración (guía), así que el cambio suele ser pequeño.
Playwright o Puppeteer: ¿cuál para su proyecto?
Responda a esto antes de elegir. Cada "sí" apunta a Playwright:
¿Necesita pruebas o un crawler que aguanten en producción?
Si necesita con regularidad datos cuya recogida permite la fuente, le construimos una recogida con monitorización que le avisa cuando deja de funcionar. Lo hacemos como parte de la automatización de procesos empresariales. La IA escribe la mayor parte de nuestro código. Un sénior revisa cada cambio y responde de la producción. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en un plazo de dos días hábiles con algunas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Cuáles de sus páginas necesitan de verdad un navegador?
En resumen
- Playwright controla Chromium, WebKit y Firefox e incluye un test runner. Puppeteer controla Chrome y Firefox desde JavaScript.
- Usamos Playwright para pruebas e2e, auditorías y comprobaciones del agente.
- En scraping, la elección mayor es HTTP con Cheerio o un navegador real, página a página.
- No hemos hecho un benchmark de Puppeteer. Si tiene un script solo para Chrome que funciona, consérvelo.
Preguntas frecuentes
¿Qué diferencia hay entre Playwright y Puppeteer?
Puppeteer es una librería de JavaScript para Chrome y Firefox. Playwright controla Chromium, WebKit y Firefox, tiene bindings para JavaScript, Python, Java y .NET e incluye su propio test runner con locators que esperan automáticamente. Para un trabajo nuevo que necesite pruebas o más de un navegador, Playwright cubre más.
¿Es Playwright mejor que Puppeteer para web scraping?
En scraping, la librería importa menos que saber si necesita un navegador. La mayoría de las páginas públicas son HTML simple, y basta con un crawler HTTP con Cheerio. Solo las páginas renderizadas con JavaScript necesitan un navegador real, y ahí encaja Playwright a través de Crawlee. No hemos comparado Puppeteer con él en un benchmark.
¿Puedo migrar de Puppeteer a Playwright?
Sí. Playwright publica una guía de migración y dice que la mayoría de las APIs de Puppeteer se pueden usar tal cual. El cambio mayor es pasar de element handles y esperas manuales a locators y aserciones web-first.
¿Puppeteer es compatible con Firefox y Safari?
Puppeteer controla Chrome o Firefox a través del DevTools Protocol o de WebDriver BiDi. No controla WebKit, así que para probar el comportamiento de Safari hace falta Playwright u otra herramienta.
¿Necesito un navegador headless para web scraping?
A menudo no. Si los datos están en el HTML que devuelve el servidor, una petición HTTP con un parser de HTML es más rápida y más barata de ejecutar. Use un navegador solo para páginas que renderizan los datos con JavaScript.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

