Web scraping dla firm: kiedy crawler się opłaca

Filip PapranecZałożyciel Digitaliko
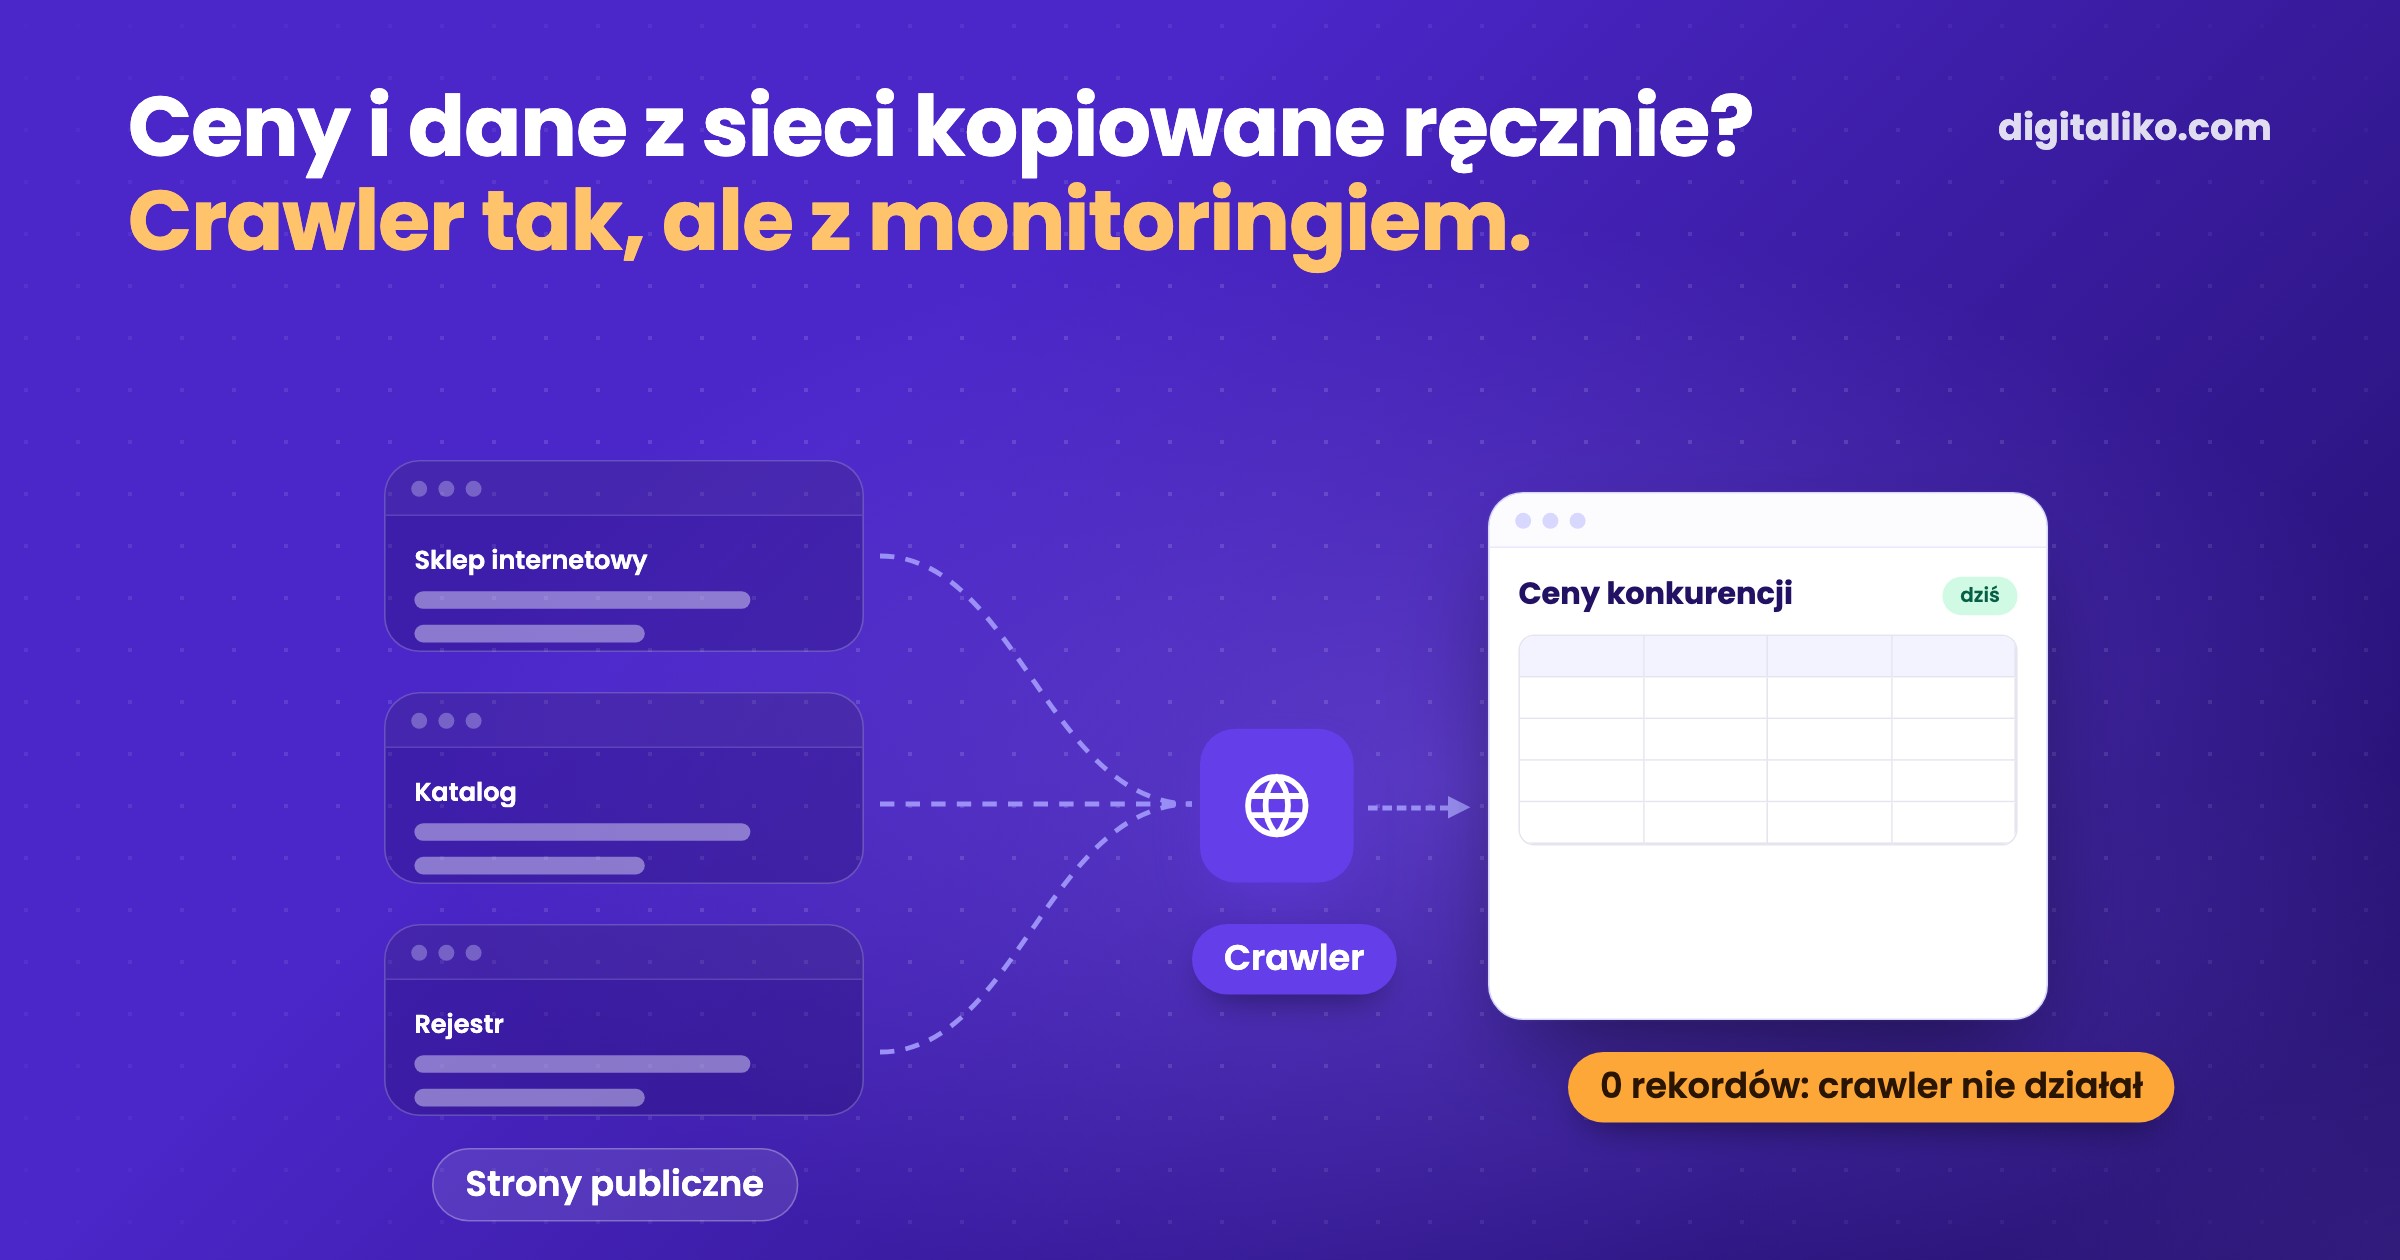
Ceny konkurencji, katalogi dostawców czy dane z rejestrów publicznych ktoś w Państwa firmie kopiuje dziś ręcznie. Crawler opłaca się, gdy regularnie potrzebują Państwo tych samych publicznych danych, a ręcznie zajmuje to godziny. Jeśli źródło oferuje eksport lub API, proszę najpierw z nich skorzystać. A każdy crawler kiedyś przestaje działać, więc bez monitoringu nie przetrwa.
Poniżej opisujemy, kiedy crawler się opłaca, co się psuje i jak go pilnować.
Do czego firmy używają crawlera?
Web scraping oznacza, że program przechodzi przez strony internetowe i zapisuje z nich dane do tabeli lub systemu. W firmach widzimy go w trzech zadaniach:
| Zadanie | Co się zbiera | Jak często | Na co uważać |
|---|---|---|---|
| Monitoring cen konkurencji | Cena, dostępność, promocje | Codziennie lub co tydzień | Ceny z VAT i bez VAT, warianty produktów |
| Dane produktowe i katalogi | Nazwy, parametry, zdjęcia od dostawców | Przy zmianie asortymentu | Prawa do tekstów i zdjęć, nie każdy może ich użyć ponownie |
| Rejestry publiczne | Firmy, adresy, stan spraw | Przy każdym nowym kontakcie | Wiele rejestrów ma API lub otwarte dane |
Zwykle zaczyna się od arkusza. Raz w tygodniu ktoś otwiera sklepy internetowe konkurencji, kopiuje ceny do Excela i wysyła je do sprzedaży. Jak poznać, że arkusz już nie wystarcza, opisuje artykuł Kiedy Excel przestaje firmie wystarczać?.
Kiedy crawler się opłaca?
Zanim zbudują Państwo crawler, proszę zaznaczyć, co jest prawdą w Państwa przypadku:
Jeśli wszystkie odpowiedzi brzmią „tak”, crawler ma sens. Jeśli nie, proszę wybrać prostszą drogę.
Proszę nie lekceważyć ostatniego punktu. Crawlera nie naprawia się raz, naprawia się go za każdym razem, gdy źródło się zmienia.
Crawler, eksport czy API?
Dane z internetu można zdobyć na trzy sposoby. Crawler to ostatni z nich.
Ręcznie
- Raz, kilka stron.
- Stabilność zależy od człowieka.
- Bez utrzymania, ale kosztuje czas.
- Do jednorazowego zebrania danych.
Nasza rada
Eksport lub API
- Gdy źródło je oferuje.
- Stabilne, warunki są spisane.
- Niskie utrzymanie.
- Zawsze pierwszy wybór.
Crawler
- Regularnie, wiele stron, bez API.
- Zmiana strony go psuje.
- Stałe utrzymanie z monitoringiem.
- Tylko gdy dwa pierwsze nie wystarczą.
Zebrane dane to dopiero początek. Mają wartość, gdy działa na ich podstawie sprzedaż albo system, na przykład oznaczając zmianę ceny. Jeśli regularnie potrzebują Państwo danych, które źródło pozwala zbierać, zbudujemy ich zbieranie z monitoringiem, który zaalarmuje, gdy przestanie działać. Robimy to w ramach automatyzacji procesów biznesowych.
Co psuje się w crawlerze?
Crawler zależy od strony, która nie należy do Państwa. Zmienia się bez uprzedzenia. Strona zmienia układ lub adresy URL, blokuje Państwa albo crawler po prostu przestaje się uruchamiać:
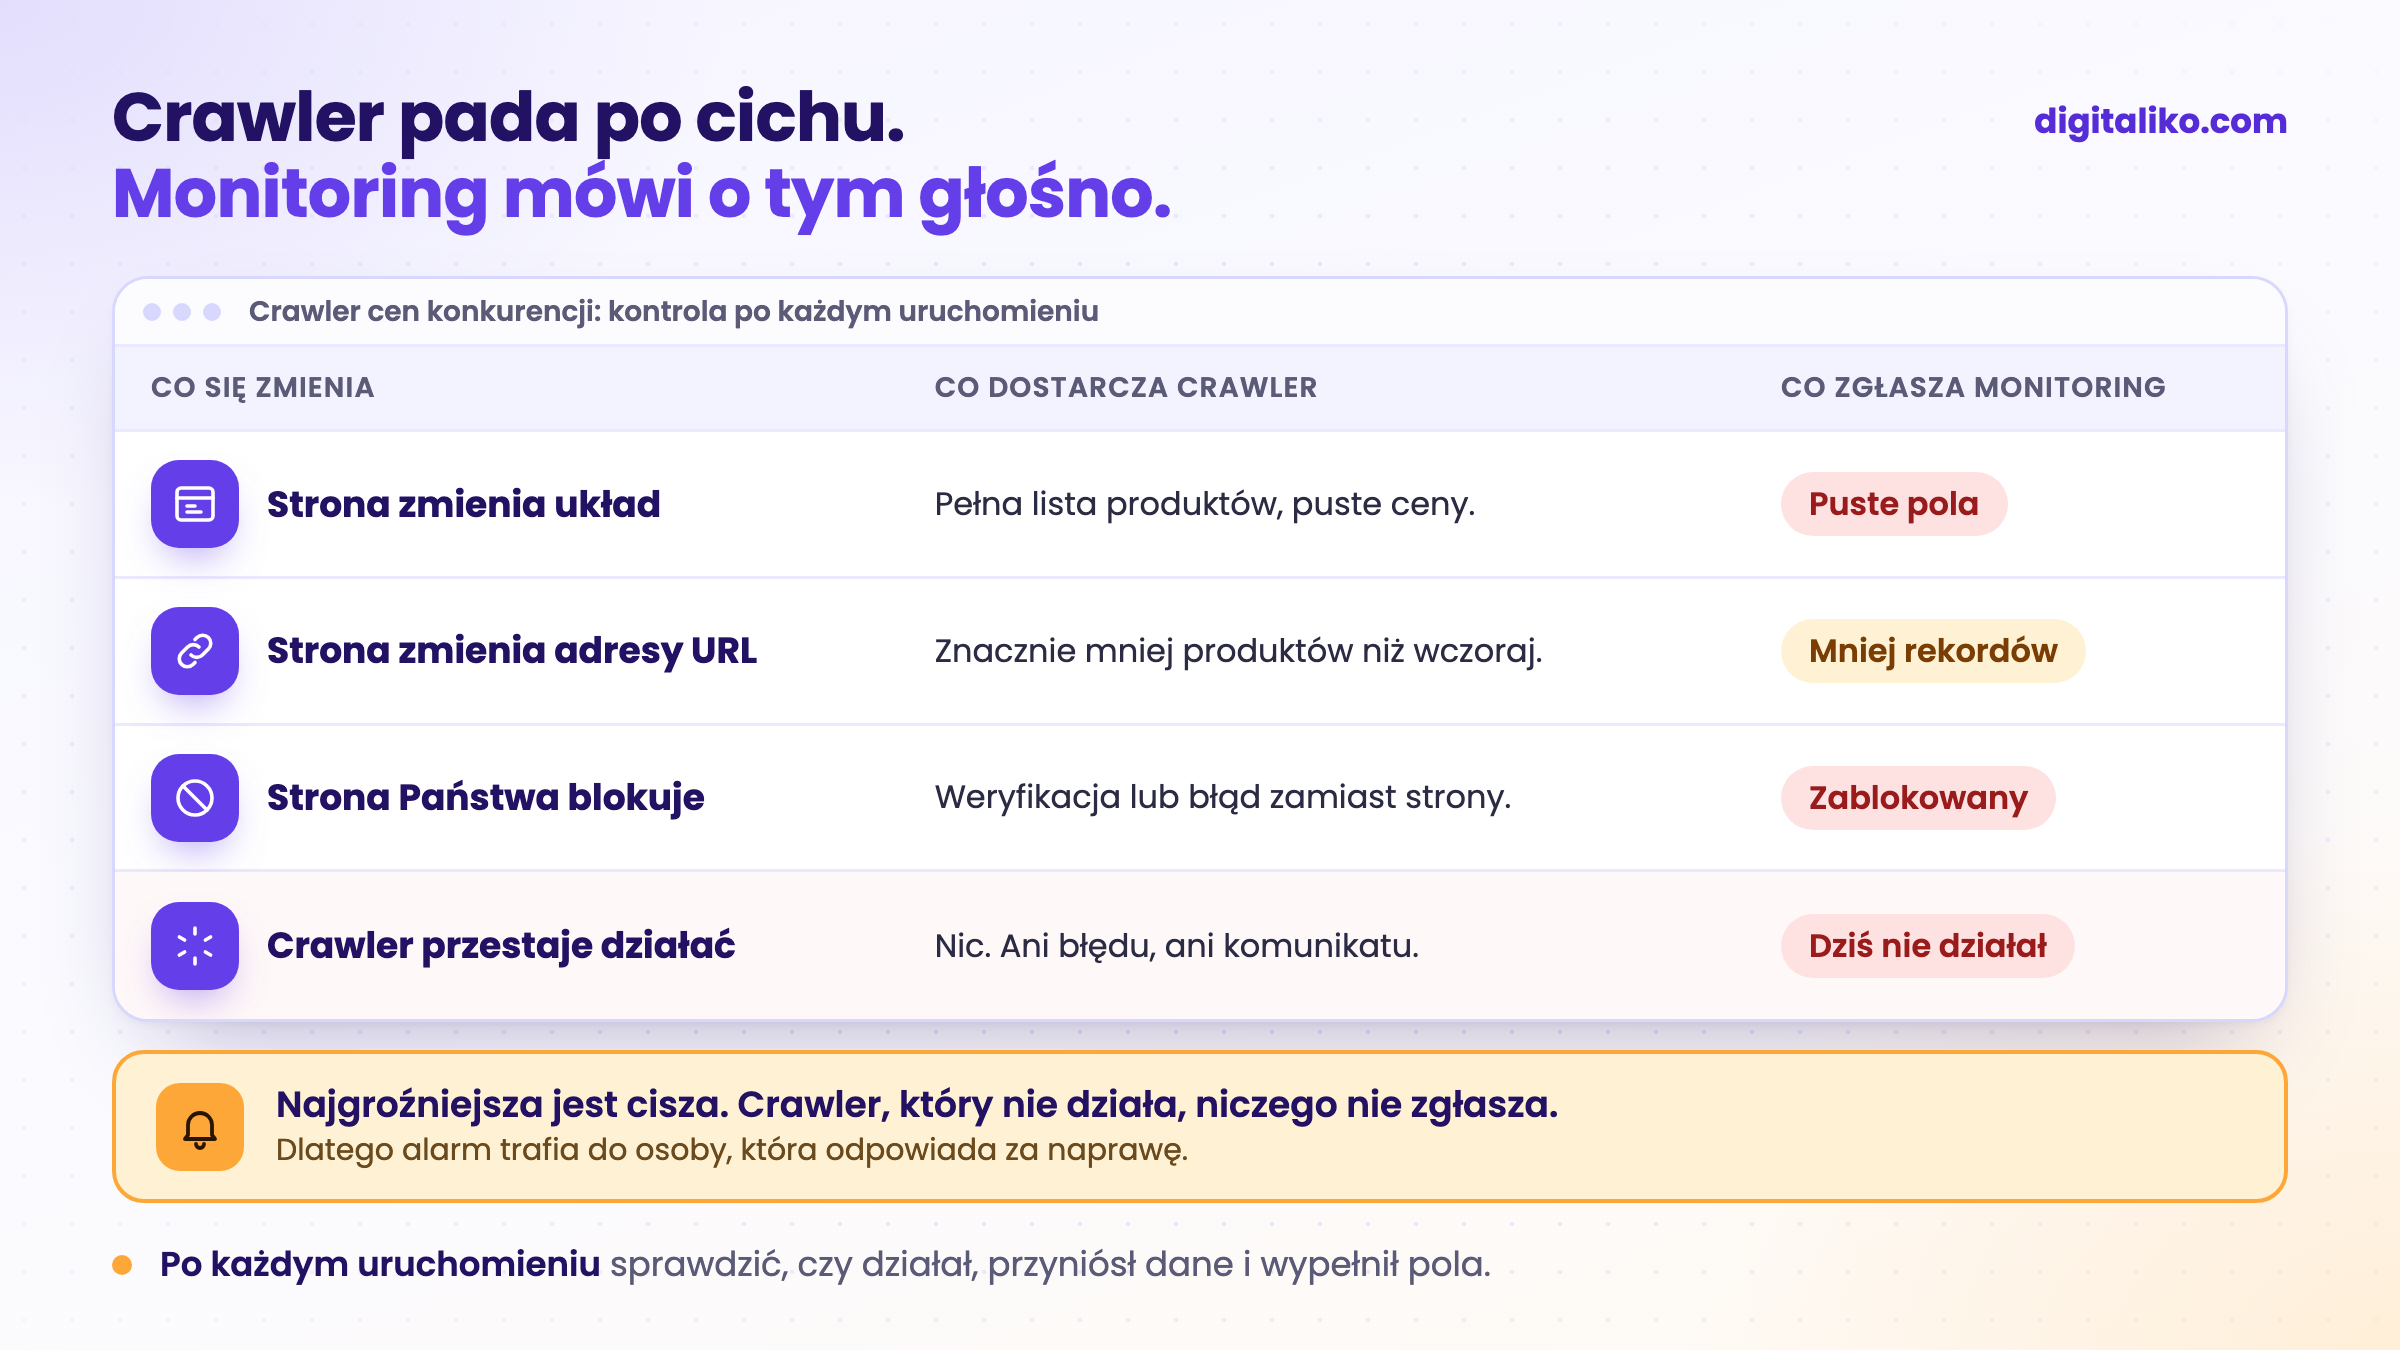
Ostatni przypadek jest najbardziej zdradliwy, bo nic go nie zgłasza. Dane po cichu przestają napływać, a ludzie często dowiadują się o tym po tygodniach, z wykresu.
Jak monitorować crawler?
Po każdym uruchomieniu crawlera proszę sprawdzić cztery rzeczy:
01
Czy dziś działał?
Jeśli nie, alarm trafia do konkretnej osoby, a nie do wspólnej skrzynki.
02
Czy przyniósł dane?
Zero rekordów albo znacznie mniej niż wczoraj to awaria, a nie sukces.
03
Czy pola są wypełnione?
Pusta cena przy pełnej liście oznacza, że strona się zmieniła.
04
Kto to naprawi?
Konkretna osoba, a nie „dział IT”.
Bez nazwiska przy naprawie monitoring tylko ładnie zgłasza problem. Naprawa przychodzi dopiero wtedy, gdy ktoś za nią odpowiada.
Dlaczego sprawdzać też dane? Crawler może działać kilka dni, trafić na limit czasu uruchomienia i niczego nie zapisać. Każde uruchomienie zaczyna wtedy od zera. Działa więc, ale danych nie przynosi. Równie zdradliwe: w repozytorium jest jeden harmonogram, a serwer wykonuje inny.
Co jest legalne w web scrapingu?
Publicznie dostępne nie znaczy wolne do użycia. Trzymamy się tych zasad:
- Tylko dane publiczne. Nic za logowaniem i nic, co strona ukrywa.
- Regulamin i robots.txt. Jeśli strona zabrania zbierania danych, nie zbieramy.
- Rozsądne tempo. Żadnych tysięcy żądań na minutę. Serwer należy do kogoś innego.
- Dane osobowe. Imiona i nazwiska, e-maile i telefony podlegają RODO, nawet jeśli są publiczne.
- Teksty i zdjęcia. Mogą być chronione prawem autorskim. Cena to fakt, opis produktu to cudzy tekst.
Przyzwoity crawler przedstawia się stronom własną nazwą i linkiem do strony, która wyjaśnia, kto zbiera dane i po co. Jeśli regulamin źródła zabrania automatyzacji, proszę z niego nie zbierać.
Kiedy tego nie polecamy
Automatyzacja nie oznacza robienia wszystkiego szybciej. Czasem lepiej znaleźć część, którą można pominąć.
- Dane są potrzebne tylko raz. Proszę skopiować je ręcznie albo zlecić jednorazowe zebranie. Crawler się nie zwróci.
- Źródło oferuje eksport, otwarte dane lub API. Proszę z nich skorzystać. Crawler byłby droższą i bardziej kruchą drogą.
- Dane są za logowaniem albo regulamin zabrania ich zbierania. Proszę go nie budować. Lepiej uzgodnić dostęp ze źródłem.
- Nikt nie będzie korzystał z wyniku ani naprawiał crawlera. Arkusz, którego nikt nie otwiera, niczego nie oszczędza.
Jeśli chcą Państwo zautomatyzować pracę, która polega na czytaniu wolnego tekstu, a nie stron, pomoże artykuł Czym jest agent AI?.
Kopiują Państwo dane z internetu ręcznie?
Proszę napisać, jakie dane Państwo zbierają, skąd i jak często. Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw. Jeśli wystarczy eksport lub API, też to powiemy.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Jakie dane ktoś w Państwa firmie co tydzień kopiuje z cudzej strony?
W skrócie
- Crawler opłaca się, gdy regularnie potrzebują Państwo tych samych publicznych danych, a ręcznie zajmuje to godziny.
- Jeśli źródło oferuje eksport lub API, proszę najpierw z nich skorzystać. Są stabilniejsze, a warunki są spisane.
- Każdy crawler kiedyś przestaje działać. Po każdym uruchomieniu proszę sprawdzić, czy działał, przyniósł dane i wypełnił pola.
- Za naprawę odpowiada konkretna osoba, a nie „dział IT”.
Najczęstsze pytania
Czy web scraping jest legalny?
Zbieranie publicznie dostępnych danych jest powszechne, ale ma granice. Proszę przestrzegać regulaminu strony i pliku robots.txt, nie wchodzić w nic za logowaniem, nie przeciążać serwera, a przy danych osobowych liczyć się z RODO. W razie wątpliwości proszę zapytać prawnika.
Kiedy crawler opłaca się firmie?
Gdy regularnie potrzebują Państwo tych samych danych z publicznych stron, a ręcznie zajmuje to godziny. Jeśli źródło oferuje eksport lub API, proszę najpierw z nich skorzystać. Do jednorazowego zebrania danych crawlera nie warto budować.
Czym różni się crawler od scrapera?
Crawler przechodzi przez strony i znajduje, gdzie są dane. Scraper wyciąga ze strony konkretne wartości, na przykład cenę lub nazwę produktu. W firmach używa się tych słów zamiennie, bo większość narzędzi robi jedno i drugie.
Jak często crawler wymaga naprawy?
Za każdym razem, gdy strona źródłowa zmienia układ, adresy URL lub ochronę przed botami. Nie da się przewidzieć kiedy. Dlatego crawler powinien alarmować, gdy przynosi zero rekordów lub puste pola, a ktoś musi odpowiadać za naprawę.
A jeśli strona oferuje API?
Proszę użyć API. Jest stabilniejsze, redesign go nie psuje, a warunki korzystania są spisane. Crawler ma sens tam, gdzie API nie ma albo brakuje w nim tego, czego Państwo potrzebują.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

