Web scraping pre firmy: kedy sa crawler oplatí
Automatizácia procesov · Aktualizované

Filip Papraneczakladateľ Digitaliko
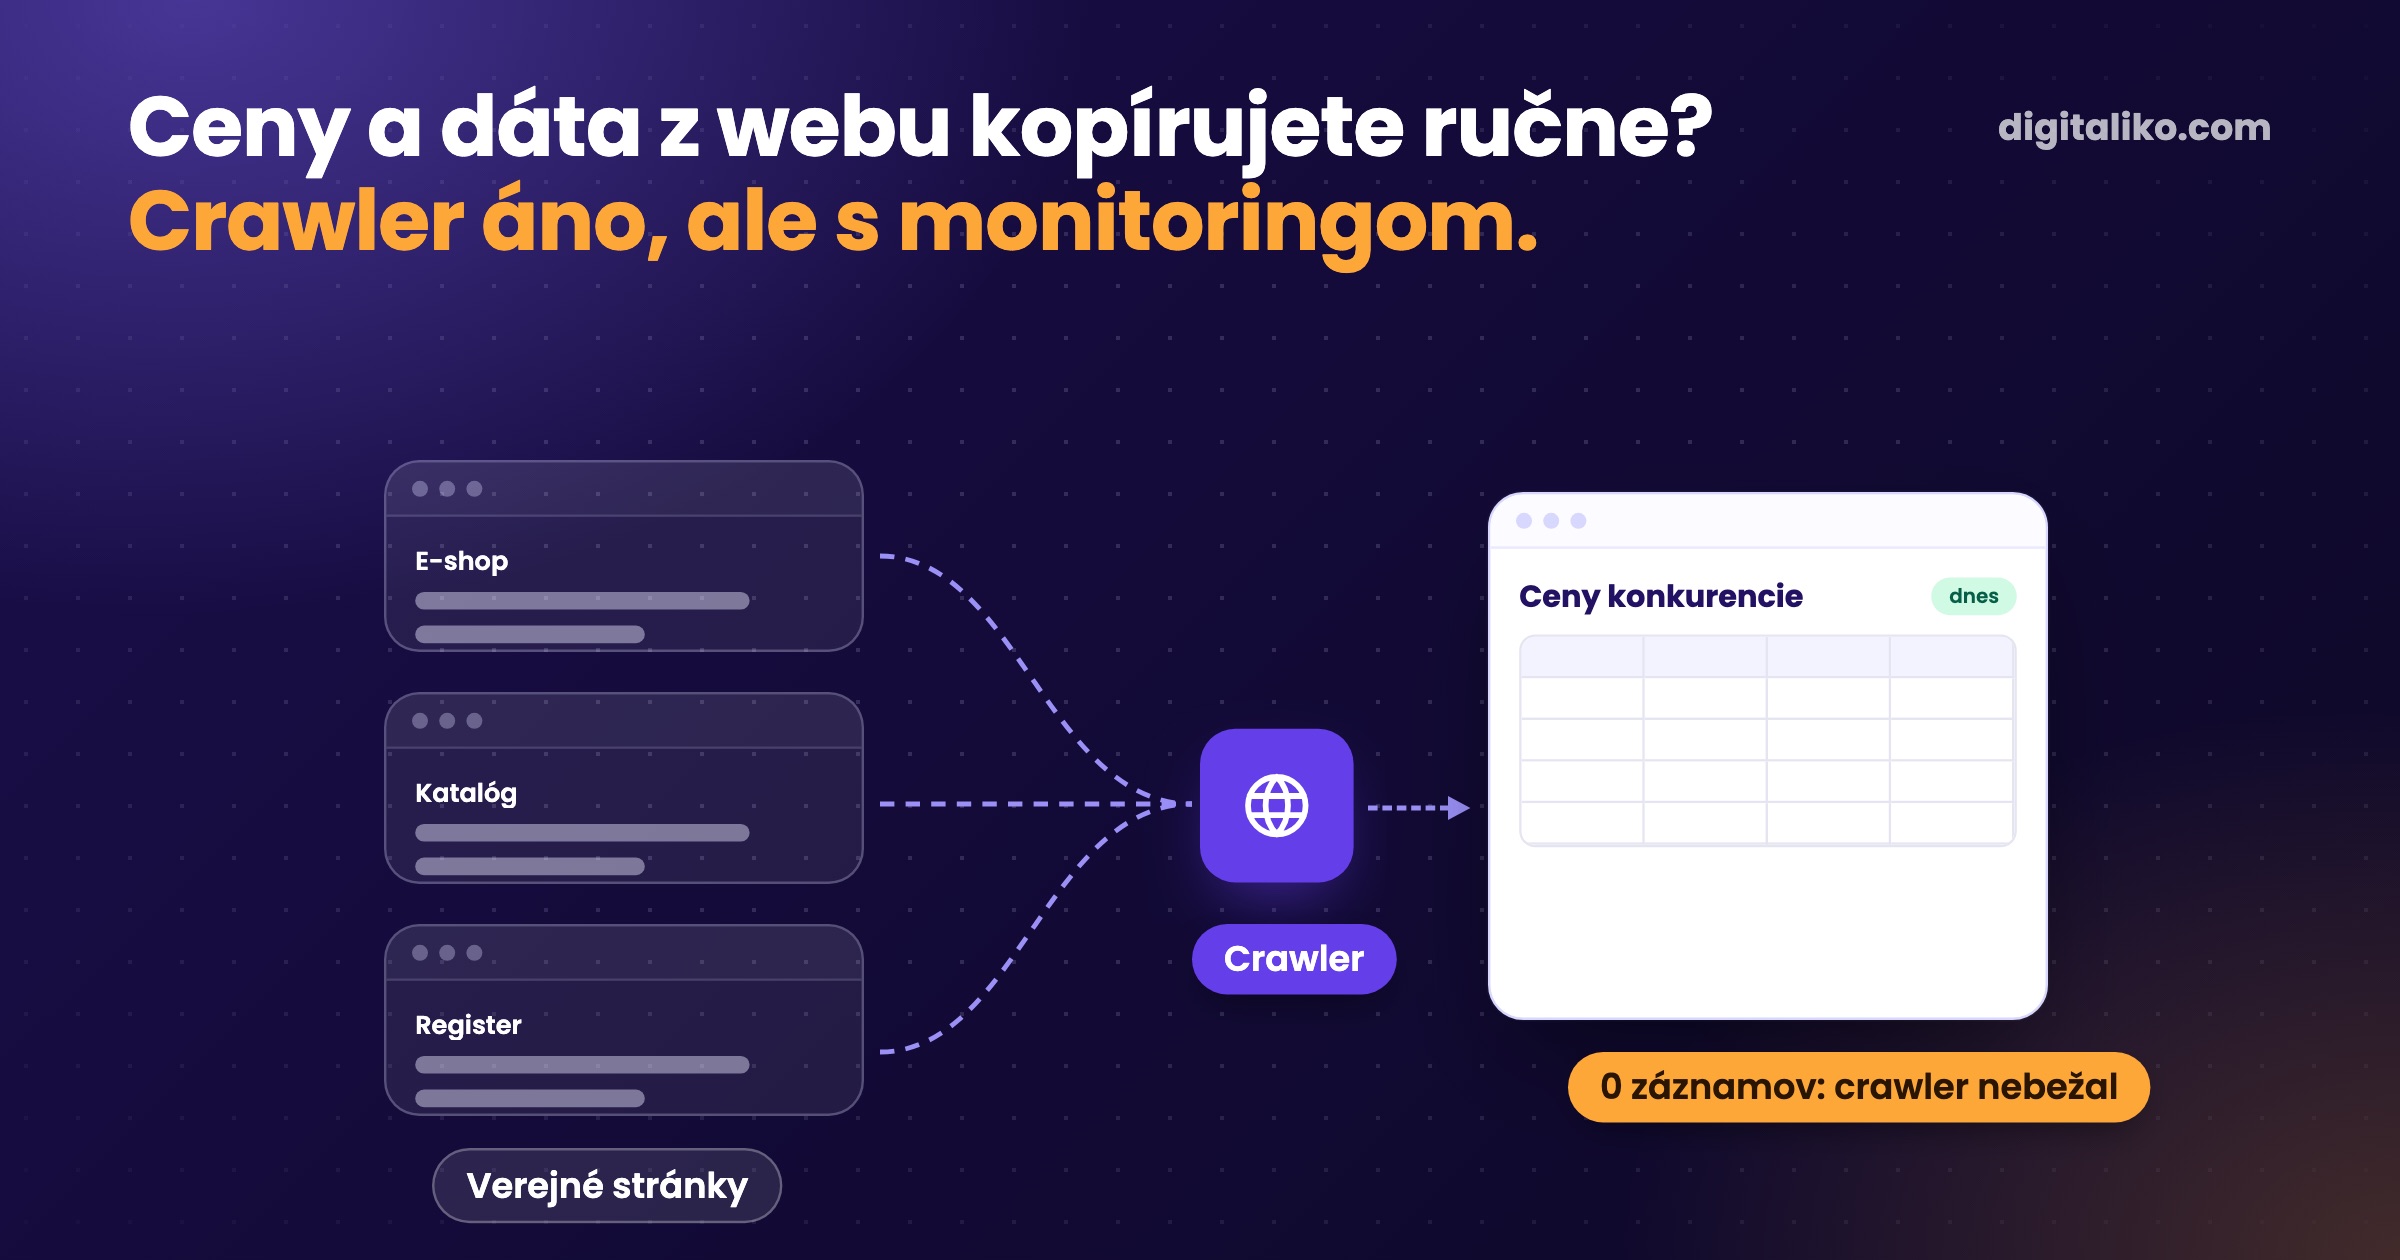
Ceny konkurencie, katalógy dodávateľov alebo údaje z verejných registrov dnes niekto vo firme kopíruje ručne. Crawler sa oplatí, keď tie isté verejné dáta potrebujete pravidelne a ručne to zaberá hodiny. Ak zdroj ponúka export alebo API, použite najprv to. A každý crawler raz prestane fungovať, preto bez monitoringu nevydrží.
Vieme to z vlastnej skúsenosti. Na projekte pre klienta s online marketplace v decembri 2025 prestal bežať crawler. Návštevnosť klesla z 250 000 na 66 000 zobrazení mesačne. Nižšie nájdete, kedy sa crawler oplatí, čo sa na ňom pokazí a ako ho strážiť.
Na čo firmy crawler používajú?
Web scraping znamená, že program prechádza webové stránky a ukladá z nich údaje do tabuľky alebo systému. Vo firmách sa s ním stretávame pri troch úlohách:
| Úloha | Čo sa zbiera | Ako často | Na čo si dať pozor |
|---|---|---|---|
| Sledovanie cien konkurencie | Cena, dostupnosť, akcie | Denne alebo týždenne | Ceny bez DPH a s DPH, varianty produktu |
| Produktové dáta a katalógy | Názvy, parametre, obrázky od dodávateľov | Pri zmene sortimentu | Práva na texty a obrázky, nie každý ich smie prebrať |
| Verejné registre | Firmy, adresy, stavy konaní | Pri každom novom kontakte | Mnohé registre majú API alebo otvorené dáta |
Najčastejšie sa začína tabuľkou. Niekto raz týždenne otvorí e-shopy konkurencie, prepíše ceny do Excelu a pošle ich obchodu. Ako spoznať, že tabuľka už nestačí, píšeme v článku Kedy Excel prestáva stačiť firme.
Kedy sa crawler oplatí?
Skôr ako crawler postavíte, zaškrtnite, čo o vás platí:
Ak máte všade áno, crawler dáva zmysel. Ak nie, zvoľte jednoduchšiu cestu.
Posledný bod nepodceňte. Crawler sa neopravuje raz, ale zakaždým, keď sa zdroj zmení.
Robot na ceny cudzieho e-shopu nám zo začiatku často padal. Upravoval som ho znova a znova, kým sme sa dostali do stavu, že funguje.

Crawler, export alebo API?
Dáta z webu dostanete tromi spôsobmi. Crawler je až posledný z nich.
Ručne
- Raz, pár stránok.
- Stabilita závisí od človeka.
- Žiadna údržba, ale stojí čas.
- Na jednorazový zber.
Naše odporúčanie
Export alebo API
- Keď ho zdroj ponúka.
- Stabilné, podmienky máte napísané.
- Malá údržba.
- Vždy prvá voľba.
Crawler
- Pravidelne, veľa stránok, bez API.
- Rozbije ho zmena stránky.
- Stála údržba s monitoringom.
- Až keď prvé dve nestačia.
Zozbierané dáta sú len začiatok. Hodnotu majú, až keď s nimi niečo robí obchod alebo systém, napríklad upozorní na zmenu ceny. Takú automatizáciu staviame v rámci automatizácie procesov vo firme.
Čo sa na crawleri pokazí?
Crawler závisí od stránky, ktorú nevlastníte. Tá sa mení bez toho, aby vám to niekto oznámil. Stránka zmení vzhľad alebo adresy, zablokuje vás, alebo crawler jednoducho prestane bežať:
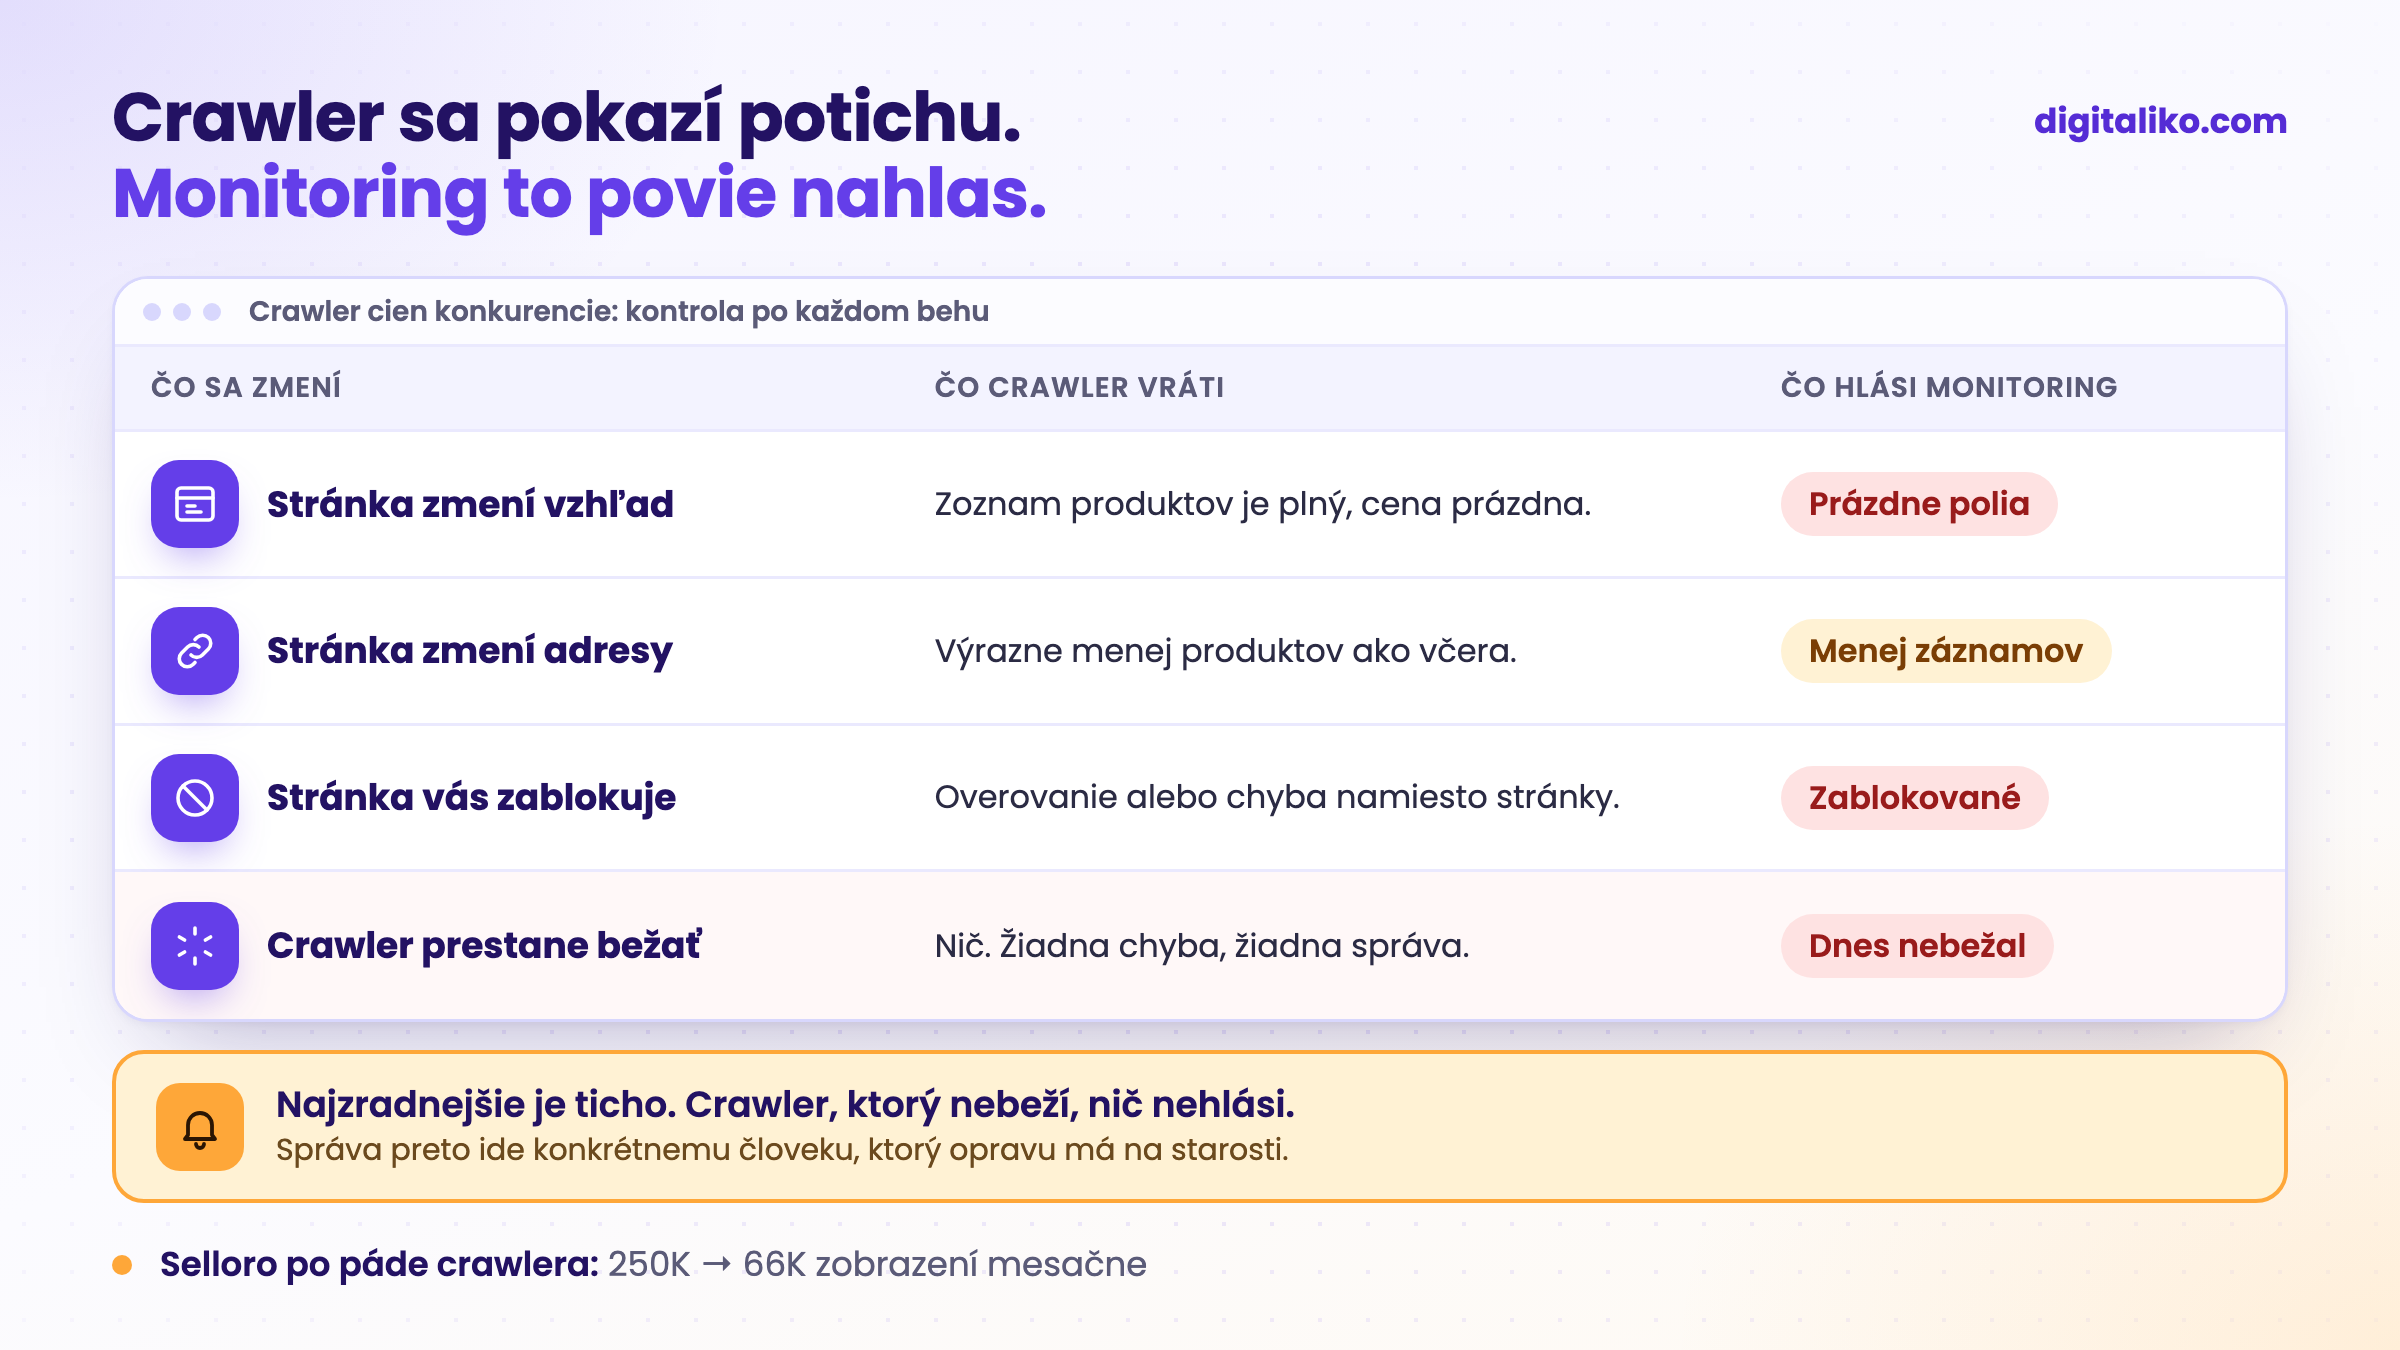
Posledný prípad je najzradnejší, lebo nič nehlási. Presne to sa stalo nám. Na online marketplace jedného klienta v decembri 2025 prestal bežať crawler. Zistili sme to neskoro, až z grafu. Návštevnosť medzitým klesla z 250 000 na 66 000 zobrazení mesačne.
Ako crawler strážiť?
Dnes pri crawleri strážime, či bežal. Ďalšie tri kontroly sme sa naučili na vlastných chybách. Po každom behu crawlera skontrolujte štyri veci:
01
Bežal dnes?
Ak nie, správa ide konkrétnemu človeku, nie do spoločnej schránky.
02
Priniesol dáta?
Nula záznamov alebo výrazne menej ako včera je chyba, nie úspech.
03
Sú polia vyplnené?
Prázdna cena pri plnom zozname znamená, že sa zmenila stránka.
04
Kto opravuje?
Meno, nie „IT“.
Bez mena pri oprave monitoring len pekne hlási problém. Oprava príde, až keď ju má niekto na starosti.
Prečo aj kontrola dát? Iný raz náš crawler niekoľko dní bežal, narazil na limit dĺžky behu a nič neuložil. Každý beh začínal od nuly. Bežal teda, ale dáta nepriniesol. Navyše v repozitári stálo, ako často má bežať, a server ho púšťal inak.
Čo je pri web scrapingu legálne?
Verejne dostupné neznamená voľne použiteľné. Držíme sa týchto pravidiel:
- Len verejné dáta. Nič za prihlásením a nič, čo stránka skrýva.
- Podmienky a robots.txt. Ak stránka zber zakazuje, nezbierame.
- Ohľaduplná rýchlosť. Žiadne tisíce požiadaviek za minútu. Server patrí niekomu inému.
- Osobné údaje. Mená, e-maily a telefóny podliehajú GDPR aj vtedy, keď sú verejné.
- Texty a obrázky. Môžu byť chránené autorským právom. Cena je údaj, popis produktu je cudzí text.
Náš crawler pre tohto klienta sa stránkam predstavuje vlastným menom a odkazom na stránku, ktorá vysvetľuje, kto zbiera a prečo. Jeden zdroj sme vypli, lebo jeho podmienky automatizáciu zakazujú.
Kedy to neodporúčame
Automatizovať neznamená robiť všetko rýchlejšie. Niekedy je lepšie nájsť časť, ktorú môžete vynechať.
- Dáta potrebujete raz. Prepíšte ich ručne alebo si objednajte jednorazový zber. Investícia do crawlera sa nevráti.
- Zdroj ponúka export, otvorené dáta alebo API. Použite ich. Crawler by bol drahšia a krehkejšia cesta.
- Dáta sú za prihlásením alebo podmienky zber zakazujú. Nestavajte ho. Dohodnite sa so zdrojom na prístupe.
- Nikto nebude výsledok používať ani crawler opravovať. Tabuľka, ktorú nikto neotvorí, nič neušetrí.
Ak chcete automatizovať prácu, kde treba čítať voľný text, nie stránky, pozrite si článok Čo je AI agent?.
Kopírujete dáta z webu ručne?
Napíšte nám, aké dáta, odkiaľ a ako často zbierate. Ozveme sa do dvoch pracovných dní a spolu vyberieme, čo vyriešime ako prvé. Povieme vám aj to, ak stačí export alebo API.
Ak sa chcete najprv porozprávať, dohodnite si meeting na 15 minút s Filipom.
Ktoré dáta u vás niekto každý týždeň prepisuje z cudzej stránky?
V skratke
- Crawler sa oplatí, keď tie isté verejné dáta potrebujete pravidelne a ručne to zaberá hodiny.
- Ak zdroj ponúka export alebo API, použite najprv to. Je stabilnejšie a podmienky máte napísané.
- Každý crawler raz prestane fungovať. Po každom behu kontrolujte, či bežal, priniesol dáta a vyplnil polia.
- Opravu má na starosti konkrétny človek, nie „IT“.
Časté otázky
Je web scraping legálny?
Zber verejne dostupných dát je bežný, ale má hranice. Rešpektujte podmienky stránky a robots.txt, nechoďte za prihlásenie, nepreťažujte server a pri osobných údajoch rátajte s GDPR. Pri pochybnostiach sa poraďte s právnikom.
Kedy sa firme oplatí crawler?
Keď tie isté dáta z verejných stránok potrebujete pravidelne a ručne to zaberá hodiny. Ak zdroj ponúka export alebo API, použite najprv to. Na jednorazový zber crawler nestavajte.
Aký je rozdiel medzi crawlerom a scraperom?
Crawler prechádza stránky a hľadá, kde sú dáta. Scraper z konkrétnej stránky vytiahne údaje, napríklad cenu alebo názov produktu. Vo firmách sa slová používajú ako jedno, lebo väčšinou robia oboje naraz.
Ako často treba crawler opravovať?
Vždy, keď zdrojová stránka zmení vzhľad, adresy alebo ochranu proti robotom. Kedy to bude, neviete dopredu. Preto má crawler hlásiť, keď prinesie nula záznamov alebo prázdne polia, a niekto musí mať opravu na starosti.
Čo ak stránka ponúka API?
Použite API. Je stabilnejšie, nerozbije ho zmena dizajnu a podmienky použitia máte napísané. Crawler má zmysel tam, kde API nie je alebo neobsahuje to, čo potrebujete.
Opýtajte sa AI na tento článok
AI pri odpovedi využije aj naše ďalšie články a skúsenosti z reálnych projektov.
ChatGPTClaudePerplexity