Web scraping pro firmy: kdy se crawler vyplatí
Automatizace procesů · Aktualizováno

Filip Papraneczakladatel Digitaliko
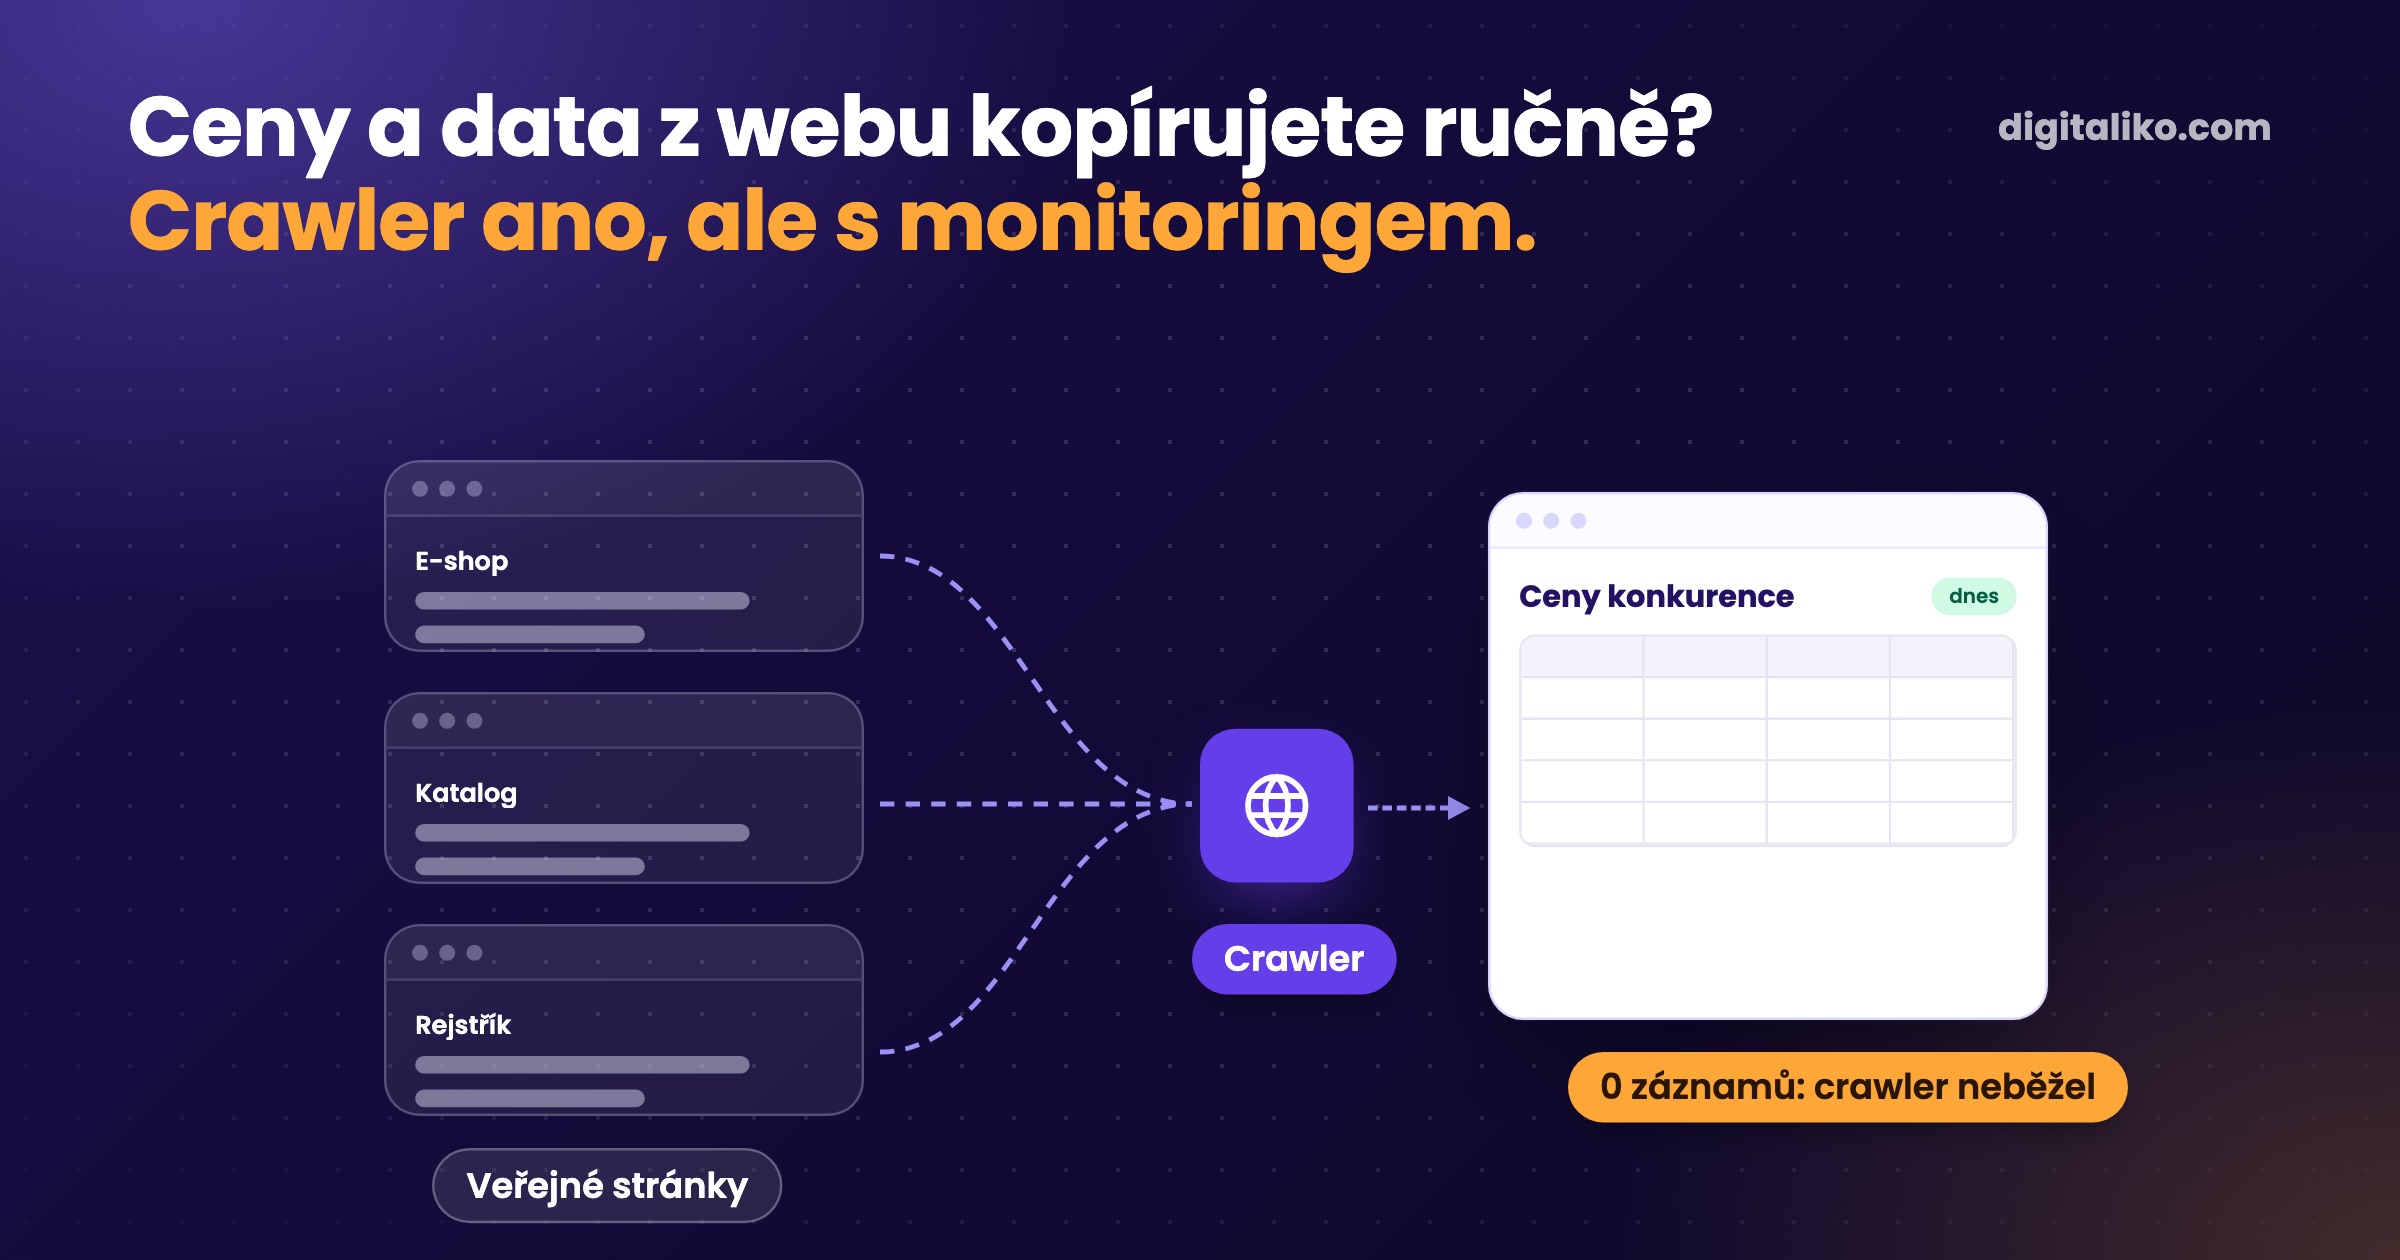
Ceny konkurence, katalogy dodavatelů nebo údaje z veřejných rejstříků dnes někdo ve firmě kopíruje ručně. Crawler se vyplatí, když stejná veřejná data potřebujete pravidelně a ručně to zabírá hodiny. Pokud zdroj nabízí export nebo API, použijte nejdřív to. A každý crawler jednou přestane fungovat, proto bez monitoringu nevydrží.
Víme to z vlastní zkušenosti. Na projektu pro klienta s online marketplace v prosinci 2025 přestal běžet crawler. Návštěvnost klesla z 250 000 na 66 000 zobrazení měsíčně. Níže je, kdy se crawler vyplatí, co se na něm rozbije a jak ho hlídat.
Na co firmy crawler používají?
Web scraping znamená, že program prochází webové stránky a ukládá z nich údaje do tabulky nebo systému. Ve firmách se s ním potkáváme u tří úloh:
| Úloha | Co se sbírá | Jak často | Na co si dát pozor |
|---|---|---|---|
| Sledování cen konkurence | Cena, dostupnost, akce | Denně nebo týdně | Ceny bez DPH a s DPH, varianty produktu |
| Produktová data a katalogy | Názvy, parametry, obrázky od dodavatelů | Při změně sortimentu | Práva na texty a obrázky, ne každý je smí převzít |
| Veřejné rejstříky | Firmy, adresy, stavy řízení | U každého nového kontaktu | Mnoho rejstříků má API nebo otevřená data |
Nejčastěji to začíná tabulkou. Někdo jednou týdně otevře e-shopy konkurence, přepíše ceny do Excelu a pošle je obchodu. Jak poznat, že tabulka už nestačí, píšeme v článku Kdy Excel firmě přestává stačit?.
Kdy se crawler vyplatí?
Než crawler postavíte, zaškrtněte, co o vás platí:
Pokud máte všude ano, crawler dává smysl. Pokud ne, zvolte jednodušší cestu.
Poslední bod nepodceňte. Crawler se neopravuje jednou, ale pokaždé, když se zdroj změní.
Robot na ceny cizího e-shopu nám ze začátku často padal. Upravoval jsem ho znovu a znovu, než jsme se dostali do stavu, že funguje.

Crawler, export, nebo API?
Data z webu získáte třemi způsoby. Crawler je až poslední z nich.
Ručně
- Jednou, pár stránek.
- Stabilita závisí na člověku.
- Žádná údržba, ale stojí čas.
- Na jednorázový sběr.
Naše doporučení
Export nebo API
- Když ho zdroj nabízí.
- Stabilní, podmínky máte napsané.
- Malá údržba.
- Vždy první volba.
Crawler
- Pravidelně, hodně stránek, bez API.
- Rozbije ho změna stránky.
- Stálá údržba s monitoringem.
- Až když první dvě nestačí.
Sesbíraná data jsou jen začátek. Hodnotu mají, až když s nimi něco dělá obchod nebo systém, třeba upozorní na změnu ceny. Takovou automatizaci stavíme v rámci automatizace firmy.
Co se na crawleru rozbije?
Crawler závisí na stránce, kterou nevlastníte. Ta se mění, aniž by vám to někdo oznámil. Stránka změní vzhled nebo adresy, zablokuje vás, nebo crawler prostě přestane běžet:
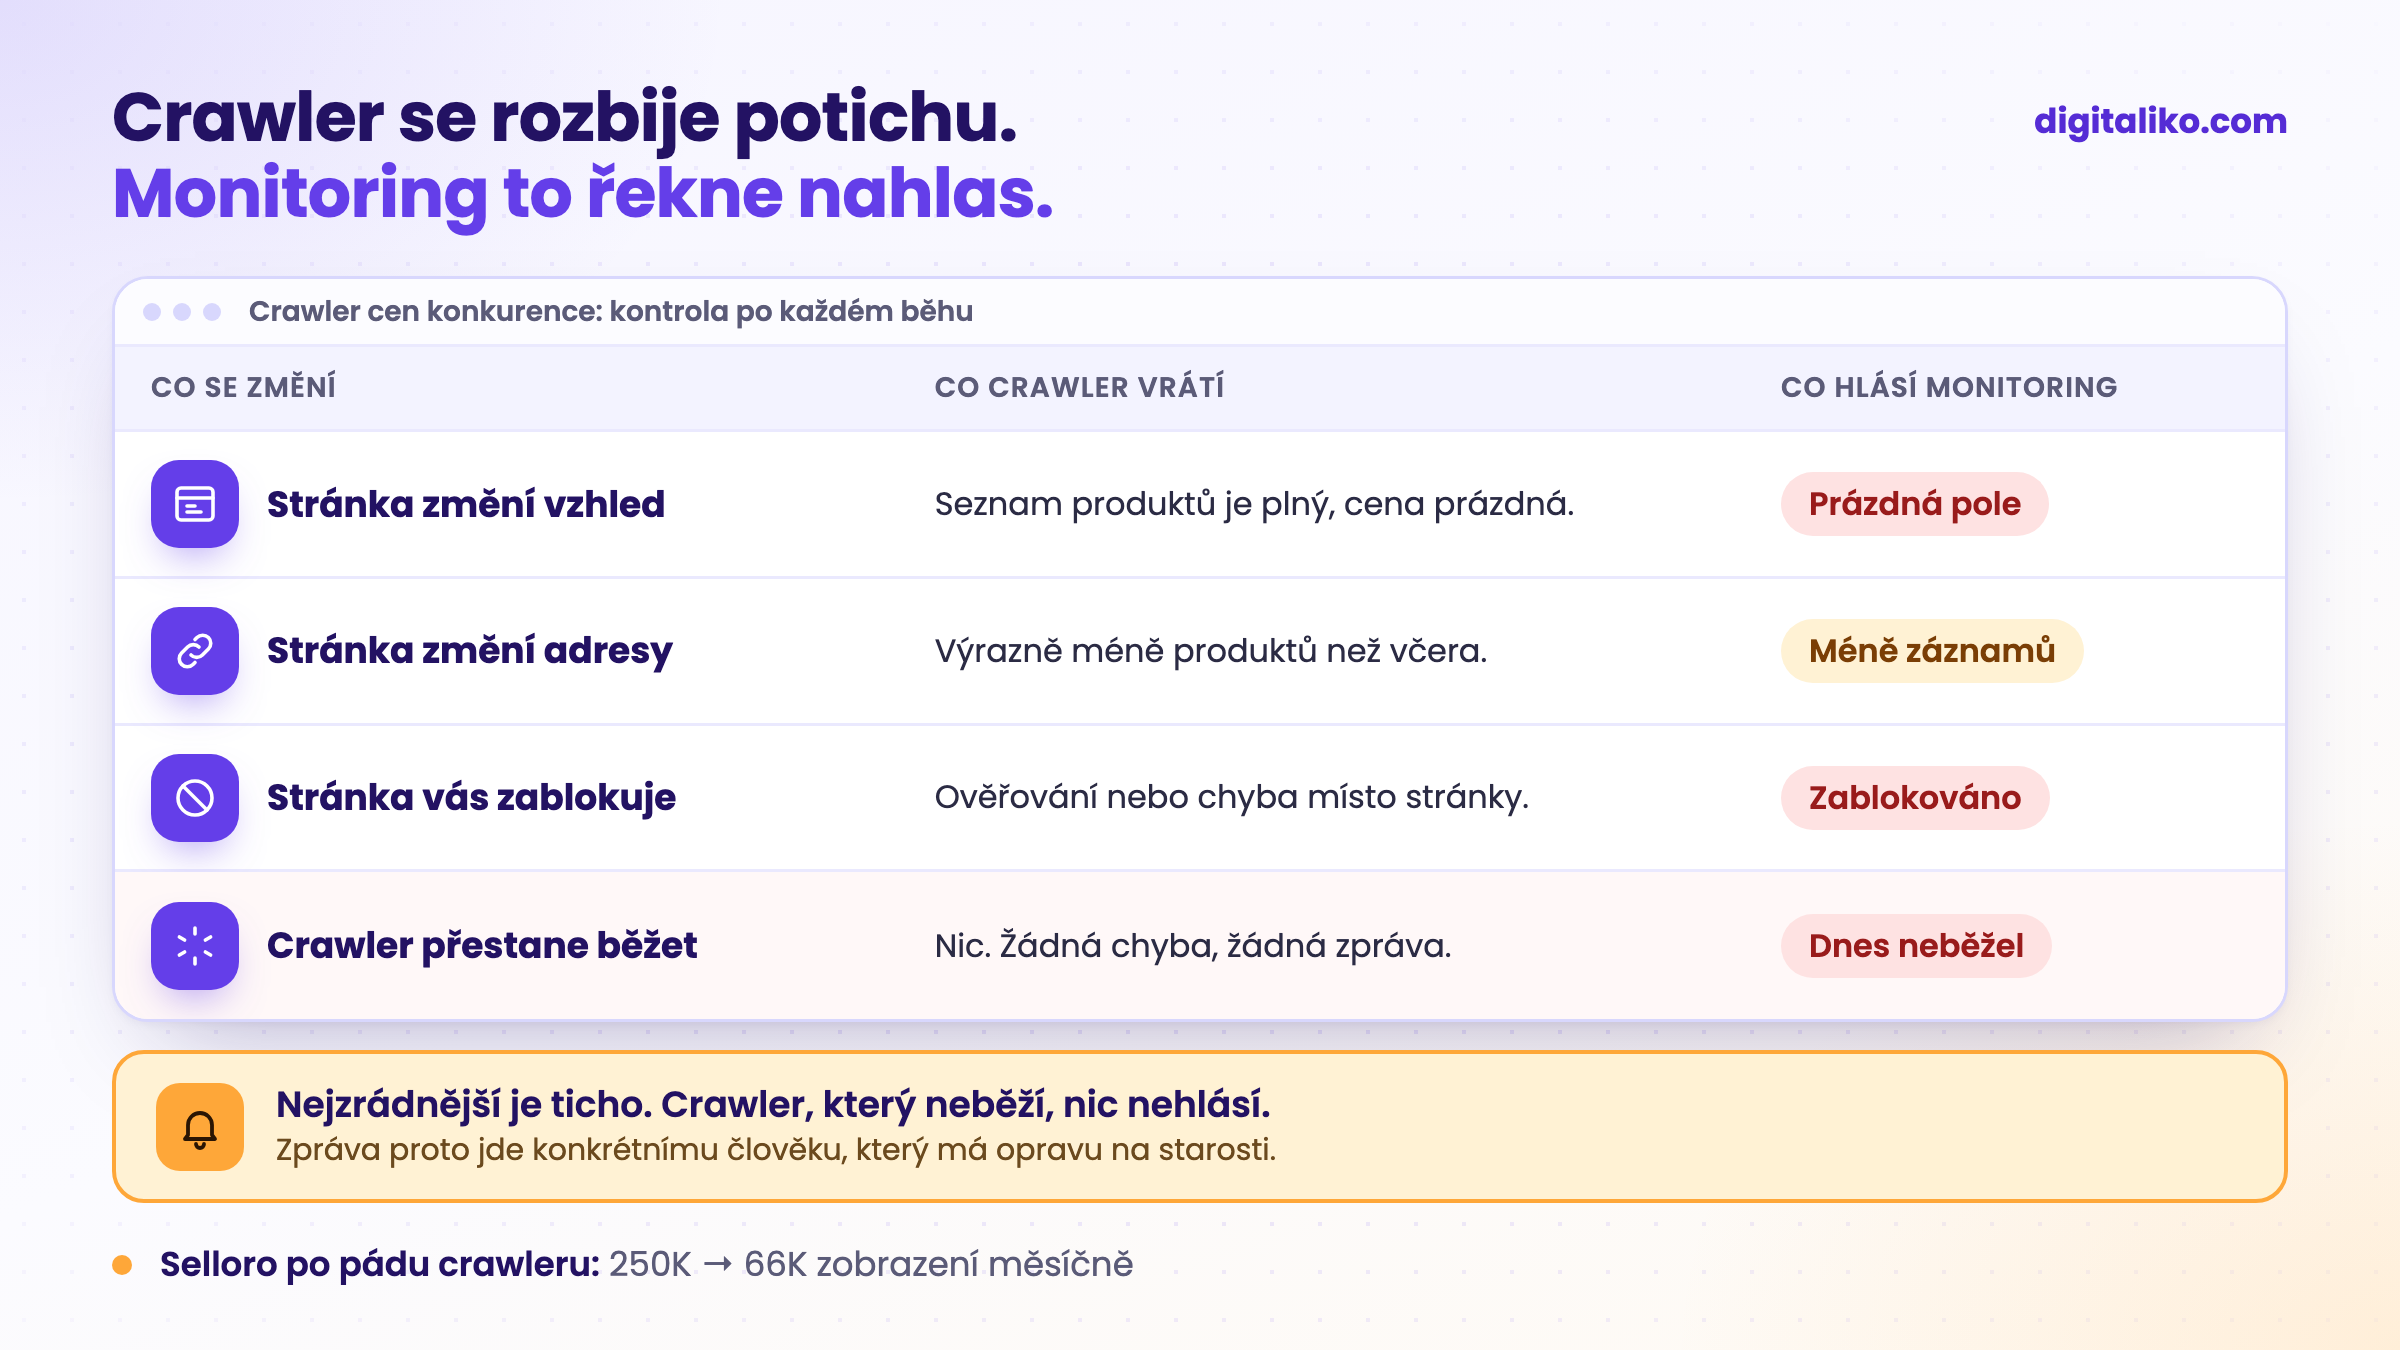
Poslední případ je nejzrádnější, protože nic nehlásí. Přesně to se stalo nám. Na online marketplace jednoho klienta v prosinci 2025 přestal běžet crawler. Zjistili jsme to pozdě, až z grafu. Návštěvnost mezitím klesla z 250 000 na 66 000 zobrazení měsíčně.
Jak crawler hlídat?
Dnes u crawleru hlídáme, jestli běžel. Další tři kontroly jsme se naučili na vlastních chybách. Po každém běhu crawleru zkontrolujte čtyři věci:
01
Běžel dnes?
Pokud ne, zpráva jde konkrétnímu člověku, ne do společné schránky.
02
Přinesl data?
Nula záznamů nebo výrazně méně než včera je chyba, ne úspěch.
03
Jsou pole vyplněná?
Prázdná cena u plného seznamu znamená, že se změnila stránka.
04
Kdo opravuje?
Jméno, ne „IT“.
Bez jména u opravy monitoring jen hezky hlásí problém. Oprava přijde, až když ji má někdo na starosti.
Proč i kontrola dat? Jindy náš crawler několik dní běžel, narazil na limit délky běhu a nic neuložil. Každý běh začínal od nuly. Běžel tedy, ale data nepřinesl. Navíc v repozitáři stálo, jak často má běžet, a server ho spouštěl jinak.
Co je při web scrapingu legální?
Veřejně dostupné neznamená volně použitelné. Držíme se těchto pravidel:
- Jen veřejná data. Nic za přihlášením a nic, co stránka skrývá.
- Podmínky a robots.txt. Pokud stránka sběr zakazuje, nesbíráme.
- Ohleduplná rychlost. Žádné tisíce požadavků za minutu. Server patří někomu jinému.
- Osobní údaje. Jména, e-maily a telefony podléhají GDPR i tehdy, když jsou veřejné.
- Texty a obrázky. Mohou být chráněné autorským právem. Cena je údaj, popis produktu je cizí text.
Náš crawler pro tohoto klienta se stránkám představuje vlastním jménem a odkazem na stránku, která vysvětluje, kdo sbírá a proč. Jeden zdroj jsme vypnuli, protože jeho podmínky automatizaci zakazují.
Kdy to nedoporučujeme
Automatizovat neznamená dělat všechno rychleji. Někdy je lepší najít část, kterou můžete vynechat.
- Data potřebujete jednou. Přepište je ručně nebo si objednejte jednorázový sběr. Crawler se nevrátí.
- Zdroj nabízí export, otevřená data nebo API. Použijte je. Crawler by byl dražší a křehčí cesta.
- Data jsou za přihlášením nebo podmínky sběr zakazují. Nestavějte ho. Domluvte se se zdrojem na přístupu.
- Nikdo nebude výsledek používat ani crawler opravovat. Tabulka, kterou nikdo neotevře, nic neušetří.
Pokud chcete automatizovat práci, kde je potřeba číst volný text, ne stránky, podívejte se na článek Co je AI agent?.
Kopírujete data z webu ručně?
Napište nám, jaká data, odkud a jak často sbíráte. Ozveme se do dvou pracovních dnů a společně vybereme, co vyřešíme jako první. Řekneme vám i to, pokud stačí export nebo API.
Pokud si chcete nejdřív promluvit, domluvte si meeting na 15 minut s Filipem.
Která data u vás někdo každý týden přepisuje z cizí stránky?
Ve zkratce
- Crawler se vyplatí, když stejná veřejná data potřebujete pravidelně a ručně to zabírá hodiny.
- Pokud zdroj nabízí export nebo API, použijte nejdřív to. Je stabilnější a podmínky máte napsané.
- Každý crawler jednou přestane fungovat. Po každém běhu kontrolujte, jestli běžel, přinesl data a vyplnil pole.
- Opravu má na starosti konkrétní člověk, ne „IT“.
Časté otázky
Je web scraping legální?
Sběr veřejně dostupných dat je běžný, ale má hranice. Respektujte podmínky stránky a robots.txt, nechoďte za přihlášení, nepřetěžujte server a u osobních údajů počítejte s GDPR. Při pochybnostech se poraďte s právníkem.
Kdy se firmě vyplatí crawler?
Když stejná data z veřejných stránek potřebujete pravidelně a ručně to zabírá hodiny. Pokud zdroj nabízí export nebo API, použijte nejdřív to. Na jednorázový sběr crawler nestavějte.
Jaký je rozdíl mezi crawlerem a scraperem?
Crawler prochází stránky a hledá, kde jsou data. Scraper z konkrétní stránky vytáhne údaje, třeba cenu nebo název produktu. Ve firmách se slova používají jako jedno, protože většinou dělají obojí najednou.
Jak často je potřeba crawler opravovat?
Vždy, když zdrojová stránka změní vzhled, adresy nebo ochranu proti robotům. Kdy to bude, dopředu nevíte. Proto má crawler hlásit, když přinese nula záznamů nebo prázdná pole, a někdo musí mít opravu na starosti.
Co když stránka nabízí API?
Použijte API. Je stabilnější, nerozbije ho změna designu a podmínky použití máte napsané. Crawler má smysl tam, kde API není nebo neobsahuje to, co potřebujete.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity