Web scraping para empresas: cuándo compensa un crawler

Filip PapranecFundador de Digitaliko
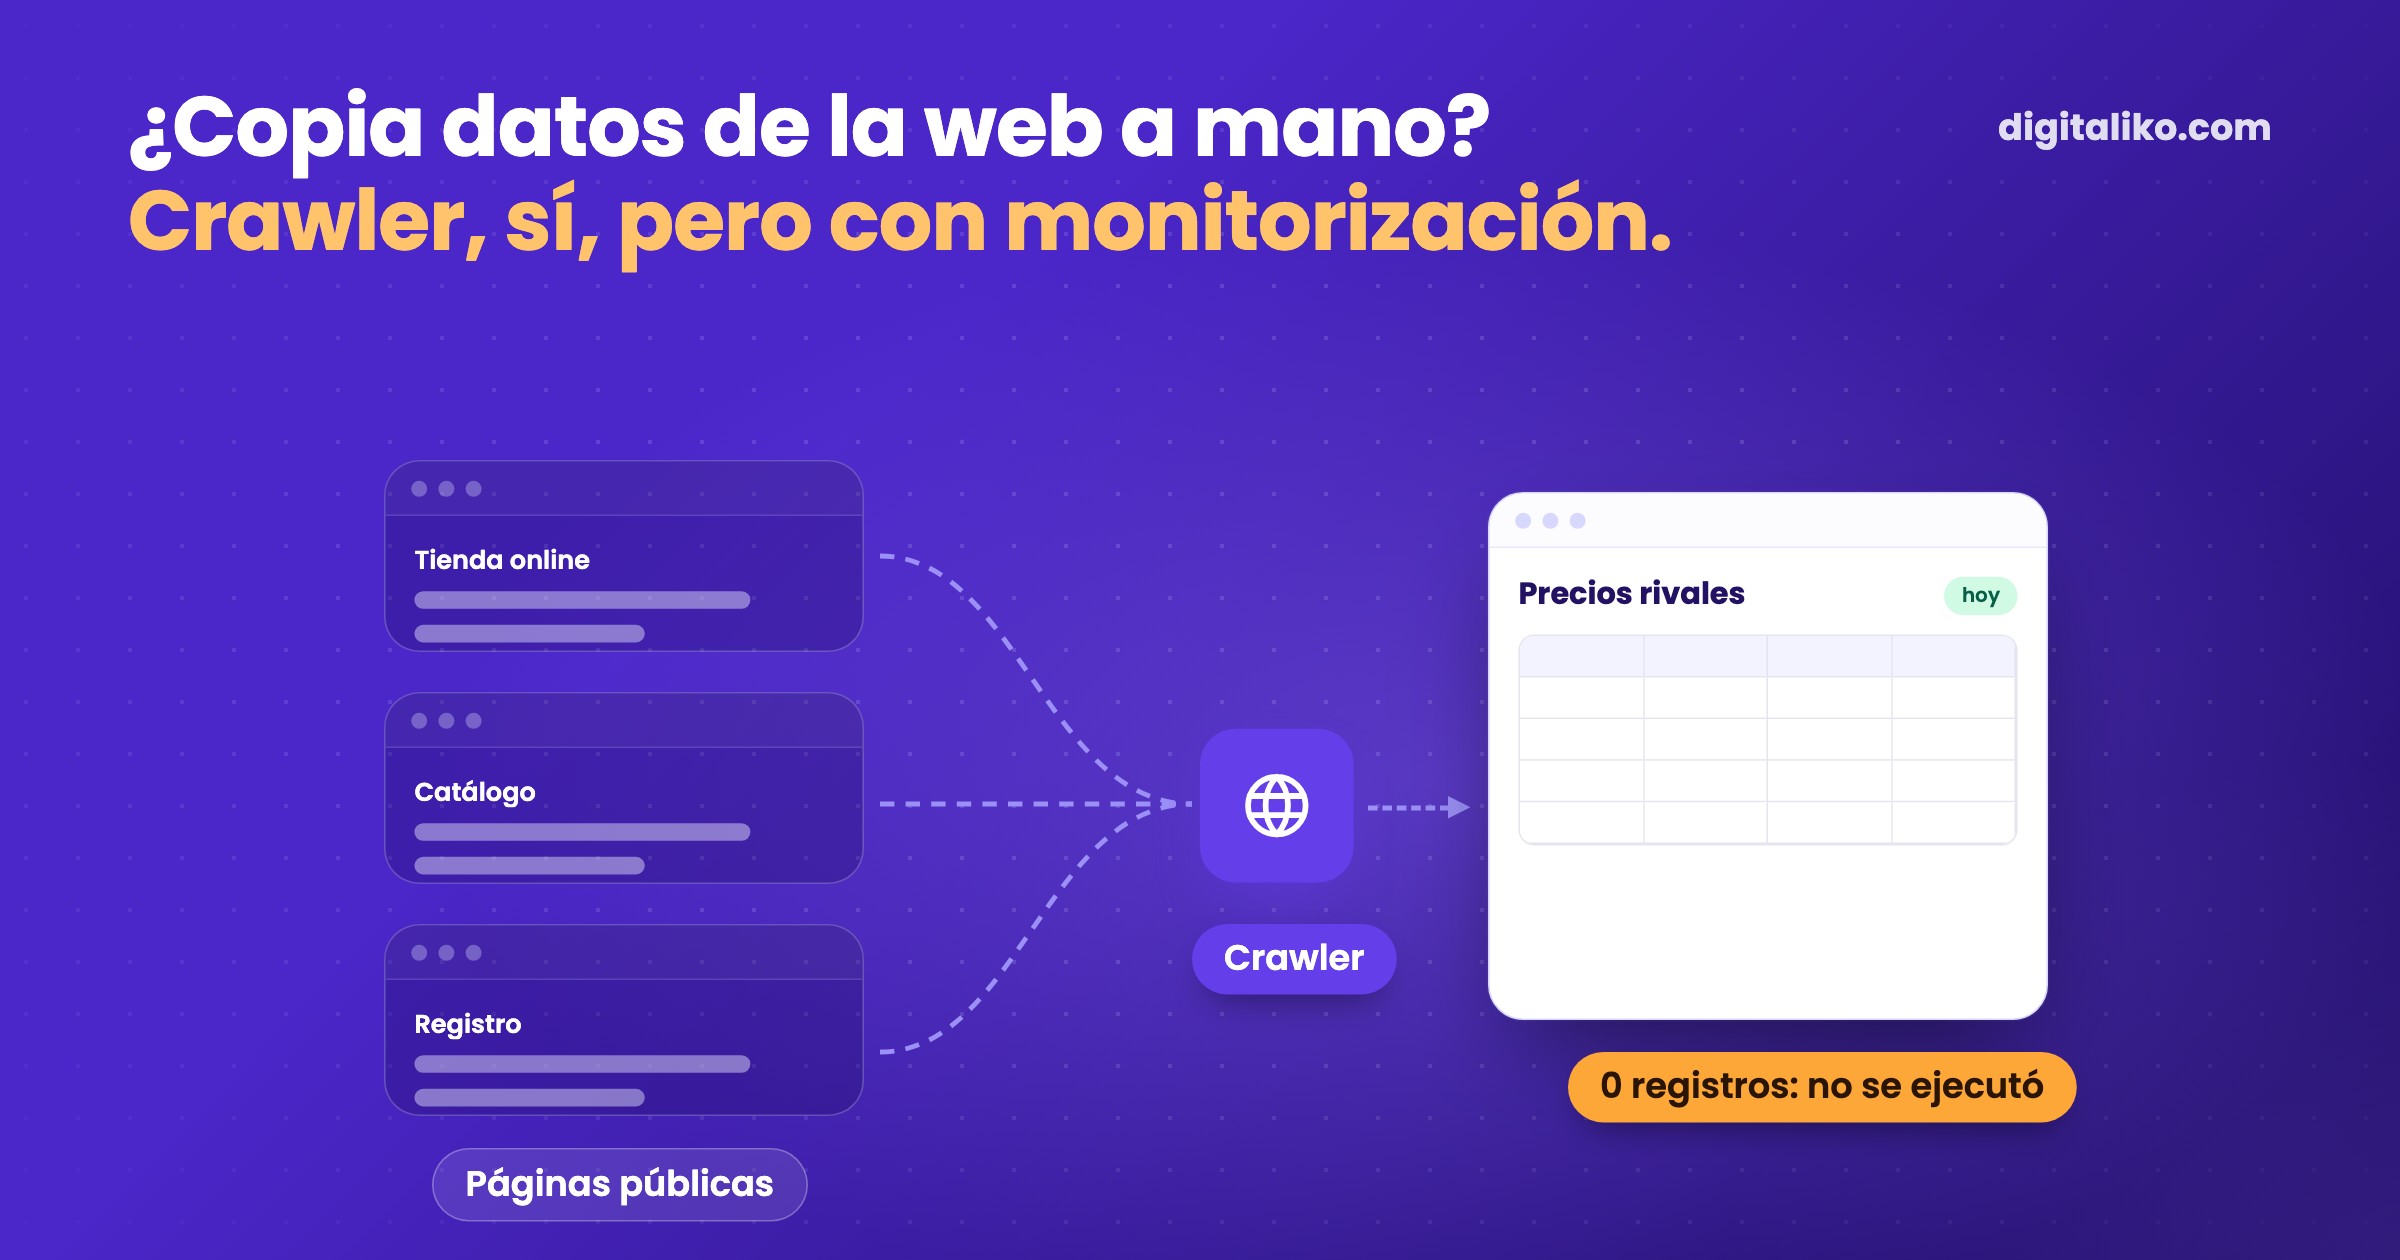
Los precios de la competencia, los catálogos de proveedores o los datos de registros públicos los copia hoy a mano alguien de su empresa. Un crawler compensa cuando necesita los mismos datos públicos con regularidad y hacerlo a mano lleva horas. Si la fuente ofrece una exportación o una API, úsela primero. Y todo crawler deja de funcionar algún día, así que sin monitorización no dura.
A continuación verá cuándo compensa un crawler, qué falla y cómo vigilarlo.
¿Para qué usan las empresas un crawler?
Web scraping significa que un programa recorre páginas web y guarda sus datos en una tabla o un sistema. En las empresas lo vemos en tres tareas:
| Tarea | Qué se recoge | Con qué frecuencia | Cuidado con |
|---|---|---|---|
| Seguimiento de precios de la competencia | Precio, disponibilidad, promociones | Diaria o semanal | Precios con y sin IVA, variantes de producto |
| Datos de producto y catálogos | Nombres, especificaciones, imágenes de proveedores | Cuando cambia la gama | Derechos sobre textos e imágenes, no todo el mundo puede reutilizarlos |
| Registros públicos | Empresas, direcciones, estado de expedientes | Con cada contacto nuevo | Muchos registros tienen API o datos abiertos |
Normalmente empieza con una hoja de cálculo. Una vez por semana alguien abre las tiendas online de la competencia, copia los precios en Excel y se los envía a ventas. Cómo saber que la hoja ya no basta lo explica ¿Cuándo deja de bastarle Excel a una empresa?.
¿Cuándo compensa un crawler?
Antes de construir un crawler, marque lo que se cumple en su caso:
Si todas las respuestas son sí, un crawler tiene sentido. Si no, elija una vía más sencilla.
No subestime el último punto. Un crawler no se arregla una vez, se arregla cada vez que cambia la fuente.
¿Crawler, exportación o API?
Los datos de la web se pueden obtener de tres formas. El crawler es la última.
A mano
- Una vez, pocas páginas.
- La estabilidad depende de la persona.
- Sin mantenimiento, pero cuesta tiempo.
- Para una recogida puntual.
Nuestra recomendación
Exportación o API
- Cuando la fuente la ofrece.
- Estable, las condiciones están por escrito.
- Poco mantenimiento.
- Siempre la primera opción.
Crawler
- Con regularidad, muchas páginas, sin API.
- Un cambio en la web lo rompe.
- Mantenimiento continuo con monitorización.
- Solo cuando las dos primeras no bastan.
Los datos recogidos son solo el comienzo. Valen algo cuando ventas o un sistema actúan sobre ellos, por ejemplo marcando un cambio de precio. Si necesita con regularidad datos que la fuente le permite recoger, le construimos la recogida con una monitorización que le avisa cuando deja de funcionar. Lo hacemos como parte de la automatización de procesos empresariales.
¿Qué falla en un crawler?
Un crawler depende de una web que no es suya. Cambia sin que nadie le avise. La web cambia su diseño o sus URLs, le bloquea, o el crawler simplemente deja de ejecutarse:
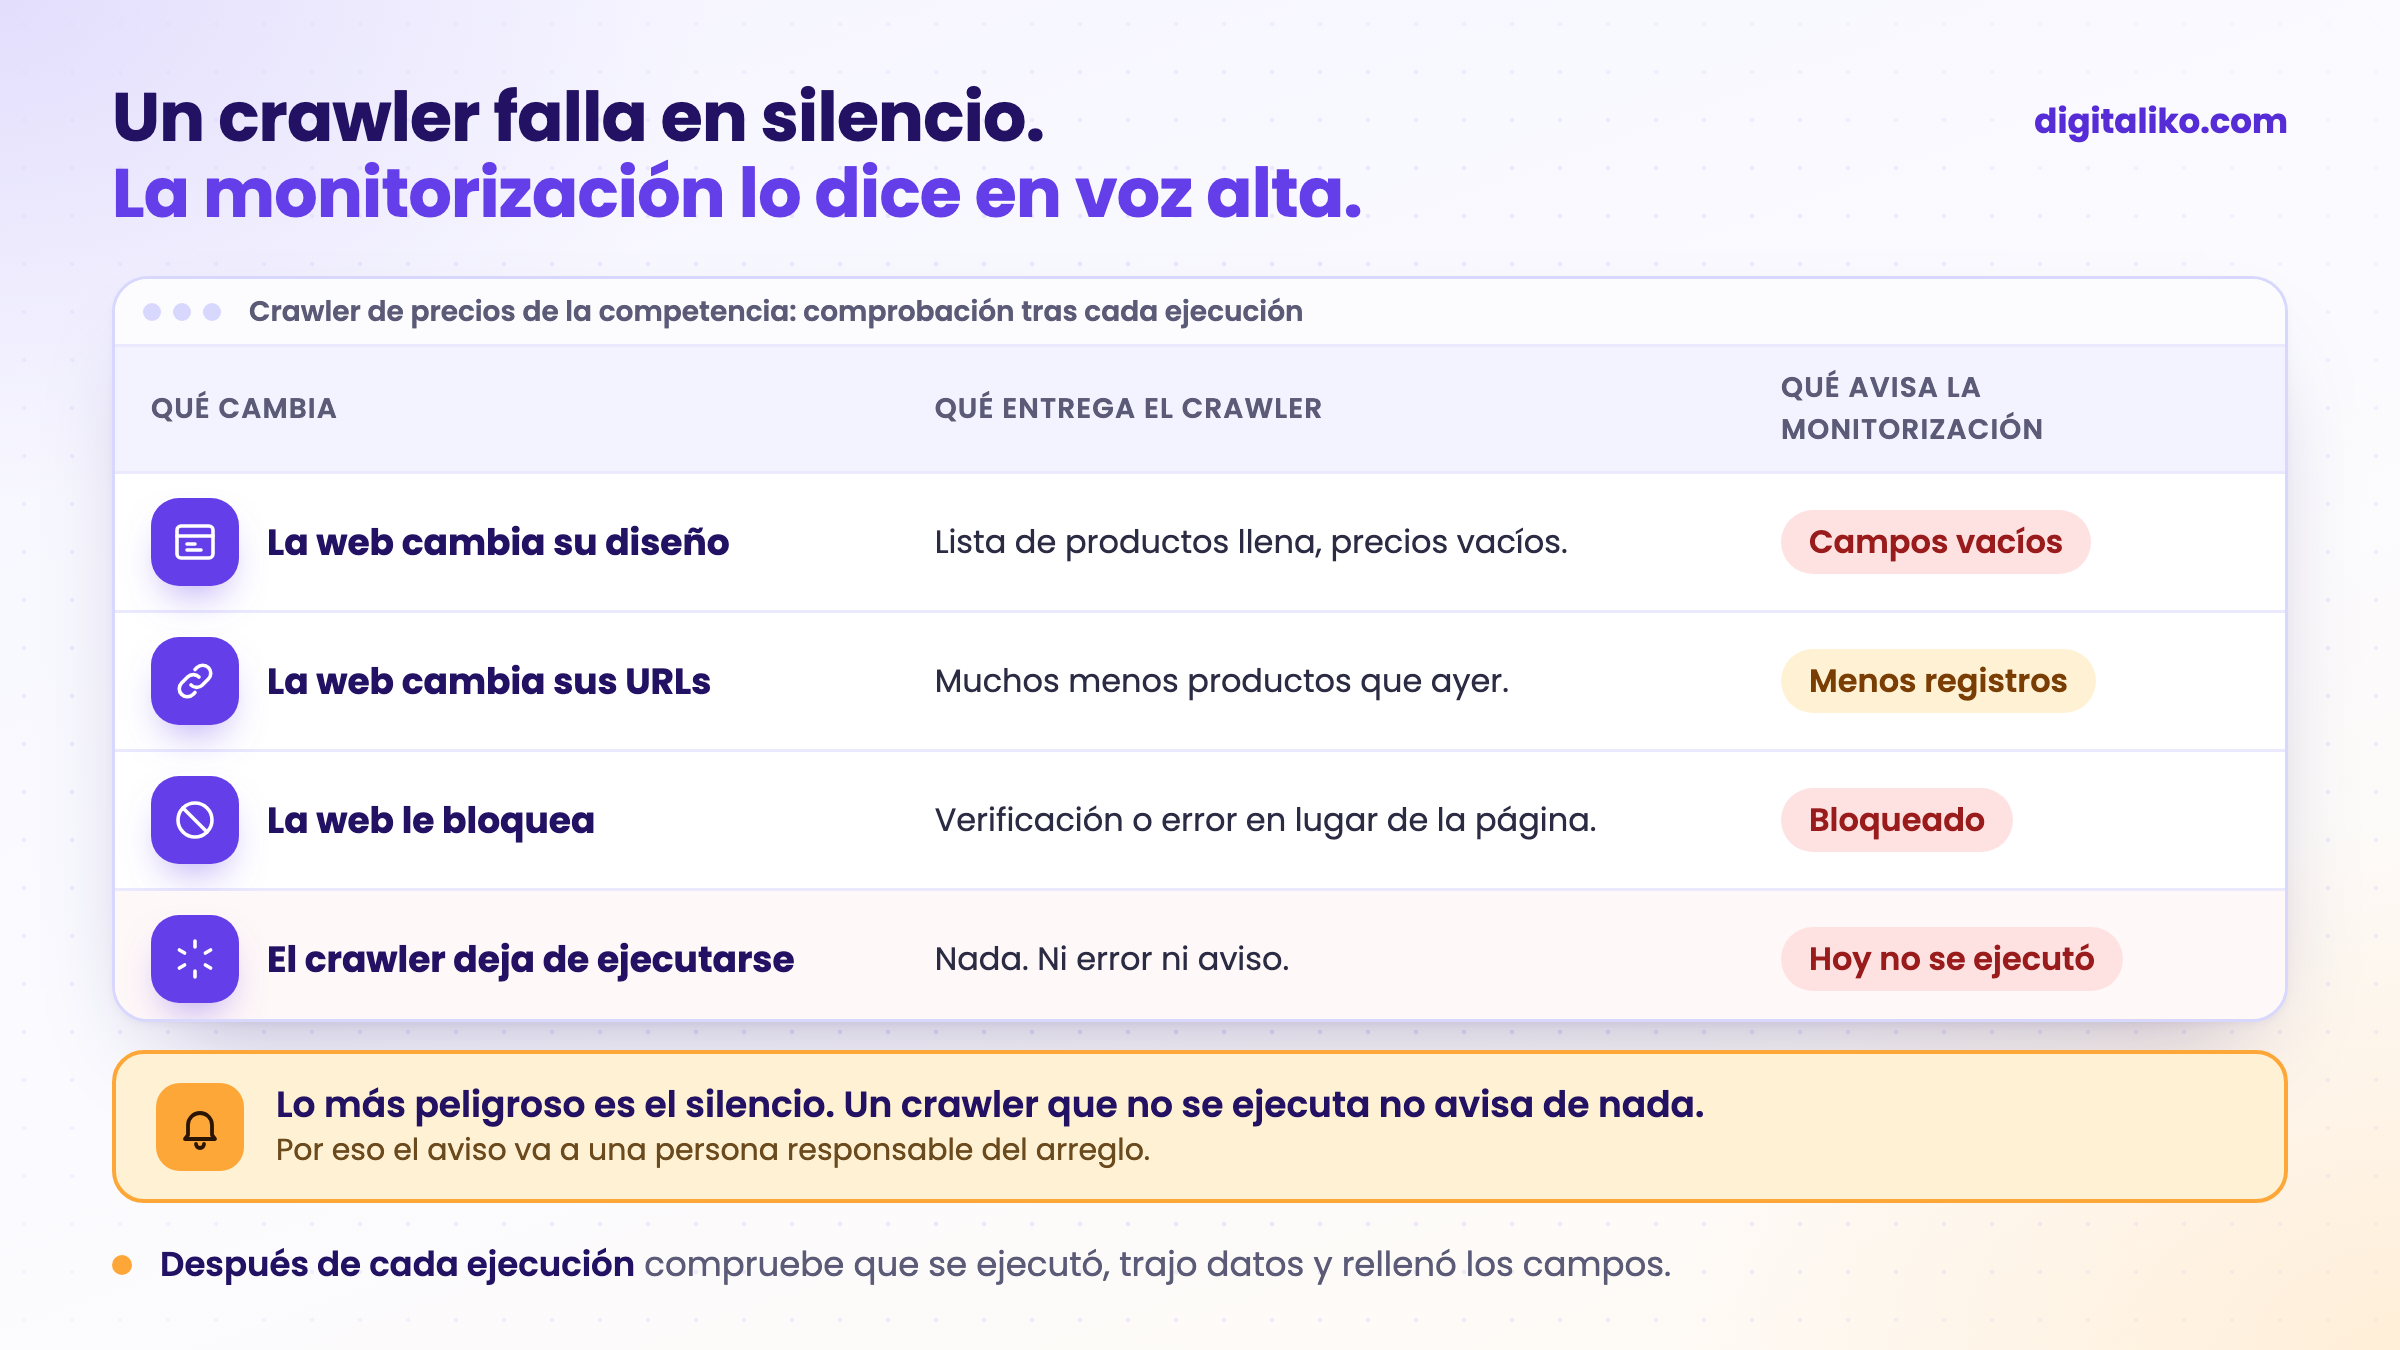
El último caso es el más traicionero, porque nada lo notifica. Los datos dejan de llegar en silencio, y a menudo la gente se entera semanas después, por un gráfico.
¿Cómo se monitoriza un crawler?
Después de cada ejecución del crawler, compruebe cuatro cosas:
01
¿Se ejecutó hoy?
Si no, la alerta va a una persona concreta, no a un buzón compartido.
02
¿Trajo datos?
Cero registros, o muchos menos que ayer, es un fallo, no un éxito.
03
¿Están rellenos los campos?
Un precio vacío en una lista llena significa que la web ha cambiado.
04
¿Quién lo arregla?
Un nombre, no "informática".
Sin un nombre junto al arreglo, la monitorización solo informa bonito del problema. El arreglo llega cuando alguien se responsabiliza de él.
¿Por qué comprobar también los datos? Un crawler puede ejecutarse varios días, chocar con un límite de tiempo y no guardar nada. Cada ejecución empieza entonces de cero. Así que funciona, pero no trae datos. Igual de traicionero: el repositorio dice una programación y el servidor ejecuta otra.
¿Qué es legal en el web scraping?
Públicamente disponible no significa libre de usar. Nos atenemos a estas reglas:
- Solo datos públicos. Nada detrás de un login y nada que la web oculte.
- Condiciones y robots.txt. Si la web prohíbe la recogida, no recogemos.
- Un ritmo considerado. Nada de miles de peticiones por minuto. El servidor es de otro.
- Datos personales. Nombres, correos y teléfonos están sujetos al RGPD aunque sean públicos.
- Textos e imágenes. Pueden estar protegidos por derechos de autor. Un precio es un dato, la descripción de un producto es un texto ajeno.
Un crawler educado se presenta a las webs con su propio nombre y un enlace a una página que explica quién recoge los datos y por qué. Si las condiciones de una fuente prohíben la automatización, no recoja datos de ella.
Cuándo no lo recomendamos
Automatizar no significa hacerlo todo más rápido. A veces es mejor encontrar la parte que se puede omitir.
- Necesita los datos una sola vez. Cópielos a mano o encargue una recogida puntual. Un crawler no se amortizará.
- La fuente ofrece una exportación, datos abiertos o una API. Úselos. Un crawler sería la vía más cara y más frágil.
- Los datos están detrás de un login o las condiciones prohíben recogerlos. No lo construya. Acuerde el acceso con la fuente.
- Nadie usará el resultado ni arreglará el crawler. Una hoja que nadie abre no ahorra nada.
Si quiere automatizar un trabajo que consiste en leer texto libre en lugar de páginas, vea ¿Qué es un agente de IA?.
¿Copia datos de la web a mano?
Escríbanos qué datos recoge, de dónde y con qué frecuencia. Le respondemos en un plazo de dos días laborables con algunas preguntas sobre su trabajo. Después acordamos qué hacemos primero. Si basta una exportación o una API, también se lo diremos.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Qué datos copia cada semana alguien de su empresa de otra web?
En resumen
- Un crawler compensa cuando necesita los mismos datos públicos con regularidad y hacerlo a mano lleva horas.
- Si la fuente ofrece una exportación o una API, úsela primero. Es más estable y las condiciones están por escrito.
- Todo crawler deja de funcionar algún día. Después de cada ejecución, compruebe que se ejecutó, trajo datos y rellenó los campos.
- Del arreglo se responsabiliza una persona concreta, no "informática".
Preguntas frecuentes
¿Es legal el web scraping?
Recoger datos públicamente disponibles es habitual, pero tiene límites. Respete las condiciones de la web y el robots.txt, no entre en nada que esté detrás de un login, no sobrecargue el servidor y, con datos personales, cuente con que se aplica el RGPD. En caso de duda, consulte a un abogado.
¿Cuándo compensa un crawler a una empresa?
Cuando necesita los mismos datos de páginas públicas con regularidad y hacerlo a mano lleva horas. Si la fuente ofrece una exportación o una API, úsela primero. No construya un crawler para una recogida puntual.
¿Qué diferencia hay entre un crawler y un scraper?
Un crawler recorre páginas y encuentra dónde están los datos. Un scraper extrae valores concretos de una página, como un precio o el nombre de un producto. En la empresa se usan como una sola cosa, porque la mayoría de herramientas hacen ambas.
¿Cada cuánto hay que arreglar un crawler?
Cada vez que la web de origen cambia su diseño, sus URLs o su protección contra bots. No se puede saber de antemano cuándo. Por eso un crawler debe avisar cuando trae cero registros o campos vacíos, y alguien tiene que responsabilizarse del arreglo.
¿Y si la web ofrece una API?
Use la API. Es más estable, un rediseño no la rompe y las condiciones de uso están por escrito. Un crawler tiene sentido donde no hay API o donde a la API le falta lo que necesita.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

