Web Scraping für Unternehmen: wann sich ein Crawler lohnt
Prozessautomatisierung · Aktualisiert

Filip PapranecGründer von Digitaliko
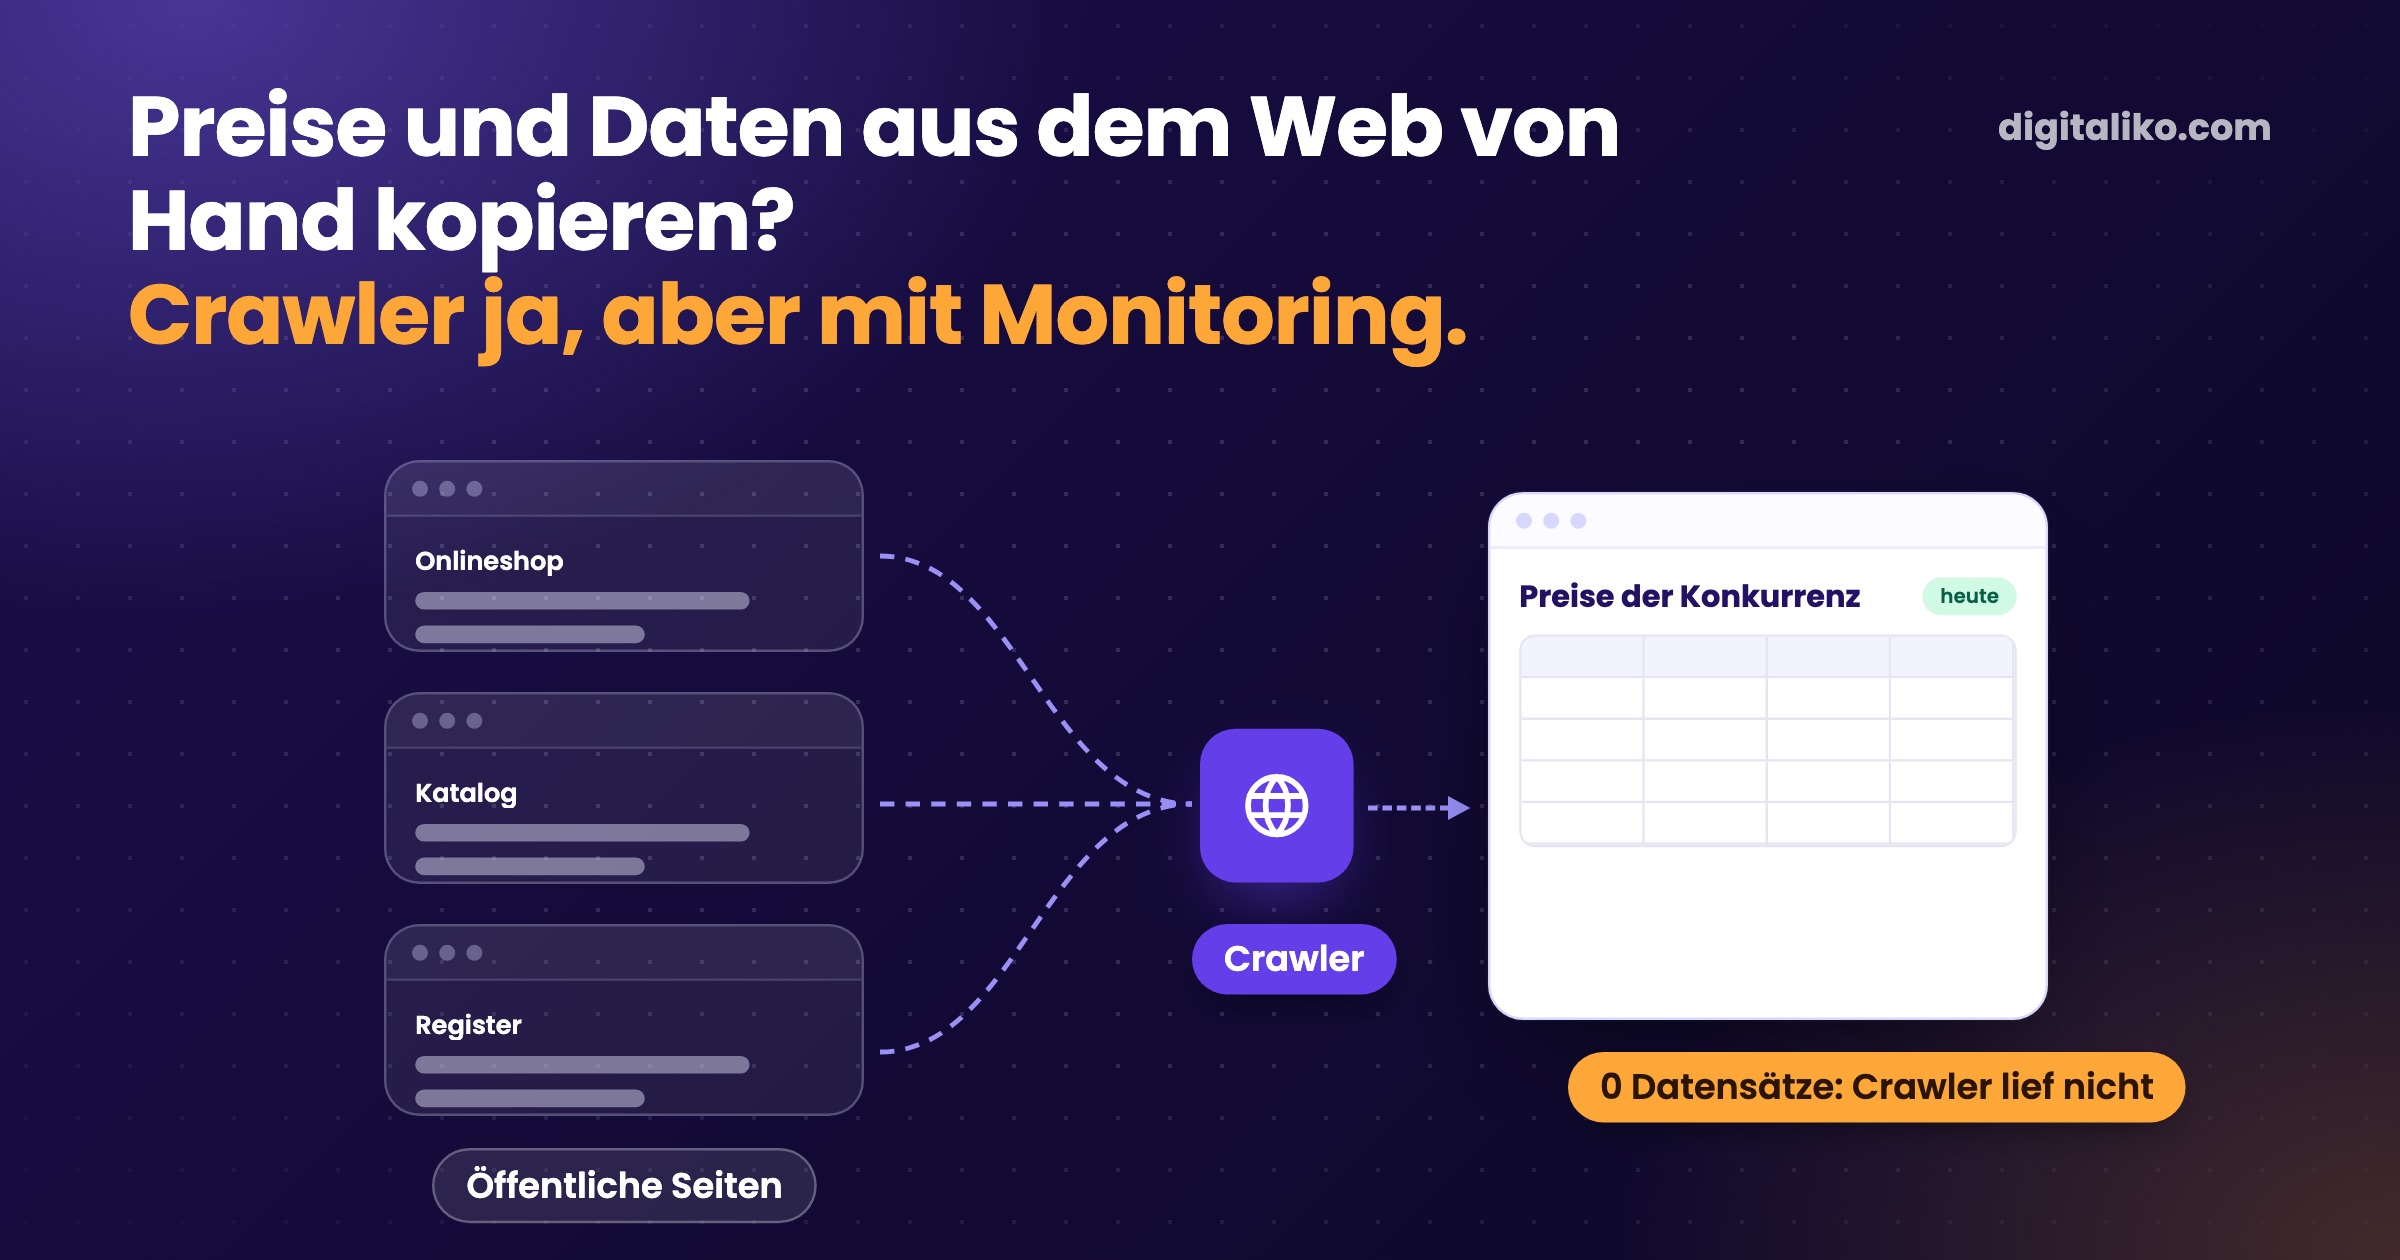
Preise der Konkurrenz, Lieferantenkataloge oder Daten aus öffentlichen Registern kopiert heute jemand in Ihrer Firma von Hand. Ein Crawler lohnt sich, wenn Sie dieselben öffentlichen Daten regelmäßig brauchen und es von Hand Stunden dauert. Bietet die Quelle einen Export oder eine API, nutzen Sie zuerst das. Und jeder Crawler hört eines Tages auf zu funktionieren, deshalb hält er ohne Monitoring nicht.
Wir wissen das aus eigener Erfahrung. Bei einem Projekt für einen Kunden mit einem Online-Marktplatz lief im Dezember 2025 der Crawler nicht mehr. Die Zugriffe fielen von 250.000 auf 66.000 Seitenaufrufe im Monat. Unten steht, wann sich ein Crawler lohnt, was kaputtgeht und wie Sie ihn überwachen.
Wofür nutzen Firmen einen Crawler?
Web Scraping heißt, ein Programm geht durch Webseiten und speichert Daten daraus in eine Tabelle oder ein System. In Firmen sehen wir es bei drei Aufgaben:
| Aufgabe | Was gesammelt wird | Wie oft | Worauf achten |
|---|---|---|---|
| Preisbeobachtung der Konkurrenz | Preis, Verfügbarkeit, Aktionen | Täglich oder wöchentlich | Preise mit und ohne MwSt., Produktvarianten |
| Produktdaten und Kataloge | Namen, Parameter, Bilder von Lieferanten | Bei Sortimentswechsel | Rechte an Texten und Bildern, nicht jeder darf sie übernehmen |
| Öffentliche Register | Firmen, Adressen, Verfahrensstand | Bei jedem neuen Kontakt | Viele Register haben eine API oder offene Daten |
Meist beginnt es mit einer Tabelle. Einmal pro Woche öffnet jemand die Onlineshops der Konkurrenz, überträgt die Preise in Excel und schickt sie an den Vertrieb. Woran Sie erkennen, dass die Tabelle nicht mehr reicht, steht in Wann reicht Excel im Unternehmen nicht mehr?.
Wann lohnt sich ein Crawler?
Bevor Sie einen Crawler bauen, haken Sie ab, was auf Sie zutrifft:
Lautet jede Antwort ja, ist ein Crawler sinnvoll. Wenn nicht, wählen Sie einen einfacheren Weg.
Unterschätzen Sie den letzten Punkt nicht. Einen Crawler repariert man nicht einmal, sondern jedes Mal, wenn sich die Quelle ändert.
Unser Roboter für die Preise eines fremden Onlineshops ist am Anfang oft ausgefallen. Ich habe ihn immer wieder angepasst, bis er funktioniert hat.

Crawler, Export oder API?
Daten aus dem Web bekommen Sie auf drei Wegen. Der Crawler ist der letzte davon.
Von Hand
- Einmal, wenige Seiten.
- Stabilität hängt vom Menschen ab.
- Keine Wartung, kostet aber Zeit.
- Für eine einmalige Sammlung.
Unsere Empfehlung
Export oder API
- Wenn die Quelle ihn anbietet.
- Stabil, die Bedingungen sind schriftlich.
- Geringe Wartung.
- Immer die erste Wahl.
Crawler
- Regelmäßig, viele Seiten, keine API.
- Eine Seitenänderung bricht ihn.
- Laufende Wartung mit Monitoring.
- Erst wenn die ersten beiden nicht reichen.
Gesammelte Daten sind nur der Anfang. Wert haben sie erst, wenn Vertrieb oder System damit etwas tun, etwa bei einer Preisänderung warnen. Solche Automatisierung bauen wir im Rahmen der Prozessautomatisierung.
Was geht an einem Crawler kaputt?
Ein Crawler hängt an einer Seite, die Ihnen nicht gehört. Sie ändert sich, ohne dass es Ihnen jemand sagt. Die Seite ändert Layout oder Adressen, sperrt Sie, oder der Crawler läuft einfach nicht mehr:
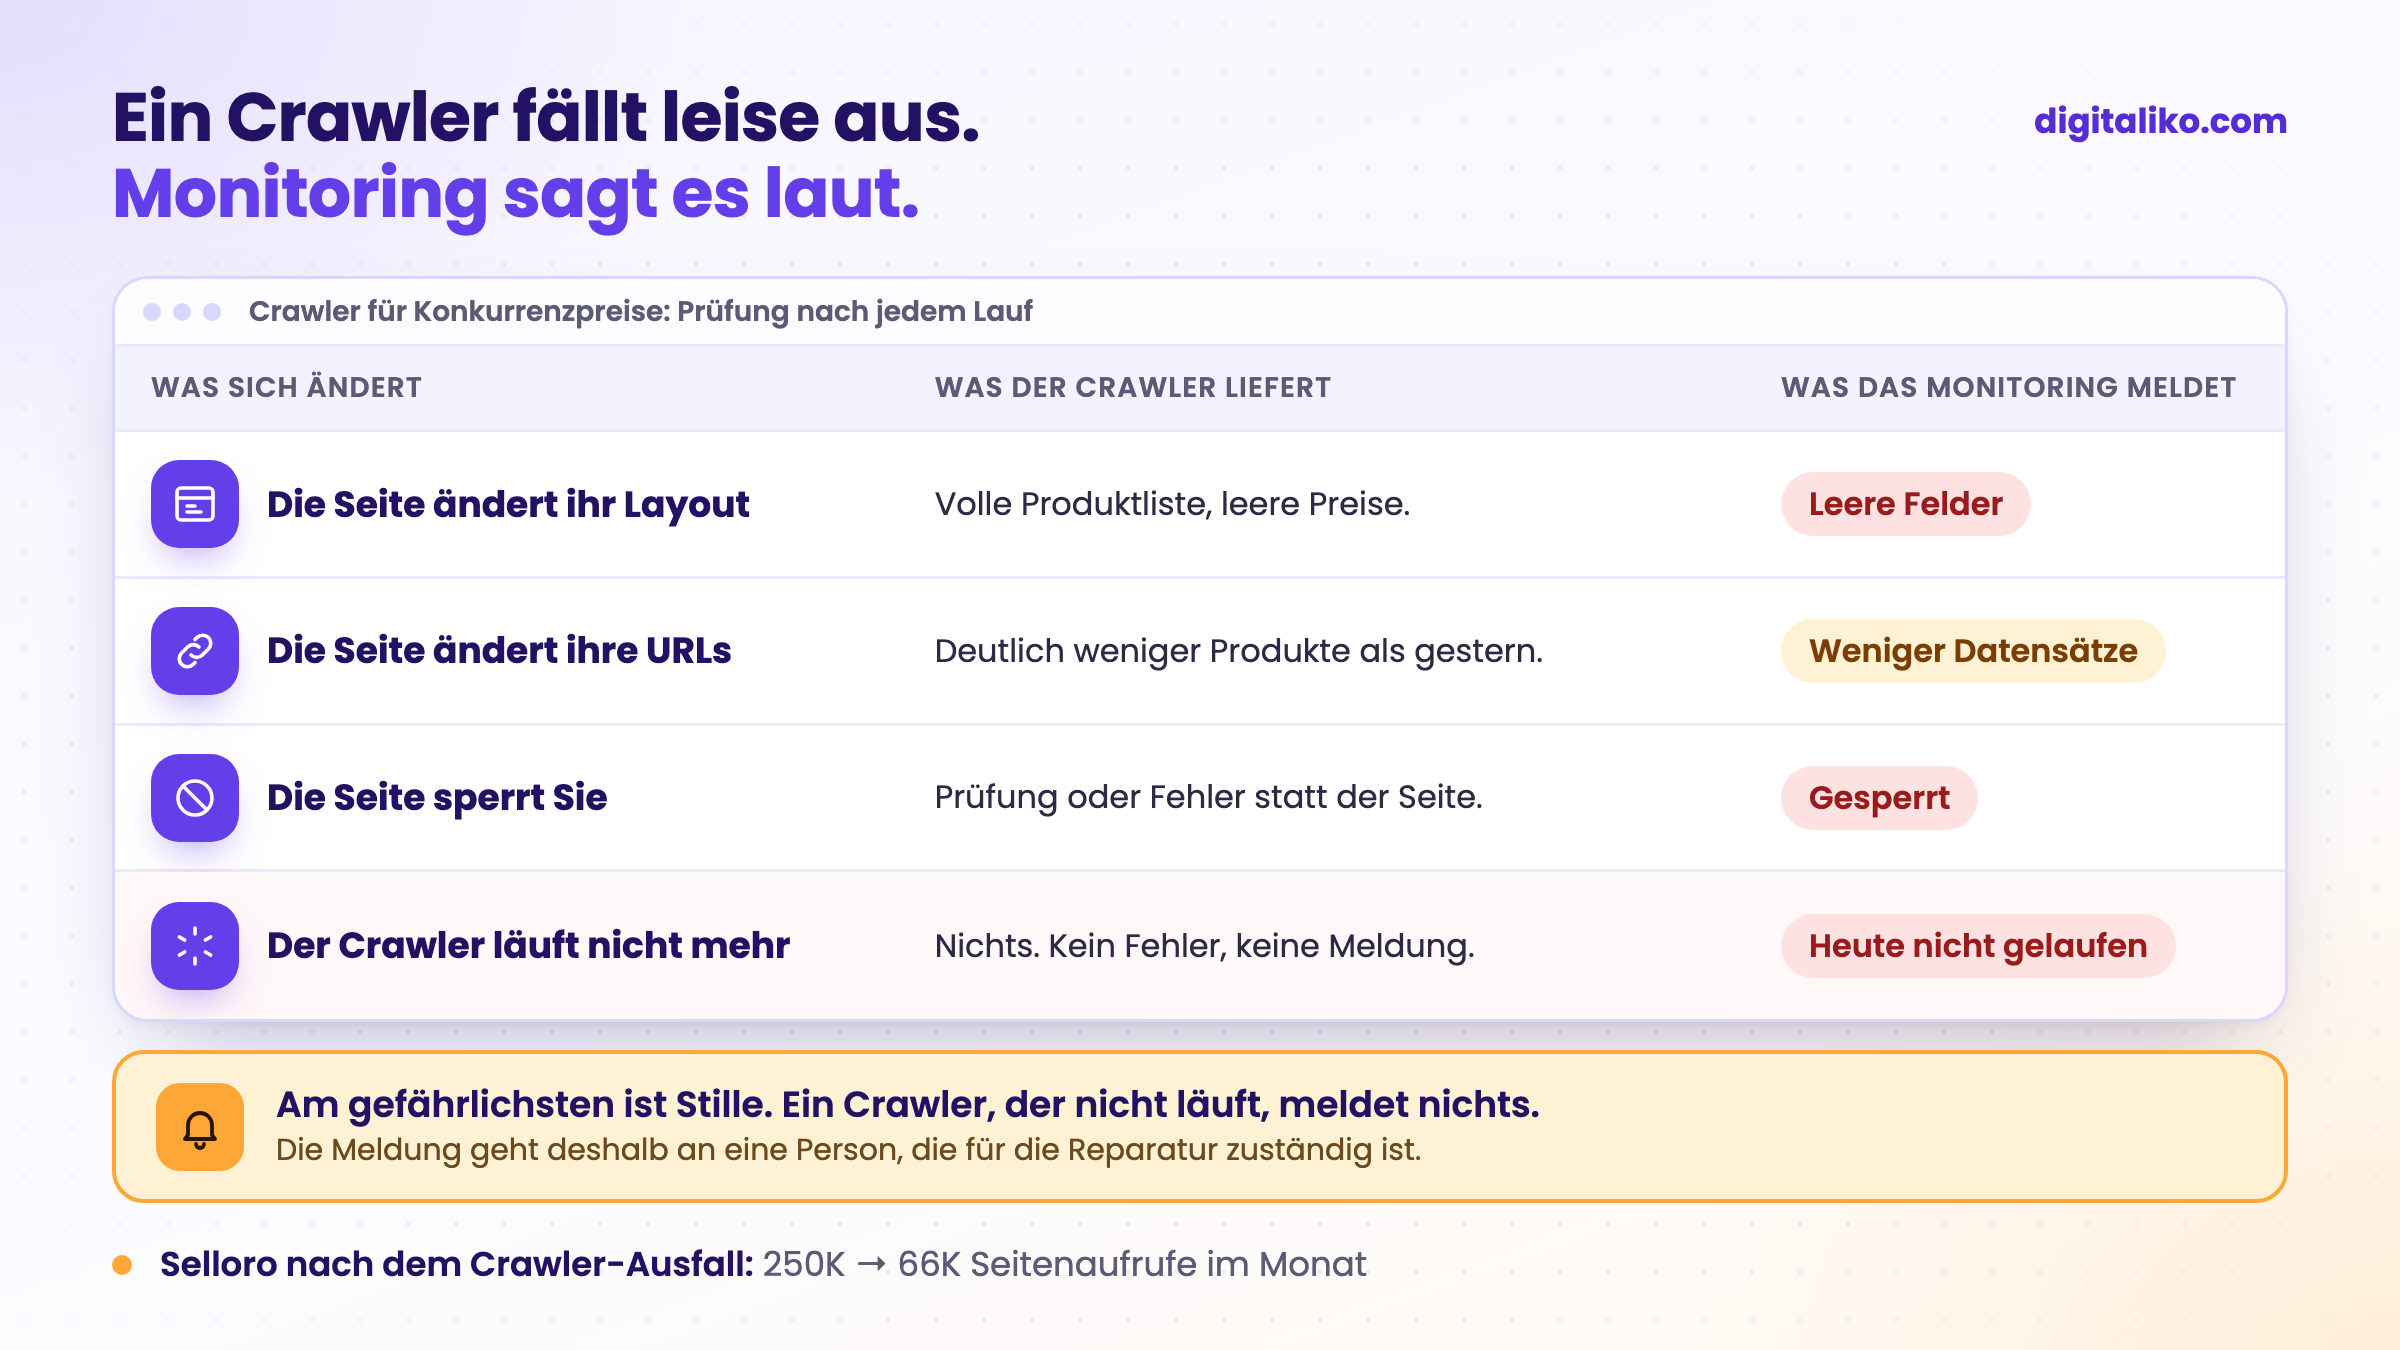
Der letzte Fall ist der tückischste, weil nichts ihn meldet. Genau das ist uns passiert. Auf dem Online-Marktplatz eines Kunden lief im Dezember 2025 der Crawler nicht mehr. Wir haben es spät gemerkt, erst an einer Grafik. Inzwischen fielen die Zugriffe von 250.000 auf 66.000 Seitenaufrufe im Monat.
Wie überwacht man einen Crawler?
Heute überwachen wir beim Crawler, ob er gelaufen ist. Die anderen drei Prüfungen haben wir aus eigenen Fehlern gelernt. Prüfen Sie nach jedem Lauf des Crawlers vier Dinge:
01
Lief er heute?
Wenn nicht, geht die Meldung an eine bestimmte Person, nicht an ein Sammelpostfach.
02
Hat er Daten gebracht?
Null Datensätze oder deutlich weniger als gestern sind ein Fehler, kein Erfolg.
03
Sind die Felder gefüllt?
Ein leerer Preis bei voller Liste heißt, dass sich die Seite geändert hat.
04
Wer repariert?
Ein Name, nicht „die IT“.
Ohne Namen bei der Reparatur meldet das Monitoring das Problem nur hübsch. Repariert wird erst, wenn jemand zuständig ist.
Warum auch die Daten prüfen? Ein anderes Mal lief unser Crawler mehrere Tage, stieß an ein Laufzeitlimit und speicherte nichts. Jeder Lauf begann bei null. Er lief also, brachte aber keine Daten. Dazu stand im Repository, wie oft er laufen soll, und der Server startete ihn anders.
Was ist beim Web Scraping legal?
Öffentlich zugänglich heißt nicht frei verwendbar. Wir halten uns an diese Regeln:
- Nur öffentliche Daten. Nichts hinter einem Login und nichts, was die Seite verbirgt.
- Bedingungen und robots.txt. Verbietet die Seite das Sammeln, sammeln wir nicht.
- Rücksichtsvolles Tempo. Keine Tausende Anfragen pro Minute. Der Server gehört jemand anderem.
- Personenbezogene Daten. Namen, E-Mails und Telefonnummern fallen unter die DSGVO, auch wenn sie öffentlich sind.
- Texte und Bilder. Sie können urheberrechtlich geschützt sein. Ein Preis ist eine Angabe, eine Produktbeschreibung ist fremder Text.
Unser Crawler für diesen Kunden stellt sich den Seiten mit eigenem Namen und einem Link auf eine Seite vor, die erklärt, wer sammelt und warum. Eine Quelle haben wir abgeschaltet, weil ihre Bedingungen Automatisierung verbieten.
Wann wir davon abraten
Automatisieren heißt nicht, alles schneller zu machen. Manchmal ist es besser, den Teil zu finden, den Sie weglassen können.
- Sie brauchen die Daten einmal. Übertragen Sie sie von Hand oder bestellen Sie eine einmalige Sammlung. Ein Crawler rechnet sich nicht.
- Die Quelle bietet Export, offene Daten oder eine API. Nutzen Sie sie. Ein Crawler wäre der teurere und empfindlichere Weg.
- Die Daten liegen hinter einem Login oder die Bedingungen verbieten das Sammeln. Bauen Sie keinen. Vereinbaren Sie den Zugriff mit der Quelle.
- Niemand nutzt das Ergebnis oder repariert den Crawler. Eine Tabelle, die niemand öffnet, spart nichts.
Wenn Sie Arbeit automatisieren wollen, bei der freier Text zu lesen ist und keine Seiten, lesen Sie Was ist ein KI-Agent?.
Sie kopieren Daten aus dem Web von Hand?
Schreiben Sie uns, welche Daten Sie woher und wie oft sammeln. Wir melden uns innerhalb von zwei Arbeitstagen und wählen gemeinsam, was wir zuerst lösen. Wir sagen Ihnen auch, wenn ein Export oder eine API reicht.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-Minuten-Meeting mit Filip.
Welche Daten überträgt bei Ihnen jede Woche jemand von einer fremden Seite?
Kurz gesagt
- Ein Crawler lohnt sich, wenn Sie dieselben öffentlichen Daten regelmäßig brauchen und es von Hand Stunden dauert.
- Bietet die Quelle einen Export oder eine API, nutzen Sie zuerst das. Es ist stabiler und die Bedingungen sind schriftlich.
- Jeder Crawler fällt eines Tages aus. Prüfen Sie nach jedem Lauf, ob er lief, Daten brachte und die Felder füllte.
- Für die Reparatur ist eine bestimmte Person zuständig, nicht „die IT“.
Häufige Fragen
Ist Web Scraping legal?
Das Sammeln öffentlich zugänglicher Daten ist üblich, hat aber Grenzen. Beachten Sie die Nutzungsbedingungen und robots.txt, bleiben Sie vor dem Login, überlasten Sie den Server nicht und rechnen Sie bei personenbezogenen Daten mit der DSGVO. Im Zweifel fragen Sie einen Anwalt.
Wann lohnt sich ein Crawler für ein Unternehmen?
Wenn Sie dieselben Daten von öffentlichen Seiten regelmäßig brauchen und es von Hand Stunden dauert. Bietet die Quelle einen Export oder eine API, nutzen Sie zuerst das. Für eine einmalige Sammlung bauen Sie keinen Crawler.
Was ist der Unterschied zwischen Crawler und Scraper?
Ein Crawler geht durch Seiten und findet, wo die Daten sind. Ein Scraper holt konkrete Werte aus einer Seite, etwa Preis oder Produktname. In Firmen werden die Wörter gleich verwendet, weil die meisten Werkzeuge beides tun.
Wie oft muss ein Crawler repariert werden?
Immer dann, wenn die Quellseite ihr Layout, ihre Adressen oder ihren Bot-Schutz ändert. Wann das passiert, wissen Sie vorher nicht. Deshalb soll der Crawler melden, wenn er null Datensätze oder leere Felder bringt, und jemand muss für die Reparatur zuständig sein.
Was, wenn die Seite eine API anbietet?
Nutzen Sie die API. Sie ist stabiler, ein Redesign bricht sie nicht und die Nutzungsbedingungen stehen schriftlich fest. Ein Crawler ist dort sinnvoll, wo es keine API gibt oder sie nicht enthält, was Sie brauchen.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity