Crawlee na web scraping: čo sa pokazí v produkcii
Pre CTO a vývojárovWeb scraping a crawlery · Aktualizované

Filip Papraneczakladateľ Digitaliko
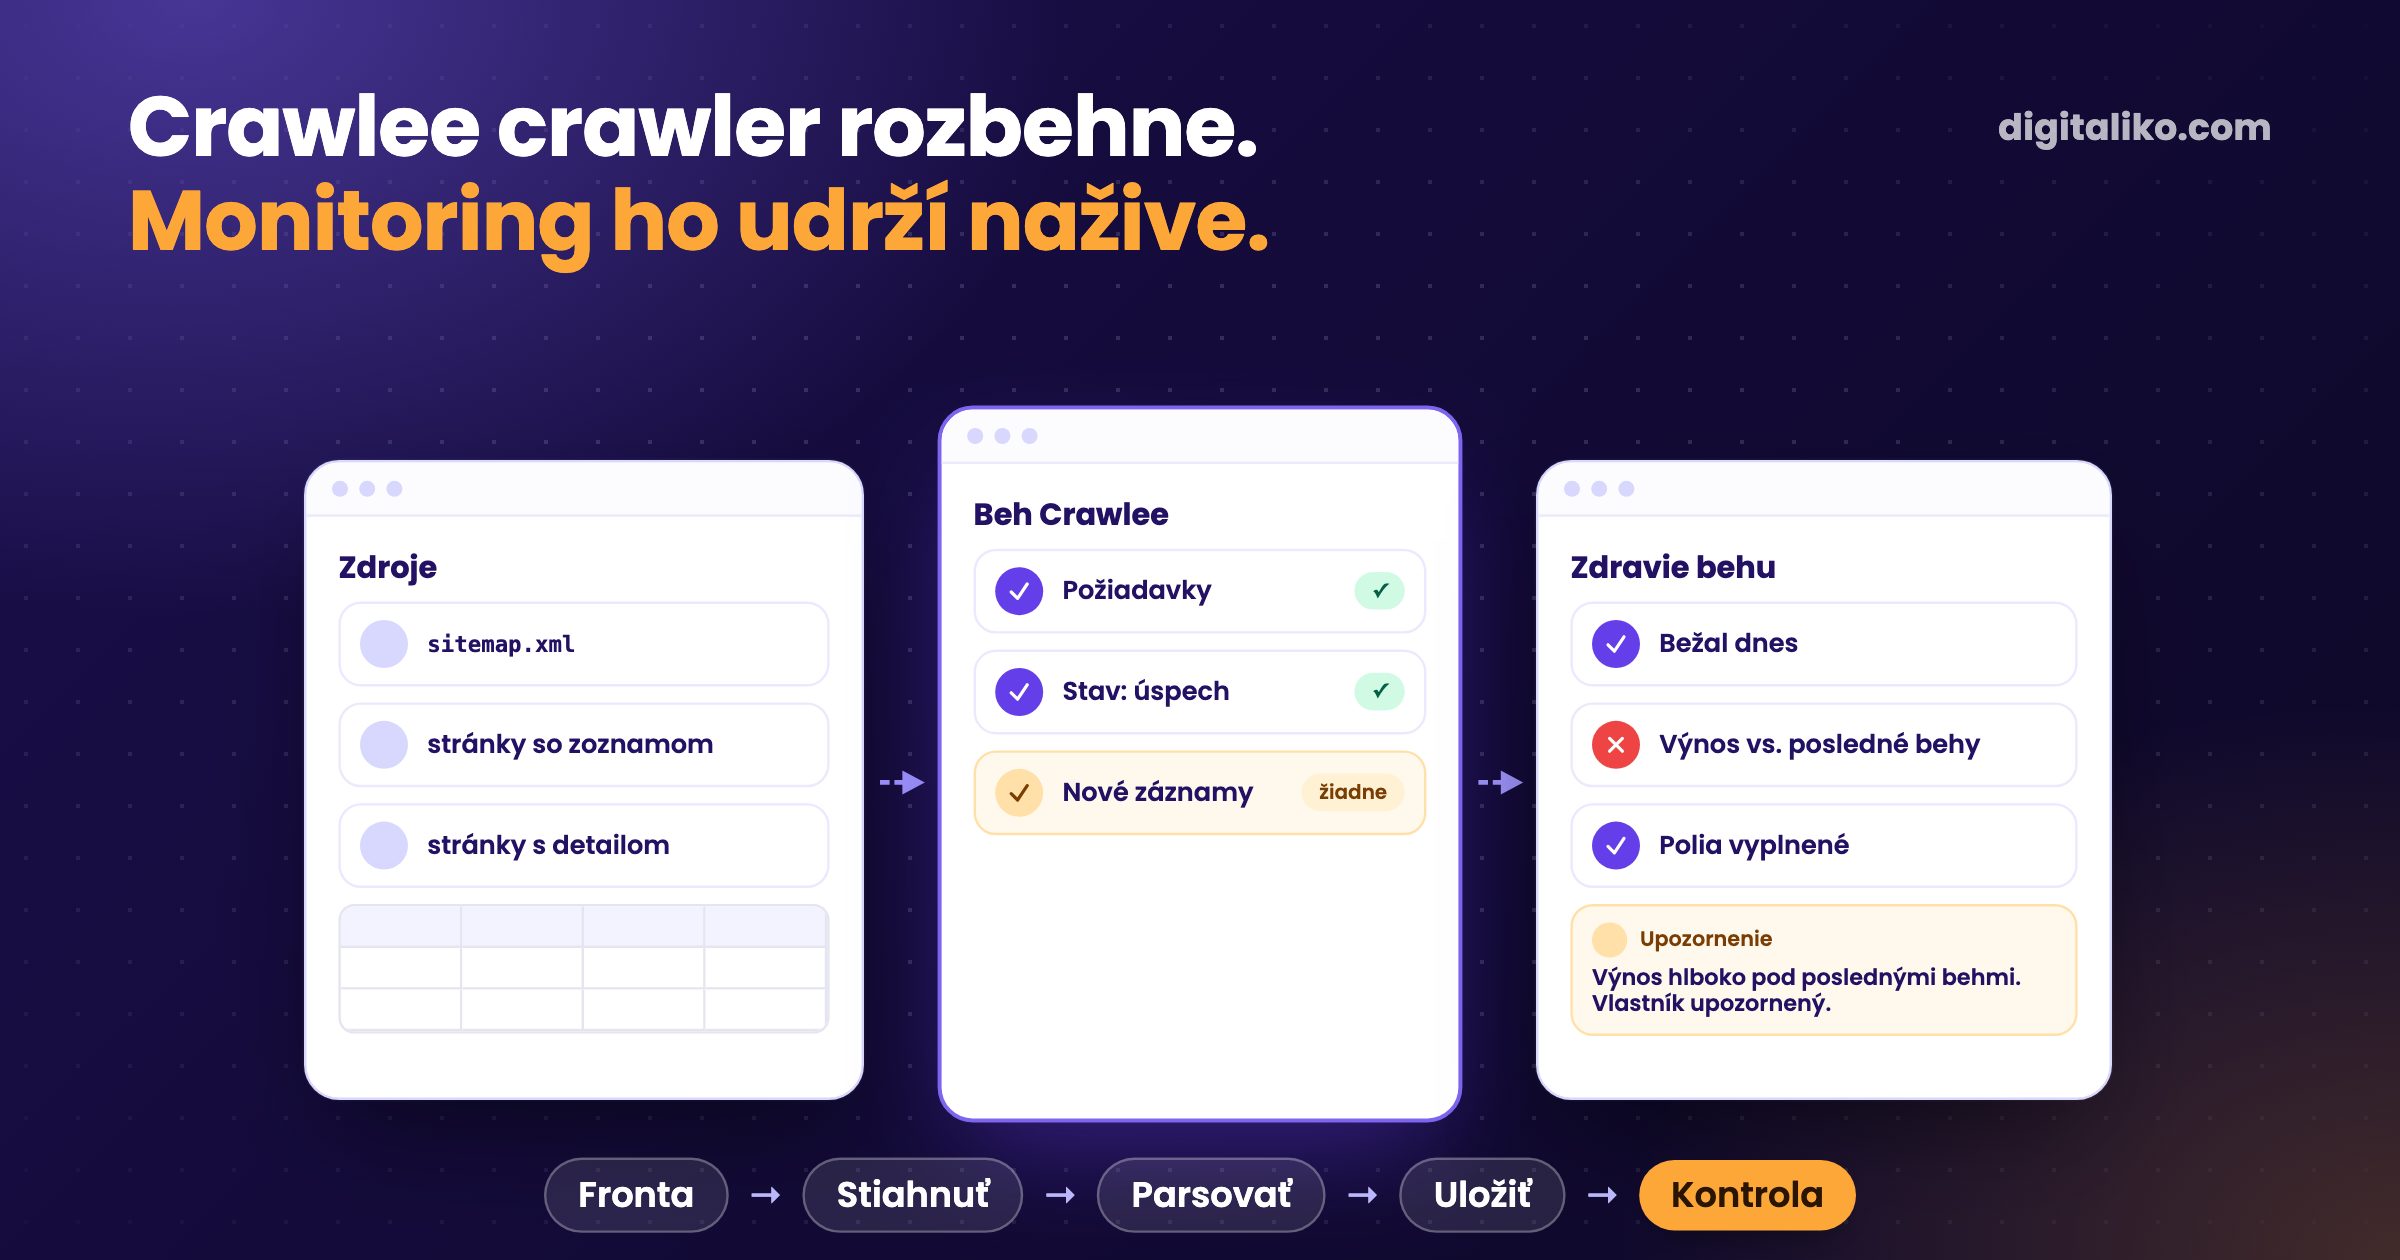
Crawlee je open-source knižnica na web crawling a scraping. Jej dokumentácia sľubuje, že „covers your crawling and scraping end-to-end“, teda pokryje crawling a scraping od začiatku do konca: rýchly HTTP crawling s Cheerio alebo JSDOM, skutočné prehliadače s Playwright alebo Puppeteer za tým istým rozhraním, trvalú frontu požiadaviek, opakovanie pokusov, sessions a striedanie proxy. Crawler s ňou rozbehnete rýchlo. Udržať ho v chode je tá ťažšia časť.
Naučili sme sa to na crawleri na Crawlee, ktorý prevádzkujeme pre klienta s online marketplace. V decembri 2025 crawler zomrel a zistili sme to neskoro, až z grafu. Nižšie je, ako Crawlee používame, čo sa v produkcii pokazilo a aké kontroly sme pridali.
Čo je Crawlee a ktorý crawler si vybrať?
Crawlee rieši základnú prácu, ktorú potrebuje každý crawler: frontu URL, ktorá prežije reštart, opakovanie pokusov, limity súbežnosti, sessions a proxy. Vy napíšete handler, ktorý zo stránky urobí záznam.
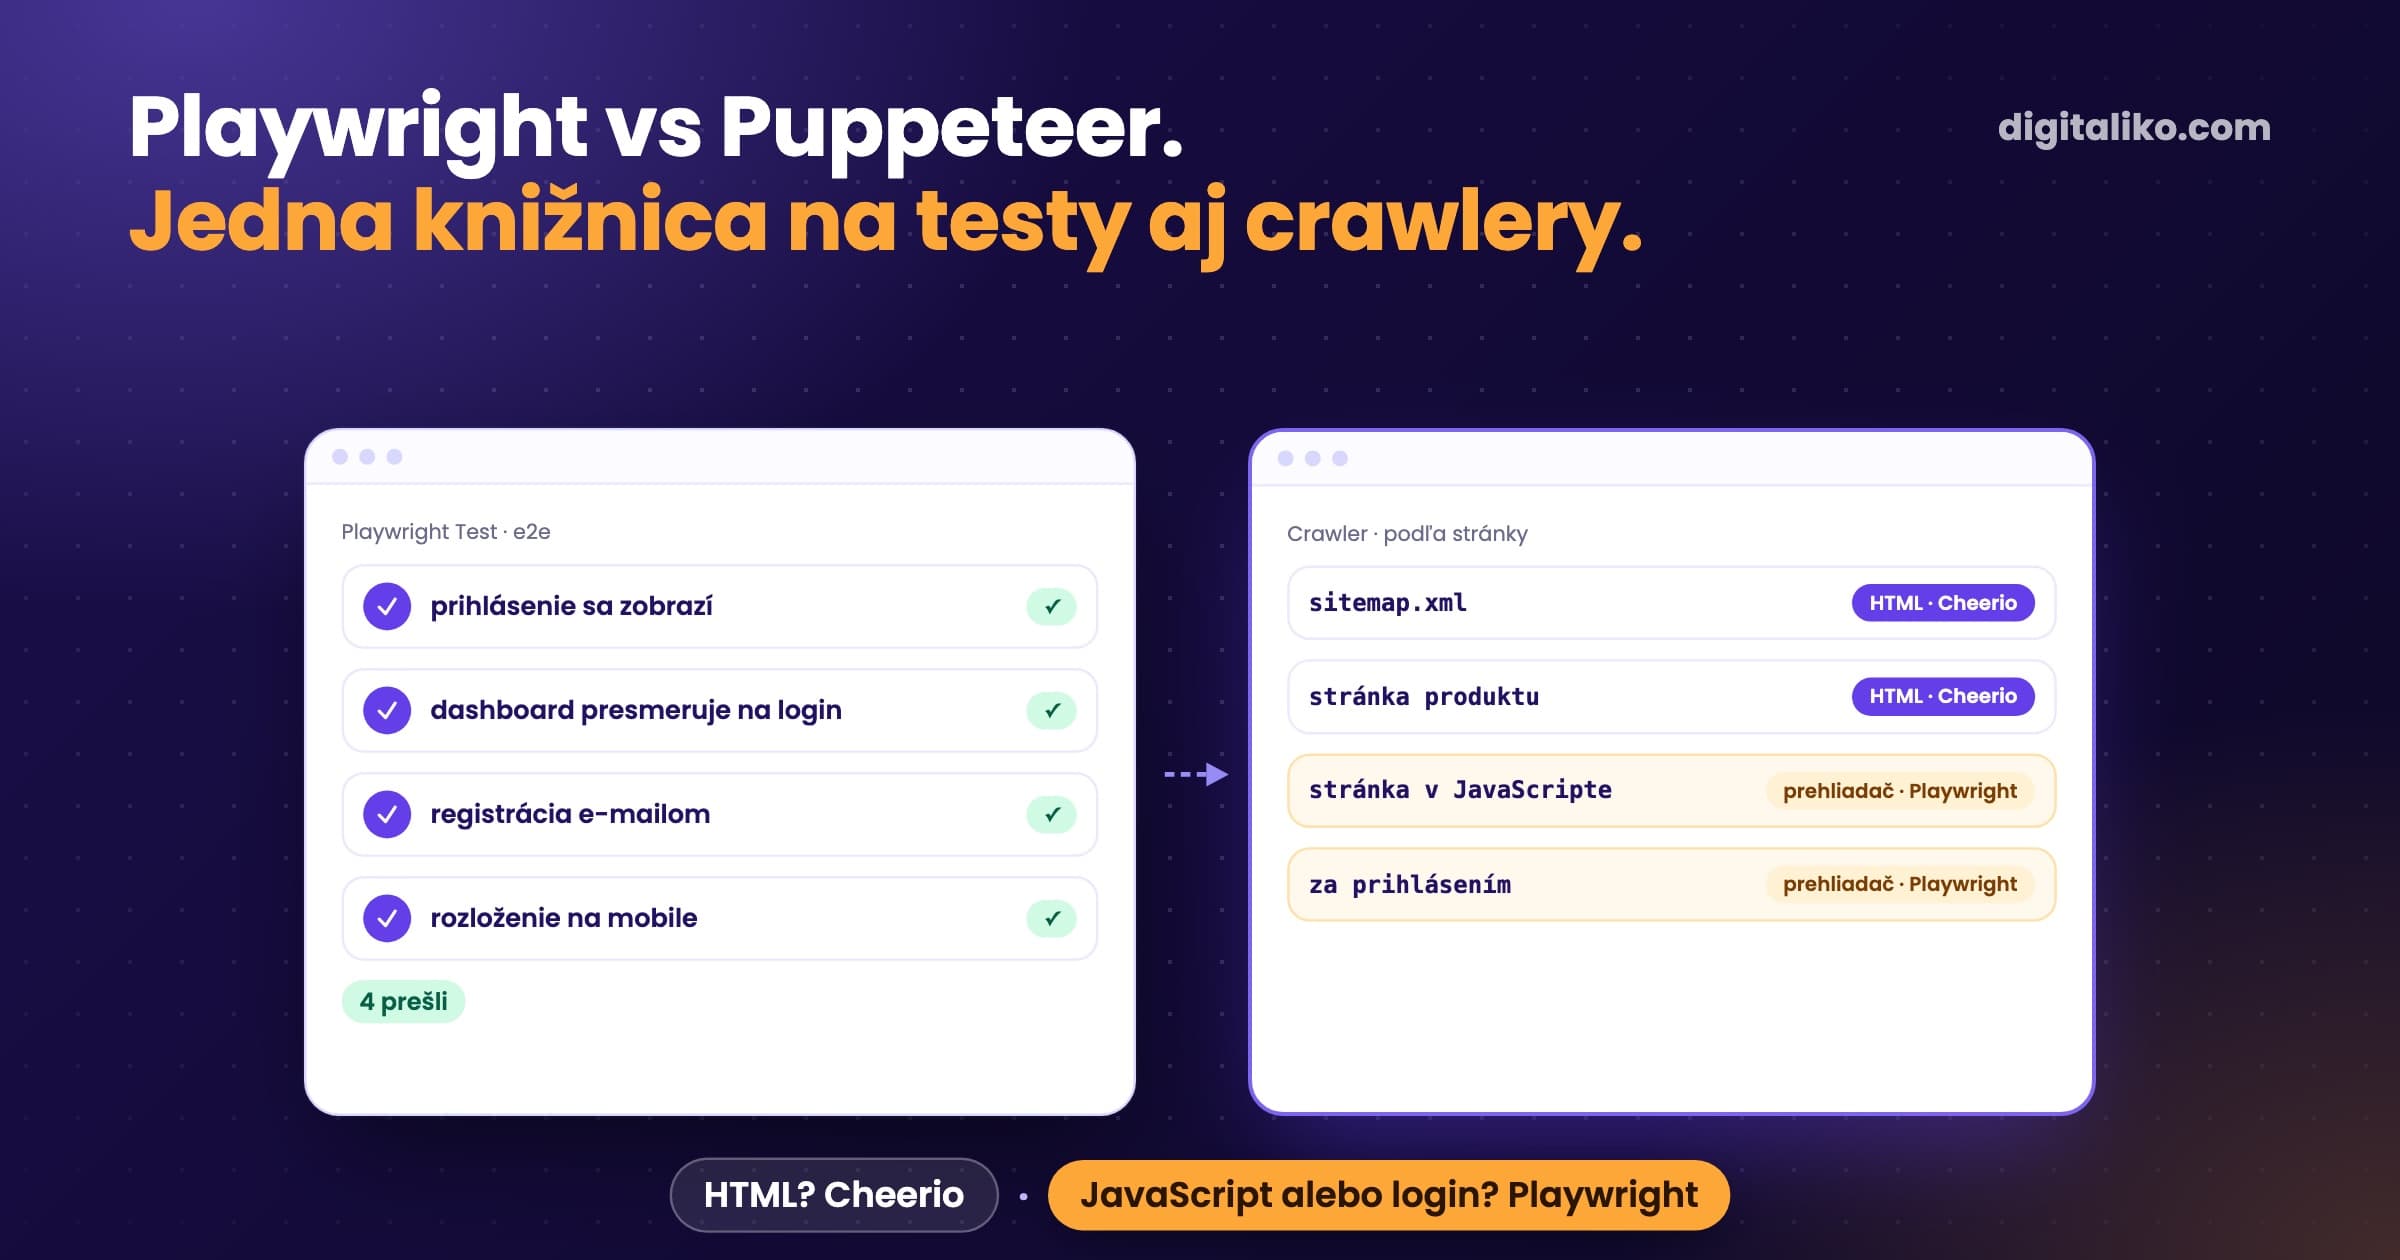
Hlavná voľba je trieda crawlera:
Začnite tu
CheerioCrawler
- Stiahne HTML a rozparsuje ho.
- Rýchly a nenáročný na pamäť.
- Stačí na stránky vykreslené na serveri a sitemapy.
- Toto používame pri väčšine zdrojov.
PlaywrightCrawler
- Spustí skutočný prehliadač.
- Na stránky poskladané JavaScriptom alebo za klikaním.
- Pomalší a ťažší na stránku.
- Len tam, kde HTML nestačí.
Oba používajú ten istý router aj frontu požiadaviek. Môžete začať s Cheerio a jeden ťažký zdroj neskôr presunúť do prehliadača.
Ako vyzerá minimálny crawler na Crawlee?
Router s dvoma handlermi: stránky so zoznamom zaradia detaily do fronty, stránky s detailom uložia záznam.
import { CheerioCrawler, createCheerioRouter, Dataset } from 'crawlee'

const router = createCheerioRouter()

router.addDefaultHandler(async ({ enqueueLinks }) => {
  await enqueueLinks({ selector: 'a.listing', label: 'DETAIL' })
})

router.addHandler('DETAIL', async ({ request, $ }) => {
  await Dataset.pushData({
    url: request.loadedUrl,
    title: $('h1').text().trim(),
    price: $('.price').text().trim(),
  })
})

const crawler = new CheerioCrawler({
  requestHandler: router,
  maxConcurrency: 4,
  maxRequestRetries: 2,
  failedRequestHandler: async ({ request }) => console.error('gave up', request.url),
})

await crawler.run(['https://example.com/listings'])
Naše produkčné crawlery k tomu pridávajú jednu myšlienku. Začínajú zo sitemáp a pamätajú si, kde posledný beh skončil, takže každý beh stiahne len to, čo sa odvtedy zmenilo. Prechádzať pri každom behu celý veľký katalóg je najistejší spôsob, ako crawler narazí na časový limit.
Čo sa pokazí v produkcii?
Ani jedno nebola chyba Crawlee. Deje sa to okolo každého crawlera, ktorý beží každý deň:
| Čo sa stalo | Čo sme videli | Čo sme pridali |
|---|---|---|
| Beh skončil zelený a neuložil skoro nič | zelený dashboard, zmenšujúci sa katalóg | kontrolu výnosu: nové záznamy v porovnaní s poslednými behmi |
| Plánovač spustil beh, kým predošlý visel | zaseknuté behy, ktoré držali spojenia do databázy | zámok pre každý zdroj a tvrdý časový limit na beh |
| Proces bol násilne ukončený | beh navždy označený ako bežiaci | krok, ktorý pred každým behom označí staré behy ako zlyhané |
| Hľadanie URL sa nikdy neskončilo | časový limit bez jediného uloženého záznamu | časový strážca na hľadanie, inkrementálne sitemapy |
| Platené API pri obohacovaní vrátilo chybu platby | worker skončil ako úspešný | samostatnú kontrolu zdravia, ktorá na to upozorní |
| Plán v repozitári nebol ten na serveri | behy v nesprávnom čase | plán synchronizovaný z repozitára na server |
Ten prvý riadok bolel najviac. Náš monitorovací kód dnes začína presne týmto prípadom: crawl, ktorý dobehne zelený, ale neprinesie skoro žiadne nové inzeráty.
Ako monitorovať crawler na Crawlee?
Crawlee vám povie o požiadavkách, ktoré zlyhali. Po vyčerpaní pokusov skončí požiadavka vo failedRequestHandler a môžete ju zalogovať alebo spočítať. Nepovie vám však, že beh, ktorý uspel, nepriniesol nič. Táto kontrola je na vás.
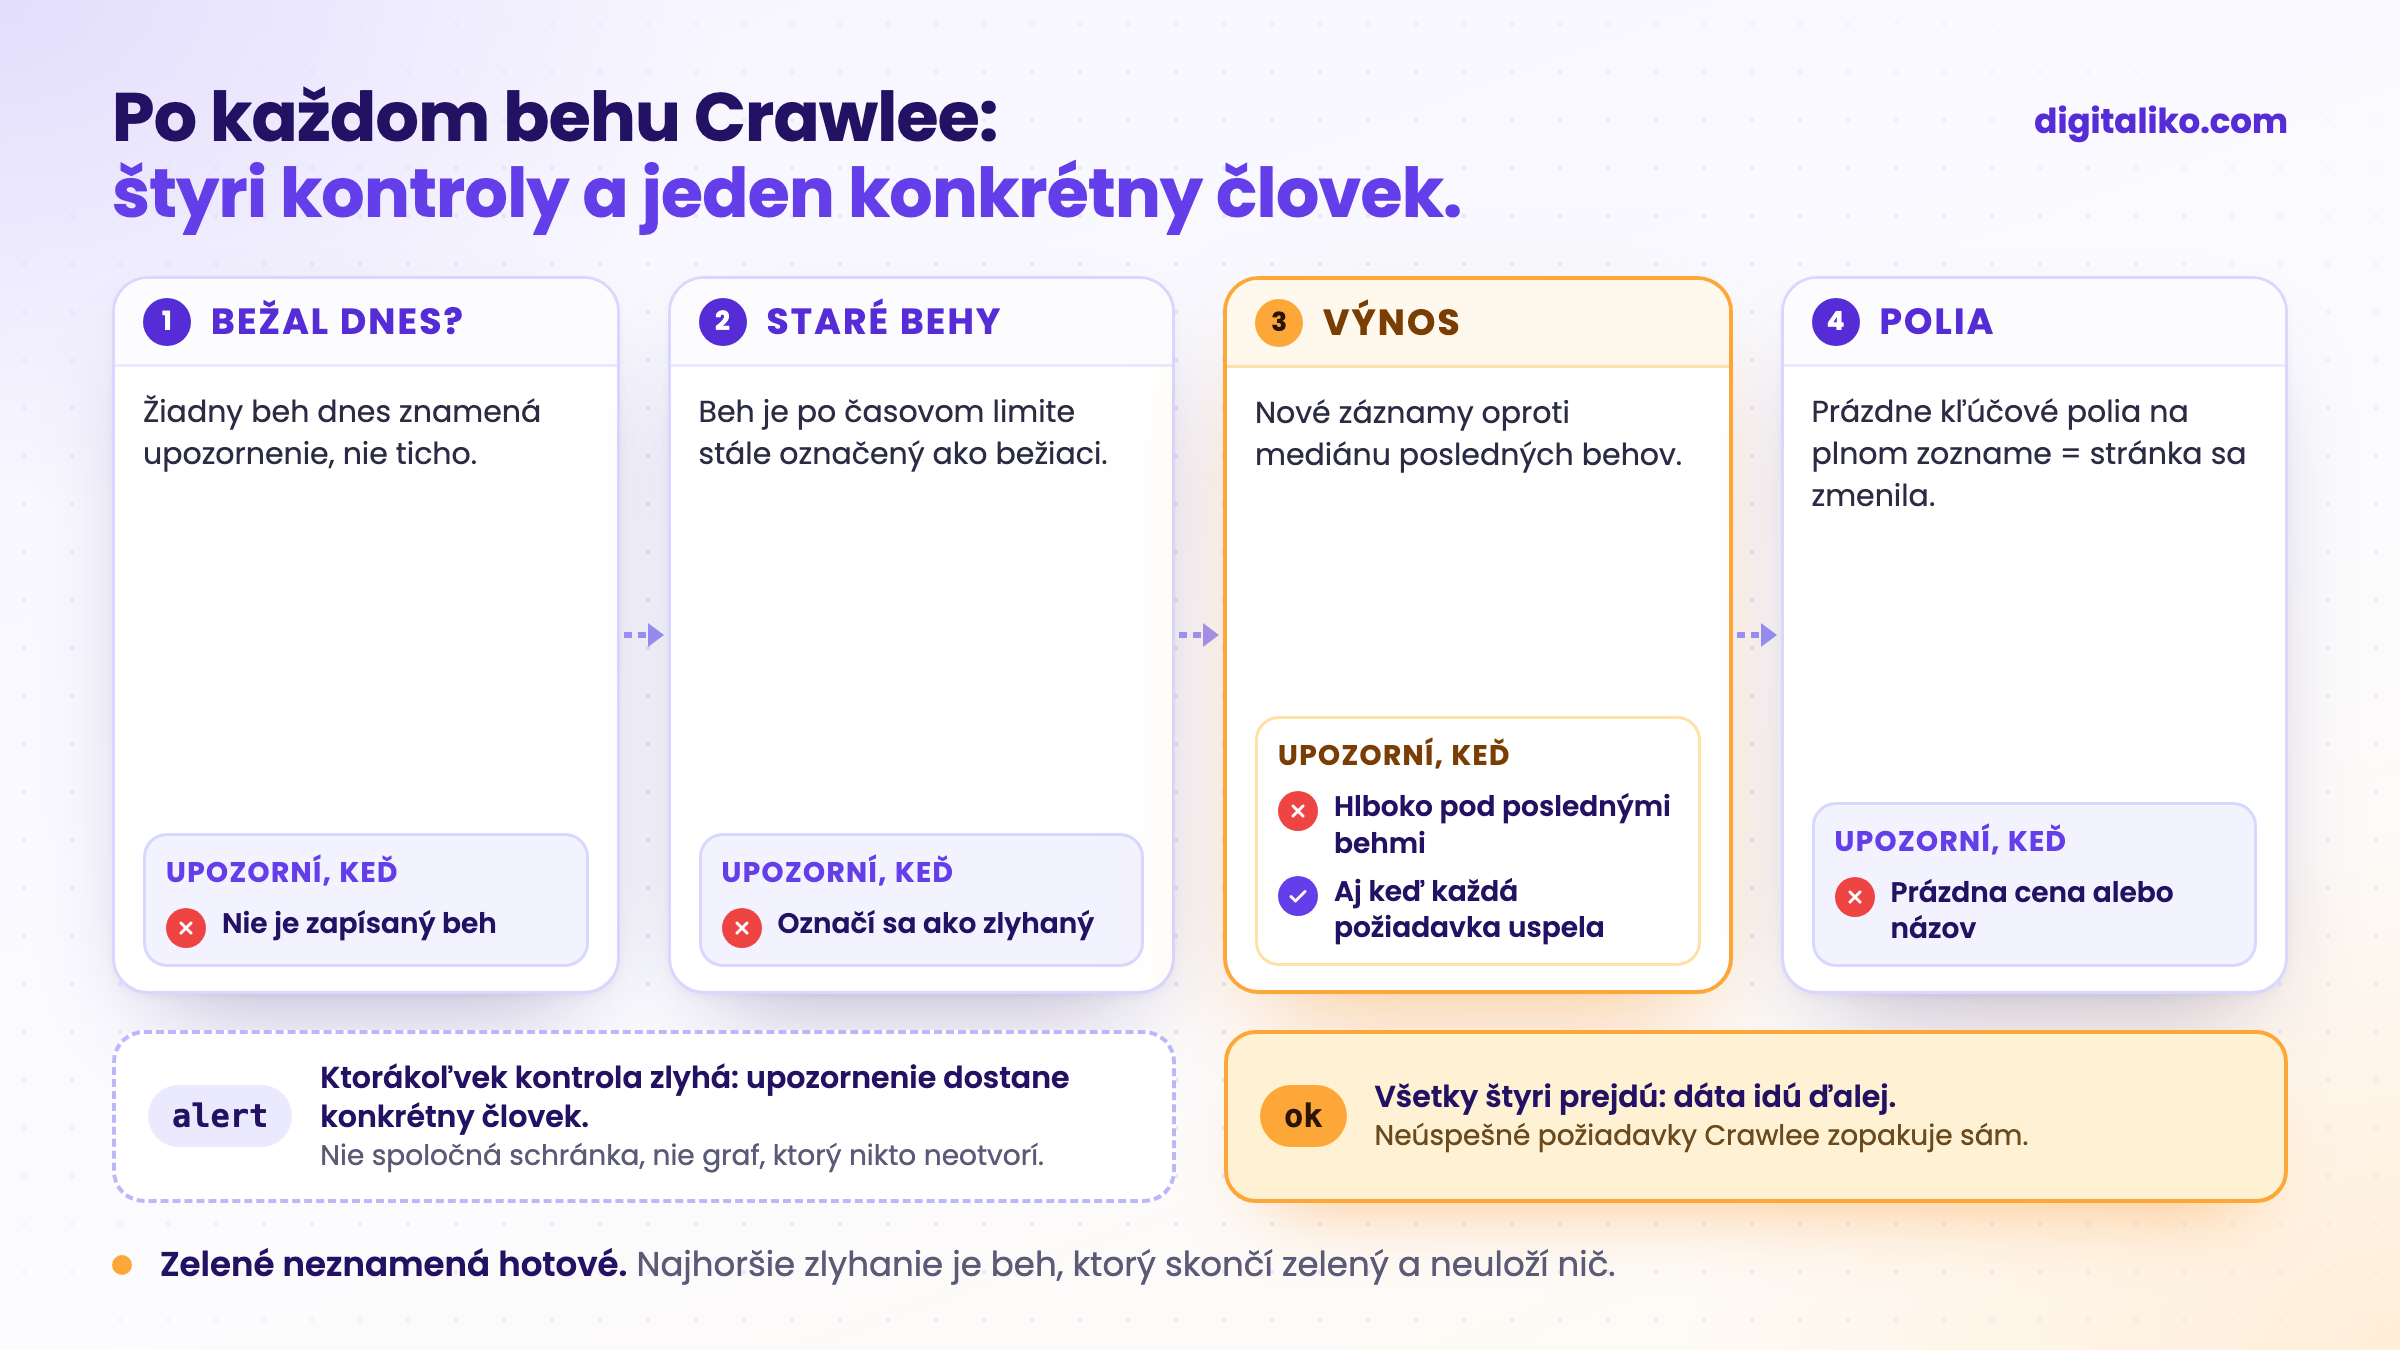
Každý beh porovnávame s mediánom posledných behov, nie s pevným číslom. Zdroj, ktorý zvyčajne prinesie veľa nových inzerátov a zrazu len pár, je zlyhanie, aj keď každá požiadavka uspela. Beh, ktorý je dlho po časovom limite stále označený ako bežiaci, je tiež zlyhanie, lebo násilne ukončený proces svoj koniec nikdy nezapíše.
Koľko stál mŕtvy crawler?
Marketplace žije z čerstvých inzerátov. Keď crawler prestal bežať, nič hlasno nezlyhalo. Nové inzeráty prestali pribúdať a návštevnosť išla za nimi.
- zobrazení mesačne na online marketplace klienta po páde crawlera (december 2025)
- 250K → 66K
Tým sa to neskončilo. Neskôr prišli ďalšie výpadky crawlera a každý pridal riadok do tabuľky vyššie. Dnes sa každé nasadenie po merge overí a otestuje a pád crawlera upozorní človeka hneď, nie až keď sa niekto pozrie na graf.
Dotiahnuť niečo do stabilnej produkcie je iný level: architektúra, infraštruktúra a ľudia, ktorí vedia, čo sa môže pokaziť.

Ako pripraviť crawler na Crawlee do produkcie?
01
Predstavte sa
Vlastný User-Agent so stránkou, ktorá hovorí, kto zbiera a prečo.
02
Zámok a limit
Pre každý zdroj naraz len jeden beh, s tvrdým časovým limitom.
03
Crawlujte inkrementálne
Začnite zo sitemáp a sťahujte len to, čo sa od posledného behu zmenilo.
04
Kontrolujte výnos
Porovnajte nové záznamy a prázdne polia s poslednými behmi.
05
Upozornite človeka
Upozornenie dostane konkrétny človek, nie spoločná schránka.
Prvý krok je o slušnosti a o práve. Náš crawler sa stránkam predstavuje vlastným menom a odkazom na stránku, ktorá vysvetľuje, kto zbiera a prečo. Jeden zdroj sme vypli, lebo jeho podmienky automatizáciu zakazujú. Čo je pri scrapingu legálne a kedy sa crawler vôbec oplatí, je v článku Web scraping pre firmy: kedy sa crawler oplatí.
Kedy je Crawlee zlý nástroj?
- Zdroj má API alebo export. Použite ho. Je stabilnejší a podmienky má spísané.
- Dáta potrebujete raz. Stačí jednorazový skript alebo ručné kopírovanie.
- Dáta sú za prihlásením alebo podmienky zber zakazujú. Dohodnite si prístup so zdrojom.
- Váš tím píše v Pythone. Zoberte Scrapy alebo Crawlee pre Python. Crawler v jazyku, ktorý nikto neudržiava, zomrie pri prvom redizajne.
Za väčšinou našich incidentov je ten istý vzor, o ktorom píšeme v článku Claude Code hooks: prečo naše hooky nerobili nič: zelené neznamená, že to fungovalo.
Je váš crawler pripravený na produkciu?
Potrebujete crawler, ktorý sa ozve, keď prestane?
Crawlery a to, čo z nich ďalej ide, staviame s monitoringom od prvého dňa v rámci služby automatizácia procesov vo firme. Od roku 2023 sme dodali 15+ produkčných projektov.
Ozveme sa do dvoch pracovných dní a spolu vyberieme, čo vyriešime ako prvé.
Ak sa chcete najprv porozprávať, dohodnite si meeting na 15 minút s Filipom.
Ako by ste dnes zistili, že váš crawler v noci nepriniesol nič?
V skratke
- Crawlee dá crawleru základ: frontu, opakovanie pokusov, sessions, proxy, Cheerio alebo skutočný prehliadač.
- Začnite s CheerioCrawler. Prehliadač len tam, kde HTML nestačí.
- V produkcii je najhoršie zlyhanie zelený beh, ktorý neuloží nič.
- Každý beh zamknite, obmedzte časom, crawlujte inkrementálne a výnos porovnajte s poslednými behmi.
- Upozornenie dostane konkrétny človek.
Časté otázky
Čo je Crawlee?
Open-source knižnica na web crawling a scraping. Dáva jedno rozhranie na rýchly HTTP crawling s HTML parsermi aj na skutočné prehliadače s Playwright alebo Puppeteer a k tomu trvalú frontu požiadaviek, opakovanie pokusov, sessions a striedanie proxy.
CheerioCrawler, alebo PlaywrightCrawler?
Začnite s CheerioCrawler. Stiahne HTML a rozparsuje ho, čo je rýchle a nenáročné. Zdroj presuňte na PlaywrightCrawler, len keď jeho stránky vykresľujú obsah JavaScriptom alebo treba klikať. Oba používajú ten istý router aj frontu.
Crawlee, alebo Scrapy?
Vyberte jazyk, ktorý bude váš tím udržiavať, lebo crawler treba opravovať znova a znova. Tím v TypeScripte zoberie Crawlee. Tím v Pythone zoberie Scrapy alebo Crawlee pre Python.
Prečo crawler na Crawlee prestane fungovať?
Stránka sa zmení alebo vás zablokuje, alebo zlyhá samotný beh: časový limit, násilne ukončený proces, plán spúšťania, ktorý nie je taký, ako si myslíte. Najhorší prípad je beh, ktorý skončí zelený a neuloží nič. Preto po každom behu kontrolujeme výnos.
Ako monitorovať crawler?
Po každom behu overte, že bežal, koľko nových záznamov priniesol v porovnaní s poslednými behmi a že sú vyplnené kľúčové polia. Upozornenie dostane konkrétny človek. Beh, ktorý je dlho po časovom limite stále označený ako bežiaci, je zlyhanie.
Opýtajte sa AI na tento článok
AI pri odpovedi využije aj naše ďalšie články a skúsenosti z reálnych projektov.
ChatGPTClaudePerplexity