Crawlee para web scraping: qué falla en producción
Para CTO y desarrolladoresWeb scraping y crawlers

Filip PapranecFundador de Digitaliko
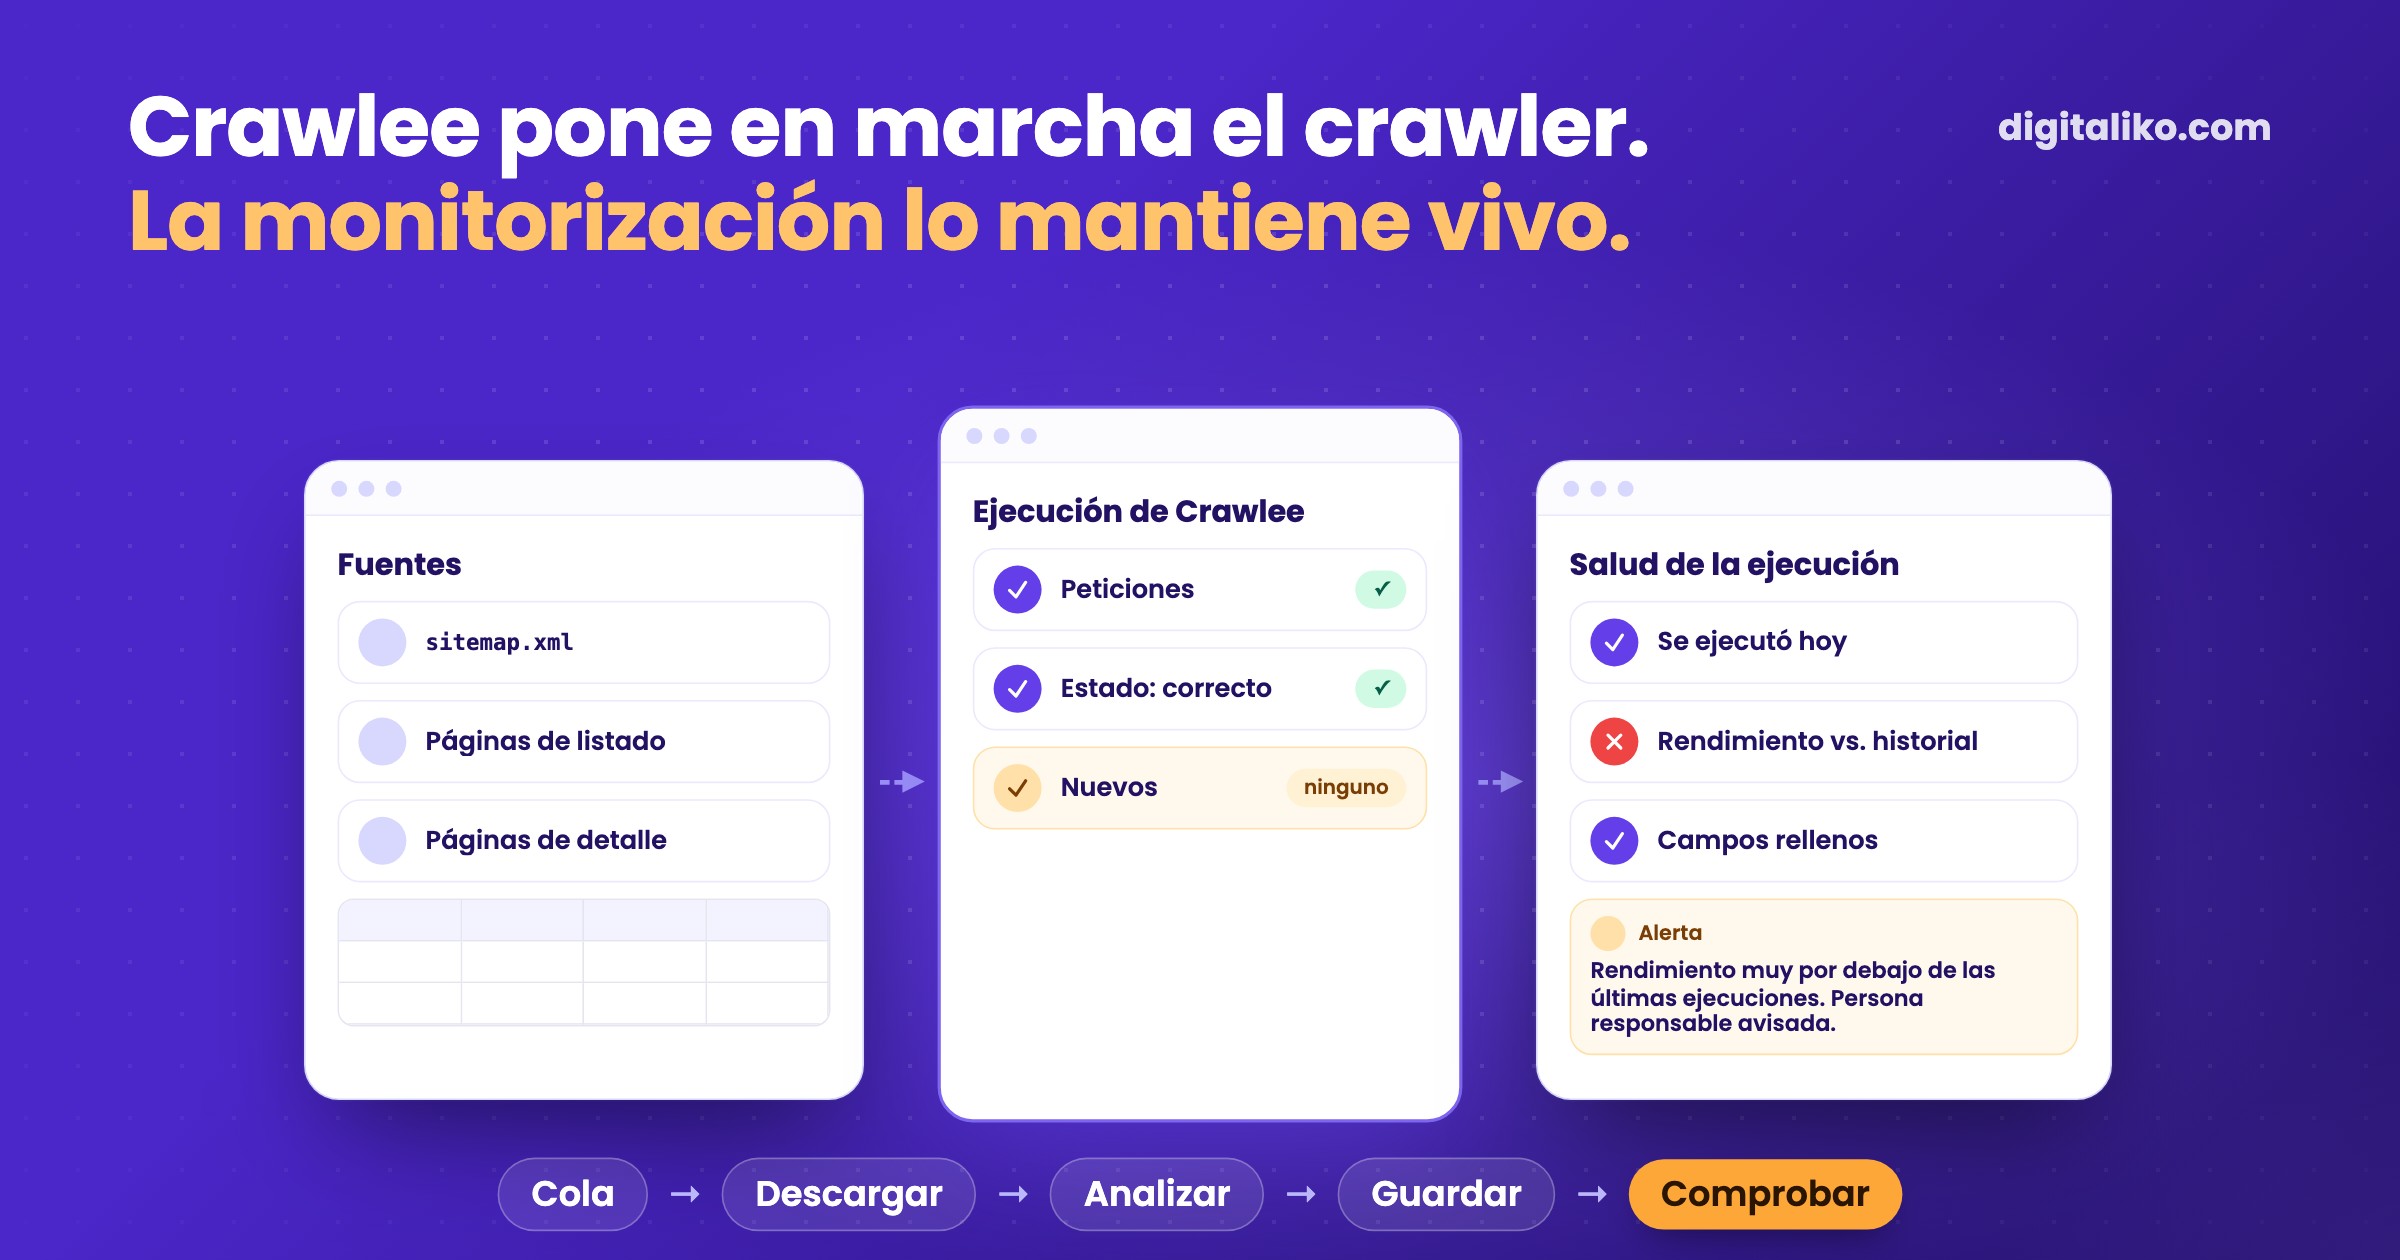
Crawlee es una librería open source para web crawling y scraping. Su documentación dice que "covers your crawling and scraping end-to-end", es decir, que cubre el crawling y el scraping de principio a fin: crawling HTTP rápido con Cheerio o JSDOM, navegadores reales con Playwright o Puppeteer detrás de la misma interfaz, una cola de peticiones persistente, reintentos y sesiones. Con ella un crawler arranca rápido. Mantenerlo en marcha es la parte difícil.
A continuación explicamos cómo funciona Crawlee, qué falla alrededor de los crawlers en producción y las comprobaciones que lo detectan.
¿Qué es Crawlee y qué crawler elegir?
Crawlee se encarga de la fontanería que necesita cualquier crawler: una cola de URLs que sobrevive a los reinicios, reintentos, límites de concurrencia y sesiones. Usted escribe el handler que convierte una página en un registro.
La decisión principal es la clase de crawler:
Empiece aquí
CheerioCrawler
- Descarga el HTML y lo analiza.
- Rápido y ligero en memoria.
- Basta para páginas renderizadas en el servidor y sitemaps.
- Basta para la mayoría de fuentes.
PlaywrightCrawler
- Ejecuta un navegador real.
- Para páginas construidas con JavaScript o detrás de clics.
- Más lento y pesado por página.
- Solo donde el HTML no basta.
Ambos usan el mismo router y la misma cola de peticiones. Puede empezar con Cheerio y pasar más adelante una sola fuente difícil a un navegador.
¿Cómo es un crawler mínimo de Crawlee?
Un router con dos handlers: las páginas de listado ponen en cola las páginas de detalle, y las páginas de detalle guardan un registro.
import { CheerioCrawler, createCheerioRouter, Dataset } from 'crawlee'

const router = createCheerioRouter()

router.addDefaultHandler(async ({ enqueueLinks }) => {
  await enqueueLinks({ selector: 'a.listing', label: 'DETAIL' })
})

router.addHandler('DETAIL', async ({ request, $ }) => {
  await Dataset.pushData({
    url: request.loadedUrl,
    title: $('h1').text().trim(),
    price: $('.price').text().trim(),
  })
})

const crawler = new CheerioCrawler({
  requestHandler: router,
  maxConcurrency: 4,
  maxRequestRetries: 2,
  failedRequestHandler: async ({ request }) => console.error('gave up', request.url),
})

await crawler.run(['https://example.com/listings'])
Un crawler en producción necesita una idea más. Empieza por los sitemaps y recuerda dónde se detuvo la última ejecución, así que cada ejecución descarga solo lo que cambió desde entonces. Recorrer entero un catálogo grande en cada ejecución es la forma de que un crawler choque con su límite de tiempo.
¿Qué falla en producción?
Nada de esto son bugs de Crawlee. Es lo que pasa alrededor de cualquier crawler que se ejecuta cada día:
| Qué pasa | Cómo se ve | Qué ayuda |
|---|---|---|
| Una ejecución termina en verde y casi no guarda nada | panel en verde, un catálogo que mengua | una comprobación de rendimiento: registros nuevos frente a las ejecuciones recientes |
| El programador lanza una ejecución mientras la anterior está colgada | ejecuciones atascadas que retienen conexiones a la base de datos | un bloqueo por fuente y un timeout estricto por ejecución |
| El proceso se mata a la fuerza | una ejecución marcada "en curso" para siempre | un paso que marca como fallidas las ejecuciones antiguas antes de cada ejecución |
| El descubrimiento nunca termina | se alcanza el límite de tiempo sin guardar nada | un límite de tiempo para el descubrimiento, sitemaps incrementales |
| Una API de pago para enriquecer datos devuelve un error de facturación | el worker termina con éxito | una comprobación de salud aparte que avisa de ello |
| La programación del repositorio no es la del servidor | ejecuciones a horas equivocadas | la programación sincronizada del repositorio al servidor |
La primera fila es la más traicionera: un crawl que termina en verde pero casi no trae registros nuevos. La monitorización debería empezar justo por ese caso.
¿Cómo se monitoriza un crawler de Crawlee?
Crawlee le informa de las peticiones que fallaron. Tras sus reintentos, una petición acaba en failedRequestHandler, y usted puede registrarla o contarla. Lo que no le dice es que una ejecución que tuvo éxito no trajo nada. Esa comprobación es cosa suya.
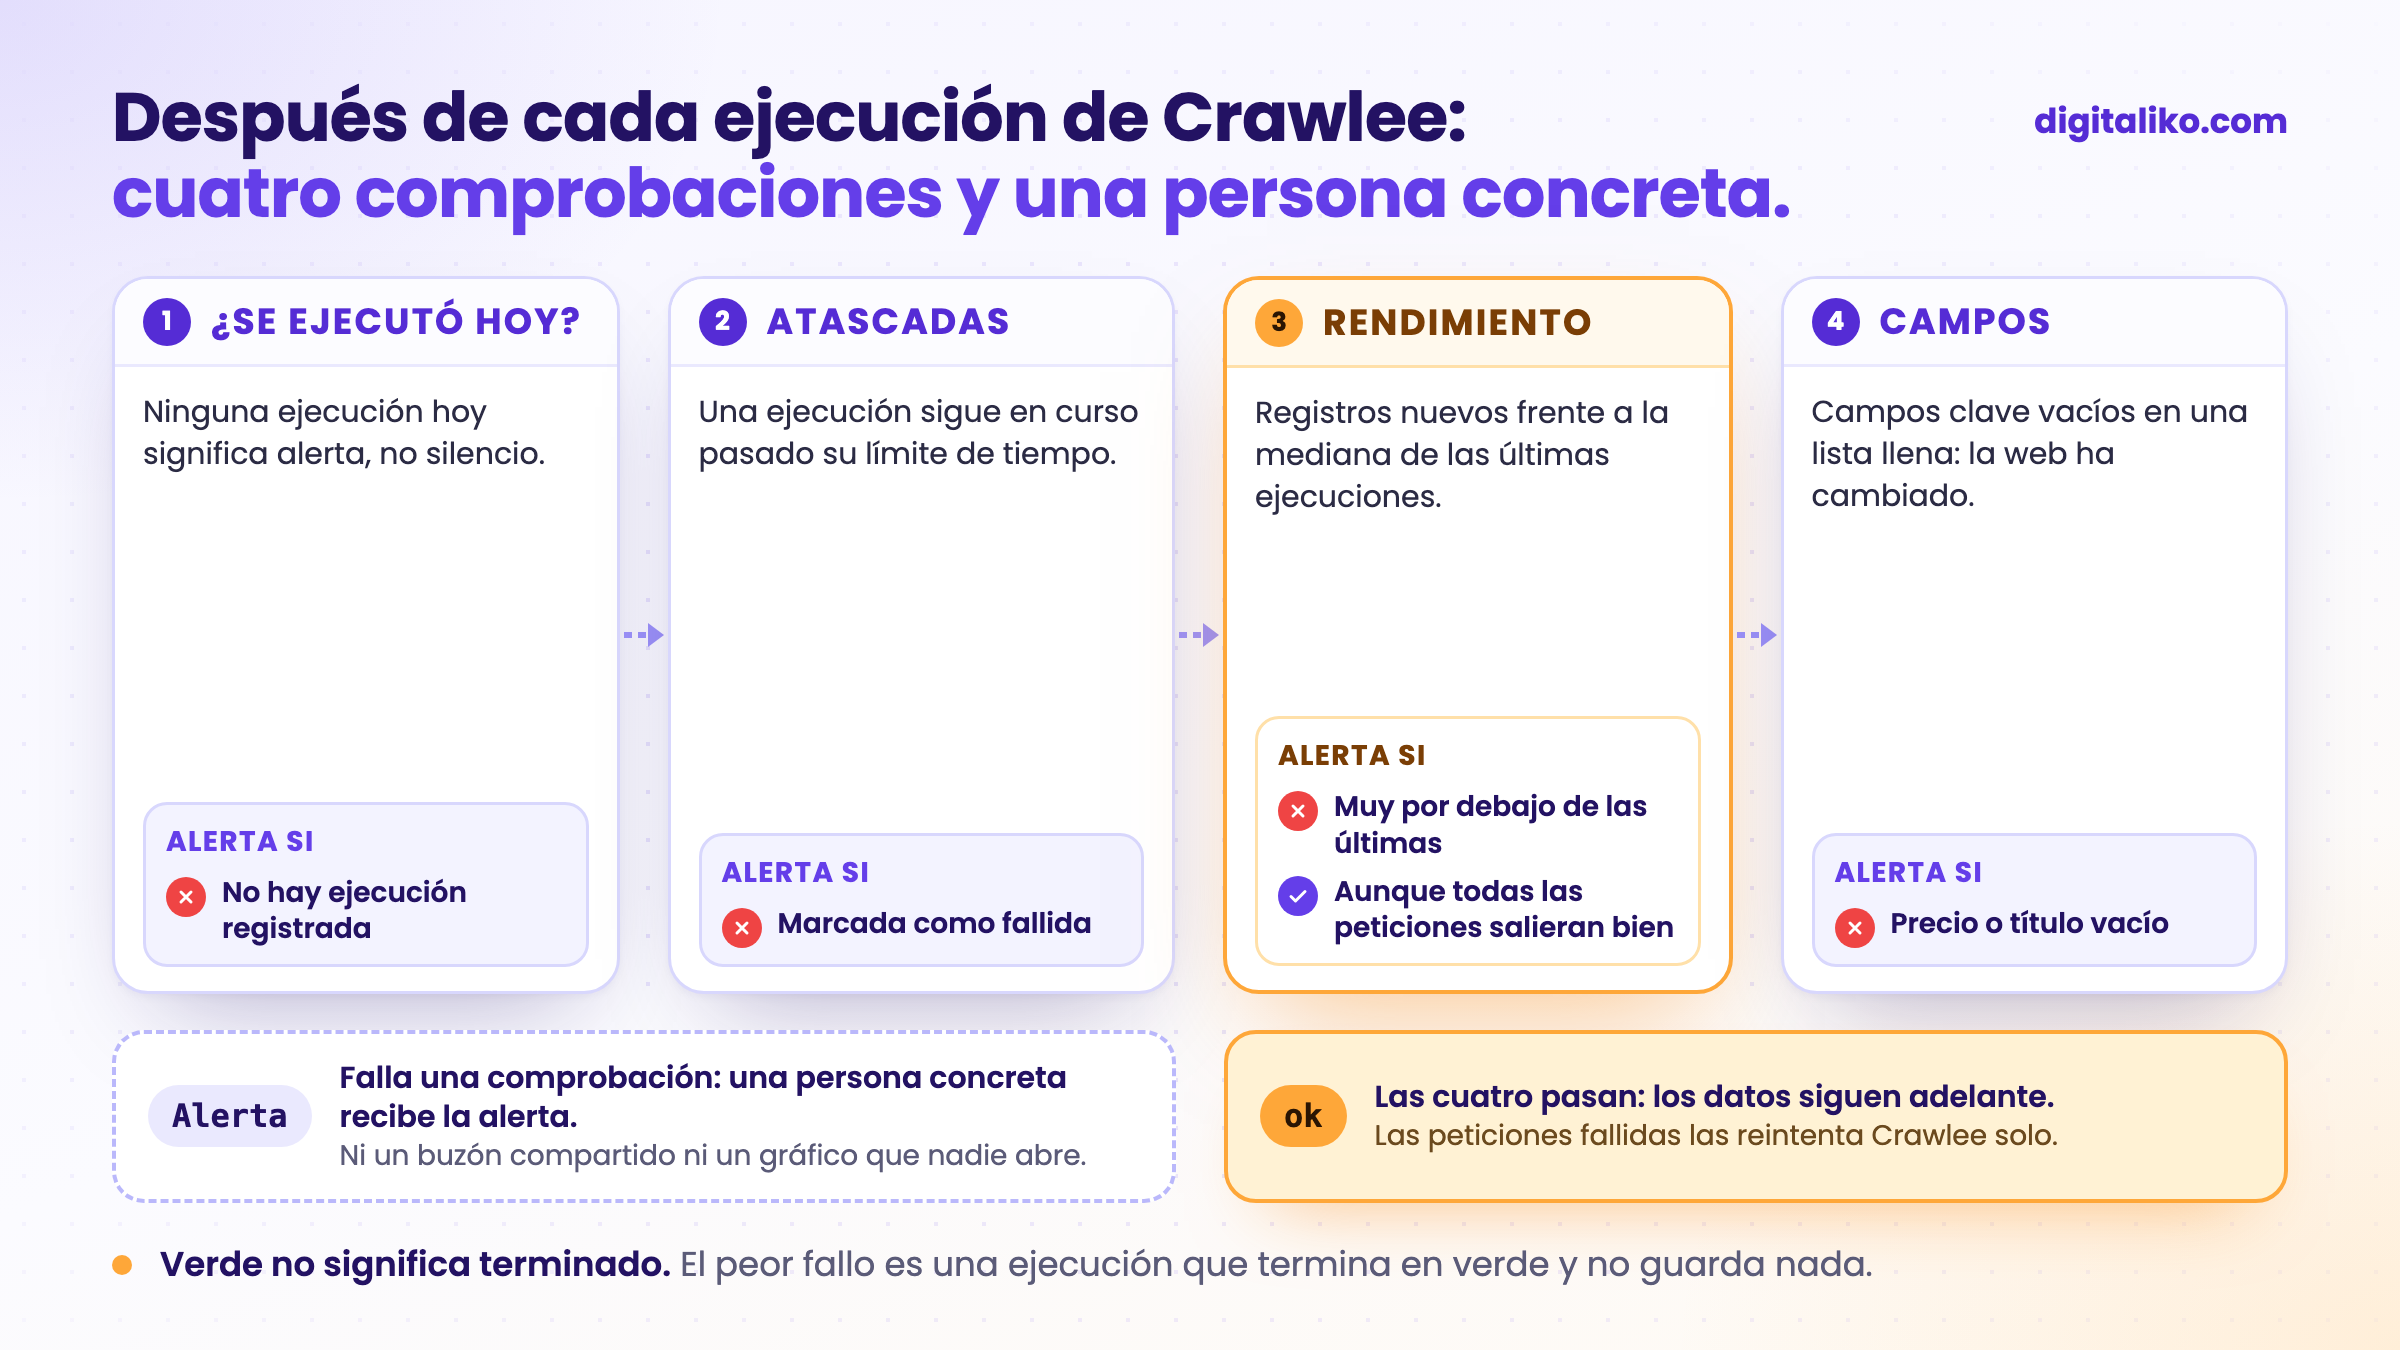
Compare cada ejecución con la mediana de las ejecuciones recientes, no con un número fijo. Una fuente que normalmente trae muchos registros nuevos y de repente trae un puñado es un fallo, aunque todas las peticiones hayan tenido éxito. Una ejecución que sigue marcada como en curso mucho después de su límite de tiempo también es un fallo, porque un proceso matado nunca escribe su propio final.
Llevar algo a una producción estable es otro nivel: arquitectura, infraestructura y personas que saben qué puede salir mal.

¿Cómo preparar un crawler de Crawlee para producción?
01
Preséntese
Su propio User-Agent con una página que diga quién recoge los datos y por qué.
02
Bloqueo y timeout
Una sola ejecución por fuente a la vez, con un límite de tiempo estricto.
03
Crawling incremental
Empiece por los sitemaps y descargue solo lo que cambió desde la última ejecución.
04
Compruebe el rendimiento
Compare los registros nuevos y los campos vacíos con las ejecuciones recientes.
05
Avise a una persona
La alerta la recibe una persona concreta, no un buzón compartido.
El primer paso tiene que ver con las formas y con la ley. Un crawler debería presentarse con su propio nombre y un enlace a una página que explique quién recoge los datos y por qué. Si las condiciones de una fuente prohíben la automatización, no recoja datos de ella. Qué es legal en el scraping, y cuándo compensa un crawler, lo contamos en Web scraping para empresas: cuándo compensa un crawler.
¿Cuándo Crawlee no es la herramienta adecuada?
- La fuente tiene una API o una exportación. Úsela. Es más estable y sus condiciones están por escrito.
- Necesita los datos una sola vez. Basta un script puntual o copiarlos a mano.
- Los datos están detrás de un login, o las condiciones prohíben recogerlos. Acuerde el acceso con la fuente.
- Su equipo escribe Python. Elija Scrapy o Crawlee para Python. Un crawler en un lenguaje que nadie mantiene muere con el primer rediseño.
El patrón detrás de la mayoría de estos incidentes es el mismo del que escribimos en Hooks de Claude Code que en silencio no hacen nada: verde no significa que funcionó.
¿Está su crawler listo para producción?
¿Necesita un crawler que avise cuando se detiene?
Si necesita con regularidad datos que la fuente le permite recoger, le construimos la recogida con una monitorización que le avisa cuando deja de funcionar. Lo hacemos como parte de la automatización de procesos empresariales. Desde 2023 hemos entregado más de 15 proyectos en producción.
Le respondemos en un plazo de dos días laborables con algunas preguntas sobre su trabajo. Después acordamos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada inicial de 15 minutos.
¿Cómo se enteraría hoy de que su crawler no trajo nada anoche?
En resumen
- Crawlee le da la fontanería del crawler: cola, reintentos, sesiones, Cheerio o un navegador real.
- Empiece con CheerioCrawler. Use un navegador solo donde el HTML no basta.
- En producción el peor fallo es una ejecución en verde que no guarda nada.
- Bloquee cada ejecución, póngale un timeout, haga crawling incremental y compare el rendimiento con las ejecuciones recientes.
- Una persona concreta recibe la alerta.
Preguntas frecuentes
¿Qué es Crawlee?
Una librería open source para web crawling y scraping. Ofrece una sola interfaz para el crawling HTTP rápido con parsers de HTML y para navegadores reales con Playwright o Puppeteer, además de una cola de peticiones persistente, reintentos y sesiones.
¿CheerioCrawler o PlaywrightCrawler?
Empiece con CheerioCrawler. Descarga el HTML y lo analiza, lo que es rápido y ligero. Pase una fuente a PlaywrightCrawler solo cuando sus páginas generan el contenido con JavaScript o necesitan clics. Ambos usan el mismo router y la misma cola.
¿Crawlee o Scrapy?
Elija el lenguaje que su equipo vaya a mantener, porque un crawler necesita arreglos una y otra vez. Un equipo de TypeScript elige Crawlee. Un equipo de Python elige Scrapy, o Crawlee para Python.
¿Por qué deja de funcionar un crawler de Crawlee?
La web cambia o le bloquea, o falla la propia ejecución: un límite de tiempo, un proceso terminado a la fuerza, una programación que no es la que usted cree. El peor caso es una ejecución que termina en verde y no guarda nada. Por eso hay que comprobar el rendimiento después de cada ejecución.
¿Cómo se monitoriza un crawler?
Después de cada ejecución, compruebe que se ejecutó, cuántos registros nuevos trajo en comparación con las ejecuciones recientes y que los campos clave están rellenos. Avise a una persona concreta. Una ejecución que sigue marcada como en curso mucho después de su límite de tiempo cuenta como fallida.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

