Ewaluacja agentów AI: jak mierzymy dokładność
Dla CTO i programistówHarness i kontrole · Zaktualizowano

Filip PapranecZałożyciel Digitaliko
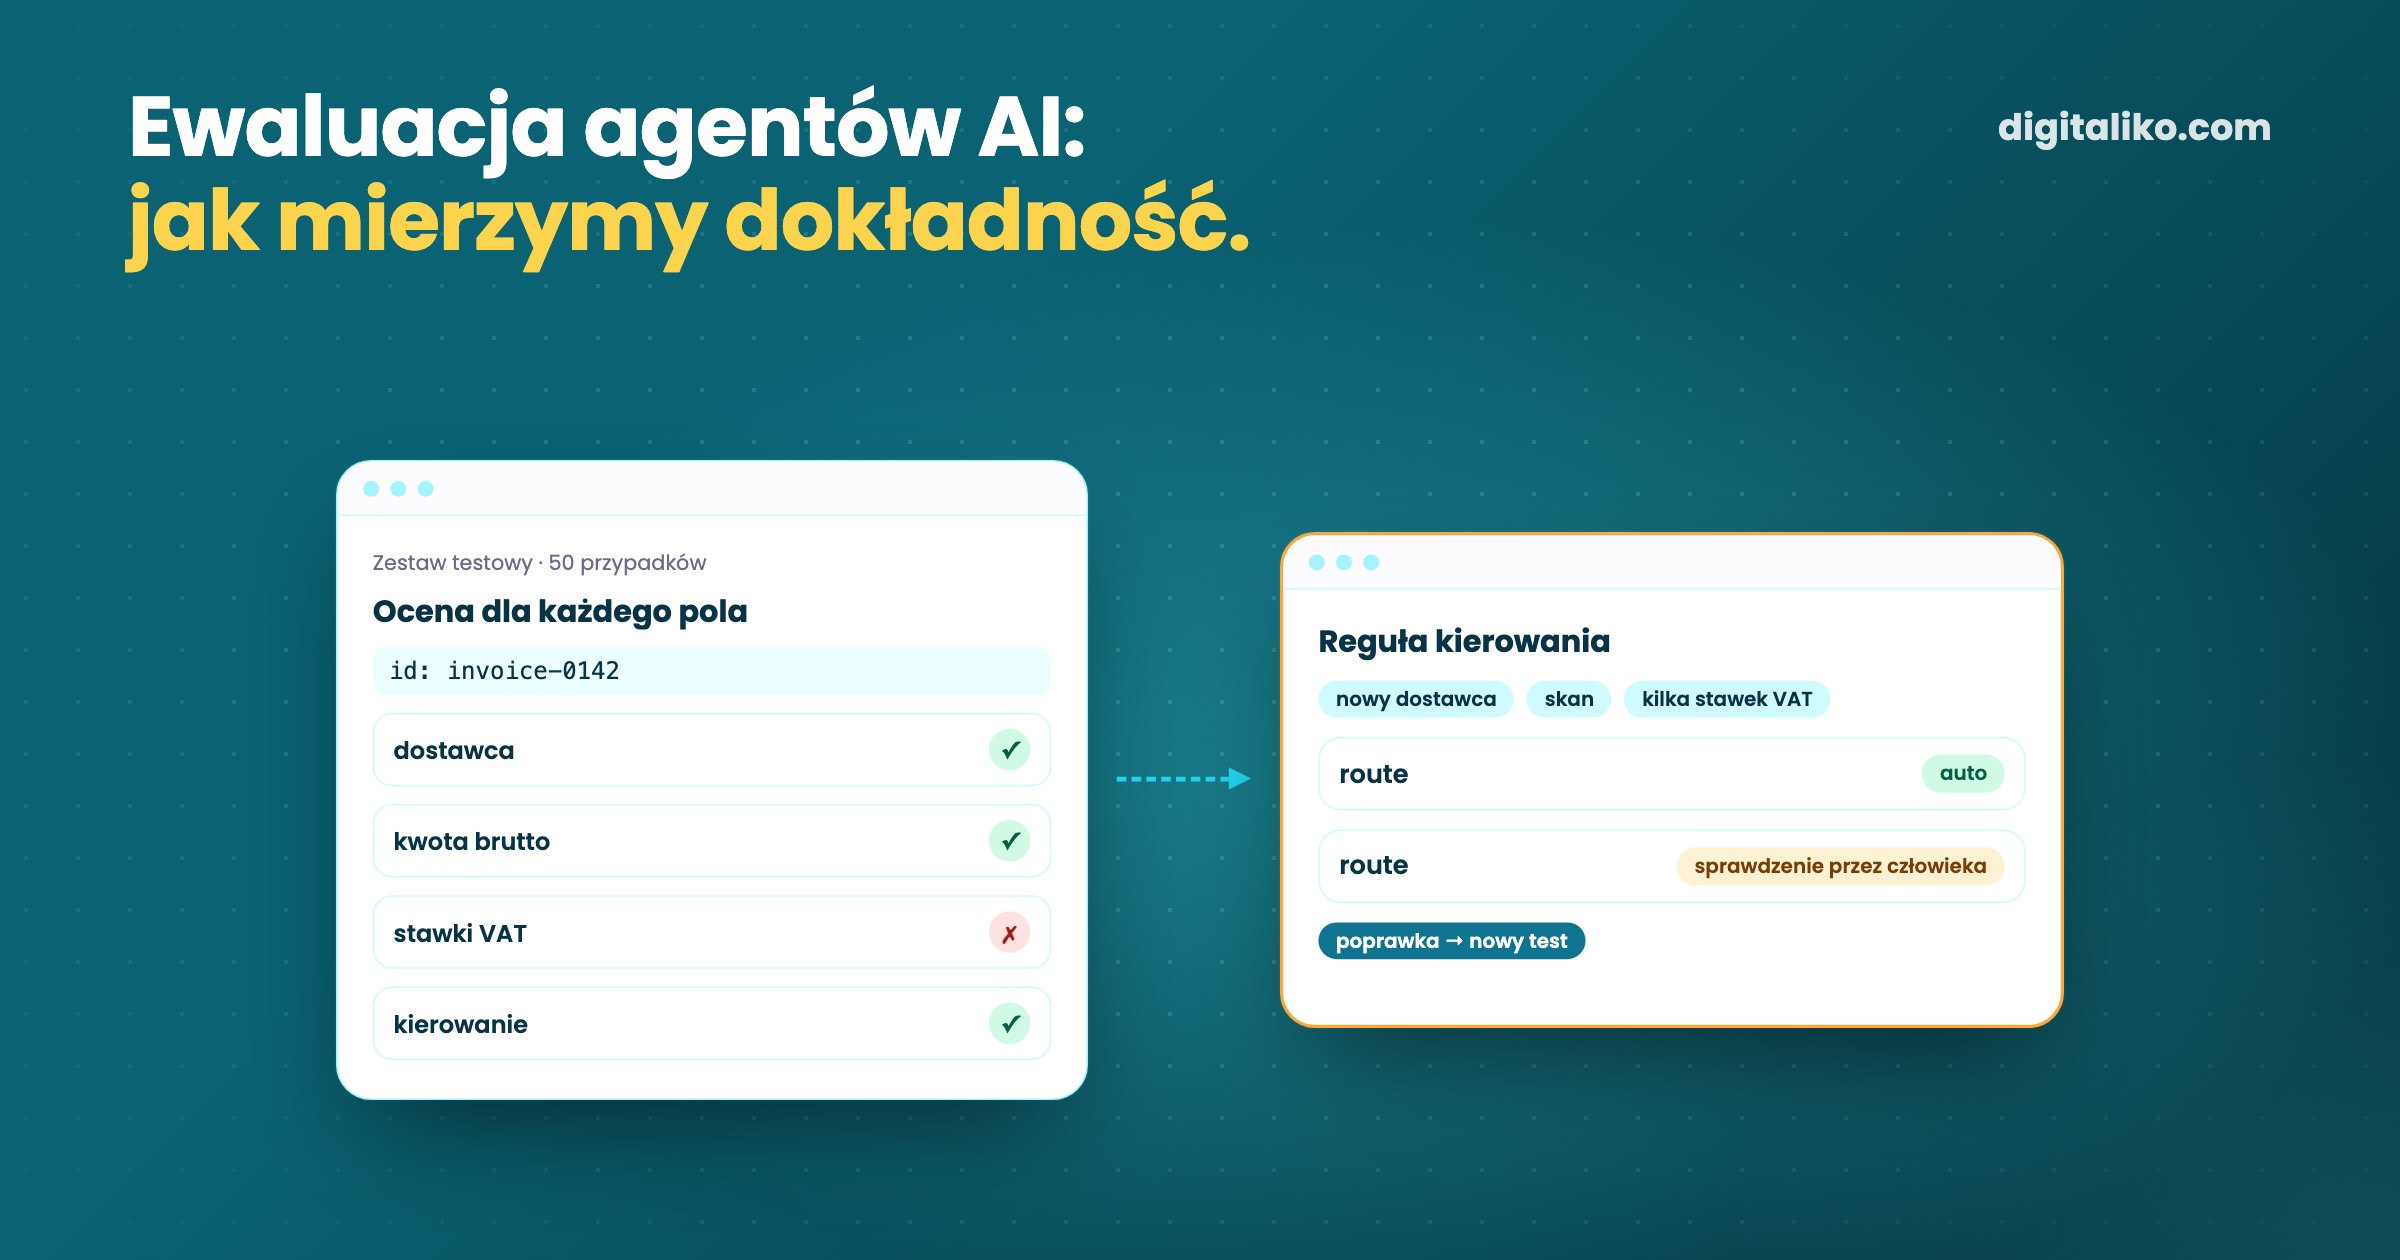
Ewaluacja agenta AI oznacza mierzenie agenta na przypadkach, dla których znają Państwo właściwą odpowiedź, przed każdą zmianą i ponownie w produkcji. Ma trzy części: zestaw testowy prawdziwych, ręcznie oznaczonych przypadków, uruchamiany przy każdej zmianie, próg dla każdego zadania ustalony przed startem, poniżej którego wszystko trafia do człowieka, oraz liczenie w produkcji tego, co ludzie musieli poprawić. Przy fakturach, które przychodzą e-mailem, w ten sposób 70 % przechodzi bez człowieka, a reszta celowo trafia do człowieka.
To techniczny artykuł dla CTO i programistów. Poniżej pokazujemy, jak wygląda każda część, z konfiguracją i kodem, oraz gdzie to się psuje.
Co mierzy ewaluacja agenta AI?
Dwie różne rzeczy w dwóch różnych momentach. Mylenie ich to najczęstszy błąd, jaki widzimy: demo, które „wyglądało dobrze”, staje się kryterium wdrożenia.
| Przed wdrożeniem (offline) | W produkcji (online) | |
|---|---|---|
| Pytanie | Czy ta zmiana poprawiła agenta, czy go pogorszyła? | Czy agent nadal wykonuje swoją pracę? |
| Dane | Stały zestaw testowy prawdziwych, ręcznie oznaczonych przypadków | Bieżące przypadki i to, co ludzie z nimi zrobili |
| Właściwa odpowiedź | Znana z góry | Znana, gdy człowiek zatwierdzi lub poprawi |
| Główna liczba | Poprawność dla każdego pola lub decyzji, na zestawie | Odsetek poprawek, udział skierowany do człowieka |
| Kiedy działa | Przy każdej zmianie promptu, modelu lub kodu | Na bieżąco, przegląd co tydzień |
Liczba offline mówi Państwu, czy wdrożyć zmianę. Liczba online mówi, czy zestaw offline nadal przypomina rzeczywistość. Gdy obie się rozjeżdżają, zestaw testowy jest nieaktualny.
Jak zbudować zestaw testowy?
Z prawdziwych przypadków, nigdy z przykładów, które programista wymyśla podczas pisania promptu. Wymyślone przypadki testują to, o czym już Państwo pomyśleli.
01
Zebrać prawdziwe przypadki
Faktury, e-maile, ogłoszenia, które agent naprawdę zobaczy, także te brzydkie: skany, wielostronicowe PDF-y, literówki.
02
Oznaczyć je ręcznie
Osoba, która zna tę pracę, zapisuje właściwą odpowiedź dla każdego pola. To powolna część i nie da się jej pominąć.
03
Dodać przypadki bez odpowiedzi
Dane wejściowe, które agent powinien odrzucić lub przekazać: zły typ dokumentu, brakujące dane, poza zakresem.
04
Oceniać dla każdego pola, kodem
Dokładne dopasowanie tam, gdzie istnieje dokładna odpowiedź. Sędzia tylko tam, gdzie ocena wymaga czytania.
05
Rozbudowywać z produkcji
Każdy przypadek poprawiony przez człowieka staje się nowym przypadkiem testowym z poprawioną odpowiedzią.
Przypadek w zestawie to zwykłe dane. Przypadek testowy może wyglądać tak:
- id: invoice-multipage-0142
  input: fixtures/invoices/0142.pdf
  expect:
    supplier_id: "12345678"      # dopasowany po NIP, nie po nazwie
    total_gross: "1 240.00"
    vat_rates: [20]
    route: auto
- id: invoice-scan-0219
  input: fixtures/invoices/0219.jpg
  expect:
    route: review                # skany z reguły trafiają do człowieka
Format i wartości są poglądowe; liczy się to, co przypadek zapisuje. Proszę zwrócić uwagę na pole route: testuje samą decyzję o kierowaniu, a nie tylko wyodrębnione wartości. Agent, który dobrze wyodrębnia dane, ale sam przepuszcza niewłaściwe przypadki, nadal jest zepsuty.
Jak wygląda zmiana na zestawie testowym?
Na internetowym marketplace'ie klienta LLM przypisuje ogłoszenia do kategorii. Nie pytaliśmy innego modelu, czy kategorie wyglądają dobrze. Ludzie ręcznie oznaczyli prawdziwe ogłoszenia, a kod policzył zgodności. Potem zmieniliśmy strukturę promptu i uruchomiliśmy ten sam zestaw ponownie:
- Dokładność kategoryzacji ogłoszeń przez AI po zmianie struktury promptu, na zestawie testowym 50 ręcznie oznaczonych ogłoszeń (wrzesień 2026)
- 84 % → 98 %
To liczba z zestawu testowego, a nie bieżąca dokładność. Mówi nam, że zmianę warto było wdrożyć. Czy produkcja to potwierdza, mierzą dwie kolejne sekcje.
Zestaw jest celowo mały. Pięćdziesiąt oznaczonych przypadków wystarcza, by zobaczyć zmianę tej wielkości, i jest ich na tyle mało, że człowiek może je oznaczyć i obejrzeć każdy błąd. Większy zestaw powstaje z produkcji, jeden poprawiony przypadek za drugim.
Jak działają progi i kierowanie do człowieka?
Przed startem proszę zapisać dla każdego zadania, które przypadki agent może zakończyć sam. Wszystko inne trafia do człowieka. Regułę warto zbudować z kontroli, które może zweryfikować kod, a nie z pewności deklarowanej przez model.
Przy fakturach, które przychodzą e-mailem, system je odczytuje i zapisuje w programie księgowym. 70 % przechodzi bez człowieka. Reszta celowo trafia do człowieka: nowy dostawca, zeskanowana faktura, więcej niż jedna stawka VAT. Uproszczona, poglądowa reguła tego typu może wyglądać tak:
type Route = 'auto' | 'review'

function route(inv: Extracted, known: SupplierIndex): Route {
  if (!known.has(inv.supplierCompanyId)) return 'review'   // nowy dostawca
  if (inv.source === 'scan') return 'review'
  if (inv.vatRates.length > 1) return 'review'
  if (!totalsAddUp(inv)) return 'review'                   // netto + VAT musi się równać brutto
  return 'auto'
}
Każda gałąź review powinna odpowiadać przypadkowi, w którym zestaw testowy pokazał błędy, albo w którym błąd kosztuje więcej niż minutę czasu człowieka. Gałąź warto luzować tylko na podstawie liczb z zestawu testowego, nigdy dlatego, że kolejka się wydłużyła.
Jak zdecydować, które kroki czekają na człowieka, i jak nie zasypać go zatwierdzeniami, opisujemy w artykule Human in the loop: kiedy agent AI powinien czekać?.
Co mierzyć w produkcji?
Nie udział przypadków, które agent „obsłużył”. Tę liczbę łatwo zawyżyć, kierując mniej do człowieka. Warto patrzeć na to, co stało się po agencie:
- Poprawki dla każdego pola. Ile pól człowiek zmienił w sprawdzanych przypadkach i których. Pole, które jest wciąż poprawiane, to kolejny przypadek testowy.
- Udział skierowany do człowieka i powód. Dla każdej reguły kierowania. Nagły skok oznacza, że zmieniły się dane wejściowe: nowy szablon dostawcy, nowy format e-maila.
- Błędy znalezione po automatycznym zatwierdzeniu. Przypadki, które przeszły same, a mimo to były błędne. To te najdroższe. Zalecamy regularne sprawdzanie próbki automatycznie zatwierdzonych przypadków; tylko tak można je zobaczyć.
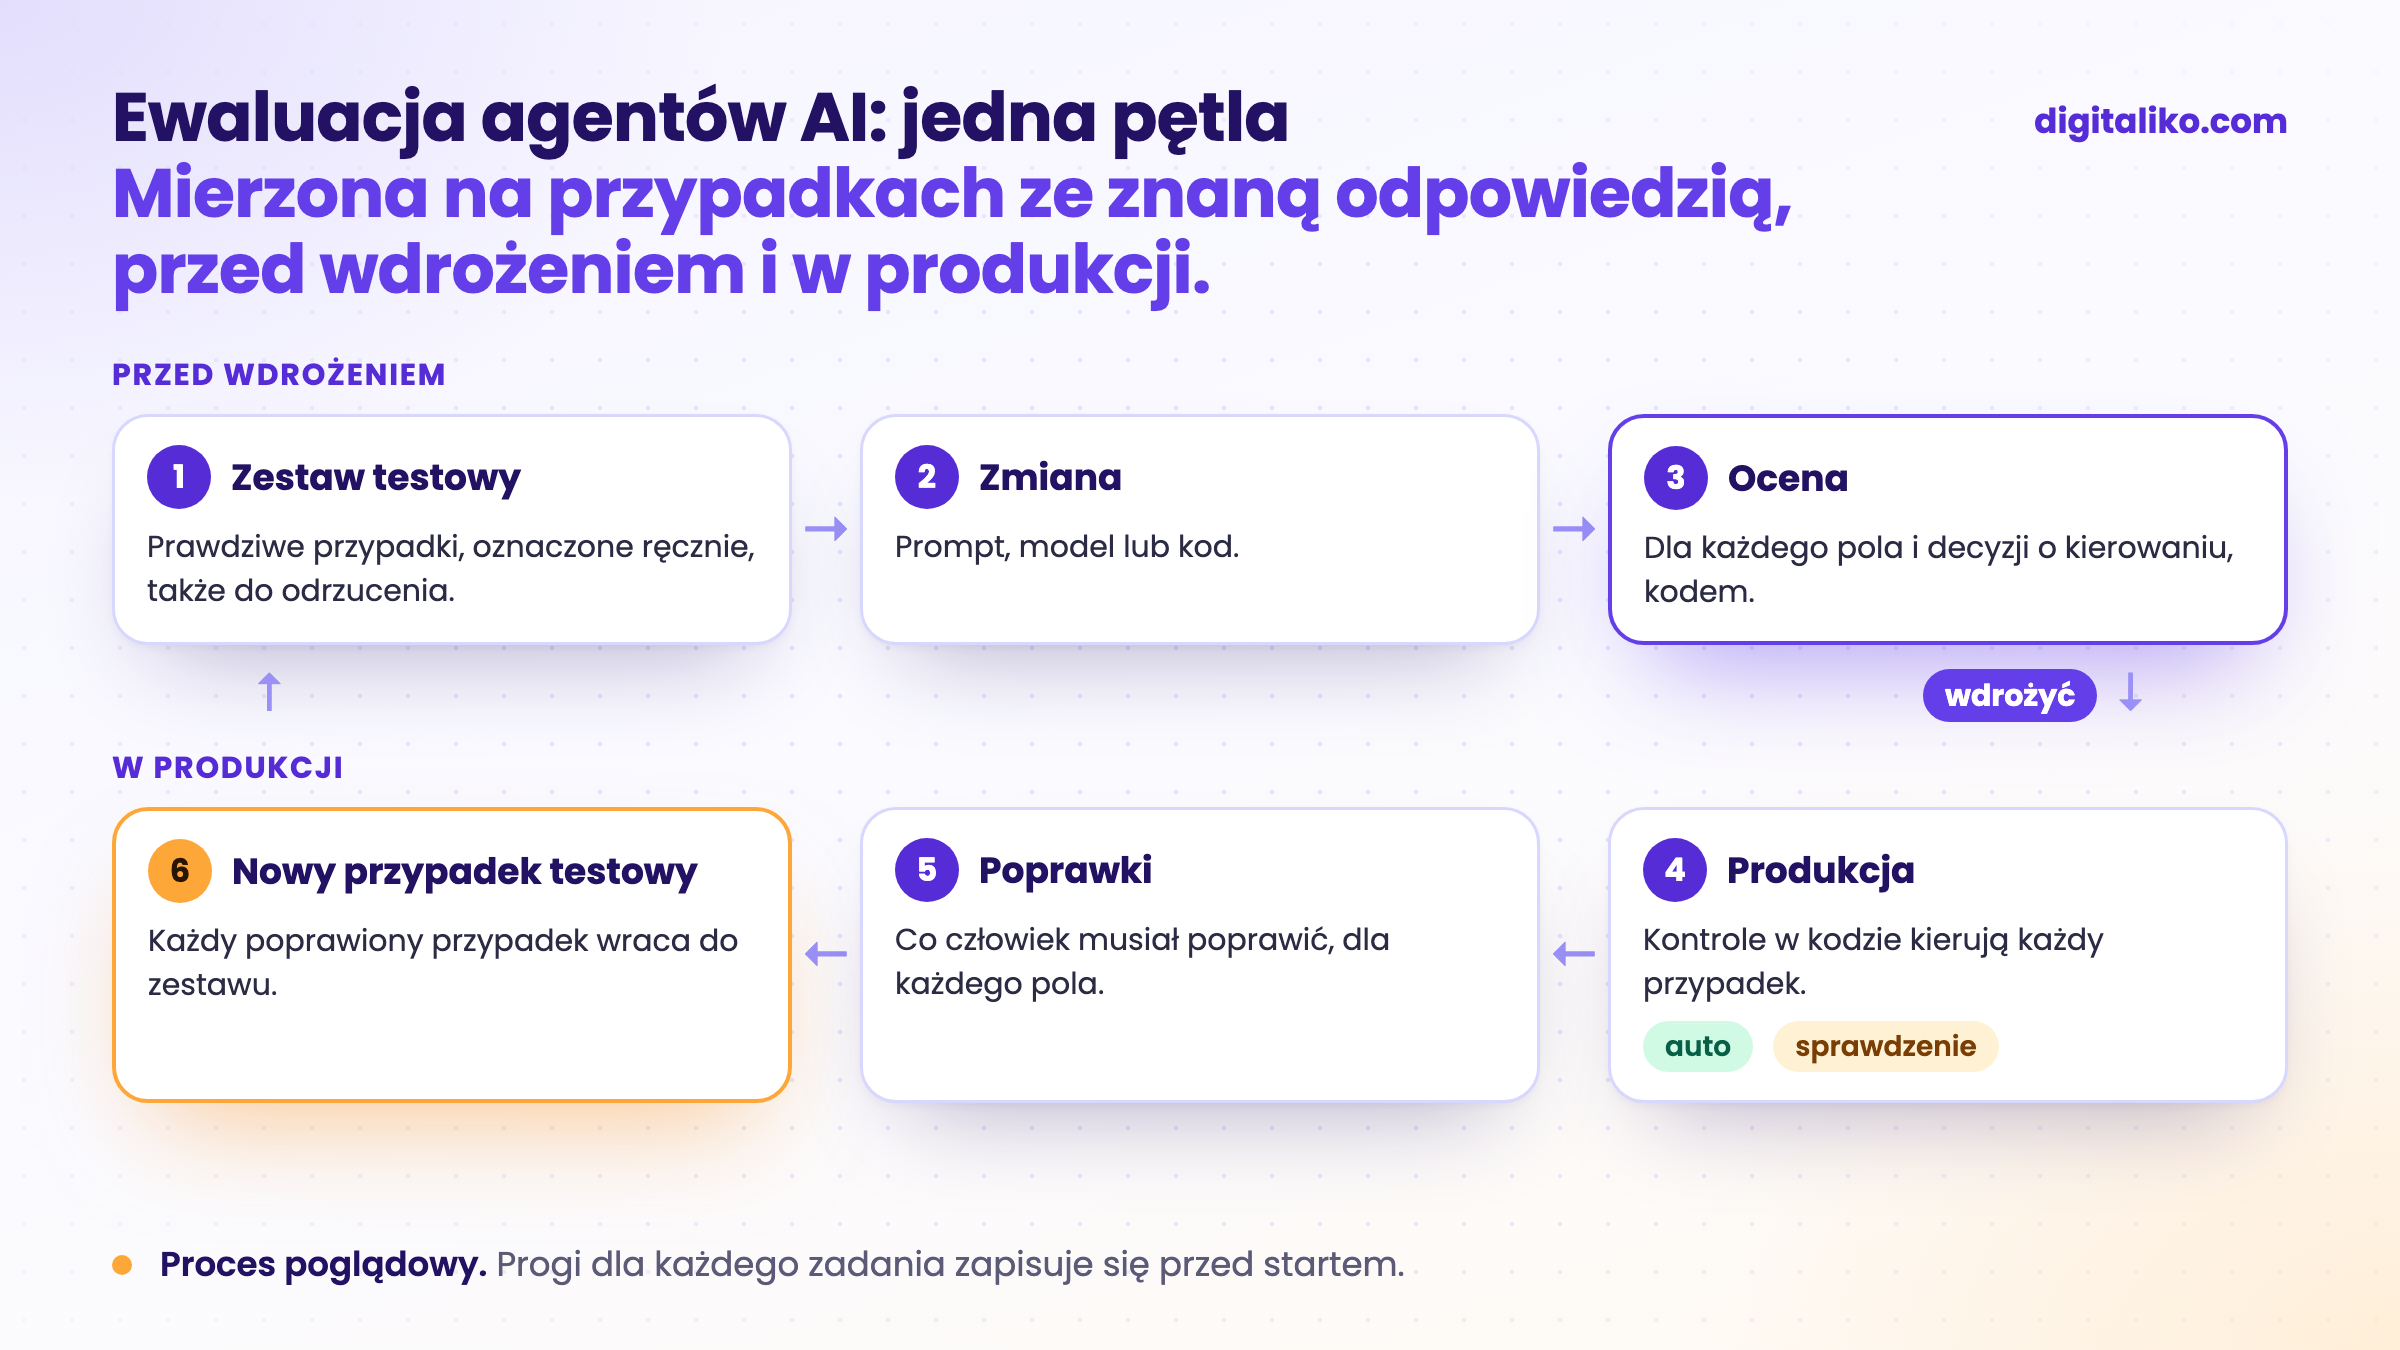
Gdy poprawki przestają spadać, problem zwykle leży w danych wejściowych, a nie w modelu. Nowy typ dokumentu albo dostawca, który zmienił szablon, pojawia się tu tygodnie, zanim ktokolwiek się poskarży.
Gdzie pasuje LLM as a judge?
Tylko tam, gdzie ocena wymaga czytania. Wyodrębnione pola, kategorie i decyzje o kierowaniu mają właściwą odpowiedź i sprawdza je kod. Sędzia dodaje tam koszt i szum. Gdzie wynikiem jest swobodny tekst, na przykład odpowiedź dla klienta, przydaje się sędzia oceniający według spisanych kryteriów, ze swoimi znanymi skrzywieniami. Jak działa nasz i w czym się mylił, opisujemy w artykule LLM as a judge: recenzent AI, który próbuje obalić pracę.
Czy ewaluacja Państwa agenta jest gotowa na produkcję?
Proszę przejść przez swoją konfigurację:
Kiedy nie budowalibyśmy tego wszystkiego
- Agent tylko przygotowuje szkice, a człowiek czyta każdy z nich. Do wdrożeń wystarczy mały zestaw testowy; liczby z produkcji i tak wynikają z poprawek.
- Przypadków jest kilka w miesiącu. Oznaczanie i reguły kierowania kosztują więcej niż ręczne sprawdzenie każdego przypadku.
- Nikt nie potrafi powiedzieć, jaka jest właściwa odpowiedź. Jeśli dwie doświadczone osoby nie zgadzają się co do oznaczenia, najpierw trzeba poprawić definicję procesu, a dopiero potem mierzyć agenta.
Chcą Państwo agenta, którego da się zmierzyć?
Budujemy agentów AI z zestawem testowym, kierowaniem i liczbami z produkcji w Państwa repozytorium, w ramach usługi agenci AI dla firm. Kod, zestaw testowy i dane należą do Państwa od pierwszego dnia.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Jaką dokładność miałby Państwa agent na 50 prawdziwych przypadkach, które sami Państwo oznaczyli?
W skrócie
- Ewaluacja offline na stałym zestawie prawdziwych, ręcznie oznaczonych przypadków, a online według tego, co ludzie musieli poprawić.
- Oceniać decyzję o kierowaniu, a nie tylko wyodrębnione wartości.
- Zapisać próg dla każdego zadania przed startem i kierować według kontroli, które może zweryfikować kod, a nie według pewności modelu.
- Nasza automatyzacja faktur: 70 % przechodzi bez człowieka, reszta celowo trafia do człowieka.
- Każdy przypadek poprawiony w produkcji staje się nowym przypadkiem testowym.
Najczęstsze pytania
Czym jest ewaluacja agenta AI?
Mierzeniem, czy agent wykonuje pracę poprawnie, na przypadkach, dla których znają Państwo właściwą odpowiedź. Przed wdrożeniem działa na stałym zestawie testowym; w produkcji mierzy się go tym, co ludzie musieli poprawić i co agent przekazał człowiekowi.
Jak duży powinien być zestaw testowy dla agenta AI?
Na tyle duży, by pokrywał rzeczywisty przekrój przypadków, także tych niewygodnych. Już kilkadziesiąt ręcznie oznaczonych prawdziwych przypadków pokazuje, czy zmiana pomaga, czy szkodzi. Rośnie z produkcji: każdy przypadek, który człowiek musiał poprawić, staje się nowym przypadkiem testowym.
Jaka dokładność agenta AI wystarczy?
Nie ma ogólnej liczby. Proszę ją ustalić dla każdego zadania przed startem, na podstawie tego, ile kosztuje błąd. Gdzie błąd jest tani, a człowiek i tak go zobaczy, wystarczy niższa poprzeczka. Gdzie trafia prosto do klienta lub do księgowości, agent sam obsługuje tylko przypadki, które robi dobrze, a resztę kieruje do człowieka.
Czym to się różni od LLM as a judge?
LLM as a judge to jeden ze sposobów oceny odpowiedzi, gdy ocena wymaga czytania i osądu. Ewaluacja to cały system wokół niego: zestaw testowy, progi, kierowanie i liczby z produkcji. Gdzie istnieje właściwa odpowiedź, sprawdza ją kod i sędzia nie jest potrzebny.
Czy można ufać wskaźnikowi pewności, który podaje model?
Nie samemu. Model może się mylić i być przy tym pewny siebie. Proszę kierować przypadki według kontroli, które może zweryfikować kod (czy suma się zgadza, czy dostawca jest znany, czy pole istnieje), i według tego, co pokazuje zestaw testowy, a nie według tego, co model mówi o sobie.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

