KI-Agenten evaluieren: wie wir die Genauigkeit messen
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer von Digitaliko
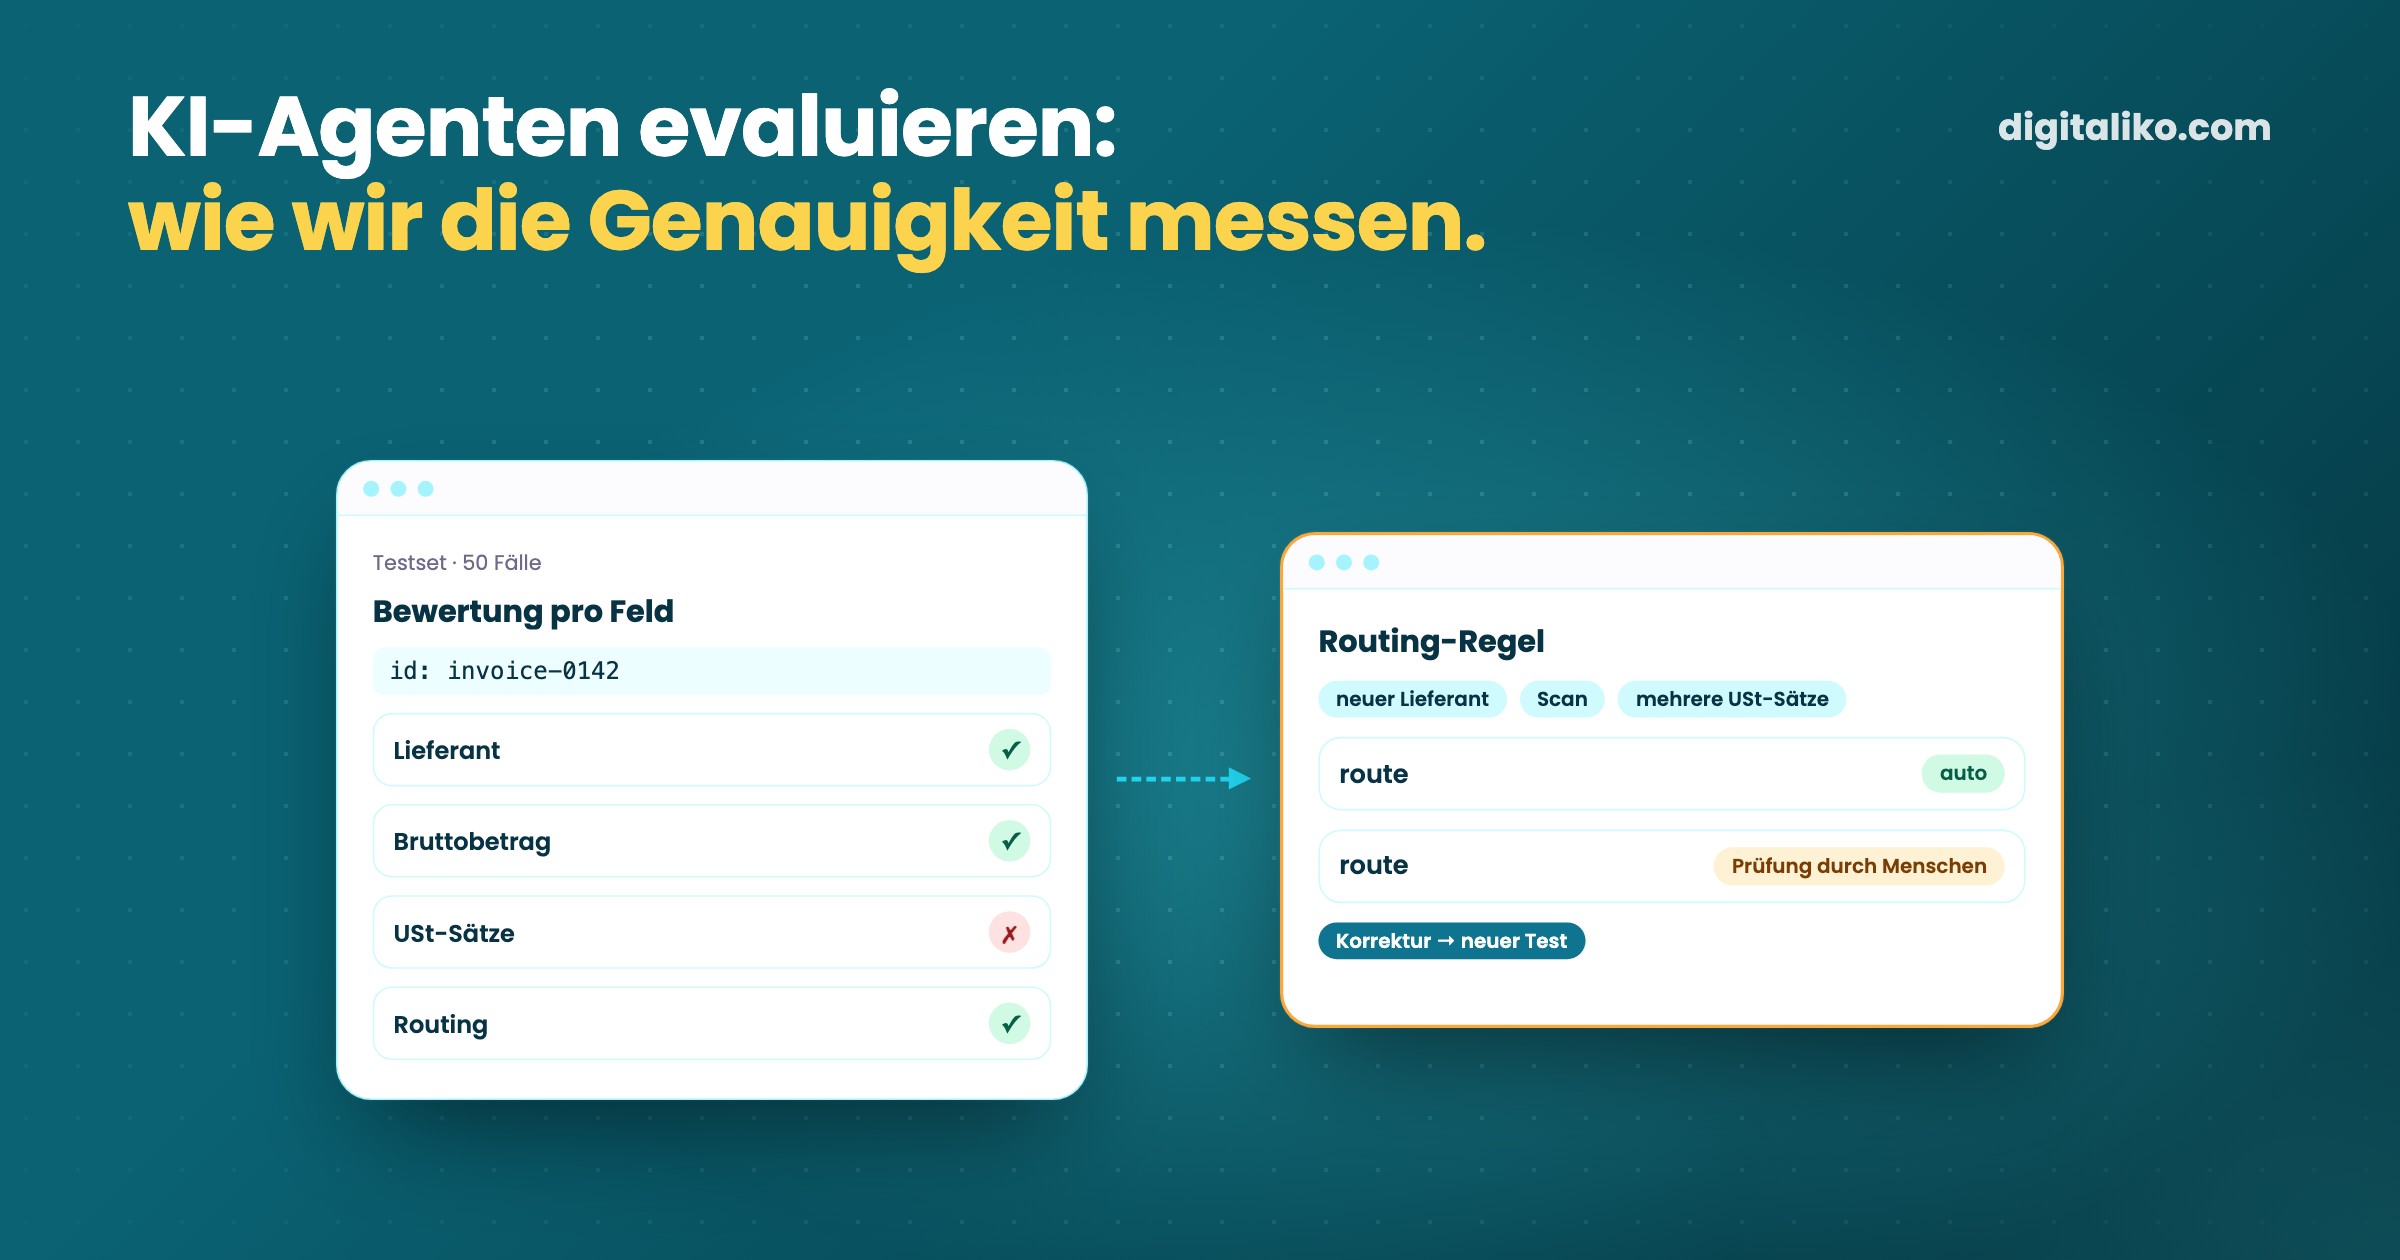
Einen KI-Agenten zu evaluieren heißt, ihn an Fällen zu messen, deren richtige Antwort Sie kennen, vor jeder Änderung und noch einmal in der Produktion. Das hat drei Teile: ein Testset aus echten, von Hand gelabelten Fällen, das bei jeder Änderung läuft, eine Schwelle pro Aufgabe, die vor dem Start feststeht und unter der alles an einen Menschen geht, und in der Produktion das Zählen dessen, was Menschen korrigieren mussten. Bei Rechnungen, die per E-Mail ankommen, gehen so 70 % ohne Menschen durch, und der Rest geht bewusst an einen Menschen.
Dies ist ein technischer Artikel für CTOs und Entwickler. Unten sehen Sie, wie jeder Teil aussieht, mit Konfiguration und Code, und wo es schiefgeht.
Was misst die Evaluation eines KI-Agenten?
Zwei verschiedene Dinge zu zwei verschiedenen Zeitpunkten. Sie zu verwechseln ist der häufigste Fehler, den wir sehen: Eine Demo, die „richtig aussah“, wird zum Release-Kriterium.
| Vor dem Release (offline) | In der Produktion (online) | |
|---|---|---|
| Frage | Hat diese Änderung den Agenten besser oder schlechter gemacht? | Erledigt der Agent seine Arbeit noch? |
| Daten | Festes Testset aus echten, von Hand gelabelten Fällen | Live-Fälle und was Menschen damit gemacht haben |
| Richtige Antwort | Vorab bekannt | Bekannt, wenn ein Mensch freigibt oder korrigiert |
| Hauptkennzahl | Richtig pro Feld oder Entscheidung, auf dem Set | Korrekturrate, Anteil an einen Menschen geroutet |
| Läuft | Bei jeder Änderung an Prompt, Modell oder Code | Laufend, wöchentlich ausgewertet |
Die Offline-Zahl sagt Ihnen, ob Sie ausliefern. Die Online-Zahl sagt Ihnen, ob das Offline-Set noch der Realität entspricht. Wenn beide auseinanderlaufen, ist das Testset veraltet.
Wie baut man das Testset?
Aus echten Fällen, nie aus Beispielen, die sich ein Entwickler beim Schreiben des Prompts ausdenkt. Ausgedachte Fälle testen, woran Sie schon gedacht haben.
01
Echte Fälle sammeln
Rechnungen, E-Mails, Inserate, die der Agent wirklich sehen wird, auch die hässlichen: Scans, mehrseitige PDFs, Tippfehler.
02
Von Hand labeln
Jemand, der die Arbeit kennt, schreibt die richtige Antwort pro Feld auf. Das ist der langsame Teil, und er lässt sich nicht überspringen.
03
Fälle ohne Antwort ergänzen
Eingaben, die der Agent ablehnen oder übergeben soll: falscher Dokumenttyp, fehlende Daten, außerhalb des Umfangs.
04
Pro Feld bewerten, per Code
Exakter Abgleich, wo es eine exakte Antwort gibt. Ein Judge nur dort, wo die Bewertung Lesen braucht.
05
Aus der Produktion erweitern
Jeder Fall, den ein Mensch korrigiert hat, wird ein neuer Testfall mit der korrigierten Antwort.
Ein Fall im Set ist einfach Daten. Ein Testfall kann so aussehen:
- id: invoice-multipage-0142
  input: fixtures/invoices/0142.pdf
  expect:
    supplier_id: "12345678"      # per Firmennummer zugeordnet, nicht per Name
    total_gross: "1 240.00"
    vat_rates: [20]
    route: auto
- id: invoice-scan-0219
  input: fixtures/invoices/0219.jpg
  expect:
    route: review                # Scans gehen per Regel an einen Menschen
Format und Werte sind illustrativ; entscheidend ist, was ein Fall festhält. Beachten Sie das Feld route: Es testet die Routing-Entscheidung selbst, nicht nur die extrahierten Werte. Ein Agent, der gut extrahiert, aber die falschen Fälle allein durchlässt, ist trotzdem kaputt.
Wie sieht eine Änderung auf dem Testset aus?
Für den Online-Marktplatz eines Kunden sortiert ein LLM Inserate in Kategorien. Wir haben kein anderes Modell gefragt, ob die Kategorien richtig aussehen. Menschen haben echte Inserate von Hand gelabelt, und Code hat die Treffer gezählt. Dann haben wir die Struktur des Prompts geändert und dasselbe Set noch einmal laufen lassen:
- Genauigkeit der KI-Kategorisierung von Inseraten nach einer Änderung der Prompt-Struktur, auf einem Testset von 50 von Hand gelabelten Inseraten (September 2026)
- 84 % → 98 %
Das ist eine Testset-Zahl, keine Live-Genauigkeit. Sie sagt uns, dass sich das Ausliefern der Änderung gelohnt hat. Ob die Produktion mithält, messen die nächsten beiden Abschnitte.
Das Set ist absichtlich klein. Fünfzig gelabelte Fälle reichen, um eine Änderung dieser Größe zu sehen, und sind wenig genug, damit ein Mensch sie labeln und sich jeden Fehler ansehen kann. Ein größeres Set entsteht aus der Produktion, ein korrigierter Fall nach dem anderen.
Wie funktionieren Schwellen und Routing an einen Menschen?
Legen Sie vor dem Start pro Aufgabe schriftlich fest, welche Fälle der Agent allein abschließen darf. Alles andere geht an einen Menschen. Bauen Sie die Regel aus Prüfungen, die Code verifizieren kann, nicht aus der Selbsteinschätzung des Modells.
Bei Rechnungen, die per E-Mail ankommen, liest das System sie und schreibt sie in die Buchhaltungssoftware. 70 % gehen ohne Menschen durch. Der Rest geht bewusst an einen Menschen: ein neuer Lieferant, eine gescannte Rechnung, mehr als ein Umsatzsteuersatz. Eine vereinfachte, illustrative Regel dieser Art kann so aussehen:
type Route = 'auto' | 'review'

function route(inv: Extracted, known: SupplierIndex): Route {
  if (!known.has(inv.supplierCompanyId)) return 'review'   // neuer Lieferant
  if (inv.source === 'scan') return 'review'
  if (inv.vatRates.length > 1) return 'review'
  if (!totalsAddUp(inv)) return 'review'                   // Netto + USt muss Brutto ergeben
  return 'auto'
}
Jeder review-Zweig sollte für einen Fall stehen, bei dem das Testset Fehler gezeigt hat oder bei dem ein Fehler mehr kostet als eine Minute Arbeitszeit eines Menschen. Lockern Sie einen Zweig nur auf Basis der Testset-Zahlen, nie, weil die Warteschlange lang geworden ist.
Wie Sie entscheiden, welche Schritte auf einen Menschen warten, und wie Sie ihn nicht in Freigaben ertränken, steht in Human in the Loop: wann ein KI-Agent warten soll.
Was sollten Sie in der Produktion messen?
Nicht den Anteil der Fälle, die der Agent „erledigt“ hat. Diese Zahl lässt sich leicht aufblähen, indem man weniger an Menschen routet. Schauen Sie darauf, was nach dem Agenten passiert ist:
- Korrekturen pro Feld. Wie viele Felder hat ein Mensch in den geprüften Fällen geändert, und welche. Ein Feld, das immer wieder korrigiert wird, ist der nächste Testfall.
- Anteil an einen Menschen geroutet, und warum. Pro Routing-Regel. Ein plötzlicher Sprung heißt, dass sich die Eingabe geändert hat: eine neue Lieferantenvorlage, ein neues E-Mail-Format.
- Fehler nach automatischer Freigabe. Fälle, die allein durchgingen und trotzdem falsch waren. Das sind die teuren. Wir empfehlen, regelmäßig eine Stichprobe automatisch freigegebener Fälle zu prüfen; nur so sehen Sie sie.
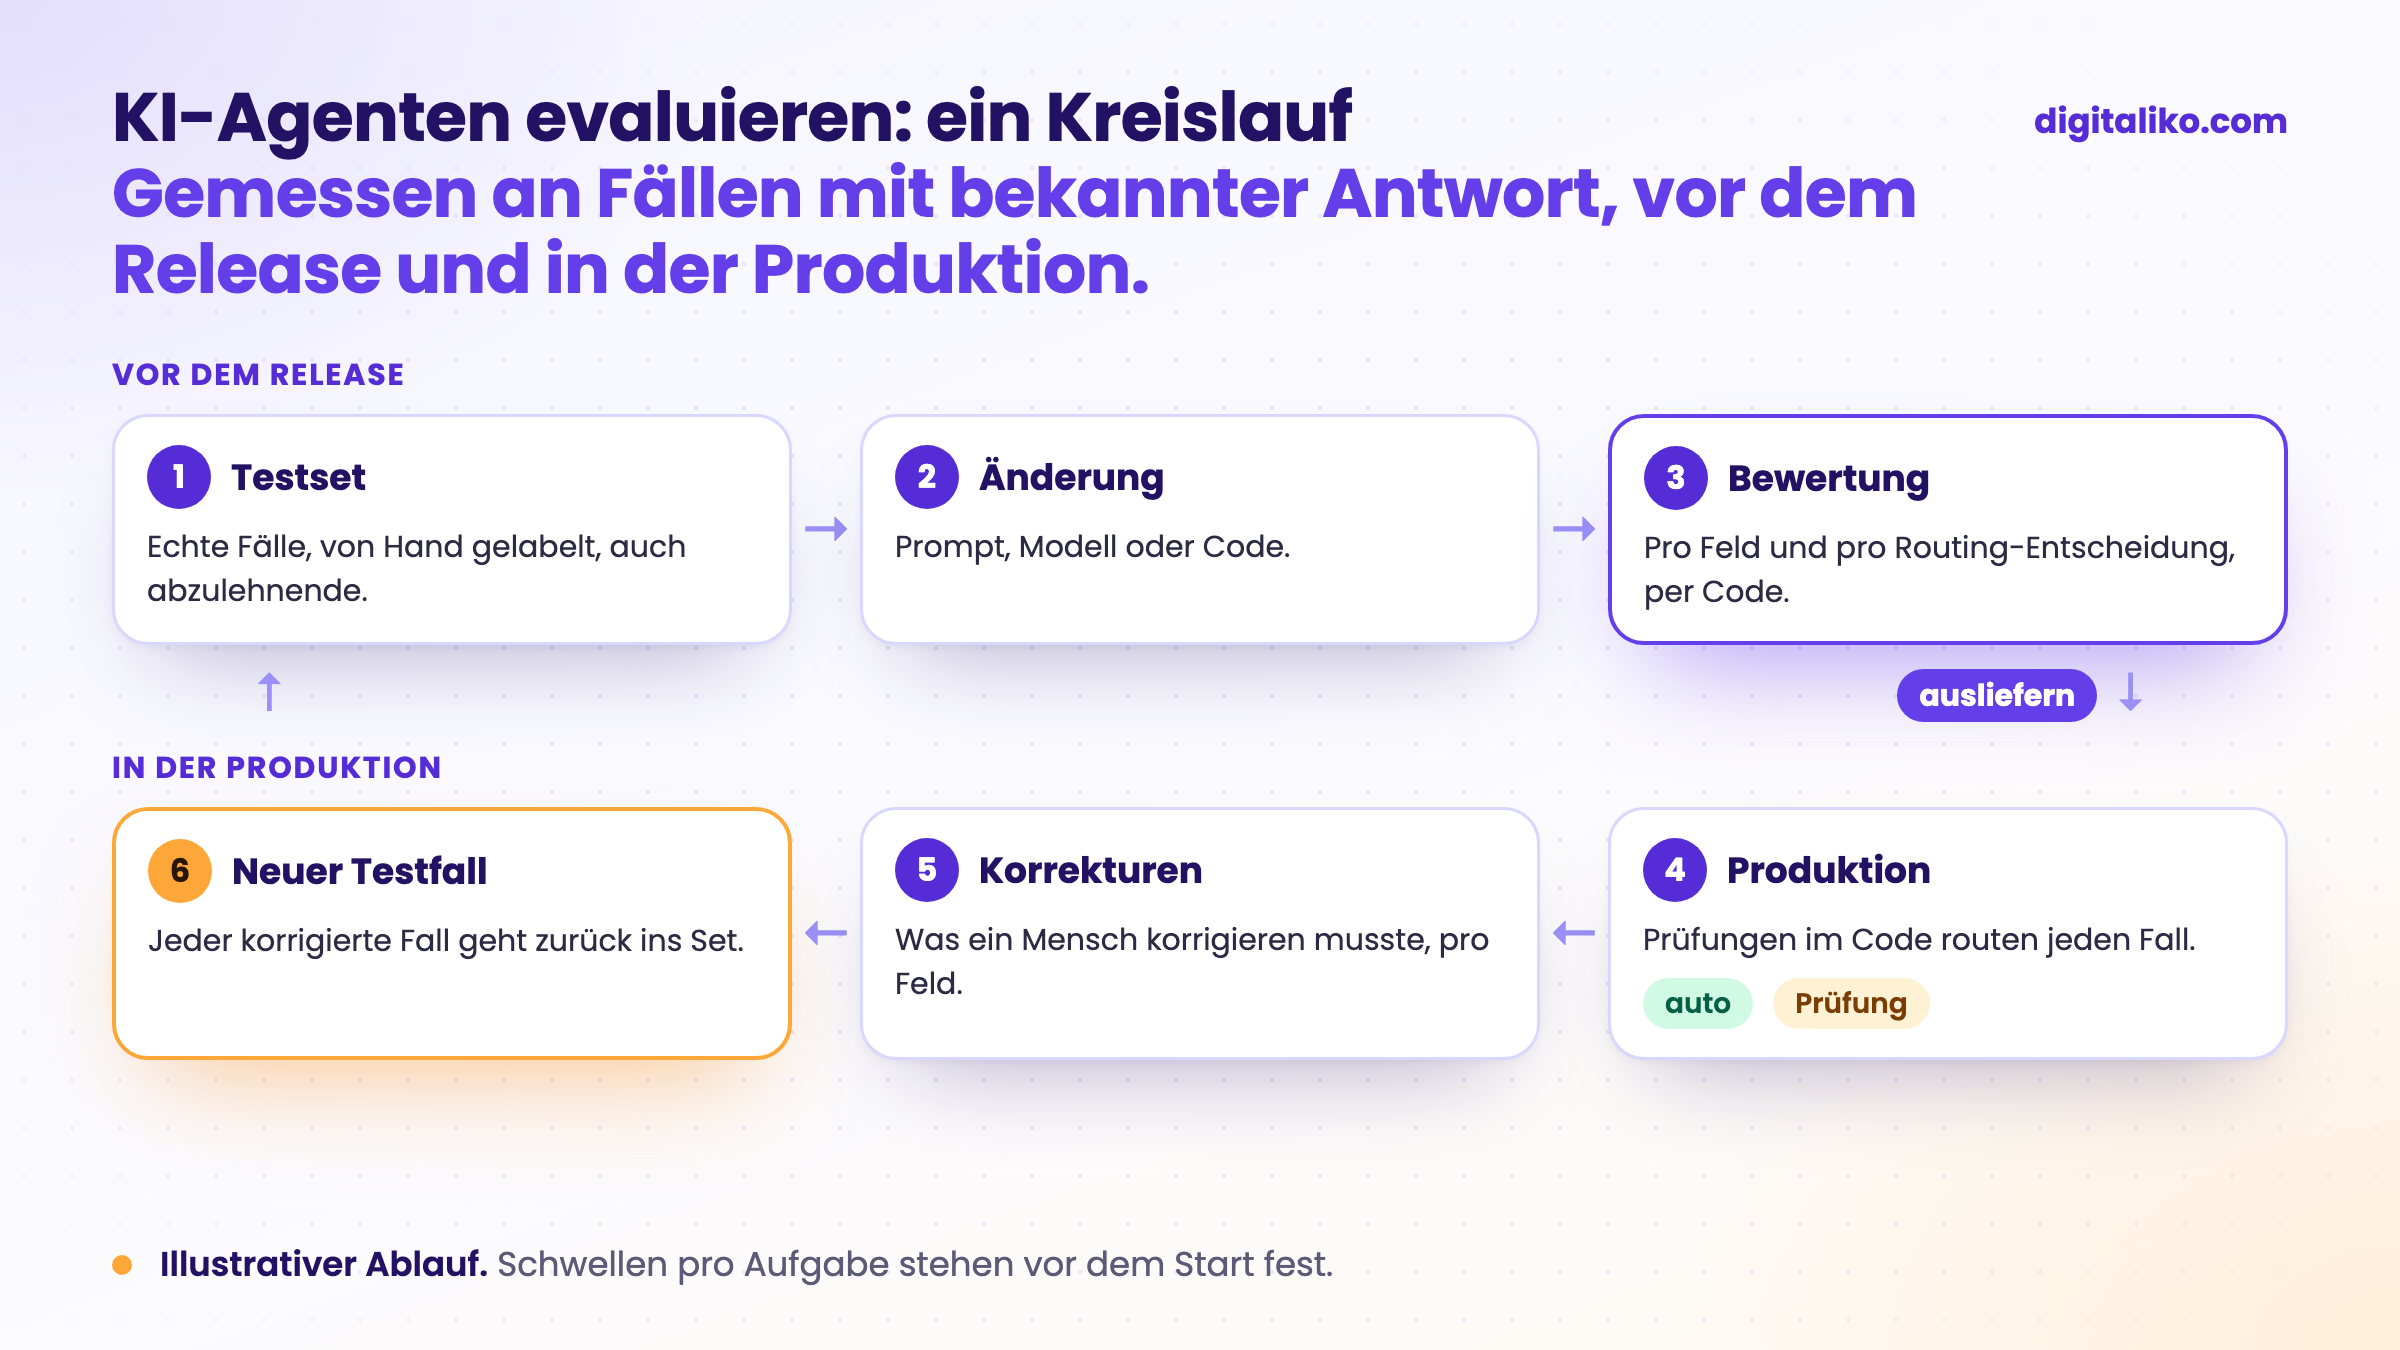
Wenn die Korrekturen nicht mehr sinken, liegt das Problem meist in den Eingaben, nicht im Modell. Ein neuer Dokumenttyp oder ein Lieferant, der seine Vorlage geändert hat, zeigt sich hier Wochen, bevor sich jemand beschwert.
Wo passt LLM as a Judge hinein?
Nur dort, wo die Bewertung Lesen braucht. Extrahierte Felder, Kategorien und Routing-Entscheidungen haben eine richtige Antwort, und Code prüft sie. Ein Judge bringt dort Kosten und Rauschen. Wo die Ausgabe freier Text ist, etwa eine Antwort an einen Kunden, ist ein Judge, der nach schriftlichen Kriterien bewertet, nützlich, mit seinen bekannten Verzerrungen. Wie unserer funktioniert und was er falsch gemacht hat, steht in LLM as a Judge: KI-Reviewer, der die Arbeit widerlegen soll.
Ist die Evaluation Ihres Agenten bereit für die Produktion?
Gehen Sie Ihr Setup durch:
Wann wir das alles nicht bauen würden
- Der Agent erstellt nur Entwürfe, und ein Mensch liest jeden. Für Releases reicht ein kleines Testset; die Produktionszahlen kommen ohnehin aus den Änderungen.
- Es gibt nur eine Handvoll Fälle im Monat. Labeln und Routing-Regeln kosten mehr, als jeden Fall von Hand zu prüfen.
- Niemand kann sagen, was die richtige Antwort ist. Wenn zwei erfahrene Menschen sich beim Label nicht einig sind, klären Sie zuerst die Definition des Prozesses, bevor Sie den Agenten messen.
Sie wollen einen Agenten, den man messen kann?
Wir bauen KI-Agenten mit Testset, Routing und Produktionszahlen in Ihrem Repository, als Teil von KI-Agenten für Unternehmen. Code, Testset und Daten gehören Ihnen ab dem ersten Tag.
Wir melden uns innerhalb von zwei Arbeitstagen mit ein paar Fragen zu Ihrer Arbeit. Dann vereinbaren wir, was wir zuerst angehen.
Wenn Sie lieber zuerst sprechen möchten, buchen Sie ein 15-minütiges Erstgespräch.
Wie genau wäre Ihr Agent auf 50 echten Fällen, die Sie selbst gelabelt haben?
Kurz gesagt
- Evaluieren Sie offline auf einem festen Set echter, von Hand gelabelter Fälle und online danach, was Menschen korrigieren mussten.
- Bewerten Sie die Routing-Entscheidung, nicht nur die extrahierten Werte.
- Legen Sie die Schwelle pro Aufgabe vor dem Start fest und routen Sie nach Prüfungen, die Code verifizieren kann, nicht nach der Konfidenz des Modells.
- Unsere Rechnungsautomatisierung: 70 % gehen ohne Menschen durch, der Rest geht bewusst an einen Menschen.
- Jeder korrigierte Fall aus der Produktion wird ein neuer Testfall.
Häufige Fragen
Was bedeutet es, einen KI-Agenten zu evaluieren?
Messen, ob ein Agent die Arbeit richtig erledigt, an Fällen, deren richtige Antwort Sie kennen. Vor dem Release läuft er gegen ein festes Testset; in der Produktion wird gemessen, was Menschen korrigieren mussten und was der Agent an einen Menschen übergeben hat.
Wie groß sollte ein Testset für einen KI-Agenten sein?
Groß genug, um die echte Mischung der Fälle abzudecken, auch die unangenehmen. Schon einige Dutzend von Hand gelabelte echte Fälle zeigen, ob eine Änderung hilft oder schadet. Es wächst aus der Produktion: Jeder Fall, den ein Mensch korrigieren musste, wird zu einem neuen Testfall.
Welche Genauigkeit reicht für einen KI-Agenten?
Eine allgemeine Zahl gibt es nicht. Legen Sie sie pro Aufgabe vor dem Start fest, danach, was ein Fehler kostet. Wo ein Fehler billig ist und ein Mensch ihn ohnehin sieht, reicht eine niedrigere Latte. Wo er direkt beim Kunden oder in der Buchhaltung landet, erledigt der Agent allein nur die Fälle, die er richtig macht, und gibt den Rest an einen Menschen.
Was ist der Unterschied zu LLM as a Judge?
LLM as a Judge ist eine Möglichkeit, eine Antwort zu bewerten, wenn die Bewertung Lesen und Urteilsvermögen braucht. Evaluation ist das ganze System darum herum: Testset, Schwellen, Routing und die Zahlen aus dem Betrieb. Wo es eine richtige Antwort gibt, prüft sie Code, und es braucht keinen Judge.
Kann man dem Konfidenzwert des Modells vertrauen?
Nicht für sich allein. Ein Modell kann sich sicher und trotzdem falsch sein. Routen Sie nach Prüfungen, die Code verifizieren kann (stimmt die Summe, ist der Lieferant bekannt, ist das Feld vorhanden), und nach dem, was Ihr Testset zeigt, nicht nach dem, was das Modell über sich selbst sagt.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity

