Evaluación de agentes de IA: cómo medimos la precisión
Para CTO y desarrolladoresHarness y controles · Actualizado

Filip PapranecFundador de Digitaliko
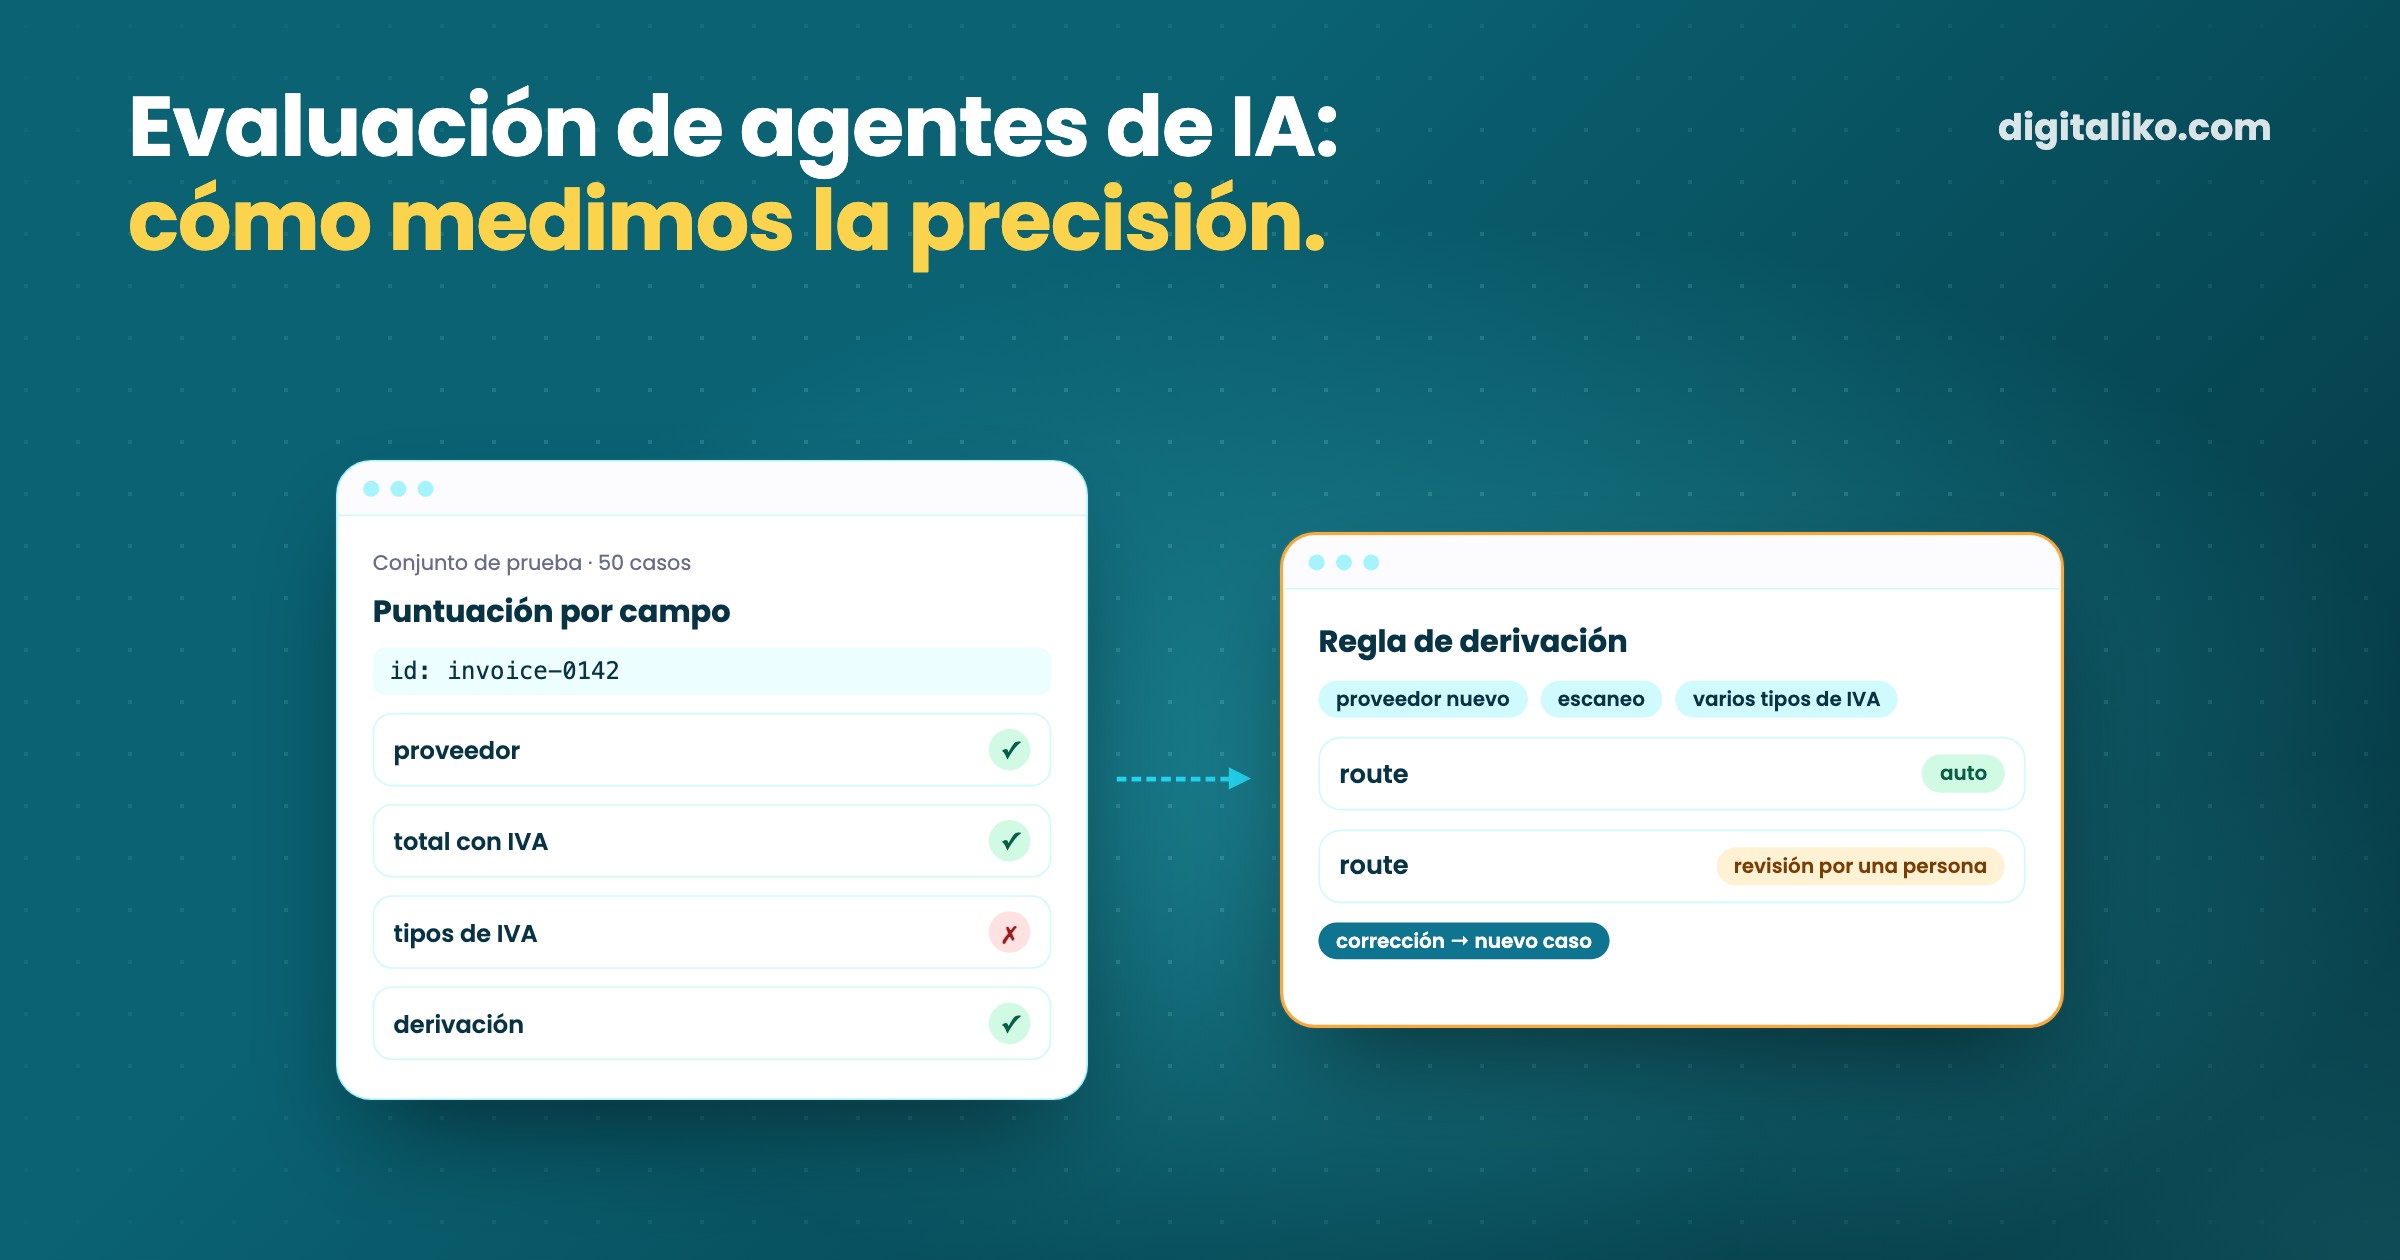
Evaluar un agente de IA significa medirlo en casos cuya respuesta correcta usted conoce, antes de cada cambio y de nuevo en producción. Tiene tres partes: un conjunto de prueba de casos reales etiquetados a mano que se ejecuta en cada cambio, un umbral por tarea fijado antes del lanzamiento por debajo del cual todo va a una persona, y en producción contar lo que las personas tuvieron que corregir. Con las facturas que llegan por correo electrónico, así el 70 % pasa sin ninguna persona, y el resto va a una persona a propósito.
Este es un artículo técnico para CTO y desarrolladores. A continuación verá cómo es cada parte, con configuración y código, y dónde falla.
¿Qué mide la evaluación de un agente de IA?
Dos cosas distintas, en dos momentos distintos. Confundirlas es el error más común que vemos: una demo que «parecía bien» se convierte en el criterio de lanzamiento.
| Antes del lanzamiento (offline) | En producción (online) | |
|---|---|---|
| Pregunta | ¿Este cambio ha mejorado o empeorado al agente? | ¿Sigue el agente haciendo su trabajo? |
| Datos | Conjunto de prueba fijo de casos reales etiquetados a mano | Casos reales en vivo y lo que las personas hicieron con ellos |
| Respuesta correcta | Conocida de antemano | Conocida cuando una persona aprueba o corrige |
| Cifra principal | Aciertos por campo o decisión, en el conjunto | Tasa de correcciones, proporción derivada a una persona |
| Se ejecuta | En cada cambio de prompt, modelo o código | De forma continua, revisión semanal |
La cifra offline le dice si lanzar. La cifra online le dice si el conjunto offline sigue pareciéndose a la realidad. Cuando las dos se separan, el conjunto de prueba está desactualizado.
¿Cómo se construye el conjunto de prueba?
A partir de casos reales, nunca de ejemplos que un desarrollador se inventa mientras escribe el prompt. Los casos inventados prueban lo que usted ya había pensado.
01
Reúna casos reales
Facturas, correos, anuncios que el agente verá de verdad, también los feos: escaneos, PDF de varias páginas, erratas.
02
Etiquételos a mano
Una persona que conoce el trabajo escribe la respuesta correcta por campo. Es la parte lenta y no se puede saltar.
03
Añada los casos sin respuesta
Entradas que el agente debe rechazar o pasar: tipo de documento equivocado, datos que faltan, fuera de alcance.
04
Puntúe por campo, con código
Coincidencia exacta donde existe una respuesta exacta. Un juez solo donde la calificación requiere lectura.
05
Hágalo crecer desde producción
Cada caso que una persona corrigió se convierte en un nuevo caso de prueba con la respuesta corregida.
Un caso del conjunto son datos simples. Un caso de prueba puede tener este aspecto:
- id: invoice-multipage-0142
  input: fixtures/invoices/0142.pdf
  expect:
    supplier_id: "12345678"      # emparejado por NIF, no por nombre
    total_gross: "1 240.00"
    vat_rates: [20]
    route: auto
- id: invoice-scan-0219
  input: fixtures/invoices/0219.jpg
  expect:
    route: review                # los escaneos van a una persona por regla
El formato y los valores son ilustrativos; lo importante es lo que registra cada caso. Fíjese en el campo route: prueba la propia decisión de derivación, no solo los valores extraídos. Un agente que extrae bien pero deja pasar solos los casos equivocados sigue roto.
¿Cómo se ve un cambio en el conjunto de prueba?
Para el marketplace online de un cliente, un LLM clasifica anuncios en categorías. No le preguntamos a otro modelo si las categorías parecían correctas. Unas personas etiquetaron a mano anuncios reales y el código contó los aciertos. Después cambiamos la estructura del prompt y ejecutamos de nuevo el mismo conjunto:
- Precisión de la clasificación de anuncios con IA tras un cambio en la estructura del prompt, en un conjunto de prueba de 50 anuncios etiquetados a mano (septiembre de 2026)
- 84 % → 98 %
Es una cifra del conjunto de prueba, no la precisión en vivo. Nos dice que merecía la pena lanzar el cambio. Si la producción aguanta es lo que miden las dos secciones siguientes.
El conjunto es pequeño a propósito. Cincuenta casos etiquetados bastan para ver un cambio de ese tamaño, y son pocos para que una persona los etiquete y revise cada fallo. Un conjunto más grande sale de producción, un caso corregido tras otro.
¿Cómo funcionan los umbrales y la derivación a una persona?
Antes del lanzamiento, deje por escrito para cada tarea qué casos puede terminar el agente por su cuenta. Todo lo demás va a una persona. Construya la regla con comprobaciones que el código puede verificar, no con la confianza que declara el modelo.
Con las facturas que llegan por correo electrónico, el sistema las lee y las registra en el programa de contabilidad. El 70 % pasa sin ninguna persona. El resto va a una persona a propósito: un proveedor nuevo, una factura escaneada, más de un tipo de IVA. Una regla simplificada e ilustrativa de este tipo puede tener este aspecto:
type Route = 'auto' | 'review'

function route(inv: Extracted, known: SupplierIndex): Route {
  if (!known.has(inv.supplierCompanyId)) return 'review'   // proveedor nuevo
  if (inv.source === 'scan') return 'review'
  if (inv.vatRates.length > 1) return 'review'
  if (!totalsAddUp(inv)) return 'review'                   // base + IVA debe ser igual al total
  return 'auto'
}
Cada rama review debería corresponder a un caso en el que el conjunto de prueba mostró errores, o en el que un error cuesta más de un minuto del tiempo de una persona. Afloje una rama solo con cifras del conjunto de prueba, nunca porque la cola se haya alargado.
Cómo decidir qué pasos esperan a una persona, y cómo no ahogarla en aprobaciones, está en Human in the loop: ¿cuándo debe esperar un agente de IA?.
¿Qué debe medir en producción?
No la proporción de casos que el agente «resolvió». Esa cifra es fácil de inflar derivando menos. Mire lo que pasó después del agente:
- Correcciones por campo. De los casos que una persona revisó, cuántos campos cambió y cuáles. Un campo que se corrige una y otra vez es el siguiente caso de prueba.
- Proporción derivada a una persona, y por qué. Por regla de derivación. Un salto repentino significa que la entrada cambió: una nueva plantilla de proveedor, un nuevo formato de correo.
- Errores encontrados tras la aprobación automática. Casos que pasaron solos y aun así eran incorrectos. Son los caros. Recomendamos revisar con regularidad una muestra de los casos aprobados automáticamente; es la única forma de verlos.
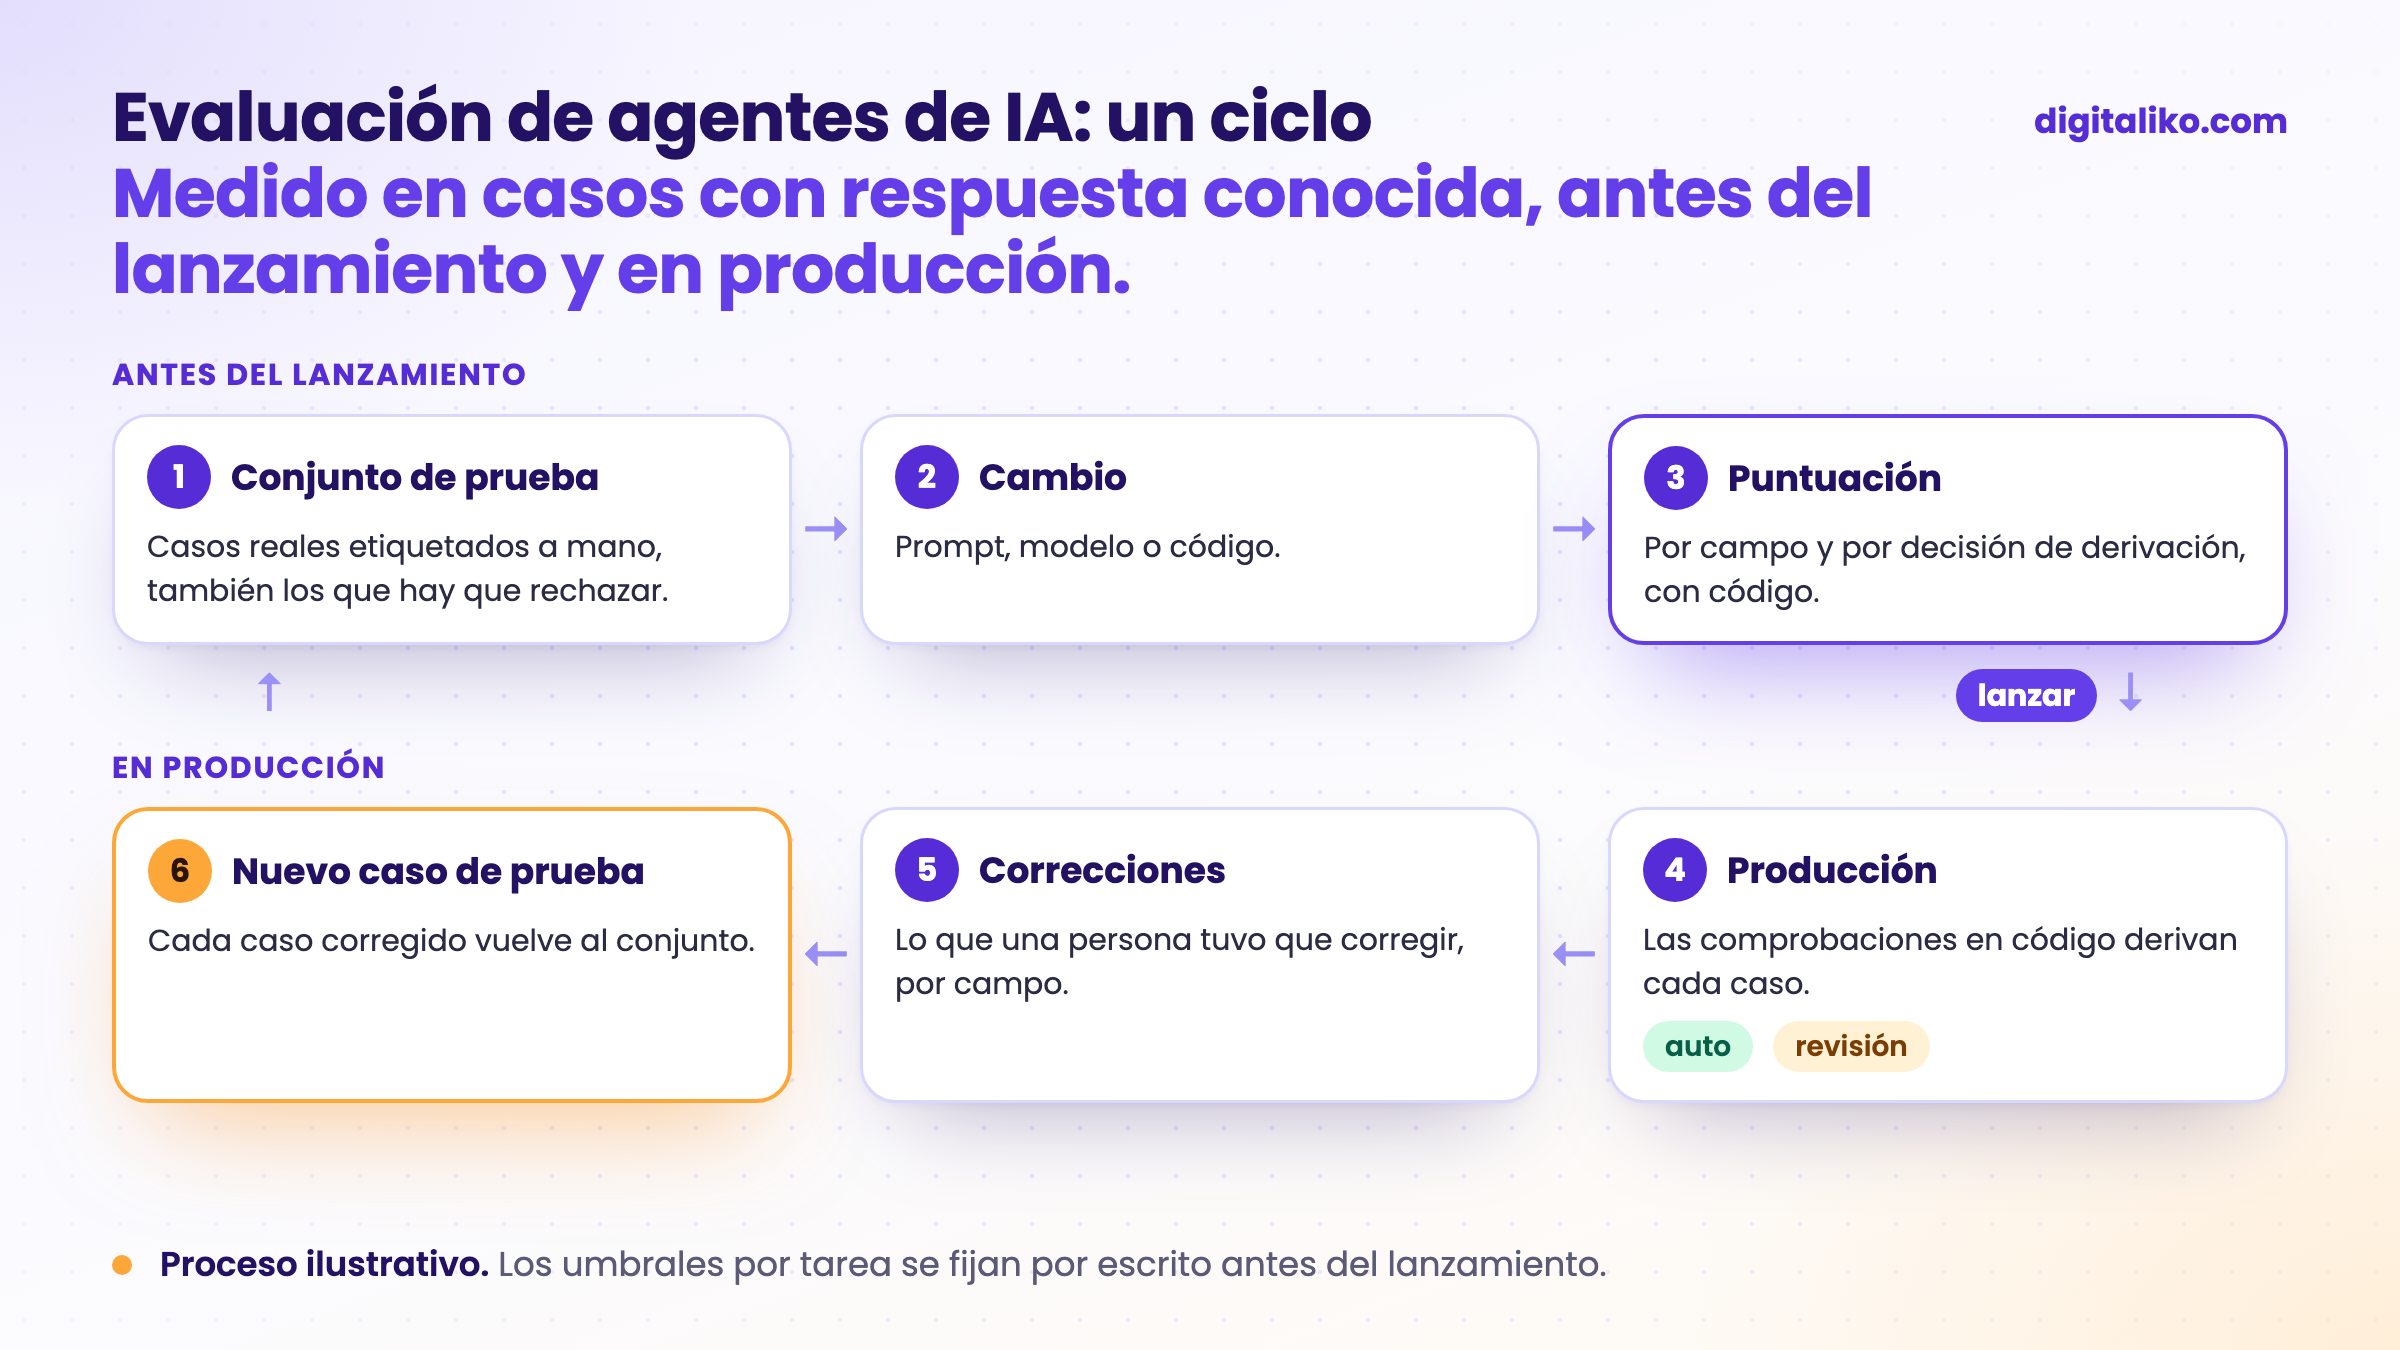
Cuando las correcciones dejan de bajar, el problema suele estar en las entradas, no en el modelo. Un nuevo tipo de documento o un proveedor que cambió su plantilla aparece aquí semanas antes de que alguien se queje.
¿Dónde encaja LLM as a judge?
Solo donde la calificación requiere lectura. Los campos extraídos, las categorías y las decisiones de derivación tienen una respuesta correcta, y el código las comprueba. Un juez ahí añade coste y ruido. Donde la salida es texto libre, como una respuesta a un cliente, un juez que califica según criterios escritos es útil, con sus sesgos conocidos. Cómo funciona el nuestro, y en qué se equivocó, está en LLM as a judge: un revisor de IA que intenta refutar el trabajo.
¿Está la evaluación de su agente lista para producción?
Revise su configuración:
Cuándo no construiríamos todo esto
- El agente solo prepara borradores y una persona lee cada uno. Para los lanzamientos basta un conjunto de prueba pequeño; las cifras de producción salen de las ediciones de todos modos.
- Hay un puñado de casos al mes. El etiquetado y las reglas de derivación cuestan más que revisar cada caso a mano.
- Nadie sabe decir cuál es la respuesta correcta. Si dos personas con experiencia no se ponen de acuerdo en la etiqueta, corrija primero la definición del proceso y después mida al agente.
¿Quiere un agente que se pueda medir?
Construimos agentes de IA con el conjunto de prueba, la derivación y las cifras de producción en su repositorio, como parte de agentes de IA para empresas. El código, el conjunto de prueba y los datos son suyos desde el primer día.
Le responderemos en dos días laborables con algunas preguntas sobre su trabajo. Después acordaremos qué hacemos primero.
Si prefiere hablar primero, reserve una llamada introductoria de 15 minutos.
¿Qué precisión tendría su agente en 50 casos reales etiquetados por usted mismo?
En resumen
- Evalúe offline en un conjunto fijo de casos reales etiquetados a mano, y online por lo que las personas tuvieron que corregir.
- Puntúe la decisión de derivación, no solo los valores extraídos.
- Fije el umbral por tarea antes del lanzamiento y derive según comprobaciones que el código puede verificar, no según la confianza del modelo.
- Nuestra automatización de facturas: el 70 % pasa sin ninguna persona, el resto va a una persona a propósito.
- Cada caso corregido en producción se convierte en un nuevo caso de prueba.
Preguntas frecuentes
¿Qué es la evaluación de agentes de IA?
Medir si un agente hace bien el trabajo, en casos cuya respuesta correcta usted conoce. Antes del lanzamiento se ejecuta contra un conjunto de prueba fijo; en producción se mide por lo que las personas tuvieron que corregir y lo que el agente pasó a una persona.
¿Qué tamaño debe tener el conjunto de prueba de un agente de IA?
El suficiente para cubrir la mezcla real de casos, incluidos los incómodos. Unas pocas decenas de casos reales etiquetados a mano ya muestran si un cambio ayuda o perjudica. Crece desde producción: cada caso que una persona tuvo que corregir se convierte en un nuevo caso de prueba.
¿Qué precisión es suficiente para un agente de IA?
No hay una cifra general. Defínala por tarea antes del lanzamiento, según lo que cuesta un error. Donde un error es barato y una persona lo ve de todos modos, basta un listón más bajo. Donde va directo a un cliente o a la contabilidad, el agente solo actúa por su cuenta en los casos que resuelve bien y deriva el resto a una persona.
¿En qué se diferencia de LLM as a judge?
LLM as a judge es una forma de calificar una respuesta cuando la calificación requiere lectura y criterio. La evaluación es todo el sistema a su alrededor: el conjunto de prueba, los umbrales, la derivación y las cifras de producción. Donde existe una respuesta correcta, la comprueba el código y no hace falta un juez.
¿Podemos fiarnos de la puntuación de confianza que da el modelo?
No por sí sola. Un modelo puede equivocarse con total seguridad. Derive según comprobaciones que el código puede verificar (cuadra el total, se conoce al proveedor, existe el campo) y según lo que muestra su conjunto de prueba, no según lo que el modelo dice de sí mismo.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

