Ako meriame presnosť AI agenta v produkcii
Pre CTO a vývojárovHarness a kontroly · Aktualizované

Filip Papraneczakladateľ Digitaliko
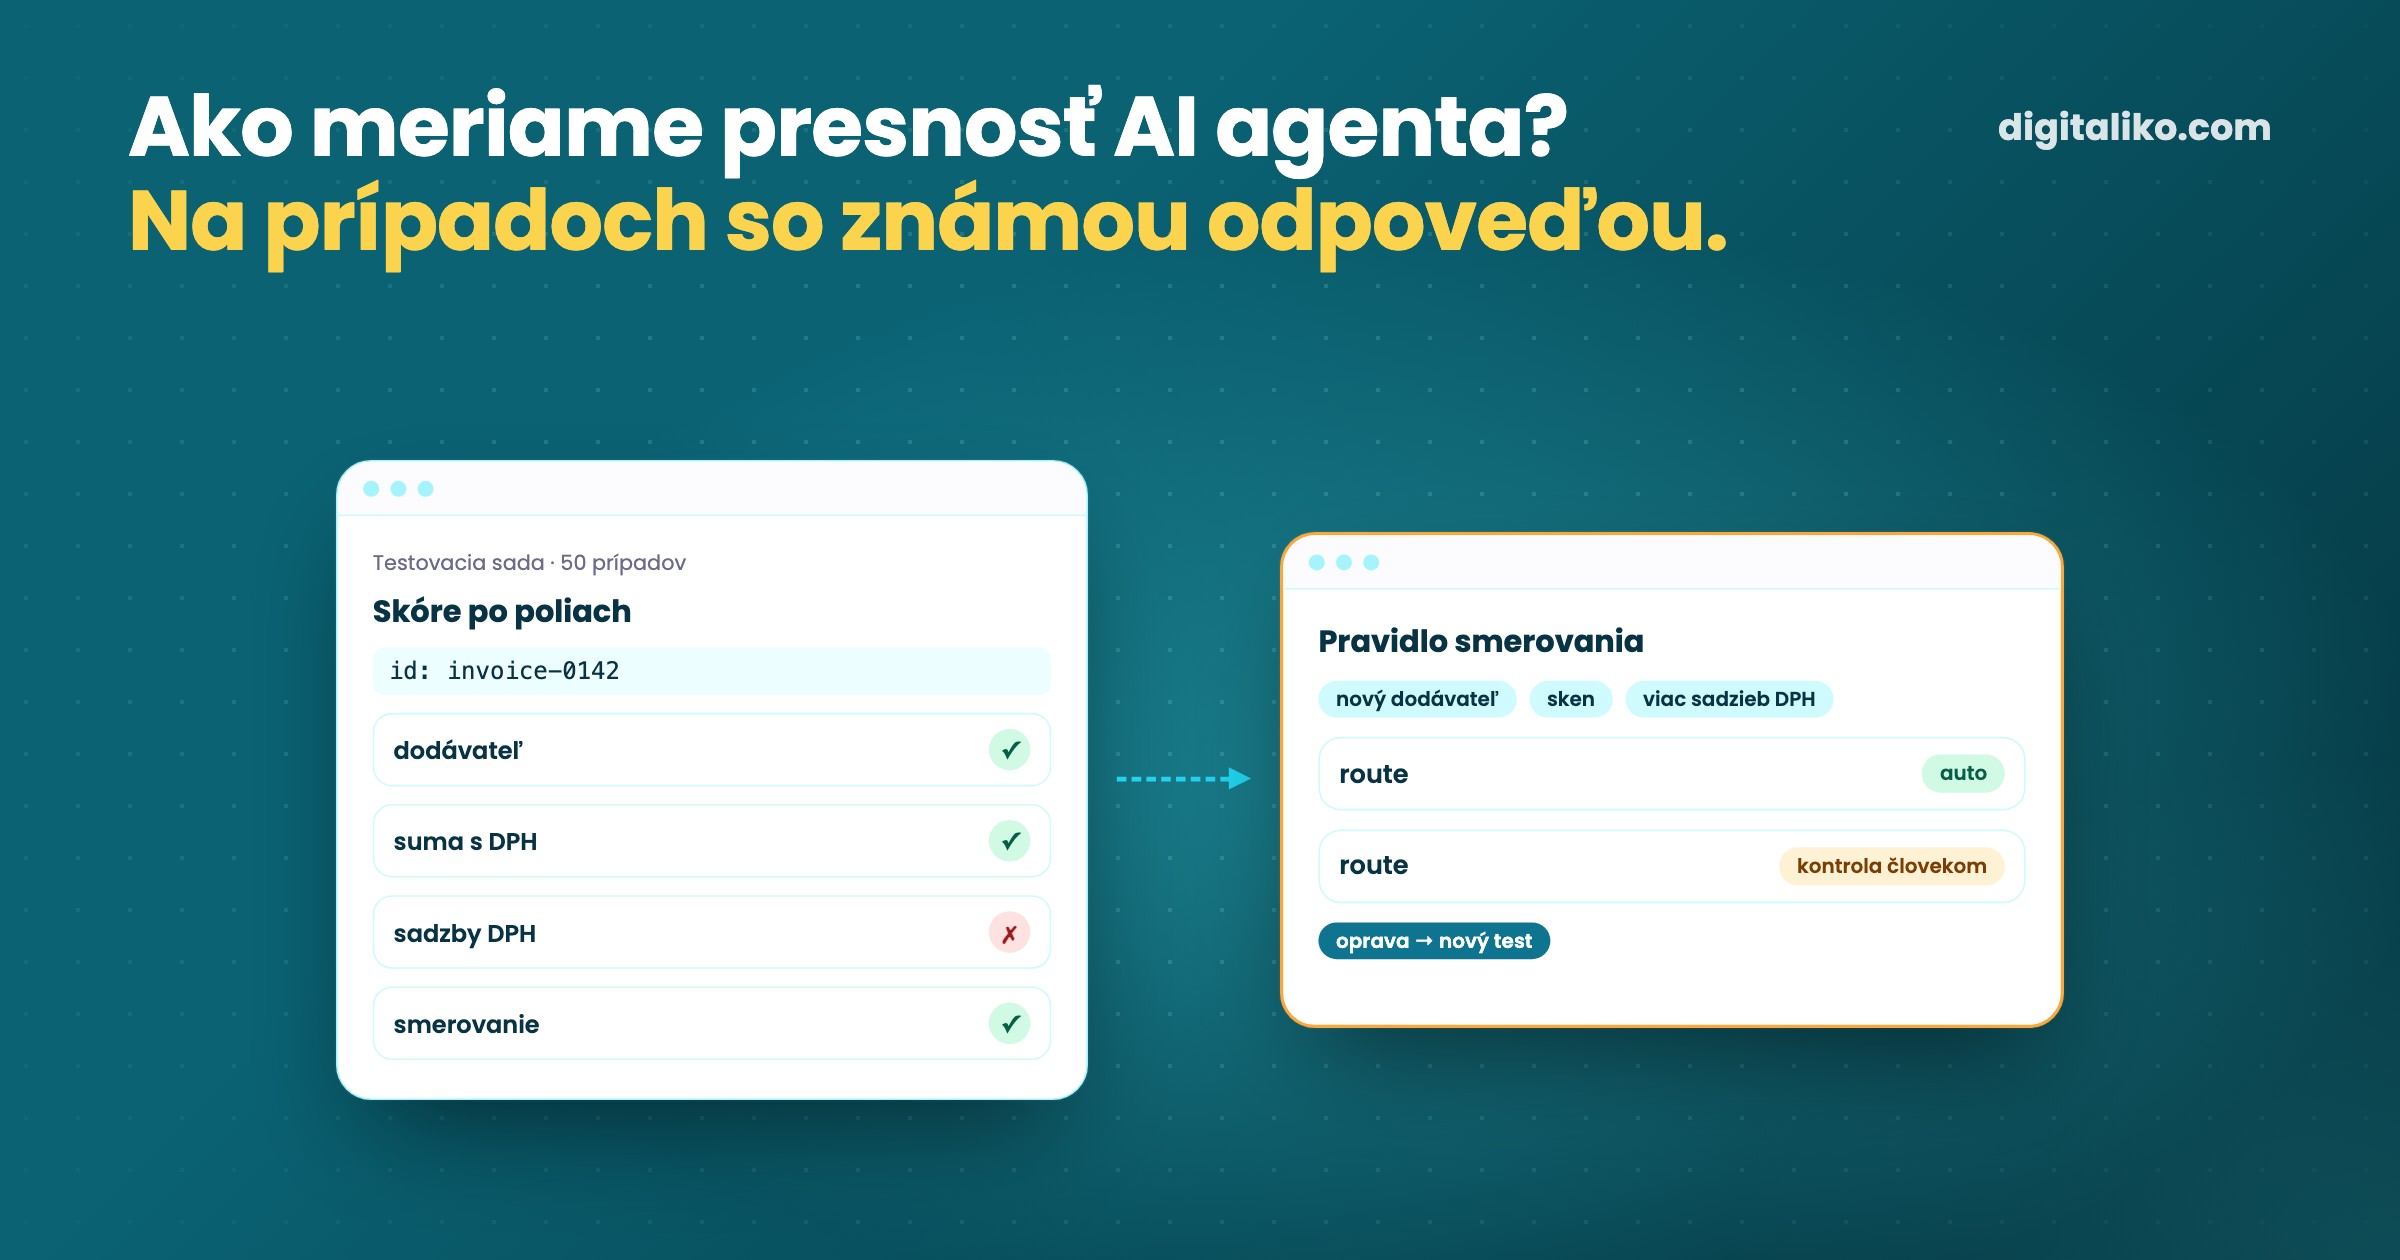
Evaluácia AI agenta znamená merať agenta na prípadoch, pri ktorých poznáte správnu odpoveď, pred každou zmenou a znova v produkcii. Má tri časti: testovaciu sadu skutočných, ručne označených prípadov, ktorá beží pri každej zmene, prah pre každú úlohu určený pred spustením, pod ktorým všetko ide na človeka, a v produkcii počítanie toho, čo museli ľudia opraviť. Pri faktúrach, ktoré prichádzajú e-mailom, takto prejde 70 % bez človeka a zvyšok ide na človeka zámerne.
Toto je technický článok pre CTO a vývojárov. Nižšie je, ako vyzerá každá časť, s konfiguráciou a kódom, a kde sa to pokazí.
Čo meria evaluácia AI agenta?
Dve rôzne veci v dvoch rôznych chvíľach. Ich zámena je najčastejšia chyba, ktorú vidíme: demo, ktoré „vyzeralo dobre“, sa stane kritériom na nasadenie.
| Pred nasadením (offline) | V produkcii (online) | |
|---|---|---|
| Otázka | Zlepšila táto zmena agenta, alebo ho zhoršila? | Robí agent stále svoju prácu? |
| Dáta | Pevná testovacia sada skutočných, ručne označených prípadov | Živé prípady a to, čo s nimi ľudia urobili |
| Správna odpoveď | Známa vopred | Známa, keď ju človek schváli alebo opraví |
| Hlavné číslo | Správne po poliach alebo rozhodnutiach, na sade | Miera opráv, podiel poslaný na človeka |
| Beží | Pri každej zmene promptu, modelu alebo kódu | Priebežne, prehľad každý týždeň |
Offline číslo vám povie, či zmenu nasadiť. Online číslo vám povie, či offline sada ešte zodpovedá realite. Keď sa tie dve rozídu, testovacia sada je zastaraná.
Ako postaviť testovaciu sadu?
Zo skutočných prípadov, nikdy z príkladov, ktoré si vývojár vymyslí pri písaní promptu. Vymyslené prípady testujú to, na čo ste už mysleli.
01
Zozbierajte skutočné prípady
Faktúry, e-maily, inzeráty, ktoré agent naozaj uvidí, aj tie škaredé: skeny, viacstranové PDF, preklepy.
02
Označte ich ručne
Človek, ktorý tú prácu pozná, zapíše správnu odpoveď pre každé pole. Toto je pomalá časť a nedá sa preskočiť.
03
Pridajte prípady bez odpovede
Vstupy, ktoré má agent odmietnuť alebo odovzdať: zlý typ dokumentu, chýbajúce údaje, mimo rozsahu.
04
Hodnoťte po poliach, kódom
Presná zhoda tam, kde existuje presná odpoveď. Sudca len tam, kde hodnotenie vyžaduje čítanie.
05
Rozširujte ju z produkcie
Každý prípad, ktorý človek opravil, sa stane novým testovacím prípadom s opravenou odpoveďou.
Prípad v sade sú obyčajné dáta. Testovací prípad môže vyzerať takto:
- id: invoice-multipage-0142
  input: fixtures/invoices/0142.pdf
  expect:
    supplier_id: "12345678"      # párované podľa IČO, nie podľa názvu
    total_gross: "1 240.00"
    vat_rates: [20]
    route: auto
- id: invoice-scan-0219
  input: fixtures/invoices/0219.jpg
  expect:
    route: review                # skeny idú podľa pravidla na človeka
Formát aj hodnoty sú ilustračné; dôležité je, čo prípad zaznamenáva. Všimnite si pole route: testuje samotné rozhodnutie o smerovaní, nielen vyťažené hodnoty. Agent, ktorý dobre vyťažuje, ale sám pustí ďalej nesprávne prípady, je stále pokazený.
Ako vyzerá zmena na testovacej sade?
Pre klienta s online marketplace triedi LLM inzeráty do kategórií. Nepýtali sme sa iného modelu, či kategórie vyzerajú dobre. Ľudia ručne označili skutočné inzeráty a kód spočítal zhody. Potom sme zmenili štruktúru promptu a pustili tú istú sadu znova:
- Presnosť AI kategorizácie inzerátov po zmene štruktúry promptu, na testovacej sade 50 ručne označených inzerátov (september 2026)
- 84 % → 98 %
To je číslo z testovacej sady, nie živá presnosť. Hovorí nám, že zmenu sa oplatilo nasadiť. Či obstojí v produkcii, merajú ďalšie dve časti.
Sada je zámerne malá. Päťdesiat označených prípadov stačí na to, aby bolo vidno zmenu takej veľkosti, a je ich dosť málo na to, aby ich človek označil a pozrel si každú chybu. Väčšia sada vznikne z produkcie, jeden opravený prípad za druhým.
Ako fungujú prahy a smerovanie na človeka?
Pred spustením si pre každú úlohu zapíšte, ktoré prípady môže agent dokončiť sám. Všetko ostatné ide na človeka. Pravidlo postavte z kontrol, ktoré overí kód, nie z istoty, ktorú hlási model.
Pri faktúrach, ktoré prichádzajú e-mailom, ich systém prečíta a zapíše do účtovného programu. 70 % prejde bez človeka. Zvyšok ide na človeka zámerne: nový dodávateľ, naskenovaná faktúra, viac ako jedna sadzba DPH. Zjednodušené, ilustračné pravidlo tohto typu môže vyzerať takto:
type Route = 'auto' | 'review'

function route(inv: Extracted, known: SupplierIndex): Route {
  if (!known.has(inv.supplierCompanyId)) return 'review'   // nový dodávateľ
  if (inv.source === 'scan') return 'review'
  if (inv.vatRates.length > 1) return 'review'
  if (!totalsAddUp(inv)) return 'review'                   // základ + DPH sa musí rovnať sume s DPH
  return 'auto'
}
Každá vetva review by mala zodpovedať prípadu, pri ktorom testovacia sada ukázala chyby, alebo pri ktorom chyba stojí viac ako minútu času človeka. Vetvu uvoľnite len na základe čísel z testovacej sady, nikdy preto, že sa predĺžila fronta.
Ako rozhodnúť, ktoré kroky čakajú na človeka, a ako ho nezahltiť schvaľovaním, je v článku Human in the loop: kedy má AI agent čakať na človeka.
Čo merať v produkcii?
Nie podiel prípadov, ktoré agent „vybavil“. To číslo sa dá ľahko nafúknuť tým, že menej smerujete na človeka. Pozerajte sa na to, čo sa stalo po agentovi:
- Opravy po poliach. Koľko polí človek zmenil v prípadoch, ktoré kontroloval, a ktoré to boli. Pole, ktoré sa opakovane opravuje, je ďalší testovací prípad.
- Podiel poslaný na človeka a prečo. Po jednotlivých pravidlách smerovania. Náhly skok znamená, že sa zmenil vstup: nová šablóna dodávateľa, nový formát e-mailu.
- Chyby nájdené po automatickom schválení. Prípady, ktoré prešli samé a aj tak boli zlé. Tie sú najdrahšie. Odporúčame pravidelne kontrolovať vzorku automaticky schválených prípadov; je to jediný spôsob, ako ich uvidieť.
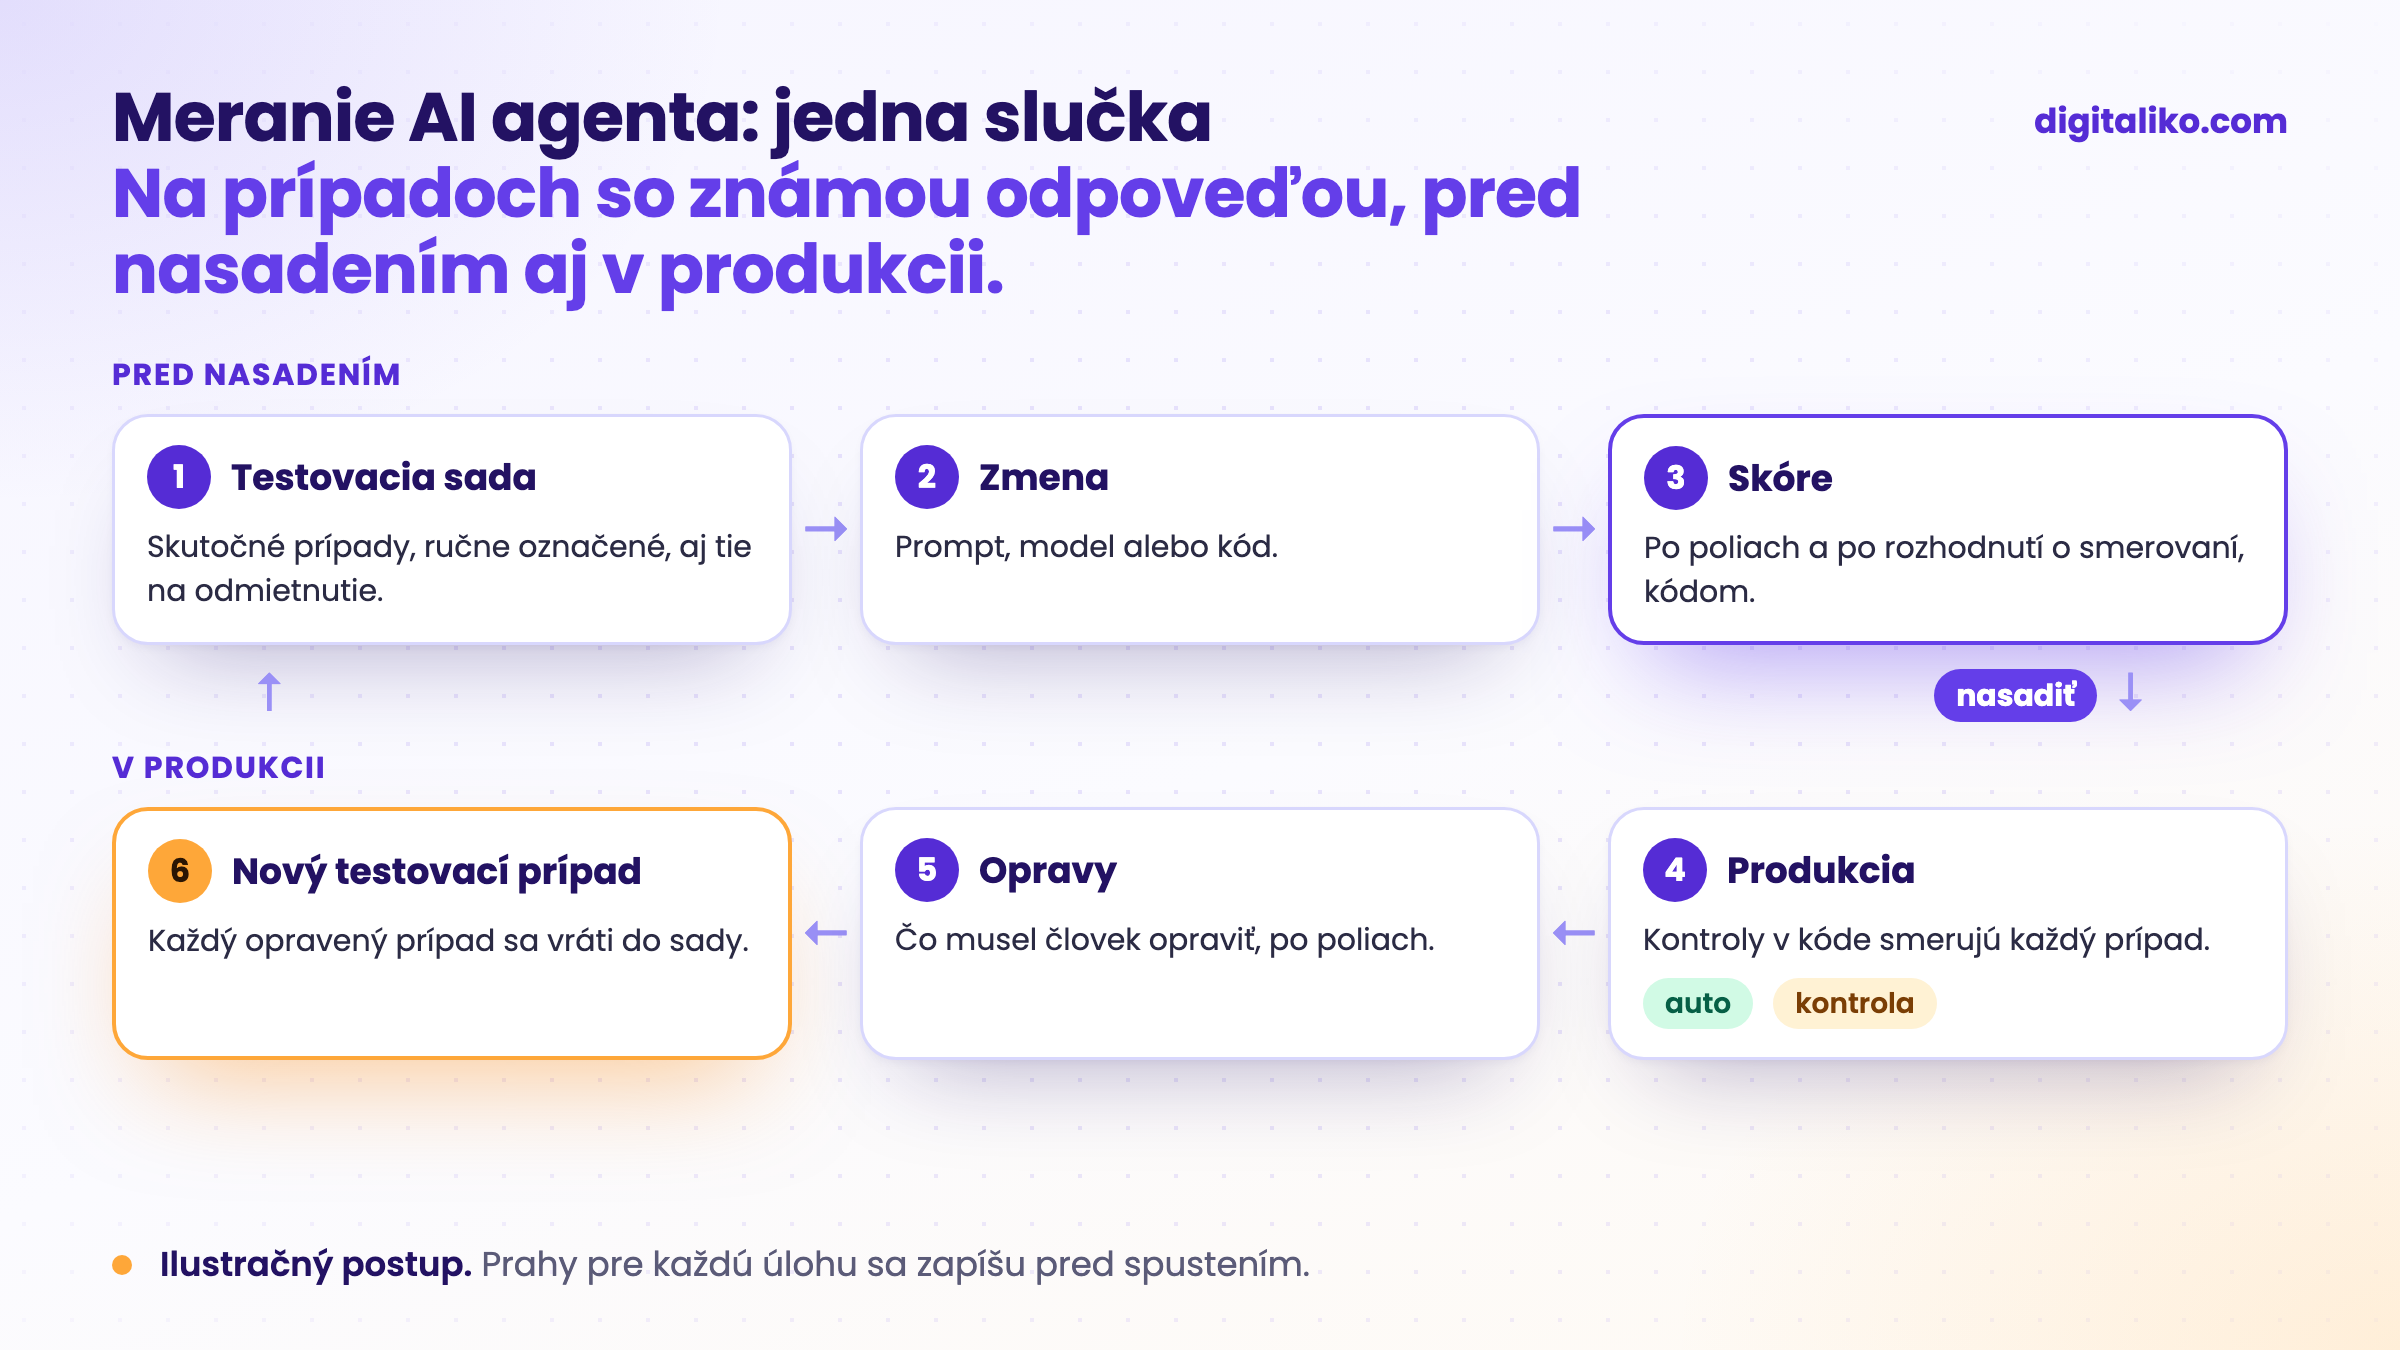
Keď opravy prestanú klesať, problém je zvyčajne vo vstupoch, nie v modeli. Nový typ dokumentu alebo dodávateľ, ktorý zmenil šablónu, sa tu ukáže týždne predtým, než sa niekto sťažuje.
Kde má miesto LLM as a judge?
Len tam, kde hodnotenie vyžaduje čítanie. Vyťažené polia, kategórie a rozhodnutia o smerovaní majú správnu odpoveď a skontroluje ich kód. Sudca tam pridáva náklady a šum. Kde je výstupom voľný text, napríklad odpoveď zákazníkovi, je sudca hodnotiaci podľa spísaných kritérií užitočný, aj so svojimi známymi skresleniami. Ako funguje ten náš a v čom sa mýlil, je v článku LLM as a judge: AI recenzent, ktorý sa snaží prácu vyvrátiť.
Je evaluácia vášho agenta pripravená na produkciu?
Prejdite si svoje nastavenie:
Kedy by sme toto všetko nestavali
- Agent len pripravuje návrhy a človek číta každý z nich. Na nasadenia stačí malá testovacia sada; čísla z produkcie aj tak prinesú úpravy.
- Prípadov je pár za mesiac. Označovanie a pravidlá smerovania stoja viac ako ručná kontrola každého prípadu.
- Nikto nevie povedať, aká je správna odpoveď. Ak sa dvaja skúsení ľudia nezhodnú na označení, najprv opravte definíciu procesu, až potom merajte agenta.
Chcete agenta, ktorého sa dá merať?
AI agentov staviame s testovacou sadou, smerovaním a číslami z produkcie vo vašom repozitári, v rámci služby AI agent pre firmu. Kód, testovacia sada aj dáta sú vaše od prvého dňa.
Ozveme sa do dvoch pracovných dní s pár otázkami k vašej práci. Potom sa dohodneme, čo urobíme ako prvé.
Ak sa chcete najprv porozprávať, dohodnite si úvodný hovor na 15 minút.
Aká by bola presnosť vášho agenta na 50 skutočných prípadoch, ktoré ste sami označili?
V skratke
- Hodnoťte offline na pevnej sade skutočných, ručne označených prípadov a online podľa toho, čo museli ľudia opraviť.
- Hodnoťte rozhodnutie o smerovaní, nielen vyťažené hodnoty.
- Prah pre každú úlohu zapíšte pred spustením a smerujte podľa kontrol, ktoré overí kód, nie podľa istoty modelu.
- Naša automatizácia faktúr: 70 % prejde bez človeka, zvyšok ide na človeka zámerne.
- Každý opravený prípad z produkcie sa stane novým testovacím prípadom.
Časté otázky
Čo je evaluácia AI agenta?
Meranie, či agent robí prácu správne, na prípadoch, pri ktorých poznáte správnu odpoveď. Pred nasadením beží na pevnej testovacej sade; v produkcii sa meria tým, čo museli ľudia opraviť a čo agent odovzdal človeku.
Aká veľká má byť testovacia sada pre AI agenta?
Taká, aby pokryla skutočný mix prípadov vrátane tých nepríjemných. Už niekoľko desiatok ručne označených skutočných prípadov ukáže, či zmena pomáha alebo škodí. Rastie z produkcie: každý prípad, ktorý musel človek opraviť, sa stane novým testovacím prípadom.
Aká presnosť AI agenta stačí?
Všeobecné číslo neexistuje. Určte ju pre každú úlohu pred spustením, podľa toho, koľko stojí chyba. Kde je chyba lacná a človek ju aj tak uvidí, stačí nižšia latka. Kde ide rovno k zákazníkovi alebo do účtovníctva, agent robí sám len prípady, ktoré zvláda správne, a zvyšok posiela človeku.
Čím sa to líši od LLM as a judge?
LLM as a judge je jeden zo spôsobov, ako ohodnotiť odpoveď, keď hodnotenie vyžaduje čítanie a úsudok. Evaluácia je celý systém okolo: testovacia sada, prahy, smerovanie a čísla z prevádzky. Kde existuje správna odpoveď, skontroluje ju kód a sudca nie je potrebný.
Môžeme veriť skóre istoty, ktoré hlási model?
Samotnému nie. Model sa môže mýliť a byť si pritom istý. Smerujte podľa kontrol, ktoré overí kód (sedí súčet, je dodávateľ známy, je pole vyplnené), a podľa toho, čo ukazuje testovacia sada, nie podľa toho, čo model hovorí sám o sebe.
Opýtajte sa AI na tento článok
AI pri odpovedi využije aj naše ďalšie články a skúsenosti z reálnych projektov.
ChatGPTClaudePerplexity

