Jak měříme přesnost AI agenta v produkci
Pro CTO a vývojářeHarness a kontroly · Aktualizováno

Filip Papraneczakladatel Digitaliko
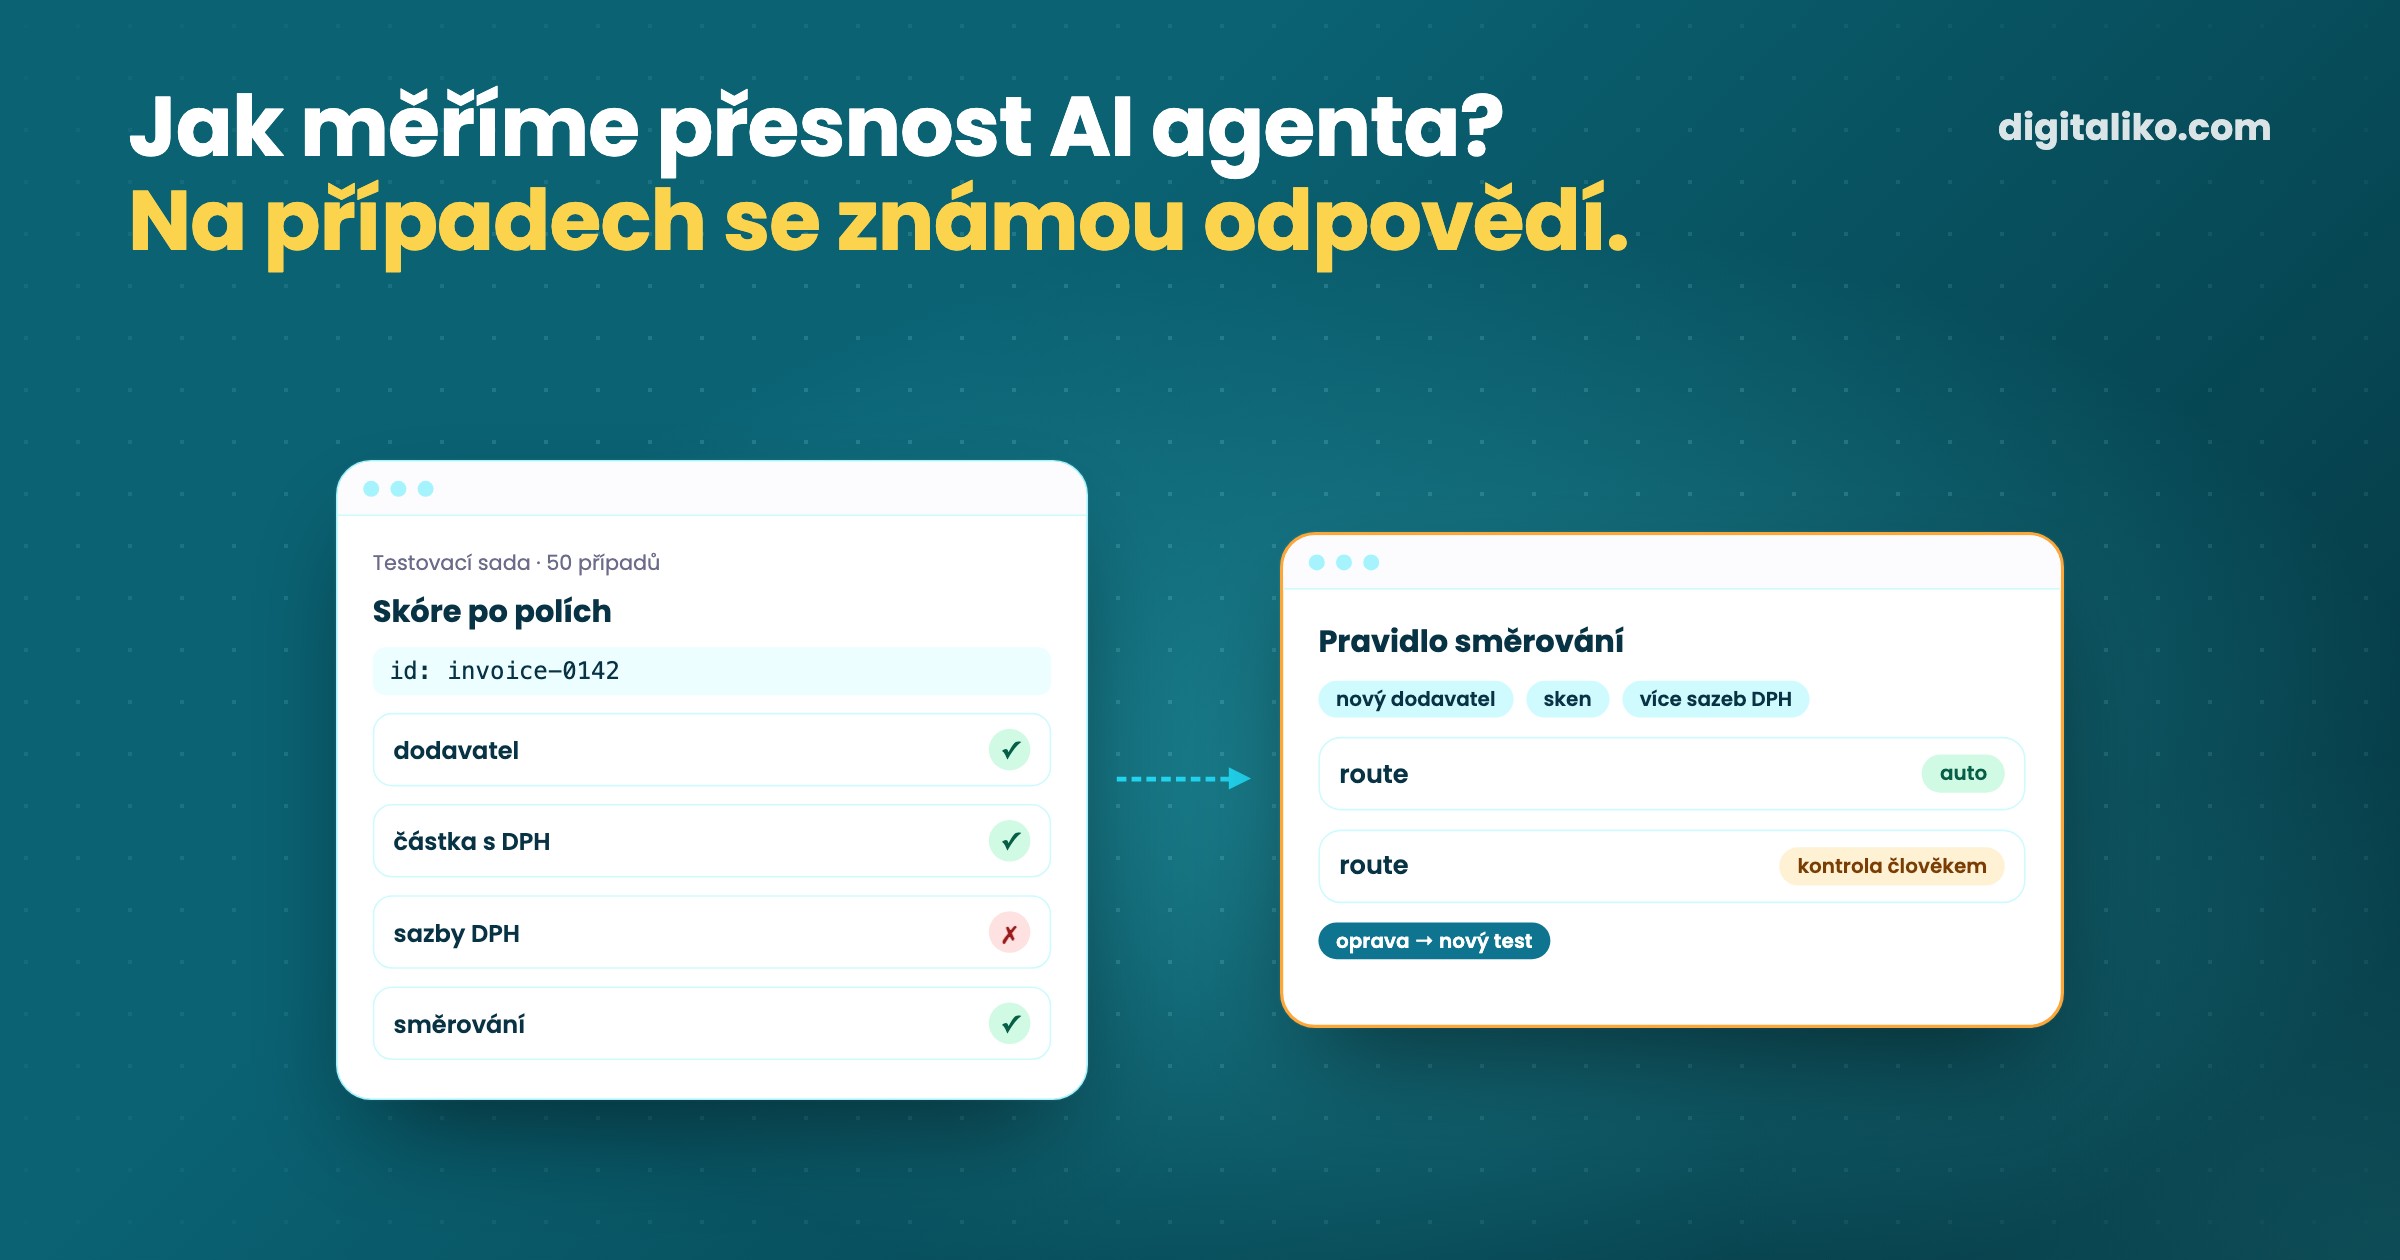
Evaluace AI agenta znamená měřit agenta na případech, u kterých znáte správnou odpověď, před každou změnou a znovu v produkci. Má tři části: testovací sadu skutečných, ručně označených případů, která běží při každé změně, práh pro každou úlohu určený před spuštěním, pod kterým všechno jde na člověka, a v produkci počítání toho, co museli lidé opravit. U faktur, které chodí e-mailem, takto projde 70 % bez člověka a zbytek jde na člověka záměrně.
Tohle je technický článek pro CTO a vývojáře. Níže je, jak vypadá každá část, s konfigurací a kódem, a kde se to pokazí.
Co měří evaluace AI agenta?
Dvě různé věci ve dvou různých chvílích. Jejich záměna je nejčastější chyba, kterou vidíme: demo, které „vypadalo dobře“, se stane kritériem pro nasazení.
| Před nasazením (offline) | V produkci (online) | |
|---|---|---|
| Otázka | Zlepšila tahle změna agenta, nebo ho zhoršila? | Dělá agent pořád svou práci? |
| Data | Pevná testovací sada skutečných, ručně označených případů | Živé případy a to, co s nimi lidé udělali |
| Správná odpověď | Známá předem | Známá, když ji člověk schválí nebo opraví |
| Hlavní číslo | Správně po polích nebo rozhodnutích, na sadě | Míra oprav, podíl poslaný na člověka |
| Běží | Při každé změně promptu, modelu nebo kódu | Průběžně, přehled každý týden |
Offline číslo vám řekne, zda změnu nasadit. Online číslo vám řekne, zda offline sada ještě odpovídá realitě. Když se ty dvě rozejdou, testovací sada je zastaralá.
Jak postavit testovací sadu?
Ze skutečných případů, nikdy z příkladů, které si vývojář vymyslí při psaní promptu. Vymyšlené případy testují to, na co jste už mysleli.
01
Sesbírejte skutečné případy
Faktury, e-maily, inzeráty, které agent opravdu uvidí, i ty ošklivé: skeny, vícestránková PDF, překlepy.
02
Označte je ručně
Člověk, který tu práci zná, zapíše správnou odpověď pro každé pole. Tohle je pomalá část a nedá se přeskočit.
03
Přidejte případy bez odpovědi
Vstupy, které má agent odmítnout nebo předat: špatný typ dokumentu, chybějící údaje, mimo rozsah.
04
Hodnoťte po polích, kódem
Přesná shoda tam, kde existuje přesná odpověď. Soudce jen tam, kde hodnocení vyžaduje čtení.
05
Rozšiřujte ji z produkce
Každý případ, který člověk opravil, se stane novým testovacím případem s opravenou odpovědí.
Případ v sadě jsou obyčejná data. Testovací případ může vypadat takto:
- id: invoice-multipage-0142
  input: fixtures/invoices/0142.pdf
  expect:
    supplier_id: "12345678"      # párováno podle IČO, ne podle názvu
    total_gross: "1 240.00"
    vat_rates: [20]
    route: auto
- id: invoice-scan-0219
  input: fixtures/invoices/0219.jpg
  expect:
    route: review                # skeny jdou podle pravidla na člověka
Formát i hodnoty jsou ilustrační; důležité je, co případ zaznamenává. Všimněte si pole route: testuje samotné rozhodnutí o směrování, nejen vytěžené hodnoty. Agent, který dobře vytěžuje, ale sám pustí dál nesprávné případy, je pořád rozbitý.
Jak vypadá změna na testovací sadě?
Pro klienta s online marketplace třídí LLM inzeráty do kategorií. Neptali jsme se jiného modelu, zda kategorie vypadají dobře. Lidé ručně označili skutečné inzeráty a kód spočítal shody. Pak jsme změnili strukturu promptu a pustili stejnou sadu znovu:
- Přesnost AI kategorizace inzerátů po změně struktury promptu, na testovací sadě 50 ručně označených inzerátů (září 2026)
- 84 % → 98 %
To je číslo z testovací sady, ne živá přesnost. Říká nám, že změnu se vyplatilo nasadit. Zda obstojí v produkci, měří další dvě části.
Sada je záměrně malá. Padesát označených případů stačí na to, aby byla vidět změna takové velikosti, a je jich dost málo na to, aby je člověk označil a prohlédl si každou chybu. Větší sada vznikne z produkce, jeden opravený případ za druhým.
Jak fungují prahy a směrování na člověka?
Před spuštěním si pro každou úlohu zapište, které případy může agent dokončit sám. Všechno ostatní jde na člověka. Pravidlo postavte z kontrol, které ověří kód, ne z jistoty, kterou hlásí model.
U faktur, které chodí e-mailem, je systém přečte a zapíše do účetního programu. 70 % projde bez člověka. Zbytek jde na člověka záměrně: nový dodavatel, naskenovaná faktura, víc než jedna sazba DPH. Zjednodušené, ilustrační pravidlo tohoto typu může vypadat takto:
type Route = 'auto' | 'review'

function route(inv: Extracted, known: SupplierIndex): Route {
  if (!known.has(inv.supplierCompanyId)) return 'review'   // nový dodavatel
  if (inv.source === 'scan') return 'review'
  if (inv.vatRates.length > 1) return 'review'
  if (!totalsAddUp(inv)) return 'review'                   // základ + DPH se musí rovnat částce s DPH
  return 'auto'
}
Každá větev review by měla odpovídat případu, u kterého testovací sada ukázala chyby, nebo u kterého chyba stojí víc než minutu času člověka. Větev uvolněte jen na základě čísel z testovací sady, nikdy proto, že se prodloužila fronta.
Jak rozhodnout, které kroky čekají na člověka, a jak ho nezahltit schvalováním, je v článku Human in the loop: kdy má AI agent čekat na člověka.
Co měřit v produkci?
Ne podíl případů, které agent „vyřídil“. To číslo se dá snadno nafouknout tím, že méně směrujete na člověka. Dívejte se na to, co se stalo po agentovi:
- Opravy po polích. Kolik polí člověk změnil v případech, které kontroloval, a která to byla. Pole, které se opakovaně opravuje, je další testovací případ.
- Podíl poslaný na člověka a proč. Po jednotlivých pravidlech směrování. Náhlý skok znamená, že se změnil vstup: nová šablona dodavatele, nový formát e-mailu.
- Chyby nalezené po automatickém schválení. Případy, které prošly samy a stejně byly špatně. Ty jsou nejdražší. Doporučujeme pravidelně kontrolovat vzorek automaticky schválených případů; je to jediný způsob, jak je uvidět.
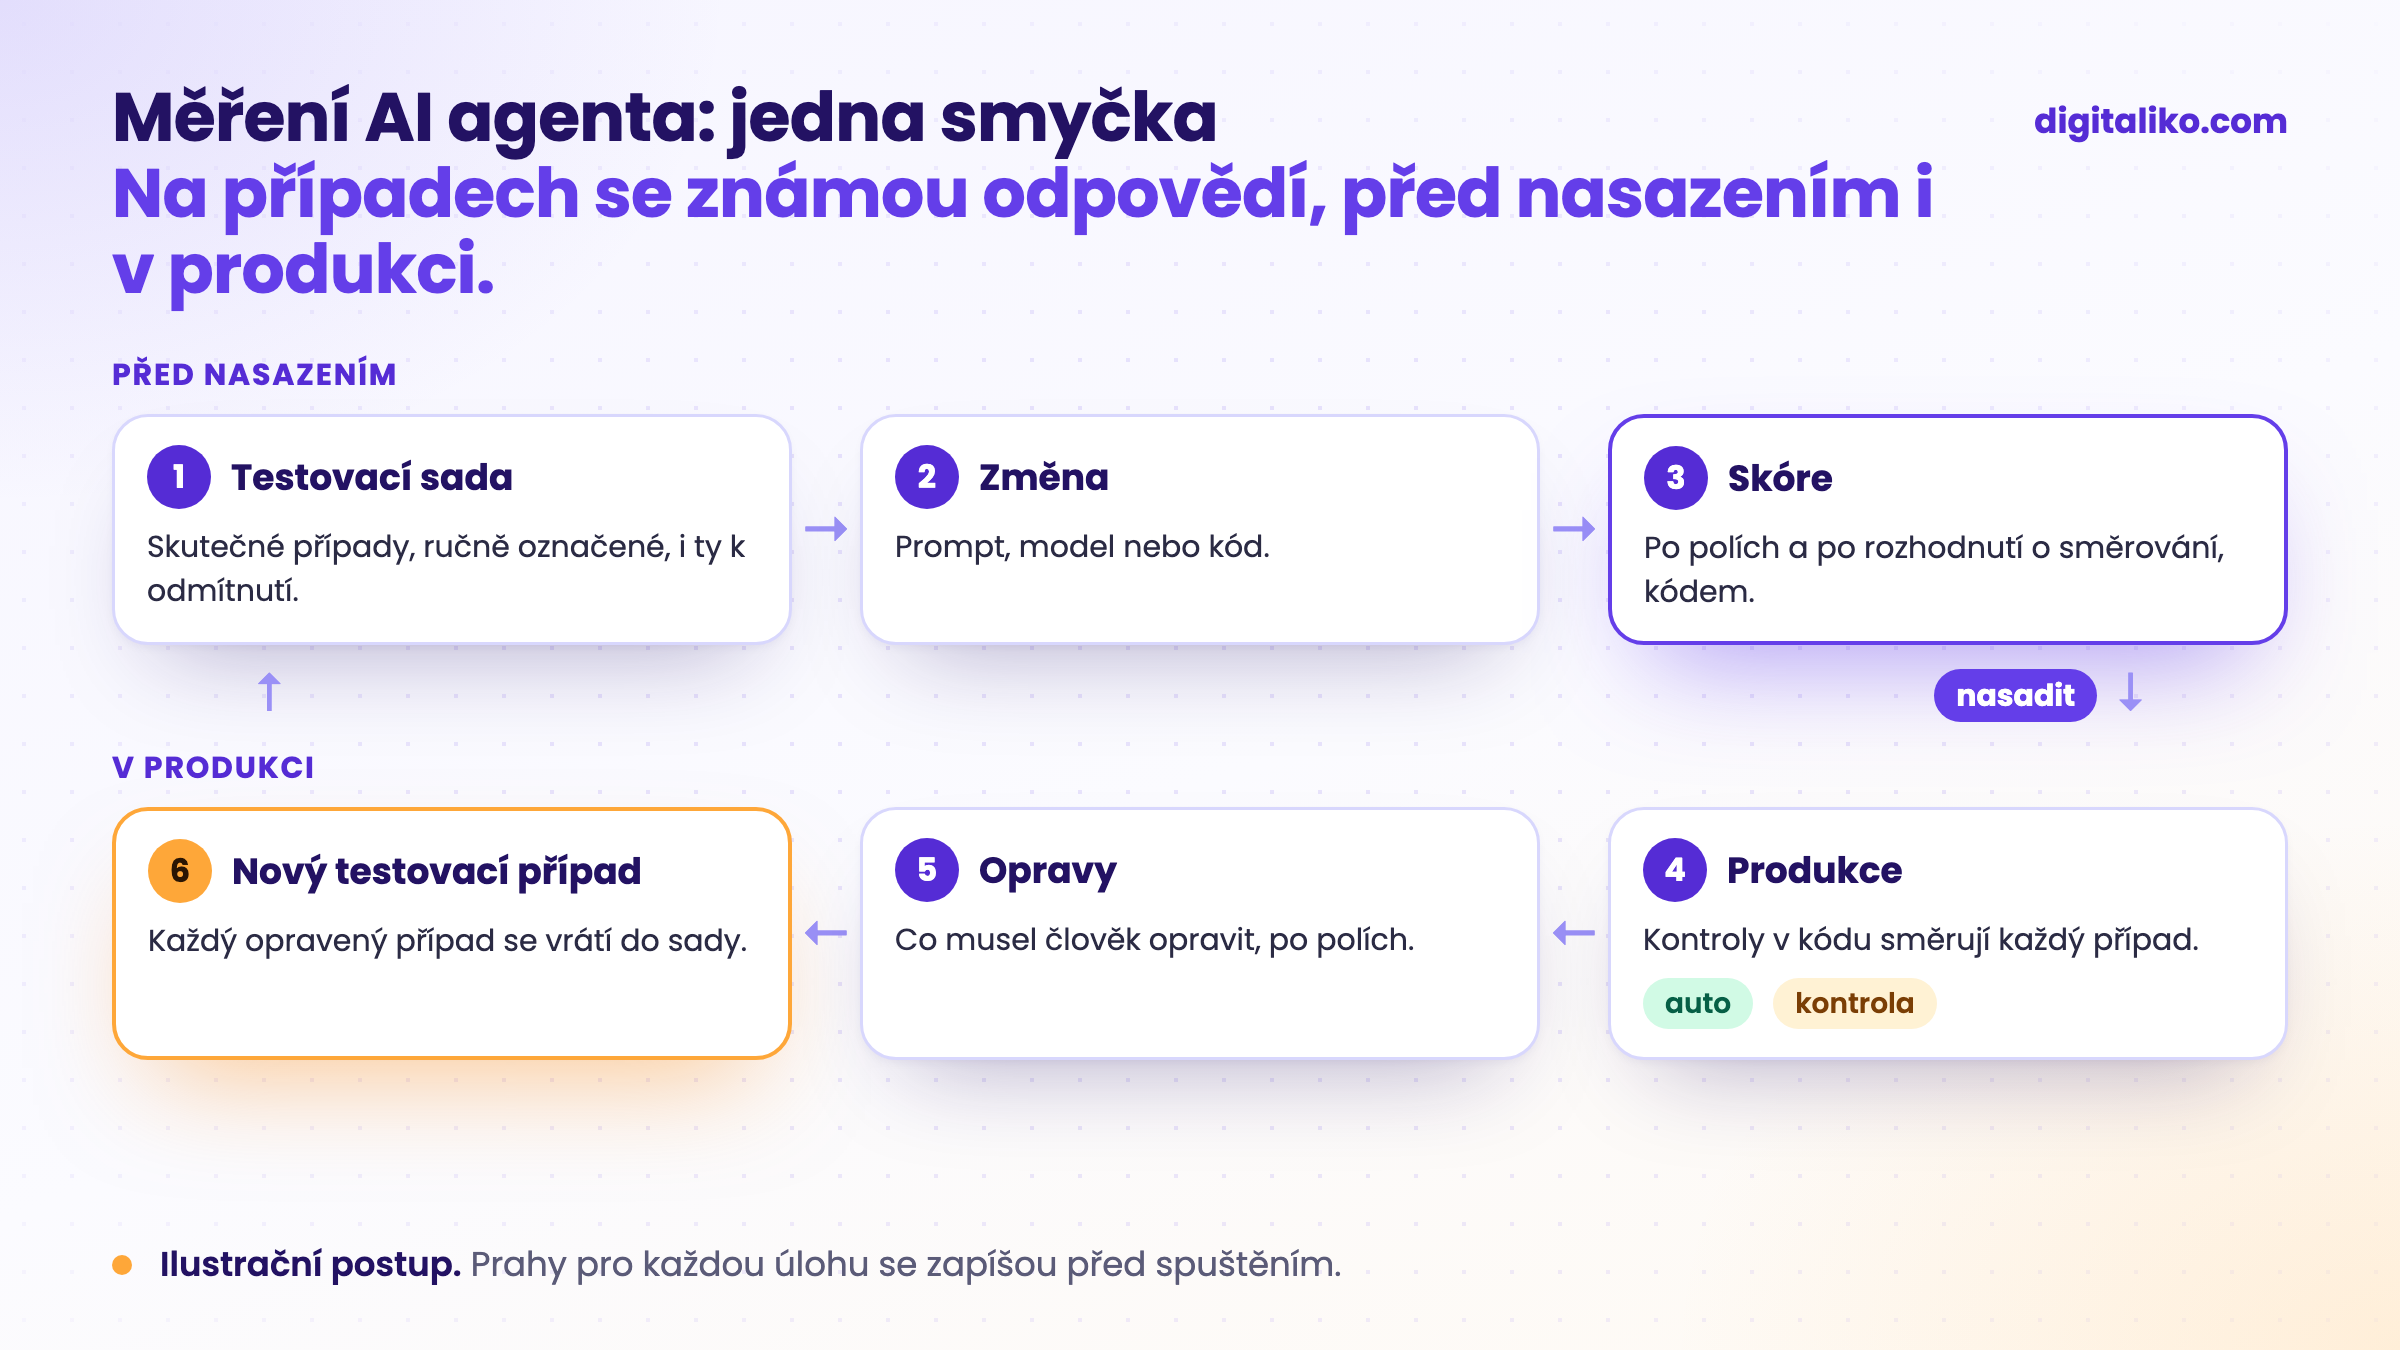
Když opravy přestanou klesat, problém je obvykle ve vstupech, ne v modelu. Nový typ dokumentu nebo dodavatel, který změnil šablonu, se tu ukáže týdny předtím, než si někdo stěžuje.
Kde má místo LLM as a judge?
Jen tam, kde hodnocení vyžaduje čtení. Vytěžená pole, kategorie a rozhodnutí o směrování mají správnou odpověď a zkontroluje je kód. Soudce tam přidává náklady a šum. Kde je výstupem volný text, například odpověď zákazníkovi, je soudce hodnotící podle sepsaných kritérií užitečný, i se svými známými zkresleními. Jak funguje ten náš a v čem se mýlil, je v článku LLM as a judge: AI recenzent, který se snaží práci vyvrátit.
Je evaluace vašeho agenta připravená na produkci?
Projděte si své nastavení:
Kdy bychom tohle všechno nestavěli
- Agent jen připravuje návrhy a člověk čte každý z nich. Na nasazení stačí malá testovací sada; čísla z produkce stejně přinesou úpravy.
- Případů je pár za měsíc. Označování a pravidla směrování stojí víc než ruční kontrola každého případu.
- Nikdo neumí říct, jaká je správná odpověď. Pokud se dva zkušení lidé neshodnou na označení, nejdřív opravte definici procesu, až pak měřte agenta.
Chcete agenta, kterého jde měřit?
AI agenty stavíme s testovací sadou, směrováním a čísly z produkce ve vašem repozitáři, v rámci služby AI agent pro firmu. Kód, testovací sada i data jsou vaše od prvního dne.
Ozveme se do dvou pracovních dnů s pár otázkami k vaší práci. Pak se domluvíme, co uděláme jako první.
Pokud si chcete nejdřív promluvit, domluvte si úvodní hovor na 15 minut.
Jaká by byla přesnost vašeho agenta na 50 skutečných případech, které jste sami označili?
Ve zkratce
- Hodnoťte offline na pevné sadě skutečných, ručně označených případů a online podle toho, co museli lidé opravit.
- Hodnoťte rozhodnutí o směrování, nejen vytěžené hodnoty.
- Práh pro každou úlohu zapište před spuštěním a směrujte podle kontrol, které ověří kód, ne podle jistoty modelu.
- Naše automatizace faktur: 70 % projde bez člověka, zbytek jde na člověka záměrně.
- Každý opravený případ z produkce se stane novým testovacím případem.
Časté otázky
Co je evaluace AI agenta?
Měření, zda agent dělá práci správně, na případech, u kterých znáte správnou odpověď. Před nasazením běží na pevné testovací sadě; v produkci se měří tím, co museli lidé opravit a co agent předal člověku.
Jak velká má být testovací sada pro AI agenta?
Taková, aby pokryla skutečný mix případů včetně těch nepříjemných. Už několik desítek ručně označených skutečných případů ukáže, zda změna pomáhá, nebo škodí. Roste z produkce: každý případ, který musel člověk opravit, se stane novým testovacím případem.
Jaká přesnost AI agenta stačí?
Obecné číslo neexistuje. Určete ji pro každou úlohu před spuštěním podle toho, kolik stojí chyba. Kde je chyba levná a člověk ji stejně uvidí, stačí nižší laťka. Kde jde rovnou k zákazníkovi nebo do účetnictví, agent dělá sám jen případy, které zvládá správně, a zbytek posílá člověku.
Čím se to liší od LLM as a judge?
LLM as a judge je jeden ze způsobů, jak ohodnotit odpověď, když hodnocení vyžaduje čtení a úsudek. Evaluace je celý systém kolem: testovací sada, prahy, směrování a čísla z provozu. Kde existuje správná odpověď, zkontroluje ji kód a soudce není potřeba.
Můžeme věřit skóre jistoty, které hlásí model?
Samotnému ne. Model se může mýlit a být si přitom jistý. Směrujte podle kontrol, které ověří kód (sedí součet, je dodavatel známý, je pole vyplněné), a podle toho, co ukazuje testovací sada, ne podle toho, co model říká sám o sobě.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity

