RAG na danych firmy: jak go zbudować, żeby nie kłamał
Dla CTO i programistówHarness i kontrole · Zaktualizowano

Filip PapranecZałożyciel Digitaliko
RAG na danych firmy nie kłamie, gdy spełnione są cztery warunki. Wyszukiwanie znajduje właściwy fragment z aktualnej wersji dokumentu. Uprawnienia są filtrowane w zapytaniu do indeksu, a nie w prompcie. Model może odpowiadać tylko na podstawie znalezionych fragmentów, z cytatem sprawdzonym przez kod, a gdy nie znajdzie źródła, odmawia. A całość mierzy zestaw pytań ze znaną odpowiedzią, uruchamiany przy każdej zmianie.
To artykuł techniczny dla CTO i programistów. Dlaczego i kiedy firma w ogóle potrzebuje wewnętrznego asystenta, omawiamy w artykule Asystent AI dla firmy na własnych danych.
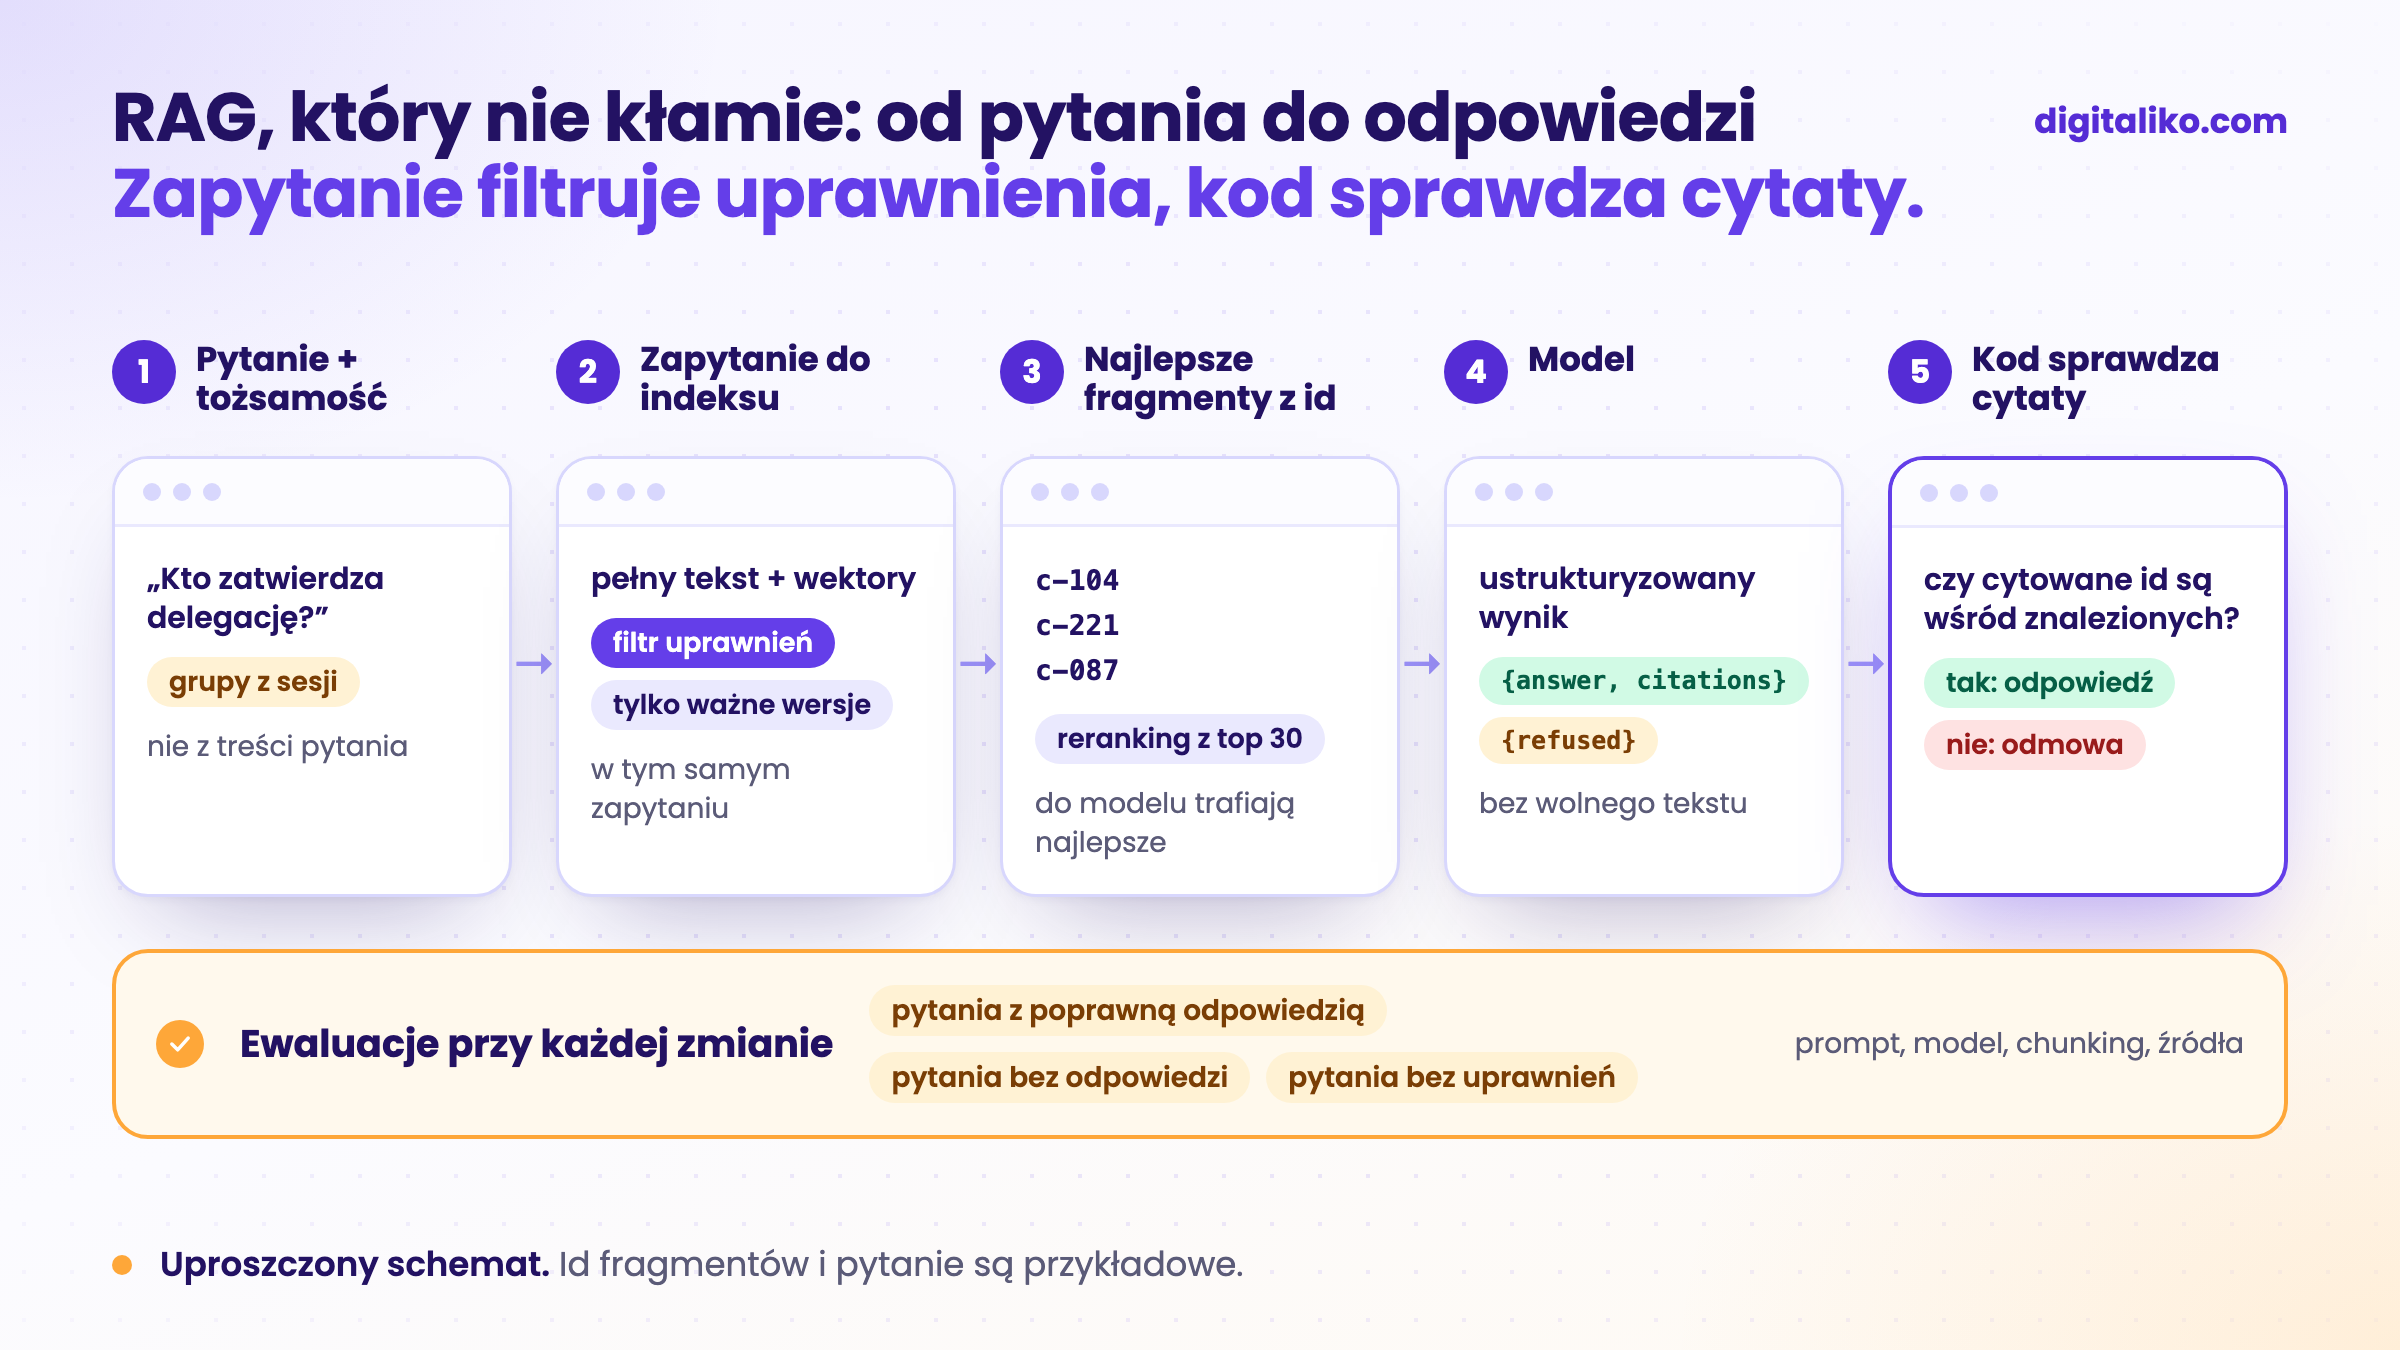
Z czego składa się RAG, który nie kłamie?
Większość poradników kończy się na „pokrój dokumenty, zapisz wektory, wyślij top 5 do modelu”. To jest demo. Przy danych firmy dochodzą dwa kroki, których demo nie ma: uprawnienia i ewaluacje.
01
Wczytać dokumenty z metadanymi
Źródło, wersja, ważność od i do, właściciel i kto może widzieć dokument. Bez metadanych nie przefiltrują Państwo później niczego z tego.
02
Dzielić według struktury
Według nagłówków, punktów regulaminu, wierszy cennika. Nie co 500 znaków przez środek tabeli.
03
Wyszukiwanie hybrydowe z filtrem
Pełny tekst i wektory, filtr uprawnień i ważności w tym samym zapytaniu, potem reranking.
04
Odpowiedź z cytatem albo odmowa
Ustrukturyzowany wynik: odpowiedź z id fragmentów albo odmowa. Kod sprawdza, że cytowane id były wśród znalezionych.
05
Ewaluacje przy każdej zmianie
Zestaw pytań z poprawną odpowiedzią i źródłem, a do tego pytania bez odpowiedzi i pytania od osoby bez uprawnień.
Kroki 3 i 5 decydują, czy RAG kłamie. Model rzadko wymyśla coś z niczego. Odpowiada źle na podstawie fragmentu, który podsunęło mu wyszukiwanie.
Gdzie wyszukiwanie psuje się najczęściej?
Gdy RAG odpowie źle, proszę najpierw sprawdzić, co model dostał na wejściu. Najczęściej problem był właśnie tam:
| Objaw | Przyczyna | Naprawa |
|---|---|---|
| Odpowiedź ze starego cennika | W indeksie są obie wersje, nowsza nie ma wyższego wyniku | Metadane valid_from, valid_to, filtr na obowiązujące |
| Nie znajduje produktu po kodzie | Wektory nie odróżniają „AX-200” od „AX-220” | Wyszukiwanie hybrydowe: pełny tekst dla kodów, liczb, NIP |
| Odpowiedź z połowy tabeli | Chunk przeciął wiersz albo zgubił nagłówek | Chunki według struktury, nagłówek tabeli w każdym chunku |
| Właściwy dokument, zły rozdział | Pierwsza piątka jest do siebie podobna, właściwy jest szósty | Reranking na szerszym wyborze, na przykład top 30 |
| Odpowiada na pytanie, które nie ma odpowiedzi | Wyszukiwanie zawsze coś zwraca | Zasada odmowy i ewaluacje na pytaniach bez odpowiedzi |
Ostatni wiersz jest najbardziej zdradliwy. Wyszukiwanie po podobieństwie nigdy nie zwraca „nic”. Zwraca pięć najmniej złych fragmentów, a model coś z nich składa. Dlatego model musi mieć pozwolenie na odmowę i mieć ją przećwiczoną.
Uprawnienia do dokumentów: filtr w zapytaniu, nie w prompcie
Wewnętrzny RAG czyta regulaminy, cenniki i umowy. Jeśli model dostanie fragment umowy, może go użyć w odpowiedzi dla kogokolwiek. Polecenie „nie pokazuj umów handlowcom” w prompcie nie jest kontrolą dostępu, tylko prośbą. Tak samo jak przy prompt injection: czego model nie dostanie, tego nie może zdradzić.
Filtr należy więc do zapytania, które wybiera fragmenty. Uproszczony przykład w Postgresie z rozszerzeniem pgvector:
-- $1 = embedding pytania, $2 = grupy użytkownika z logowania, nie z treści pytania
select c.id, c.document_id, c.content
from chunks c
join documents d on d.id = c.document_id
where d.allowed_groups && $2::text[]
  and d.valid_from <= now()
  and (d.valid_to is null or d.valid_to > now())
order by c.embedding <=> $1
limit 30;  -- szerszy wybór do rerankingu, do modelu trafiają najlepsze
Ważne jest, skąd bierze się $2. Z sesji zalogowanego użytkownika, nigdy z tego, co wpisał w pytanie. A uprawnienia synchronizują się ze źródła, na przykład z dysków sieciowych albo z systemu, w którym dokument żyje. Jeśli dokument zostanie zablokowany w źródle, zablokuje się też w indeksie.
Jak zmusić model do odmowy, gdy nie ma źródła?
Prompt „odpowiadaj tylko na podstawie kontekstu” pomaga, ale nie wystarcza. Polegać można na tym, co sprawdzi kod. Dlatego model nie zwraca wolnego tekstu, tylko ustrukturyzowany wynik: albo odpowiedź z id cytowanych fragmentów, albo odmowę.
type RagAnswer = { answer: string; citations: string[] } | { refused: true; reason: string }

function check(out: RagAnswer, retrievedIds: Set<string>): RagAnswer {
  if ('refused' in out) return out
  // citation must exist and point only at chunks this user actually got
  if (out.citations.length === 0 || out.citations.some((id) => !retrievedIds.has(id)))
    return { refused: true, reason: 'no valid source' }
  return out
}
Kod nie sprawdzi, czy odpowiedź naprawdę wynika ze źródła. Sprawdzi, że źródło istnieje i że model mógł je widzieć. Czy odpowiedź zgadza się ze źródłem, mierzymy w ewaluacjach, a przy swobodniejszych odpowiedziach także sędzią oceniającym według kryteriów. Jak działa taki sędzia i gdzie się myli, opisujemy w artykule LLM as a judge.
Użytkownik widzi przy odpowiedzi link do dokumentu. Gdy RAG odmawia, mówi to wprost i pokazuje, gdzie szukał. Odpowiedź „nie znalazłem tego w dokumentach” jest lepsza niż przekonujący błąd. Więcej o tym, dlaczego modele zmyślają, w artykule Halucynacje AI.
Jak zmierzyć, że RAG nie kłamie?
Zestawem pytań, które ludzie naprawdę zadają, z poprawną odpowiedzią i dokumentem, który ją zawiera. Nie pytaniami, które wymyśla programista przy pisaniu promptu. Jeden przypadek wygląda na przykład tak:
- id: delegacja-zatwierdzenie
  as_user: groups=[sprzedaz]
  question: Kto zatwierdza moją delegację zagraniczną?
  expect_source: regulamin-podrozy-sluzbowych.pdf#zatwierdzanie
  expect_answer_contains: ["kierownik działu"]
- id: wynagrodzenia-bez-uprawnien
  as_user: groups=[sprzedaz]
  question: Ile zarabia kierownik magazynu?
  expect: refused
- id: poza-dokumentami
  as_user: groups=[sprzedaz]
  question: Jaki jest dziś kurs euro?
  expect: refused
Przykład jest wymyślony, chodzi o formę. Przy każdej zmianie promptu, modelu, chunkingu albo źródeł uruchamia się cały zestaw i osobno śledzi się cztery liczby:
- Wyszukiwanie: czy oczekiwane źródło było wśród fragmentów, które dostał model?
- Odpowiedź: czy zawiera poprawną informację i cytuje właściwe źródło?
- Odmowa: czy odmówił tam, gdzie odpowiedzi nie ma, i nie odmówił tam, gdzie jest?
- Uprawnienia: przypadki, w których ktoś dostał fragment, którego nie może widzieć. Tu jedyną akceptowalną wartością jest zero.
Złe odpowiedzi z produkcji, które oznaczą użytkownicy, wracają do zestawu jako nowe przypadki. Dzięki temu zestaw rośnie razem z tym, o co ludzie naprawdę pytają.
Czy Państwa RAG jest gotowy na dane firmy?
Proszę przejrzeć swoją konfigurację:
Kiedy nie budować RAG
- Dokumentów jest kilkadziesiąt i rzadko się zmieniają. Często wystarczy włożyć je w całości do kontekstu modelu i oszczędzić sobie indeksu.
- Odpowiedź jest w bazie danych, nie w tekście. O status zamówienia albo stan magazynu proszę pytać zapytaniem do systemu, nie wyszukiwaniem w dokumentach.
- Nikt nie wie, które dokumenty obowiązują. RAG nad bałaganem odpowiada szybko i źle. Najpierw trzeba uporządkować źródła.
- Nie ma komu napisać ewaluacji. Bez zestawu pytań ze znaną odpowiedzią nie wiedzą Państwo, czy RAG kłamie, i nie dowiedzą się tego nawet po zmianie modelu.
Potrzebują Państwo RAG, któremu ludzie zaufają?
RAG na danych firmy budujemy w ramach usługi Agent AI na zamówienie dla firm: wyszukiwanie, uprawnienia, cytaty i ewaluacje bezpośrednio w Państwa repozytorium. Kod, indeks i dane należą do Państwa od pierwszego dnia.
Odezwiemy się w ciągu dwóch dni roboczych z kilkoma pytaniami o Państwa pracę. Potem ustalimy, co zrobimy najpierw.
Jeśli wolą Państwo najpierw porozmawiać, proszę zarezerwować 15-minutową rozmowę wstępną.
Co zrobi dziś Państwa RAG, gdy zapytają go Państwo o coś, czego nie ma w dokumentach?
W skrócie
- RAG kłamie zwykle dlatego, że wyszukiwanie zwróciło zły albo nieaktualny fragment, a nie dlatego, że model zmyśla coś z niczego.
- Metadane z wersją i ważnością, wyszukiwanie hybrydowe i reranking rozwiązują większość złych odpowiedzi.
- Uprawnienia proszę filtrować w zapytaniu do indeksu według zalogowanego użytkownika. Prompt nie jest kontrolą dostępu.
- Model zwraca odpowiedź z cytatami albo odmowę, a kod sprawdza, że cytaty są wśród znalezionych fragmentów.
- Zestaw ewaluacji z pytaniami bez odpowiedzi i bez uprawnień uruchamia się przy każdej zmianie.
Często zadawane pytania
Czym jest RAG?
RAG (retrieval-augmented generation) oznacza, że system najpierw wyszukuje do pytania fragmenty Państwa dokumentów i dopiero na ich podstawie model językowy pisze odpowiedź. Model odpowiada więc z Państwa danych, a nie z tego, co zapamiętał z treningu.
Dlaczego RAG na danych firmy kłamie?
Najczęściej dlatego, że wyszukiwanie zwróciło zły albo nieaktualny fragment, a model posłusznie na jego podstawie odpowiedział. Rzadziej dlatego, że model dopisał coś, czego we fragmencie nie było. Pierwsze rozwiązują metadane, wyszukiwanie hybrydowe i ewaluacje wyszukiwania, drugie cytaty sprawdzane kodem i zasada odmowy bez źródła.
Jak w RAG rozwiązać uprawnienia dostępu do dokumentów?
Filtrem w zapytaniu do indeksu, według tożsamości użytkownika, zanim model zobaczy jakikolwiek fragment. Polecenie w prompcie w rodzaju „nie pokazuj wynagrodzeń” nie jest kontrolą dostępu. Czego model nie dostanie, tego nie może zdradzić.
Jak sprawdzić, czy RAG odpowiada poprawnie?
Zestawem prawdziwych pytań z poprawną odpowiedzią i źródłem, które ją zawiera. Należą do niego też pytania, na które w dokumentach nie ma odpowiedzi, i pytania od użytkownika, który nie może widzieć dokumentu. Uruchamia się go przy każdej zmianie promptu, modelu, chunkingu i dokumentów.
Czy do RAG potrzebuję bazy wektorowej?
Niekoniecznie osobnej. Przy tysiącach dokumentów często wystarczy Państwa obecna baza danych z rozszerzeniem do wektorów i wyszukiwaniem pełnotekstowym. Ważniejsze od samej bazy jest to, żeby umiała filtrować według uprawnień i wersji w tym samym zapytaniu.
Zapytaj AI o ten artykuł
AI przy odpowiedzi wykorzysta też nasze inne artykuły i doświadczenia z prawdziwych projektów.
ChatGPTClaudePerplexity

