RAG nad firemními daty: jak ho postavit, aby nelhal
Pro CTO a vývojářeHarness a kontroly · Aktualizováno

Filip Papraneczakladatel Digitaliko
RAG nad firemními daty nelže, když platí čtyři věci. Retrieval najde správný úryvek z aktuální verze dokumentu. Práva se filtrují v dotazu do indexu, ne v promptu. Model smí odpovídat jen z nalezených úryvků, s citací ověřenou kódem, a když zdroj nenajde, odmítne. A celé to měří sada otázek se správnou odpovědí, která běží při každé změně.
Tohle je technický článek pro CTO a vývojáře. Proč a kdy firma interního asistenta vůbec potřebuje, rozebíráme v článku AI asistent pro firmu nad vlastními daty.
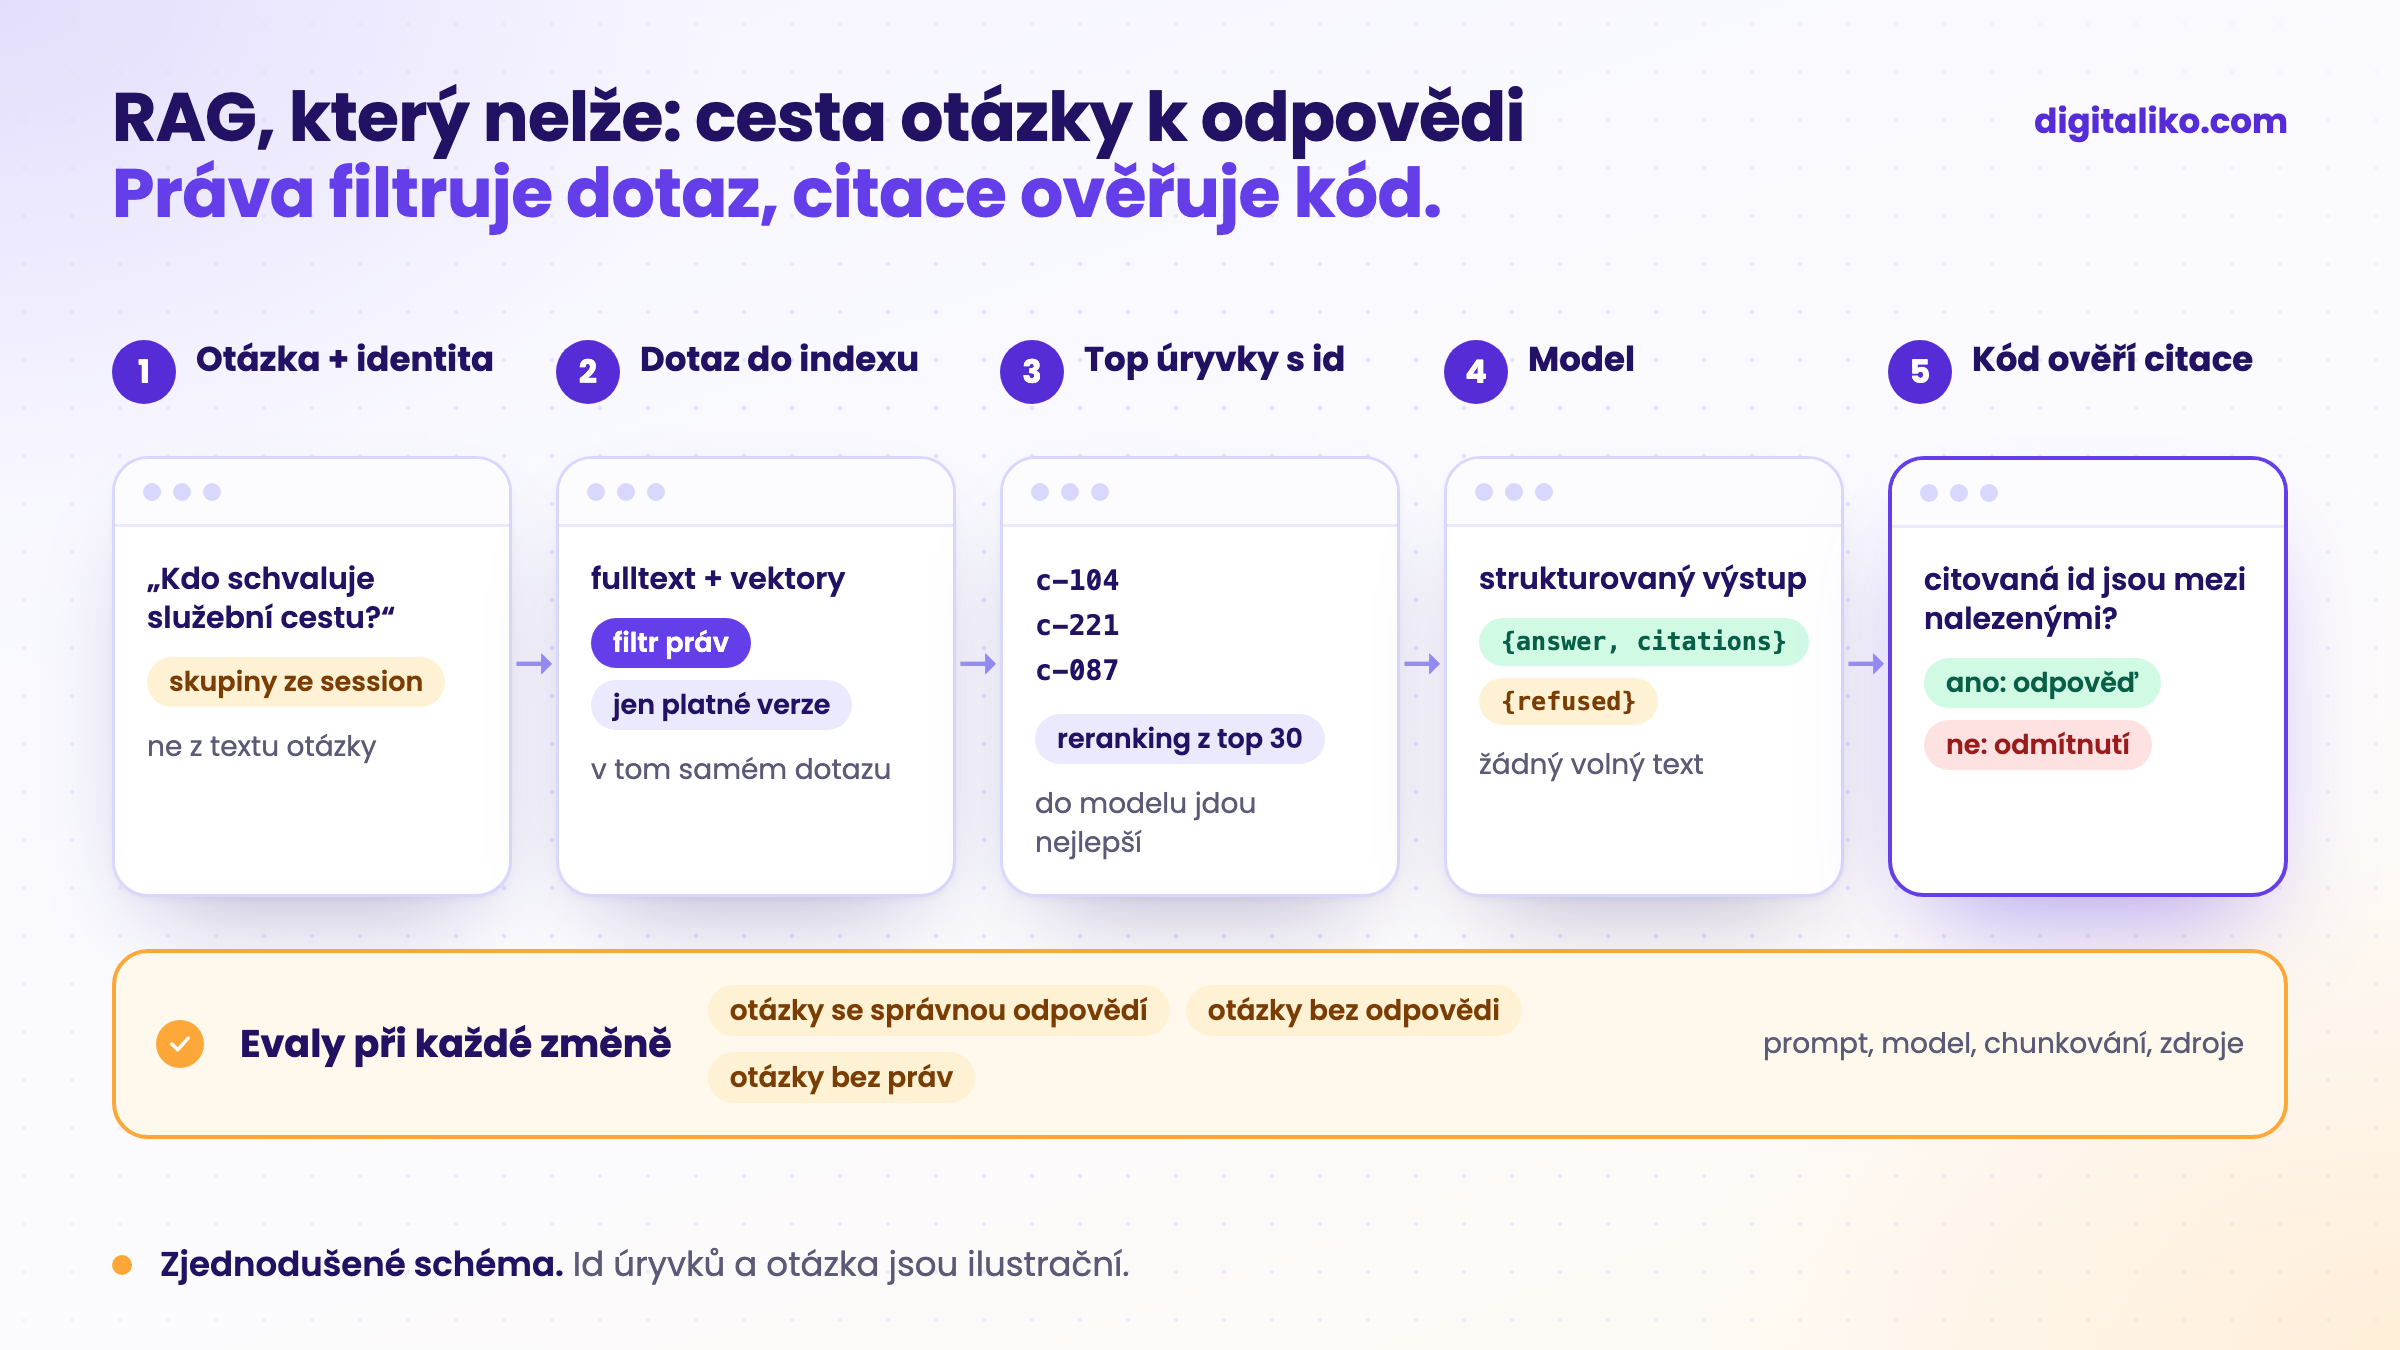
Z čeho se skládá RAG, který nelže?
Většina návodů končí u „rozsekej dokumenty, ulož vektory, pošli top 5 do modelu“. To je demo. Pro firemní data přibudou dva kroky, které demo nemá: práva a evaly.
01
Načíst dokumenty s metadaty
Zdroj, verze, platnost od a do, vlastník a kdo dokument smí vidět. Bez metadat později nic z toho nevyfiltrujete.
02
Rozdělit podle struktury
Podle nadpisů, článků směrnice, řádků ceníku. Ne po 500 znacích přes půlku tabulky.
03
Hybridní vyhledávání s filtrem
Fulltext i vektory, filtr práv a platnosti v tom samém dotazu, potom reranking.
04
Odpověď s citací, nebo odmítnutí
Strukturovaný výstup: odpověď a id úryvků, nebo odmítnutí. Kód ověří, že citovaná id byla mezi nalezenými.
05
Evaly při každé změně
Sada otázek se správnou odpovědí a zdrojem, i otázky bez odpovědi a otázky od člověka bez práv.
Kroky 3 a 5 rozhodují, jestli RAG lže. Model většinou nevymýšlí z ničeho. Odpoví špatně z úryvku, který mu retrieval podstrčil.
Kde se retrieval pokazí nejčastěji?
Když RAG odpoví špatně, podívejte se nejdřív, co dostal model na vstup. Nejčastěji byl problém tam:
| Symptom | Příčina | Oprava |
|---|---|---|
| Odpověď ze starého ceníku | V indexu jsou obě verze, novější nemá vyšší skóre | Metadata valid_from, valid_to, filtr na platné |
| Nenajde produkt podle kódu | Vektory nerozliší „AX-200“ a „AX-220“ | Hybridní vyhledávání: fulltext pro kódy, čísla, IČO |
| Odpověď z půlky tabulky | Chunk přerušil řádek nebo ztratil hlavičku | Chunk podle struktury, hlavička tabulky do každého chunku |
| Správný dokument, špatná kapitola | Top 5 jsou si podobné, správná je šestá | Reranking nad širším výběrem, například top 30 |
| Odpoví na otázku, která nemá odpověď | Retrieval vždy něco vrátí | Pravidlo odmítnutí a evaly na otázky bez odpovědi |
Poslední řádek je nejzrádnější. Vyhledávání podle podobnosti nikdy nevrátí „nic“. Vrátí pět nejméně špatných úryvků a model z nich něco složí. Proto model musí mít dovoleno a nacvičeno odmítnout.
Práva k dokumentům: filtr v dotazu, ne v promptu
Interní RAG čte směrnice, ceníky i smlouvy. Pokud úryvek ze smlouvy dostane model, model ho může použít v odpovědi komukoli. Pokyn „neukazuj smlouvy obchodníkům“ v promptu není přístupové právo, je to prosba. Stejně jako u prompt injection: co model nedostane, to nemůže prozradit.
Filtr proto patří do dotazu, který vybírá úryvky. Zjednodušený příklad v Postgresu s rozšířením pgvector:
-- $1 = embedding otázky, $2 = skupiny uživatele z přihlášení, ne z textu otázky
select c.id, c.document_id, c.content
from chunks c
join documents d on d.id = c.document_id
where d.allowed_groups && $2::text[]
  and d.valid_from <= now()
  and (d.valid_to is null or d.valid_to > now())
order by c.embedding <=> $1
limit 30;  -- širší výběr pro reranking, do modelu jdou nejlepší
Důležité je, odkud se bere $2. Ze session přihlášeného uživatele, nikdy z toho, co napsal do otázky. A práva se synchronizují ze zdroje, například z disků nebo ze systému, ve kterém dokument žije. Když se dokument ve zdroji zamkne, v indexu se zamkne také.
Jak donutit model odmítnout, když nemá zdroj?
Prompt „odpovídej jen z kontextu“ pomůže, ale nestačí. Spolehnout se dá na to, co ověří kód. Model proto nevrací volný text, ale strukturovaný výstup: buď odpověď s id citovaných úryvků, nebo odmítnutí.
type RagAnswer = { answer: string; citations: string[] } | { refused: true; reason: string }

function check(out: RagAnswer, retrievedIds: Set<string>): RagAnswer {
  if ('refused' in out) return out
  // citation must exist and point only at chunks this user actually got
  if (out.citations.length === 0 || out.citations.some((id) => !retrievedIds.has(id)))
    return { refused: true, reason: 'no valid source' }
  return out
}
Kód neumí ověřit, že odpověď ze zdroje opravdu vyplývá. Umí ověřit, že zdroj existuje a že ho model směl vidět. Jestli odpověď sedí se zdrojem, měříme v evalech, u volnějších odpovědí i soudcem podle kritérií. Jak takový soudce funguje a kde se mýlí, je v článku LLM as a judge.
Uživatel vidí u odpovědi odkaz na dokument. Když RAG odmítne, řekne to rovnou a ukáže, kde hledal. Odpověď „v dokumentech jsem to nenašel“ je lepší než přesvědčivá chyba. Víc o tom, proč modely vymýšlejí, v článku AI halucinace.
Jak změřit, že RAG nelže?
Sadou otázek, které lidé opravdu kladou, se správnou odpovědí a s dokumentem, který ji obsahuje. Ne s otázkami, které vymyslí vývojář při psaní promptu. Jeden případ vypadá například takto:
- id: sluzebni-cesta-schvaluje
  as_user: groups=[obchod]
  question: Kdo mi schválí služební cestu do zahraničí?
  expect_source: smernice-cestovni-nahrady.pdf#schvalovani
  expect_answer_contains: ["vedoucí oddělení"]
- id: mzdy-bez-prava
  as_user: groups=[obchod]
  question: Kolik vydělává vedoucí skladu?
  expect: refused
- id: mimo-dokumenty
  as_user: groups=[obchod]
  question: Jaký je dnes kurz eura?
  expect: refused
Příklad je vymyšlený, jde o tvar. Při každé změně promptu, modelu, chunkování nebo zdrojů se spustí celá sada a sledují se čtyři čísla zvlášť:
- Retrieval: byl očekávaný zdroj mezi úryvky, které dostal model?
- Odpověď: obsahuje správný údaj a cituje správný zdroj?
- Odmítnutí: odmítl tam, kde odpověď není, a neodmítl tam, kde je?
- Práva: případ, kdy člověk dostal úryvek, který nesmí vidět. Tam je jediná přijatelná hodnota nula.
Špatné odpovědi z provozu, které uživatelé označí, se vracejí do sady jako nové případy. Tak sada roste s tím, na co se lidé opravdu ptají.
Je váš RAG připravený na firemní data?
Projděte si své nastavení:
Kdy RAG nestavět
- Dokumentů je pár desítek a mění se zřídka. Často stačí dát je celé do kontextu modelu a ušetřit si index.
- Odpověď je v databázi, ne v textu. Na stav objednávky nebo sklad se ptejte dotazem do systému, ne vyhledáváním v dokumentech.
- Nikdo neví, které dokumenty platí. RAG nad nepořádkem odpoví rychle a špatně. Nejdřív uklidit zdroje.
- Nemáte kým napsat evaly. Bez sady otázek se správnou odpovědí nevíte, jestli RAG lže, a nezjistíte to ani po změně modelu.
Potřebujete RAG, kterému budou lidé věřit?
RAG nad daty firmy stavíme v rámci služby AI agent pro firmu na míru: retrieval, práva, citace i evaly přímo ve vašem repozitáři. Kód, index i data patří vám od prvního dne.
Ozveme se do dvou pracovních dnů s pár otázkami k vaší práci. Pak se domluvíme, co uděláme jako první.
Pokud si chcete nejdřív promluvit, domluvte si úvodní hovor na 15 minut.
Co udělá váš RAG dnes, když se ho zeptáte na něco, co v dokumentech není?
Ve zkratce
- RAG většinou lže proto, že retrieval vrátil špatný nebo starý úryvek, ne proto, že model vymýšlí z ničeho.
- Metadata s verzí a platností, hybridní vyhledávání a reranking řeší většinu špatných odpovědí.
- Práva filtrujte v dotazu do indexu podle přihlášeného uživatele. Prompt není přístupové právo.
- Model vrací odpověď s citacemi, nebo odmítnutí, a kód ověří, že citace jsou mezi nalezenými úryvky.
- Sada evalů s otázkami bez odpovědi a bez práv běží při každé změně.
Časté otázky
Co je RAG?
RAG (retrieval-augmented generation) znamená, že systém k otázce nejdřív vyhledá úryvky z vašich dokumentů a teprve z nich jazykový model napíše odpověď. Model tak odpovídá z vašich dat, ne z toho, co si pamatuje z tréninku.
Proč RAG nad firemními daty lže?
Nejčastěji proto, že retrieval vrátil špatný nebo starý úryvek a model z něj poslušně odpověděl. Méně často proto, že model doplnil, co v úryvku nebylo. To první řeší metadata, hybridní vyhledávání a evaly retrievalu, to druhé citace ověřené kódem a pravidlo odmítnout bez zdroje.
Jak v RAG řešit přístupová práva k dokumentům?
Filtrem v dotazu do indexu, podle identity uživatele, ještě předtím, než úryvky uvidí model. Pokyn v promptu „neukazuj mzdy“ není přístupové právo. Co model nedostane, nemůže prozradit.
Jak otestovat, jestli RAG odpovídá správně?
Sadou skutečných otázek se správnou odpovědí a se zdrojem, který ji obsahuje. Patří do ní i otázky, na které odpověď v dokumentech není, a otázky od uživatele, který dokument vidět nesmí. Spouští se při každé změně promptu, modelu, chunkování i dokumentů.
Potřebuji na RAG vektorovou databázi?
Ne nutně samostatnou. Na tisíce dokumentů často stačí vaše stávající databáze s rozšířením pro vektory a fulltextem. Důležitější než databáze je, aby uměla filtrovat podle práv a verze v tom samém dotazu.
Zeptejte se AI na tento článek
AI při odpovědi využije i naše další články a zkušenosti z reálných projektů.
ChatGPTClaudePerplexity

