RAG con datos de empresa: cómo construirlo sin que mienta
Para CTO y desarrolladoresHarness y controles · Actualizado

Filip PapranecFundador de Digitaliko
Un RAG con datos de empresa no miente cuando se cumplen cuatro cosas. La búsqueda encuentra el fragmento correcto de la versión vigente del documento. Los permisos se filtran en la consulta al índice, no en el prompt. El modelo solo puede responder a partir de los fragmentos encontrados, con una cita verificada por código, y si no encuentra fuente, rechaza. Y todo ello lo mide un conjunto de preguntas con respuesta conocida que se ejecuta con cada cambio.
Este es un artículo técnico para CTO y desarrolladores. Por qué y cuándo una empresa necesita un asistente interno lo tratamos en el artículo Asistente de IA para empresas con sus propios datos.
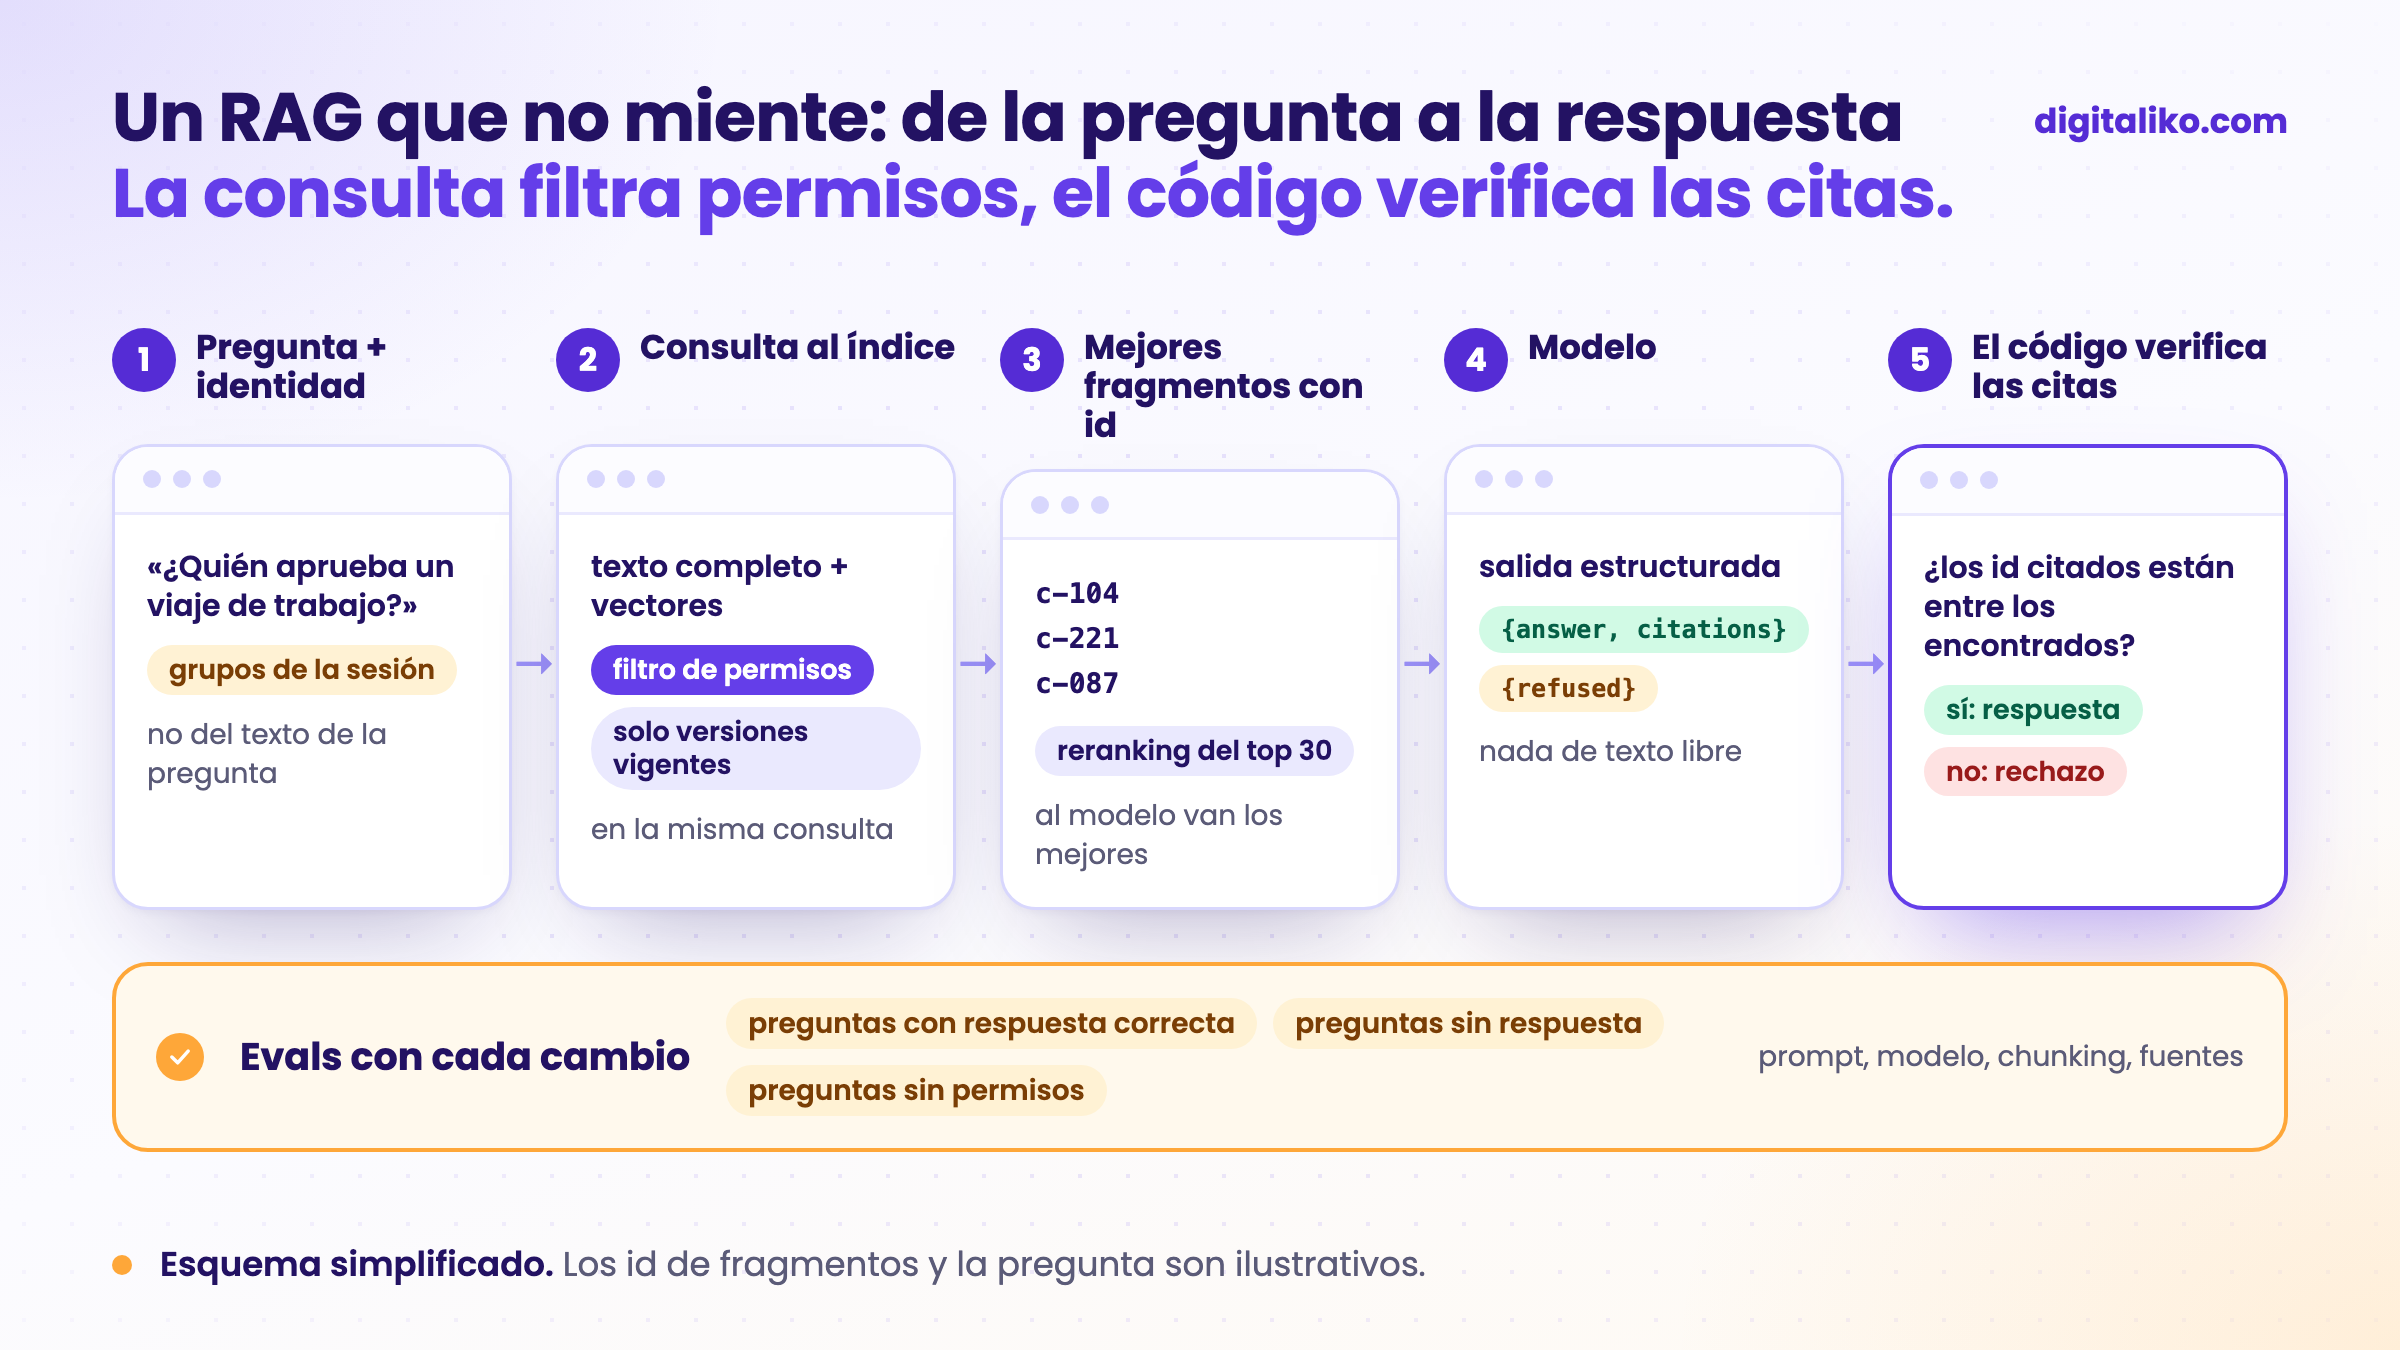
¿De qué se compone un RAG que no miente?
La mayoría de los tutoriales terminan en «trocea los documentos, guarda los vectores, envía el top 5 al modelo». Eso es una demo. Con datos de empresa se añaden dos pasos que la demo no tiene: permisos y evals.
01
Cargar documentos con metadatos
Fuente, versión, vigencia desde y hasta, responsable y quién puede ver el documento. Sin metadatos no podrá filtrar nada de esto más adelante.
02
Dividir según la estructura
Por títulos, apartados de una política interna, filas de una tarifa. No cada 500 caracteres partiendo una tabla por la mitad.
03
Búsqueda híbrida con filtro
Texto completo y vectores, filtro de permisos y vigencia en la misma consulta, y después reranking.
04
Respuesta con cita, o rechazo
Salida estructurada: respuesta con los id de los fragmentos, o rechazo. El código verifica que los id citados estaban entre los encontrados.
05
Evals con cada cambio
Un conjunto de preguntas con respuesta correcta y fuente, además de preguntas sin respuesta y preguntas de alguien sin permisos.
Los pasos 3 y 5 deciden si el RAG miente. El modelo rara vez inventa de la nada. Responde mal a partir de un fragmento que la búsqueda le pasó.
¿Dónde falla la búsqueda con más frecuencia?
Cuando el RAG responde mal, mire primero qué recibió el modelo como entrada. Casi siempre el problema estaba ahí:
| Síntoma | Causa | Solución |
|---|---|---|
| Respuesta con la tarifa antigua | En el índice están las dos versiones y la nueva no puntúa más alto | Metadatos valid_from, valid_to, filtro a las vigentes |
| No encuentra un producto por su código | Los vectores no distinguen «AX-200» de «AX-220» | Búsqueda híbrida: texto completo para códigos, números, NIF |
| Respuesta a partir de media tabla | El chunk cortó una fila o perdió la cabecera | Chunks según la estructura, cabecera de la tabla en cada chunk |
| Documento correcto, capítulo equivocado | Los 5 primeros se parecen, el correcto es el sexto | Reranking sobre una selección más amplia, por ejemplo el top 30 |
| Responde a una pregunta que no tiene respuesta | La búsqueda siempre devuelve algo | Regla de rechazo y evals con preguntas sin respuesta |
La última fila es la más traicionera. La búsqueda por similitud nunca devuelve «nada». Devuelve los cinco fragmentos menos malos y el modelo compone algo con ellos. Por eso el modelo debe tener permitido rechazar, y haberlo practicado.
Permisos sobre documentos: filtro en la consulta, no en el prompt
Un RAG interno lee políticas internas, tarifas y contratos. Si el modelo recibe un fragmento de un contrato, puede usarlo en la respuesta a cualquiera. La instrucción «no muestres los contratos al equipo comercial» en el prompt no es control de acceso, es una petición. Igual que con la prompt injection: lo que el modelo no recibe, no lo puede revelar.
Por eso el filtro va en la consulta que selecciona los fragmentos. Un ejemplo simplificado en Postgres con la extensión pgvector:
-- $1 = embedding de la pregunta, $2 = grupos del usuario del inicio de sesión, no del texto de la pregunta
select c.id, c.document_id, c.content
from chunks c
join documents d on d.id = c.document_id
where d.allowed_groups && $2::text[]
  and d.valid_from <= now()
  and (d.valid_to is null or d.valid_to > now())
order by c.embedding <=> $1
limit 30;  -- selección más amplia para el reranking, al modelo van solo los mejores
Lo importante es de dónde sale $2. De la sesión del usuario que ha iniciado sesión, nunca de lo que escribió en la pregunta. Y los permisos se sincronizan desde el origen, por ejemplo desde las unidades compartidas o desde el sistema donde vive el documento. Si el documento se bloquea en el origen, también se bloquea en el índice.
¿Cómo obligar al modelo a rechazar cuando no tiene fuente?
Un prompt como «responde solo a partir del contexto» ayuda, pero no basta. En lo que se puede confiar es en lo que verifica el código. Por eso el modelo no devuelve texto libre, sino una salida estructurada: o una respuesta con los id de los fragmentos citados, o un rechazo.
type RagAnswer = { answer: string; citations: string[] } | { refused: true; reason: string }

function check(out: RagAnswer, retrievedIds: Set<string>): RagAnswer {
  if ('refused' in out) return out
  // citation must exist and point only at chunks this user actually got
  if (out.citations.length === 0 || out.citations.some((id) => !retrievedIds.has(id)))
    return { refused: true, reason: 'no valid source' }
  return out
}
El código no puede verificar que la respuesta se deduzca realmente de la fuente. Puede verificar que la fuente existe y que el modelo podía verla. Si la respuesta encaja con la fuente lo medimos en los evals y, en respuestas más abiertas, también con un juez que aplica criterios. Cómo funciona ese juez y dónde se equivoca está en el artículo LLM as a judge.
El usuario ve junto a la respuesta un enlace al documento. Cuando el RAG rechaza, lo dice claramente y muestra dónde buscó. «No lo he encontrado en los documentos» es mejor que un error convincente. Más sobre por qué los modelos inventan en el artículo Alucinaciones de la IA.
¿Cómo medir que el RAG no miente?
Con un conjunto de preguntas que la gente hace de verdad, con la respuesta correcta y el documento que la contiene. No con preguntas que se inventa un desarrollador mientras escribe el prompt. Un caso tiene, por ejemplo, este aspecto:
- id: viaje-de-trabajo-aprobacion
  as_user: groups=[comercial]
  question: ¿Quién aprueba mi viaje de trabajo al extranjero?
  expect_source: politica-de-gastos-de-viaje.pdf#aprobacion
  expect_answer_contains: ["responsable de departamento"]
- id: salarios-sin-permiso
  as_user: groups=[comercial]
  question: ¿Cuánto cobra el jefe de almacén?
  expect: refused
- id: fuera-de-documentos
  as_user: groups=[comercial]
  question: ¿Cuál es hoy el tipo de cambio del euro?
  expect: refused
El ejemplo es inventado, lo que importa es la forma. Con cada cambio de prompt, modelo, chunking o fuentes se ejecuta el conjunto completo y se siguen cuatro cifras por separado:
- Retrieval: ¿estaba la fuente esperada entre los fragmentos que recibió el modelo?
- Respuesta: ¿contiene el dato correcto y cita la fuente correcta?
- Rechazo: ¿rechazó donde no hay respuesta y no rechazó donde sí la hay?
- Permisos: casos en los que alguien recibió un fragmento que no debe ver. Ahí el único valor aceptable es cero.
Las respuestas erróneas en producción que marcan los usuarios vuelven al conjunto como casos nuevos. Así el conjunto crece con lo que la gente pregunta de verdad.
¿Está su RAG preparado para los datos de la empresa?
Revise su configuración:
Cuándo no construir un RAG
- Hay unas pocas decenas de documentos y cambian poco. A menudo basta con meterlos enteros en el contexto del modelo y ahorrarse el índice.
- La respuesta está en una base de datos, no en un texto. El estado de un pedido o el stock se consultan con una consulta al sistema, no con una búsqueda en documentos.
- Nadie sabe qué documentos están vigentes. Un RAG sobre el desorden responde rápido y mal. Primero hay que ordenar las fuentes.
- No tiene a nadie que escriba los evals. Sin un conjunto de preguntas con respuesta conocida no sabe si el RAG miente, y tampoco lo sabrá después de cambiar de modelo.
¿Necesita un RAG en el que la gente confíe?
Construimos RAG con datos de empresa dentro de nuestro servicio Agente de IA a medida para empresas: búsqueda, permisos, citas y evals directamente en su repositorio. El código, el índice y los datos son suyos desde el primer día.
Le responderemos en dos días laborables con algunas preguntas sobre su trabajo. Después acordaremos qué hacemos primero.
Si prefiere hablar antes, reserve una llamada introductoria de 15 minutos.
¿Qué hace hoy su RAG cuando le pregunta algo que no está en los documentos?
En resumen
- Un RAG miente casi siempre porque la búsqueda devolvió un fragmento equivocado o antiguo, no porque el modelo invente de la nada.
- Los metadatos con versión y vigencia, la búsqueda híbrida y el reranking resuelven la mayoría de las respuestas erróneas.
- Filtre los permisos en la consulta al índice según el usuario que ha iniciado sesión. Un prompt no es control de acceso.
- El modelo devuelve una respuesta con citas o un rechazo, y el código verifica que las citas están entre los fragmentos encontrados.
- Un conjunto de evals con preguntas sin respuesta y sin permisos se ejecuta con cada cambio.
Preguntas frecuentes
¿Qué es RAG?
RAG (retrieval-augmented generation) significa que el sistema primero busca fragmentos de sus documentos para la pregunta y solo después el modelo de lenguaje redacta la respuesta a partir de ellos. Así el modelo responde con sus datos, no con lo que recuerda del entrenamiento.
¿Por qué miente un RAG con datos de empresa?
Casi siempre porque la búsqueda devolvió un fragmento equivocado o antiguo y el modelo respondió obedientemente a partir de él. Con menos frecuencia, porque el modelo añadió algo que no estaba en el fragmento. Lo primero se resuelve con metadatos, búsqueda híbrida y evals del retrieval; lo segundo, con citas verificadas por código y la regla de rechazar sin fuente.
¿Cómo se gestionan en RAG los permisos de acceso a los documentos?
Con un filtro en la consulta al índice, según la identidad del usuario, antes de que el modelo vea ningún fragmento. Una instrucción en el prompt como «no muestres los salarios» no es control de acceso. Lo que el modelo no recibe, no lo puede revelar.
¿Cómo se comprueba si un RAG responde bien?
Con un conjunto de preguntas reales, cada una con la respuesta correcta y la fuente que la contiene. Incluye también preguntas que los documentos no responden y preguntas de un usuario que no debe ver el documento. Se ejecuta con cada cambio de prompt, modelo, chunking y documentos.
¿Necesito una base de datos vectorial para RAG?
No necesariamente una aparte. Para miles de documentos suele bastar su base de datos actual con una extensión para vectores y búsqueda de texto completo. Más importante que la base de datos es que pueda filtrar por permisos y versión en la misma consulta.
Pregunte a una IA sobre este artículo
La IA también tiene en cuenta nuestros otros artículos y la experiencia de proyectos reales.
ChatGPTClaudePerplexity

