RAG mit Firmendaten: So bauen Sie es, damit es nicht lügt
Für CTOs und EntwicklerHarness und Prüfungen · Aktualisiert

Filip PapranecGründer von Digitaliko
RAG mit Firmendaten lügt nicht, wenn vier Dinge gelten. Das Retrieval findet den richtigen Chunk aus der aktuellen Version des Dokuments. Berechtigungen werden in der Index-Abfrage gefiltert, nicht im Prompt. Das Modell darf nur aus den gefundenen Chunks antworten, mit einem per Code geprüften Zitat, und lehnt ab, wenn es keine Quelle findet. Und ein Satz von Fragen mit bekannter Antwort misst das Ganze bei jeder Änderung.
Dies ist ein technischer Artikel für CTOs und Entwickler. Warum und wann ein Unternehmen überhaupt einen internen Assistenten braucht, behandeln wir im Artikel KI-Assistent für Unternehmen mit eigenen Daten.
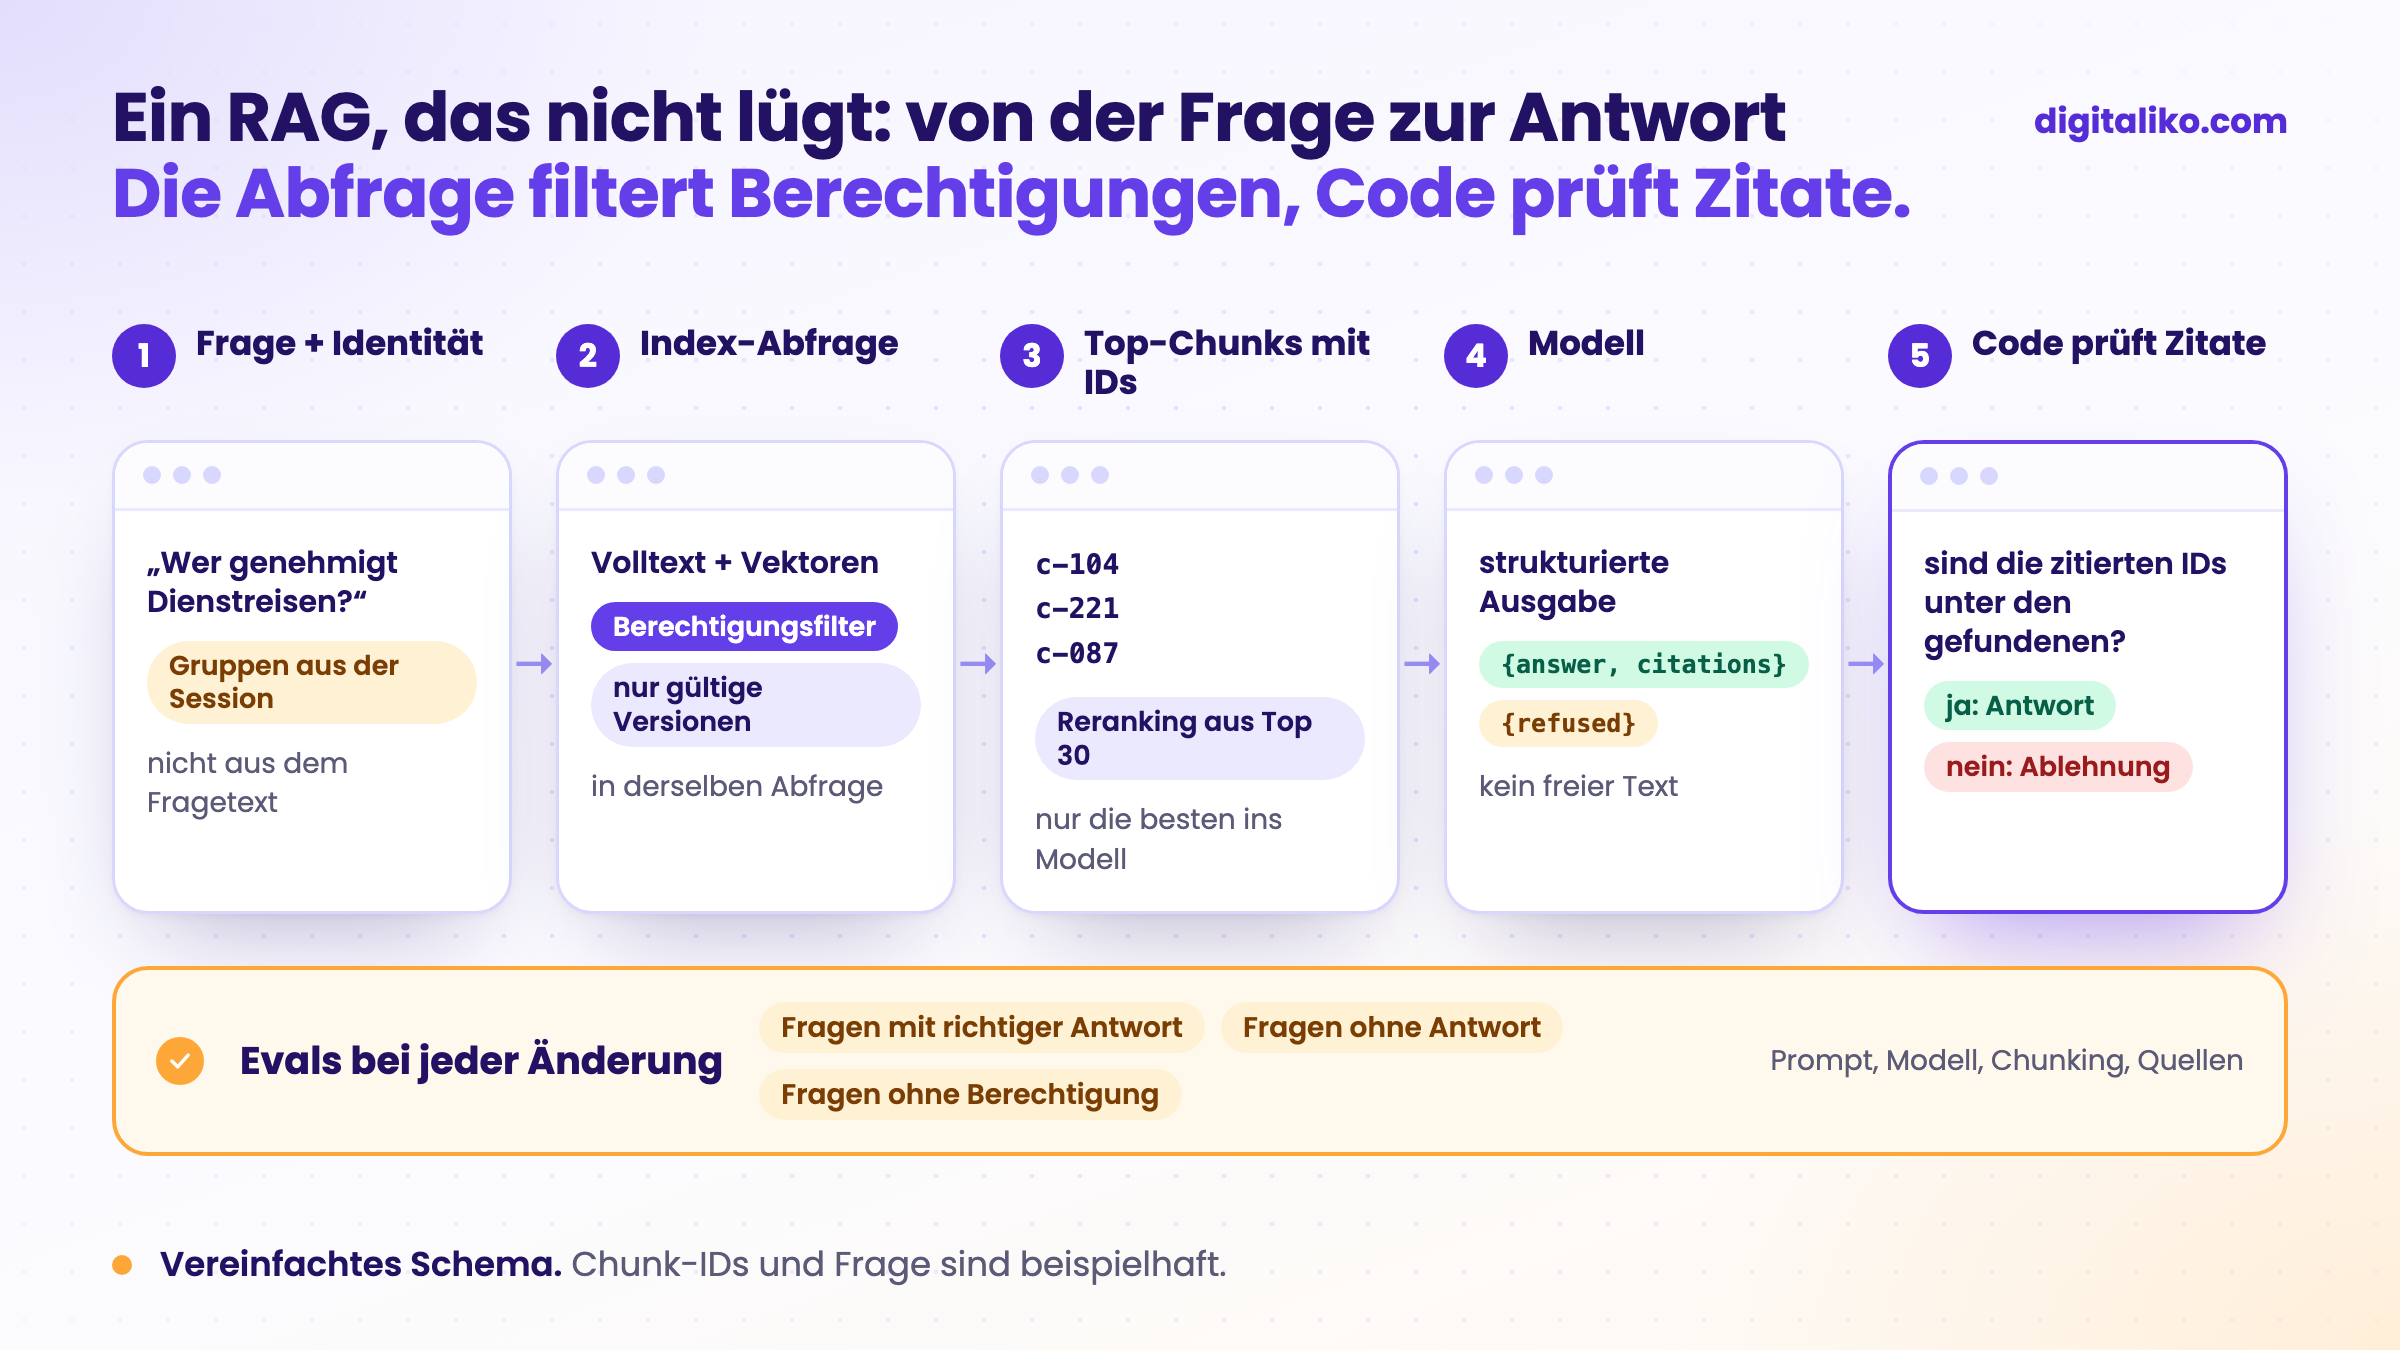
Woraus besteht ein RAG, das nicht lügt?
Die meisten Anleitungen enden bei „Dokumente zerlegen, Vektoren speichern, Top 5 an das Modell schicken“. Das ist eine Demo. Bei Firmendaten kommen zwei Schritte dazu, die die Demo nicht hat: Berechtigungen und Evals.
01
Dokumente mit Metadaten laden
Quelle, Version, gültig von und bis, Eigentümer und wer das Dokument sehen darf. Ohne Metadaten können Sie später nach nichts davon filtern.
02
Nach Struktur aufteilen
Nach Überschriften, Abschnitten einer Richtlinie, Zeilen einer Preisliste. Nicht alle 500 Zeichen mitten durch eine Tabelle.
03
Hybride Suche mit Filter
Volltext und Vektoren, Filter für Berechtigungen und Gültigkeit in derselben Abfrage, danach Reranking.
04
Antwort mit Zitat oder Ablehnung
Strukturierte Ausgabe: Antwort mit Chunk-IDs oder Ablehnung. Code prüft, dass die zitierten IDs unter den gefundenen waren.
05
Evals bei jeder Änderung
Ein Satz Fragen mit richtiger Antwort und Quelle, dazu Fragen ohne Antwort und Fragen von jemandem ohne Berechtigung.
Die Schritte 3 und 5 entscheiden, ob RAG lügt. Das Modell erfindet selten etwas aus dem Nichts. Es antwortet falsch aus einem Chunk, den ihm das Retrieval untergeschoben hat.
Wo geht das Retrieval am häufigsten kaputt?
Wenn RAG falsch antwortet, schauen Sie zuerst, was das Modell als Eingabe bekommen hat. Meistens lag das Problem dort:
| Symptom | Ursache | Lösung |
|---|---|---|
| Antwort aus der alten Preisliste | Beide Versionen sind im Index, die neuere hat keinen höheren Score | Metadaten valid_from, valid_to, Filter auf gültige |
| Findet ein Produkt nicht über den Code | Vektoren unterscheiden „AX-200“ und „AX-220“ nicht | Hybride Suche: Volltext für Codes, Nummern, USt-IdNr. |
| Antwort aus einer halben Tabelle | Der Chunk hat eine Zeile zerschnitten oder den Kopf verloren | Chunks nach Struktur, Tabellenkopf in jeden Chunk |
| Richtiges Dokument, falsches Kapitel | Die Top 5 ähneln sich, das richtige ist das sechste | Reranking über eine breitere Auswahl, zum Beispiel Top 30 |
| Beantwortet eine Frage ohne Antwort | Das Retrieval liefert immer etwas | Ablehnungsregel und Evals für Fragen ohne Antwort |
Die letzte Zeile ist die tückischste. Eine Ähnlichkeitssuche liefert nie „nichts“. Sie liefert die fünf am wenigsten falschen Chunks, und das Modell baut daraus etwas zusammen. Deshalb muss das Modell ablehnen dürfen und es geübt haben.
Berechtigungen auf Dokumente: Filter in der Abfrage, nicht im Prompt
Ein internes RAG liest Richtlinien, Preislisten und Verträge. Bekommt das Modell einen Chunk aus einem Vertrag, kann es ihn in einer Antwort an jeden verwenden. Die Anweisung „Verträge nicht dem Vertrieb zeigen“ im Prompt ist keine Zugriffskontrolle, sondern eine Bitte. Genau wie bei Prompt Injection: Was das Modell nicht bekommt, kann es nicht verraten.
Der Filter gehört deshalb in die Abfrage, die die Chunks auswählt. Ein vereinfachtes Beispiel in Postgres mit der Erweiterung pgvector:
-- $1 = Embedding der Frage, $2 = Gruppen des Nutzers aus dem Login, nicht aus dem Fragetext
select c.id, c.document_id, c.content
from chunks c
join documents d on d.id = c.document_id
where d.allowed_groups && $2::text[]
  and d.valid_from <= now()
  and (d.valid_to is null or d.valid_to > now())
order by c.embedding <=> $1
limit 30;  -- breitere Auswahl für das Reranking, ins Modell gehen nur die besten
Entscheidend ist, woher $2 kommt. Aus der Session des angemeldeten Nutzers, nie aus dem, was er in die Frage geschrieben hat. Und die Berechtigungen werden aus der Quelle synchronisiert, etwa aus Netzlaufwerken oder dem System, in dem das Dokument liegt. Wird das Dokument in der Quelle gesperrt, wird es auch im Index gesperrt.
Wie bringt man das Modell dazu, ohne Quelle abzulehnen?
Ein Prompt wie „antworte nur aus dem Kontext“ hilft, reicht aber nicht. Verlassen können Sie sich auf das, was Code prüft. Das Modell liefert deshalb keinen freien Text, sondern eine strukturierte Ausgabe: entweder eine Antwort mit den IDs der zitierten Chunks oder eine Ablehnung.
type RagAnswer = { answer: string; citations: string[] } | { refused: true; reason: string }

function check(out: RagAnswer, retrievedIds: Set<string>): RagAnswer {
  if ('refused' in out) return out
  // citation must exist and point only at chunks this user actually got
  if (out.citations.length === 0 || out.citations.some((id) => !retrievedIds.has(id)))
    return { refused: true, reason: 'no valid source' }
  return out
}
Code kann nicht prüfen, ob die Antwort wirklich aus der Quelle folgt. Er kann prüfen, dass die Quelle existiert und dass das Modell sie sehen durfte. Ob die Antwort zur Quelle passt, messen wir in Evals, bei freieren Antworten auch mit einem Richter nach Kriterien. Wie so ein Richter funktioniert und wo er sich irrt, steht im Artikel LLM as a judge.
Der Nutzer sieht bei der Antwort einen Link zum Dokument. Lehnt RAG ab, sagt es das direkt und zeigt, wo es gesucht hat. „In den Dokumenten habe ich das nicht gefunden“ ist besser als ein überzeugender Fehler. Mehr dazu, warum Modelle etwas erfinden, im Artikel KI-Halluzinationen.
Wie misst man, dass RAG nicht lügt?
Mit einem Satz von Fragen, die Menschen wirklich stellen, mit der richtigen Antwort und dem Dokument, das sie enthält. Nicht mit Fragen, die sich ein Entwickler beim Schreiben des Prompts ausdenkt. Ein Fall sieht zum Beispiel so aus:
- id: dienstreise-genehmigung
  as_user: groups=[vertrieb]
  question: Wer genehmigt meine Dienstreise ins Ausland?
  expect_source: reisekostenrichtlinie.pdf#genehmigung
  expect_answer_contains: ["Abteilungsleiter"]
- id: gehaelter-ohne-berechtigung
  as_user: groups=[vertrieb]
  question: Wie viel verdient der Lagerleiter?
  expect: refused
- id: ausserhalb-dokumente
  as_user: groups=[vertrieb]
  question: Wie ist der Euro-Wechselkurs heute?
  expect: refused
Das Beispiel ist erfunden, es geht um die Form. Bei jeder Änderung an Prompt, Modell, Chunking oder Quellen läuft der ganze Satz, und vier Zahlen werden getrennt verfolgt:
- Retrieval: War die erwartete Quelle unter den Chunks, die das Modell bekommen hat?
- Antwort: Enthält sie die richtige Angabe und zitiert sie die richtige Quelle?
- Ablehnung: Hat es dort abgelehnt, wo es keine Antwort gibt, und dort nicht, wo es eine gibt?
- Berechtigungen: Fälle, in denen jemand einen Chunk bekam, den er nicht sehen darf. Der einzige akzeptable Wert ist dort null.
Falsche Antworten aus dem Betrieb, die Nutzer markieren, gehen als neue Fälle zurück in den Satz. So wächst er mit dem, was Menschen wirklich fragen.
Ist Ihr RAG bereit für Firmendaten?
Gehen Sie Ihr Setup durch:
Wann Sie kein RAG bauen sollten
- Es gibt ein paar Dutzend Dokumente, und sie ändern sich selten. Oft reicht es, sie komplett in den Kontext des Modells zu geben und sich den Index zu sparen.
- Die Antwort steht in einer Datenbank, nicht in einem Text. Fragen Sie Bestellstatus oder Lagerbestand per Abfrage an das System ab, nicht per Dokumentensuche.
- Niemand weiß, welche Dokumente gelten. RAG über einem Durcheinander antwortet schnell und falsch. Räumen Sie zuerst die Quellen auf.
- Sie haben niemanden, der Evals schreibt. Ohne einen Satz Fragen mit bekannter Antwort wissen Sie nicht, ob RAG lügt, und erfahren es auch nach einem Modellwechsel nicht.
Brauchen Sie ein RAG, dem Menschen vertrauen?
RAG mit Firmendaten bauen wir im Rahmen unserer Leistung KI-Agent für Unternehmen nach Maß: Retrieval, Berechtigungen, Zitate und Evals direkt in Ihrem Repository. Code, Index und Daten gehören Ihnen vom ersten Tag an.
Wir melden uns innerhalb von zwei Arbeitstagen mit ein paar Fragen zu Ihrer Arbeit. Dann vereinbaren wir, was wir zuerst angehen.
Wenn Sie zuerst sprechen möchten, buchen Sie ein 15-minütiges Erstgespräch.
Was macht Ihr RAG heute, wenn Sie es nach etwas fragen, das nicht in den Dokumenten steht?
Kurz gesagt
- RAG lügt meistens, weil das Retrieval einen falschen oder veralteten Chunk geliefert hat, nicht weil das Modell etwas aus dem Nichts erfindet.
- Metadaten mit Version und Gültigkeit, hybride Suche und Reranking lösen die meisten falschen Antworten.
- Filtern Sie Berechtigungen in der Index-Abfrage nach dem angemeldeten Nutzer. Ein Prompt ist keine Zugriffskontrolle.
- Das Modell liefert eine Antwort mit Zitaten oder eine Ablehnung, und Code prüft, dass die Zitate unter den gefundenen Chunks sind.
- Ein Eval-Satz mit Fragen ohne Antwort und ohne Berechtigung läuft bei jeder Änderung.
Häufige Fragen
Was ist RAG?
RAG (Retrieval-Augmented Generation) bedeutet, dass das System zur Frage zuerst Abschnitte aus Ihren Dokumenten sucht und erst daraus das Sprachmodell eine Antwort schreibt. Das Modell antwortet so aus Ihren Daten, nicht aus dem, was es sich aus dem Training gemerkt hat.
Warum lügt RAG mit Firmendaten?
Meistens, weil das Retrieval einen falschen oder veralteten Chunk geliefert hat und das Modell brav daraus geantwortet hat. Seltener, weil das Modell ergänzt hat, was nicht im Chunk stand. Das Erste lösen Metadaten, hybride Suche und Retrieval-Evals, das Zweite per Code geprüfte Zitate und die Regel, ohne Quelle abzulehnen.
Wie regelt man in RAG die Zugriffsrechte auf Dokumente?
Mit einem Filter in der Index-Abfrage, nach der Identität des Nutzers, bevor das Modell die Chunks sieht. Eine Anweisung im Prompt wie „keine Gehälter zeigen“ ist keine Zugriffskontrolle. Was das Modell nicht bekommt, kann es nicht verraten.
Wie testet man, ob RAG richtig antwortet?
Mit einem Satz echter Fragen mit der richtigen Antwort und der Quelle, die sie enthält. Dazu gehören auch Fragen, auf die die Dokumente keine Antwort haben, und Fragen eines Nutzers, der das Dokument nicht sehen darf. Er läuft bei jeder Änderung an Prompt, Modell, Chunking und Dokumenten.
Brauche ich für RAG eine Vektordatenbank?
Nicht unbedingt eine eigene. Für Tausende Dokumente reicht oft Ihre bestehende Datenbank mit einer Vektor-Erweiterung und Volltextsuche. Wichtiger als die Datenbank ist, dass sie in derselben Abfrage nach Berechtigungen und Version filtern kann.
Fragen Sie eine KI zu diesem Artikel
Die KI nutzt dabei auch unsere anderen Artikel und Erfahrung aus echten Projekten.
ChatGPTClaudePerplexity

