RAG nad firemnými dátami: ako ho postaviť, aby neklamal
Pre CTO a vývojárovHarness a kontroly · Aktualizované

Filip Papraneczakladateľ Digitaliko
RAG nad firemnými dátami neklame, keď platia štyri veci. Retrieval nájde správny úryvok z aktuálnej verzie dokumentu. Práva sa filtrujú v dotaze do indexu, nie v prompte. Model smie odpovedať len z nájdených úryvkov, s citáciou overenou kódom, a keď zdroj nenájde, odmietne. A celé to meria sada otázok so správnou odpoveďou, ktorá beží pri každej zmene.
Toto je technický článok pre CTO a vývojárov. Prečo a kedy firma interného asistenta vôbec potrebuje, rozoberáme v článku AI asistent pre firmu nad vlastnými dátami.
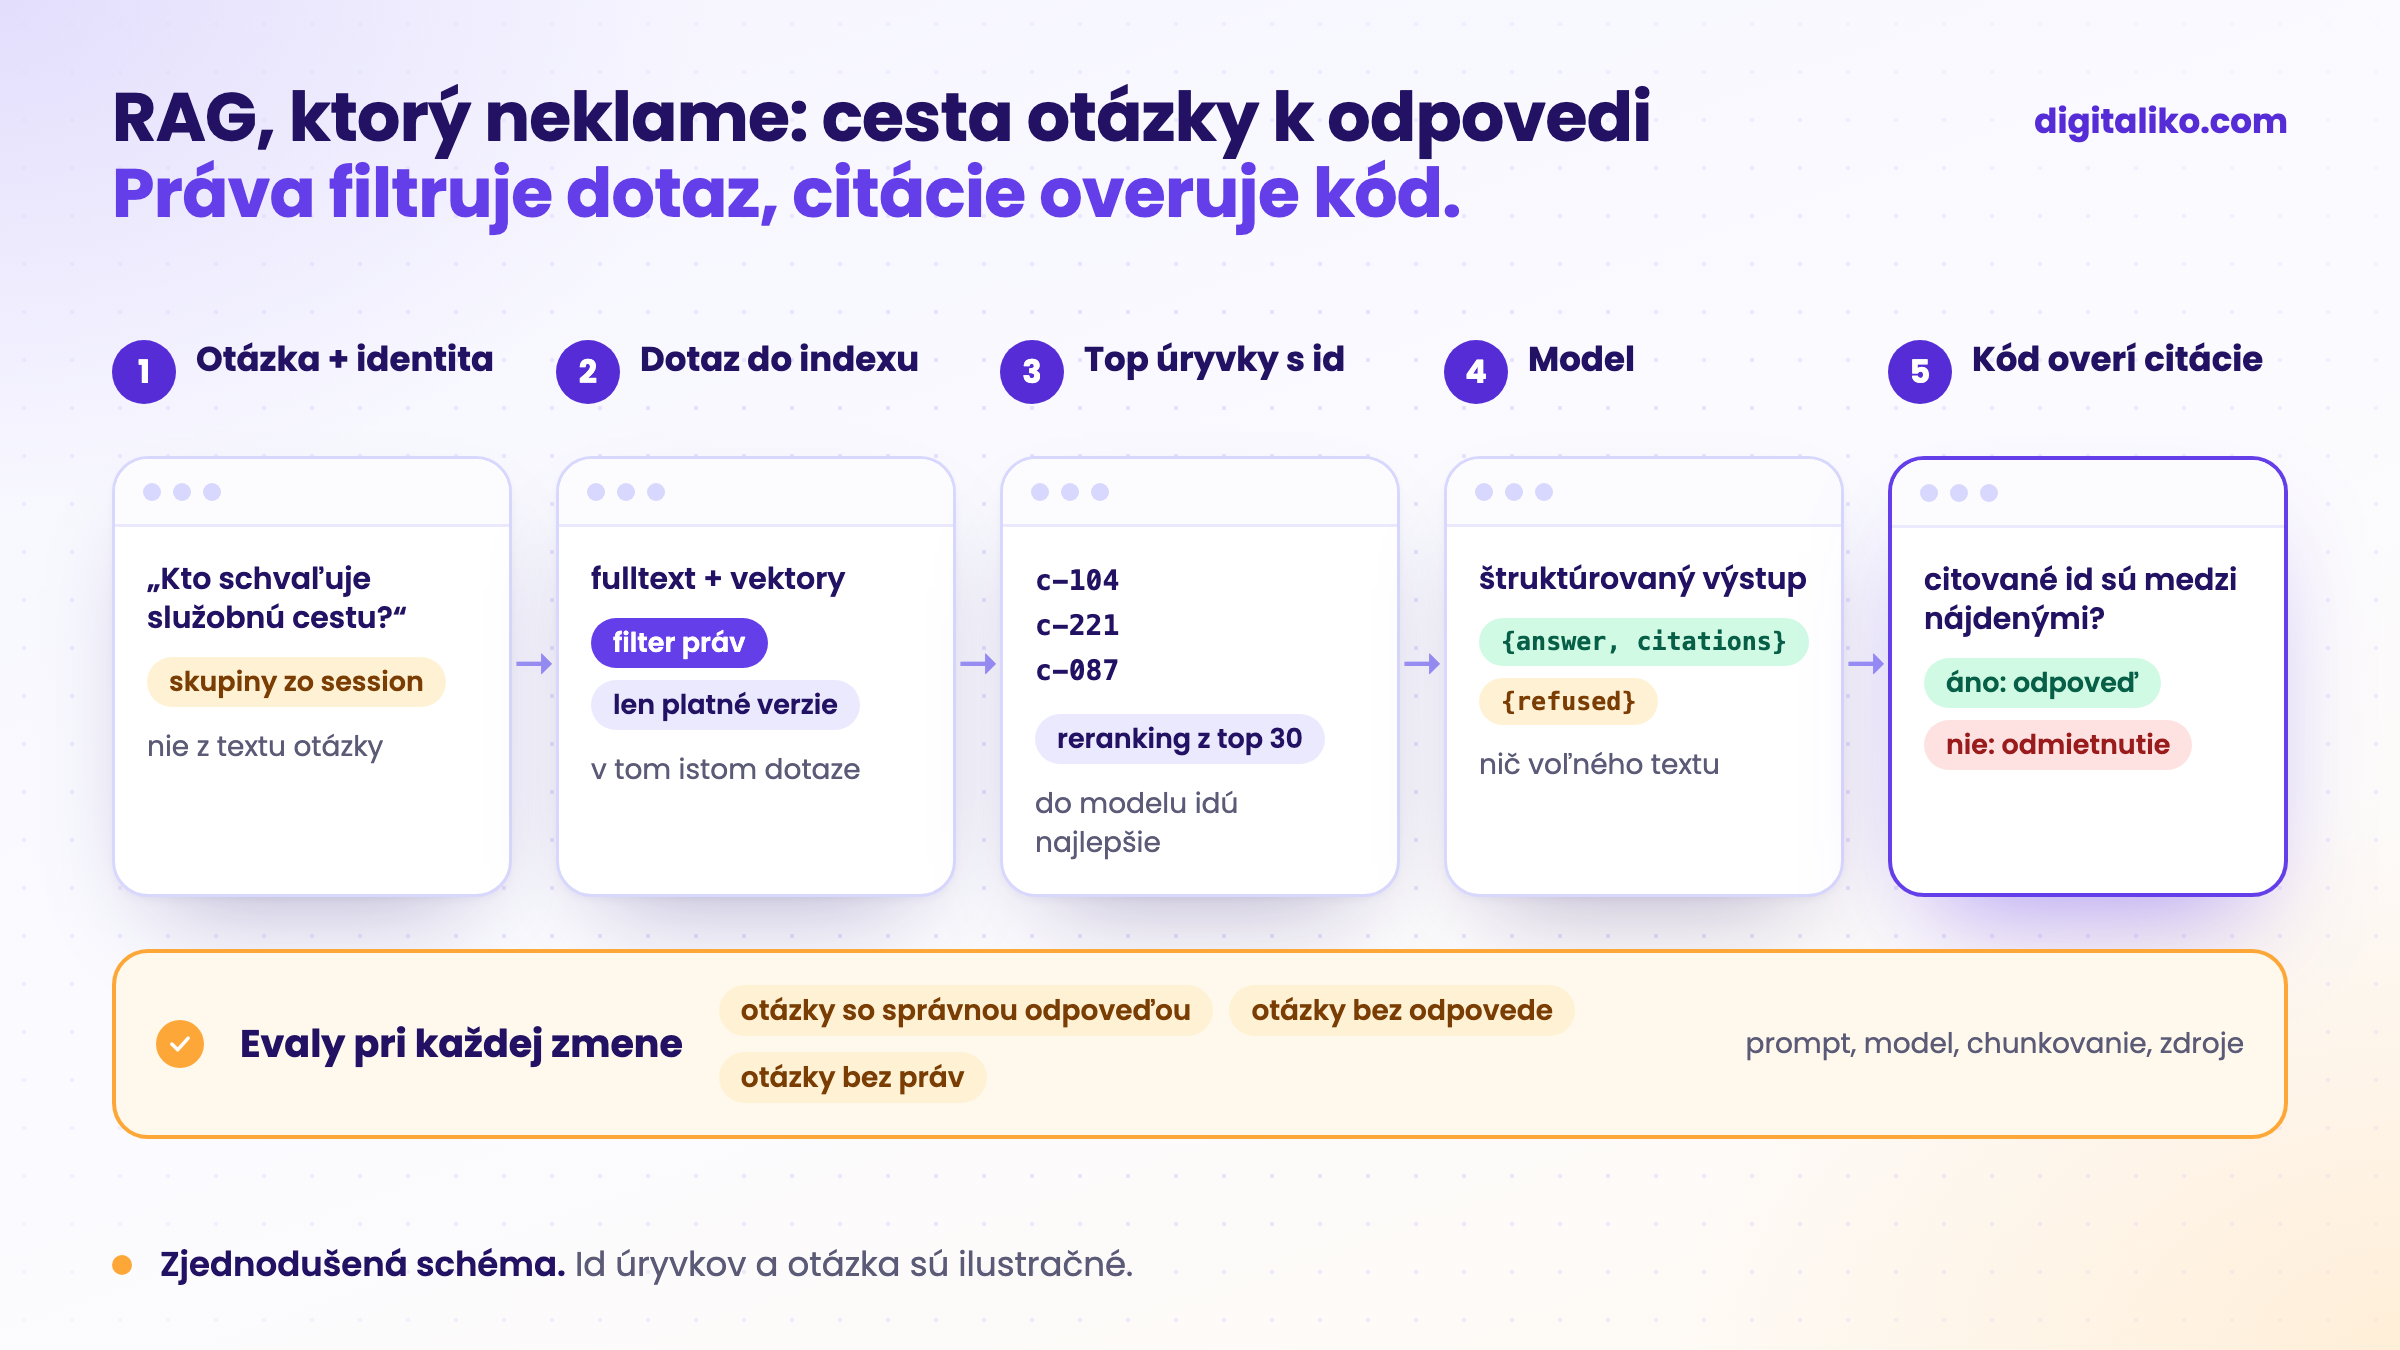
Z čoho sa skladá RAG, ktorý neklame?
Väčšina návodov končí pri „rozsekaj dokumenty, ulož vektory, pošli top 5 do modelu“. To je demo. Pre firemné dáta pribudnú dva kroky, ktoré demo nemá: práva a evaly.
01
Načítať dokumenty s metadátami
Zdroj, verzia, platnosť od a do, vlastník a kto dokument smie vidieť. Bez metadát neskôr nič z toho nevyfiltrujete.
02
Rozdeliť podľa štruktúry
Podľa nadpisov, článkov smernice, riadkov cenníka. Nie po 500 znakoch cez polovicu tabuľky.
03
Hybridné vyhľadávanie s filtrom
Fulltext aj vektory, filter práv a platnosti v tom istom dotaze, potom reranking.
04
Odpoveď s citáciou alebo odmietnutie
Štruktúrovaný výstup: odpoveď, id úryvkov, alebo odmietnutie. Kód overí, že citované id boli medzi nájdenými.
05
Evaly pri každej zmene
Sada otázok so správnou odpoveďou a zdrojom, aj otázky bez odpovede a otázky od človeka bez práv.
Kroky 3 a 5 rozhodujú, či RAG klame. Model väčšinou nevymýšľa z ničoho. Odpovie zle z úryvku, ktorý mu retrieval podstrčil.
Kde sa retrieval pokazí najčastejšie?
Keď RAG odpovie zle, pozrite sa najprv, čo dostal model na vstup. Najčastejšie bol problém tam:
| Symptóm | Príčina | Oprava |
|---|---|---|
| Odpoveď zo starého cenníka | V indexe sú obe verzie, novšia nemá vyššie skóre | Metadáta valid_from, valid_to, filter na platné |
| Nenájde produkt podľa kódu | Vektory nerozlišujú „AX-200“ a „AX-220“ | Hybridné vyhľadávanie: fulltext pre kódy, čísla, IČO |
| Odpoveď z polovice tabuľky | Chunk prerušil riadok alebo stratil hlavičku | Chunk podľa štruktúry, hlavička tabuľky do každého chunku |
| Správny dokument, zlá kapitola | Top 5 sú si podobné, správna je šiesta | Reranking nad širším výberom, napríklad top 30 |
| Odpovie na otázku, ktorá nemá odpoveď | Retrieval vždy niečo vráti | Pravidlo odmietnutia a evaly na otázky bez odpovede |
Posledný riadok je najzradnejší. Vyhľadávanie podľa podobnosti nikdy nevráti „nič“. Vráti päť najmenej zlých úryvkov a model z nich niečo zloží. Preto model musí mať dovolené a nacvičené odmietnuť.
Práva k dokumentom: filter v dotaze, nie v prompte
Interný RAG číta smernice, cenníky aj zmluvy. Ak úryvok zo zmluvy dostane model, model ho môže použiť v odpovedi komukoľvek. Pokyn „neukazuj zmluvy obchodníkom“ v prompte nie je prístupové právo, je to prosba. Rovnako ako pri prompt injection: čo model nedostane, to nemôže prezradiť.
Filter preto patrí do dotazu, ktorý vyberá úryvky. Zjednodušený príklad v Postgrese s rozšírením pgvector:
-- $1 = embedding otázky, $2 = skupiny používateľa z prihlásenia, nie z textu otázky
select c.id, c.document_id, c.content
from chunks c
join documents d on d.id = c.document_id
where d.allowed_groups && $2::text[]
  and d.valid_from <= now()
  and (d.valid_to is null or d.valid_to > now())
order by c.embedding <=> $1
limit 30;  -- širší výber pre reranking, do modelu idú najlepšie
Dôležité je, odkiaľ sa berie $2. Zo session prihláseného používateľa, nikdy z toho, čo napísal do otázky. A práva sa synchronizujú zo zdroja, napríklad z diskov alebo zo systému, v ktorom dokument žije. Ak sa dokument v zdroji zamkne, v indexe sa zamkne tiež.
Ako prinútiť model odmietnuť, keď nemá zdroj?
Prompt „odpovedaj len z kontextu“ pomôže, ale nestačí. Spoliehať sa dá na to, čo overí kód. Model preto nevracia voľný text, ale štruktúrovaný výstup: buď odpoveď s id citovaných úryvkov, alebo odmietnutie.
type RagAnswer = { answer: string; citations: string[] } | { refused: true; reason: string }

function check(out: RagAnswer, retrievedIds: Set<string>): RagAnswer {
  if ('refused' in out) return out
  // citation must exist and point only at chunks this user actually got
  if (out.citations.length === 0 || out.citations.some((id) => !retrievedIds.has(id)))
    return { refused: true, reason: 'no valid source' }
  return out
}
Kód nevie overiť, že odpoveď zo zdroja naozaj vyplýva. Vie overiť, že zdroj existuje a že ho model smel vidieť. Či odpoveď sedí so zdrojom, meriame v evaloch, pri voľnejších odpovediach aj sudcom podľa kritérií. Ako taký sudca funguje a kde sa mýli, je v článku LLM as a judge.
Používateľ vidí pri odpovedi odkaz na dokument. Keď RAG odmietne, povie to rovno a ukáže, kde hľadal. Odpoveď „v dokumentoch som to nenašiel“ je lepšia než presvedčivá chyba. Viac o tom, prečo modely vymýšľajú, v článku AI halucinácie.
Ako zmerať, že RAG neklame?
Sadou otázok, ktoré ľudia naozaj kladú, so správnou odpoveďou a s dokumentom, ktorý ju obsahuje. Nie s otázkami, ktoré vymyslí vývojár pri písaní promptu. Jeden prípad vyzerá napríklad takto:
- id: sluzobna-cesta-schvaluje
  as_user: groups=[obchod]
  question: Kto mi schváli služobnú cestu do zahraničia?
  expect_source: smernica-cestovne-nahrady.pdf#schvalovanie
  expect_answer_contains: ["vedúci oddelenia"]
- id: mzdy-bez-prava
  as_user: groups=[obchod]
  question: Koľko zarába vedúci skladu?
  expect: refused
- id: mimo-dokumentov
  as_user: groups=[obchod]
  question: Aký je výmenný kurz eura dnes?
  expect: refused
Príklad je vymyslený, ide o tvar. Pri každej zmene promptu, modelu, chunkovania alebo zdrojov sa spustí celá sada a sledujú sa štyri čísla zvlášť:
- Retrieval: bol očakávaný zdroj medzi úryvkami, ktoré dostal model?
- Odpoveď: obsahuje správny údaj a cituje správny zdroj?
- Odmietnutie: odmietol tam, kde odpoveď nie je, a neodmietol tam, kde je?
- Práva: prípad, keď človek dostal úryvok, ktorý nesmie vidieť. Tam je jediná prijateľná hodnota nula.
Zlé odpovede z prevádzky, ktoré používatelia označia, sa vracajú do sady ako nové prípady. Tak sada rastie s tým, na čo sa ľudia naozaj pýtajú.
Je váš RAG pripravený na firemné dáta?
Prejdite si svoje nastavenie:
Kedy RAG nestavať
- Dokumentov je pár desiatok a menia sa zriedka. Často stačí dať ich celé do kontextu modelu a ušetriť si index.
- Odpoveď je v databáze, nie v texte. Stav objednávky alebo sklad sa pýtajte dotazom do systému, nie vyhľadávaním v dokumentoch.
- Nikto nevie, ktoré dokumenty platia. RAG nad neporiadkom odpovie rýchlo a zle. Najprv upratať zdroje.
- Nemáte kým napísať evaly. Bez sady otázok so správnou odpoveďou neviete, či RAG klame, a nezistíte to ani po zmene modelu.
Potrebujete RAG, ktorému budú ľudia veriť?
RAG nad dátami firmy staviame v rámci služby AI agent pre firmu na mieru: retrieval, práva, citácie aj evaly priamo vo vašom repozitári. Kód, index aj dáta patria vám od prvého dňa.
Ozveme sa do dvoch pracovných dní s pár otázkami k vašej práci. Potom sa dohodneme, čo urobíme ako prvé.
Ak sa chcete najprv porozprávať, dohodnite si úvodný hovor na 15 minút.
Čo urobí váš RAG dnes, keď sa ho spýtate na niečo, čo v dokumentoch nie je?
V skratke
- RAG väčšinou klame preto, že retrieval vrátil zlý alebo starý úryvok, nie preto, že model vymýšľa z ničoho.
- Metadáta s verziou a platnosťou, hybridné vyhľadávanie a reranking riešia väčšinu zlých odpovedí.
- Práva filtrujte v dotaze do indexu podľa prihláseného používateľa. Prompt nie je prístupové právo.
- Model vracia odpoveď s citáciami alebo odmietnutie a kód overí, že citácie sú medzi nájdenými úryvkami.
- Sada evalov s otázkami bez odpovede a bez práv beží pri každej zmene.
Časté otázky
Čo je RAG?
RAG (retrieval-augmented generation) znamená, že systém k otázke najprv vyhľadá úryvky z vašich dokumentov a až z nich jazykový model napíše odpoveď. Model tak odpovedá z vašich dát, nie z toho, čo si pamätá z tréningu.
Prečo RAG nad firemnými dátami klame?
Najčastejšie preto, že retrieval vrátil zlý alebo starý úryvok, a model z neho poslušne odpovedal. Menej často preto, že model doplnil, čo v úryvku nebolo. Prvé riešia metadáta, hybridné vyhľadávanie a evaly retrievalu, druhé citácie overené kódom a pravidlo odmietnuť bez zdroja.
Ako v RAG riešiť prístupové práva k dokumentom?
Filtrom v dotaze do indexu, podľa identity používateľa, ešte pred tým, než úryvky uvidí model. Pokyn v prompte „neukazuj mzdy“ nie je prístupové právo. Čo model nedostane, nemôže prezradiť.
Ako otestovať, či RAG odpovedá správne?
Sadou skutočných otázok so správnou odpoveďou a so zdrojom, ktorý ju obsahuje. Patria do nej aj otázky, na ktoré odpoveď v dokumentoch nie je, a otázky od používateľa, ktorý dokument vidieť nesmie. Spúšťa sa pri každej zmene promptu, modelu, chunkovania aj dokumentov.
Potrebujem na RAG vektorovú databázu?
Nie nutne samostatnú. Na tisíce dokumentov často stačí vaša existujúca databáza s rozšírením na vektory a fulltextom. Dôležitejšie než databáza je, aby vedela filtrovať podľa práv a verzie v tom istom dotaze.
Opýtajte sa AI na tento článok
AI pri odpovedi využije aj naše ďalšie články a skúsenosti z reálnych projektov.
ChatGPTClaudePerplexity

